全世界第一个基于text的超参数optimizer诞生!
358 阅读
超参数是现代模型里面一个神奇的东西。很多时候无法有一个实际的含义去解释这个参数的意义,但是它的结果对于模型的影响有时候却十分巨大。因此,超参数优化是现代模型中一个必不可少的调优内容。
5月26日,DeepMind研究人员Yutian Chen等人提出了一个超参数优化框架,取得了很好的性能。实验结果看,这个方法比Random Search、GP-UCB、HyperBO等效果都要好出不少。

由于目前大平台都积累了很多的超参数优化调整的数据(如Google的Vizier、Amazon的SageMaker等),利用这些调整数据来做meta-learn hyperparameter optimization也成为一种非常不错的方式。但是,当前大多数元学习和转移学习的HPO方法考虑了一个限制性的设置,即所有的任务必须共享相同的超参数集,以便输入数据可以被表示为固定大小的向量。显然,这里有巨大的优化空间。因此,DeepMind的研究人员提出了OPTFORMER模型,一个基于Transformer通用超参数优化框架,它将任何元数据和优化轨迹的组合转换为文本,表示为一个标记序列,并将HPO任务制定为一个序列建模问题。
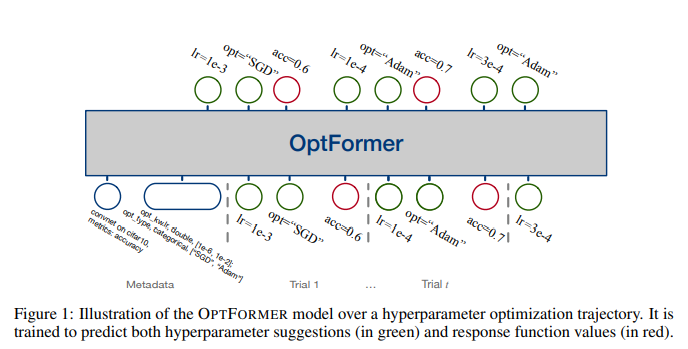
这个方法有如下优点:
- 轻松模仿非常不同的超参数调谐算法,也就是说一个框架覆盖多种方法;
- 比高斯过程更稳健地预测下一个目标值
- 使用主动采样策略,如预期改进,以决定下一步尝试哪些超参数。
不过可惜的是,目前这个模型的代码没有公布,但是作者表示以后会考虑。
DataLearner 官方微信
欢迎关注 DataLearner 官方微信,获得最新 AI 技术推送