
MiniMax M3.1 Flash 开放权重解析:428B MoE 的量化架构、显存需求与本地部署可行性指南
2026 年 10 月 19 日,MiniMax 正式发布了主打高频 Agent 工作流与代码工程的 MiniMax M3.1 Flash;10 月 23 日,其开放权重仓库(MiniMaxAI/MiniMax-M3.1-Flash)正式在 Hugging Face 社区上线(采用 minimax-community 许可协议)。这款此前以代号“Space Bunny”在匿名测试阶段累计处理超过 200 万亿 Token、在 DeepSWE v1.1 拿到 73.7%、OSWorld V2 达到 61.7 的大模型,迅速成为本地部署圈讨论的焦点。
面对一个总参数量约 428B、激活参数 23B(428B-A23B)、原生支持 1M(100 万)上下文窗口的超大规模混合专家(MoE)模型,其完整权重下载体积约为 250GB~265GB。
为什么 428B 参数的模型权重能压到 250GB 左右?在线推理 200+ TPS 的表现能否复制到本地?在不同硬件平台与推理框架下,哪些能力已经验证,哪些仍存在算子或带宽瓶颈?本文将从官方技术规格、硬件显存需求分析与本地部署可行性出发,提供一份面向工程落地的选型参考。
一、核心架构与原生量化拆解:250GB 级权重是怎么来的?
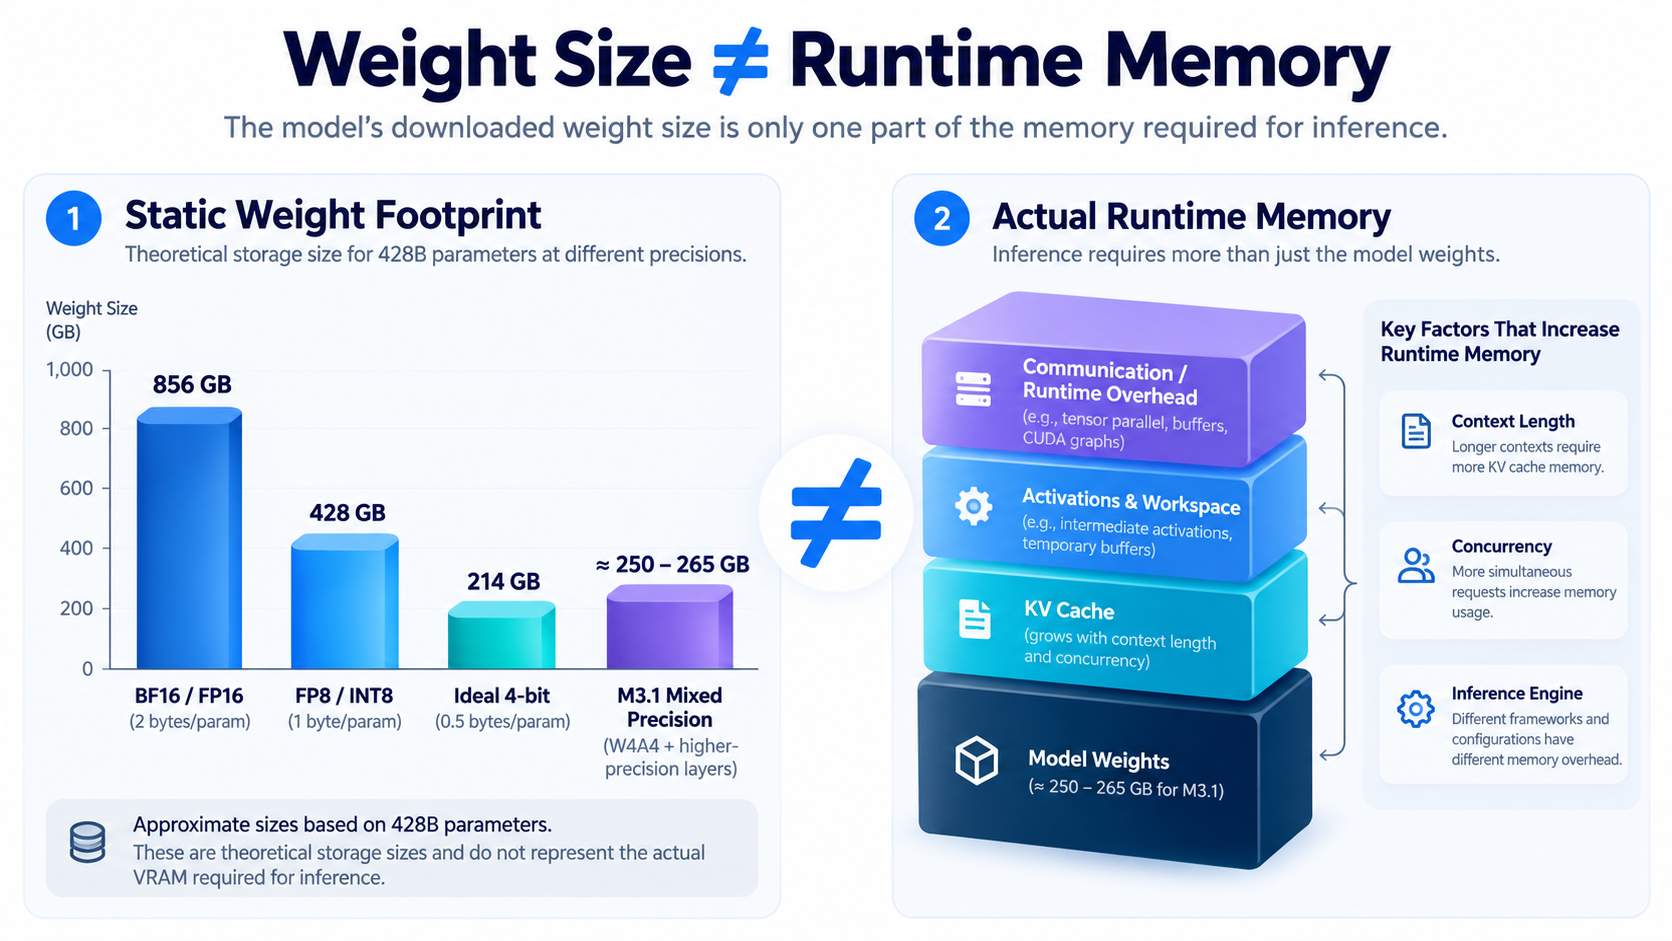
在常规认知中,428B 参数的模型即便做全量 FP8 量化,纯权重体积也需要约 428GB。M3.1 Flash 之所以能将公开检查点体积控制在 250GB~265GB 区间,源于其在架构与量化策略上的三项核心演进:
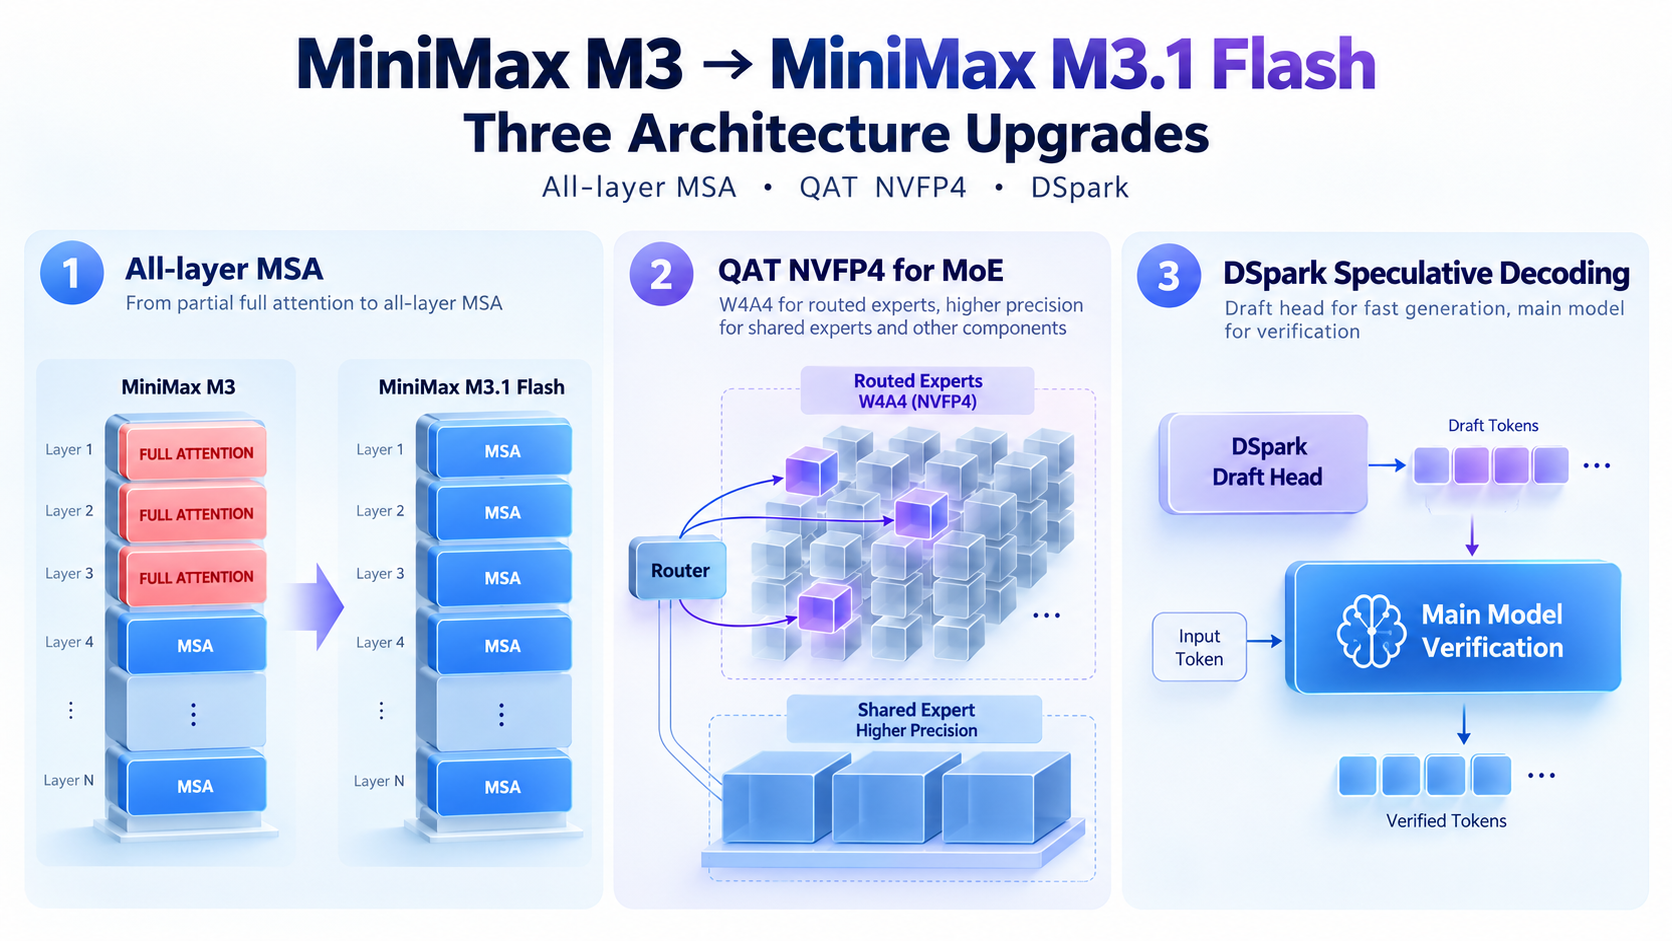
1. 全层稀疏注意力(MSA)与 DSpark 投机采样
在上一代 MiniMax M3 中,为了保底长序列初期的表征稳定性,模型保留了前三个全注意力层(Full Attention),其余层采用 MiniMax 稀疏注意力(MSA)。而在 M3.1 Flash 中,前三个全注意力层被彻底替换为 MSA,实现了真正的全模型稀疏注意力;同时模型内置了 DSpark 投机采样草稿头(Draft Head),替代了早期类 EAGLE 的多 Token 预测(MTP)机制。
工程认知纠偏:全层 MSA 主要解决的是 1M 超长上下文下 Attention 计算复杂度与 KV 访问成本的膨胀问题,但它并不会让 KV Cache 完全消失,更不会消除 428B MoE 专家权重在解码阶段带来的显存/内存带宽压力。
2. 区分两套量化机制:W4A4 (NVFP4) 与 Q8KV4
M3.1 Flash 的低体积与高吞吐建立在量化感知训练(QAT)导出的混合精度架构之上,工程选型时需区分两个概念:
- 路由专家的
W4A4(NVFP4):模型中占比庞大的稀疏路由专家(Routed Experts)在训练阶段直接迁移至 W4A4(4-bit 权重 + 4-bit 激活),而对精度敏感的共享专家(Shared Experts)、门控路由(Router)及主干层则保留高精度(FP8/BF16)。 - 稀疏注意力的
Q8KV4:注意力机制中的索引器(Indexer)与主分支计算从上一代的Q8KV8迁移至Q8KV4。 - 对本地部署的直接影响:
Q8KV4是针对 MSA 注意力结构的专用混合量化格式,不能简单等同于推理引擎里的通用全局 FP4 KV Cache。即便推理框架提供通用nvfp4KV 缓存选项,也需配合实装 M3.1 专用的 MSA 内核路径,才能完整复现其设计性能。
3. 428B 权重的静态体积与运行时显存需求分析
从参数规模出发,可以估算 428B 参数在不同精度下的纯权重静态体积:
关键硬件预警:250GB 级静态权重 ≠ 250GB 显存即可运行!
在实际部署中,除了驻留全部 428B 专家权重外,显存/内存还必须容纳:
- 长上下文 KV Cache:随并发数(Batch Size)与上下文长度(如 128K~1M)动态增长;
- 运行时开销:激活值临时缓冲区(Activation Workspace)、CUDA Graph 捕获开销以及多卡张量并行(TP)的通信缓冲区。
因此,单机或集群的可用总显存建议留出 300GB~320GB 以上的安全水位。
二、量化路线与硬件选型评估
由于官方首发权重本身已是经过 QAT 训练的混合精度检查点,在做硬件与量化选型时,需跳出常规“从 BF16 往下降级量化”的传统思路:
硬件选型的两个核心避坑指南
- 破除“FP8 展开无损”的误区:H100 / H200 的 Tensor Core 原生支持到 FP8,不支持硬件级 FP4 加速。在 Hopper 架构上运行 M3.1 Flash,通常是通过 W4A8(4-bit 权重存储、运行时反量化至 FP8/BF16 计算)或兼容模式服务。这属于算子兼容手段,其精度上限依然受限于官方检查点本身的表达能力。
- 认清 NVIDIA DGX Spark 的真实容量限制:根据 NVIDIA 官方规格,单台 DGX Spark 配备的是 128GB 统一内存。面对 250GB+ 的 M3.1 Flash:
- 1 台 DGX Spark(128GB):物理容量不足,无法完整驻留;
- 2 台 DGX Spark(256GB):扣除系统与运行时开销后依然捉襟见肘;
- 至少需要 3~4 台 DGX Spark(384GB~512GB)组建分布式推理集群,才具备完整加载运行的可行性。
关于部署配置与性能数据的说明
本文涉及的权重体积、显存需求、推理吞吐及硬件选型建议,主要基于官方公开资料、模型架构分析与理论估算。实际表现会受到量化格式、推理框架及其版本、硬件配置、上下文长度和并发规模等因素影响。尤其对于刚开放权重的新模型,相关框架的适配与优化仍可能持续变化。因此,文中的配置与性能数据应视为选型参考,而非保证达到的部署指标,具体以最新官方文档及实际测试结果为准。
三、本地与私有化部署路径可行性分析
需要明确的是:官方公布的 200+ TPS 峰值(中位数 170+ TPS)属于其在线推理集群的表现。在本地或私有化部署时,实际吞吐取决于硬件内存带宽与推理框架的算子适配进度。
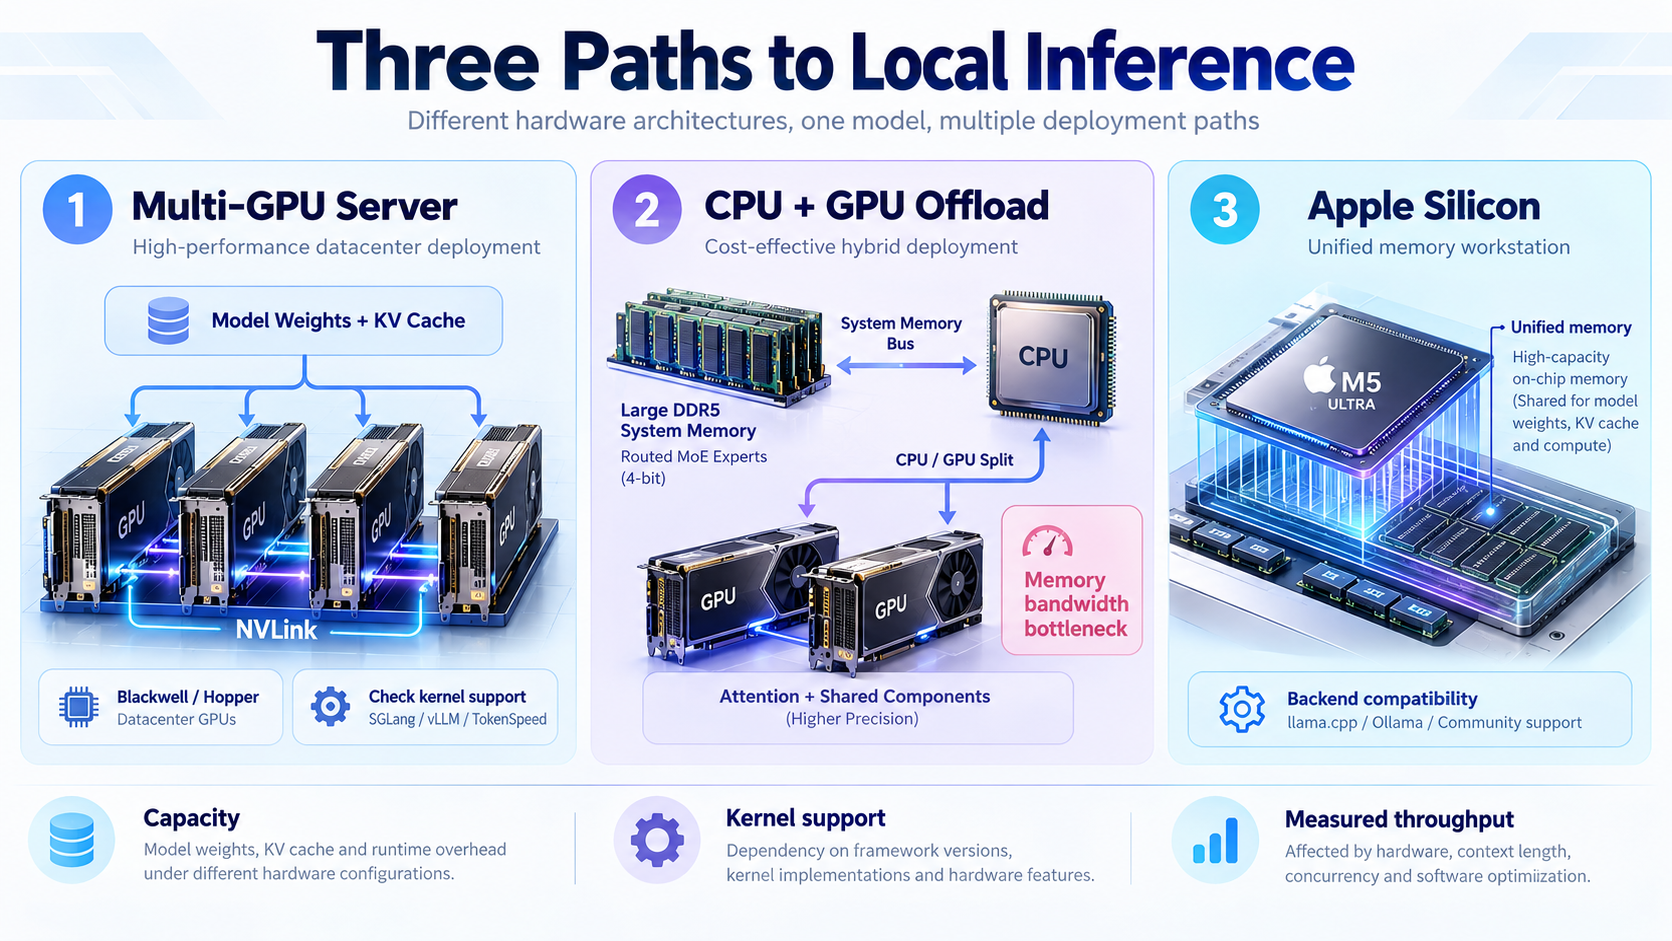
路径 1:多卡 GPU 服务器(vLLM / SGLang / TokenSpeed 部署参考)
官方 Model Card 推荐使用 SGLang、vLLM 或 TokenSpeed 部署 M3.1 Flash。以 vLLM 为例,结合 MiniMax M3 系列稀疏注意力架构的参数规范,启动配置参考如下:
# 参考配置:基于 M3 系列架构规范整理;实际执行前须核对 M3.1 对应的 vLLM recipe 和硬件限制
vllm serve MiniMaxAI/MiniMax-M3.1-Flash \
  --tensor-parallel-size 4 \
  --block-size 128 \
  --kv-cache-dtype nvfp4 \
  --enable-auto-tool-choice \
  --tool-call-parser minimax_m3 \
  --reasoning-parser minimax_m3 \
  --trust-remote-code
部署前核查要点:
- 参数规范对齐:vLLM 中的 FP4 KV 缓存参数名为
nvfp4;工具与思考解析器在 M3 系列中通常使用minimax_m3,且需配合--block-size 128对齐稀疏注意力块大小。nvfp4的可用性还取决于 GPU 架构和特定 MSA 后端。 - 推荐采样参数:官方建议在推理设置中将采样参数设为
temperature=1.0与top_p=0.95。 - 版本适配确认:由于 M3.1 将前三层改为了 MSA 并引入了 DSpark 草稿头,拉取镜像前请务必查阅官方仓库附带的 SGLang cookbook 与 vLLM recipe 链接,确保使用了合入 M3.1 专用支持代码的最新版本。
路径 2:CPU + GPU 异构卸载(基于内存带宽的吞吐边界估算)
对于拥有大内存服务器(如 384GB/512GB DDR5)加单双卡消费级 GPU 的开发者,通过 llama.cpp 或 KTransformers 将 Attention 与共享专家放在 GPU、把庞大的稀疏路由专家卸载到系统内存,是一条低成本跑通 428B 模型的经典路线。
这条路线在容量上具有可行性,但速度受限于物理内存带宽。我们可以做一个简单的理论估算:
假设单并发解码(Batch Size = 1)时,每个 Token 激活 23B 参数,其中约 20B 属于存放在系统内存中的 4-bit 路由专家,那么 CPU 每生成 1 个 Token 至少需要从内存读取约 10GB 的权重数据(20 × 10⁹ × 0.5 Bytes)。
在忽略计算、索引、PCIe 同步与缓存未命中开销的理想情况下,CPU 异构卸载的理论解码上限取决于系统内存的有效带宽:
- 双通道 DDR5-6000(普通消费级台式机,理论带宽 ~96 GB/s):受限于每 Token 10GB 的访存量,理论极限仅数个 Token/s,加上开销后难以满足实时交互。
- 八通道 DDR5-6400(主流工作站/单路服务器,理论峰值 409.6 GB/s,有效带宽约 300 GB/s):物理带宽决定了其理论上限不可能突破 40 TPS;扣除 CPU 算子与同步开销后,10~25 TPS 可作为待验证的经验参考,而非 M3.1 的实测结果。
- 十二通道 DDR5-6400(如高配 AMD EPYC 平台,理论峰值 614.4 GB/s):具备更高的带宽余量,更有希望获得流畅的单流 Agent 编码体验。
此外,此前 llama.cpp 在适配 M3 的 MSA 架构时曾经历过 KV 量化与 RPC 分布式推理的兼容性迭代,M3.1 的异构卸载同样需要等待社区完成 GGUF 转换与张量适配验证。
路径 3:Apple Silicon 统一内存(M5 Ultra 纳入考量)与 Ollama 云端分流
- Apple Silicon 选型(M3 Ultra vs. M5 Ultra):配备 512GB 统一内存的 Mac Studio 是少数能单机装下整个模型的桌面设备。除了 M3 Ultra(最高 512GB,内存带宽约 819 GB/s)外,苹果在 2026 年 8 月发布的 M5 Ultra 已将统一内存带宽提升至 1.2 TB/s(512GB 配置于 10 月下旬起陆续交付)。对于访存密集型的超大 MoE 解码,更高内存带宽具有潜在的吞吐优势,但具体性能仍取决于推理后端适配。
- 区分 Ollama 的
:cloud与本地运行:目前 Ollama 模型库已提供minimax-m3.1-flash:cloud。需要明确的是:带有:cloud后缀的命令调用的是云端托管服务,并非在本地运行 428B 权重。如果你想在采购本地硬件前,先在 OpenCode 或 Claude Code 中验证 M3.1 Flash 的 Agent 表现,可通过云端命令快速接入:
# 通过 Ollama Cloud 远程接入体验,不占用本地海量显存
ollama run minimax-m3.1-flash:cloud
ollama launch opencode --model minimax-m3.1-flash:cloud
四、Agent 生产工程调优:思考深度控制与防幻觉策略
无论是私有化部署还是通过 API 接入,M3.1 Flash 在 Agent 场景中有三项特性需要工程团队重点关注:
1. Always-On Thinking 与五档思考深度路由
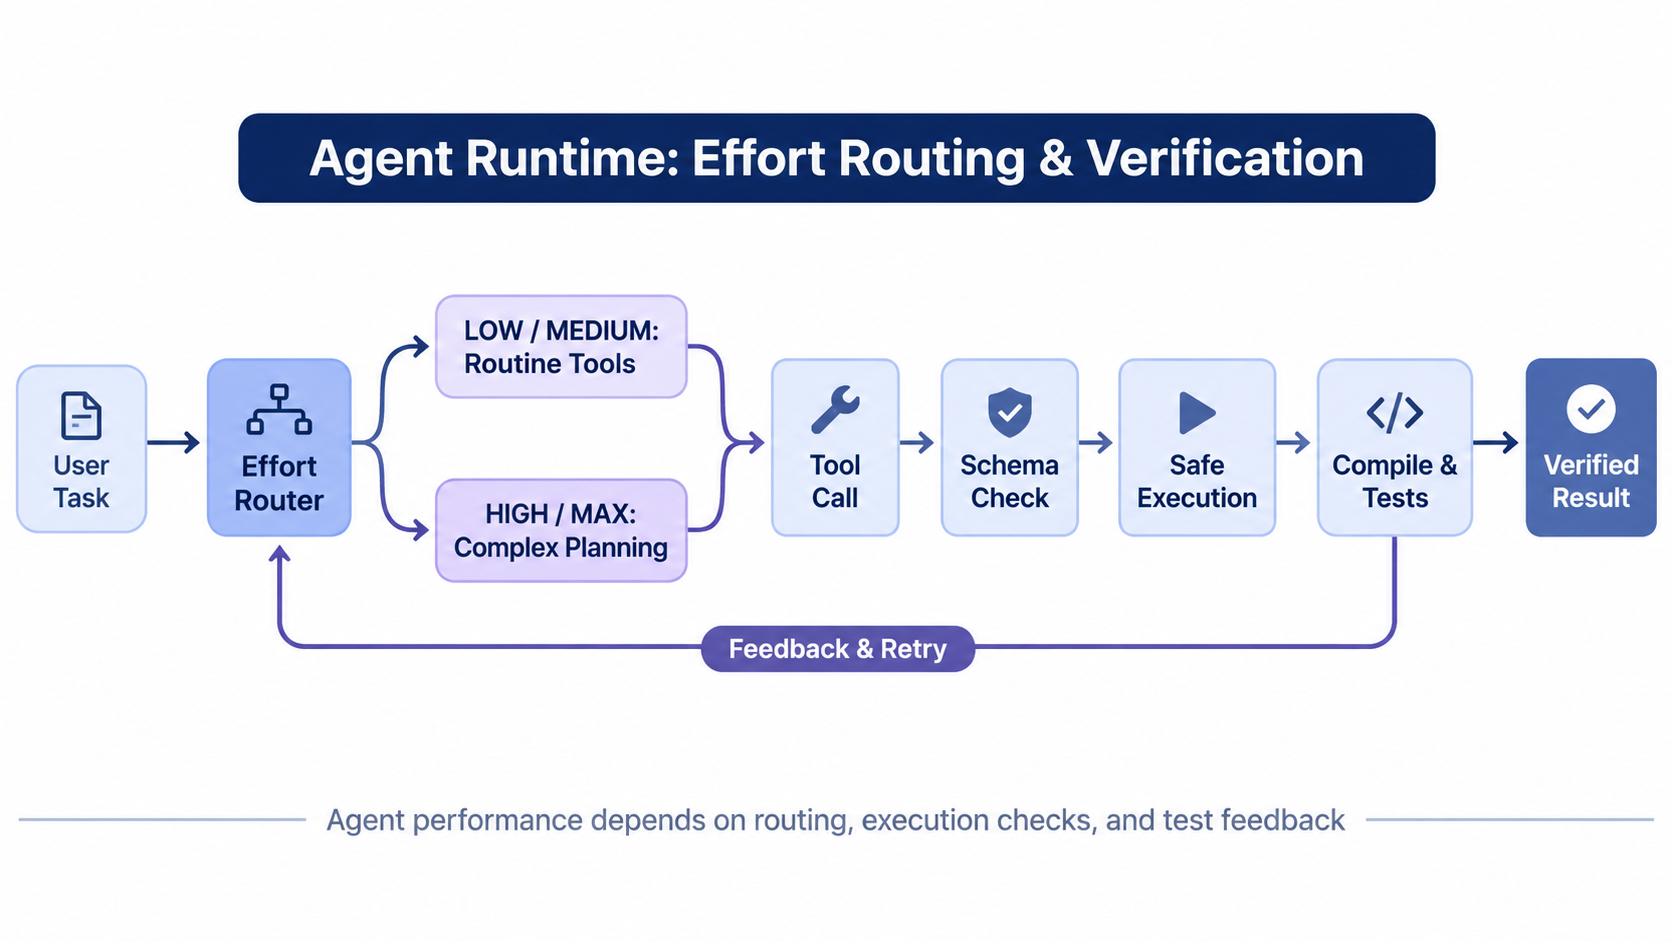
根据官方文档与 Model Card 说明,M3.1 Flash 的思考模式默认常开且不可关闭。模型在 Chat Template 与 API 中提供了五档思考深度:low、medium、high、xhigh、max(默认值为 max)。
第三方实测表明,在默认的 max 档位下,模型面对简单的目录查看或小步修复也会生成高达十余倍的推理 Token,导致耗时与成本大幅增加。因此在构建多步 Agent 时,强烈建议在编排层主动设置思考档位:
- OpenAI 兼容接口 / Chat Template:传入
"reasoning_effort": "low" | "medium" | "high" | "xhigh" | "max"。 - Anthropic 兼容接口:传入
"output_config": {"effort": "low" | "medium" | "high" | "xhigh" | "max"}。 - 分层调度策略:将
xhigh/max留给架构规划(Planning)与疑难 Bug 定位;将常规工具调用、文件遍历与简单修改显式设为low或medium,可在保障任务通过率的同时显著降低耗时与算力开销。
2. 应对高幻觉倾向:构建四层验证沙箱(Verification Harness)
在 Artificial Analysis 的 AA-Omniscience 评测中,M3.1 Flash 的事实知识正确率达到 56.2%,但同时表现出高达 92.8% 的 Omniscience 幻觉指标(反映其在非完全正确回答中倾向于给出错误答案,而不是弃答或部分回答;并不直接测量模型自信程度)。
针对这种“高知识储备、低拒答倾向”的特征,在自主 Agent 循环中应配置严格的外部验证机制:
- 工具调用 Schema 校验:在执行 Tool Call 前校验参数类型与必填项,拦截未定义的参数字段;
- 外部状态预检(Dry-run):对数据库修改、文件删除等副作用操作,先通过只读查询确认目标对象存在;
- 静态检查与编译反馈:代码落盘后自动运行
tsc --noEmit、ruff或node --check,用确定性的语法/类型报错引导模型修正; - 单元测试闭环:结合
pytest等测试框架验证实际运行结果,避免模型“盲目自信”地结束任务。
3. 多模态输入的工程兼容建议
M3.1 Flash 原生支持文本、图像与视频输入(OSWorld V2 达 61.7,BabyVision 工具辅助下达 91.0)。但在实际工程接入中,不同推理后端对多模态附件的支持程度存在差异(例如部分兼容接口能精准识别 base64 图像,但直接传入原生 PDF 文档块时可能被静默忽略)。在本地推理框架的多模态管线完全稳定前,建议在前置流程中先将 PDF 页面渲染为 PNG 图像或解析为 Markdown 文本后再传入模型。
结语
MiniMax M3.1 Flash 的权重开放,展示了“全层稀疏注意力(MSA)+ 原生量化感知训练(QAT)+ DSpark 投机采样”如何将 428B 级巨型 MoE 模型的硬件门槛拉低至 250GB 级权重区间。对于计划在本地或私有云引入该模型的团队而言,把握住运行时显存余量评估、系统内存带宽边界以及五档思考深度的动态调度,就能更好地发挥这一 Agent 模型的实际价值。
