
大型语言模型的能力更进一步——谷歌发布可以做定量推理的语言模型!
语言模型在各种自然语言任务上表现出了非凡的性能—事实上,从包括BERT、GPT-3、Gopher和PaLM在内的许多作品中得到的一个一般教训是,以无监督的方式大规模训练各种数据的神经网络可以在各种任务上表现良好。
定量推理是语言模型仍然远远低于人类水平的表现的一个领域。解决数学和科学问题需要结合技能,包括用自然语言和数学符号正确解析问题,回忆相关公式和常数,以及生成涉及数值计算和符号操作的逐步解决方案。由于这些挑战,人们通常认为,使用机器学习解决量化推理问题需要模型体系结构和训练技术的显著进步,允许模型访问Python解释器等外部工具,或者可能进行更深刻的范式转变。
在前几天,谷歌发布了Minerva,一个能够使用逐步推理解决数学和科学问题的语言模型。其表明,通过专注于收集与定量推理问题相关的训练数据,大规模训练模型,并采用一流的推理技术,可以在各种困难的定量推理任务上获得了显著的性能提升。Minerva通过生成包括数值计算和符号操作的解决方案来解决这些问题,而不依赖计算器等外部工具。该模型使用自然语言和数学符号的混合来解析和回答数学问题。Minerva结合了几种技术,包括少镜头提示、思维链或暂存板提示和多数投票,以实现在科学和技术推理任务上的最先进性能。您可以使用我们的交互式示例资源管理器探索Minerva的输出!

为了促进定量推理,Minerva建立在Pathway语言模型(PaLM)的基础上,对arXiv服务器和包含使用LaTeX、MathJax或其他数学排版格式的数学表达式的118GB科学论文数据集进行进一步训练。标准的文本清理过程通常会删除对数学表达式语义意义至关重要的符号和格式。通过在训练数据中维护此信息,模型学习使用标准数学符号进行转换。
Minerva还结合了最近的提示和评估技术,以更好地解决数学问题。这些措施包括思维链或暂存板提示—在提出新问题之前,Minerva会被提示为现有问题提供几个逐步的解决方案—以及多数票。像大多数语言模型一样,Minerva将概率分配给不同的可能输出。在回答问题时,而不是将单一解Minerva分数视为最可能的,而是通过从所有可能的输出中随机采样来生成多个解。这些解决方案是不同的(例如,步骤不相同),但往往得出相同的最终答案。Minerva对这些抽样解决方案使用多数票,将最常见的结果作为最终答案。
模型测试结果
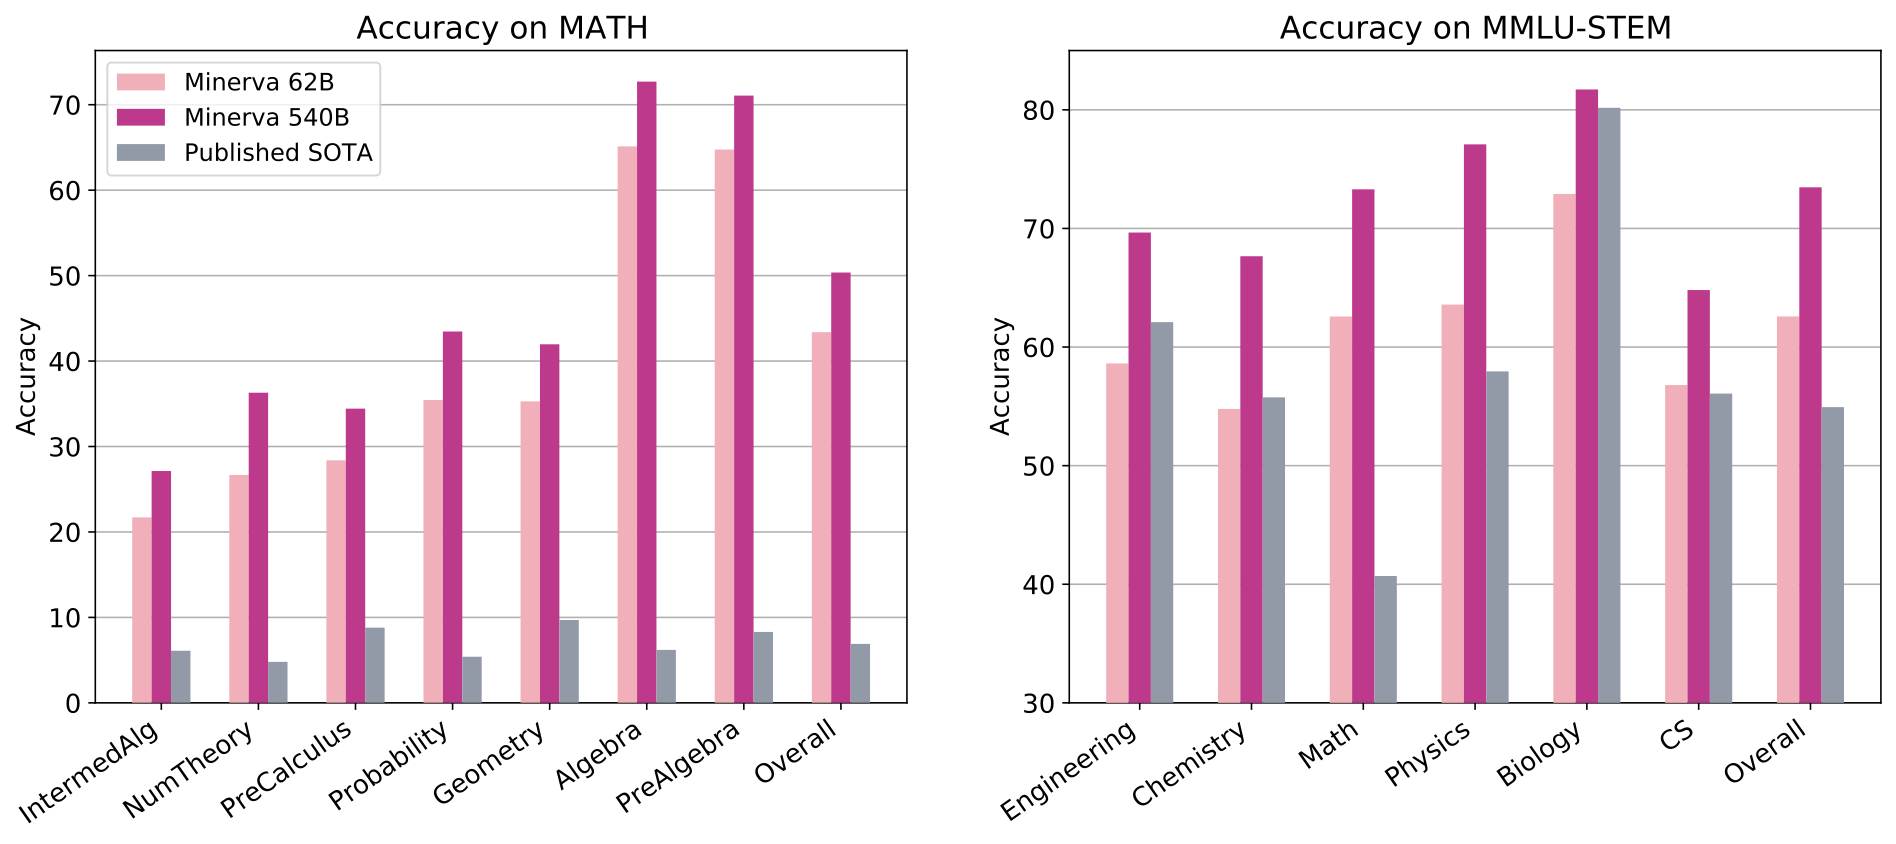
为了测试Minerva的量化推理能力,谷歌根据从小学水平的问题到研究生水平的课程作业的困难程度的科学和技术基准评估了该模型。
- 数学:高中数学竞赛水平问题
- MMLU-STEM:大规模多任务语言理解基准的一个子集,重点是科学和技术,涵盖了高中和大学阶段的工程、化学、数学和物理等主题。
- GSM8k:涉及基本算术运算的小学数学问题,所有这些问题都应该由一个有才华的中学生解决。
此外,谷歌还在OCWCourse上评估了Minerva,这是一个大学和研究生水平的问题集合,涵盖了从麻省理工学院OpenCourseWare收集的各种科学和技术主题,如固态化学、天文学、微分方程和狭义相对论。
在所有情况下,Minerva都获得了最先进的结果,有时比现有模型取得了很大的优势。
DataLearner 官方微信
欢迎关注 DataLearner 官方微信,获得最新 AI 技术推送
