
2026 年本地大模型硬件与模型选型指南:从 8GB 显存到 128GB 内存,怎样配置最划算?
2026 年 10 月更新 | 深度解析 GPU、统一内存、开放权重模型与本地 Agent 选购逻辑
两年前,想在自己的电脑上运行一个性能可靠的本地大语言模型,往往意味着要在“昂贵的硬件成本”、“缓慢的推理速度”和“明显妥协的模型能力”之间做痛苦的取舍。
到了 2026 年,本地 AI 的底层生态已经发生了实质性变化。
在模型端,Qwen、Gemma、OpenAI 等团队持续迭代高效能的开放权重模型。像 Qwen3.5-9B、Gemma 4 12B 以及 gpt-oss-20b 等模型,让普通消费级硬件也有机会在本地跑通具备逻辑推理、代码生成和工具调用能力的实用工作流。在硬件端,选择也不再局限于传统的消费级显卡:除了显存提升至 32GB 的 RTX 5090 和高达 96GB 的专业卡 RTX PRO 6000 Blackwell,Apple M5 Max/Ultra、AMD Ryzen AI Max 系列以及 NVIDIA DGX Spark 提供了另一条技术路线——通过大容量统一内存,让单台桌面设备能够装下参数规模更大的模型。
硬件与模型的组合变多后,开发者在实际采购时反而更容易陷入纠结:
- 16GB 显存现在究竟够不够用?同为 16GB 显存,买 RTX 5080 和 RTX 5060 Ti 实际体验差在哪?
- 128GB 统一内存能不能替代高端 NVIDIA 独立显卡?
- 一个模型“能加载运行”,是否意味着它适合放进日常生产或 Agent 工作流?
这篇文章不追求罗列所有硬件参数,而是帮你建立一套经得起推敲的选型框架。在展开技术细节前,我们先给出一个贯穿全文的核心原则:硬件决定资源上限,模型决定能力基线,而推理框架与上层系统(如 Agent Harness)决定了这些能力能否转化为真实的任务结果。
2026 本地大模型全景选型速查表
对大多数个人开发者而言,16GB 显存是兼顾成本与可用性的实用起点,24GB~32GB 显存是构建主力本地 AI 工作站的核心区间;只有当你明确需要运行 70B、120B 级大模型,或需要为多模型并发预留空间时,才应进一步考虑 大容量统一内存 或 专业级高显存 GPU。
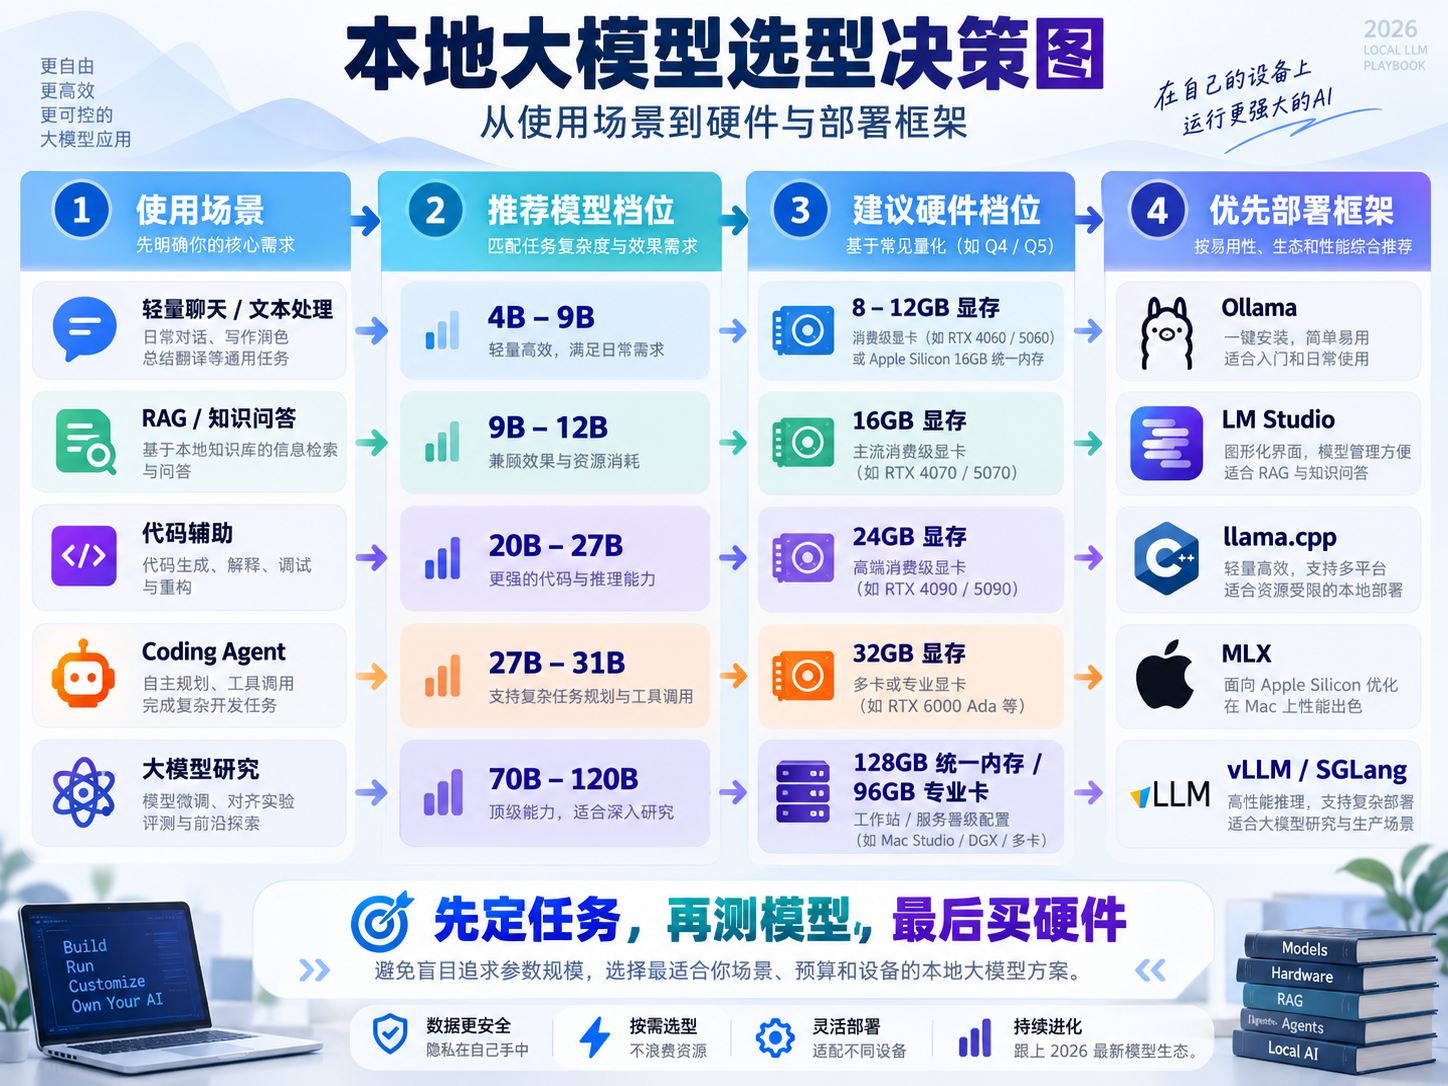
你可以先通过下表对号入座,再按需阅读后文的深度解析(注:以下为配置定位建议,具体表现需结合实际工作负载评测):
一、理解硬件底层逻辑:决定体验的三个核心变量
购买游戏显卡时,我们习惯关注核心数量、功耗和游戏帧率。但运行大语言模型时,硬件面临的负载特征完全不同。要避免花冤枉钱,首先需要理清三个决定本地推理体验的底层变量。
1. 显存容量与 KV Cache:为什么“能加载”不等于“能流畅用”?
运行本地大模型面临的第一个硬性门槛是:模型权重与运行时数据,能否完整放进加速器可直接访问的内存池中?
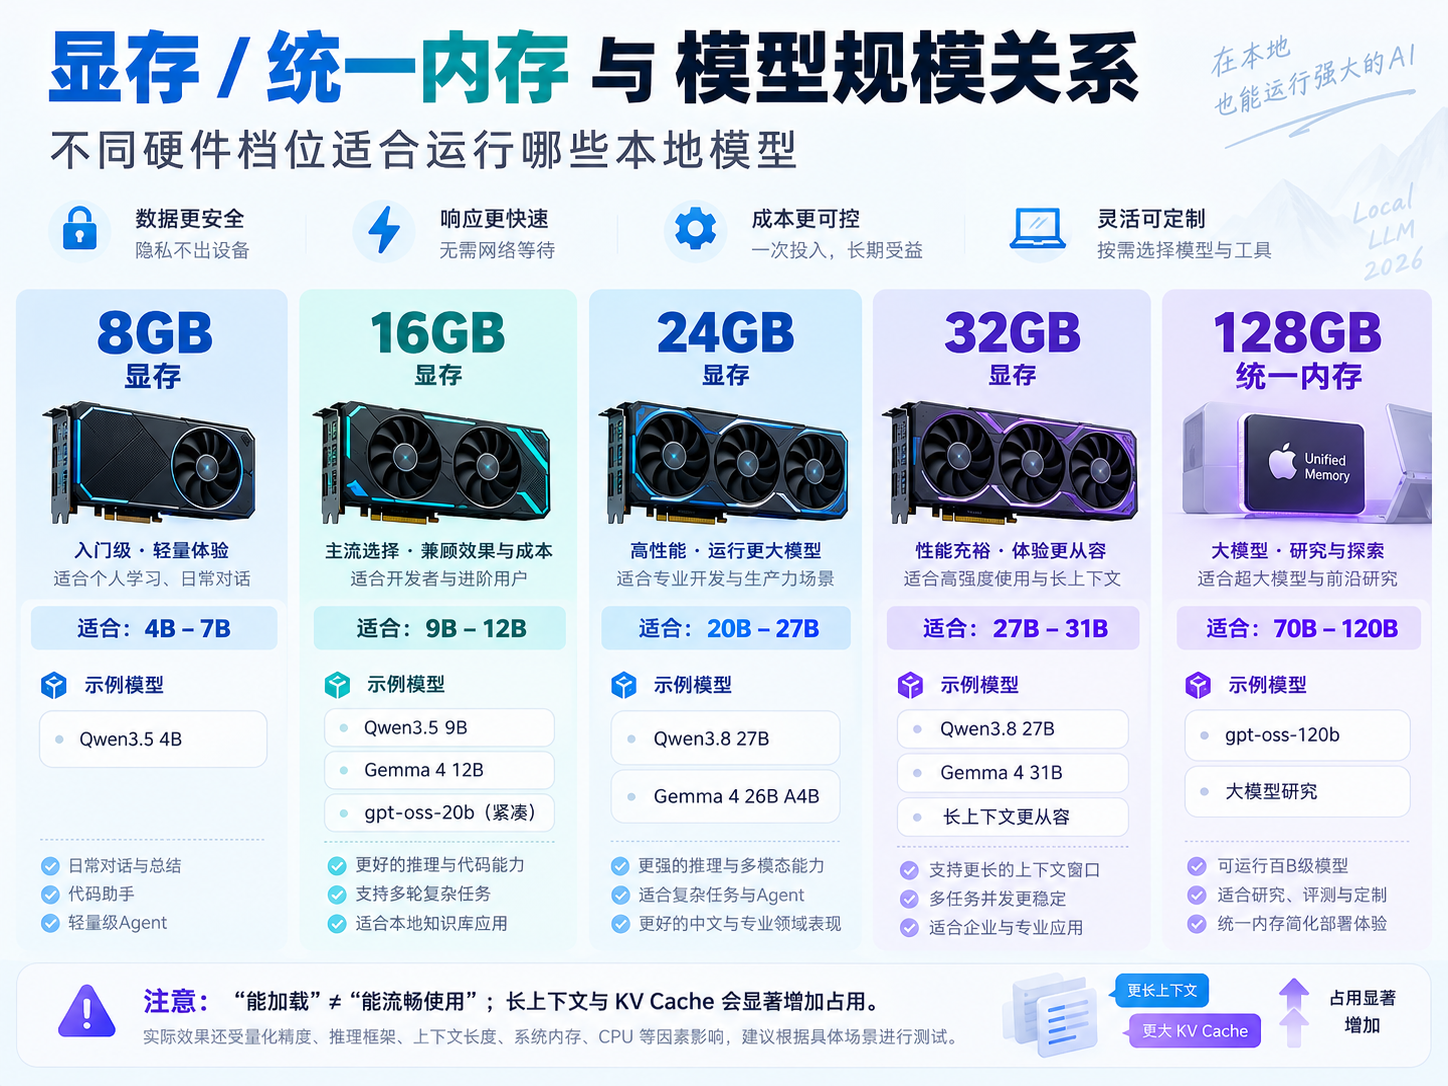
模型名称中的 14B、27B、70B 代表参数规模(以十亿为单位),而非显存占用体积。对于传统的稠密(Dense)模型,可以用一个基础公式估算其理论权重体积:模型权重占用 ≈ 参数量 × 每个参数的字节数。以一个 14B(约 140 亿参数)模型为例:
但理论权重大小绝不等于实际运行所需的显存。在实际部署中,显存还必须容纳量化元数据、部分保留高精度的张量、推理引擎运行时缓冲(Runtime Buffer)、多模态模型的视觉编码器,以及随对话长度动态增长的 KV Cache(键值缓存)。
很多开发者遇到过类似情况:某个模型在 4K~8K 短对话下运行流畅,但一旦输入整篇长文档或将上下文扩展到 64K,显存占用就会显著飙升,甚至触发显存不足(OOM),迫使推理框架将部分计算卸载(Offload)到系统内存和 CPU 上,导致输出速度断崖式下降。
因此,评估硬件容量时必须严格区分三个工程层次:
- 模型可加载:显存仅够装下模型权重与基础运行时开销(仅适合短上下文尝鲜)。
- 模型可流畅运行:在目标上下文长度(如 16K~32K)下,无需借助 CPU 卸载即可保持稳定的生成速度(个人开发者的核心参考线)。
- 模型可稳定提供服务:在多用户并发请求下,依然能维持可接受的响应延迟与吞吐量(团队与企业采购的基准线)。
💡 选型避坑指南 1:模型支持 256K/1M 上下文 ≠ 你的硬件能直接开满。 模型发布的上下文窗口上限仅代表其架构与训练所支持的能力范围。在消费级显卡上,盲目将上下文配置拉满会瞬间耗尽显存。建议根据真实业务需求(如日常问答 8K、代码分析 32K)阶梯式测试显存峰值。
2. GPU 算力 vs 内存带宽:各自决定哪一部分速度?
既然显存容量决定了“能不能跑”,那么 GPU 的计算性能(TFLOPS)和显存带宽(GB/s)又分别决定什么?
在大语言模型推理中,计算过程分为两个特征截然不同的阶段:
- 预填充阶段(Prefill,处理输入提示词):模型需要并行计算用户输入的全部文本(如读取一段长文档或代码库)。在典型的单用户长输入场景下,这一阶段主要受限于 GPU 算力(Compute-bound),算力越强,首 token 延迟(TTFT)通常越短。
- 解码阶段(Decode,逐字生成回答):模型每生成一个新 token,都需要将庞大的模型权重从内存中读取一遍。在单用户或小批量(Low Batch Size)场景下,算力往往处于闲置等待状态,生成速度(token/s)主要受限于 内存带宽(Bandwidth-bound)。
需要严谨指出的是,上述规律并非绝对。实际性能瓶颈还会受到批处理大小(Batch Size)、上下文长度、Prefix Caching(前缀缓存命中率)以及量化算子实现方式的影响——例如当启用长前缀缓存且单次新增输入很短时,Prefill 阶段同样可能表现出内存带宽受限的特征。
我们不妨对比 2026 年几款代表性硬件的容量与理论带宽参数:
从表格中可以清晰看到硬件选型的核心权衡:RTX 5090 拥有 1,792 GB/s 的高带宽,在运行能完整塞进 32GB 显存的模型时,具备极高的解码速度潜力;但面对需要 70GB 以上内存空间的模型时,单张 RTX 5090 无法完整容纳权重,而带宽在 256 GB/s~614 GB/s 区间的 128GB 统一内存设备则能够将其完整加载到内存中运行。
3. 独立显存 vs 统一内存:容量边界在哪里?
许多初次接触本地部署的用户容易产生一个误区:既然模型需要大内存,那我在普通台式机主板上插满 128GB DDR5 系统内存,能不能达到和 128GB 统一内存设备一样的效果?
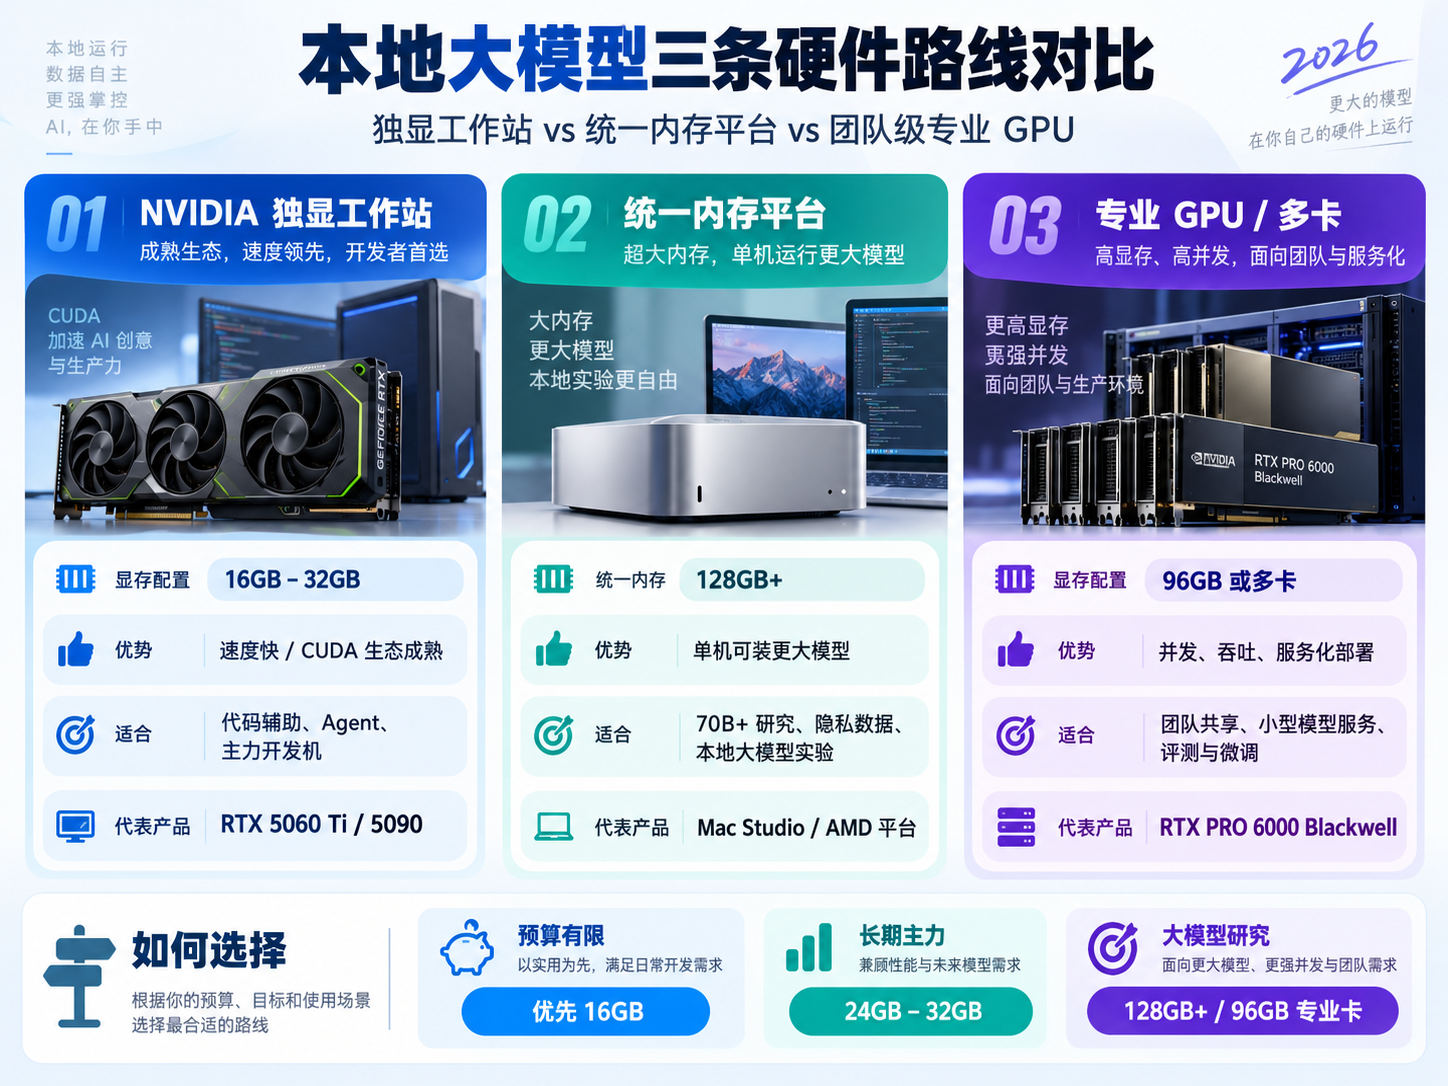
答案是否定的。在传统 PC 架构中,系统内存与独立 GPU 显存是两个物理隔离的内存池,中间隔着带宽有限的 PCIe 总线。一旦模型体积超出独立显存,需要频繁通过系统内存与 CPU 分担计算,推理速度就会大幅下降。
而 Apple Silicon、AMD Ryzen AI Max 以及 NVIDIA DGX Spark 采用的统一内存架构(Unified Memory),允许 CPU 与 GPU 直接访问同一个物理内存池,从而省去了跨总线拷贝的瓶颈。但同样需要注意:128GB 统一内存绝不等于 128GB 可用显存。操作系统、后台服务与推理运行时本身需要占用内存,且不同软硬件平台有着各自的 GPU 内存分配机制(例如 macOS Metal 的工作集上限机制、AMD 平台的 UMA/GTT 显存划分策略、以及 DGX Spark 的系统预留策略)。实际可供模型使用的内存上限,必须结合具体设备、操作系统版本与推理框架进行实测,不能简单按标称容量满打满算。
二、2026 硬件实战选型:四个档位与两难购买决策
与其按显卡售价排列型号,不如按照“能够稳定支撑的模型规模与任务复杂度”来划分硬件档位。
第一档:8GB~12GB 显存——低成本入门与轻量体验
- 代表硬件:RTX 4060 8GB、RTX 5060 8GB、Intel Arc B580 12GB
- 适用人群:手里已有同档位显卡、不打算额外追加硬件预算的尝鲜用户。
在这个档位,8GB 显存主要适合运行 Qwen3.5 4B、Gemma 4 E2B/E4B 等小尺寸模型;如果尝试运行 9B 模型的低精度量化版,显存余量会非常紧张,往往需要严格限制上下文长度。相比之下,12GB 显存拥有更实用的缓冲空间,可以较平稳地运行 9B 或部分 12B 量化模型。这一档硬件非常适合用来熟悉 Ollama 基本操作、搭建个人轻量问答助手,但不建议将其作为复杂代码生成或长上下文智能体的主力平台。
第二档:16GB 显存——个人本地 AI 的实用起点
- 代表硬件:RTX 5060 Ti 16GB、RTX 5070 Ti 16GB、RTX 5080 16GB
- 适用人群:预算相对有限,希望稳定运行日常问答、本地知识库(RAG)及基础工具调用的个人开发者。
16GB 是目前个人本地部署非常关键的分水岭。在这个容量下,Qwen3.5 9B 和 Gemma 4 12B 可以获得充裕的上下文空间,同时你也具备了加载尝试 gpt-oss-20b(Ollama 量化版约 14GB)的条件——不过运行 20B 模型时,留给 KV Cache 的显存余量依然偏紧,仅适合中短上下文任务。对于大多数个人开发者,一张 16GB 显卡配合 32GB~64GB 系统内存和 1TB NVMe SSD,是一套投入产出比很均衡的起步配置。
第三档:24GB~32GB 显存——主力开发者的本地 AI 工作站
- 代表硬件:RTX 3090 24GB、RTX 4090 24GB、RTX 5090 32GB
- 适用人群:高频使用本地模型进行代码编写、复杂推理、长文档分析及 Agent 开发的工程师。
这是个人重度用户最值得重点考量的区间。跨入 24GB~32GB 档位后,你可以正式将 27B~32B 级模型(如 Qwen3.8 27B、Gemma 4 31B、Gemma 4 26B A4B、Qwen3.5 35B A3B)纳入日常工具箱。
这里需要特别注意 24GB 与 32GB 在长上下文场景下的边界差异:以 Ollama 上的 Qwen3.8 27B 为例,其默认量化模型文件约为 18GB。在 24GB 显卡(如 RTX 3090/4090)上,扣除模型权重后剩余约 6GB 空间,应对常规长度的代码补全和对话是顺畅的;但如果开启图文多模态输入(需加载视觉编码器)或运行需要将上下文拉到 32K~64K 以上的复杂 Coding Agent,24GB 显存依然会面临压力。
此时,32GB 显存的 RTX 5090 凭借多出的 8GB 显存余量和更高的 GDDR7 带宽,在长上下文容载力和高负载推理速度上具备明显优势。不过从成本角度看,RTX 5090 属于昂贵的消费级性能旗舰;如果你追求极致的性价比,或者是先搭建第一台验证机,二手市场存量丰富的 RTX 3090 24GB 或已有的 RTX 4090 24GB 配合合理的上下文裁剪,依然是非常务实的高性价比方案。
第四档:128GB 统一内存与 96GB 专业 GPU——百亿大模型研究与团队服务
-
代表硬件:
-
统一内存路线:Apple Mac Studio (M5 Max 128GB / M5 Ultra)、AMD Ryzen AI Max+ 395 128GB、NVIDIA DGX Spark 128GB
-
专业 GPU 路线:NVIDIA RTX PRO 6000 Blackwell 96GB 及多卡服务器
-
适用人群:需要单机运行 70B~120B 级模型的研究人员、注重绝对数据隐私的本地重度用户,以及需要提供内部多用户并发服务的小型团队。
当目标模型来到 70B 稠密模型(4-bit 权重即超过 35GB)或约 65GB 的 gpt-oss-120b 时,单张 32GB 消费级显卡已无法独立承载。此时,统一内存设备与专业大显存 GPU 成为了两条分化明显的路线。
为了帮你在具体的采购纠结中做出决定,我们拆解两个最具代表性的实战对比案例:
🔍 核心选购决策案例 A:同为 16GB 显存,买 RTX 5060 Ti 还是加钱上 RTX 5080?
- 核心矛盾:显存容量完全相同(均为 16GB)的前提下,为更强的 GPU 核心算力与更高的显存带宽支付大几千元的溢价是否划算?
- 决策逻辑:
- 看模型体积上限:两者能塞进显存的最大模型规模是完全一致的。RTX 5060 Ti 16GB 装不下的模型,RTX 5080 16GB 同样装不下。
- 看工作负载特征:如果你只是用来跑 9B~12B 模型的日常对话或轻量知识库,RTX 5060 Ti 16GB 的生成速度已经完全够用,省下的预算用来升级系统内存或大容量 SSD 更实在。只有当你除了跑本地大模型外,还有重度 4K 游戏需求、本地图像/视频生成(Diffusion 类模型对算力极度敏感),或者极其看重长提示词输入下的首字响应速度时,RTX 5080 才值得考虑——但即便预算到了 5080 级别,纯 AI 开发者往往也会优先权衡“是否干脆咬牙加预算上 24GB/32GB 显卡”,因为显存容量的跨代提升通常比同容量下的算力提升更有价值。
🔍 核心选购决策案例 B:跑 gpt-oss-120b 等大模型,买 128GB Mac Studio 还是 96GB RTX PRO 6000?
- 核心矛盾:在单机运行 70B~120B 级大模型时,如何在“整机成本、软件生态、安静易用性与极限推理吞吐”之间做取舍?
- 决策逻辑:
- 预算与物理环境维度:128GB 统一内存的 Mac Studio(或 Ryzen AI Max 迷你工作站、DGX Spark)是一套完整的、低功耗且运行安静的桌面系统,整机购置与维护成本远低于搭建一台搭载 RTX PRO 6000 Blackwell(96GB)的工作站主机。如果只是个人单用户做模型能力对比、离线私有数据处理,能够容忍相对温和的吐字速度,128GB 统一内存设备是门槛更低的选择(其中 Mac 适合熟悉 MLX/llama.cpp 的用户,AMD 适合喜欢折腾 Linux/ROCm 的高性价比玩家,DGX Spark 则适合需要原生 CUDA 软件栈做原型验证的开发者)。
- 推理性能与团队并发维度:RTX PRO 6000 拥有高达 1,792 GB/s 的显存带宽和满血的 Blackwell 架构算力,且完美兼容 vLLM、SGLang、PyTorch 等所有主流 CUDA 加速特性与微调工具链。如果你需要为团队多名工程师提供低延迟的代码助手 API 服务、需要运行高频长上下文 Agent,或者需要进行 LoRA/QLoRA 微调训练,那么统一内存受限的带宽与算力就会成为瓶颈,96GB 专业 GPU 才是面向生产环境的正确投资。
三、2026 重点本地模型选型与量化策略
硬件搭好舞台后,真正决定产出质量的是模型本身。2026 年的开放权重模型已经形成了非常清晰的梯度,选型时不应只看单一公开榜单,而应结合本地资源占用与任务特性进行匹配。
下表整理了当前值得重点测试的代表性模型,并区分了最低可加载显存与推荐长上下文/Agent 显存(注:模型体积参考 2026 年 10 月 Ollama 提供的常见量化版本,未包含运行时额外开销):
在实际业务选型中,建议按以下四个方向构建你的本地测试集:
1. Qwen 系列:中文业务与本地 Agent 的核心基座
Qwen 家族的优势在于尺寸梯度完整且中文与代码生态极其扎实。12GB~16GB 显存用户可以直接以 Qwen3.5 9B 作为基准线;而在 24GB~32GB 硬件上,Qwen3.8 27B 是目前非常值得优先评测的主力模型——它不仅支持文本与图像多模态输入,还针对代码仓库理解、结构化 JSON 输出和工具调用做了专项强化。在选型评测时,建议用你所在行业的真实业务术语、复杂指令遵循和长链路工具调用成功率来重点考核它。
2. Gemma 4 系列:稠密与 MoE 并行的多语言方案
Google 的 Gemma 4 提供了从端侧 E2B/E4B 到 12B、26B A4B 和 31B 的完整矩阵。其中 Gemma 4 26B A4B 采用了混合专家(MoE)架构,虽然部署时仍需为全部专家权重分配 24GB 以上的内存空间,但由于每次推理仅激活约 4B 参数,有潜力以更低的激活计算量换取较高的推理效率(注:由于仍存在注意力计算、专家路由与内存访问开销,MoE 模型的实际生成速度并不直接等同于 4B 稠密模型,需结合具体框架实测)。
此外,针对开发者普遍关心的“量化是否会导致模型能力下降”的问题,Google 为 Gemma 4 提供了专门的 QAT(量化感知训练) 版本。
💡 选型避坑指南 2:理性看待 4-bit 与 8-bit 量化,用任务成功率说话。 量化对模型能力的影响不能一概而论:它取决于模型是否做过 QAT 优化、具体的量化算法(如 AWQ、GGUF K-quants 等)以及任务类型。在日常闲聊与摘要中,4-bit 量化往往难以察觉差异;但在严密的代码生成与多步逻辑推理中,部分后训练量化(PTQ)模型可能出现指令遵循能力波动。建议在显存允许的范围内,对比测试同一模型的不同量化精度与 QAT 版本,以实际任务通过率作为最终取舍依据。
3. gpt-oss 系列:可调节推理强度的推理与 Agent 利器
OpenAI 发布的开放权重模型 gpt-oss-20b 与 gpt-oss-120b 专为推理任务与工具调用设计,并支持在接口层配置不同的推理强度(Reasoning Effort)。其中 20B 版本让消费级显卡用户也能在本地跑通深度思考工作流。
在评估这类推理模型时,需要重点关注推理 token 带来的延迟与资源成本:模型在给出最终答案前,会生成一段用于自我推演的推理 token(在支持该特性的 API 或 Ollama 接口中可单独读取,部分前端界面可能会默认折叠或隐藏)。当把推理强度调高时,单次任务生成的总 token 数量会显著增加,即便每秒生成速度正常,端到端的任务等待时间也会相应拉长。
4. DeepSeek V4.1 Flash 与 GLM-5.3 Flash:认清超大 MoE 的硬件边界
2026 年的开源生态中,以 GLM-5.3 Flash(总参数量约 320B,每次推理激活约 18B)和 DeepSeek V4.1 Flash 为代表的大型 MoE 模型展现了极高的技术水准。但很多个人开发者容易被名称中的“Flash”或“18B 激活参数”误导,试图将其部署在单张家用显卡上。
必须再次明确:总参数量决定了权重存储的物理体积下限,而激活参数量仅决定单次前向计算的工作量。未激活的专家权重依然需要驻留在内存中随时待命,动辄数百 GB 的体积远超单张 24GB/32GB 显卡的承载能力。对于这类超大规模 MoE 模型,最合理的策略是直接通过官方或第三方云端 API 验证业务价值,只有当数据合规要求极其严苛且预算充足时,才去评估多卡服务器或超大容量统一内存集群的本地部署方案。
四、软件栈与任务分层:从日常问答到本地 Coding Agent
选定硬件和模型后,推理框架与上层应用架构决定了硬件性能能发挥出几成。
1. 推理框架怎么选?
不同工具的定位非常清晰,按使用阶段选择即可:
💡 选型避坑指南 3:使用 Ollama 时,注意甄别本地模型与
:cloud标签。 如果你是因为严格的数据隐私合规要求而采用本地部署,在使用 Ollama 或各类桌面客户端时,请务必确认所运行的模型为纯本地权重。若拉取了带有:cloud标记的模型或配置了远端转发网关,实际计算仍会在云端服务器进行。涉密环境下建议配合本地防火墙策略进行核验。
2. 区分三个任务层次:别让 Coding Agent 绑架所有硬件预算
在 2026 年,本地 Coding Agent(代码智能体)是最受关注的应用方向,但并非所有人都需要按照 Agent 的最高标准去采购硬件。我们可以将本地 AI 的真实需求划分为三个层次:
- 第一层:日常问答与轻量级 RAG(知识库检索) 系统先通过向量检索找到相关文档片段,再交由模型总结回答。这类任务路径短、容错率高,12GB~16GB 显存运行 9B~12B 模型往往就能取得令人满意的效果,无需盲目追求大显存。
- 第二层:单次代码生成与长文档分析 例如在 IDE 中选中几百行代码要求重构,或一次性总结数万字的 PDF 报告。这类任务对模型的指令遵循能力和 Prefill 算力有一定要求,但属于单轮或少轮交互,16GB~24GB 显存配合 12B~27B 模型即可稳健应对。
- 第三层:自主执行多步骤任务的 Coding Agent 这是对本地硬件和模型考验最严苛的场景。一个完整的 Coding Agent 需要自主读取项目结构、调用命令行工具、分析编译报错、修改多处代码并运行测试闭环。
为什么哪怕只用 27B 模型,跑 Coding Agent 时的资源消耗也远高于普通聊天?原因有三点:
- 上下文快速累积:代码片段、文件目录树、多轮工具调用返回的日志会迅速堆满上下文窗口,使显存峰值显著升高。
- 工具调用的连锁反应:Agent 高度依赖结构化输出与工具参数生成的准确性。中间某一步工具调用格式出错,就会导致后续重试循环,浪费大量推理时间。
- 最终体验取决于“单任务总完成时间”与 Agent Harness 适配度:评价本地 Agent 不能只看每秒吐出多少个 token。如果模型 A 生成速度极快,但因为逻辑能力不足或与当前 Agent 框架(Harness)的提示词模板适配不佳,改一个 Bug 需要反复重试五六次;而模型 B 生成速度稍慢,却能一次性精准调用工具通过测试,那么模型 B 的实际工程效率反而高得多。
因此,如果你计划将本地硬件重度用于 Coding Agent,建议以 24GB~32GB 显存为基准,优先评测 Qwen3.8 27B、Gemma 4 31B 或 gpt-oss-20b 在你常用 Agent 框架(如 Claude Code 本地后端、Cline、Aider 等)下的真实任务成功率,而不必一开始就盲目追求运行缓慢的百亿参数大模型。
五、结语:本地部署 vs 云端 API 的成本账与采购闭环
回到文章最初的问题:2026 年,怎样配置本地大模型最划算?
在真正下单购买硬件之前,最划算的第一步其实是算清楚 “买硬件本地跑”与“直接调云端 API”的经济账:
- 什么时候调用云端 API 更划算? 如果你的日均调用量不高、经常需要切换体验 DeepSeek V4.1、GLM-5.3 等数百亿参数的顶尖大模型,且业务数据脱敏后无合规障碍,那么按量付费的云端 API 无论在响应速度还是模型智商上限上,性价比都远高于自己掏几万元买显卡。
- 什么时候本地硬件投资能够回本? 当你面临严格的私有代码与商业数据不出域要求、拥有高频且固定的自动化工作负载(例如每天高强度运行本地 RAG 批处理、自动化数据清洗、全天候挂机评测或团队高频内部辅助),或者需要完全可控的离线环境时,一台配置合理的本地工作站才能真正发挥出长期成本优势。
由于开源模型与推理框架几乎按月迭代,任何静态的硬件推荐名单都会随时间演进。为了确保你的硬件投资不踩坑,建议在采购前严格走完以下 四步实测闭环:
- 定义真实工作负载与上下文基线:明确你 80% 的时间是在做中文问答、写代码,还是跑多步 Agent,并估算常规状态下的上下文长度(如 8K、32K 还是 64K)。
- 先借用算力盲测 3~5 个跨家族候选模型:在购买硬件前,先通过云端 GPU 实例或现有设备,用你手头真实的业务数据和代码库,横向测试 Qwen3.8、Gemma 4 和 gpt-oss 等不同家族模型的实际任务成功率,不要仅凭公开 Benchmark 分数做决定。
- 测定显存峰值与可接受的延迟底线:记录下能够稳定完成任务的最小模型参数量、量化精度、运行时显存峰值以及首字延迟(TTFT),以此倒推你需要 16GB、24GB、32GB 显存还是 128GB 统一内存。
- 核算整机与长期持有成本:除了显卡或主机本身的价格,将电源、机箱散热、噪音容忍度、设备折旧以及电费一并纳入考量。
最值得购买的本地 AI 硬件,从来不是参数表上最昂贵、能塞下最大模型的那一台,而是刚好能以合理的综合成本,每天稳定、安静地帮你把核心任务跑通的那套配置。
参考资料与持续更新说明:本文涉及的硬件规格(NVIDIA GeForce RTX 50 系列、RTX PRO 6000 Blackwell、NVIDIA DGX Spark、Apple Mac Studio M5 Max/Ultra、AMD Ryzen AI Max+ 395)、模型参数与量化体积(Qwen3.5/3.8、Gemma 4、OpenAI gpt-oss、DeepSeek V4.1 Flash、GLM-5.3 Flash)以及推理框架特性(Ollama、llama.cpp、MLX、vLLM、SGLang),均基于 2026 年 10 月主流公开技术文档与模型库整理。本文中的模型体积与显存档位属于特定量化版本下的选型参考,实际采购前请结合最新模型适配动态与目标业务负载进行实测验证。
DataLearner 官方微信
欢迎关注 DataLearner 官方微信,获得最新 AI 技术推送
