
Gemini Embedding 001
承诺至少可用至 2028-05-14embedding模型Gemini EmbeddingGemini Embedding (gemini-embedding-001) is Google's text embedding model, generally available through the Gemini API and Vertex AI from July 14, 2025 after an experimental release in March. It supports more than 100 languages, inputs of up to 2,048 tokens and output dimensions up to 3,072 with Matryoshka truncation, and led the MTEB multilingual leaderboard at launch.
数据优先来自官方发布(GitHub、Hugging Face、论文),其次为评测基准官方结果,最后为第三方评测机构数据。 了解数据收集方法
模型基本信息
开源和体验地址
官方介绍与博客
API接口信息
表中「—」表示该模态在此方向不计费,或供应商未公开对应价格。
评测结果
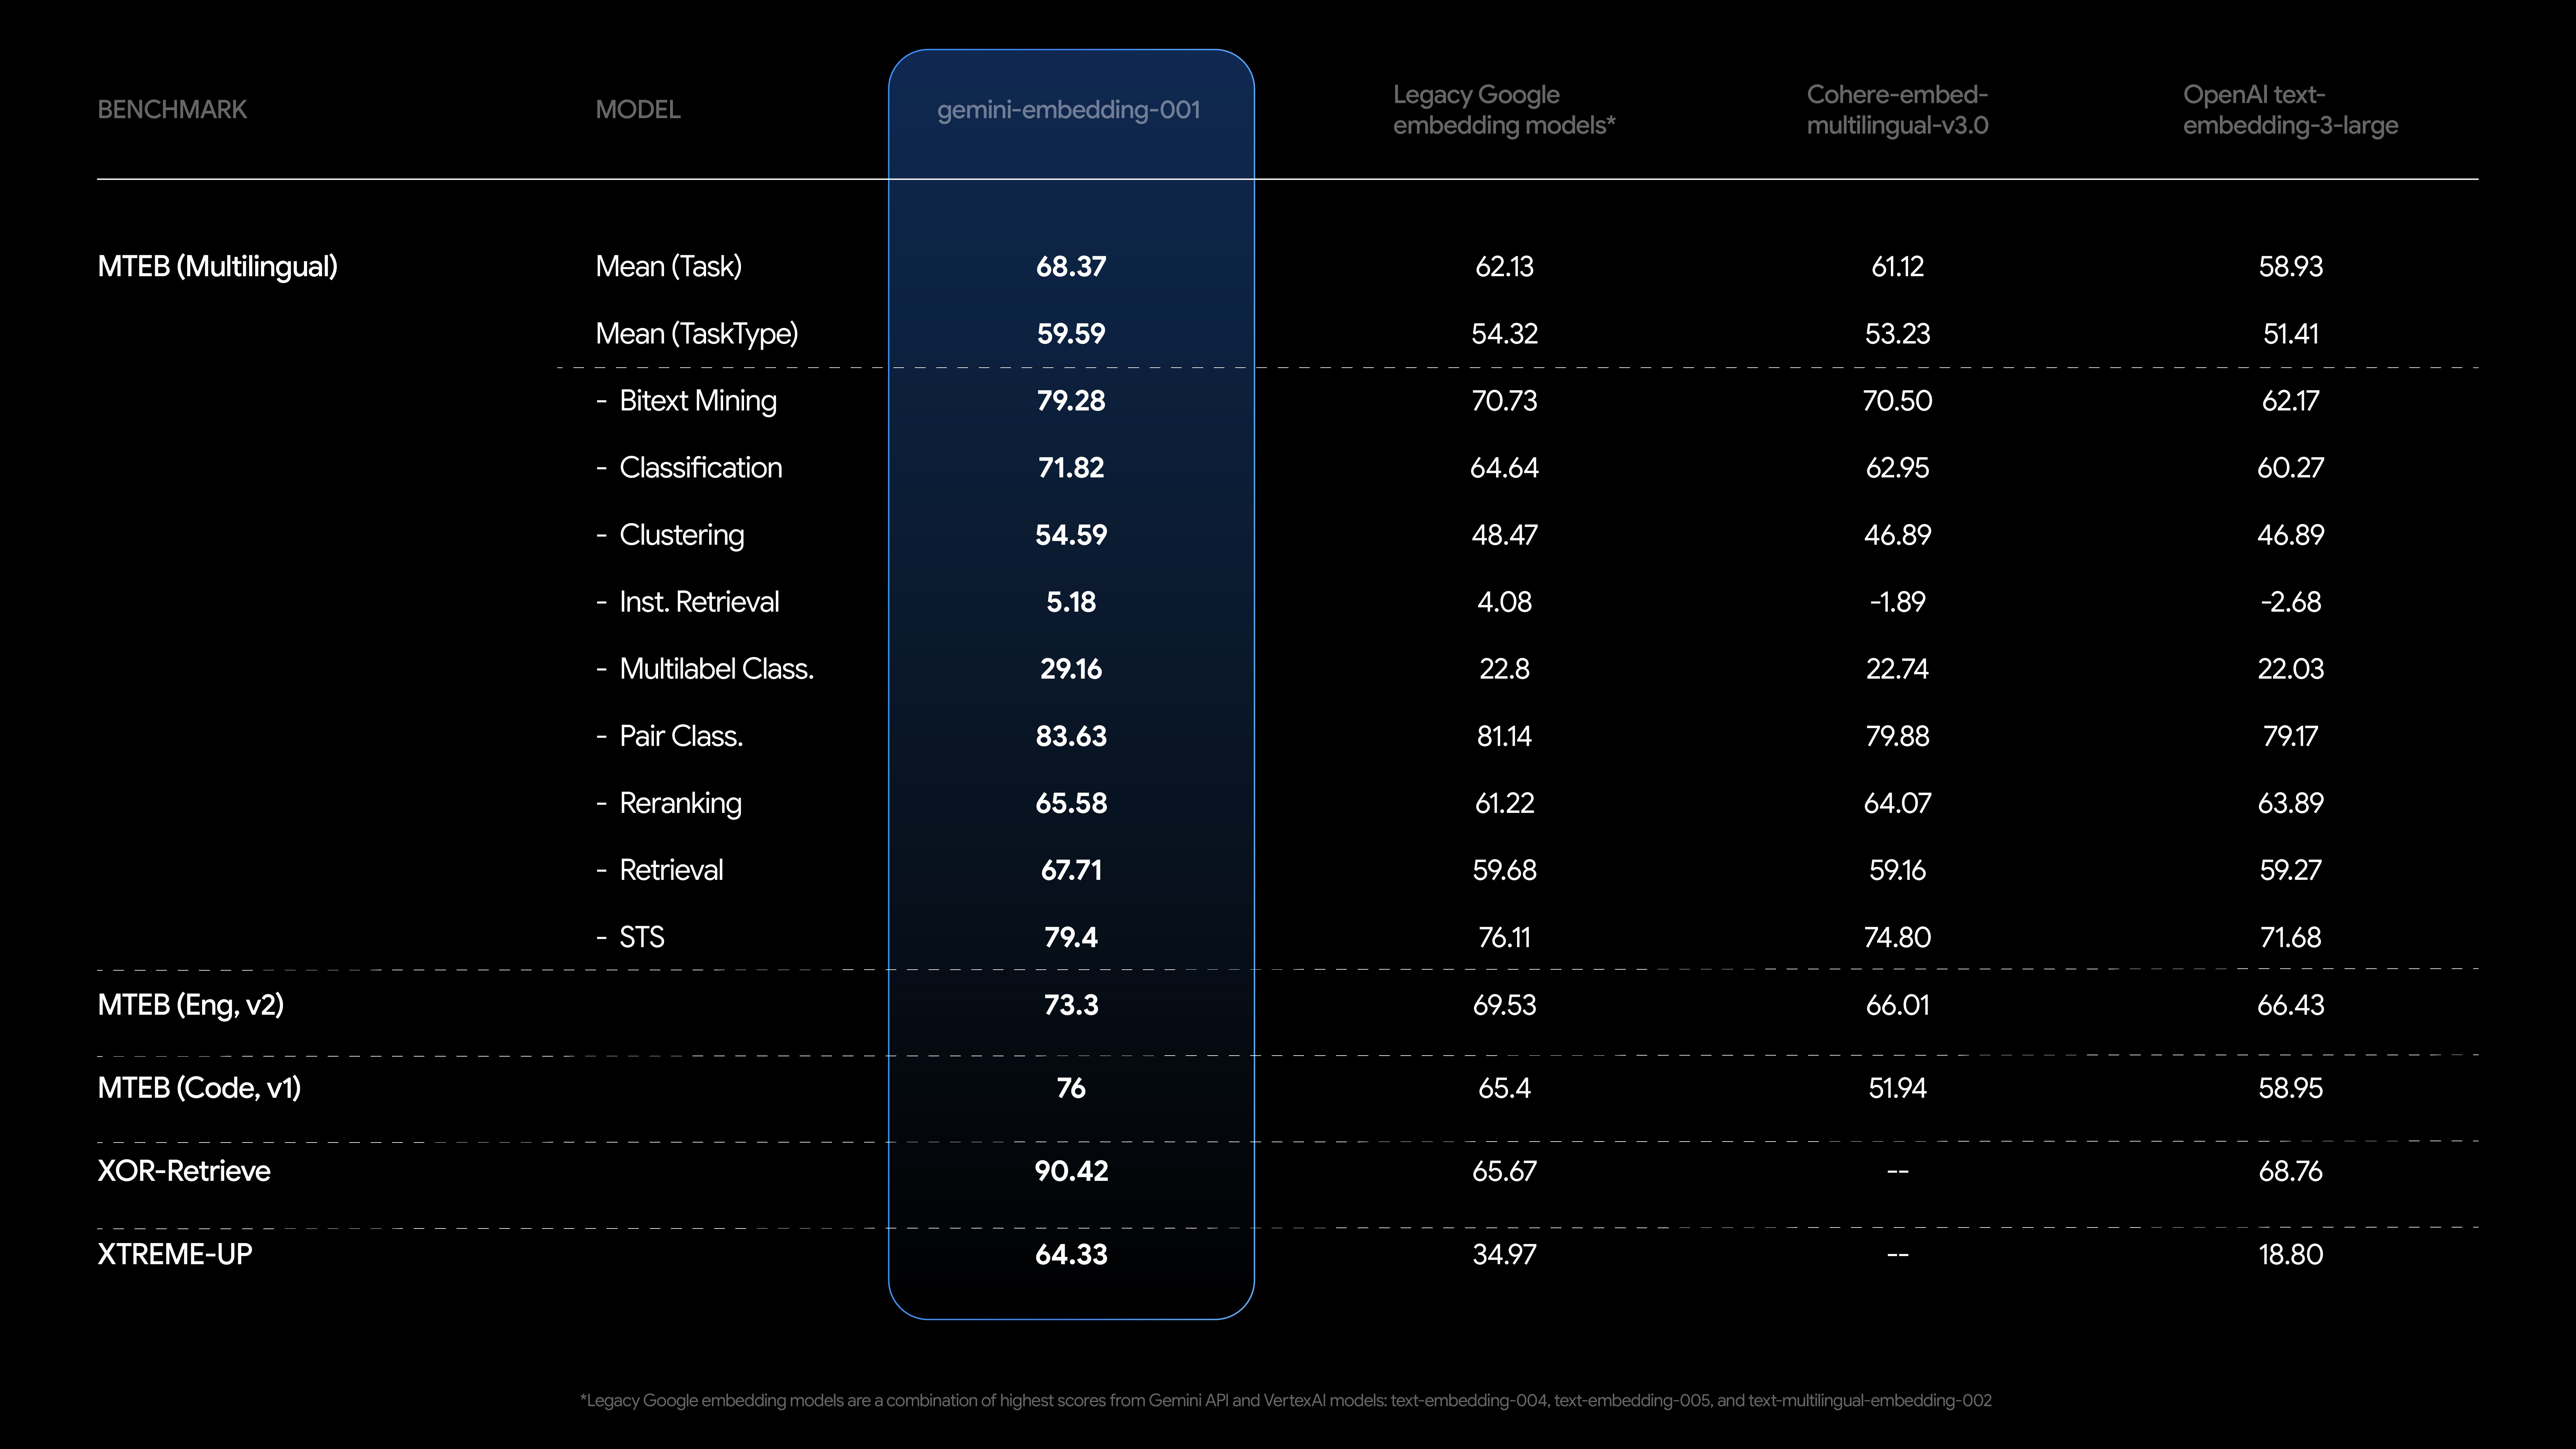
Gemini Embedding 001 当前已收录的代表性评测结果包括 MTEB English v2(3 / 11,得分 73.30)、MTEB Multilingual v2(4 / 9,得分 68.37)、MTEB(3 / 5,得分 68.37)。 本页还汇总了参数规模、上下文长度与 API 价格,便于结合评测结果与部署约束一起判断模型适配度。
发布机构
模型解读
Gemini-Embedding 是谷歌发布的先进向量大模型,现已通过 Gemini API 和 Vertex AI 正式向开发者开放。
模型概述
Gemini-Embedding(gemini-embedding-001)是一个高性能的文本嵌入模型,旨在为多语言、多领域的任务提供强大的语义表示能力。自 2025 年 3 月实验性发布以来,该模型在 MTEB(Massive Text Embedding Benchmark)多语言排行榜 上持续领先,超越谷歌此前发布的文本嵌入模型(如 text-embedding-004、text-embedding-005 和 text-multilingual-embedding-002)以及其他商业模型。
核心能力
- 多语言支持:支持 100+ 种语言,适用于全球化的 NLP 任务,如跨语言检索、分类和聚类。
- 输入长度:最大支持 2048 个 token,适用于长文本嵌入需求。
- 输出维度灵活调整:采用 Matryoshka Representation Learning (MRL) 技术,允许开发者动态调整输出维度(默认 3072,可降至 1536 或 768),以优化存储和计算成本,同时保持高精度。
- 跨领域优化:在科学、法律、金融、编程等多个领域表现优异,适用于检索增强生成(RAG)、语义搜索、推荐系统、聚类分析等任务。
性能与基准测试
- 在 MTEB 基准测试中,Gemini-Embedding 在多语言和单语言任务上均表现卓越,特别是在检索(Retrieval)和分类(Classification)任务中显著优于竞品。
- 谷歌官方技术报告提供了更详细的性能对比数据。
API 访问与定价
- 免费试用:开发者可通过 Google AI Studio 免费体验 Gemini-Embedding。
- 生产级定价:$0.15 / 100 万输入 token,适合大规模应用。提供更高的速率限制,满足企业级需求。
迁移与兼容性
- 旧版模型(如 gemini-embedding-exp-03-07、embedding-001 和 text-embedding-004)将于 2025 年 8 月至 2026 年 1 月 逐步淘汰,建议开发者尽早迁移至 gemini-embedding-001。
- 兼容现有 embed_content API 接口,迁移成本低。
未来更新
谷歌计划推出 Batch API 支持,允许异步处理大规模数据,进一步降低成本。此外,未来可能扩展至多模态嵌入(如图像、音频等)。
DataLearner 官方微信
欢迎关注 DataLearner 官方微信,获得最新 AI 技术推送
