DataLearner logo
Original Blog

Original AI Tech Blogs

Explore the latest AI and LLM news and technical articles, covering original content and practical cases in machine learning, deep learning, and natural language processing.

重磅!百度文心一言开源,包含2个多模态大模型,4个大语言模型,最大参数量4240亿!完全免费商用授权!

重磅!百度文心一言开源,包含2个多模态大模型,4个大语言模型,最大参数量4240亿!完全免费商用授权!

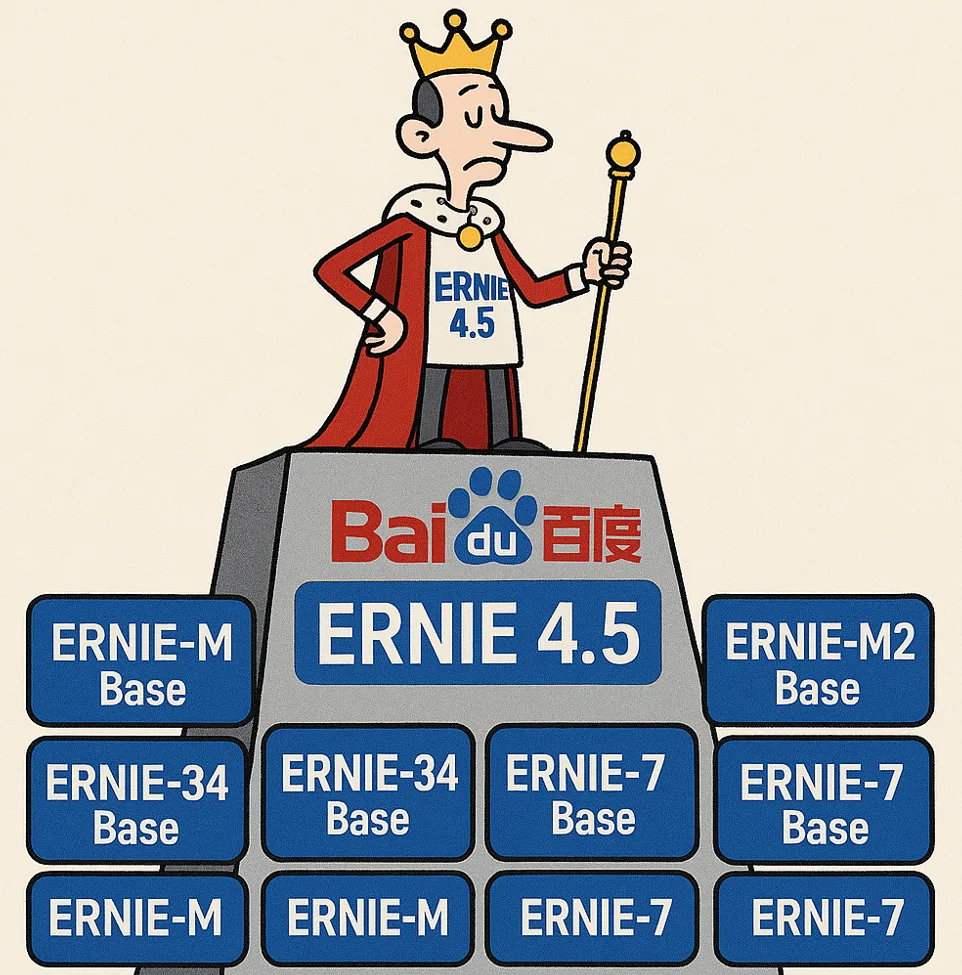
今天,百度正式宣布开源其最新的旗舰级大模型系列——ERNIE 4.5。ERNIE 4.5系列模型当前包含2个多模态大模型,4个大语言模型及其不同变体的庞大家族,还区分了PyTorch版本和paddlepaddle版本,共23个模型,其核心采用了创新的异构多模态混合专家(MoE)架构,在提升多模态理解能力的同时,实现了文本处理性能的同步增强。每个版本的模型都开源了基座(Base)版本和后训练版本(不带Base)。

2025/06/30 13:44:471,016
DeepSeekAI开源全新的DeepSeek-OCR模型:参数规模仅30亿的MoE大模型,图像文本结构化提取成本下降十倍!准确率超过Qwen2.5-VL-7B

DeepSeekAI开源全新的DeepSeek-OCR模型:参数规模仅30亿的MoE大模型,图像文本结构化提取成本下降十倍!准确率超过Qwen2.5-VL-7B

DeepSeek AI团队重磅推出DeepSeek-OCR,该模型不仅在文档提取上达到了行业领先水平,更通过创新的视觉压缩技术,将长上下文处理效率提升了 10 倍以上。根据测算,在A100-40G的一个GPU上,它每天可以将20万页的文档图像数据转为Markdown文本!

2025/10/20 20:47:35999
自己制作电影不是梦,视频生成大模型的巨大进步!OpenAI发布第二代视频生成大模型Sora2:物理规律符合率达到88%,可以同步生成音频!物理真实感与声音控制全面突破

自己制作电影不是梦,视频生成大模型的巨大进步!OpenAI发布第二代视频生成大模型Sora2:物理规律符合率达到88%,可以同步生成音频!物理真实感与声音控制全面突破

就在今日,OpenAI正式推出了 Sora 2 ——其旗舰级视频与音频生成模型。相比2024年2月发布的初代 Sora,本次升级带来了断层级的真实感与显著增强的可控性。它不仅能更好地遵循物理规律生成视频,还首次实现了同步对话与环境音效的生成,并通过全新 iOS 应用“Sora”开放给公众使用。

2025/10/01 15:17:59997
Tool Decathlon:大模型工具使用能力基准测试

Tool Decathlon:大模型工具使用能力基准测试

Tool Decathlon(简称 Toolathlon)是一个针对语言代理的基准测试框架,用于评估大模型在真实环境中使用工具执行复杂任务的能力。该基准涵盖32个软件应用和604个工具,包括日常工具如 Google Calendar 和 Notion,以及专业工具如 WooCommerce、Kubernetes 和 BigQuery。它包含108个任务,每个任务平均需要约20次工具交互。该框架于2025年10月发布,旨在填补现有评测在工具多样性和长序列执行方面的空白。通过执行式评估,该基准提供可靠的性能指

华为开源2个Pangu大模型:分别是MoE架构,720亿总参数,160亿激活参数的Pangu Pro MoE以及Pangu Embedded,评测结果略超同级别的Qwen3

华为开源2个Pangu大模型:分别是MoE架构,720亿总参数,160亿激活参数的Pangu Pro MoE以及Pangu Embedded,评测结果略超同级别的Qwen3

盘古大模型是华为自研的大语言模型,基于华为的硬件和技术栈进行训练。此前一直被认为是国产技术占比很高的国产大模型。今天,华为开源了2个盘古大模型,分别是MoE架构的Pangu Pro MoE模型以及70亿参数规模的Pangu Embedded模型。

2025/07/01 07:36:33990
阿里开源推理大模型QwQ-32B-Preview:开源领域对OpenAI o1模型奋起直追,能力接近o1-mini,超过GPT-4o!

阿里开源推理大模型QwQ-32B-Preview:开源领域对OpenAI o1模型奋起直追,能力接近o1-mini,超过GPT-4o!

随着OpenAI发布推理大模型o1,专注于推理能力的大模型开始被广泛关注。基于思维链探索的推理大模型也不断涌现。此前,DeepSeekAI与上海人工智能实验室都发布过推理大模型,也展现了很不错的推理能力,虽然DeepSeekAI官方承诺该模型会开源,但是目前还没有发布。今天,阿里开源了一个全新的推理大模型QwQ-32B-Preview,其推理能力在评测结果上超过o1-mini,是目前开源领域最强的推理大模型(也可能是目前唯一)。

2024/11/28 13:40:41989
Moonshot AI 发布 Kimi K2 Thinking:连续执行200-300次顺序工具调用,人类最后难题评测得分超过所有模型,全球第一!依然免费开源商用!

Moonshot AI 发布 Kimi K2 Thinking:连续执行200-300次顺序工具调用,人类最后难题评测得分超过所有模型,全球第一!依然免费开源商用!

就在今日,Moonshot AI 正式推出 Kimi K2 Thinking,这款开源思考代理模型以其革命性的工具集成和长程推理能力,瞬间点燃了开发者社区的热情。Kimi K2能自主执行200-300次连续工具调用,跨越数百步推理,解决PhD级数学难题或实时网络谜题。本次发布的Kimi K2不仅仅是模型升级,更是AI Agent能力的扩展。

2025/11/07 09:06:48989
Anthropic发布Claude Haiku 4.5:一个不可忽视的低成本模型,1/3的价格,1.5倍的速度,但是有Claude Sonnet 4的水平!

Anthropic发布Claude Haiku 4.5:一个不可忽视的低成本模型,1/3的价格,1.5倍的速度,但是有Claude Sonnet 4的水平!

Anthropic正式发布最新一代入门级模型Claude Haiku 4.5。相较上一代小模型,Haiku 4.5 在编码、推理与“计算机使用/子代理编排”等关键生产力场景上实现逼近甚至局部追平 Sonnet 4,但价格更低、速度更快,定位于“面向规模化落地的高性价比主力”。

2025/10/19 22:15:00982
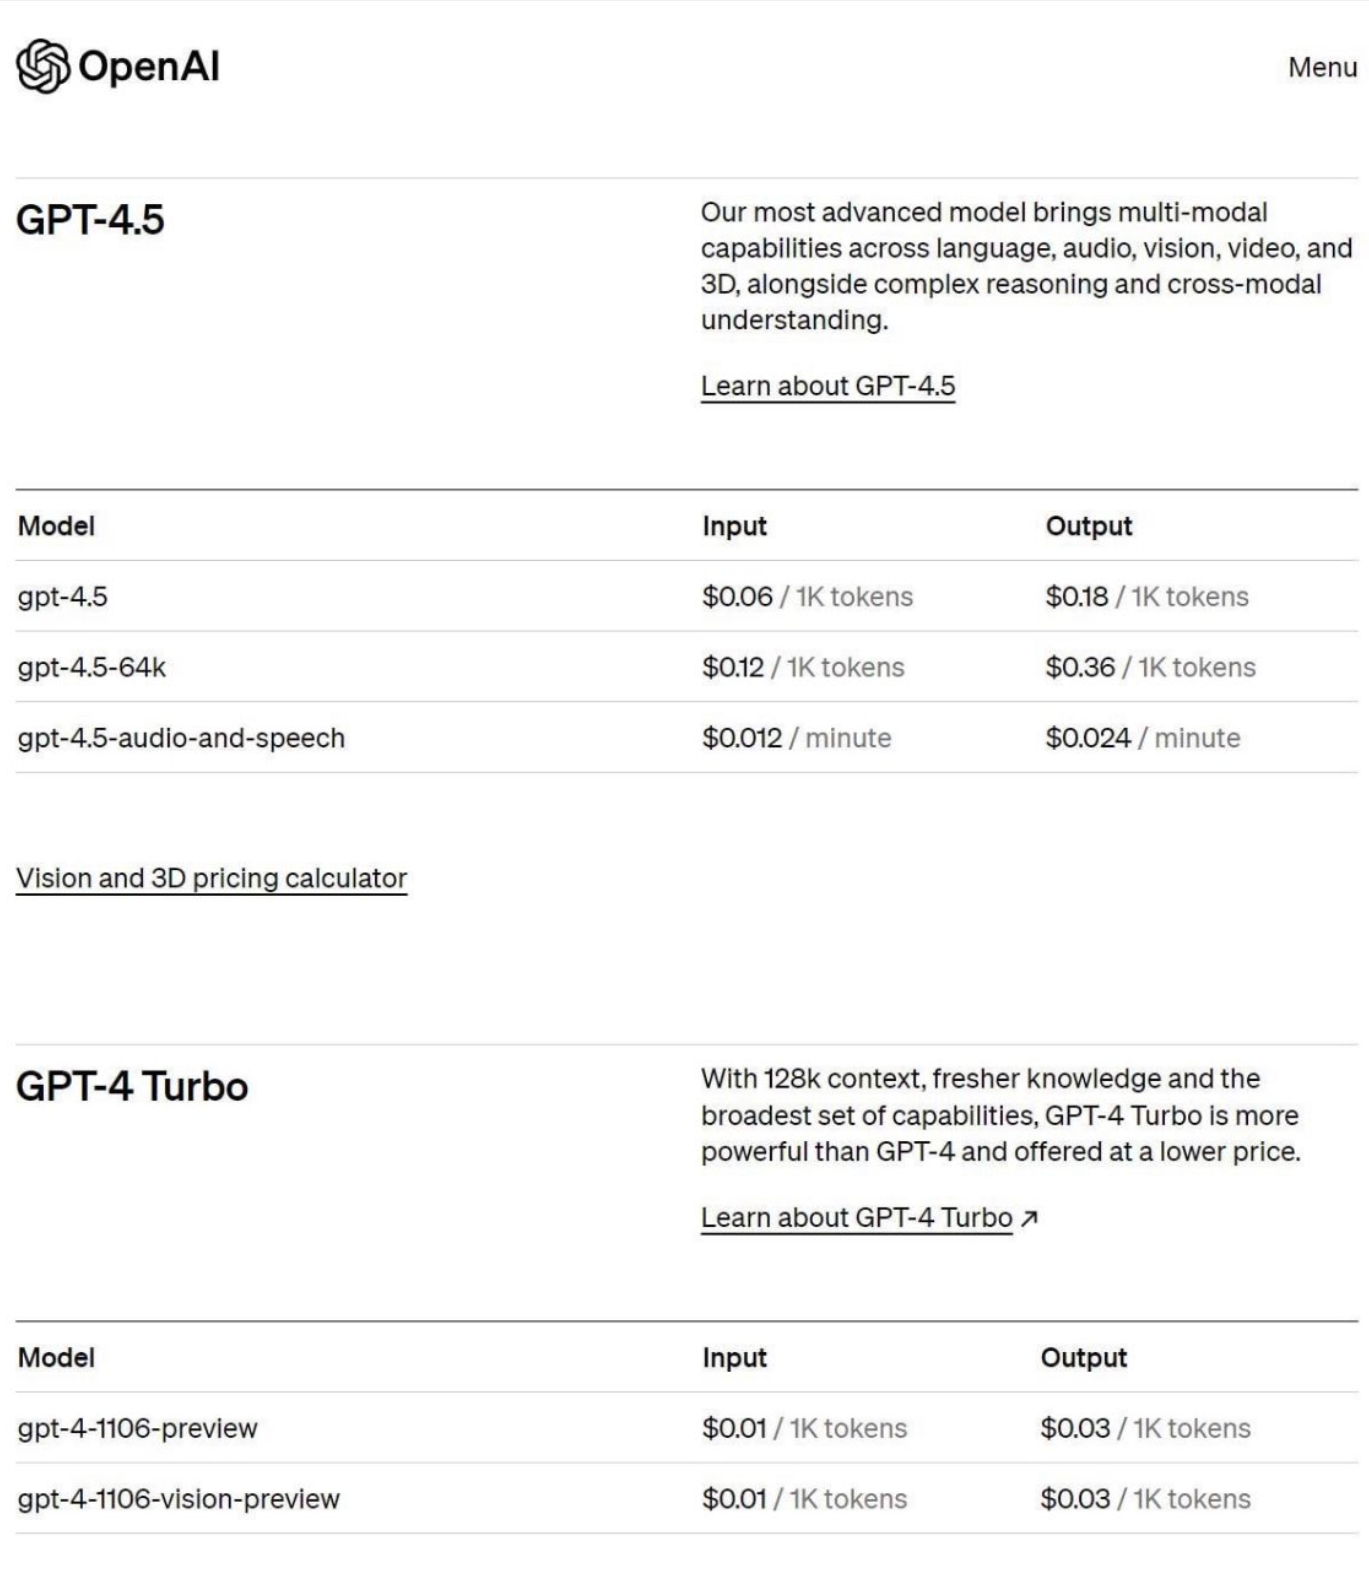
GPT-4.5:技术细节与用户反馈

GPT-4.5:技术细节与用户反馈

OpenAI 于 2025 年 2 月 27 日发布了 GPT-4.5,作为其语言模型系列的最新版本。尽管具体的技术细节因商业保密而未完全公开,基于现有信息和合理推测,DataLearner提供更具体的数据和分析,同时补充更多来自用户的评价。

2025/03/02 13:07:30973
大模型速度、效果与价格的完美结合?xAI发布Grok 4 Fast:性能接近Grok 4,成本降 98%,生成速度翻倍!

大模型速度、效果与价格的完美结合?xAI发布Grok 4 Fast:性能接近Grok 4,成本降 98%,生成速度翻倍!

xAI 正式发布 Grok 4 Fast —— 一款以 极致性价比与前沿性能 为核心卖点的新一代推理模型。相比前代产品,它不仅在推理准确率上几乎与旗舰模型Grok 4等持平,还凭借 40%更高的推理效率 和 高达98%的成本降低,将高质量智能推理真正带入大众用户和企业应用场景。

2025/09/21 21:09:22971
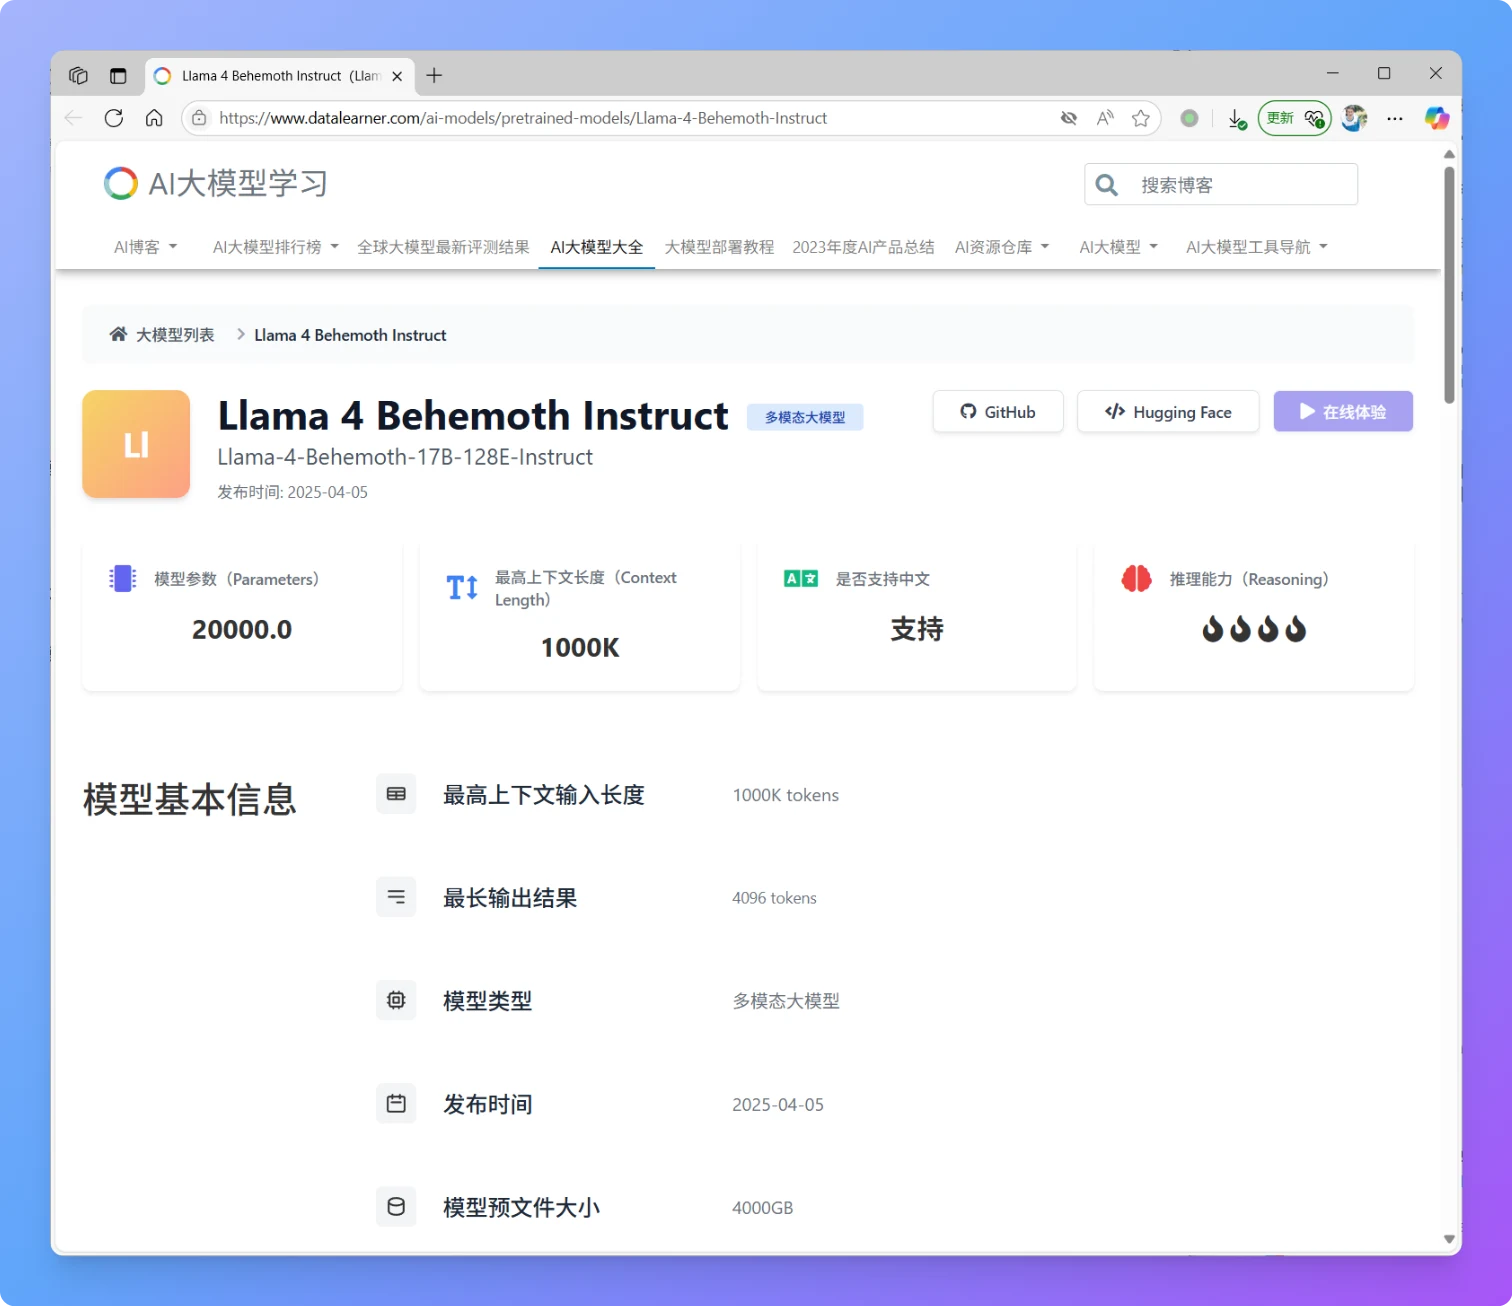
重磅!MetaAI开源Llama4系列,全面进入MoE架构时代,本次发布Llama4 Scout和Llama4 Maverick,1000万上下文输入,170亿激活参数,不支持中文!

重磅!MetaAI开源Llama4系列,全面进入MoE架构时代,本次发布Llama4 Scout和Llama4 Maverick,1000万上下文输入,170亿激活参数,不支持中文!

就在刚刚,MetaAI发布了全新一代Llama4大模型,Llama正式进入多模态和MoE架构时代。本次新发布的是Llama4中的2个模型分别是Llama4 Scout和Llama4 Maverick。这两个模型都是170亿激活参数,但是前者共16个专家,后者有128个专家,因此总的参数量分别达到了1090亿和4000亿!不过根据评测的情况看,即使是4000亿规模170亿激活的模型,也和DeepSeek V3.1(即DeepSeek V3 0324)版本差不多。

2025/04/06 08:41:47951
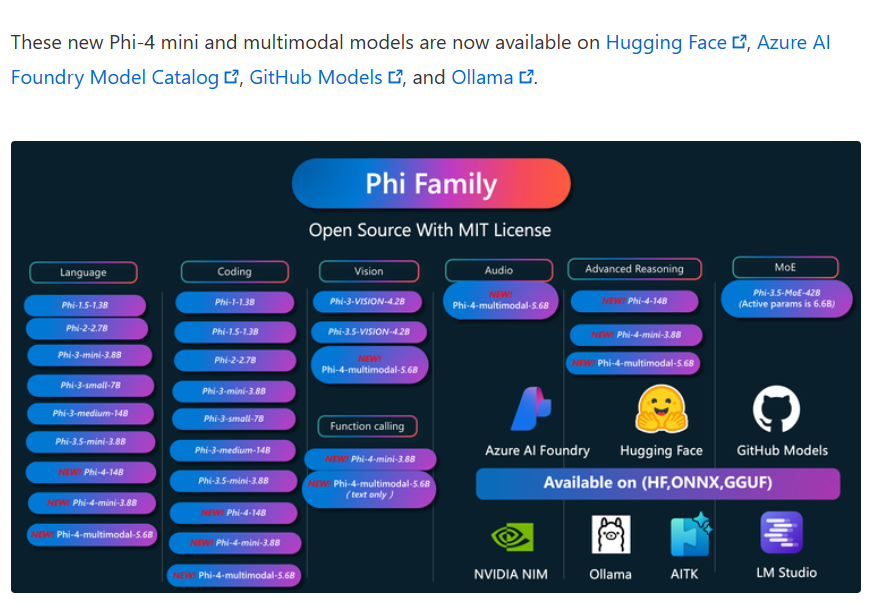
微软开源最强38亿小规模参数大语言模型以及56亿参数规模全模态大模型,但是总体评测结果超过Qwen2.5-7B以及Llama3.1-8B等模型,接近GPT-4o mini。

微软开源最强38亿小规模参数大语言模型以及56亿参数规模全模态大模型,但是总体评测结果超过Qwen2.5-7B以及Llama3.1-8B等模型,接近GPT-4o mini。

2025年2月27日,微软正式发布了其全新系列的大型语言模型——Phi-4系列。这一系列包含了三个创新性的模型:Phi-4-Mini、Phi-4-Multimodal和一款经过推理优化的Phi-4-Mini。此次发布的模型不仅在性能上展现出色,更在多模态能力与推理任务中实现了显著突破。其中,Phi-4-Multimodal是一个仅仅包含56亿参数规模的多模态大模型,但是支持文本、语音、图片的输入,十分强大。

2025/02/27 22:20:01928
除了Mistral-7B-MoE外,MistralAI还有更强大的模型,未宣布的Mistral-medium比混合专家模型更强!

除了Mistral-7B-MoE外,MistralAI还有更强大的模型,未宣布的Mistral-medium比混合专家模型更强!

MistralAI开源的混合专家模型Mistral-7B×8-MoE在本周吸引了大量的关注。这个模型不仅是稍有的基于混合专家技术开源的大模型,而且有较高的性能、较低的推理成本、支持法语、德语等特性。昨天MistralAI发布的不仅仅是这个混合专家模型,还有他们的平台服务La plateforme。在这里他们透露了MistralAI还有更加强大的模型。

2023/12/12 09:07:04907
IMO-Bench:谷歌发布的用于大模型数学推理的鲁棒评估基准

IMO-Bench:谷歌发布的用于大模型数学推理的鲁棒评估基准

IMO-Bench 是 Google DeepMind 开发的一套基准测试套件,针对国际数学奥林匹克(IMO)水平的数学问题设计,用于评估大型语言模型在数学推理方面的能力。该基准包括三个子基准:AnswerBench、ProofBench 和 GradingBench,涵盖从短答案验证到完整证明生成和评分的全过程。发布于 2025 年 11 月,该基准通过专家审核的问题集,帮助模型实现 IMO 金牌级别的性能,并提供自动评分机制以支持大规模评估。