

复杂问题推理能力大幅提升,DeepSeekAI发布DeepSeek V3.2正式版本以及一个评测结果可以媲美Gemini 3.0 Pro的将开源模型推到极限性能的DeepSeek-V3.2-Speciale模型
几个小时前,DeepSeek 突然发布了两款全新的推理模型:DeepSeek V3.2 正式版与DeepSeek V3.2-Speciale。前者已经全面替换官方网页、App 与 API 成为新的默认模型;后者则以“临时研究 API”的方式开放,被定位为极限推理版本。
Explore the latest AI and LLM news and technical articles, covering original content and practical cases in machine learning, deep learning, and natural language processing.
几个小时前,DeepSeek 突然发布了两款全新的推理模型:DeepSeek V3.2 正式版与DeepSeek V3.2-Speciale。前者已经全面替换官方网页、App 与 API 成为新的默认模型;后者则以“临时研究 API”的方式开放,被定位为极限推理版本。
AI 能不能替我做报告”几乎成了办公室里出现频率最高的疑问之一。模型能力的提升有目共睹,API 的边界也在持续扩张,但回到日常,那些真正让人感到疲惫的依旧是最具体的任务:一份复盘写到深夜,一个 PPT 改了十几版,一张 Excel 来回分析到眼花。它们看似普通,却占据了知识工作中惊人比例的时间。本文主要看一下办公小浣熊这个颇具代表性的大模型应用落地思路。
最近 Vibe Coding 的概念越来越热,尤其是 Gemini 3 Pro 发布后,很多人都在说:“现在做网站和 App,好像一句话就能生成。” 界面生成、交互补全、流程搭建这些事情确实越来越轻松,模型能在很短时间内产出一个“看起来完整”的应用原型。一个国产开源项目就在尝试解决这个问题,它就是 AipexBase。
就在昨天,Anthropic 发布了一套非常重要的工程方案,专门针对这些挑战而设计:基于“Initializer Agent + Coding Agent”的双 Agent 架构。
本文介绍 Terminal-Bench 的设计理念,深入讲解 core、Terminal-Bench Hard 与最新 Terminal-Bench 2.0 的区别,帮助开发者选择合适的 AI 终端评测基准。
Google 最新推出的 Nano Banana Pro(Gemini 3 Pro Image) 不只是一次“图像质量提升”,而是让普通用户也能借助专业级提示词,生成具备排版、构图、品牌、摄影语言的作品。 在这个版本中,最关键的能力不是模型本身,而是: 它对结构化、专业化 Prompt 的响应能力非常强。 写对提示词,效果天差地别。 本文将完全聚焦于: 怎么写提示词,才能让 Nano Banana Pro 生出最好的图。
就在刚才,谷歌推出了 Nano Banana Pro(Gemini 3 Pro Image)。这是基于 Gemini 3 Pro 打造的专业级图像生成与编辑模型,相比几个月前的 Nano Banana,这次升级几乎重构了谷歌图像生成能力的上限。从文本渲染、多图一致性,到世界知识、摄影级控制和信息可视化,Nano Banana Pro 在多个维度显著拉开了与上一代、乃至整个行业同类产品的差距。
谷歌终于在2025年11月18日发布了新一代Gemini 3模型:Gemini 3.0 Pro。该模型目前在各个评测排行榜中都获得了非常优秀的结果,几乎是领先了所有的模型。而根据此前大家的匿名投票评分和早期测试,该模型的文本生成、编程、SVG生成等方面都非常优秀。谷歌官方强调,Gemini 3.0 Pro不仅在推理能力上达到了新的业界巅峰,更在理解深度、细微差别以及“思考”能力上实现了质的飞跃。
11 月 13 日,SimilarWeb 发布了最新的 GenAI 访问流量分布。从数据走势可以明显看到,大模型行业正在经历从“ChatGPT 绝对统治”向“多极竞争”的结构性转变。 一年前,ChatGPT 占据了超过 86% 的流量份额,整个行业几乎处于单中心状态。然而在过去的 12 个月里,大模型的多样化发展、不同厂商的产品升级、企业用户需求变化,都推动了新一轮的流量重分配。
2025 年 11 月 13 日,OpenAI 团队在 Reddit 上进行了一场针对 GPT-5.1、模型自定义能力、开发者 API、未来路线图 的公开 AMA(Ask Me Anything)。这次交流并不是简单的功能答疑,而是罕见地从内部视角解释了他们如何思考安全策略、模型行为塑形、推理模式优化、人格定制逻辑、多模态进展以及实际工程实现细节。
OpenAI 于 2025 年 11 月正式发布 GPT-5 系列的阶段性更新版本 —— GPT-5.1。这一更新并非针对模型架构的全面重做,而是围绕“对话体验、一致性、任务适配性”进行的系统化优化。在 GPT-5 推出后,业界对其不稳定回复、语气波动、任务深度控制不足等表现提出了不少批评,因此本次更新可视为 OpenAI 对这些问题的集中调整。
IMO-Bench 是 Google DeepMind 开发的一套基准测试套件,针对国际数学奥林匹克(IMO)水平的数学问题设计,用于评估大型语言模型在数学推理方面的能力。该基准包括三个子基准:AnswerBench、ProofBench 和 GradingBench,涵盖从短答案验证到完整证明生成和评分的全过程。发布于 2025 年 11 月,该基准通过专家审核的问题集,帮助模型实现 IMO 金牌级别的性能,并提供自动评分机制以支持大规模评估。
LiveBench是一个针对大型语言模型(LLM)的基准测试框架。该框架通过每月更新基于近期来源的问题集来评估模型性能。问题集涵盖数学、编码、推理、语言理解、指令遵循和数据分析等类别。LiveBench采用自动评分机制,确保评估基于客观事实而非主观判断。基准测试的总问题数量约为1000个,每月替换约1/6的问题,以维持测试的有效性。
BrowseComp是一个用于评估AI代理网页浏览能力的基准测试。它包含1266个问题,这些问题要求代理在互联网上导航以查找难以发现的信息。该基准关注代理在处理多跳事实和纠缠信息时的持久性和创造性。OpenAI于2025年4月10日发布此基准,并将其开源在GitHub仓库中。
就在今日,Moonshot AI 正式推出 Kimi K2 Thinking,这款开源思考代理模型以其革命性的工具集成和长程推理能力,瞬间点燃了开发者社区的热情。Kimi K2能自主执行200-300次连续工具调用,跨越数百步推理,解决PhD级数学难题或实时网络谜题。本次发布的Kimi K2不仅仅是模型升级,更是AI Agent能力的扩展。
让AI Agent通过编写代码来调用工具,而不是直接工具调用。这种方法利用了MCP(Model Context Protocol,模型上下文协议)标准,能显著降低token消耗,同时保持系统的可扩展性。下面,我结合原文的逻辑,分享我的理解和改写版本,目的是记录这个洞察,并为后续实验提供参考。Anthropic作为领先的AI研究机构,于2024年11月推出了MCP,这是一个开放标准,旨在简化AI Agent与外部工具和数据的连接,避免传统自定义集成的碎片化问题。
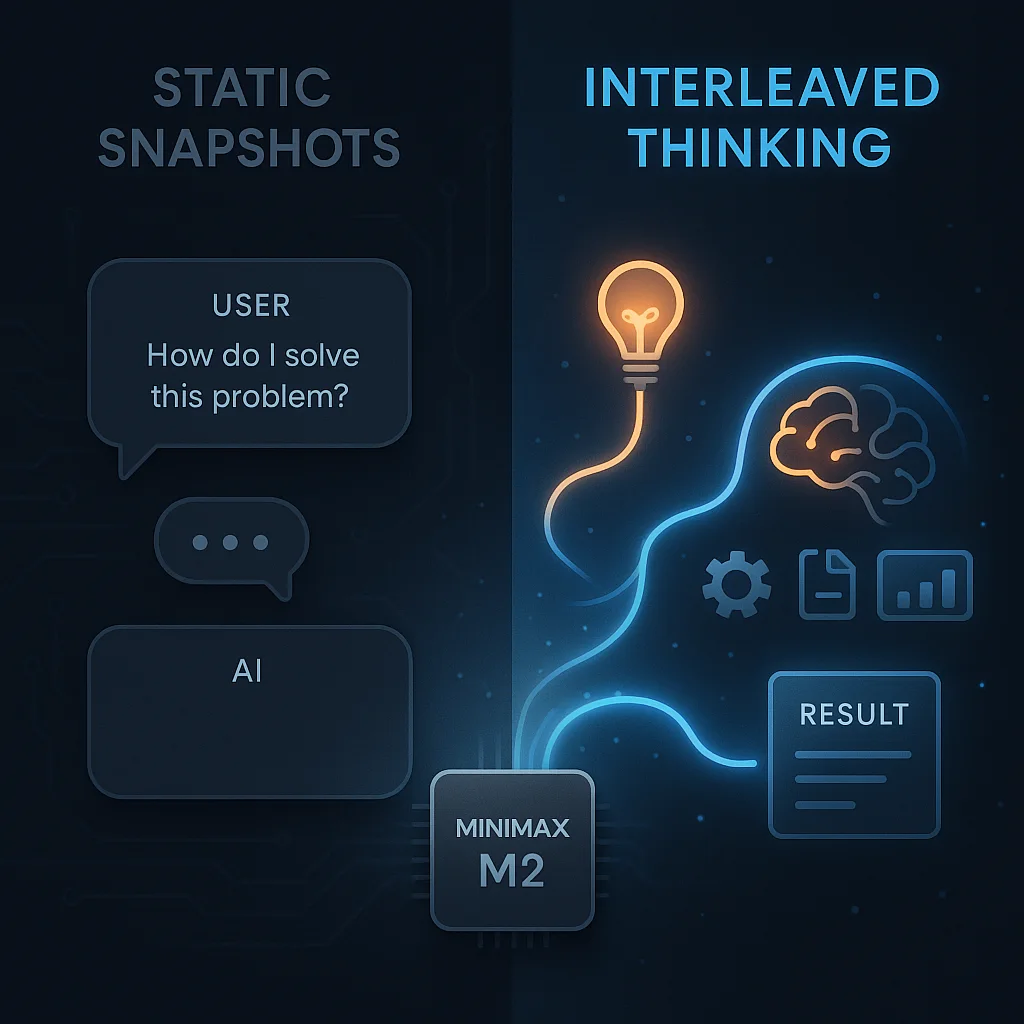
MiniMax M2发布2周后已经成为OpenRouter上模型tokens使用最多的模型之一。已经成为另一个DeepSeek现象的大模型了。然而,实际使用中,很多人反馈说模型效果并不好。而此时,官方也下场了,说当前大家使用MiniMax M2效果不好的一个很重要的原因是没有正确使用Interleaved Thinking。正确使用Interleaved thinking模式,可以让MiniMax M2模型的效果最多可以提升35%!本文我们主要简单聊聊这个Interleaved thinking。
IFBench 是一个针对大语言模型(LLM)指令跟随能力的评测基准。该基准聚焦于模型对新颖、复杂约束的泛化表现,通过 58 个可验证的单轮任务进行评估。发布于 2025 年 7 月,该基准旨在揭示模型在未见指令下的精确执行水平。目前,主流模型在该基准上的得分普遍低于 50%,显示出指令跟随的潜在局限。
MiniMax正式开源MiniMax M2模型,该模型定位是“Mini 模型,Max 编码与代理工作流”。最大的特点是2300亿总参数量,但是每次推理仅激活100亿,类似于10B模型。这款模型非常火爆,原因在于这么小的激活参数数量,推理速度很快,但是其评测结果非常优秀。
在AI时代,Hugging Face Hub已成为开源大语言模型(LLM)和预训练模型的宝库。从Qwen到DeepSeek系列,这些模型往往体积庞大(几GB甚至上百GB),下载过程容易受网络波动影响,导致中断、重试或失败。作为一名AI从业者,你可能不止一次遇到过“下载到99%就崩”的尴尬。本文将从客观角度,基于实际使用经验,介绍四种常见下载Hugging Face大模型的方法:从基础的Git克隆,到CLI工具、Transformers库,再到国内镜像加速。每种方法都有其适用场景和优缺点,我们将逐一剖析,帮

就在今日,阿里巴巴Qwen团队重磅推出Qwen3-VL-2B和Qwen3-VL-32B两款视觉语言模型,这些dense架构的创新之作,将多模态AI的强大能力压缩进更紧凑的框架中,显著降低了部署门槛。 作为Qwen3系列的最新扩展,它们在保持顶级性能的同时,支持从边缘设备到云端的无缝应用——想象一下,一款手机App就能实时分析2小时视频,或从模糊手写笔记中提取精确信息。这不仅仅是参数缩减,更是AI普惠化的关键一步,帮助开发者以更低的成本实现视觉智能的突破。
Scale AI 于 2025 年 9 月 21 日发布了 SWE-Bench Pro,这是一个针对 AI 代理在软件工程任务上的评估基准。该基准包含 1,865 个问题,来源于 41 个活跃维护的代码仓库,聚焦企业级复杂任务。现有模型在该基准上的表现显示出显著差距,顶级模型的通过率低于 25%,而最近的榜单更新显示部分模型已超过 40%。这一发布旨在推动 AI 在长时程软件开发中的应用研究。
DeepSeek AI团队重磅推出DeepSeek-OCR,该模型不仅在文档提取上达到了行业领先水平,更通过创新的视觉压缩技术,将长上下文处理效率提升了 10 倍以上。根据测算,在A100-40G的一个GPU上,它每天可以将20万页的文档图像数据转为Markdown文本!