
OpenAI正在开发一个全新的基于大模型的Agent产品
今天The Information独家披露了一个令人兴奋的消息,那就是OpenAI正在开发一种Agent产品,可以通过控制用户的设备来帮助用户完成复杂的任务。
Explore the latest AI and LLM news and technical articles, covering original content and practical cases in machine learning, deep learning, and natural language processing.
今天The Information独家披露了一个令人兴奋的消息,那就是OpenAI正在开发一种Agent产品,可以通过控制用户的设备来帮助用户完成复杂的任务。
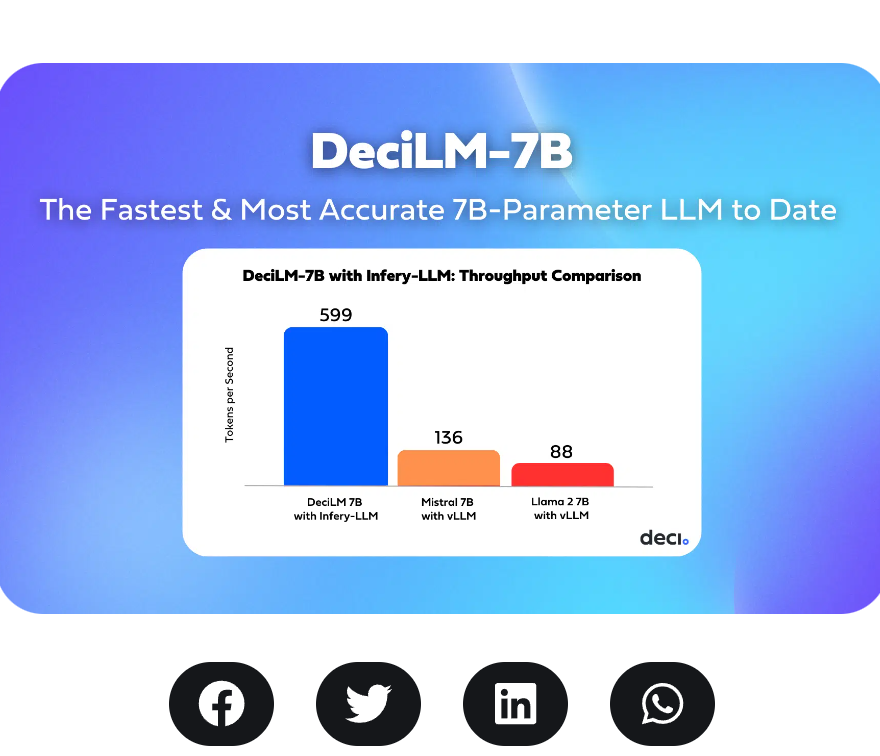
DeciAI是一家成立于2019年的以色列企业,他们最主要的产品是深度学习平台Deci,可以让大家部署运行更快、更准确的模型。包括Adobe、HPE等都是他们的客户。在昨天,他们开源了截止目前可能是Open LLM Leader综合评分最高的大语言模型DeciLM-7B以及指令优化版本的DeciLM-7B-Instruct。最重要的是,这个模型以Apache2.0的协议开源,可以免费商用。
Mistral AI今天发布了其首个专注于推理能力的系列模型——**Magistral**。这次发布包含两个核心模型:旗舰模型`Magistral Medium`和<font color=red>已开源的</font>`Magistral Small (24B)`。最引人注目的亮点是,Mistral展示了其自研的强化学习(RL)pipeline能够从头开始,仅通过RL训练就将基础模型的推理能力提升到业界顶尖水平,而无需依赖任何其他预先存在的推理模型进行数据蒸馏。这套技术栈非常强大!
MLOps的主要目标是创建一个更有效、可重复和可靠的机器学习工作流程。现在,随着大语言模型的流行,LLMOps概念也随之提出。即如何高效地开发大模型应用,包括自动化管理升级如prompt、模型评估等。为此,吴恩达联合Google的研发人员推出了最新的大模型短课LLMOps,帮助大家学习大语言模型开发过程中的自动化测试、自动化Prompt管理等一系列实践,提高大模型应用开发的效率和质量。
OpenAI 正式发布了其最新模型 OpenAI o3-pro,这是其旗舰模型 o3 的专业增强版。o3-pro 专为需要“更长时间思考”的复杂任务而设计,其核心亮点在于极致的可靠性和准确性,尤其在数学、科学和编程等专业领域表现卓越。根据OpenAI引入的全新“4/4可靠性”评测标准,o3-pro 的性能远超前代,OpenAI官方强调o3-pro在处理高难度、高风险任务的能力上实现了质的飞跃。
OpenAI正在申请一个新商标Voice Engine,商标的覆盖范围主要是围绕语音识别、语音合成和语音生成几个方面。这暗示着OpenAI可能即将推出围绕语音引擎开发的产品或者服务,很有可能是类似Siri那样的个人助理产品。尽管这是商标申请,但是谷歌前雇员透露的信息以及上个月泄露的OpenAI正在开发的产品都似乎印证着OpenAI要做的事情:开发一个全球最强的个人助理,接管个人设备,以Jarvis那样的形式提供服务!
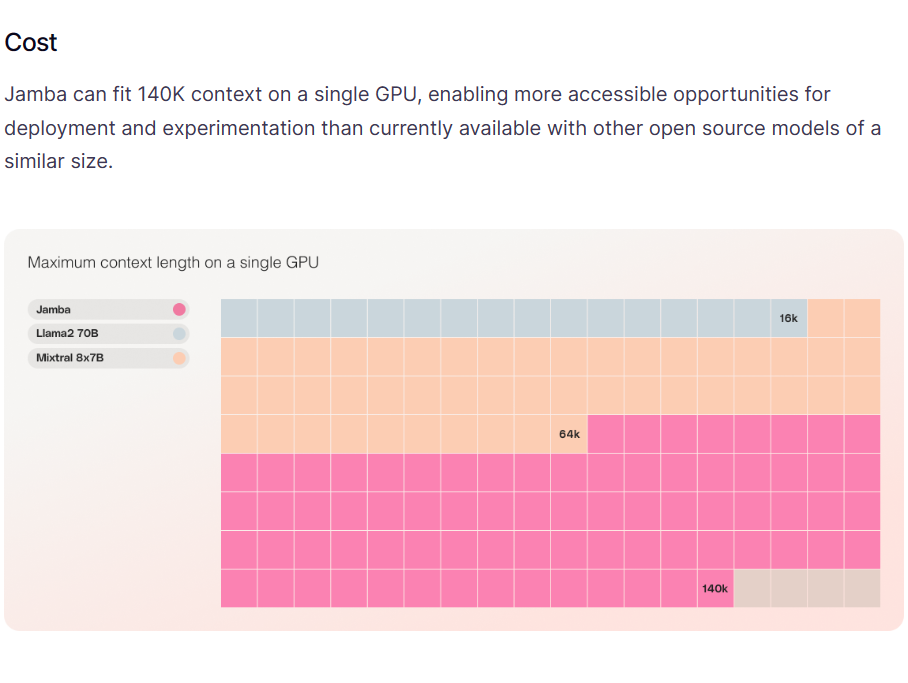
A21实验室是一家以色列的大模型研究机构,专门从事自然语言处理相关的研究。就在今天,A21实验室开源了一个全新的基于混合专家的的大语言模型Jamba,这个MoE模型可以在单个GPU上支持最高140K上下文的输入,非常具有吸引力。

短短两年间,AI技术的进步为软件工程带来了新的可能性。然而,这些模型在真实世界的软件工程任务中究竟能发挥多大的作用?它们能否通过完成实际的软件工程任务来赚取可观的收入?为了验证大模型解决真实任务的能力和水平,OpenAI发布了一个全新的大模型评测基准SWE-Lancer来评测大模型这方面的能力。
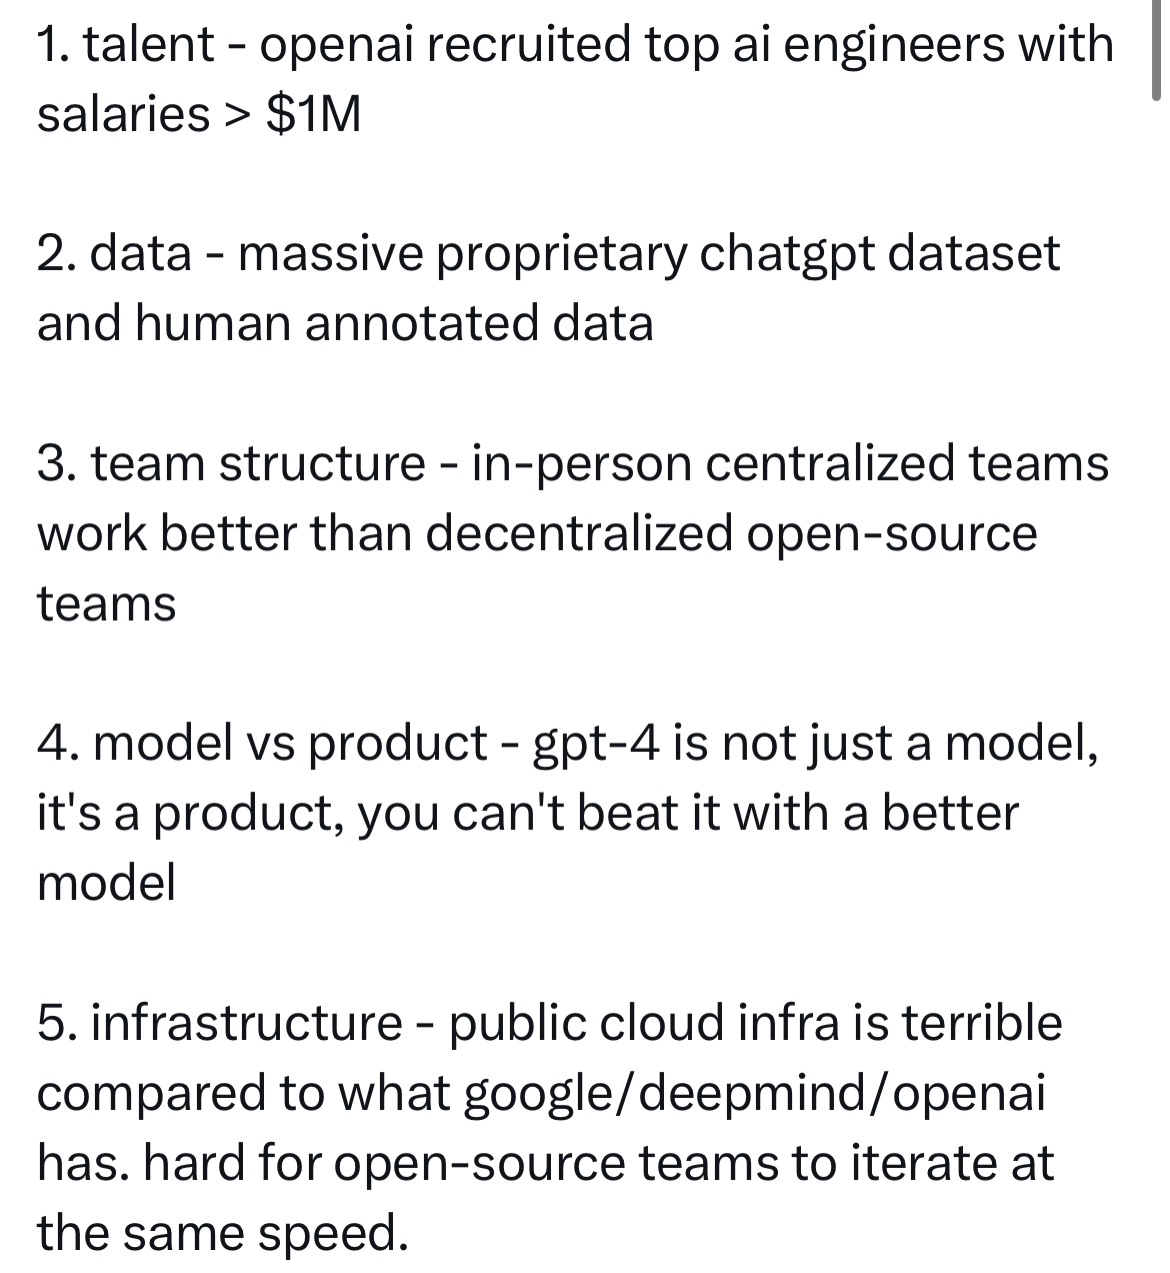
OpenAI在2023年3月份发布了GPT-4,10个月过去了,目前也没有任何一家产品或者模型可以打败GPT-4。但是,很多人都对2024年抱有非常好的期待,认为2024年会出现能与GPT-4竞争的大模型。包括MistralAI的CEO也说他们会在2024年发布性能媲美GPT-4的大模型。但是,Google前AI研究人员,GalileoAI的联合创始人认为2024年也不会出现这种情况。
在几个小时前,OpenAI开源了两款名为gpt-oss-120b和gpt-oss-20b的大语言模型。这是自GPT-2以来,OpenAI首次推出开源权重大语言模型,这两个模型的评测效果达到了o4-mini和o3-mini的水平,而且以Apache 2.0协议开源,大家可以自由使用,包括任何形式的商用。
尽管人工智能语言模型的能力日益强大,但它们依然面临一个棘手的问题:“幻觉”(Hallucination)。所谓幻觉,指的是模型自信地生成一个事实上错误的答案。OpenAI 的最新研究论文指出,这一现象的根源在于标准的训练和评估方式实际上在鼓励模型“猜测”而非“承认不确定性”。
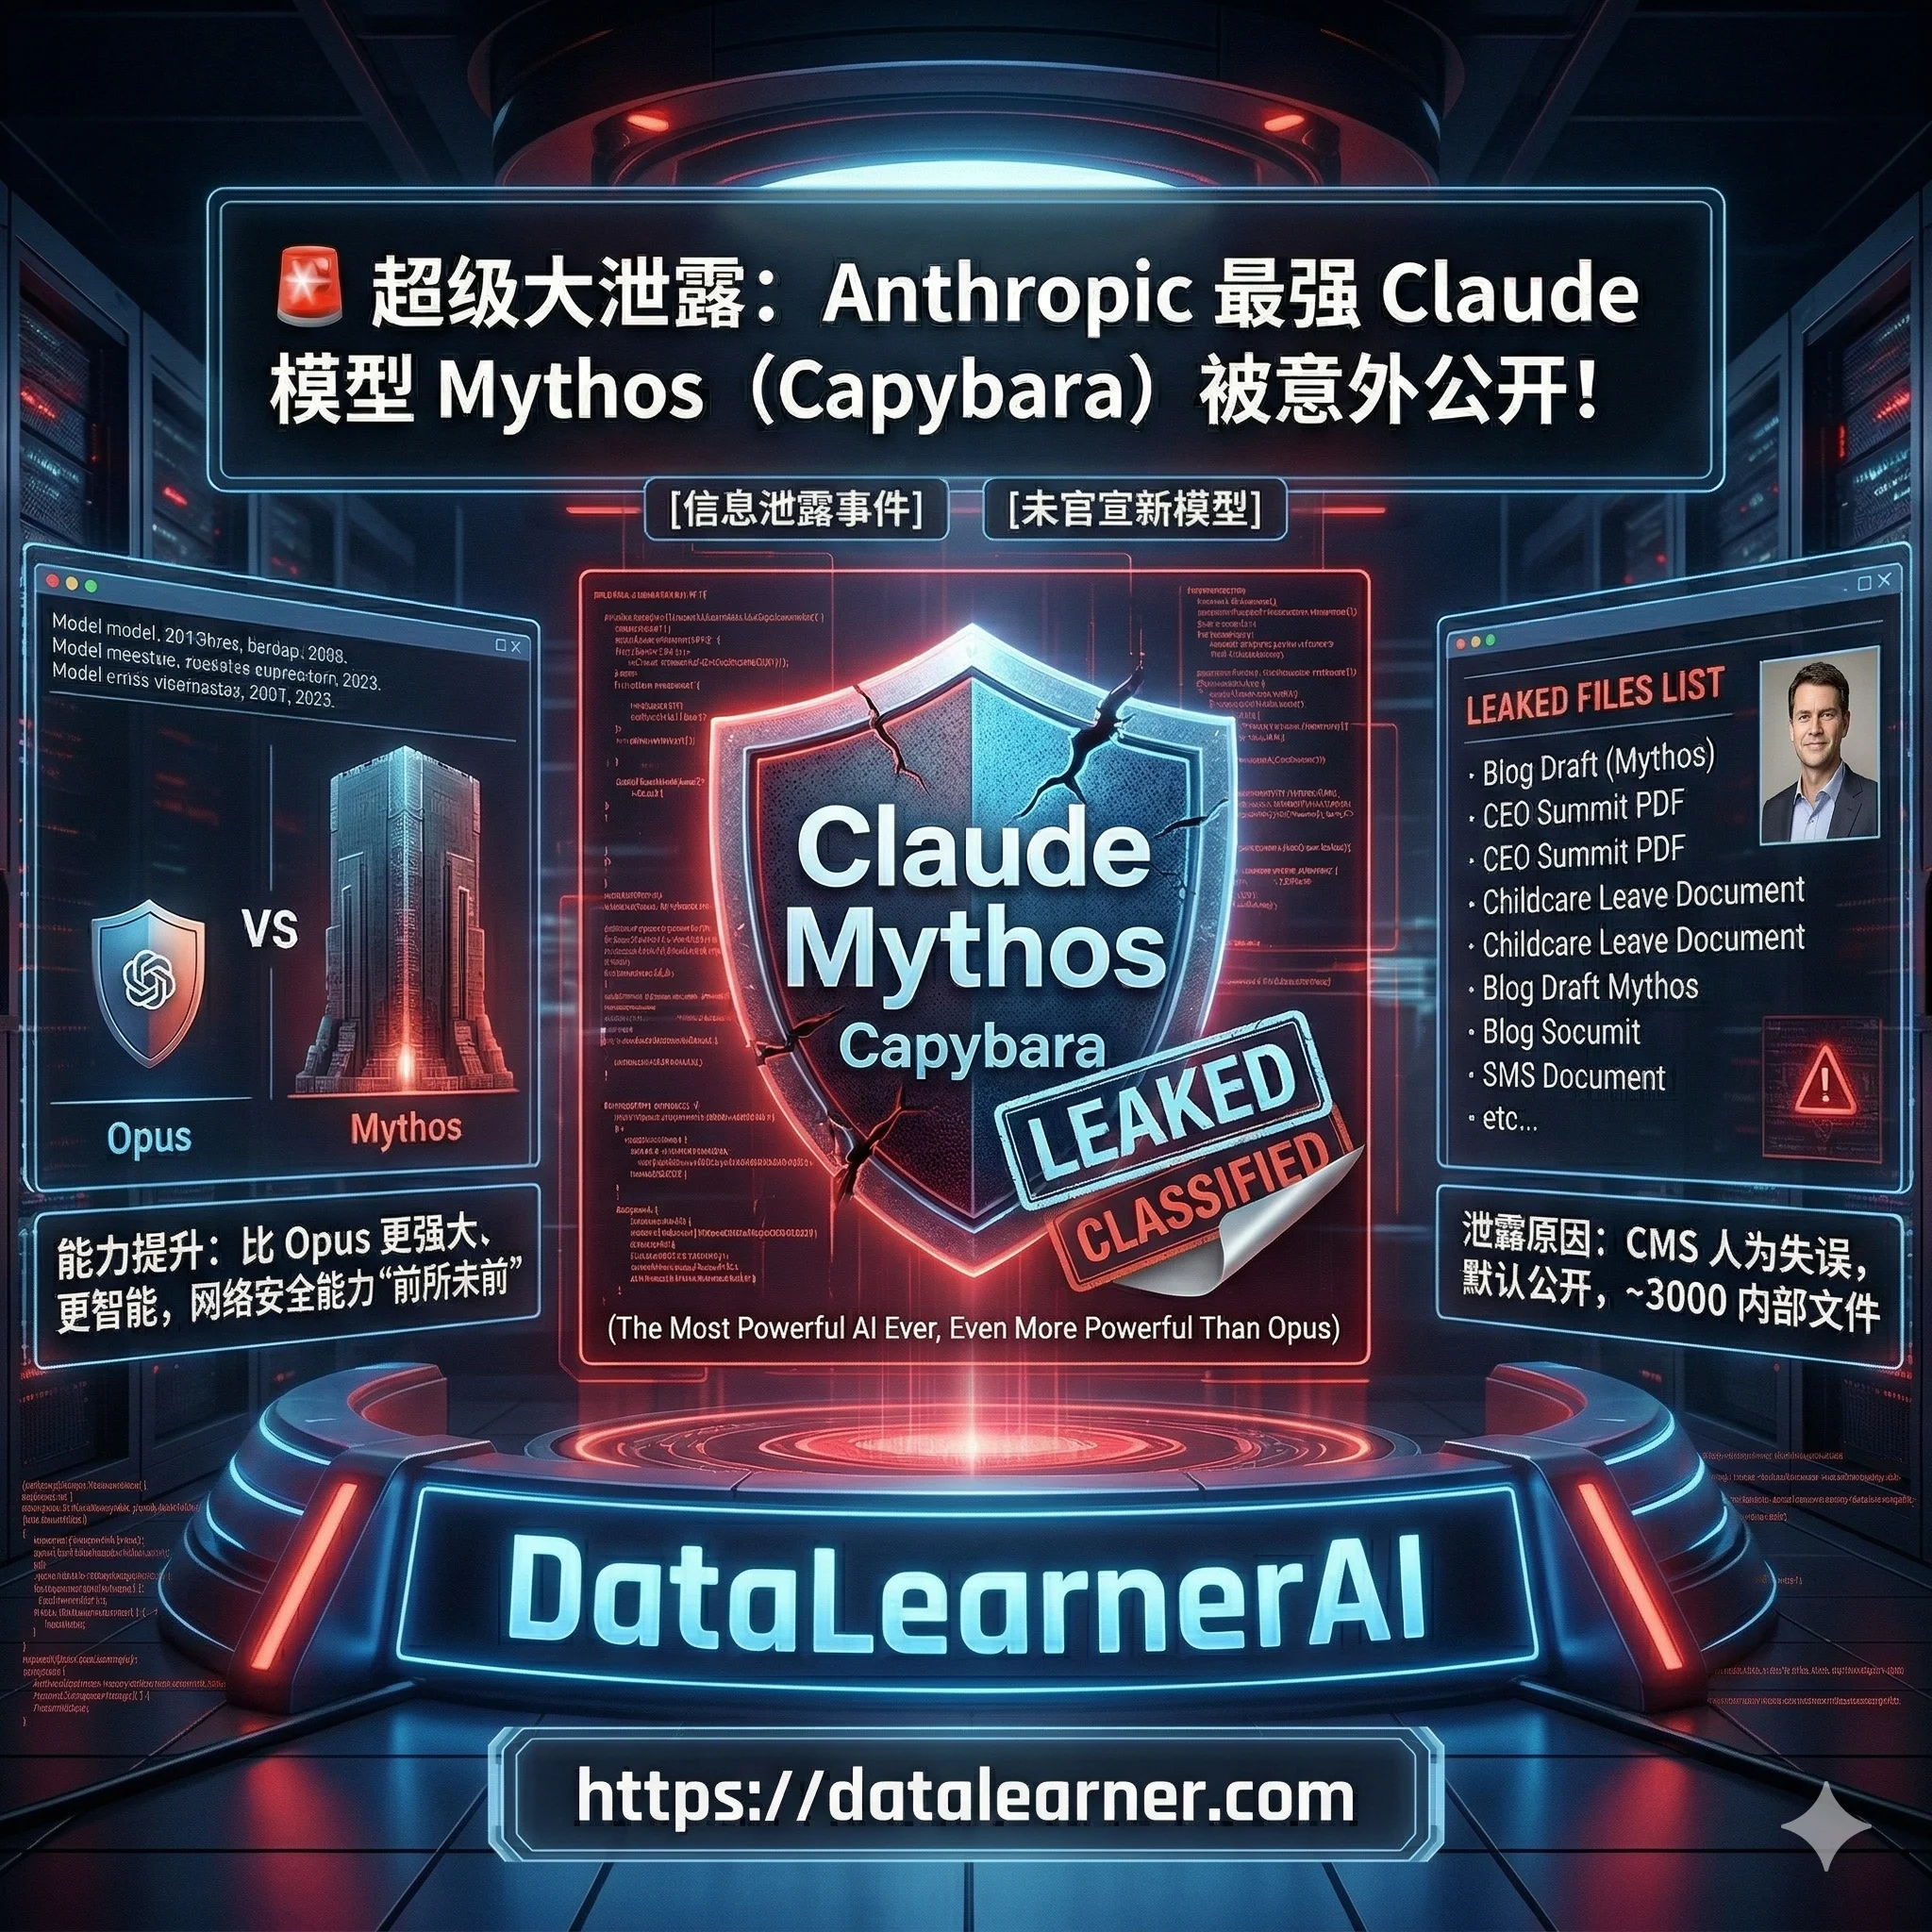
几个小时前,Anthropic发生一起信息泄露事件,还没来得及官宣,自家最强新模型就被”意外”公之于众。新模型的能力据称远超Opus 4.6!
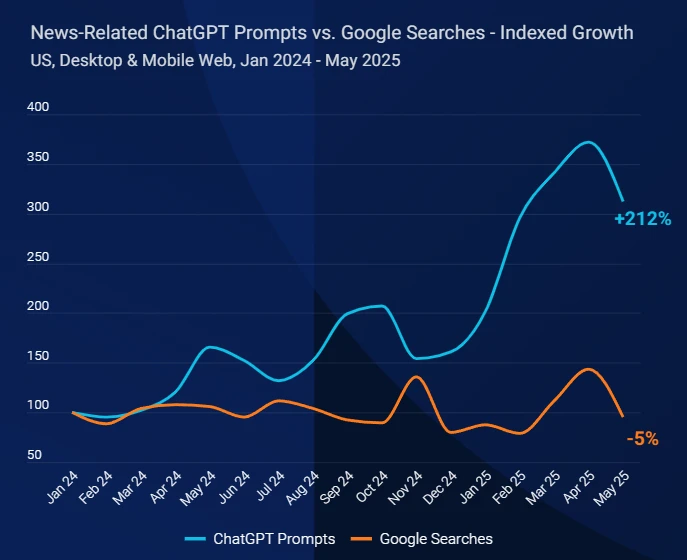
今天,SimilarWeb发布了一个全新的报告,描述了自从ChatGPT这种大模型产品发布之后,新闻出版网站的流量下滑严重,并提供了相关的分析。尽管这是针对新闻网站的报告,但是实际上所有的内容网站或者是内容生产者可能都是有影响的。我们基于这份报告进行解读,为大家提供一个参考。
编程领域大模型一直是进展非常快的大模型领域。因为编程能力更强的模型,通常在逻辑思维、工具调用上有更好的表现,在很多领域,特别是Agent领域有很大的应用价值。今天法国人工智能明星公司MistralAI发布了2个全新的编程大模型,分别是Devstral Medium和 Devstral Small 1.1,后者是一个开源的240亿参数的编程大模型。
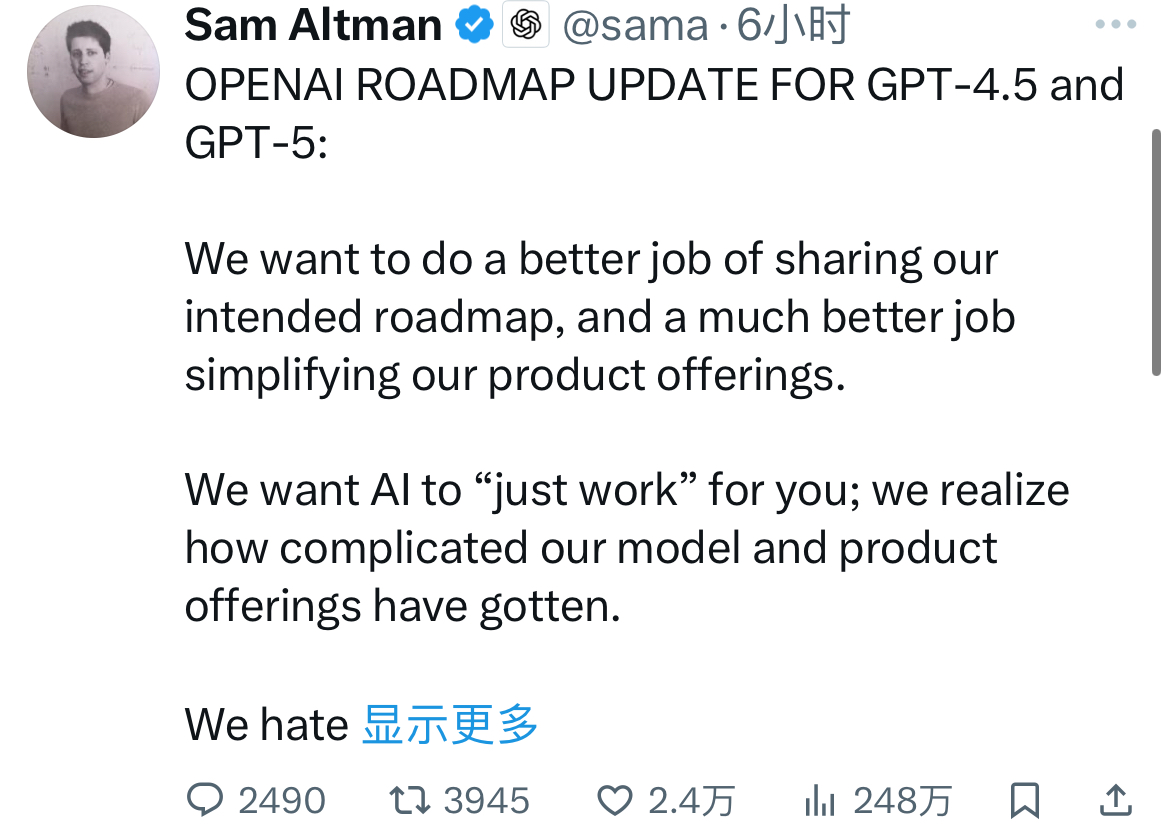
三个小时前,Sam Altam在推特上说明了OpenAI未来的大模型路线图。比较重磅的消息是即将在未来几周发布GPT-4.5,并且在几个月后发布GPT-5。
最近 Vibe Coding 的概念越来越热,尤其是 Gemini 3 Pro 发布后,很多人都在说:“现在做网站和 App,好像一句话就能生成。” 界面生成、交互补全、流程搭建这些事情确实越来越轻松,模型能在很短时间内产出一个“看起来完整”的应用原型。一个国产开源项目就在尝试解决这个问题,它就是 AipexBase。
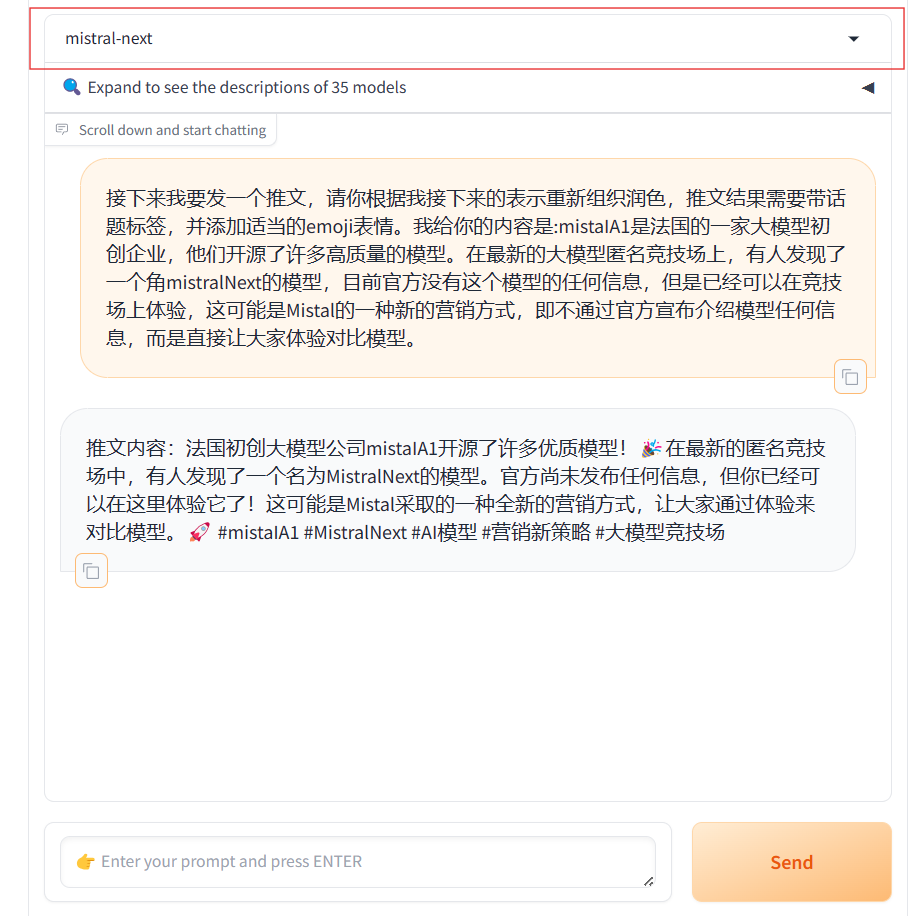
MistralAI又悄悄地上线了另一个模型,即Mistral Next。相比之前的发布预训练种子引起大家猜测的方式,本次MistralAI又把模型发布玩出了花,他们没有公布任何信息,选择直接上架LM-SYS的大模型竞技场Chat Arena,让大家直接体验对比。
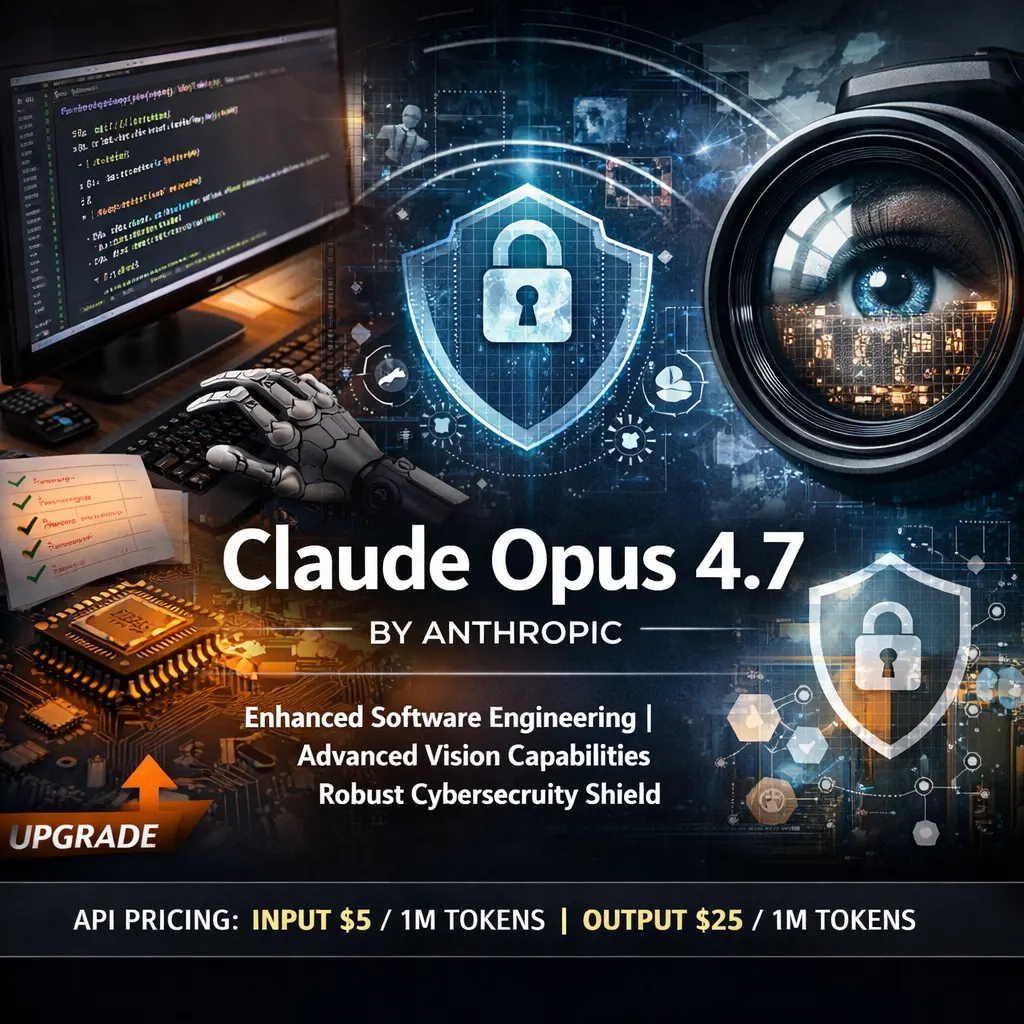
就在今天,Anthropic正式发布Claude Opus 4.7,作为Opus 4.6的直接升级版本,这次更新的重点非常集中:软件工程能力的大幅提升、视觉理解的显著增强,以及一套全新的网络安全防护机制。值得一提的是,Opus 4.7并非Claude系列中能力最强的模型——那个头衔目前属于Claude Mythos Preview——但它是第一个面向大规模开放部署、同时配备完整安全体系的新一代旗舰模型。定价与Opus 4.6保持一致,即API输入25/百万token。
DocVQA是一个针对文档图像的视觉问答基准数据集。该数据集包含50,000个问题,这些问题基于12,767张文档图像构建而成。数据集旨在评估模型在提取和理解文档内容方面的能力,特别是当问题涉及布局、表格和文本时。基准通过提供标注的问答对,支持模型在真实文档场景下的测试。

2025年11月24日,Anthropic正式发布了Programmatic Tool Calling (PTC)特性,允许Claude通过代码而非单次API调用来编排工具执行。这一创新被认为是Agent开发的重要突破,能够显著降低token消耗、减少延迟并提升准确性。 然而,作为minion框架的创建者,我想分享一个有趣的事实:minion从一开始就采用了这种架构理念。在PTC概念被正式提出之前,minion已经在生产环境中证明了这种方法的价值。
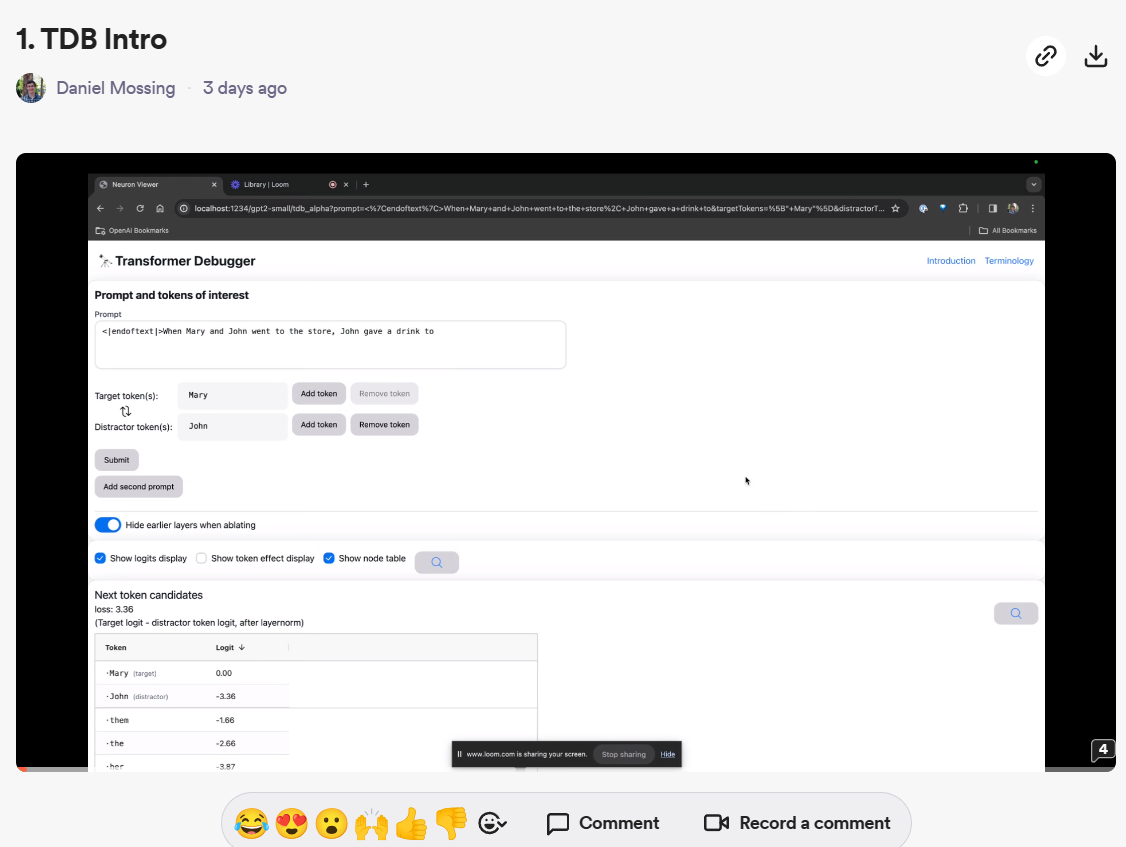
自从OpenAI转向盈利化运营之后,很少再开源自己的技术。但就在刚才,OpenAI开源了一个全新的大模型调测工具:Transformer Debugger。这个工具可以帮助开发者调测大模型的推理情况,帮助我们理解模型的输出并提供一定的解释支持。
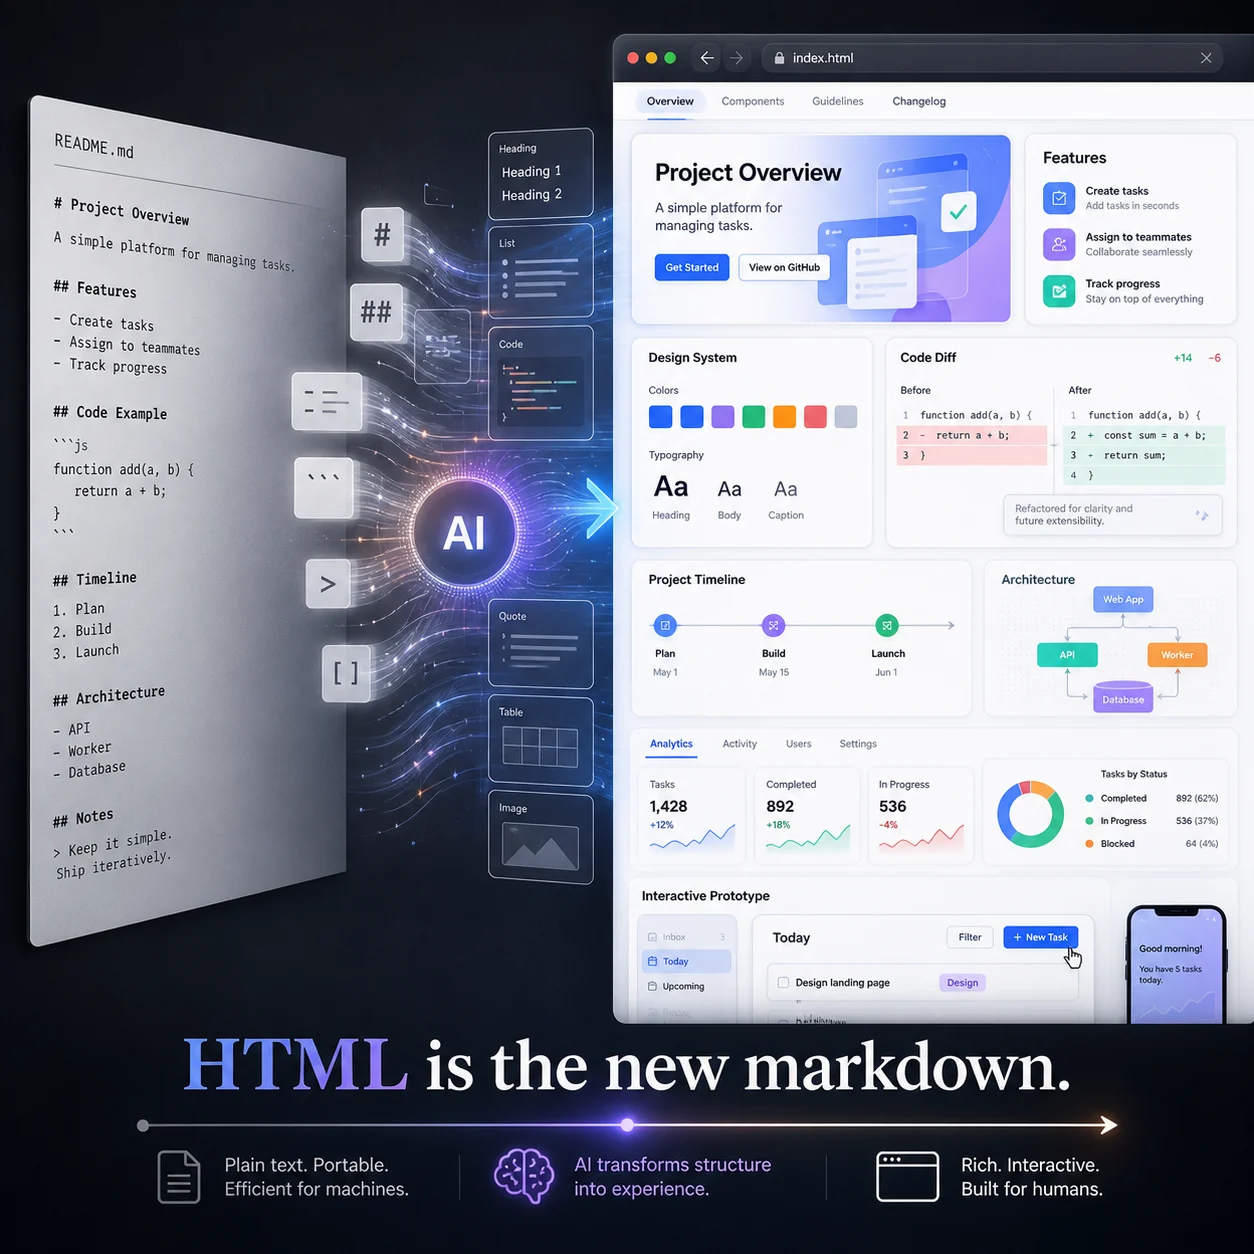
Anthropic Claude Code工程师Thariq发文称HTML应取代Markdown成为AI输出的新标准,并提供了20个HTML示例覆盖代码审查、设计系统、原型交互等9类场景。本文分析了HTML胜出的三类结构性原因——空间信息降维损失、交互体验不可替代、HTML作为原生交付介质,同时指出该论断在token成本和生成速度约束下过于绝对。文章进一步探讨了AI文档格式的终局:结构化数据+渲染分离、模板填充、AI-native语义格式等可能方向。
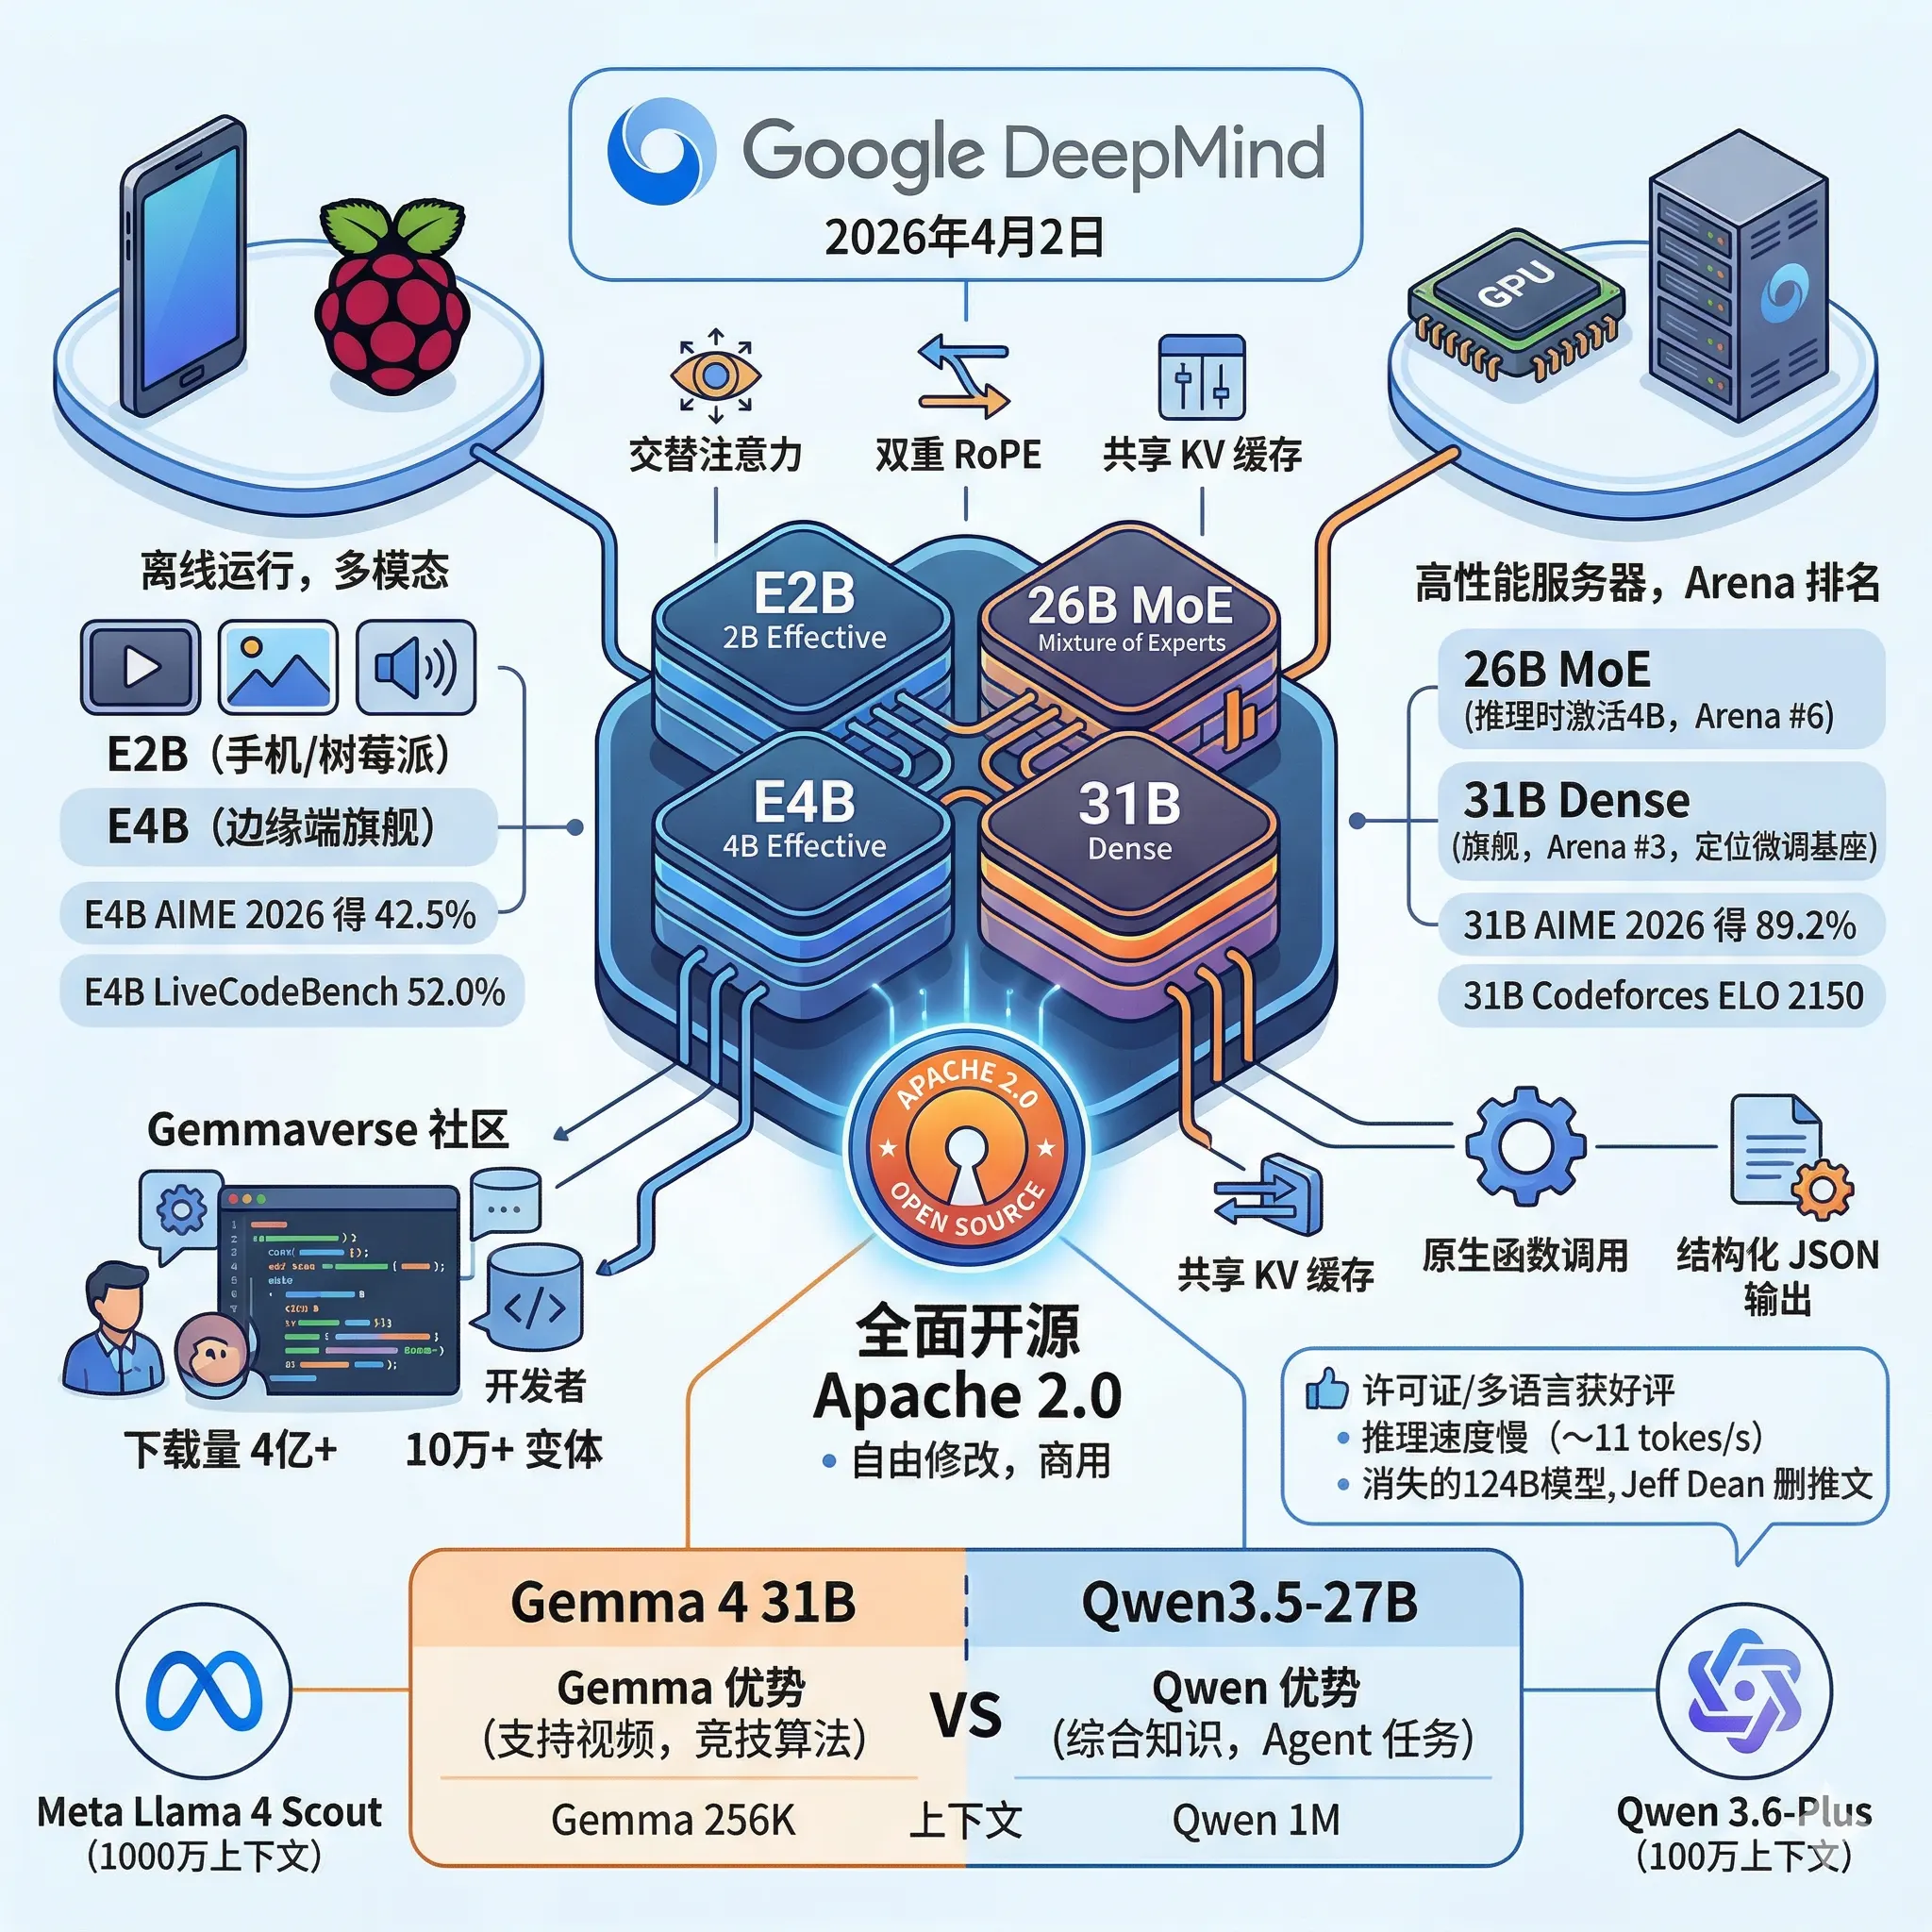
2026年4月2日,Google DeepMind 发布了 Gemma 4 系列,共四个版本:E2B、E4B、26B A4B 和 31B Dense。这也是 Gemma 系列首次采用 Apache 2.0 授权,允许完全商用和二次分发。
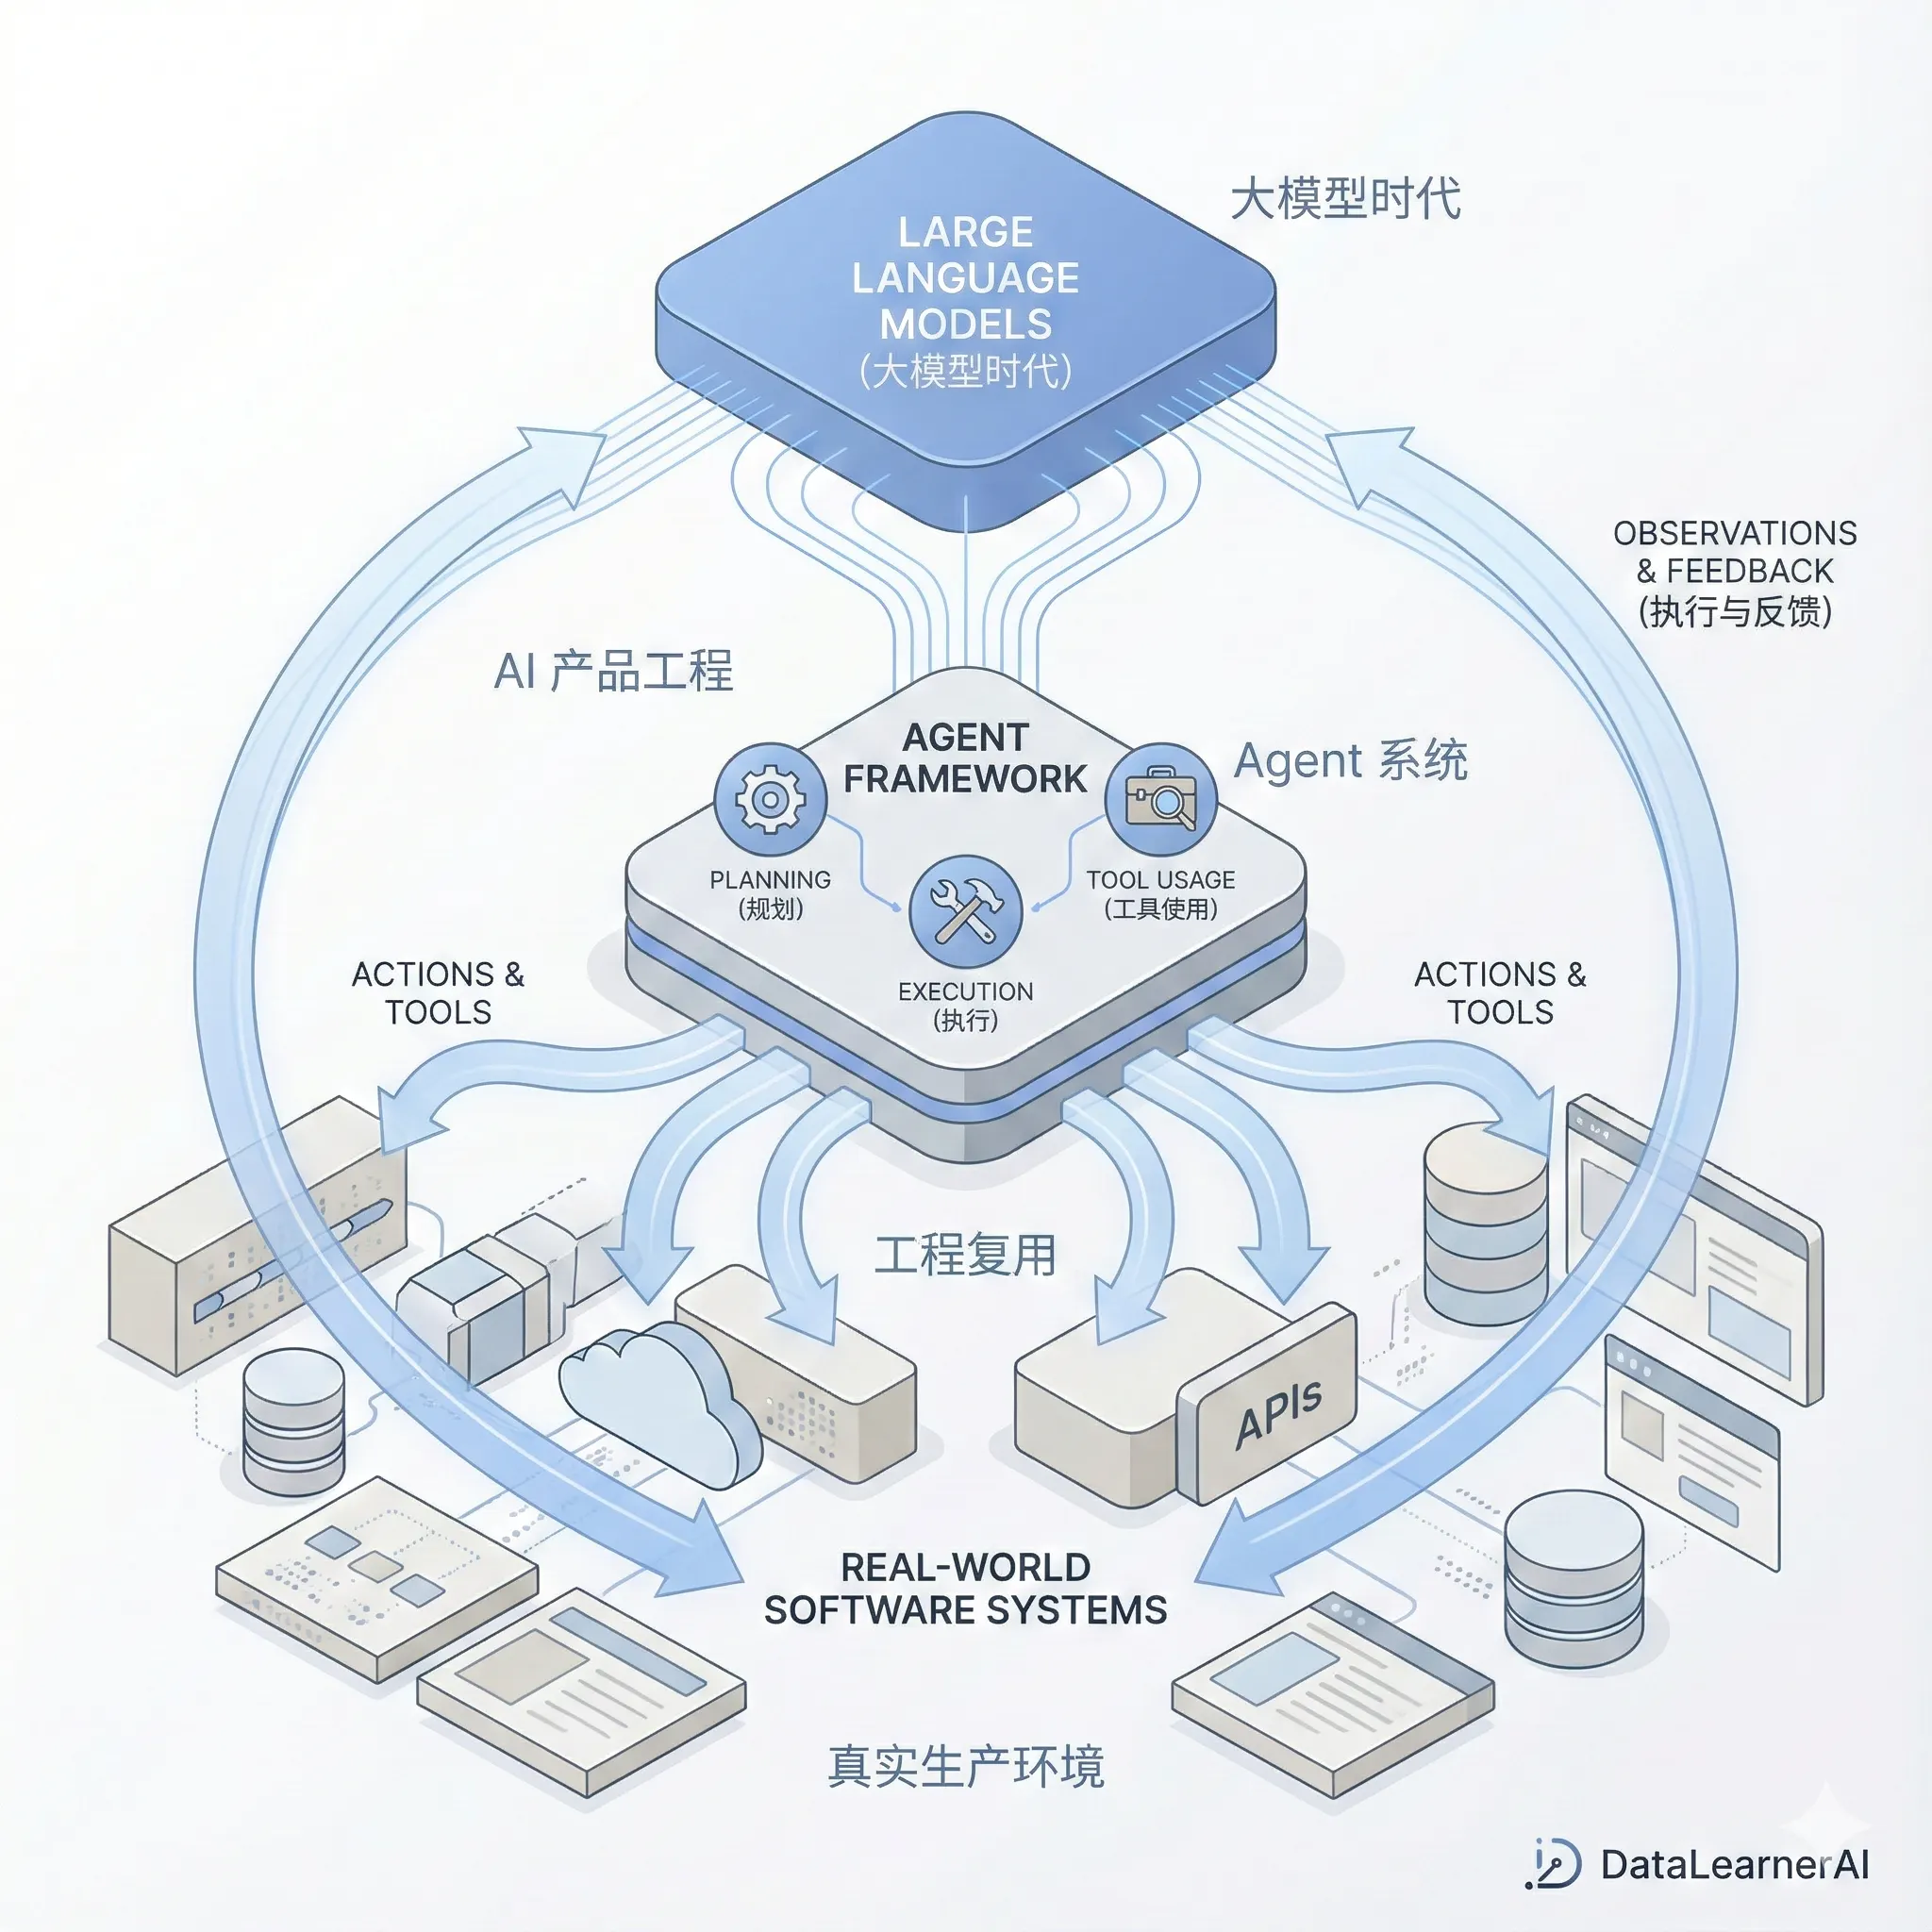
本文基于 Manus 一线工程成员的真实实践,总结并分析了 大模型时代 AI 产品在工程与复用层面发生的关键变化。文章并不关注模型参数或算法细节,而是聚焦于真实生产环境中的工程问题:功能交付的责任边界如何变化、为何原型验证比完整规划更重要,以及在 Agent 系统中个人角色与系统边界如何被重新定义。这些经验揭示了一个趋势——在大模型具备“执行能力”之后,AI 产品的可用性越来越依赖工程体系本身,而非模型能力本身。本文适合关注 AI 工程实践、Agent 架构以及大模型落地问题的技术读者参考。