
全球大模型竞争格局:从“模型榜单”走向“智能体、成本与全栈生态”之争
全球大模型竞争正在从单纯的模型能力竞赛,走向模型、产品、开发者生态、成本与商业化能力的综合竞争。本文系统梳理全球主流基础模型的发展格局,对比 OpenAI、Google、Anthropic、DeepSeek、Qwen 等主要参与者的技术路线、模型能力与生态布局,分析全球大模型市场当前的竞争态势及未来演进方向。
汇总「人工智能」相关的原创 AI 技术文章与大模型实践笔记,持续更新。
全球大模型竞争正在从单纯的模型能力竞赛,走向模型、产品、开发者生态、成本与商业化能力的综合竞争。本文系统梳理全球主流基础模型的发展格局,对比 OpenAI、Google、Anthropic、DeepSeek、Qwen 等主要参与者的技术路线、模型能力与生态布局,分析全球大模型市场当前的竞争态势及未来演进方向。
今天,OpenAI在其官网上发布了一个全新的研究成果:一个利用较弱的模型来引导对齐更强模型的能力的技术,称为由弱到强的泛化。OpenAI认为,未来十年来将诞生超过人类的超级AI系统。但是,这会出现一个问题,即基于人类反馈的强化学习技术将终结。因为彼时,人类的水平不如AI系统,所以可能无法再对模型输出的内容评估好坏。为此,OpenAI提出这种超级对齐技术,希望可以用较弱的模型来对齐较强的模型。这样可以在出现比人类更强的AI系统之后可以继续让AI模型可以遵循人类的意志、偏好和价值观。
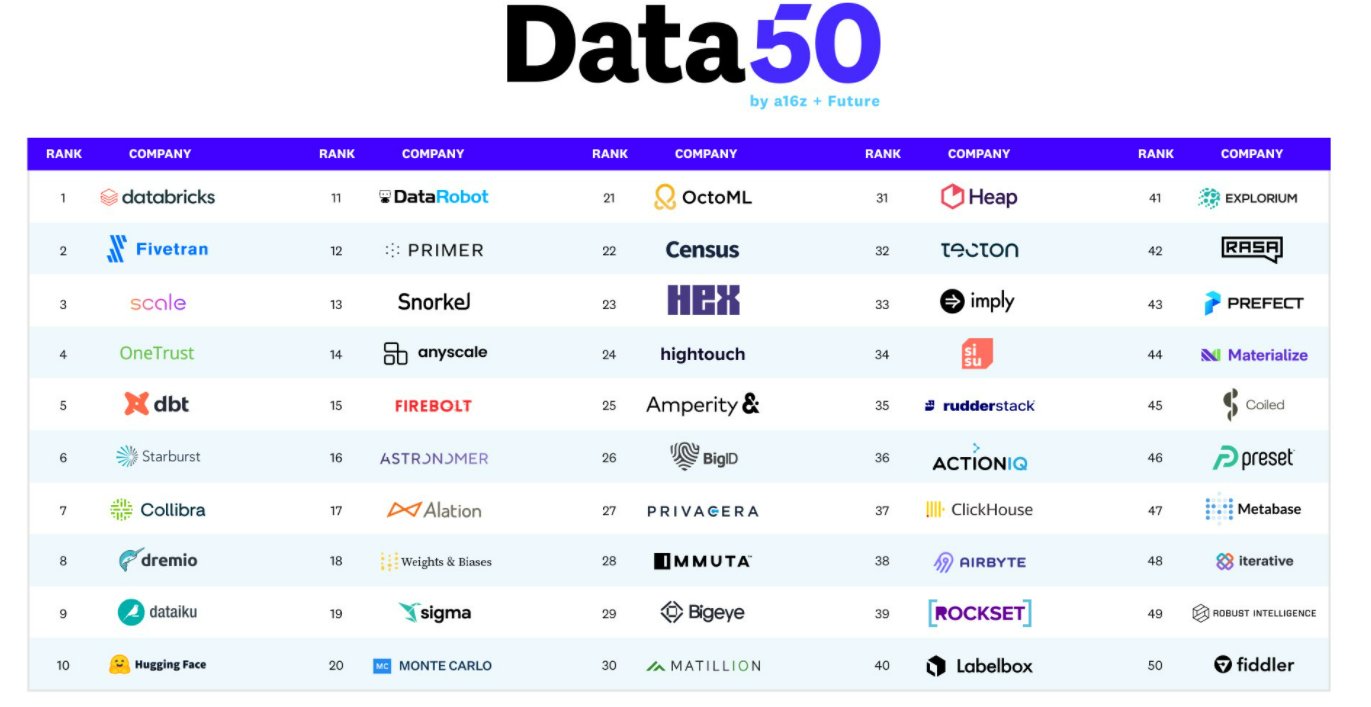
最近几年,数据的重要性在各个领域都获得了巨大的重视。因此,数据管理相关的业务也成为各项基础设施中增长最快的业务,目前的市场规模约700亿美元,占所有企业的基础设施支持约1/5。仅在2021年,数据处理相关的公司获得了数百亿的风险投资。为此,Future总结了2022年全球最大的50家数据创业企业。这里我们列举其中的最大的10个进行介绍。
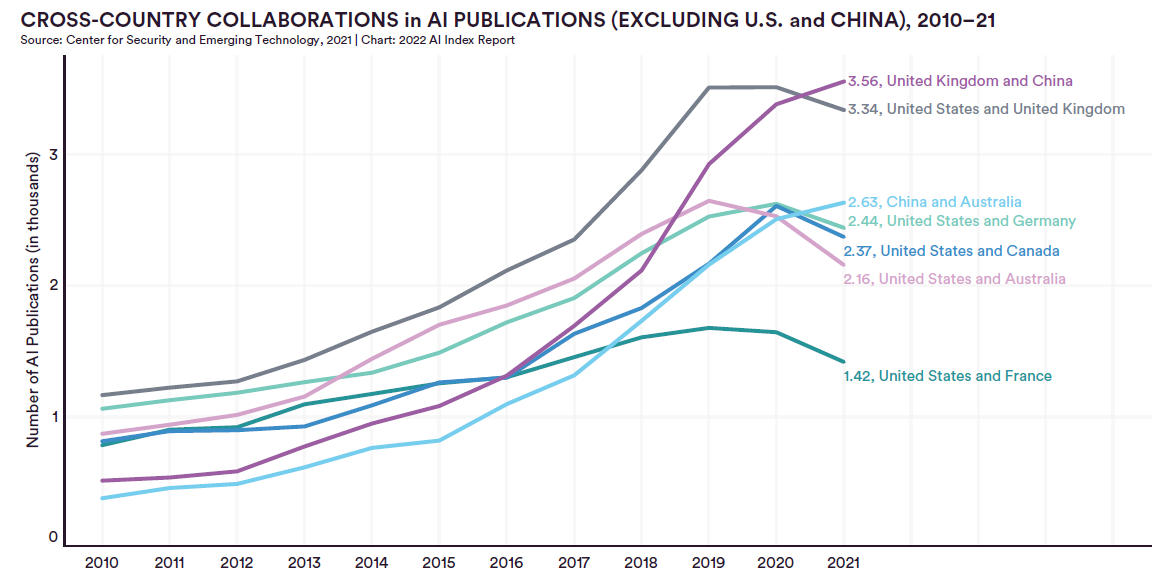
人工智能指数是斯坦福大学以人为本人工智能研究所(Stanford Institute for Human-Centered Artificial Intelligence (HAI))联合学术界、工业界的专家一起发布的人工智能相关的发展报告。2022年度AI指数报告在近几日发布。
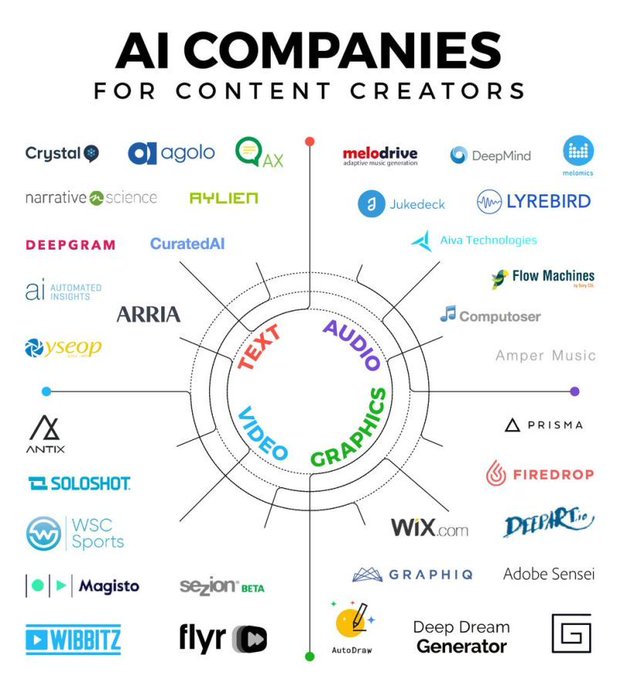
文本生成的主要目的是基于报表和分析生成总结性的文字以辅助商业决策,也就是NLG(Natural Language Generation)。主要的方向包括:基于图表生成洞察报告、基于数据与图表支持问答系统等。本文介绍文字生成的方案提供商。
吴恩达是人工智能领域非常著名的人物。2011年在谷歌创建的谷歌大脑项目,震惊了全世界。2014年他加入百度负责百度大脑计划,并于2017年离职。离职之后他创建了人工智能公司LandingAI,并担任首席执行官。昨天吴恩达宣布他新成立的这家公司已经募集到5,700万美金。本文主要简单介绍这家公司的业务。
Hugging Face是一家非常活跃的人工智能创业公司。它拥有一个非常强大并且活跃的人工智能社区。有超过5000多家机构都在Hugging Face的社区发布内容,包括Google AI、Facebook AI、微软等。自从2016年成立以来,这家企业经历了5轮融资,总共募集了6000万美金。本文将简要介绍这家企业相关的信息。
微软在去年4月份的时候推出了一个构建虚拟助手的指南:《构建人工智能应用的开发者指南·第二版》。这份报告帮助我们借助微软的工具构建一个虚拟助手,本文将简要描述一下这份报告,文末有相关资源下载。
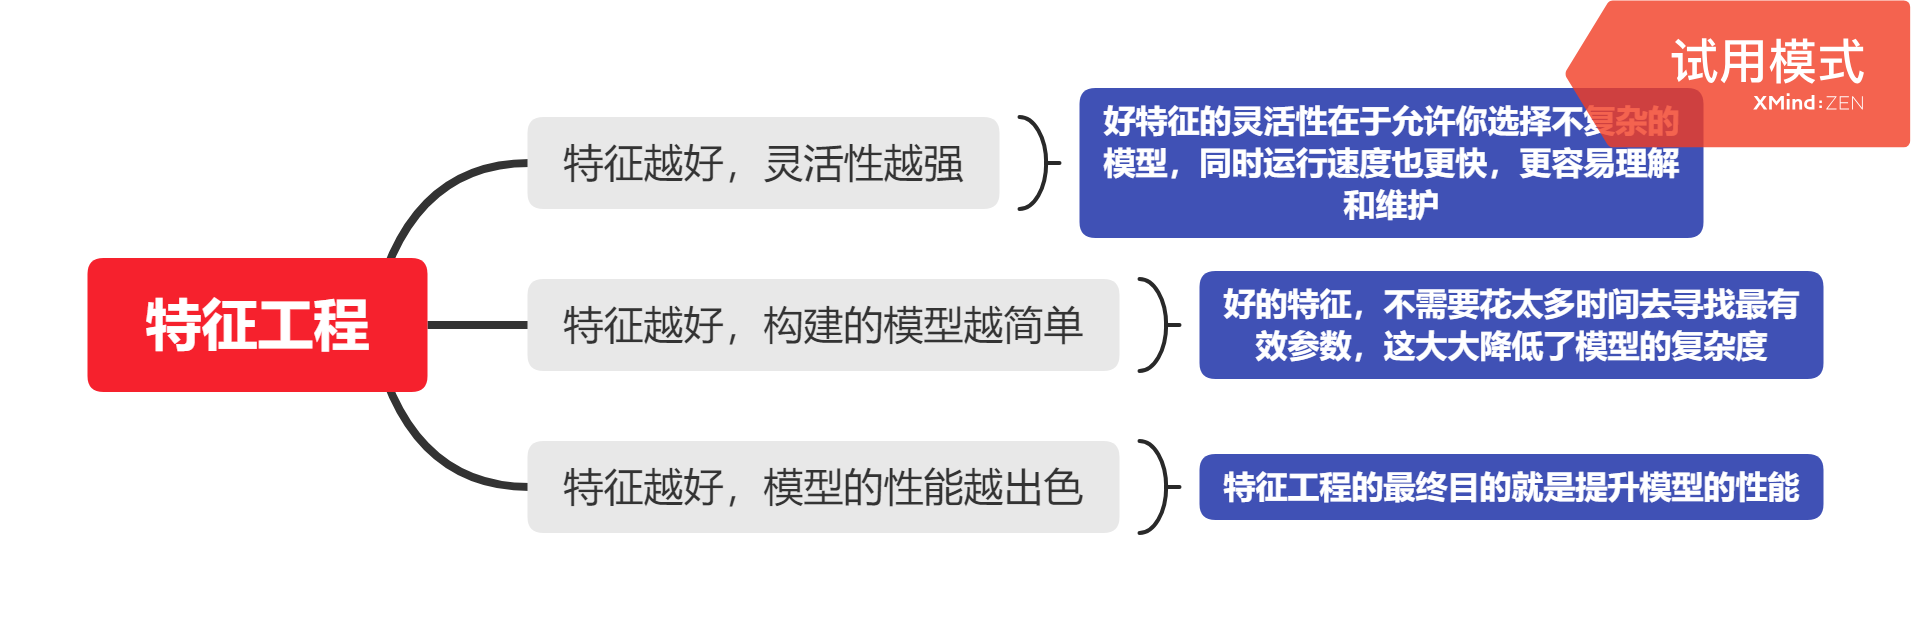
本篇是《阿里云天池大赛赛题解析-机器学习篇》的第一部分工业蒸汽量预测的第三章-特征工程的内容,并附带了一些知识点的网页链接。内有数据预处理、特征降维等内容。
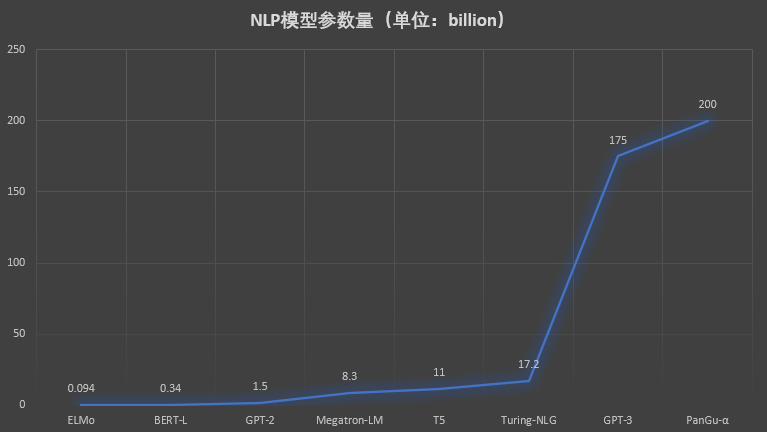
这几年深度学习的发展给人工智能相关应用的落地带来了很大的促进。随着NLP、CV相关领域的算法的发展,算法层面的创新已经逐渐慢了下来,但是工程方面的研究依然非常火热。从底层的硬件的创新,到平台框架的发展,为支撑超大规模模型训练与移动端小规模算法推断而创造的软硬件体系也在飞速革新。本文将总结深度学习平台框架软件及下层的硬件支撑系统。
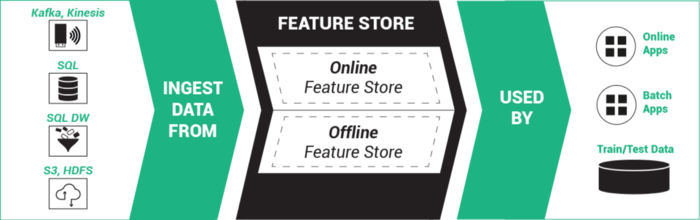
在2020年的亚马逊reInvent发布会上,亚马逊正式发布了一项新的服务,即Amazon SageMaker Feature Store,中文简介是适用于机器学习特征的完全托管的存储库。 Feature Store是这两年兴起的另一个关于人工智能系统的基础设施,应该也是未来几年最重要的人工智能基础设施之一。本文将介绍一下Feature Store是什么以及为什么很多企业开始推广这个东西。
Scikit-Learn有很优秀的机器学习处理思想,包括TensorFlow等新框架都借鉴了它的设计思想。最近的更新也让Scikit-Learn更加强大。在描述这个更新之前我们先简单看一下历史,然后让我们一起看看都有什么新内容吧。
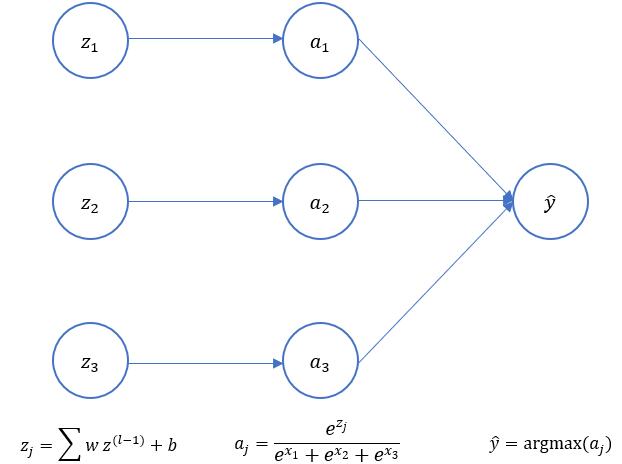
softmax作为多标签分类中最常用的激活函数,常常作为最后一层存在,并经常和交叉熵损失函数一起搭配使用。这里描述如何推导交叉熵损失函数的推导问题。
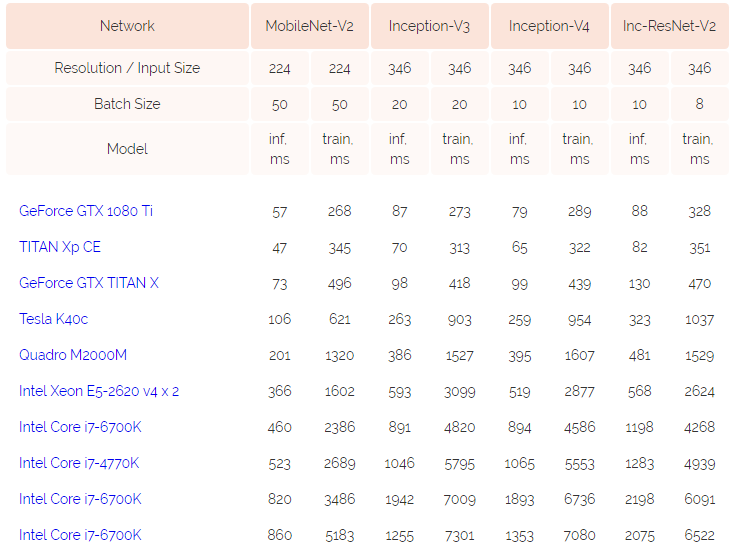
机器学习是实现人工智能最重要的方法之一,包括深度学习等都属于机器学习中的一种方法。因此,机器学习的应用被认为是实现人工智能应用的重要途径。人工智能的应用目标是使用计算机(机器)来代替或者辅助人工来完成某项任务。机器学习在解决业务问题的应用需要谨慎考虑。本文提供一些步骤可以参考。
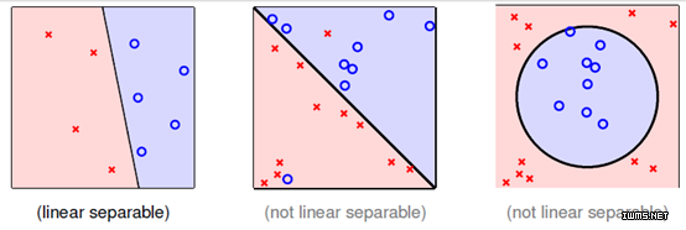
在机器学习或者深度学习中,正则项是我们经常遇到的概念。它对提高模型的准确性和泛化能力非常重要。本文详细描述了正则项的来源以及与其他概念的相关关系。
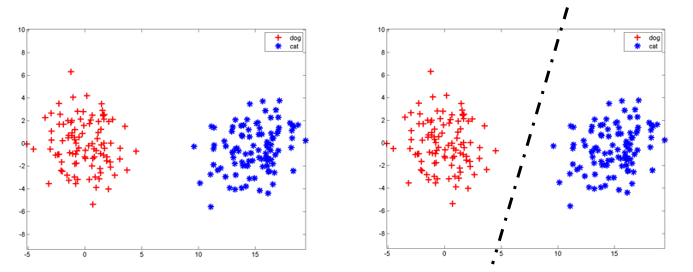
人工神经网络,简称神经网络,是一种模仿生物神经网络的结构和功能的数学模型或者计算模型。其实是一种与贝叶斯网络很像的一种算法。之前看过一些内容始终云里雾里,这次决定写一篇博客。弄懂这个基本原理,毕竟现在深度学习太火了。
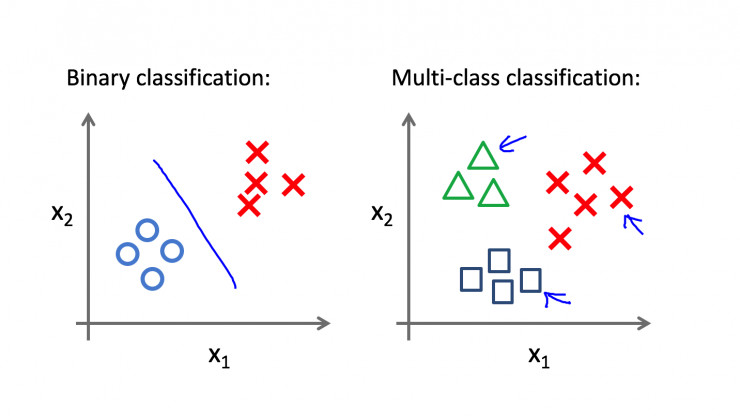
本文转自雷锋网,原文《通过从零开始实现一个感知机模型,我学到了这些》,作者:恒亮,文章转载已获授权。感知器(英语:Perceptron)是Frank Rosenblatt在1957年就职于Cornell航空实验室(Cornell Aeronautical Laboratory)时所发明的一种人工神经网络。它可以被视为一种最简单形式的前馈神经网络,是一种二元线性分类器。本文介绍了搭建感知机模型的基本操作也包含了作者的一些心得。