
如何评价大模型和AI Agent在命令行环境中执行工具解决任务的能力?Terminal Bench评测简介
Terminal-Bench是一个新兴的开源基准测试,专为评估人工智能Agent(AI Agent)在命令行终端环境中的实际操作能力而设计。它通过一系列模拟真实世界场景的复杂任务,旨在客观、可量化地衡量AI Agent在执行代码编译、服务器管理和数据处理等任务时的熟练程度与自主性。
Explore the latest AI and LLM news and technical articles, covering original content and practical cases in machine learning, deep learning, and natural language processing.
Terminal-Bench是一个新兴的开源基准测试,专为评估人工智能Agent(AI Agent)在命令行终端环境中的实际操作能力而设计。它通过一系列模拟真实世界场景的复杂任务,旨在客观、可量化地衡量AI Agent在执行代码编译、服务器管理和数据处理等任务时的熟练程度与自主性。
阿里宣布开源第三代编程大模型Qwen3-Coder-480B-A35B,该模型是Qwen3编程大模型中第一个开源的版本,同时官方还基于Google的Gemini CLI改造并开源了阿里自己的命令行编程工具Qwen Code,完全免费使用。
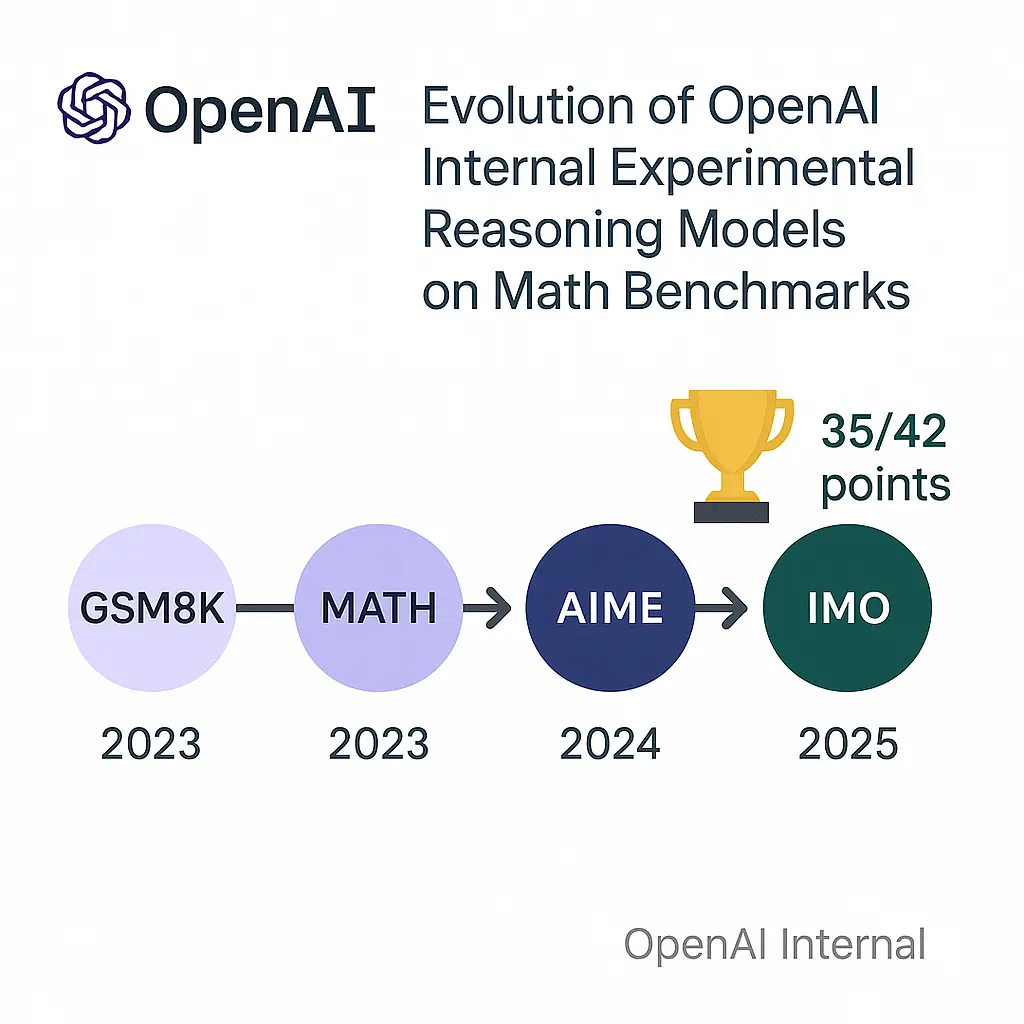
几个小时前,OpenAI的研究人员披露,其一款内部实验性的大语言模型,在模拟的国际数学奥林匹克(International Math Olympiad ,IMO)竞赛2025中取得了金牌水平的成绩。这是一个里程碑式的突破,因为IMO被认为是衡量创造性数学推理能力的巅峰,远超以往任何AI基准测试。这项成就并非通过专门针对数学的“窄”方法实现,而是源于通用人工智能研究的根本性突破,尤其是在处理难以验证的任务和长时间推理方面。
2025年7月17日,LMArena的大模型Web能力匿名竞技场出现了一个代号为anonymous-chatbot-0717的模型,而根据ChatGPT网页版的抓包显示,这个模型应该是o3家族系列的一员,其模型的api的id为“o3-alpha-responses-2025-07-17”。
OpenAI刚刚发布了一个全新的AI Agent产品,称为ChatGPT Agent。这个全新的Agent系统可以控制我们的电脑,然后使用电脑上的浏览器、PPT、Excel等工具帮我们完成一些日常的工作,从头开始帮我们完成一些非常复杂的任务。根据OpenAI的描述,这个Agent系统的目标未来是一个通用的Agent,而这些能力未来将会随着这个产品不定期更新。
Kiro 是一款AWS刚发布的、具有代理(agentic)能力的集成开发环境(IDE),它的目的是希望通过简化的开发者体验,帮助开发者从概念原型无缝过渡到生产级别的应用。它的核心理念是“规格驱动开发”(spec-driven development),以解决当前 AI 编程从有趣的原型到可靠的生产系统之间存在的鸿沟。
MTEB是一个用于评估向量大模型向量化准确性的评测排行榜。它全称为Massive Text Embedding Benchmark,是一个旨在衡量文本嵌入模型在多种任务上表现的基准测试。
Creative Writing v3 是一个用于评估大型语言模型(LLM)创意写作能力的评测基准。该基准采用混合评分系统,旨在更精确地区分不同模型,特别是顶尖模型之间的性能差异。
上周,MoonshotAI 发布了 Kimi K2,并宣布 完全开源、允许商用。发布 24 小时内,社区即完成了 MLX 移植、4-bit 量化等后续工作。外网很多人评价说,Kimi K2是另一个DeepSeek R1时刻。本文尝试以第三方视角,把Kimi开发者公开的技术讨论、社区疑问与公开配置里的数字串成一条完整的技术决策链,解释Kimi K2背后的技术决策以及他们眼中大模型创业企业的方向。
刚刚,X平台疑似泄露出GPT-5的评测结果,共四项评测结果,均排名第一。根据泄露的信息,GPT-5的评测包含2个不同的版本,分别是基础版本的GPT-5以及带推理模式的GPT-5 Reasoning。各项评测结果均大幅超越当前现有其它模型,都是第一!且都是断档领先!
Kimi K2是由Moonshot AI最新推出的旗舰级大模型,首次将开放Agentic Intelligence(自主代理智能)与强大工具调用能力有机整合。它不仅在知识推理、数学、代码等传统“非思维模型”任务上展现出全球领先的能力,还特别针对一系列实际Agentic(自动决策与操作型)任务进行了深度优化。在业内,这代表AI模型正从“只会答题”向“能自主完成复杂任务”转变。K2模型完全开源,可免费商用授权。
编程领域大模型一直是进展非常快的大模型领域。因为编程能力更强的模型,通常在逻辑思维、工具调用上有更好的表现,在很多领域,特别是Agent领域有很大的应用价值。今天法国人工智能明星公司MistralAI发布了2个全新的编程大模型,分别是Devstral Medium和 Devstral Small 1.1,后者是一个开源的240亿参数的编程大模型。
马斯克旗下的xAI公司正式发布Grok4大模型,包含Grok 4和Grok4 Heavy版本,其中Grok4 Heavy是一个Agent系统,在AIME2025(美国的数学邀请赛)得分满分,超过了所有大模型。此前透露的Grok 4 Code和视频生成能力都没有发布。
人工智能(AI)的通用智能(AGI)发展一直是研究领域的焦点。近期,由 ARC Prize 基金会推出并由 AI 研究者 François Chollet 联合发起的 ARC-AGI-2 评测基准,为衡量大模型在未知情境下的实时推理能力和学习效率提供了新的视角。
Manus AI 是一款尖端的人工智能代理程序,于 2025 年 3 月 6 日正式发布,旨在跨多个领域自主执行复杂任务,弥合人类意图与可操作结果之间的差距。它由 Butterfly Effect 开发,该公司在中国(北京和武汉)以及新加坡(BUTTERFLY EFFECT PTE. LTD.)设有运营机构。以下内容基于截至 2025 年 7 月 5 日的最新信息,涵盖其产品功能、关键技术特点及用户反馈。
Grok4是马斯克旗下大模型初创企业xAI的第四代代码,在五月份的时候,马斯克就透露他们马上要发布Grok 3.5模型,六月份的时候说这个模型效果很好,版本号就直接改为4,这中间经过多次波折,最终马斯克说Grok 4将在7月4日之后发布。截止目前,虽然xAI官方没有正式宣布Grok 4,但是目前Grok 4已经透露了很多的消息。本文将对这些信息做总结和分析。
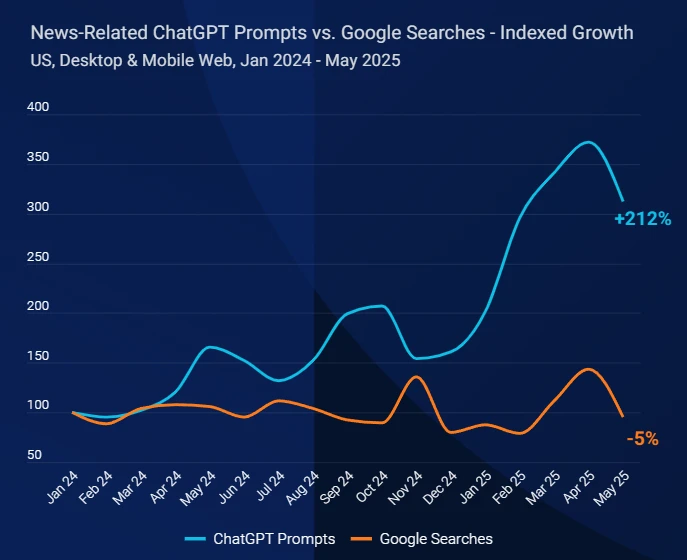
今天,SimilarWeb发布了一个全新的报告,描述了自从ChatGPT这种大模型产品发布之后,新闻出版网站的流量下滑严重,并提供了相关的分析。尽管这是针对新闻网站的报告,但是实际上所有的内容网站或者是内容生产者可能都是有影响的。我们基于这份报告进行解读,为大家提供一个参考。
GLM-4.1V-Thinking是智谱AI(Zhipu AI)与清华大学KEG实验室联合推出的多模态推理大模型。这款模型并非简单的版本迭代,而是通过一个以“推理为中心”的全新训练框架,旨在将多模态模型的能力从基础的视觉感知,推向更复杂的逻辑推理和问题解决层面。多模态理解能力接近720亿的Qwen2.5-VL-72B。
Ai2近日发布的全新评测平台——SciArena,为这一痛点带来了创新解法。此次产品不仅继承了“人类众包对比评测”的理念,更结合科学问题的独特复杂性,构建了开放、透明且可迭代的模型评测生态。
盘古大模型是华为自研的大语言模型,基于华为的硬件和技术栈进行训练。此前一直被认为是国产技术占比很高的国产大模型。今天,华为开源了2个盘古大模型,分别是MoE架构的Pangu Pro MoE模型以及70亿参数规模的Pangu Embedded模型。
今天,百度正式宣布开源其最新的旗舰级大模型系列——ERNIE 4.5。ERNIE 4.5系列模型当前包含2个多模态大模型,4个大语言模型及其不同变体的庞大家族,还区分了PyTorch版本和paddlepaddle版本,共23个模型,其核心采用了创新的异构多模态混合专家(MoE)架构,在提升多模态理解能力的同时,实现了文本处理性能的同步增强。每个版本的模型都开源了基座(Base)版本和后训练版本(不带Base)。
2025年6月26日,阿里达摩院正式发布了全新的Qwen VLo大模型。这是继QwenVL和Qwen2.5 VL后,阿里在多模态大模型领域又一具有里程碑意义的创新。Qwen VLo是一款统一的多模态理解与生成模型,不仅具备深度理解图片与文本内容的能力,更能基于这种理解实现高质量和高度一致的图像生成与编辑,真正跨越了“感知”与“创造”的界限。
昨天,Anthropic公布了一项引人注目的实验——Project Vend。他们让旗下的大模型Claude Sonnet 3.7在一个真实的办公环境中,自主经营一家小型自动化商店,为期约一个月。这个实验的目标是探索,在不久的将来,AI模型在真实经济体中自主运行任务的可行性、潜在的成功模式以及那些出人意料的失败方式。实验结果非常强大,也充满了令人深思的细节!
腾讯发布并开源了其混元大模型系列的新成员Hunyuan-A13B。该模型定位为一个基于细粒度专家混合(MoE)架构的大语言模型。其主要特点是高效率和可扩展性,旨在为开发者和研究人员,特别是在资源受限的环境中,提供高级推理和通用应用能力。Hunyuan-A13B是由原来的微软的WizardLM团队成员打造,评测结果超Qwen2.5-72B和Qwen3-A22B