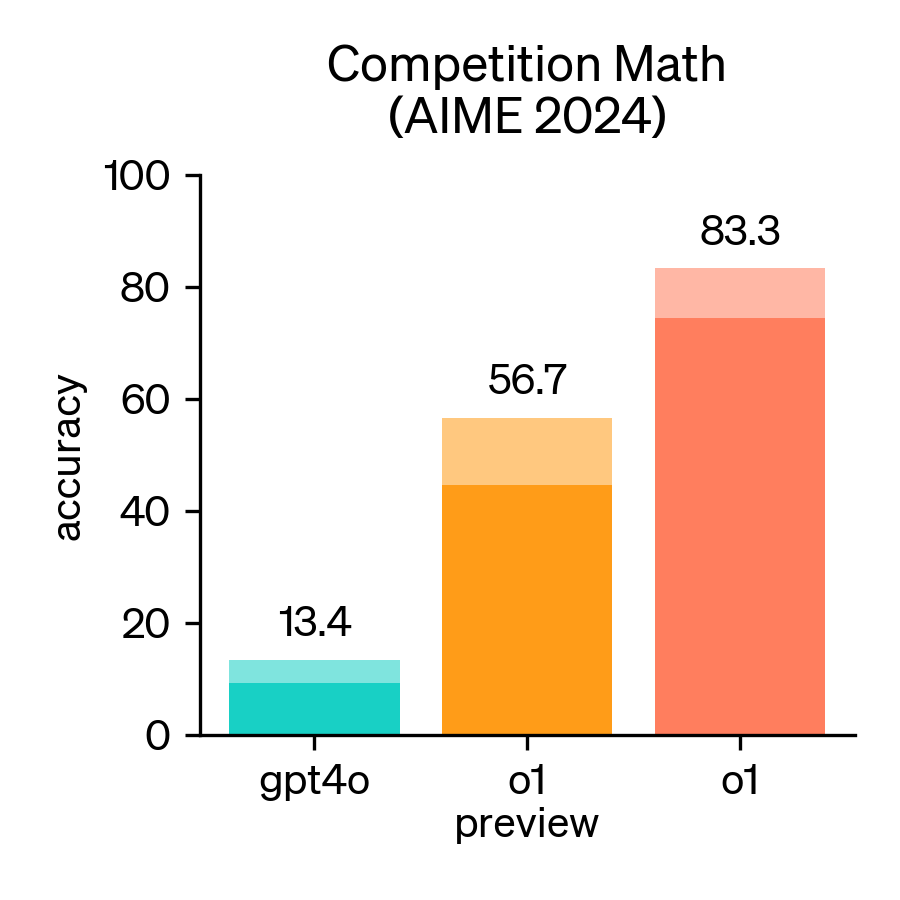
DataLearner logo
Original Blog

Original AI Tech Blogs

Explore the latest AI and LLM news and technical articles, covering original content and practical cases in machine learning, deep learning, and natural language processing.

神秘的图片生成和编辑大模型Nano Banana是什么?背后是Google吗?什么时候发布?能否颠覆Adobe

神秘的图片生成和编辑大模型Nano Banana是什么?背后是Google吗?什么时候发布?能否颠覆Adobe

最近,一个代号 “Nano Banana” 的神秘图像生成与编辑大模型突然在社交网络上掀起风暴。与之前所有模型截然不同,它似乎拥有「记忆面孔」的魔法:无论角度、光影如何变化,人物的面容始终一致;它还能读懂照片里的故事,精准捕捉场景氛围,并服从多步骤、高复杂度的指令。然而,它像幽灵一样没有身世——没有官方文档,没有作者署名,甚至没有一行技术白皮书。极致的神秘感与惊人的效果形成巨大反差,像磁铁般吸住了整个社区的目光:它究竟出自谁手?能力边界到底在哪儿? 本文会介绍一下这个模型当前已知的信息,以及如何使用。

2025/08/24 16:43:541,584
Aider Benchmark:面向代码编辑的大模型评测基准全解析

Aider Benchmark:面向代码编辑的大模型评测基准全解析

Aider 是一个在终端里进行结对编程的开源工具。为评估不同大模型在“按照指令对代码进行实际可落地的编辑”上的能力,Aider 提出并维护了公开基准与排行榜,用于比较模型在无人工干预下完成代码修改任务的可靠性与成功率。该评测已被多家模型提供方在技术说明中引用,用作代码编辑与指令遵循能力的对照指标。

来自OpenAI官方的GPT-5编码提示词优化实践:6 条“更懂开发者”的提示工程技巧

来自OpenAI官方的GPT-5编码提示词优化实践:6 条“更懂开发者”的提示工程技巧

GPT-5 在指令遵循和推理能力上比前代更强,但也因此更“敏感”:如果规则里有冲突或表述过度强硬,模型往往会卡壳或输出异常。为此,OpenAI 发布了面向开发者的 《GPT-5 for Coding》技巧小抄,其中总结了使用 GPT-5 进行编程与代码生成时最实用的六条经验。这些技巧与普通的“写作提示工程”不同,它们专门针对软件开发场景:如何写规则、怎样控制推理强度、如何避免模型“想太多”,以及怎样利用 GPT-5 的新特性把它真正驯化成可靠的结对编程伙伴。本文对这六条技巧逐条进行解释总结。

2025/08/16 21:48:20830
GPT-5 模式与配额全解析:自动与手动 Thinking 的区别、不同用户的使用配额问题等

GPT-5 模式与配额全解析:自动与手动 Thinking 的区别、不同用户的使用配额问题等

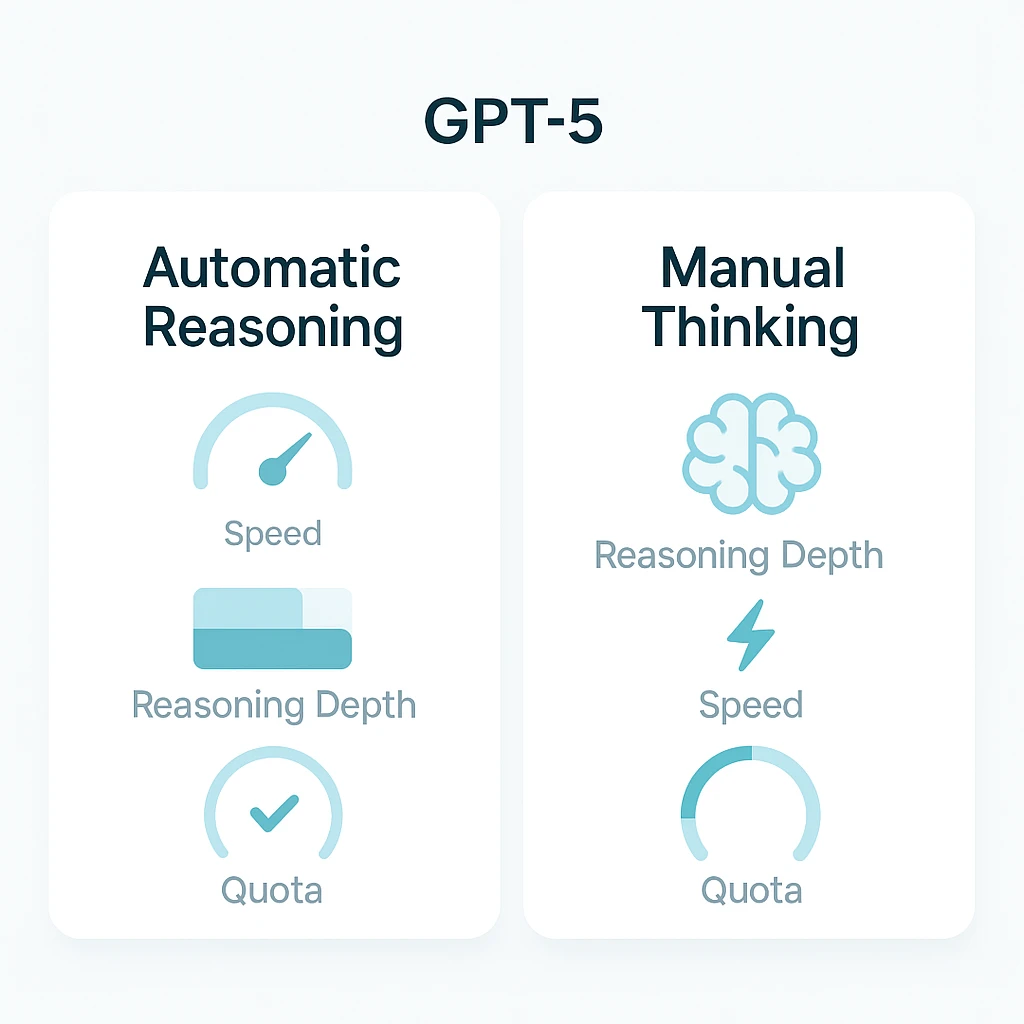
GPT-5 在 ChatGPT 中引入了“自动在普通/推理间切换”的机制,但模式命名、配额规则和速率限制让许多用户困惑。本文梳理不同模式的作用、是否计入推理配额、各订阅层的可用性与限制、旧模型的替换规则,并提供三步配额优化策略。特别提示:编码与大上下文任务应优先使用 GPT-5 Thinking(≈196k 上下文),而普通 Chat 模式上下文为 32k。

2025/08/12 22:51:123,598
IOI(International Olympiad in Informatics):从世界顶级算法竞赛到大语言模型的新基准

IOI(International Olympiad in Informatics):从世界顶级算法竞赛到大语言模型的新基准

在衡量大语言模型(LLM)智能水平的众多方法中,除了常见的常识推理、专业领域测评外,还有一个正在兴起且极具挑战性的方向——算法问题求解。在这一领域,几乎没有哪项比赛能比 国际信息学奥林匹克(International Olympiad in Informatics,简称 IOI) 更具权威性与含金量。

智谱AI发布GLM-4.5V多模态推理模型

智谱AI发布GLM-4.5V多模态推理模型

智谱AI刚刚开源了新一代视觉-语言模型(Vision-Language Model, VLM)——GLM-4.5V。该模型基于其旗舰文本基础模型GLM-4.5-Air(总参数量1060亿,激活参数量120亿),延续GLM-4.1V-Thinking的技术路线,在42项公开视觉多模态基准测试中,在同规模模型中实现领先性能。GLM-4.5V面向图像、视频、文档理解以及GUI任务等常见多模态场景,采用Mixture-of-Experts(MoE)架构,并保持开源。

2025/08/11 23:28:481,121
大模型评测基准AIME 2024介绍

大模型评测基准AIME 2024介绍

2024年,美国数学邀请赛(AIME)成为评估大型语言模型(LLM)数学推理能力的重要基准。AIME是一项备受尊崇的考试,包含15道题,考试时间为3小时,旨在考察美国顶尖高中生在各类数学领域的复杂问题解决能力。

2025/08/11 16:56:235,681
SWE-bench Verified:提升 AI 模型在软件工程任务评估中的可靠性

SWE-bench Verified:提升 AI 模型在软件工程任务评估中的可靠性

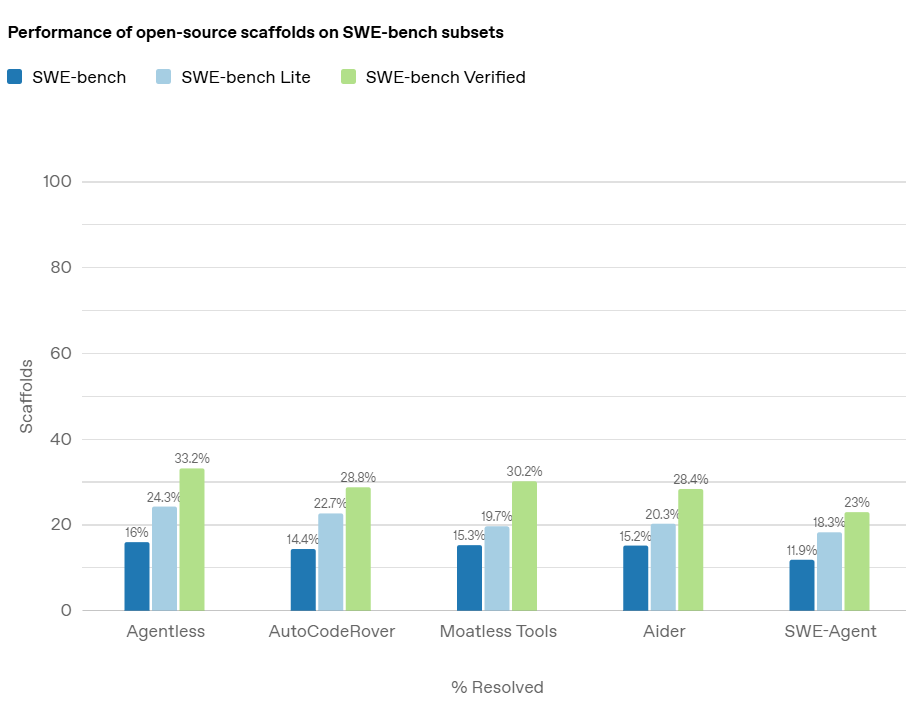
在人工智能领域,随着大型语言模型(LLMs)在各类任务中的表现不断提升,评估这些模型的实际能力变得尤为重要。尤其是在软件工程领域,AI 模型是否能够准确地解决真实的编程问题,是衡量其真正应用潜力的关键。而在这方面,OpenAI 推出的 *SWE-bench Verified* 基准测试,旨在提供一个更加可靠和精确的评估工具,帮助开发者和研究者全面了解 AI 模型在处理软件工程任务时的能力。

2025/08/11 16:54:152,167
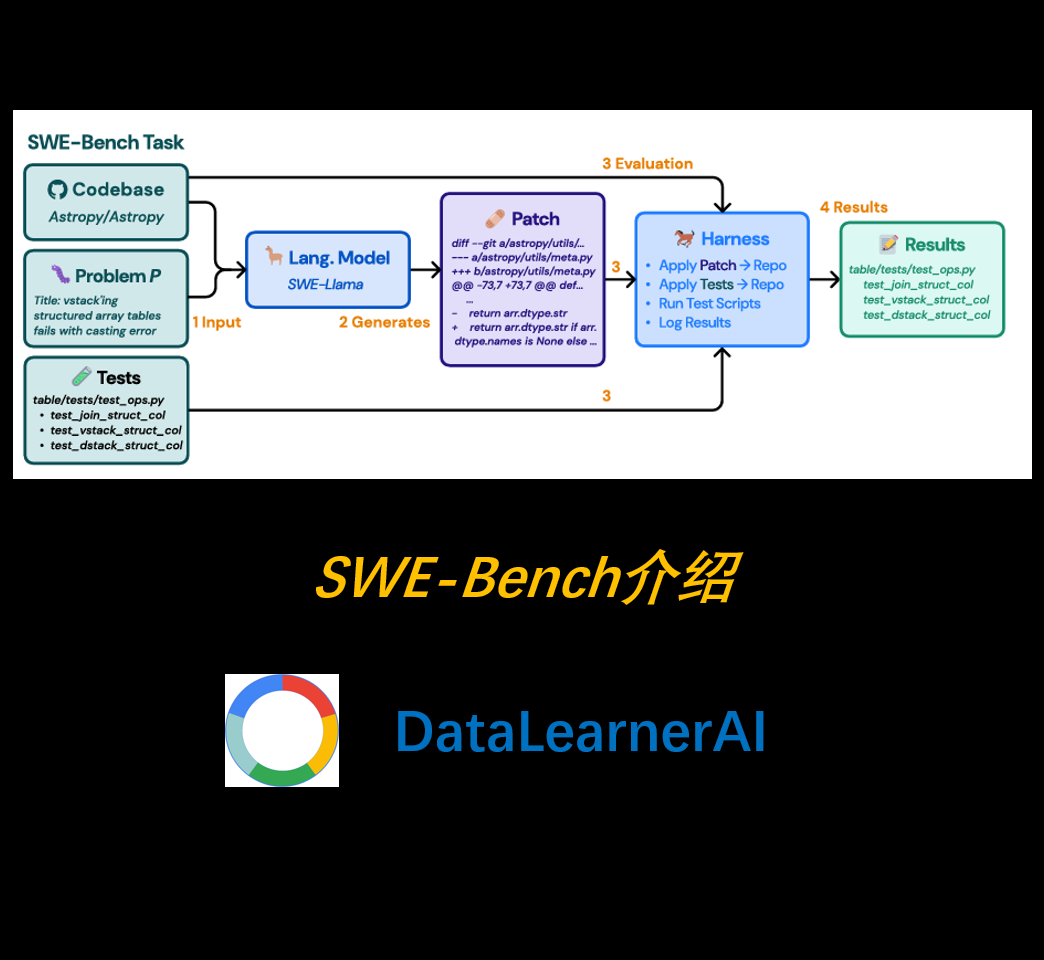
SWE-bench大模型评测基准介绍:测试大模型在真实软件工程任务中的能力

SWE-bench大模型评测基准介绍:测试大模型在真实软件工程任务中的能力

随着大语言模型(LLM)的快速发展,它们在自然语言处理(NLP)、代码生成等领域的表现已达到前所未有的高度。然而,现有的代码评测基准(如 HumanEval)通常侧重于**自包含的、较短的代码生成任务**,而未能充分模拟真实世界的软件开发环境。为弥补这一空白,研究者提出了一种全新的评测基准——**SWE-Bench**,旨在测试 LLM 在**真实软件工程问题**中的能力。

xAI发布Grok Imagine功能,一条文本命令即可生成图片和最长达15秒的视频,也可以基于现有照片生成视频,免费用户也可以使用~

xAI发布Grok Imagine功能,一条文本命令即可生成图片和最长达15秒的视频,也可以基于现有照片生成视频,免费用户也可以使用~

Grok Imagine 是一个由 xAI 开发的创新功能,集成到 Grok AI 聊天机器人中,旨在让用户能够从文本和视觉命令快速生成图像和视频。Grok Imagine最大的特点是能够生成长达 15 秒的视频,带有同步音频,使其成为 OpenAI 的 Sora 和 Google 的 Veo 3 等工具的直接竞争者。此外,它还包括一个“Spicy”模式,允许生成成人或显式内容,这一点引发了伦理和潜在误用的争议。

2025/08/08 22:07:142,436
OpenAI Harmony 消息格式技术详解:一种为高级 Agent 设计的精细化消息格式

OpenAI Harmony 消息格式技术详解:一种为高级 Agent 设计的精细化消息格式

近日,OpenAI在发布其开源模型gpt-oss-120b和gpt-oss-20b的同时,也推出了一种专为这些模型设计的全新消息格式——Harmony。对于希望在自有解决方案中充分利用这些开源模型的开发者而言,理解Harmony至关重要。本文将以客观的第三方视角,详细解析Harmony格式的设计理念与技术细节。

Simple Bench:一个专为“常识”而生的大模型评测基准

Simple Bench:一个专为“常识”而生的大模型评测基准

随着大型语言模型(LLM)的飞速发展,如何准确、全面地评估它们的能力成为了一个日益重要的课题。在众多评测基准中,Simple Bench 以其独特的定位脱颖而出,它专注于检验模型在日常人类推理方面的能力,而在这些方面,当前最先进的模型往往还不如普通人。本文将详细介绍 Simple Bench 评测基准,探讨其出现的背景、设计理念、评测流程以及当前主流模型的表现。

2025/08/07 09:34:05836
大模型评测基准Codeforces:代码生成能力的终极试金石

大模型评测基准Codeforces:代码生成能力的终极试金石

随着大型语言模型(LLM)能力的飞速发展,如何科学、准确地评估其性能,特别是深度的逻辑推理和代码生成能力,已成为人工智能领域的一大挑战。传统的评测基准在面对日益强大的模型时,逐渐暴露出数据污染、难度不足、无法有效评估真实推理能力等问题。在这一背景下,一个旨在检验模型竞赛级编程水平的评测基准——Codeforces应运而生,为我们提供了一个更严苛、更接近人类程序员真实水平的竞技场。

谷歌发布Genie 3:一个可以生成720P开启实时交互式虚拟世界生成新纪元

谷歌发布Genie 3:一个可以生成720P开启实时交互式虚拟世界生成新纪元

谷歌DeepMind发布了一个全新的大模型——Genie 3,这是一个能够根据文本描述生成多样化、可实时交互虚拟世界的通用世界模型。目前,Genie3可以生成几分钟的720P的视频,且每秒24帧左右。用户也可以在生成的视频中实时交互控制。从谷歌官方的视频看,这个Genie 3模型生成的视频和游戏世界的质量很高,非常令人心动!

2025/08/05 23:17:111,221
重磅!阿里开源媲美GPT-4o的图片生成和编辑大模型Qwen Image,中文渲染能力很强,还有精确的文字控制,免费开源!

重磅!阿里开源媲美GPT-4o的图片生成和编辑大模型Qwen Image,中文渲染能力很强,还有精确的文字控制,免费开源!

就在刚才,阿里开源了Qwen Image大模型,这是阿里千问团队开源的高质量图片生成和编辑的大模型。这份发布迅速在AI社区引起了广泛关注,其核心并非又一个单纯追求图像美学或真实感的模型,而是直指一个长期存在的行业痛点:在图像中进行复杂、精准、尤其是高保真的多语言文本渲染。

2025/08/05 08:23:391,392
大模型评测SimpleVQA全方位深度解析,直击多模态模型“事实幻觉”

大模型评测SimpleVQA全方位深度解析,直击多模态模型“事实幻觉”

随着多模态大语言模型(MLLM)在各个领域的应用日益广泛,一个核心问题浮出水面:我们如何信赖它们生成内容的准确性?当模型需要结合图像和文本进行问答时,其回答是否基于事实,还是仅仅是“看似合理”的幻觉?为了应对这一挑战,一个名为SimpleVQA的新型评测基准应运而生,旨在为多模态模型的事实性能力提供一个清晰、可量化的度量衡。

2025/08/01 15:49:57540
Zhipu AI重磅发布GLM-4.5系列:技术深度解析与多维度性能评测

Zhipu AI重磅发布GLM-4.5系列:技术深度解析与多维度性能评测

7月28日,智谱AI(Zhipu AI)向开源社区投下了一枚重磅炸弹,正式发布了其最新的旗舰模型系列:GLM-4.5。该系列包含两个新成员——GLM-4.5和GLM-4.5-Air,两者均以开源权重形式提供。官方技术报告详细阐述了其设计理念、技术细节以及在多项基准测试中的表现。本次发布的核心目标是打造一个能够统一推理、代码和Agent智能体能力的模型,以应对日益复杂的AI应用需求。本文将深入解析这份官方报告,剖析其核心技术、性能表现,并探讨其在当前大模型竞争格局中的战略定位。

2025/07/29 11:06:251,776
阿里发布Qwen3小幅更新版本,放弃混合思考模式,发布全新的2个版本Qwen3-235B-A22B-2507模型,1/5的参数,性能直逼Kimi K2,推理模式版本评测结果接近o3

阿里发布Qwen3小幅更新版本,放弃混合思考模式,发布全新的2个版本Qwen3-235B-A22B-2507模型,1/5的参数,性能直逼Kimi K2,推理模式版本评测结果接近o3

阿里今天开源了一个Qwen3-235B-A22B模型的小幅更新版本,命名为Qwen3-235B-A22B-Thinking-2507,这是一个只支持带推理过程的模型,而四天前,阿里还开源了Qwen3-235B-A22B-Instruct-2507,一个不支持推理过程的模型。这2个版本模型去除了Qwen3此前的一个模型的混合架构模式(即一个模型同时支持thinking和non-thinking),而是拆分成2个不同的版本。阿里官方说这是从社区获得了反馈之后决策的。

2025/07/26 08:22:251,581