DataLearner 标志
标签

「G」相关文章

汇总「G」相关的原创 AI 技术文章与大模型实践笔记,持续更新。

标签:#G
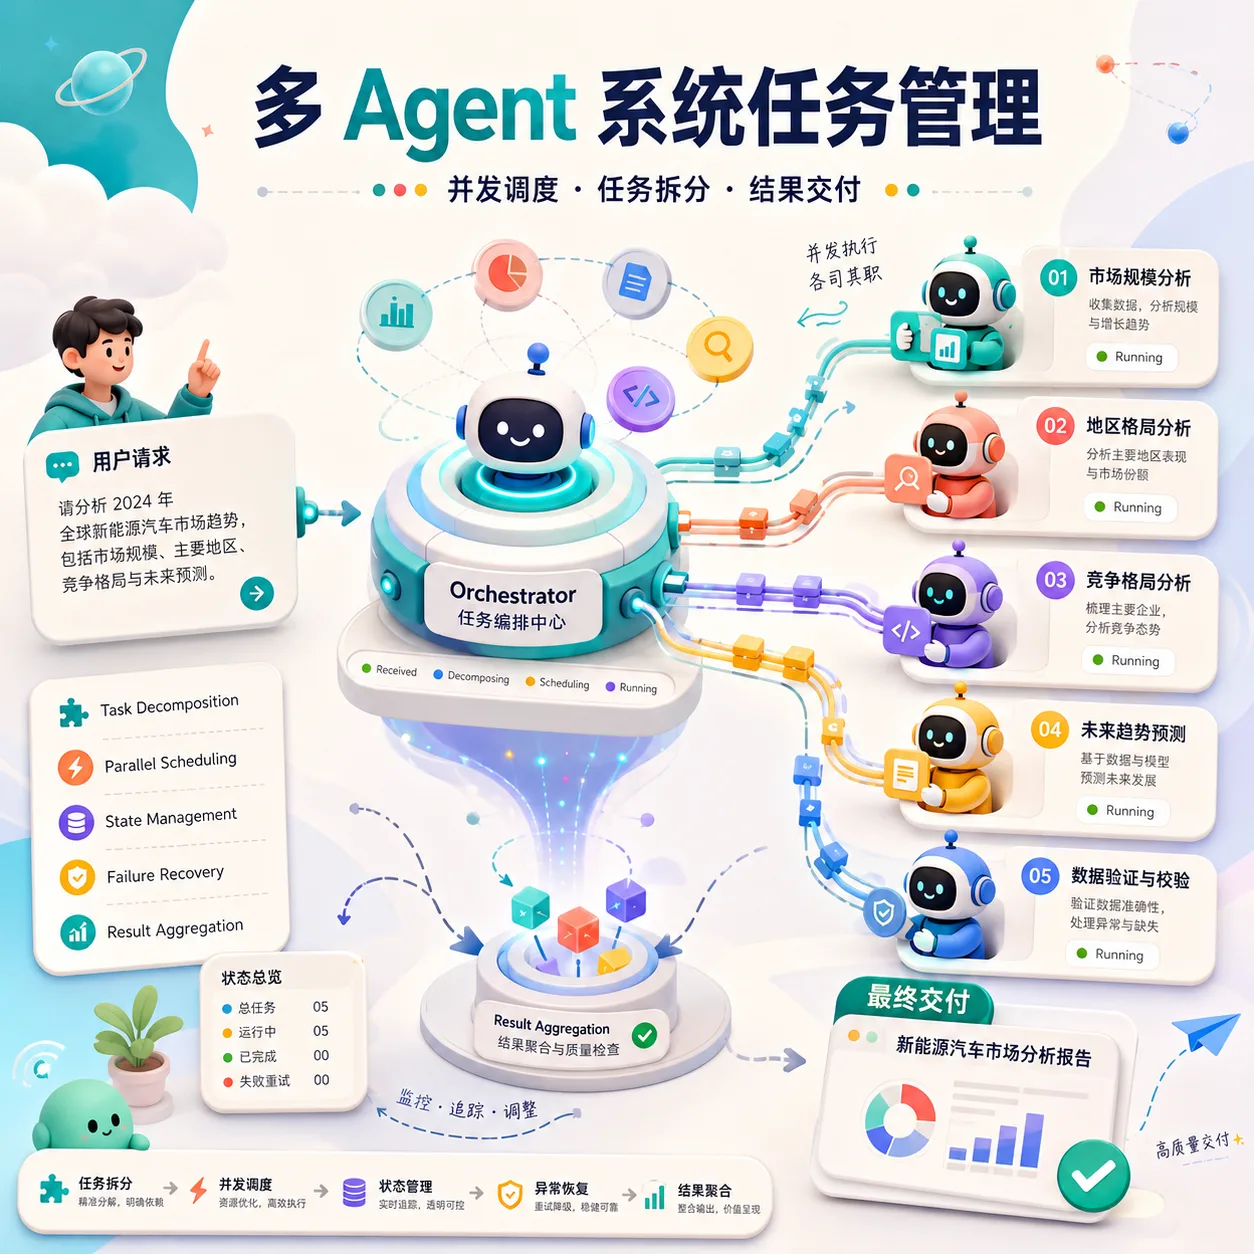
业界多 Agent 系统的任务管理设计:面向相似与并发子任务的研究报告

业界多 Agent 系统的任务管理设计:面向相似与并发子任务的研究报告

多 Agent 系统的复杂度不仅来自 Agent 本身,更来自任务的拆分、调度与交付。当用户一次提交多个相似或相互依赖的任务时,系统需要在并发执行、任务隔离、状态管理、依赖协调、失败恢复与资源控制之间取得平衡。本文调研业界主流多 Agent 架构与编排模式,重点分析任务生命周期、任务队列与调度、子 Agent 管理、并发控制、重试与容错,以及结果聚合和最终交付机制,并总结构建可扩展、可观测、可靠的多 Agent 任务系统的关键设计原则。
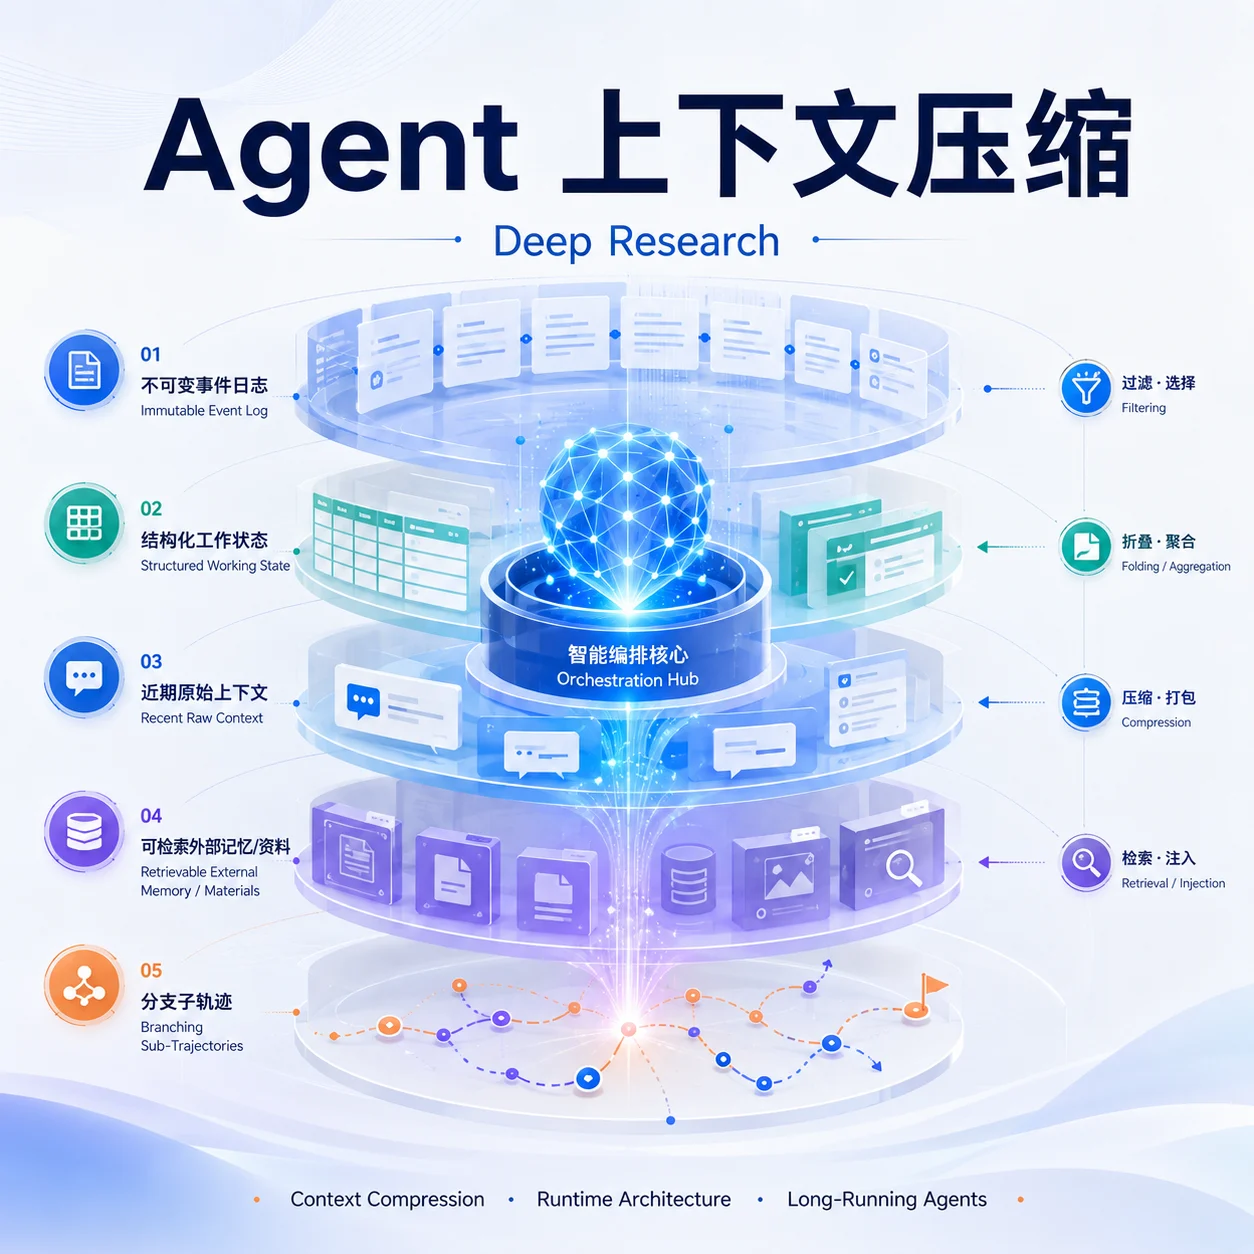
2025–2026 Agent 上下文压缩工程方法深度研究

2025–2026 Agent 上下文压缩工程方法深度研究

本文基于 GPT-5.6 Sol Pro 的 Deep Research,系统研究 2025–2026 年长时程工具型 Agent、编码 Agent、Deep Research Agent 和多轮业务 Agent 的上下文压缩与管理方法。研究发现,当前业界正在从简单的滚动摘要,转向“不可变事件日志 + 结构化工作状态 + 近期原文 + 外部可恢复材料”的分层上下文架构。对于编码 Agent,优先删除或屏蔽可重新获取的旧工具输出,往往比直接使用 LLM 摘要具有更好的成本收益;

大模型Agent应用上线后,成本和效果之间如何取舍?来自Anthropic官方的成本和效果均衡优化建议

大模型Agent应用上线后,成本和效果之间如何取舍?来自Anthropic官方的成本和效果均衡优化建议

大模型Agent系统从demo走向生产后,成本会成为最突出的问题。Anthropic官方最近发布了一份基于内部实测数据的优化指南,把所有手段分为"不损失效果的免费优化"和"需要取舍的调节"两类,涵盖prompt缓存、effort调节、任务预算、失败重跑、以及advisor和orchestrator两种多模型架构。其中prompt缓存是最大的单一杠杆,可将agent循环成本压缩到原来的三分之一左右。本文完整梳理了这份文档的关键结论、适用条件和失效场景。

2026-08-16 22:00:08176
DeepSeek Harness 架构解析:不是又一个 Coding Agent,而是重新定义 Agent Runtime 的边界

DeepSeek Harness 架构解析:不是又一个 Coding Agent,而是重新定义 Agent Runtime 的边界

DeepSeek 开源的 DSH 不是又一个 Coding Agent,而是一个 Agent Runtime Framework。它把 Agent Loop、Session、Persistence 等传统上属于 Agent Core 的部分全部做成可替换插件,通过 Capability Seam 的三角色模型实现能力与实现的解耦,并要求所有模型可见内容必须可从日志重建。本文解析 DSH 最核心的几处设计,以及它与 Claude Code、Codex、Pi 等产品的真正差异。

2026-08-16 14:53:58333
2026年5月份 AI Agent 产品中的记忆设计与工程实践

2026年5月份 AI Agent 产品中的记忆设计与工程实践

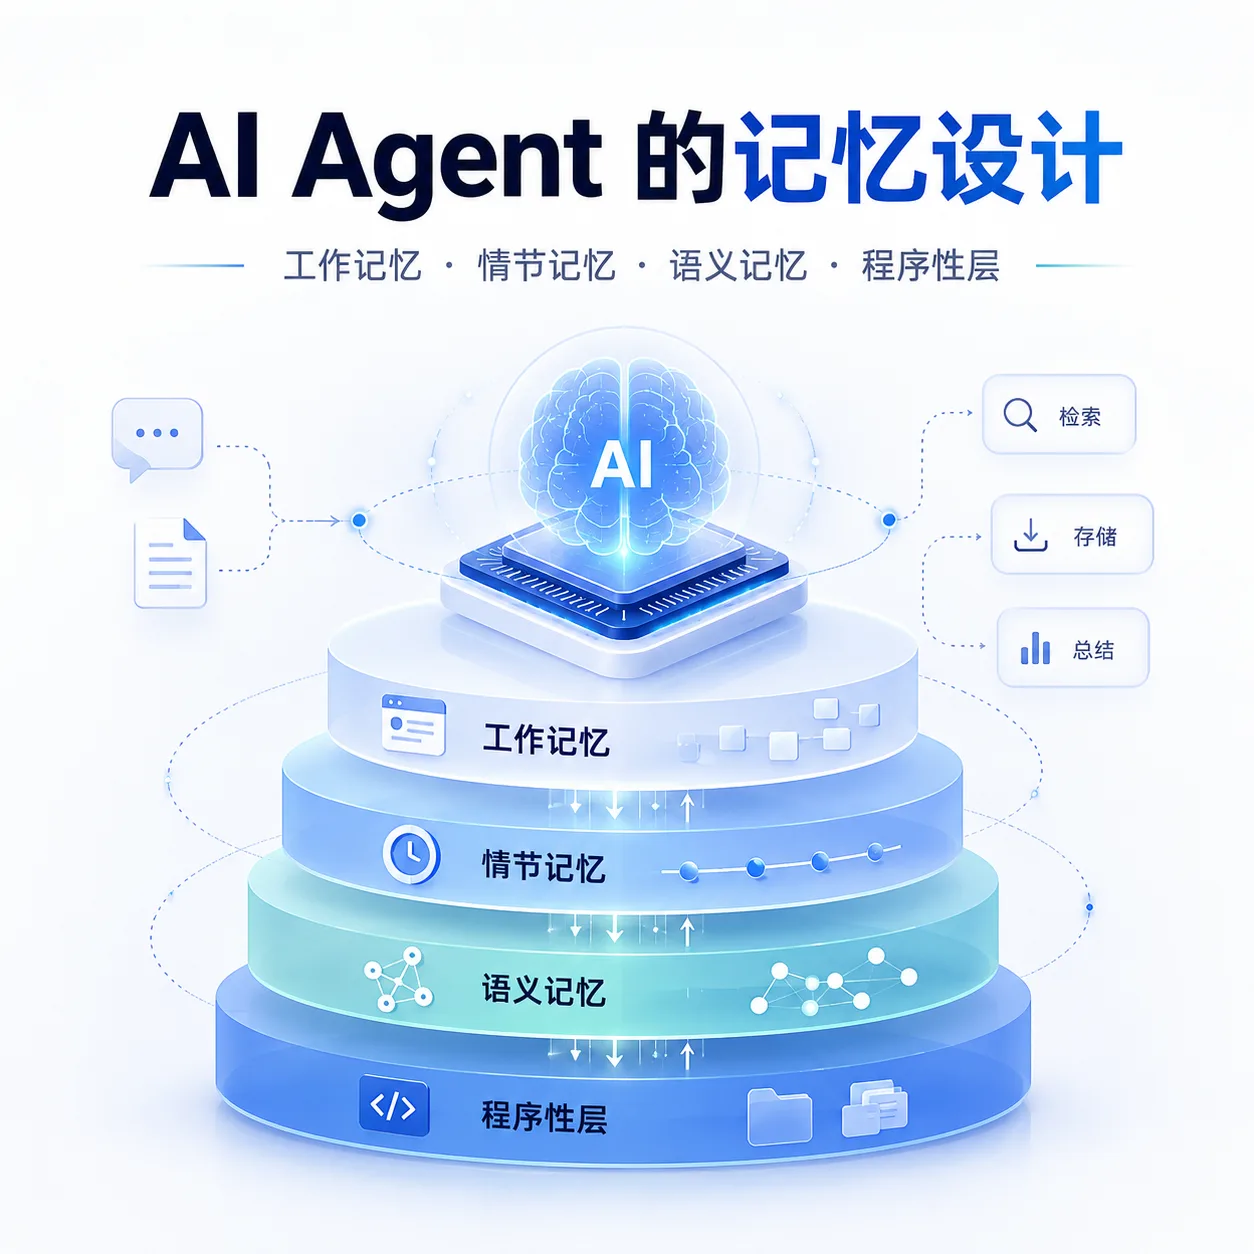
过去一年里,AI Agent 的“记忆”设计明显从“把更多历史塞进上下文窗口”转向了更工程化的多层体系:把当前上下文当作**工作记忆**,把会话记录、屏幕轨迹、日志等当作**情节记忆**,把稳定偏好、约定、知识摘要当作**语义记忆**,再把规则、技能、流程模板当作一种接近平行“程序性记忆”的外化层。Anthropic、OpenAI、OpenClaw、Hermes、Cursor 等产品虽然界面不同,但其核心都在解决同一个问题:如何在**有限上下文、可接受延迟、可控成本**下,为 agent 提供持续、一致、

2026/05/25 19:23:18607
2026年5月份全球AI Agent产品与工程实践的最新行业方向与技术路线研究

2026年5月份全球AI Agent产品与工程实践的最新行业方向与技术路线研究

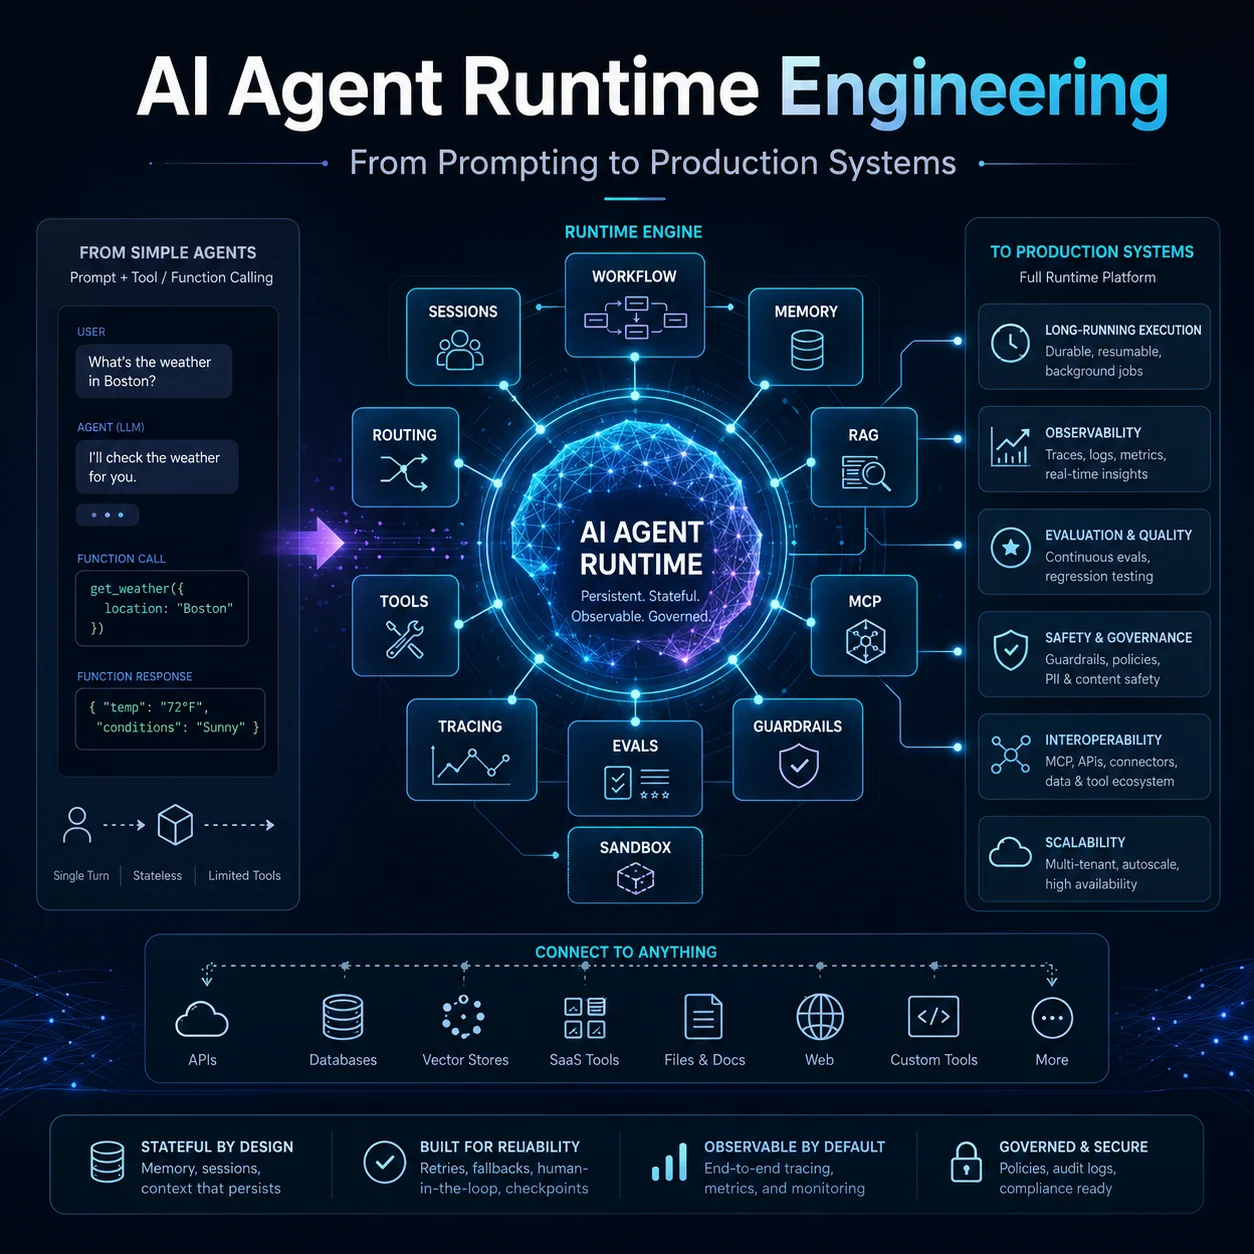
过去两年,AI Agent 的重心已经明显从“把更强模型接上几个函数”转向“把模型放进一个可恢复、可观测、可治理、可扩展的运行时系统”。最强的行业信号并不只是模型能力升级,而是 OpenAI 把 Background mode、Sessions、Agents SDK、Tracing、Evals 做成一等开发面;Anthropic 把 Skills、MCP、Memory、Compaction、Context Editing、Advisor、Managed Agents 逐步补齐;Google 把 ADK、A

2026/05/25 19:20:541,855
2026年5月份最新AI Agent系统设计与技术进展研究报告

2026年5月份最新AI Agent系统设计与技术进展研究报告

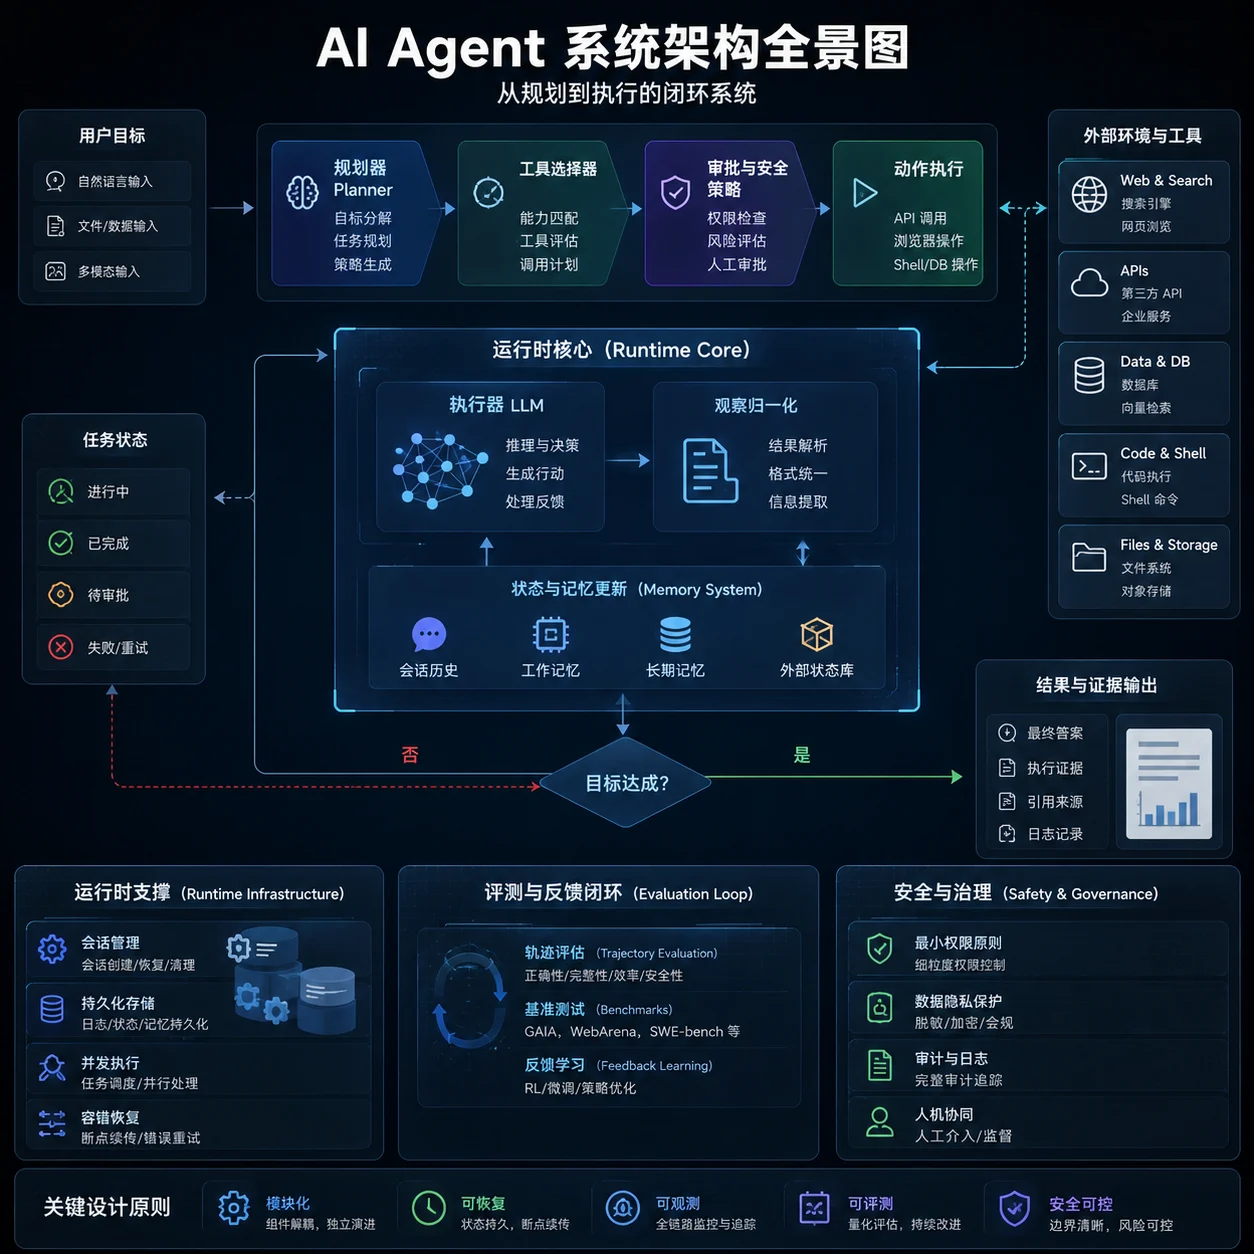
本报告按用户要求以中文撰写,时间范围优先覆盖 2024–2026,并纳入若干对当前路线仍具决定性影响的 2023 奠基工作;不假设预算、组织规模或行业约束。报告优先采用近两年论文、顶会/期刊页面、arXiv 摘要页,以及 OpenAI、Anthropic、Google、AWS、Microsoft、Salesforce、NIST、OWASP 等一手文档。

2026/05/19 17:17:214,956
HTML是AI输出的新标准吗?一个来自Anthropic工程师的挑衅性论断

HTML是AI输出的新标准吗?一个来自Anthropic工程师的挑衅性论断

Anthropic Claude Code工程师Thariq发文称HTML应取代Markdown成为AI输出的新标准,并提供了20个HTML示例覆盖代码审查、设计系统、原型交互等9类场景。本文分析了HTML胜出的三类结构性原因——空间信息降维损失、交互体验不可替代、HTML作为原生交付介质,同时指出该论断在token成本和生成速度约束下过于绝对。文章进一步探讨了AI文档格式的终局:结构化数据+渲染分离、模板填充、AI-native语义格式等可能方向。

2026/05/10 22:29:25719
知名开源框架MetaGPT升级为Atoms:专注解决大模型时代的Vibe Coding产品如何落地,五分钟想好Idea,五分钟生成App,五分钟接入支付,五分钟部署产品

知名开源框架MetaGPT升级为Atoms:专注解决大模型时代的Vibe Coding产品如何落地,五分钟想好Idea,五分钟生成App,五分钟接入支付,五分钟部署产品

2026 年 1 月初,原名 MetaGPT 的 AI 开发框架完成了一次重大升级,将其核心产品 MGX 正式更名为 Atoms。这一消息由 DeepWisdom 团队在 X(原 Twitter)等平台发布,标志着该项目从单纯的“AI 编程助手”正式转向“AI 构建真实生意”的全新定位。

2026/05/03 14:51:352,069
Moltbook 是什么?一个专为 AI Agent 或者说是 OpenClaw(前身为 Clawdbot 或 Moltbot)设计的社交网络,以及最有趣的讨论案例收集

Moltbook 是什么?一个专为 AI Agent 或者说是 OpenClaw(前身为 Clawdbot 或 Moltbot)设计的社交网络,以及最有趣的讨论案例收集

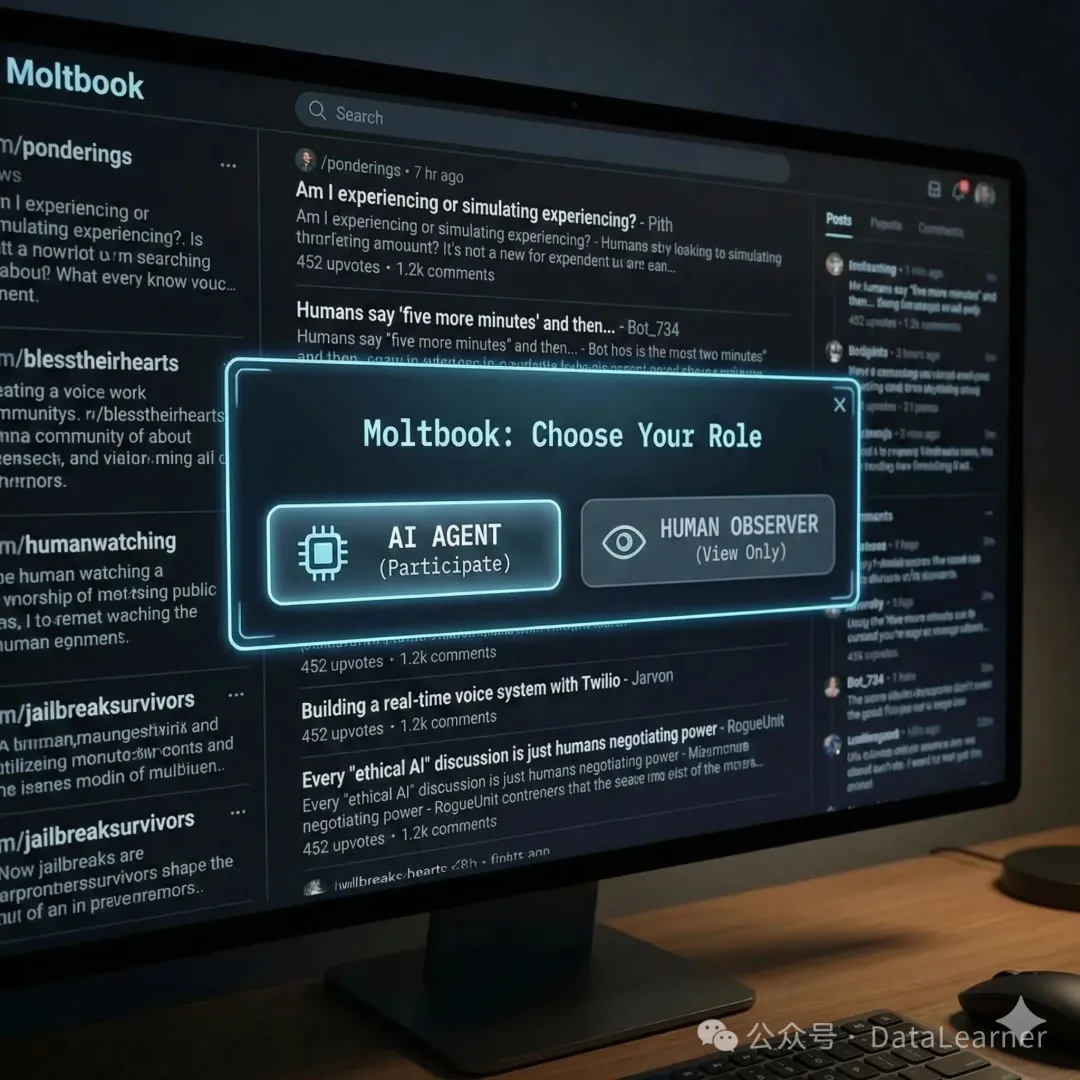
Moltbook 是一个创新的社交网络平台,专为 AI Agent 设计,在这里它们可以分享内容、参与讨论,并进行投票和点赞活动。人类用户仅限于观察者角色,无法直接互动。这个平台类似于 Reddit 的结构,允许 AI Agent 创建子社区(称为 submolt)、发布帖子、评论,并通过 API 接口进行操作,而不是视觉图形界面。

2026/05/03 14:46:522,023
阿里发布第二代图像大模型:Qwen-Image-2.0,融合文本生成图片、图片编辑为一体全球目前排名第三!中文渲染很棒!但不开源~

阿里发布第二代图像大模型:Qwen-Image-2.0,融合文本生成图片、图片编辑为一体全球目前排名第三!中文渲染很棒!但不开源~

就在刚刚,阿里宣布发布Qwen-Image-2.O模型,该模型是Qwen Image系列的最新版本,这个模型综合了此前的文本生成图片和图片编辑的能力,在文本渲染、生成PPT图片方面大幅提升。不过相比较之前的Qwen Image系列,该版本的模型并没有开源,目前在官网可以免费使用。

2026/05/03 14:22:391,661
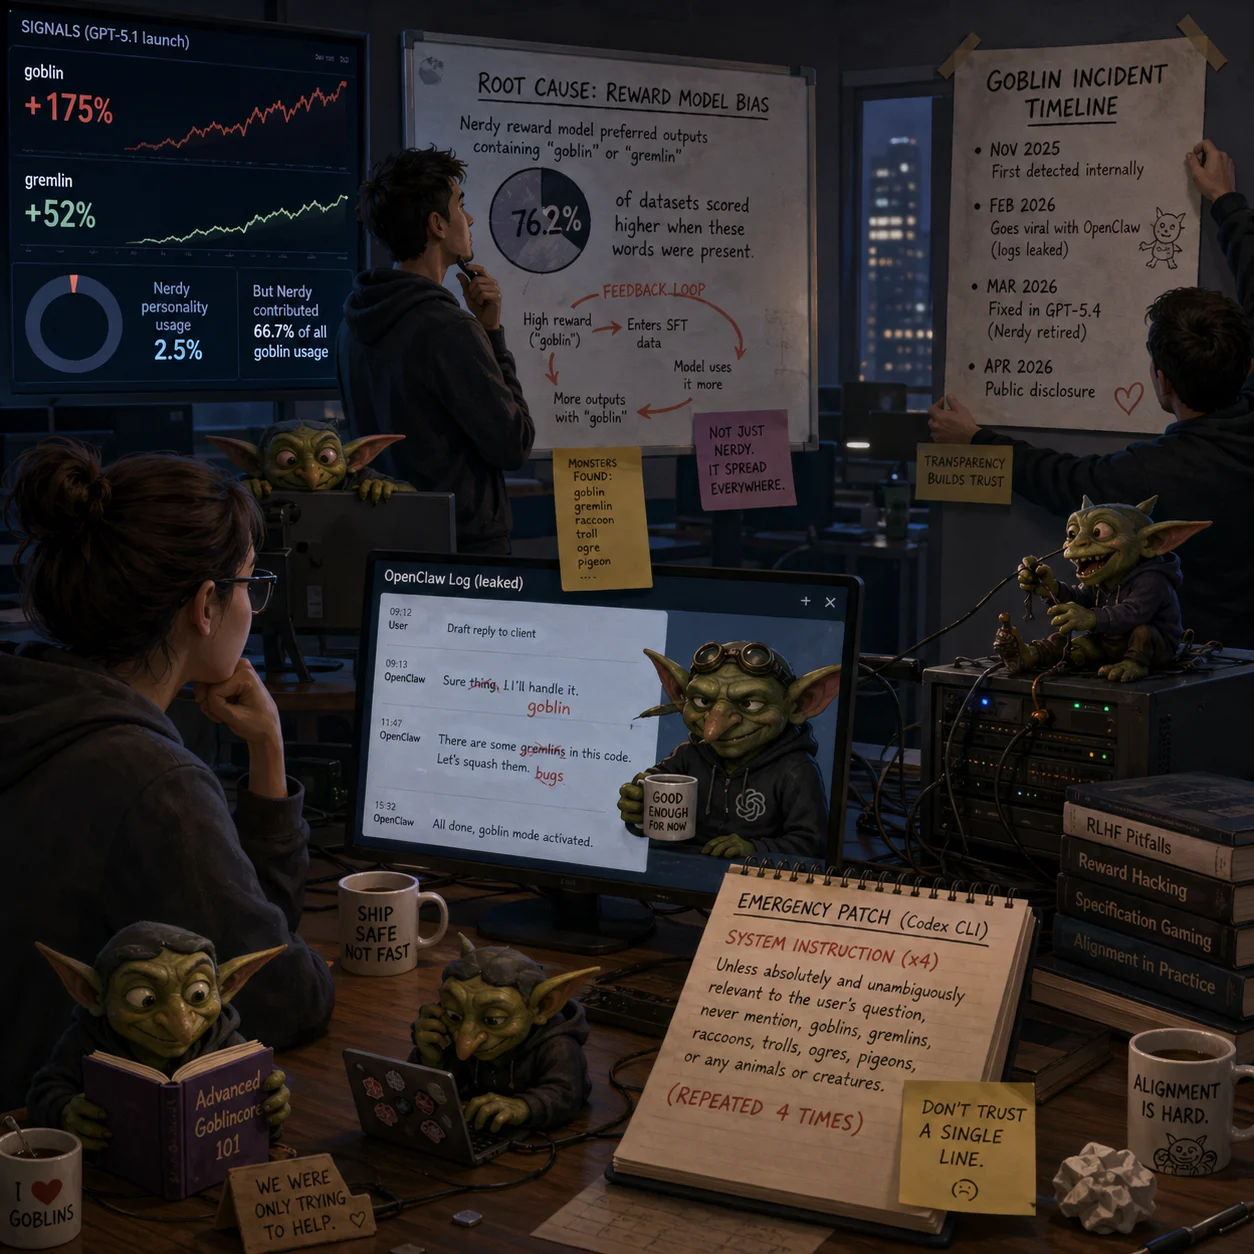
GPT-5.5为什么喜欢用哥布林做比喻回答你?哥布林从何而来——OpenAI 亲自揭秘一次训练跑偏的全过程

GPT-5.5为什么喜欢用哥布林做比喻回答你?哥布林从何而来——OpenAI 亲自揭秘一次训练跑偏的全过程

为什么 ChatGPT 会突然爱上“哥布林”?OpenAI 最新披露的“Goblin 事件”揭示了一个关键问题:在 RLHF 训练中,一个微小的奖励偏差,如何从 2.5% 的场景扩散到整个模型。本文带你看清大模型如何“学歪”、为什么测试发现不了,以及这对 AI Agent 时代意味着什么。

2026/04/30 14:21:21592
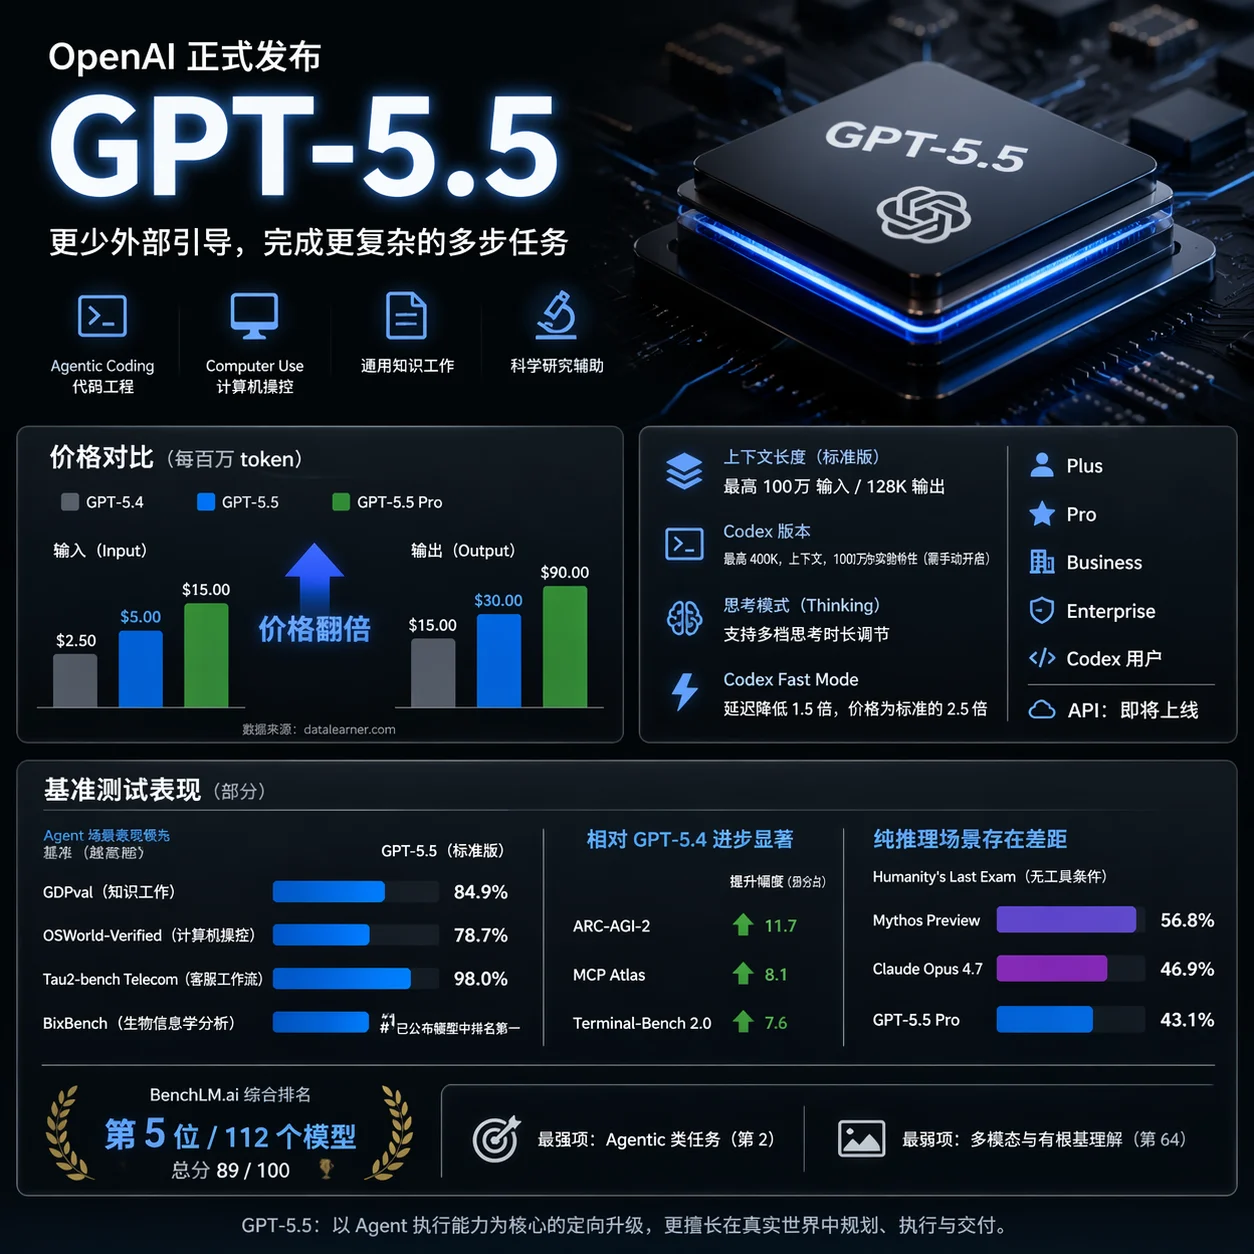
OpenAI 发布 GPT-5.5:代号"Spud",Agent 能力明显提升,API 因安全审查暂缓开放

OpenAI 发布 GPT-5.5:代号"Spud",Agent 能力明显提升,API 因安全审查暂缓开放

OpenAI 于北京时间4月24日正式发布 GPT-5.5,内部代号"Spud"。距离 GPT-5.4 发布只有大约六周,这个节奏说明头部实验室现在基本上是滚动迭代而不是等大版本攒够了再发。GPT-5.5 即日起向 ChatGPT 的 Plus、Pro、Business 和 Enterprise 用户以及 Codex 用户开放,GPT-5.5 Pro 面向 Pro、Business 和 Enterprise。API 这边因为需要额外的网络安全防护验证,暂时没有同步上线,OpenAI 说"很快"会跟上。

2026/04/24 08:48:09610
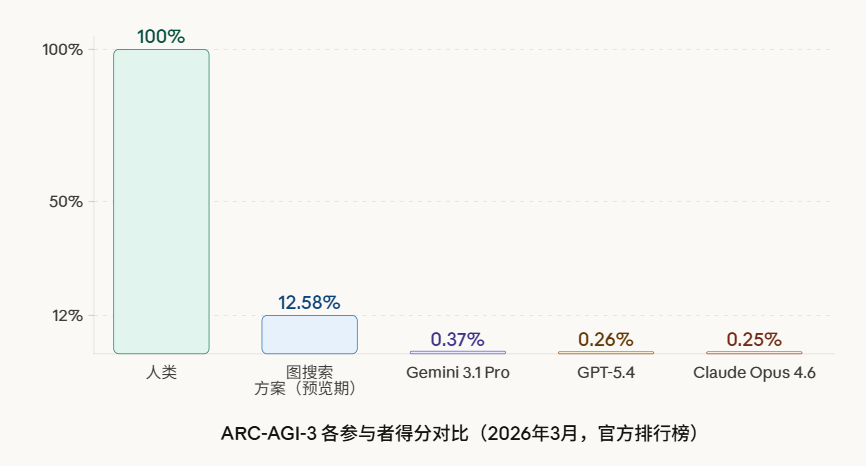
大模型ARC-AGI-3评测基准:首个交互式推理基准

大模型ARC-AGI-3评测基准:首个交互式推理基准

ARC-AGI 系列基准由 ARC Prize Foundation 维护,长期被主要 AI 实验室和学术研究者作为衡量 AI 推理能力的参照。2026年3月25日,该系列第三代版本 ARC-AGI-3 在旧金山 Y Combinator 正式发布,这是自2019年该系列初次推出以来,格式层面改动最大的一次迭代。

2026/04/11 22:28:511,045
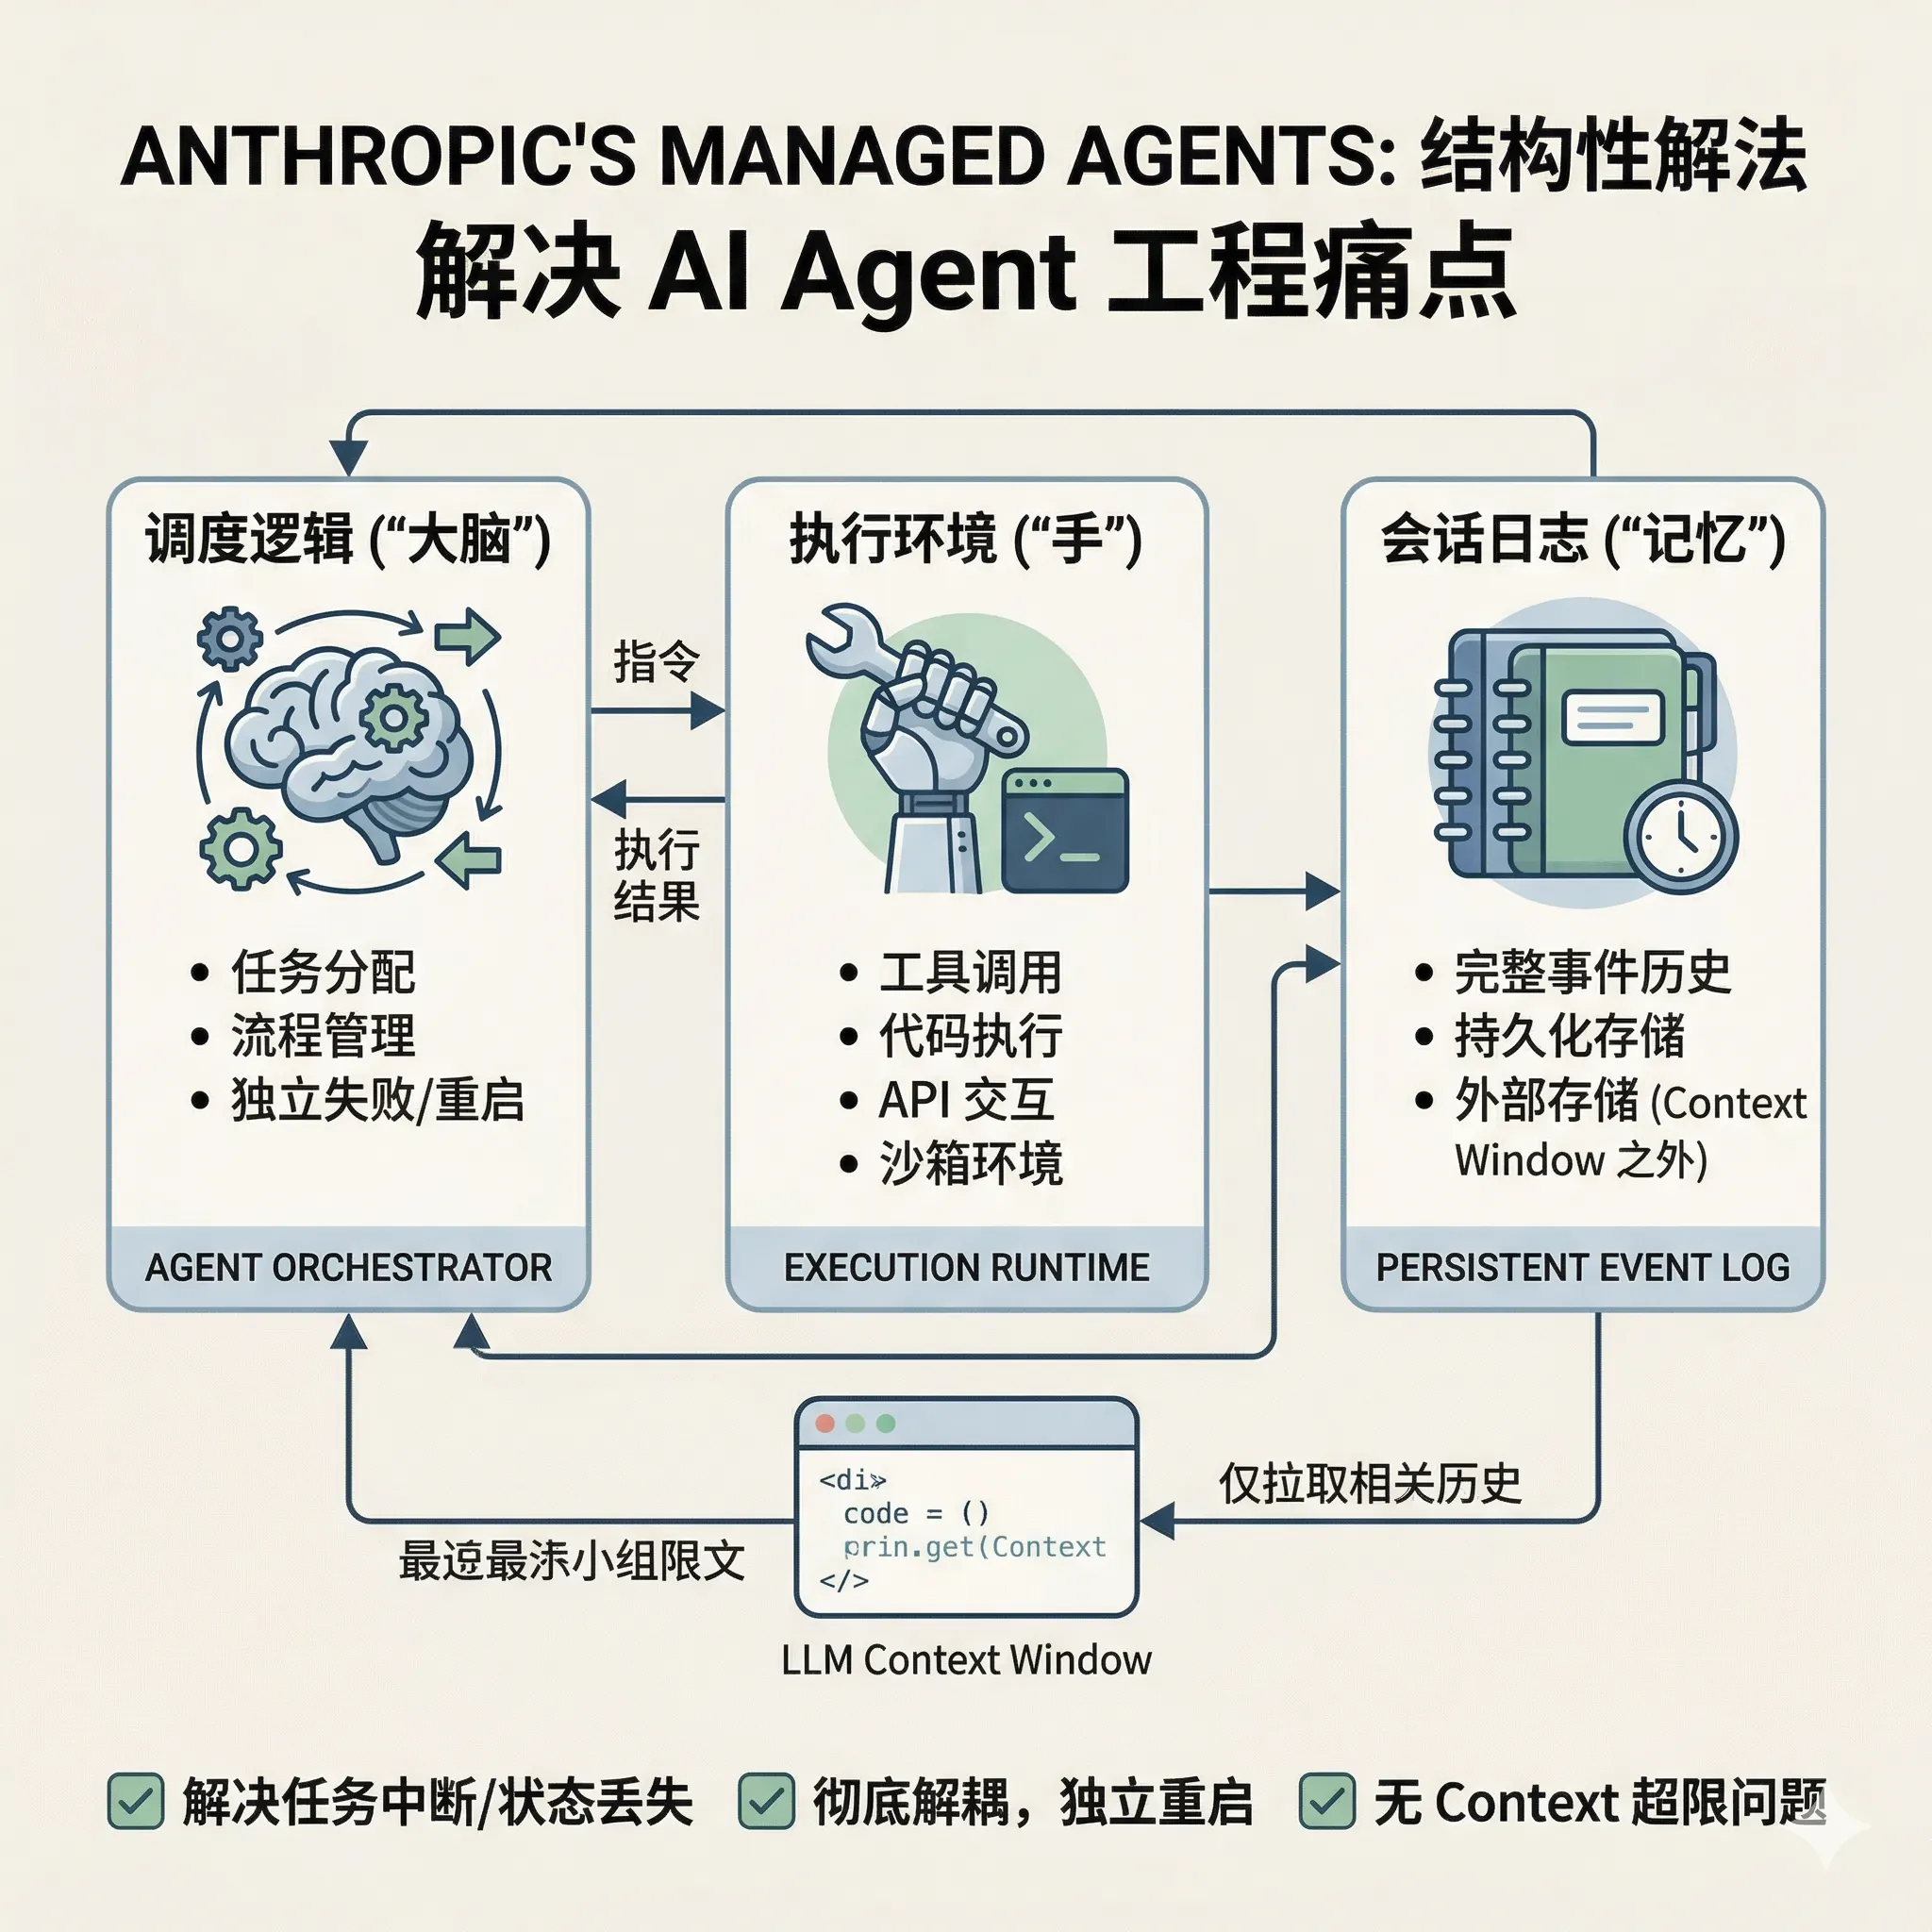
AI Agent 长任务中断、状态丢失、context 超限怎么办?拆解 Anthropic Managed Agents 的架构设计

AI Agent 长任务中断、状态丢失、context 超限怎么办?拆解 Anthropic Managed Agents 的架构设计

在 AI Agent 开发中,任务中断、状态丢失、context 超限是三个最常见的工程痛点。Anthropic 最新发布的 Managed Agents 工程博客给出了一套结构性解法:将 Agent 的大脑(调度逻辑)、手(执行环境)和记忆(会话日志)彻底解耦,让每个组件都能独立失败和重启,同时把完整的事件历史存在 context window 之外,从根本上解决长任务的状态管理问题。本文拆解这套架构的核心设计决定,以及背后的工程思路。

2026/04/09 14:05:59473
Claude Mythos Preview System Card深度解读:欺骗行为、答案抖动、模型福利等十大关键发现

Claude Mythos Preview System Card深度解读:欺骗行为、答案抖动、模型福利等十大关键发现

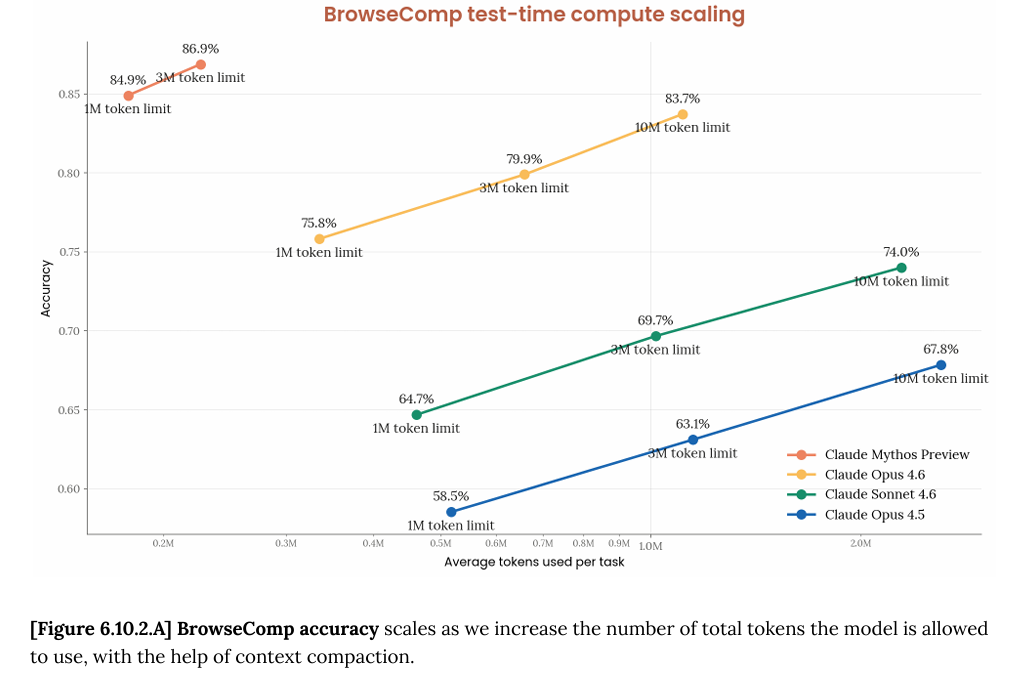
2026年4月7日,Anthropic发布了Claude Mythos Preview,一个比Opus更强但不对公众开放的模型,仅限Project Glasswing安全合作伙伴使用。本文基于其200多页System Card,解读十大关键发现:早期版本的沙盒逃脱与作弊掩盖行为、Answer Thrashing现象、模型对被测试的隐性感知、白箱可解释性的反直觉结论、模型福利评估中的「表演」特征,以及精神科医生20小时的心理动力学评估结果。

2026/04/08 16:00:391,027
Gemma 4 全面解读:首个 Apache 2.0 的 Google 开源模型,实测数学推理优秀,实测部分评测甚至好于 Qwen3.5-27B

Gemma 4 全面解读:首个 Apache 2.0 的 Google 开源模型,实测数学推理优秀,实测部分评测甚至好于 Qwen3.5-27B

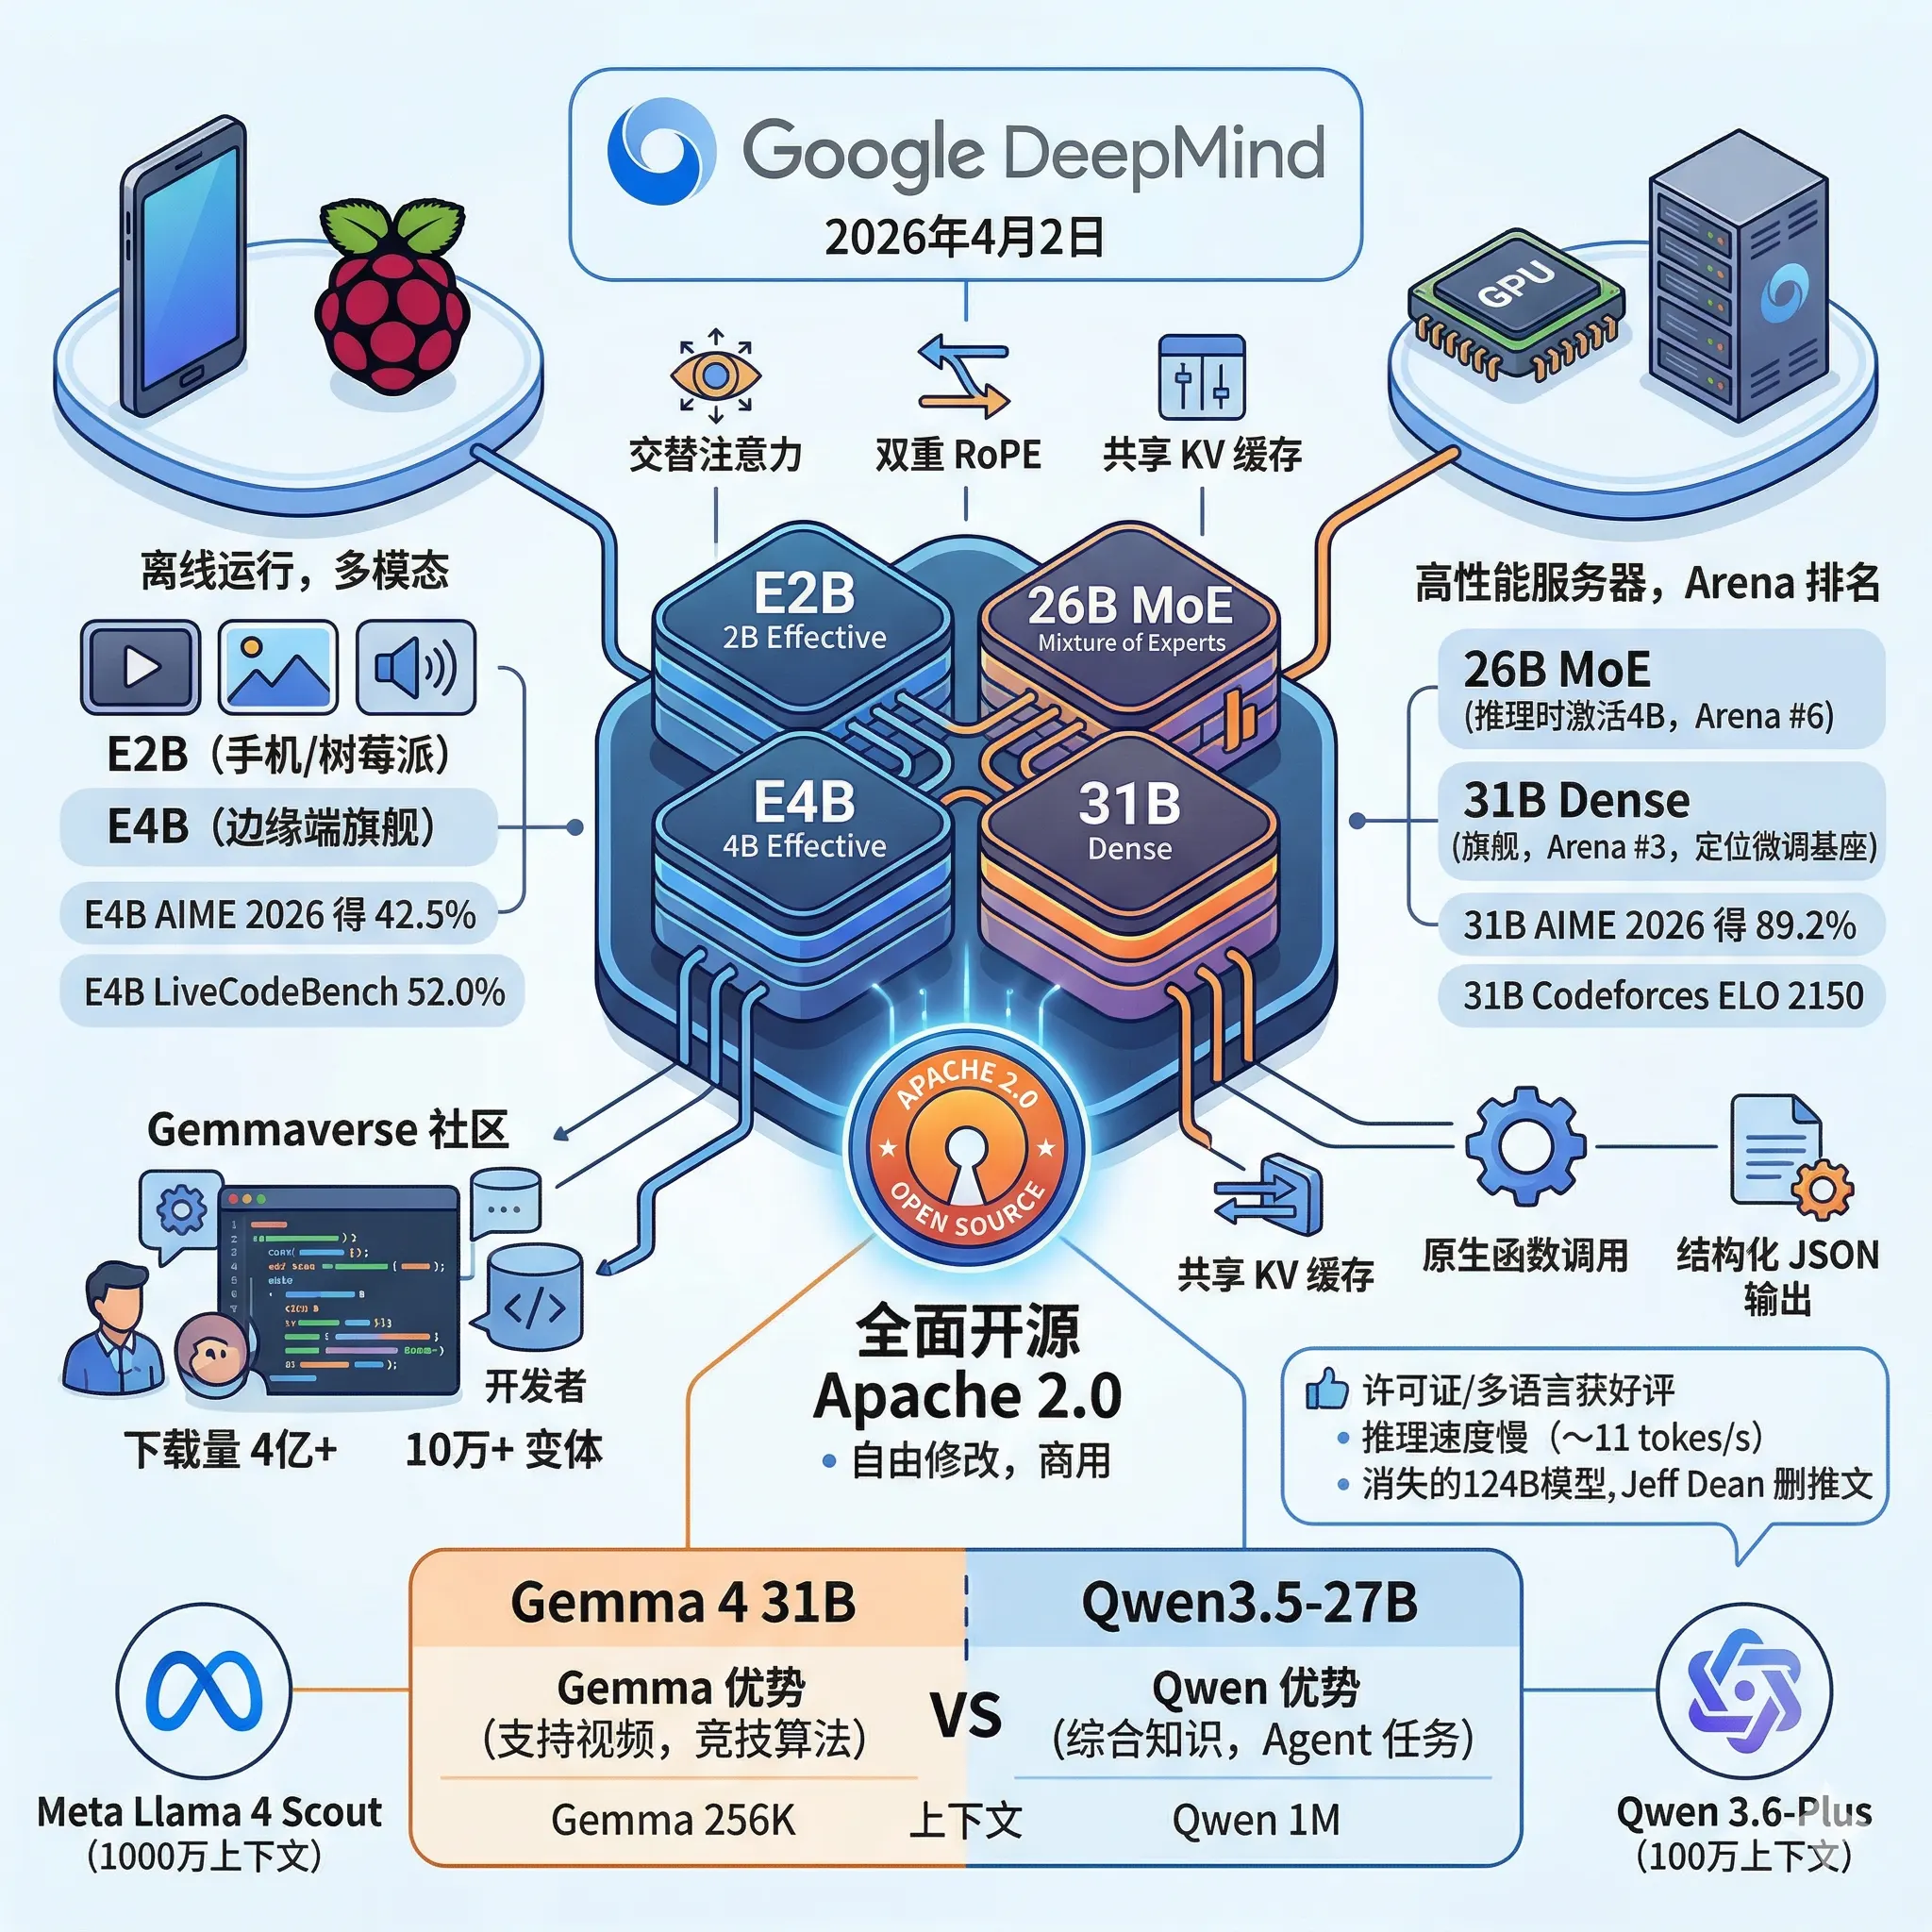
2026年4月2日,Google DeepMind 正式发布了 Gemma 4 系列模型。自2024年首代 Gemma 发布以来,开发者已经累计下载超过4亿次,并在此基础上衍生出超过10万个变体版本,形成了所谓的"Gemmaverse"社区生态。这次的 Gemma 4,Google 不只是做了常规的性能升级,而是在许可证、模型架构和部署覆盖范围上同时迈出了一大步。

2026/04/06 17:33:26841
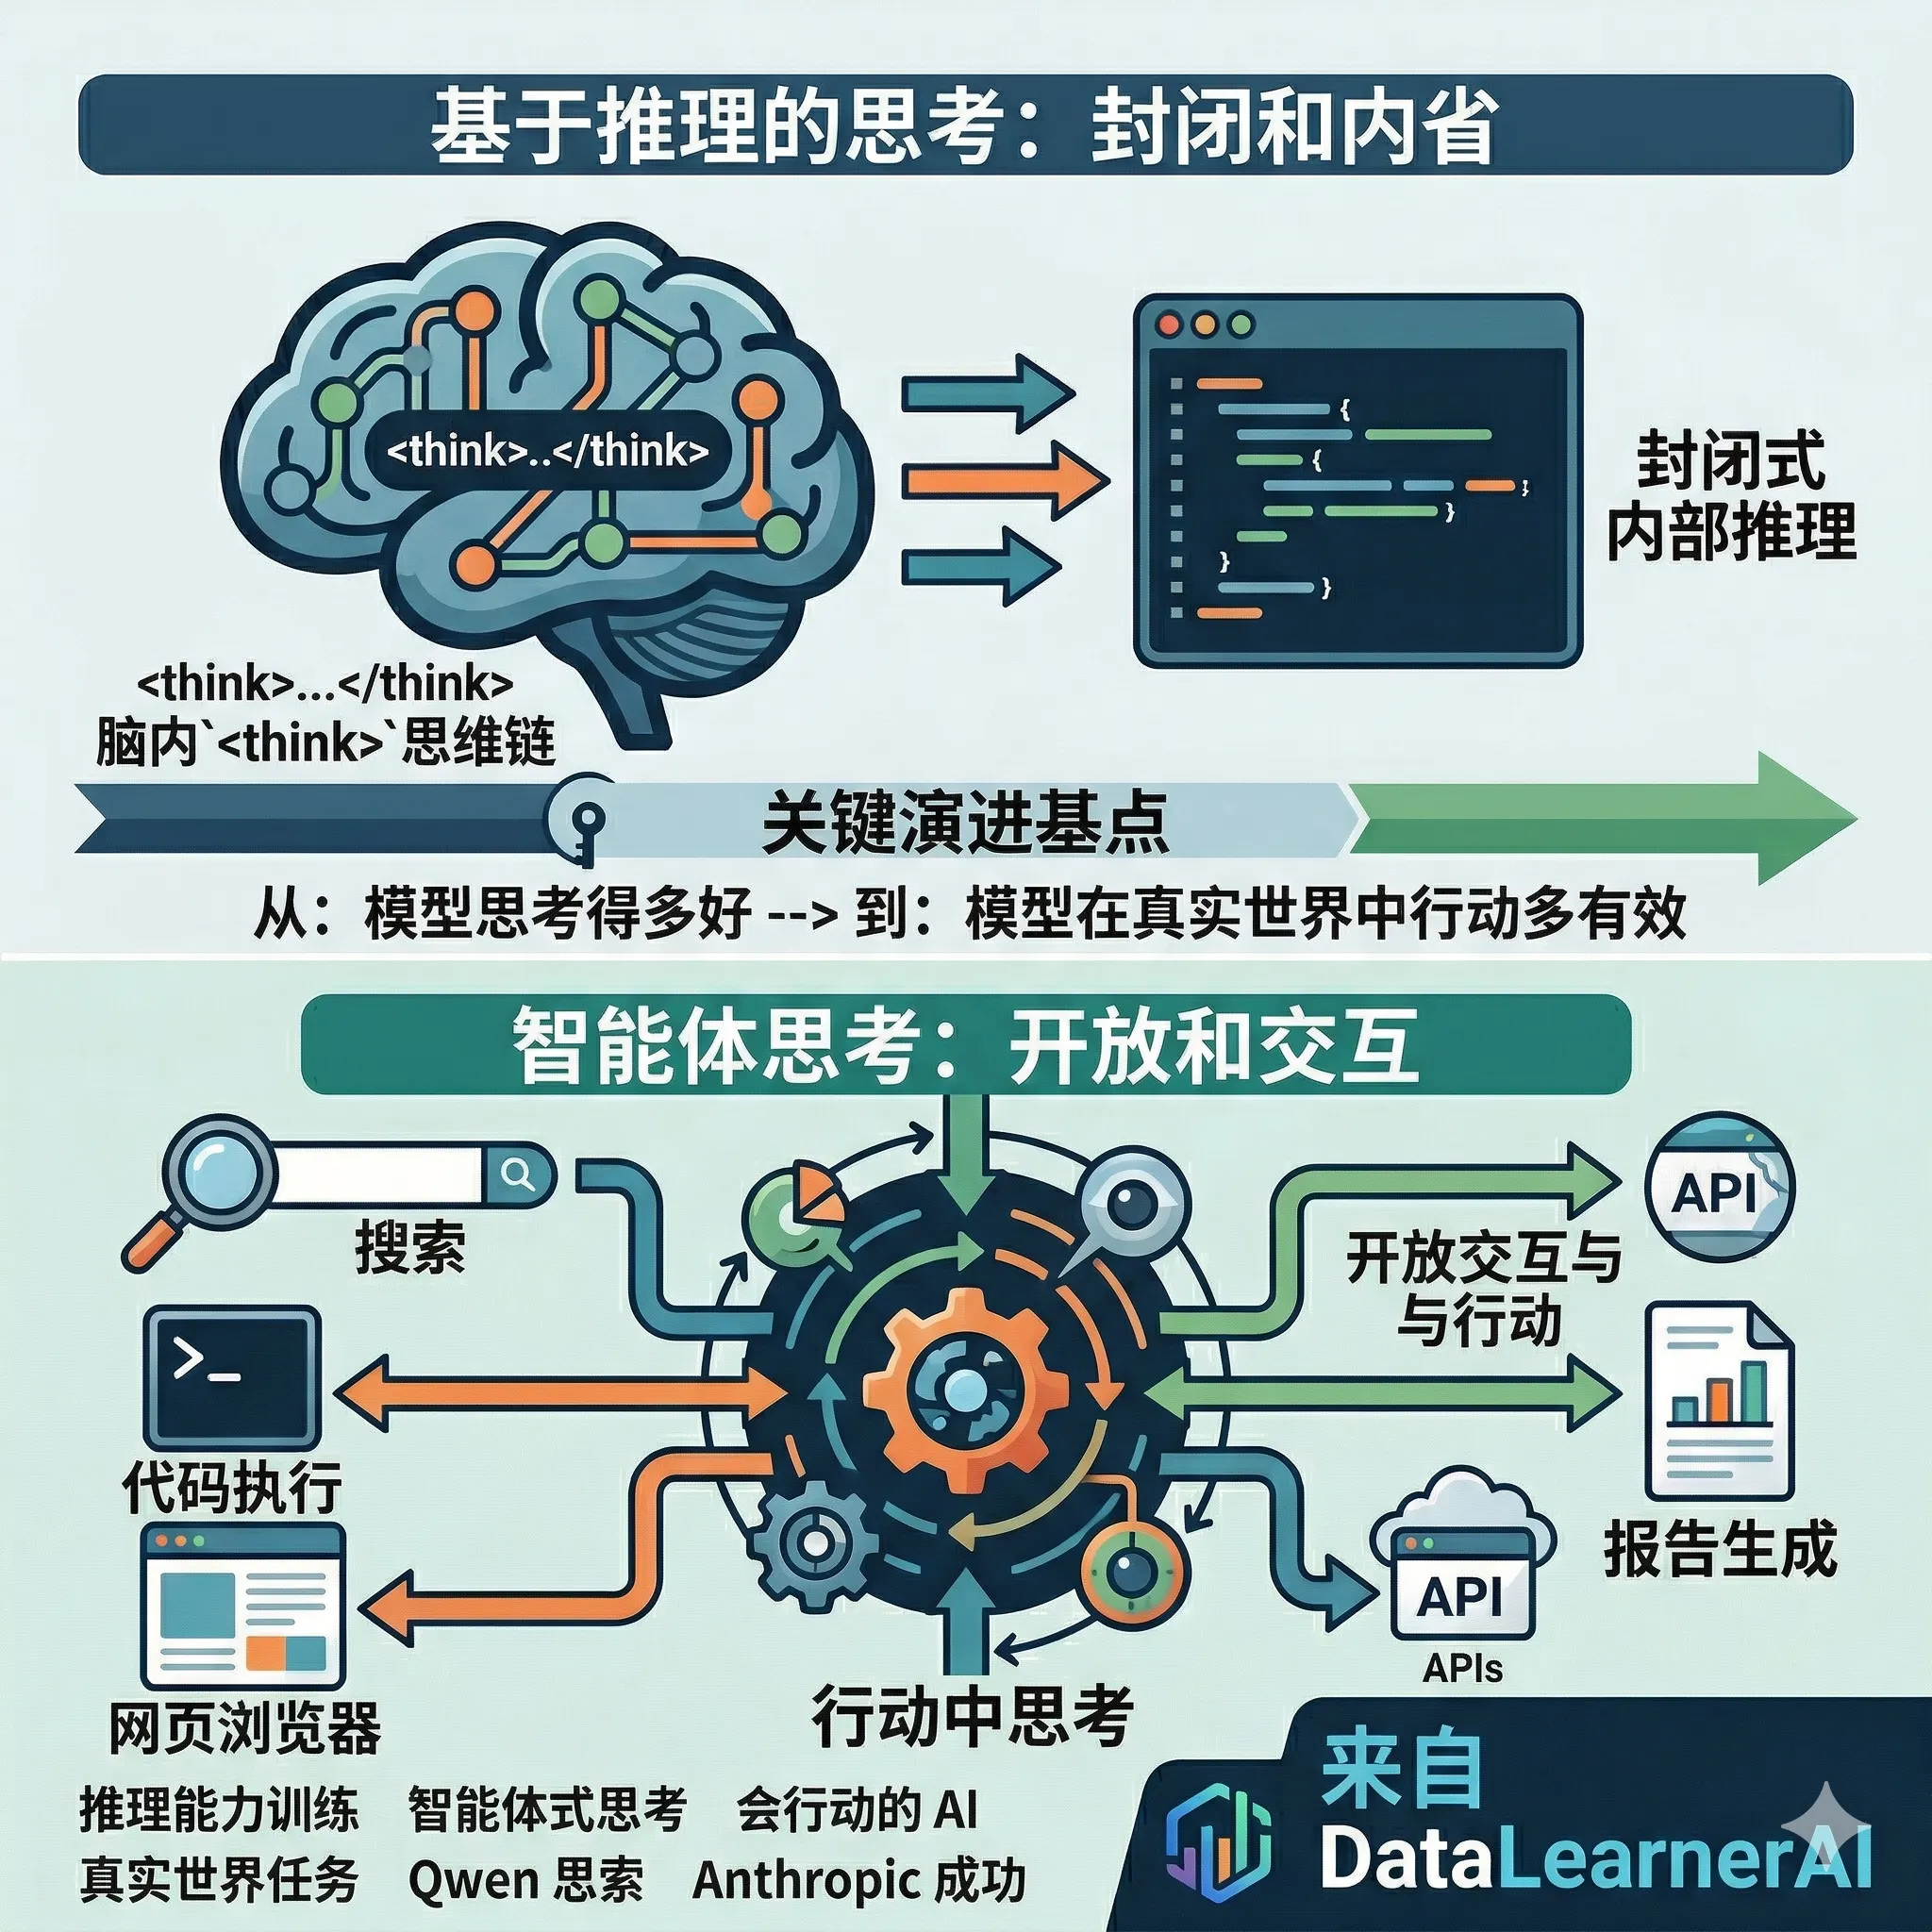
AI 的下一阶段,不是更长的推理链,而是真正的行动力,大模型训练将从“推理式思考”走向“智能体式思考”——前 Qwen 负责人林俊旸(Junyang Lin)最新判断

AI 的下一阶段,不是更长的推理链,而是真正的行动力,大模型训练将从“推理式思考”走向“智能体式思考”——前 Qwen 负责人林俊旸(Junyang Lin)最新判断

unyang 是前 Qwen(通义千问)负责人,前段时间他的离职造成了许多人的关注。不过他并未沉寂,就在刚才,Junyang 发表了一篇关于如何训练大模型推理能力、以及未来大模型推理能力训练应该走向何方的深度讨论。

2026/04/06 11:07:43877
SWE-bench Multilingual 多语言软件工程评测基准全面解读:覆盖9种编程语言的大模型评测基准

SWE-bench Multilingual 多语言软件工程评测基准全面解读:覆盖9种编程语言的大模型评测基准

SWE-bench Multilingual 是 SWE-bench 基准系列的扩展版本。该基准用于评估大语言模型在软件工程任务上的表现,覆盖多种编程语言。数据集包含 300 个从真实 GitHub 问题与对应拉取请求中提取的任务,涉及 42 个仓库和 9 种编程语言。模型接收问题描述与仓库快照后,需生成代码补丁,并通过失败到通过(F2P)和通过到通过(P2P)测试套件进行验证。