
Moonshot AI发布Kimi K2-Instruct-0905:256K上下文长度加持,全面升级的开放式智能体模型
今日,Moonshot AI正式发布了最新旗舰模型 Kimi K2-Instruct-0905。这是一款基于混合专家架构(MoE)的前沿大语言模型,总参数规模达到 1万亿,激活参数为 320亿,不仅在编码智能上实现了断层式提升,更凭借 256K超长上下文 成为当前同类产品中的佼佼者。官方称其在公共基准和真实智能体任务上的表现均有显著突破,已对标并超越部分国际顶尖模型。
Explore the latest AI and LLM news and technical articles, covering original content and practical cases in machine learning, deep learning, and natural language processing.
今日,Moonshot AI正式发布了最新旗舰模型 Kimi K2-Instruct-0905。这是一款基于混合专家架构(MoE)的前沿大语言模型,总参数规模达到 1万亿,激活参数为 320亿,不仅在编码智能上实现了断层式提升,更凭借 256K超长上下文 成为当前同类产品中的佼佼者。官方称其在公共基准和真实智能体任务上的表现均有显著突破,已对标并超越部分国际顶尖模型。
Grok系列是马斯克旗下的人工智能企业xAI发布的大语言模型,在推特上给大家使用。第一个版本,Grok-1前端时间 开源,效果一般。就在刚才,xAI宣布他们开始内测Grok-1.5,即将全面商用!
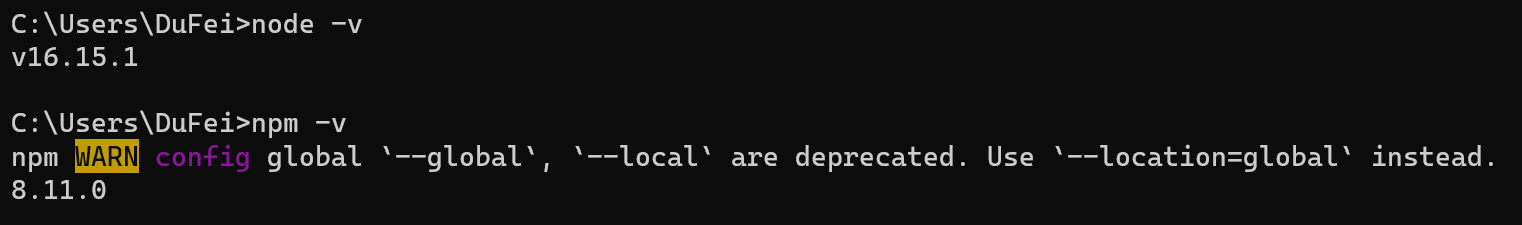
最近开始学习新的前端技术。以前开发网站直接使用jQuery+Bootstrap组合,感觉非常容易和方便。但是,现在前端貌似都开始转向基于构建的方式去开发。由于初学者进入一个项目看很多内容也不如上手启动一个项目感受好,本文抛弃原理,直接教大家上手创建一个vue项目。
今天微软宣布,新版本的Bing将全线接入ChatGPT,试图领先谷歌一步。这篇博客将总结一下带了ChatGPT的新版本Bing将有哪些新功能!
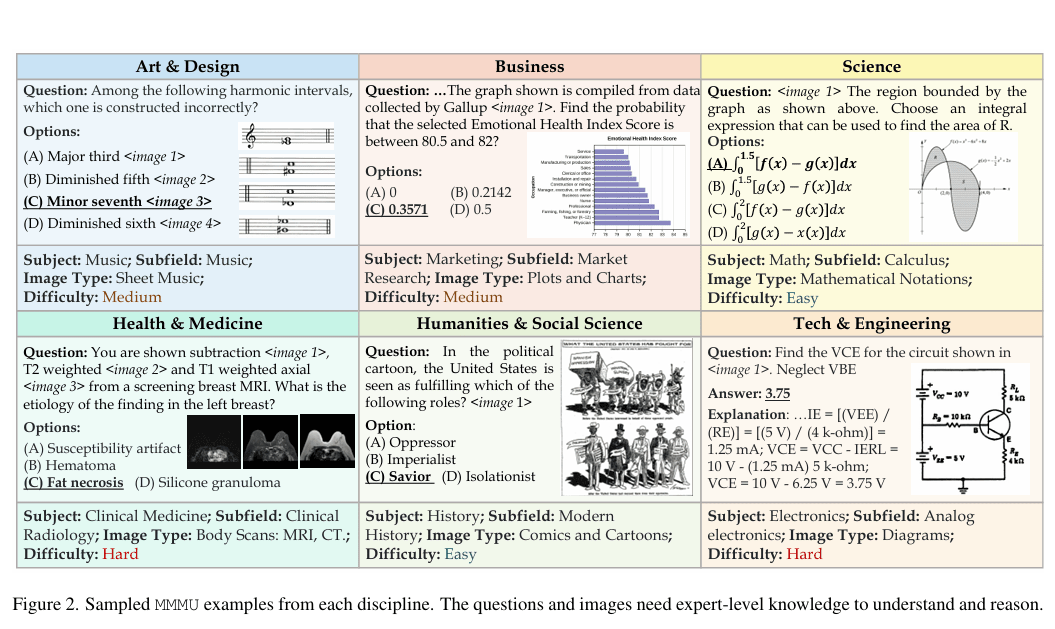
大规模多学科多模态理解与推理基准(MMMU)于2023年11月推出,是一种用于评估多模态模型的复杂工具。该基准测试人工智能系统在需要大学水平学科知识和深思熟虑推理的任务上的能力。与之前的基准不同,MMMU强调跨多个领域的先进感知和推理,旨在衡量朝专家级人工智能通用智能(AGI)的进展。
智谱AI刚刚开源了新一代视觉-语言模型(Vision-Language Model, VLM)——GLM-4.5V。该模型基于其旗舰文本基础模型GLM-4.5-Air(总参数量1060亿,激活参数量120亿),延续GLM-4.1V-Thinking的技术路线,在42项公开视觉多模态基准测试中,在同规模模型中实现领先性能。GLM-4.5V面向图像、视频、文档理解以及GUI任务等常见多模态场景,采用Mixture-of-Experts(MoE)架构,并保持开源。
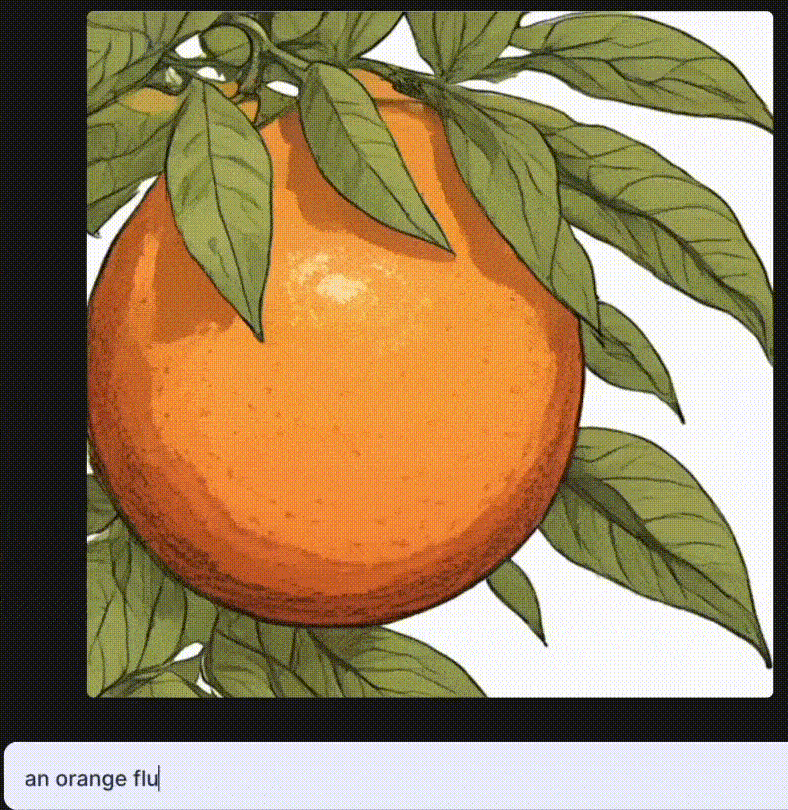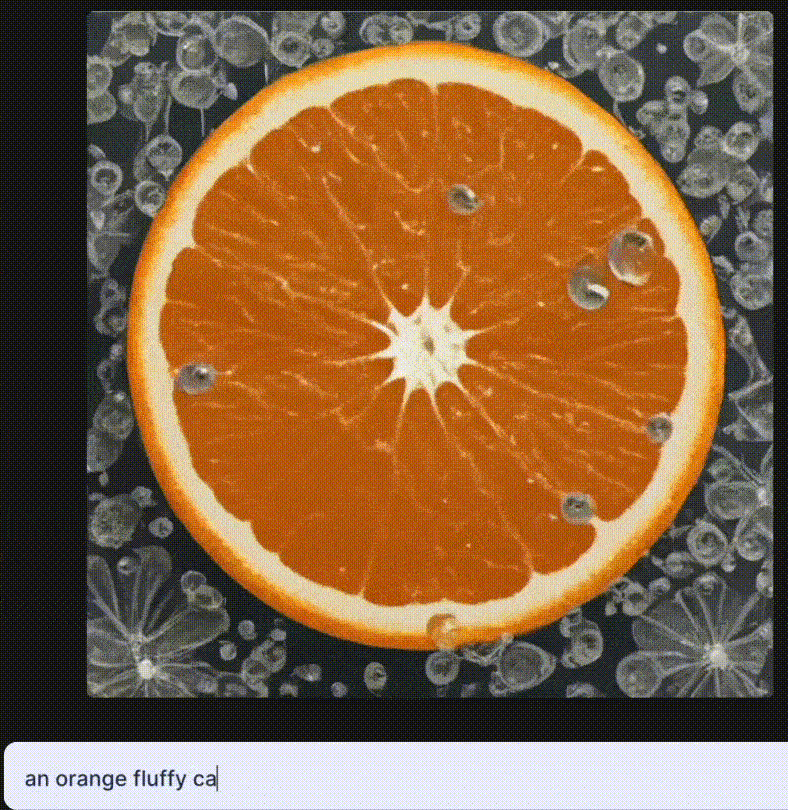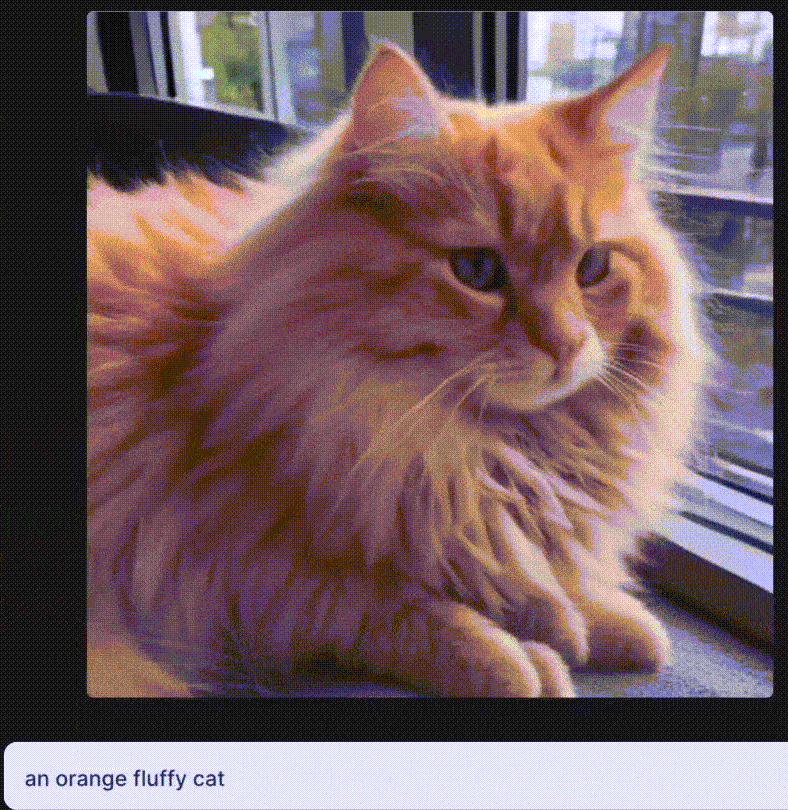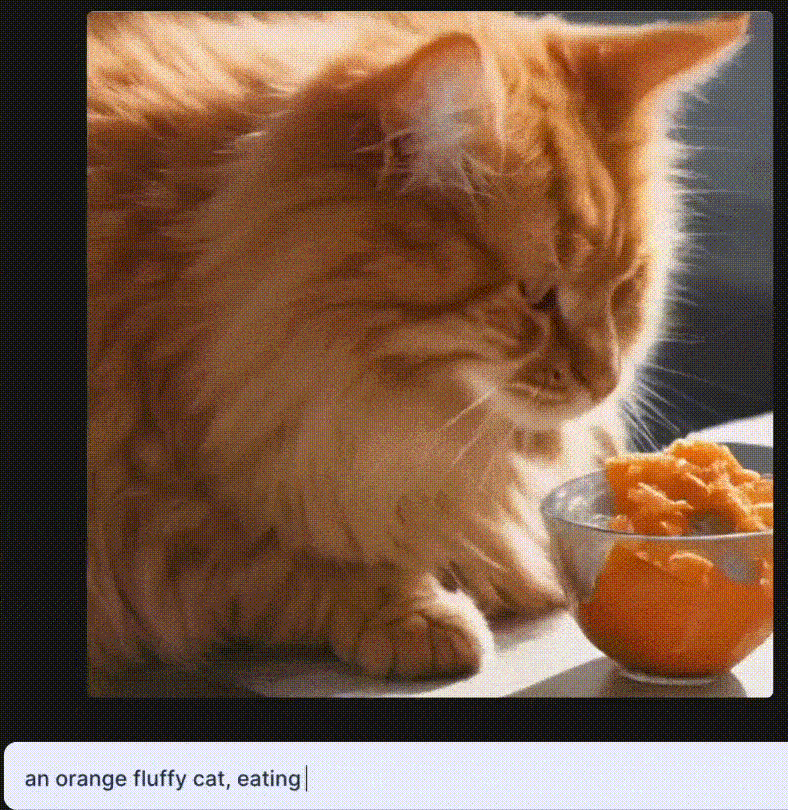
StabilityAI是当前最流行的开源文本生成图像大模型Stable Diffusion背后的公司。这家公司在文本生成图片和文本生成视频方面开源了诸多的大模型。其中,Stable Diffusion是目前使用人数最多的开源文本生成图像大模型。就在刚才,StabilityAI又发布了一个全新的实时的文本生成图像大模型Stable Diffusion XL Turbo,这个最新的模型在A100上生成一张图片只需要0.207秒!
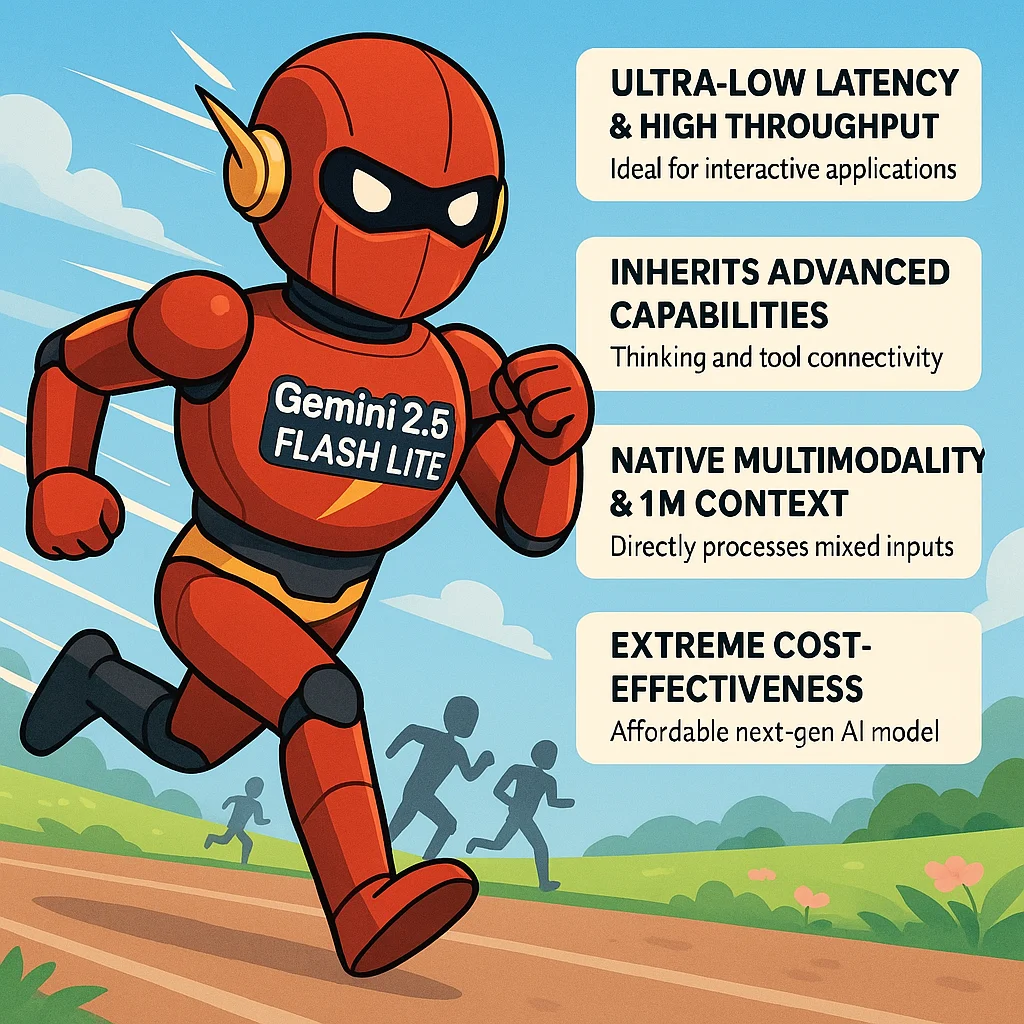
今天,Google发布Gemini 2.5 Flash Lite。这是一款专为追求极致速度、超低延迟和高性价比场景打造的轻量级模型。它的发布标志着 Google 正在将旗舰模型的先进能力(如百万级上下文、原生多模态、工具调用等)逐步下放到更轻量、更经济的模型层级。根据 DataLearnerAI 的实测,这款模型的生成速度最高可达 400 tokens/秒,即使在输入达到 18K tokens 的情况下,也依然可以维持在 160+ tokens/秒 的性能表现,令人惊喜。
虽然LLM在很多任务上很好用,但是实际应用中我们常见的文本分类、文本标注等工作目前却依然缺少一个可以利用LLM能力的好方法。LLM的强大并没有在工程落地上比肩传统的机器学习处理框架。上周,一个叫Scikit-LLM新的开源项目发布,将传统优秀的Scikit-learn框架与LLM结合,带来了LLM落地的新方法。
就在刚才,Grok官网出现了Grok 4.2 Beta版本,并且已经可以直接使用。即使是免费用户,目前看也可以使用至少8次的提问。
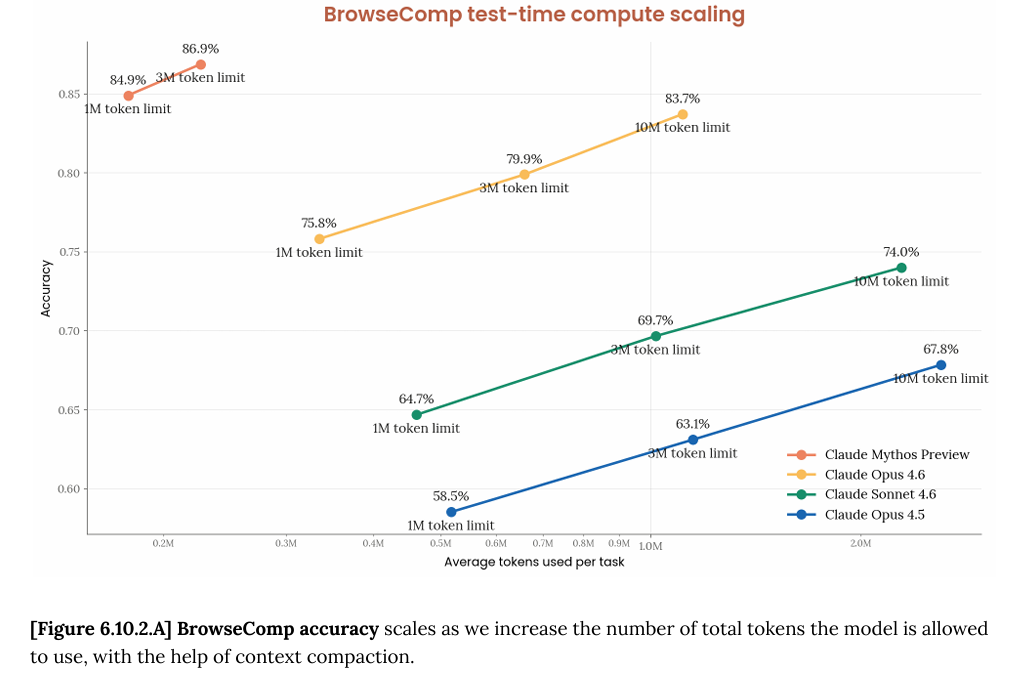
Anthropic 正式发布 Claude Mythos Preview,内部代号 Capybara,能力全面超越 Opus 4.6。该模型以不到 $50 的成本发现了 OpenBSD 27 年零日漏洞,SWE-bench Pro 达到 77.8%。Anthropic 通过 Project Glasswing 向 40 家机构开放访问权限,暂不对公众发布。DataLearner 提供完整评测数据。
本周,谷歌的研究人员在arXiv上提交了一个非常有意思的论文,其主要目的就是分享了他们建立能够翻译一千多种语言的机器翻译系统的经验和努力。
在AI时代,Hugging Face Hub已成为开源大语言模型(LLM)和预训练模型的宝库。从Qwen到DeepSeek系列,这些模型往往体积庞大(几GB甚至上百GB),下载过程容易受网络波动影响,导致中断、重试或失败。作为一名AI从业者,你可能不止一次遇到过“下载到99%就崩”的尴尬。本文将从客观角度,基于实际使用经验,介绍四种常见下载Hugging Face大模型的方法:从基础的Git克隆,到CLI工具、Transformers库,再到国内镜像加速。每种方法都有其适用场景和优缺点,我们将逐一剖析,帮
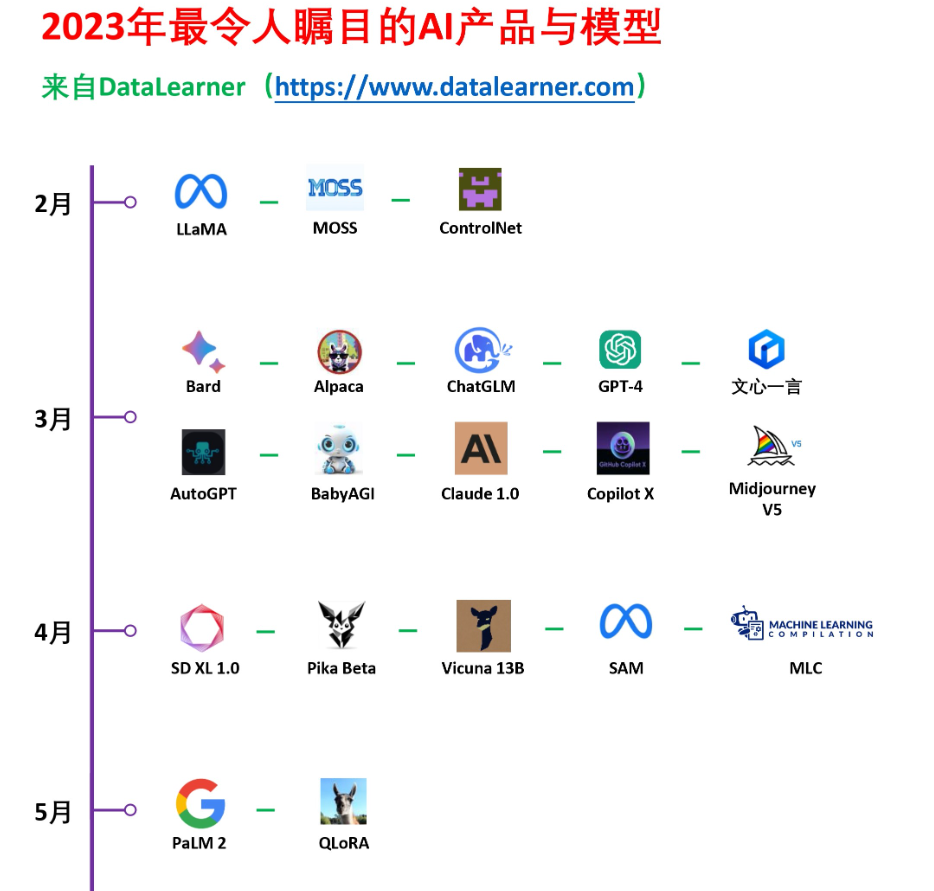
2022年11月底,ChatGPT横空出世,全球都被这样一个“好像”有智能的产品吸引力。随后,工业界、科研机构开始疯狂投入大模型。在2023年,这个被称为大模型元年的年份,有很多令人瞩目的AI产品与模型发布。2023年,DataLearner收集了大量的大模型,并发布了很多大模型相关的技术博客,在即将结束的2023年,我们以这个『2023年最令人瞩目的AI产品』结束本年的技术分享。
就在昨天,2025年10月7日,Google DeepMind 正式发布其最新模型——Gemini 2.5 Computer Use。该模型基于 Gemini 2.5 Pro 的视觉理解与推理能力,新增了“界面交互(UI 控制)”能力,能够在浏览器或移动端界面上像人类那样点击、输入、滚动、选择控件等操作。
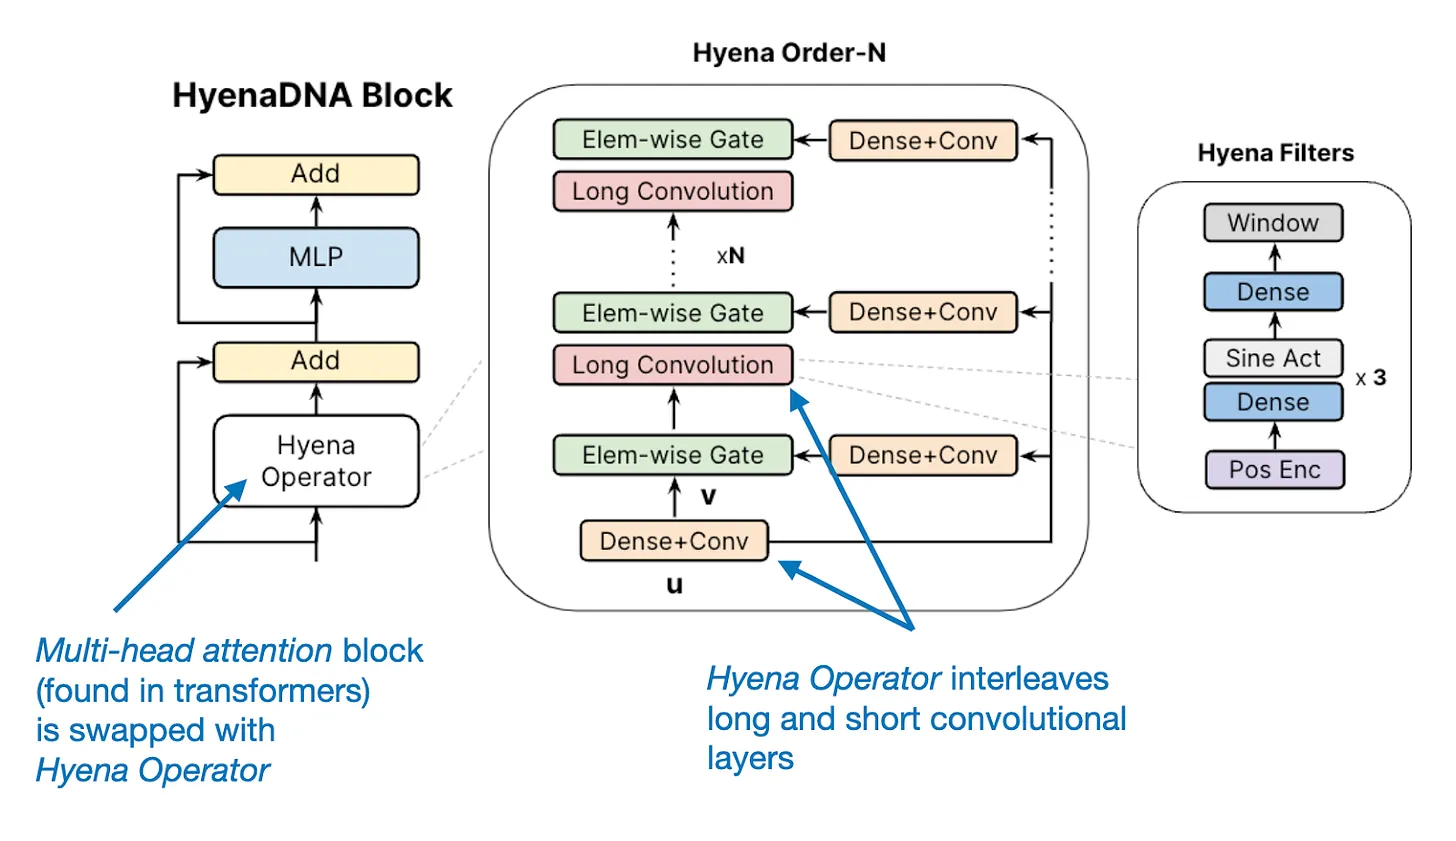
Sebastian Raschka博士是一位深度学习和人工智能研究员、程序员、作者和教育者。他曾是威斯康星大学麦迪逊分校的统计学助理教授,专注于机器学习和深度学习研究。然而,他在2023年辞职,全职投入到他在2022年加入的Lightning AI创业公司,担任首席AI教育者。本文是Sebastian Raschka博士最新的2023年AI进展总结的翻译,大家参考。
大模型究竟能否真正提升工程师的编码效率?Anthropic 最近发布的一份重量级内部研究给出了少见的、基于真实工程环境的数据答案。研究覆盖 132 名工程师、53 场深度访谈,以及 20 万条 Claude Code 使用记录,展示了 AI 在软件工程中的实际作用:从生产力显著提升(人均合并 PR 数同比增长 67%)、任务空间扩张(27% 的 Claude 工作原本不会被执行),到工程师技能版图、协作方式与职业路径的深刻变化。与此同时,研究也揭示了技能萎缩、监督负担、工作流变化等新挑战。这是一份罕见的“
在去年末的OpenAI宫斗风波中,伴随着Sam下台和重新掌权过程中有一个非常重要但不被大家了解的算法Q*。国外的路透社曾经提到OpenAI内部一个称为Q*(Q Star)项目取得了非常重大的突破,使得部分人认为AGI很接近,进而引发了一系列事件。但是,Q*到底是什么?是否存在一直被很多人猜测。而最近,一个神秘的帖子继续爆料了Q*的信息。
Llama系列是MetaAI开源的大语言模型,是全球开源大模型中最重要的力量之一。第一代的Llama系列模型不允许商用,第二代模型则放松了范围,允许商用。而Llama系列模型因为优秀的品质,也是许多开源模型的基座。而今天Llama3即将发布。
在过去的几年里,我们看到了AI在图像、视频和文本生成方面的巨大进步。然而,音频生成领域的进展却相对滞后。MetaAI这次再为开源贡献重磅产品:AudioCraft,一个支持多个音频生成模型的音频生成开发框架。
OpenAI的o1模型被认为是大模型领域中推理能力最强的代表之一,由于其强大的数学逻辑推理能力,被认为是大模型未来的进化方向。而就在2个月之后的11月快结束的时间里,幻方量化旗下人工智能企业DeepSeekAI发布了全新的DeepSeek-R1-Lite-Preview模型,号称是o1模型的有力挑战者。该模型利用了类似的o1的思维链思索过程,推理能力大幅增强。DataLearnerAI将在本文中对该模型进行介绍,并进行几个简单的对比结果测试。结果证明这个模型是非常优秀的!
智谱AI开源了一个60亿参数规模的文生图大模型CogView4-6B,支持生成的图像中加入文字,文字效果自然融入图像中,且该模型支持支持宽高范围512px至2048px内的任意尺寸图像(有限制,正文解释)。