原创博客
原创AI技术博客
探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。
聊天大模型的输出速度应该是多少?单张显卡最多可以支持多少个人同时聊天?来自贾扬清最新的讨论
大模型应用中一个非常重要的问题就是大模型的响应速度。尤其是作为聊天应用来说,在用户输入之后,大模型可以在多短的时间内给出回应对于用户体验来说影响巨大。这里有2个问题经常会被大家所关注,一个是大模型每秒输出多少个tokens就可以满足用户的日常聊天使用,另一个问题是单张显卡最多可以支撑多少个用户的聊天需求。在前几天的vllm meetup上,贾扬清给出了一些讨论,他认为我们目前可能高估了大模型的聊天应用成本。

Dask分布式任务中包含写文件的方法时候,程序挂起不结束的解决方案
使用Dask进行分布式处理的时候一个最常见的场景是有很多个文件,每个文件由一个进程处理。这种操作经常会遇到一个程序挂起的问题,使得程序永远运行,无法结束。本文描述如何解决。
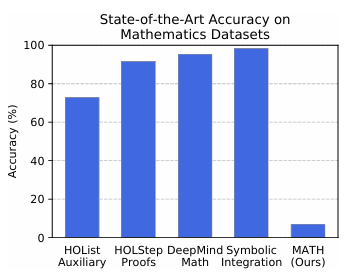
MATH vs. MATH-500:数学推理评测基准的对比与解析
在评估大型语言模型(LLM)的数学推理能力时,MATH和MATH-500是两个备受关注的基准测试。尽管它们都旨在衡量模型的数学解题能力,但在发布者、发布目的、评测目标和对比结果等方面存在显著差异。
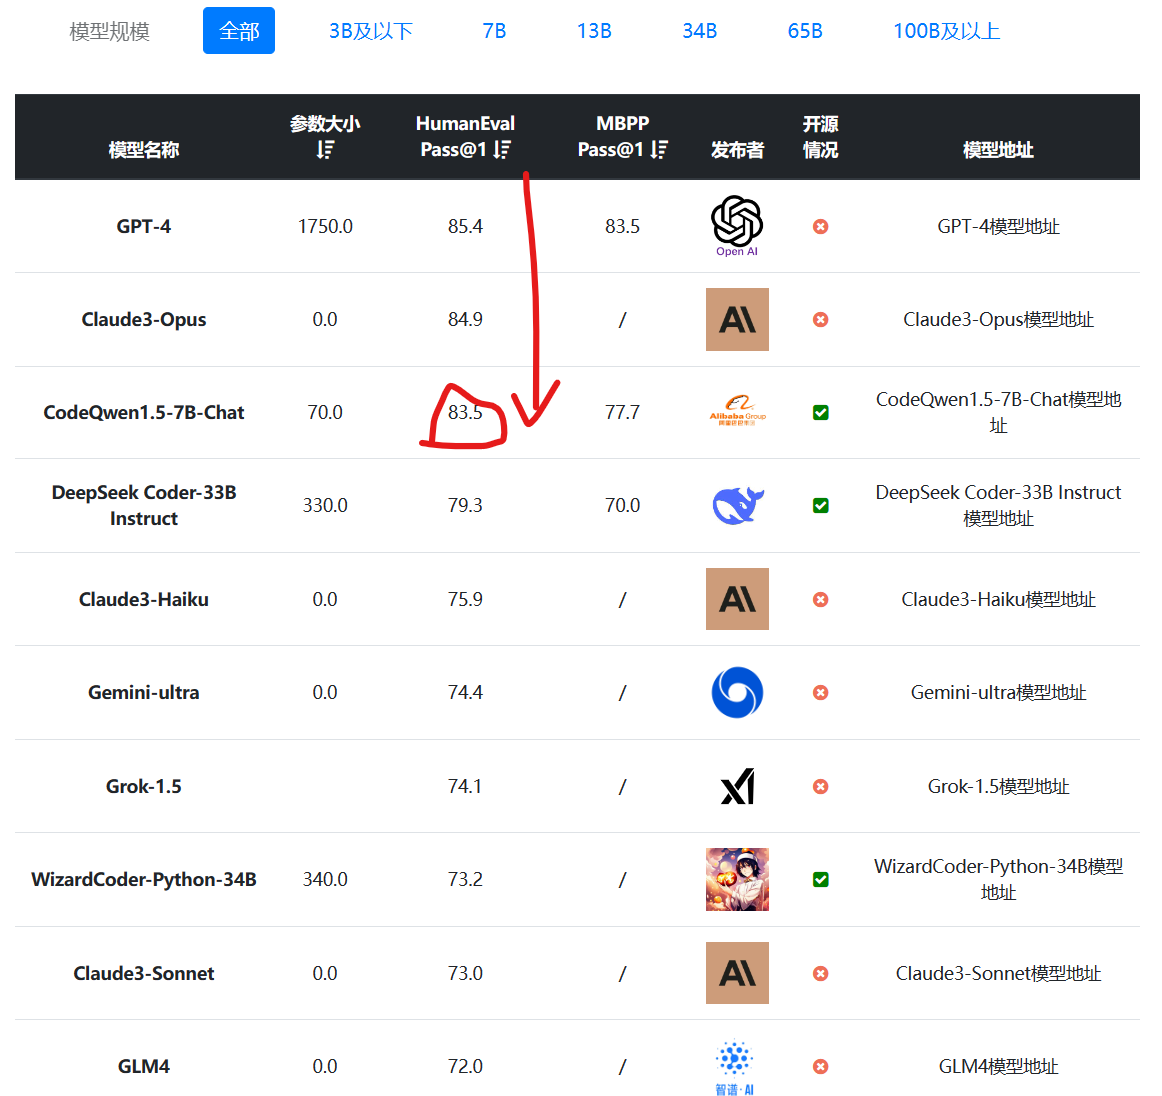
HumanEval评测接近GPT-4-Turbo!阿里巴巴开源70亿参数编程大模型CodeQwen1.5-7B!
编程大模型是当前大语言模型里面最重要的一类。一般是基础大模型在预训练之后,加入代码数据集继续训练得到。在代码补全、代码生成方面一般强于常规的大语言模型。阿里最新开源的70亿参数大模型CodeQwen1.5-7B在HumanEval评测结果上超过了GPT-4早期版本,表现异常地好!
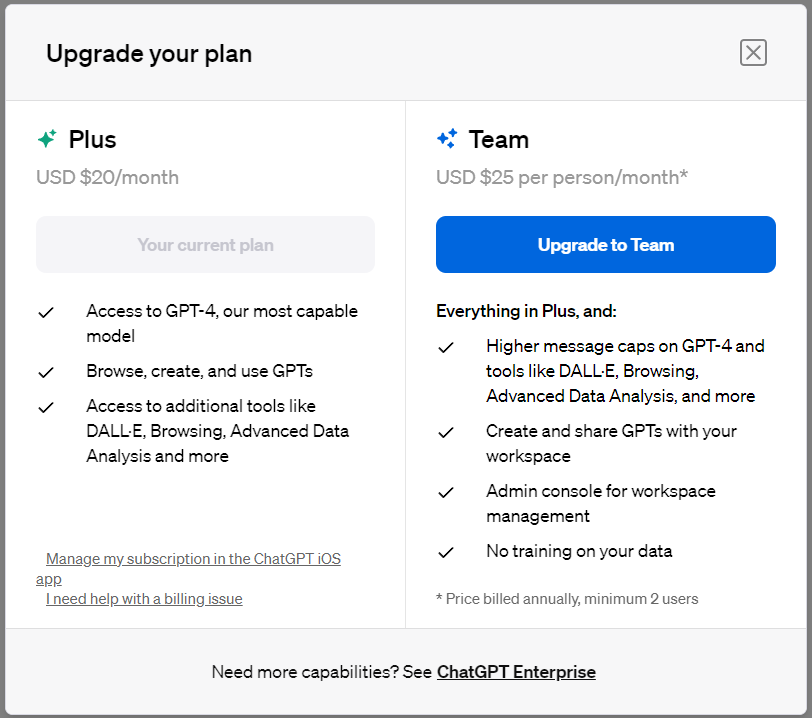
OpenAI正式开放ChatGPT Team订阅计划,价格每个月贵25%,更多的GPT-4,附ChatGPT付费计划对比
OpenAI今天开放了ChatGPT的Team版本的订阅计划,相比较普通的Plus会员版本,Team版本的计划价格更贵,但是可以使用更多的GPT-4额度。不过,与此前传闻比较少了很多功能,唯一比较吸引人的就是更多的GPT-4使用额度了。最少两个人合买。
MistralAI开源全球首个(可能)基于MoE(Mixture of Experts)技术的大模型:预训练下载链接全球直发,但实测表现似乎一般!
MistralAI是一家法国的大模型初创企业,其2023年9月份发布的Mistral-7B模型声称是70亿参数规模模型中最强大的模型,并且由于其商用友好的开源协议,吸引了很多的关注。在昨晚,MistralAI突然在推特上公布了一个磁力下载链接,而下载之后大家发现这是一个基于混合专家的大模型这是由8个70亿参数规模专家网络组成的混合模型(Mixture of Experts,MoE,混合专家网络)。
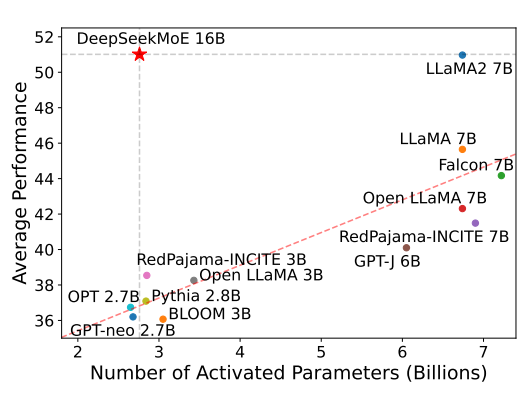
DeepSeekAI开源国产第一个基于混合专家技术的大模型:DeepSeekMoE-16B,未来还有1450亿参数的MoE大模型
混合专家(Mixture of Experts)是大模型一种技术,这个技术将大模型划分为不同的子专家模型,每次推理只选择部分专家网络进行推理,在降低成本的同时保证模型的效果。此前Mistral开源的Mixtral-8×7B-MoE大模型被证明效果很好,推理速度很棒。而幻方量化旗下的DeepSeek刚刚开源了可能是国产第一个MoE技术的大模型,DeepSeek-MoE 16B。
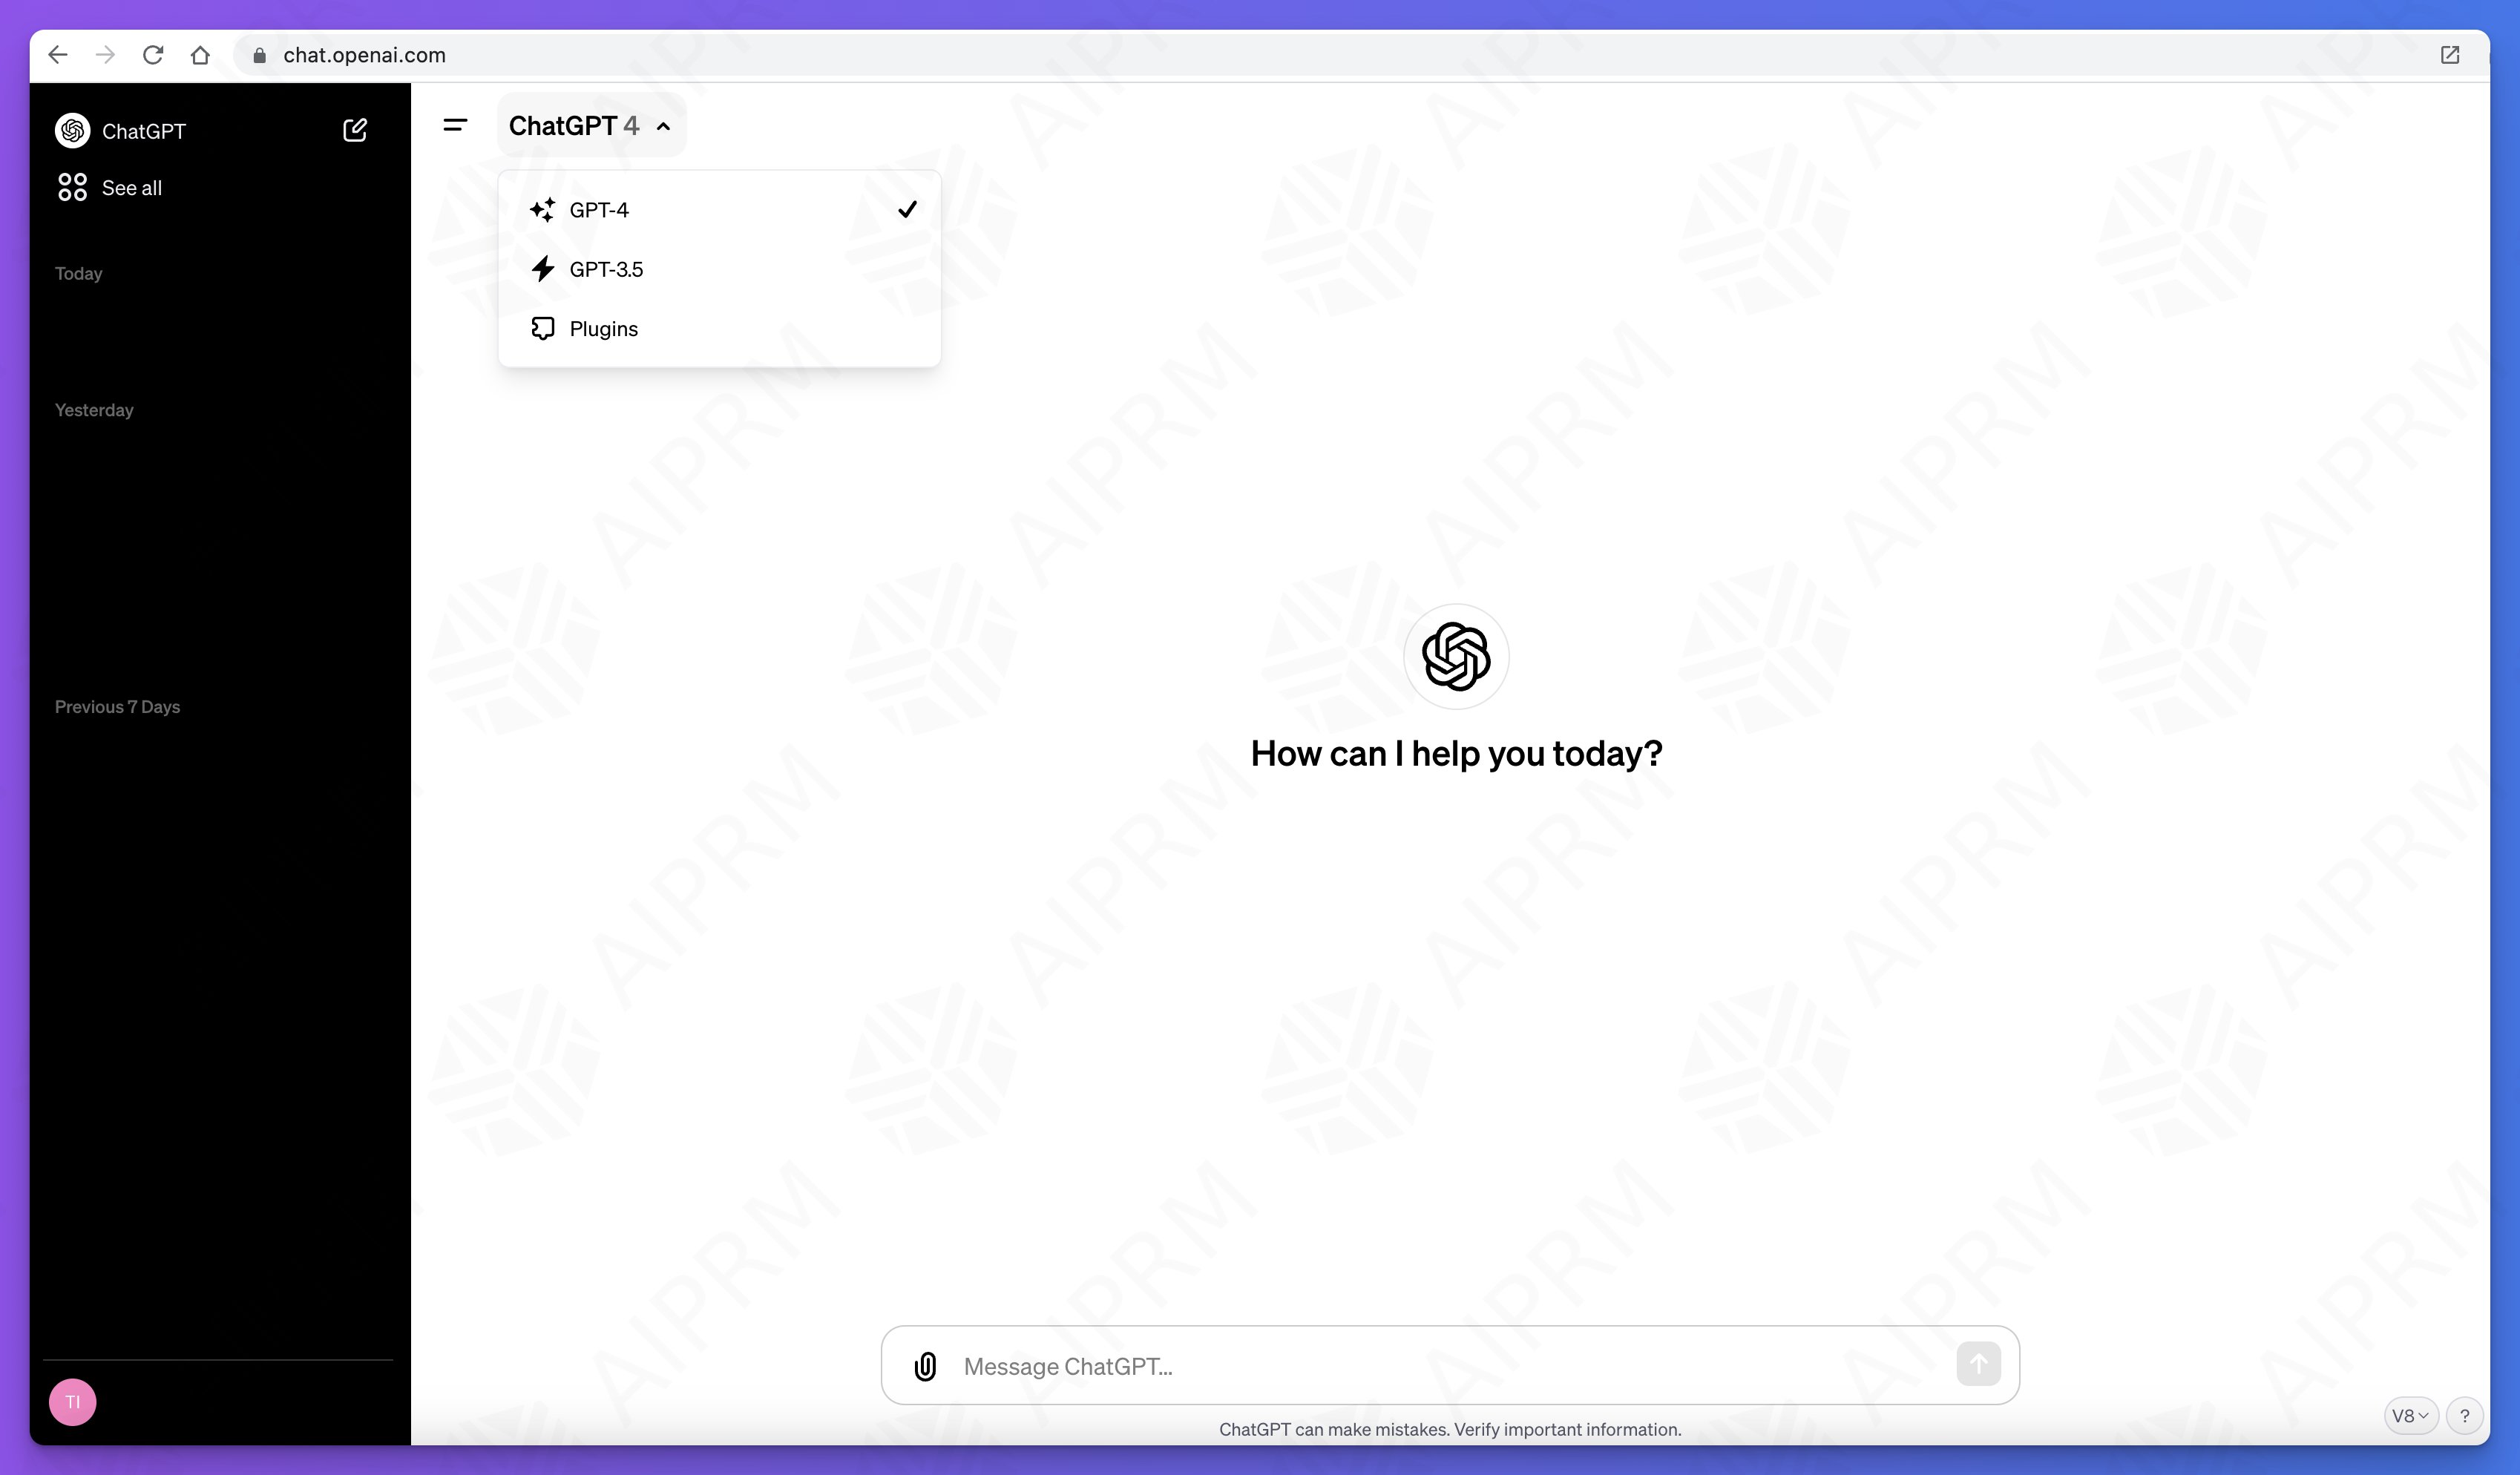
ChatGPT颠覆更新!即将发布的ChatGPT新版本带来巨变,新界面和可以自定义GPT-4功能:可以对接私有数据与私有接口的个性化ChatGPT即将到来!
ChatGPT是当前大模型服务最前沿和风向标,每一次改动都会引起巨大的关注。此前,在ChatGPT的js脚本中就隐藏了即将发布的ChatGPT Team计划。而现在,新的ChatGPT UI代码和功能也被发现。新的GPT除了界面的巨大变化外,还有一个类似自定义AI Agent能力,可以直接接入自己的私有数据和API接口对外提供服务!十分震惊!

吴恩达的LandingAI究竟是一家什么样的创业公司
吴恩达是人工智能领域非常著名的人物。2011年在谷歌创建的谷歌大脑项目,震惊了全世界。2014年他加入百度负责百度大脑计划,并于2017年离职。离职之后他创建了人工智能公司LandingAI,并担任首席执行官。昨天吴恩达宣布他新成立的这家公司已经募集到5,700万美金。本文主要简单介绍这家公司的业务。
介绍 AIME 2025:评估大型语言模型高级数学推理能力的基准
随着大语言模型(LLM)的发展越来越快,我们需要更好的方法来评估它们到底有多“聪明”,特别是在处理复杂数学问题的时候。AIME 2025 就是这样一个工具,它专门用来测试当前 AI 在高等数学推理方面的真实水平。
GPT-4-Turbo的128K长度上下文性能如何?超过73K Tokens的数据支持依然不太好!
GPT-4 Turbo是OpenAI最新发布的号称性能超过当前GPT-4的模型。在新版本的ChatGPT中已经可以使用。而接口也在开放。除了速度和质量外,GPT-4 Turbo最吸引人的是支持128K超长上下文输入。但是,实际测试中GPT-4 Turbo对于超过73K tokens文档的理解能力急速下降。
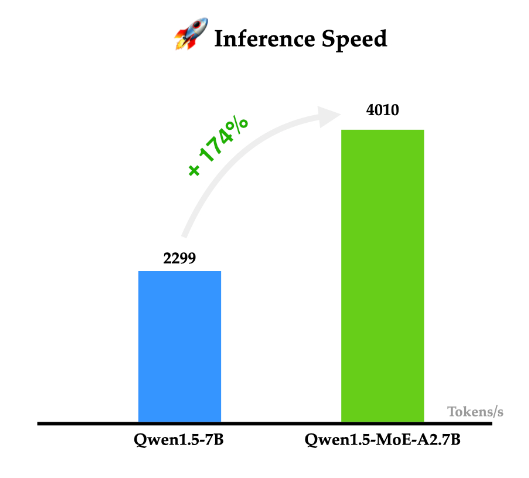
重磅!阿里巴巴开源自家首个MoE技术大模型:Qwen1.5-MoE-A2.7B,性能约等于70亿参数规模的大模型Mistral-7B
阿里巴巴的通义千问一直是开源领域最强大的大模型之一。就在今天,阿里巴巴首次开源了他们家的MoE技术大模型Qwen1.5-MoE-A2.7B,这个模型是使用现有的Qwen-1.8B模型作为起点,通过类似merge技术进行合并得到的。
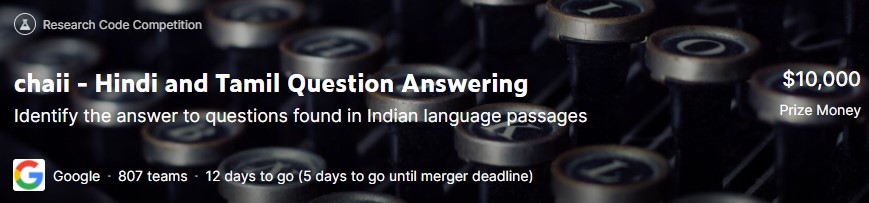
目前正在举办的机器学习相关的比赛
机器学习相关的竞赛为大家学习使用算法提供了一个非常好的平台和机会。既能检验大家学习的算法的实际应用情况,也可以帮助我们学习到很多有用的技巧。很多竞赛也都产生了优秀的算法思想与经验。所以积极参加比赛是一种非常重要的学习方式。本文总结目前正在举办的比赛,各位可以根据自己的情况参与。

OpenAI CEO详解今明两年GPT发展计划:10万美元部署私有ChatGPT、最高支持100万tokens、建立微调模型应用市场
前段时间,OpenAI的CEO Sam Altman与二十多位开发者一起聊了很多关于OpenAI的API和产品的规划问题。Sam Altman透露了一些非常重要的OpenAI的发展方向,包括GPT产品功能的未来规划等。目前这份原始博客内容已经应OpenAI的要求被删除,这里我们简单总结一下这些内容。
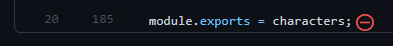
为什么GitHub要求文件的末尾必须有换行符?
这几天逛reddit的时候发现了一个很有意思的讨论,有个童鞋说他在GitHub上提交代码的时候发现了提交文件被提示有一个红色警告的提示,鼠标移动上去会告诉你“No newline at end of file”(也就是文件末尾没有换行)。因此,他很奇怪,他不懂为什么GitHub要求文件的末尾必须有换行符。这个问题引起了很多的讨论。这里我也顺便记录共享一下。
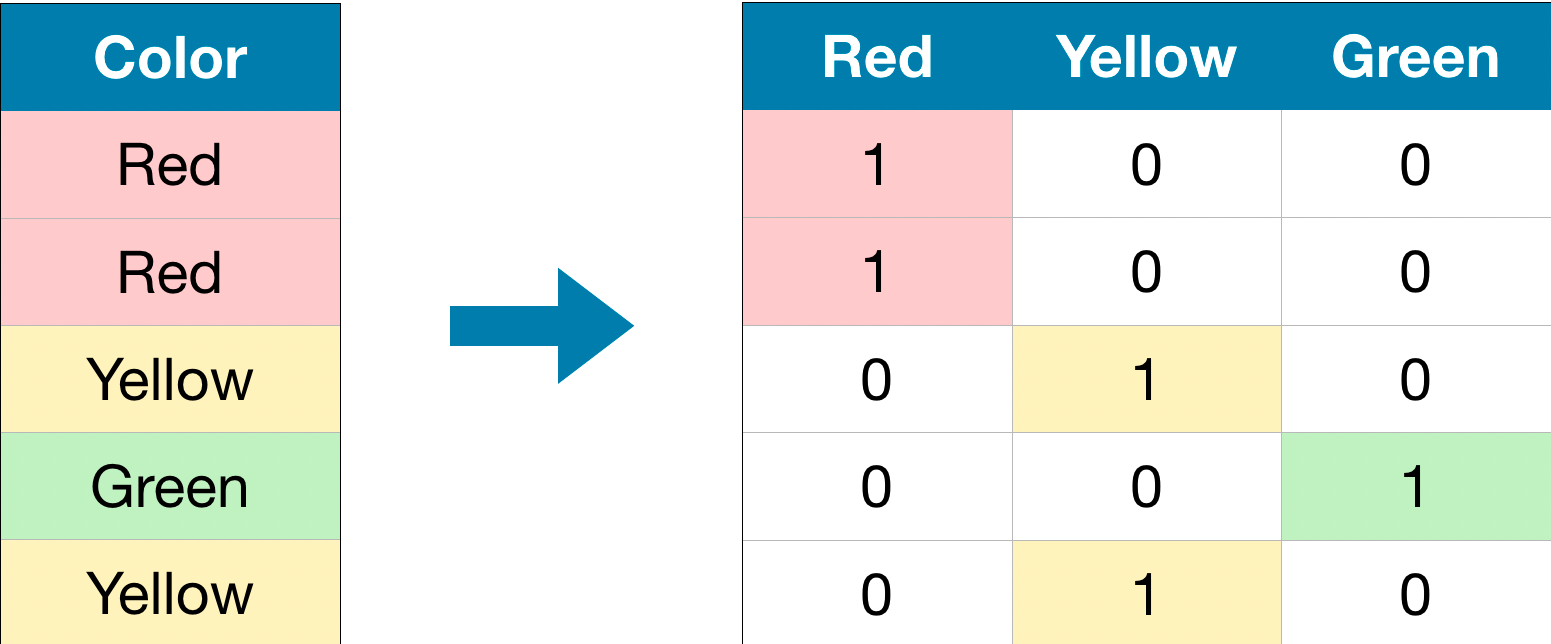
使用kaggle房价预测的实例说明预测算法中OneHotEncoder、LabelEncoder与OrdinalEncoder的使用及其差异
对于分类特征的处理,sklearn中常见的方法有两种,一种是OneHotEncoder,另一种很多人说是LabelEncoder,其实不对。sklearn中,还有一个OrdinalEncoder,二者似乎一样,但其实并不相同,差别很大。本文将用Kaggle的房价预测的实例来描述如何这些差异以及不同处理对预测算法的影响。