DataLearner 标志
原创博客

原创AI技术博客

探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。

大模型Agent应用上线后,成本和效果之间如何取舍?来自Anthropic官方的成本和效果均衡优化建议

大模型Agent应用上线后,成本和效果之间如何取舍?来自Anthropic官方的成本和效果均衡优化建议

大模型Agent系统从demo走向生产后,成本会成为最突出的问题。Anthropic官方最近发布了一份基于内部实测数据的优化指南,把所有手段分为"不损失效果的免费优化"和"需要取舍的调节"两类,涵盖prompt缓存、effort调节、任务预算、失败重跑、以及advisor和orchestrator两种多模型架构。其中prompt缓存是最大的单一杠杆,可将agent循环成本压缩到原来的三分之一左右。本文完整梳理了这份文档的关键结论、适用条件和失效场景。
2026-08-16 22:00:08197
全球大模型竞争格局:从“模型榜单”走向“智能体、成本与全栈生态”之争

全球大模型竞争格局:从“模型榜单”走向“智能体、成本与全栈生态”之争

全球大模型竞争正在从单纯的模型能力竞赛,走向模型、产品、开发者生态、成本与商业化能力的综合竞争。本文系统梳理全球主流基础模型的发展格局,对比 OpenAI、Google、Anthropic、DeepSeek、Qwen 等主要参与者的技术路线、模型能力与生态布局,分析全球大模型市场当前的竞争态势及未来演进方向。

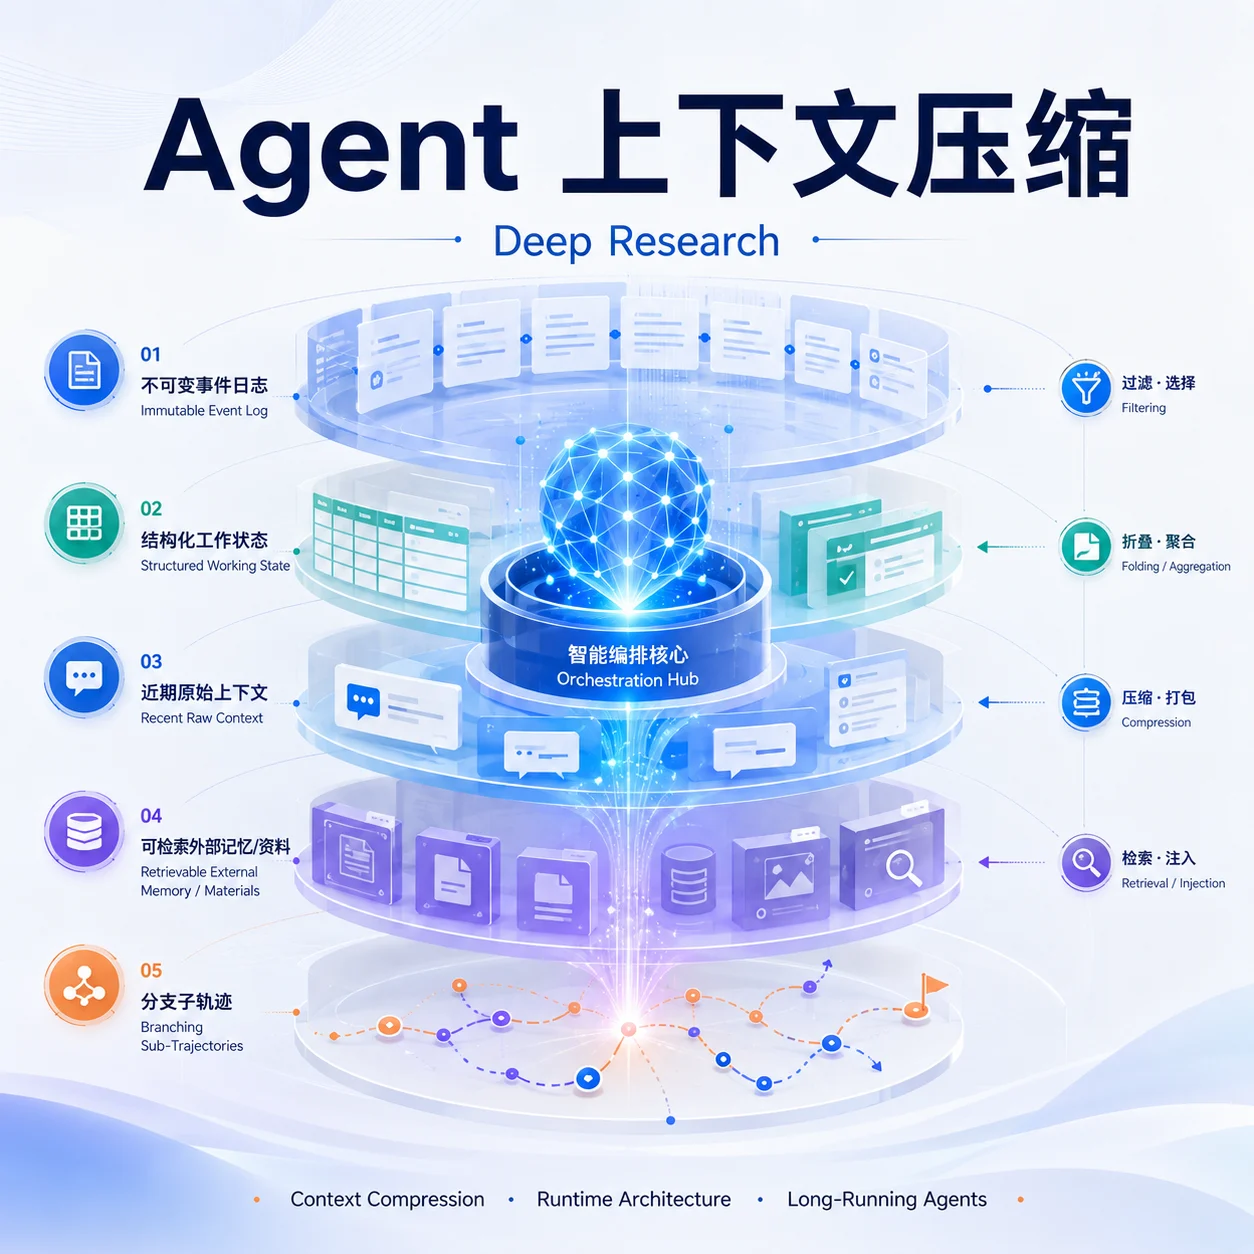
2025–2026 Agent 上下文压缩工程方法深度研究

2025–2026 Agent 上下文压缩工程方法深度研究

本文基于 GPT-5.6 Sol Pro 的 Deep Research,系统研究 2025–2026 年长时程工具型 Agent、编码 Agent、Deep Research Agent 和多轮业务 Agent 的上下文压缩与管理方法。研究发现,当前业界正在从简单的滚动摘要,转向“不可变事件日志 + 结构化工作状态 + 近期原文 + 外部可恢复材料”的分层上下文架构。对于编码 Agent,优先删除或屏蔽可重新获取的旧工具输出,往往比直接使用 LLM 摘要具有更好的成本收益;

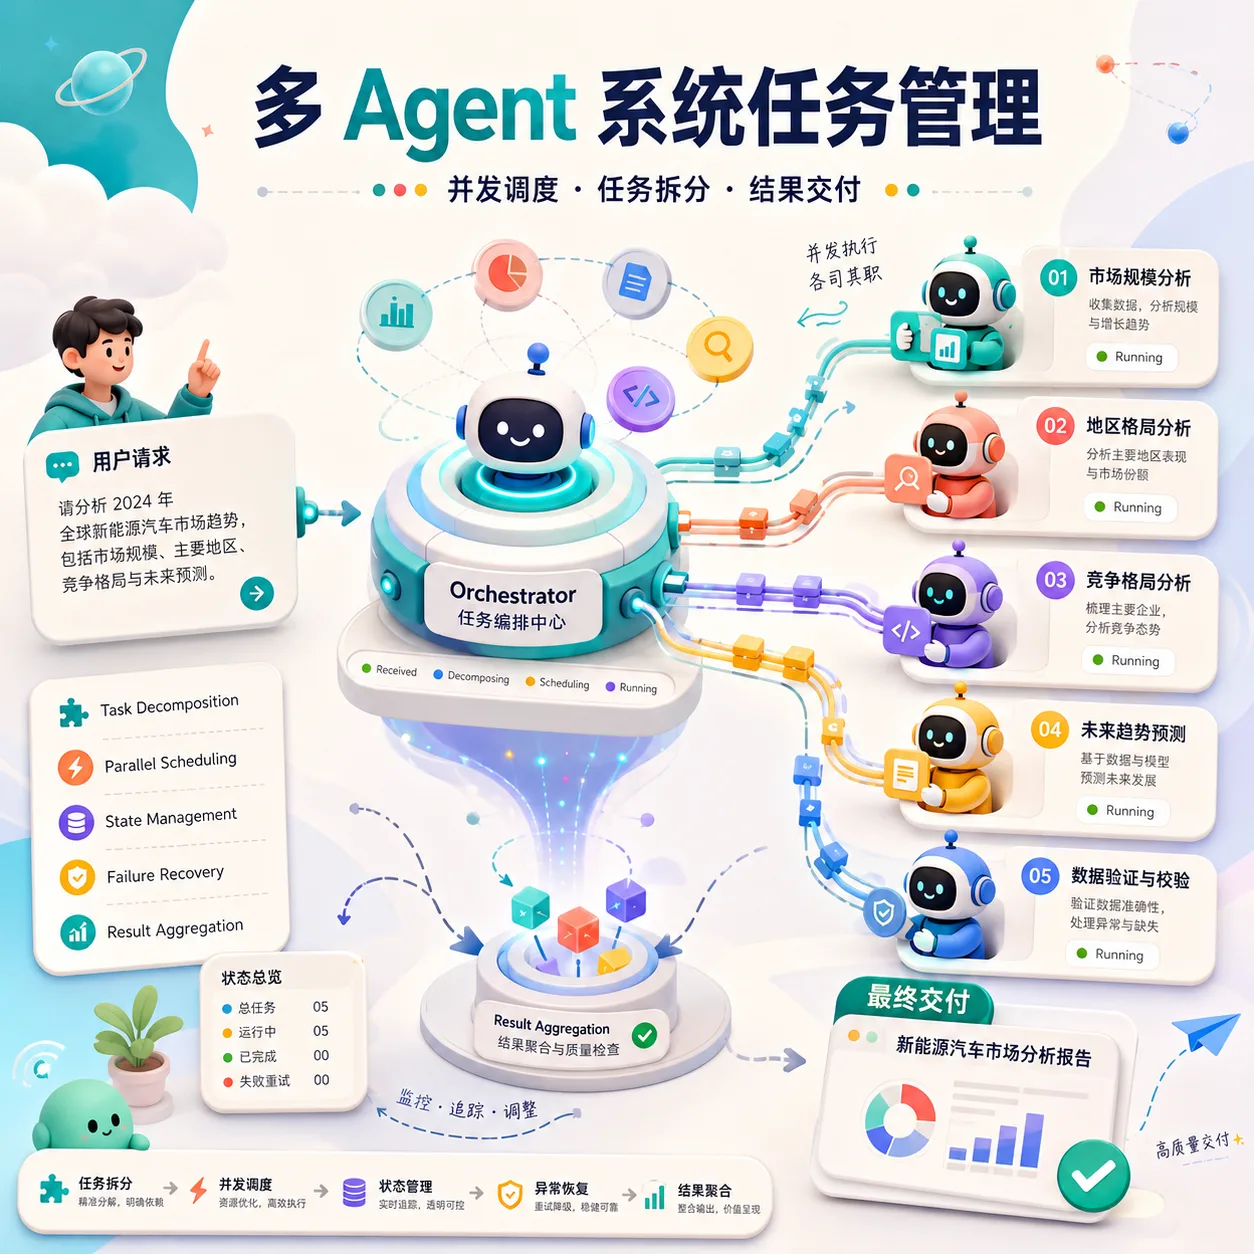
业界多 Agent 系统的任务管理设计:面向相似与并发子任务的研究报告

业界多 Agent 系统的任务管理设计:面向相似与并发子任务的研究报告

多 Agent 系统的复杂度不仅来自 Agent 本身,更来自任务的拆分、调度与交付。当用户一次提交多个相似或相互依赖的任务时,系统需要在并发执行、任务隔离、状态管理、依赖协调、失败恢复与资源控制之间取得平衡。本文调研业界主流多 Agent 架构与编排模式,重点分析任务生命周期、任务队列与调度、子 Agent 管理、并发控制、重试与容错,以及结果聚合和最终交付机制,并总结构建可扩展、可观测、可靠的多 Agent 任务系统的关键设计原则。

DeepSeek Harness 架构解析:不是又一个 Coding Agent,而是重新定义 Agent Runtime 的边界

DeepSeek Harness 架构解析:不是又一个 Coding Agent,而是重新定义 Agent Runtime 的边界

DeepSeek 开源的 DSH 不是又一个 Coding Agent,而是一个 Agent Runtime Framework。它把 Agent Loop、Session、Persistence 等传统上属于 Agent Core 的部分全部做成可替换插件,通过 Capability Seam 的三角色模型实现能力与实现的解耦,并要求所有模型可见内容必须可从日志重建。本文解析 DSH 最核心的几处设计,以及它与 Claude Code、Codex、Pi 等产品的真正差异。

2026-08-16 14:53:58370
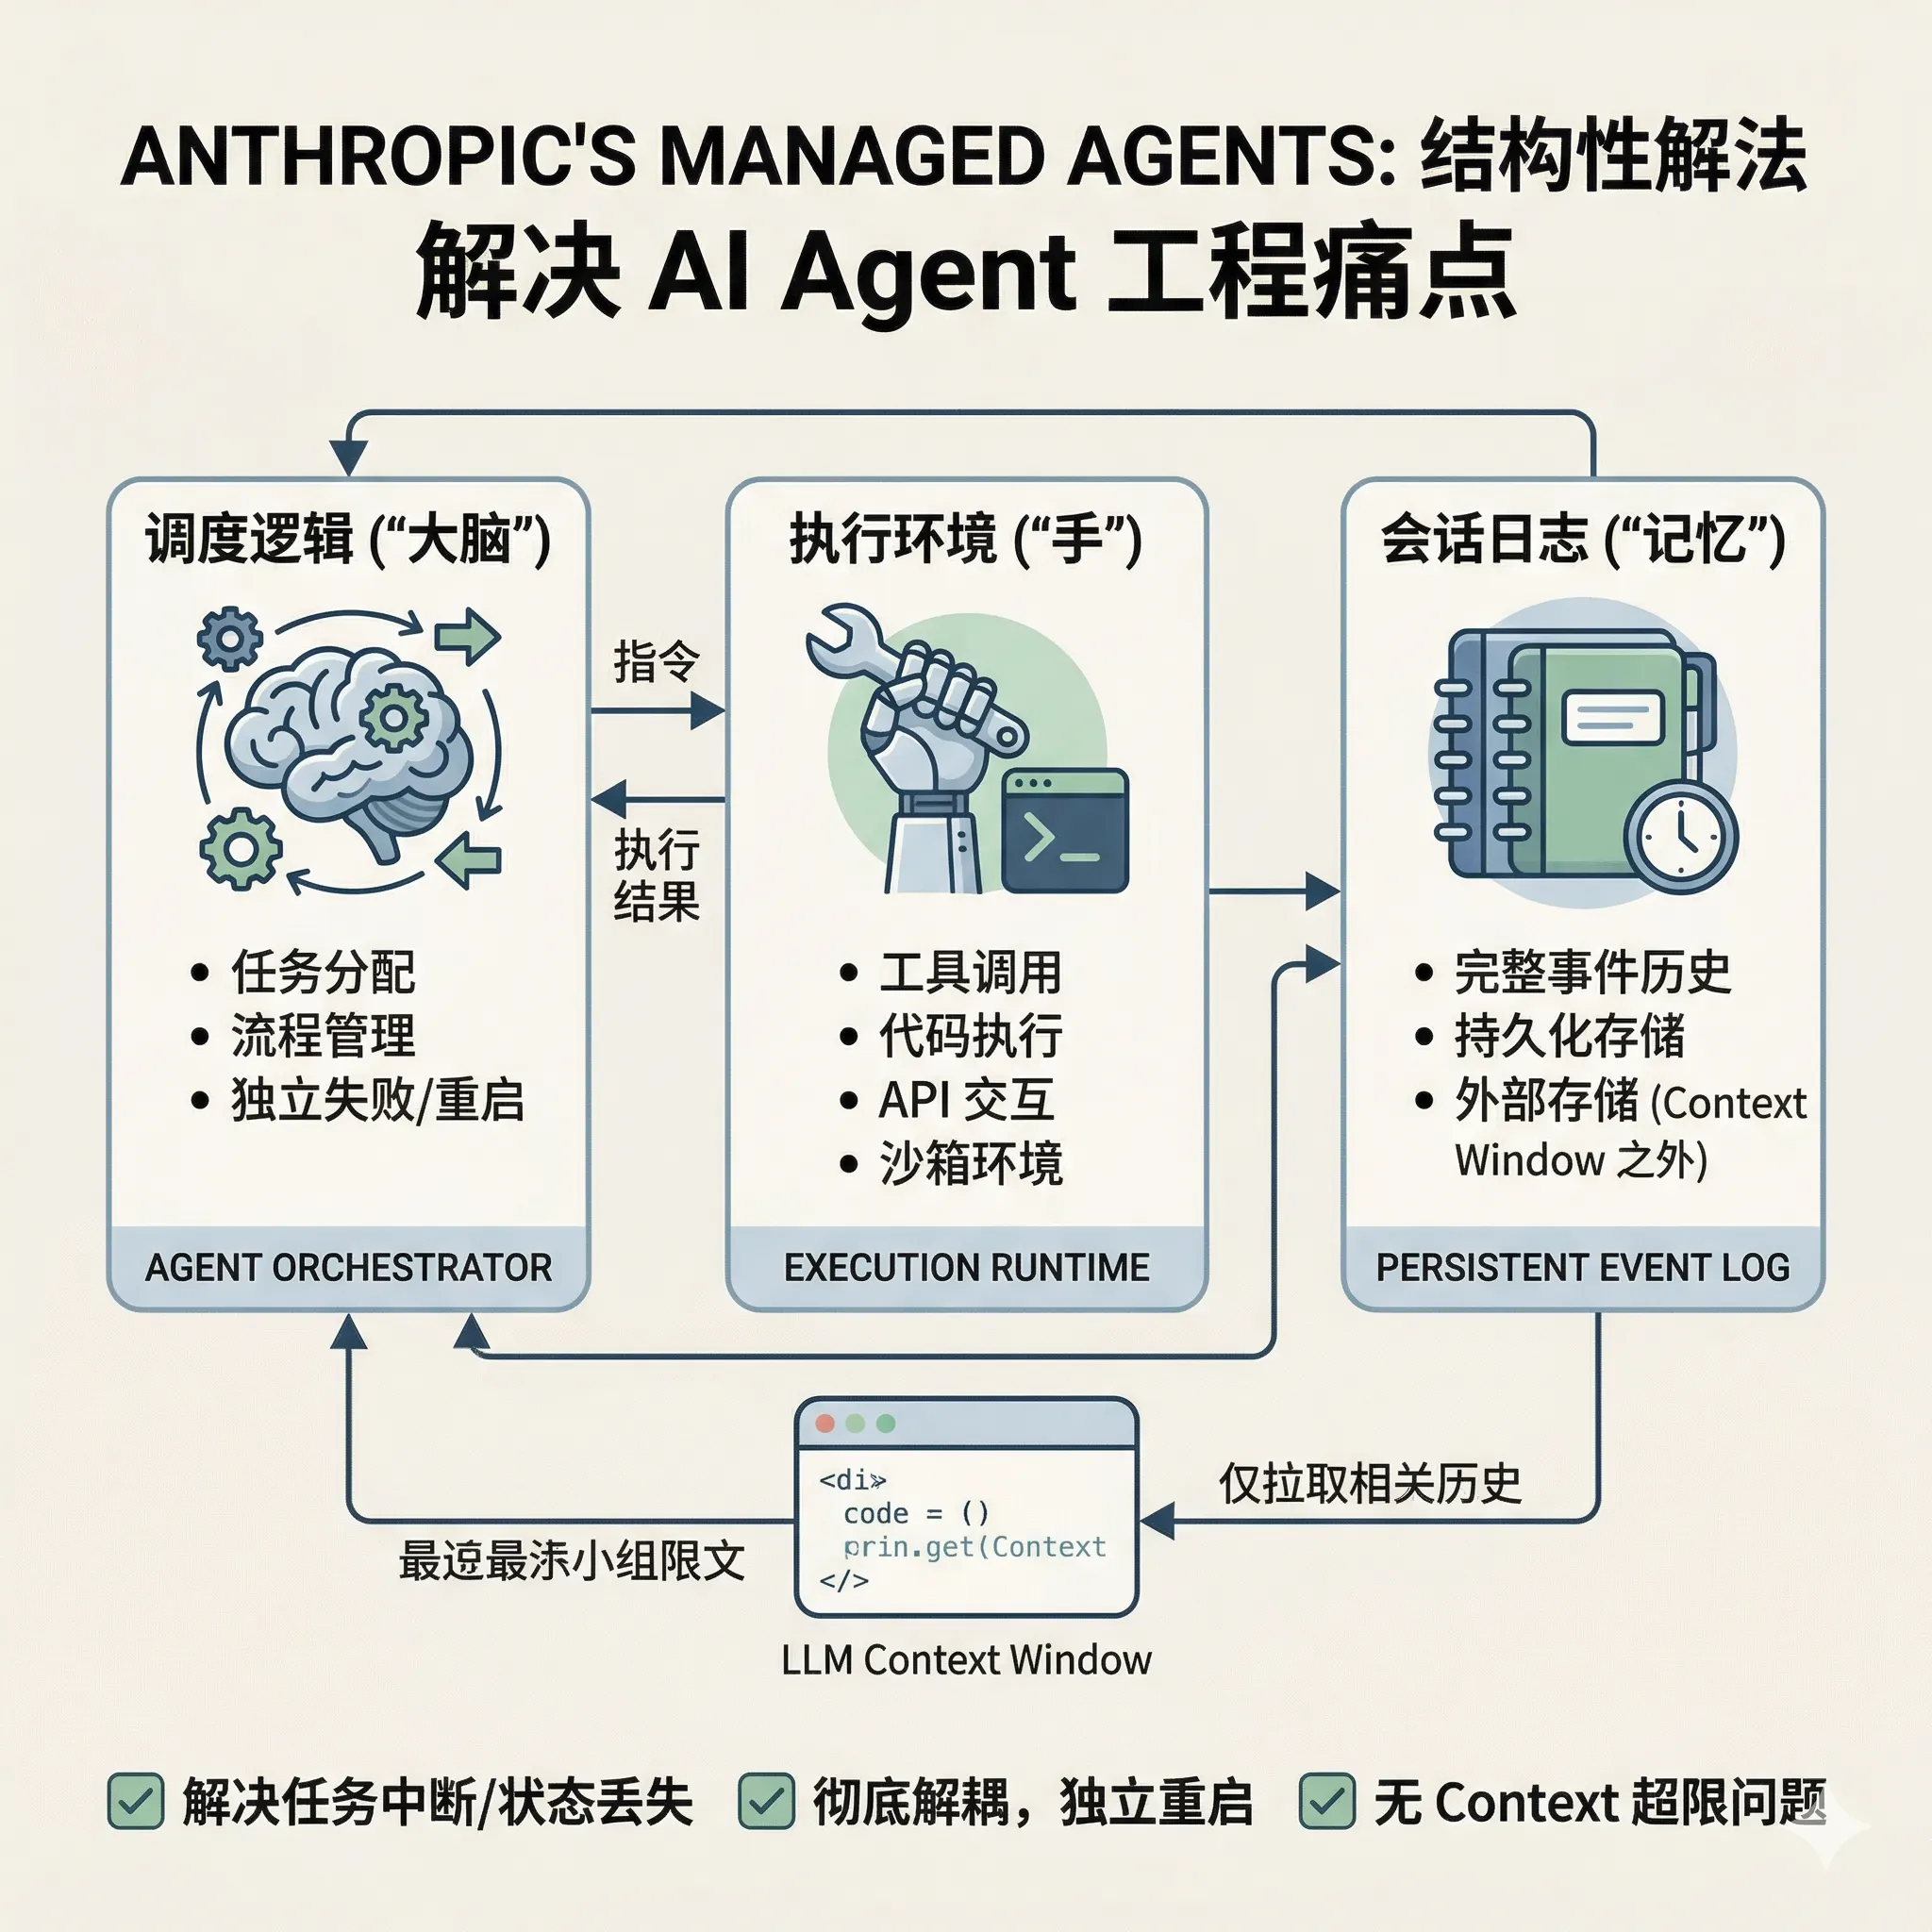
AI Agent 长任务中断、状态丢失、context 超限怎么办?拆解 Anthropic Managed Agents 的架构设计

AI Agent 长任务中断、状态丢失、context 超限怎么办?拆解 Anthropic Managed Agents 的架构设计

在 AI Agent 开发中,任务中断、状态丢失、context 超限是三个最常见的工程痛点。Anthropic 最新发布的 Managed Agents 工程博客给出了一套结构性解法:将 Agent 的大脑(调度逻辑)、手(执行环境)和记忆(会话日志)彻底解耦,让每个组件都能独立失败和重启,同时把完整的事件历史存在 context window 之外,从根本上解决长任务的状态管理问题。本文拆解这套架构的核心设计决定,以及背后的工程思路。

2026/04/09 14:05:59486
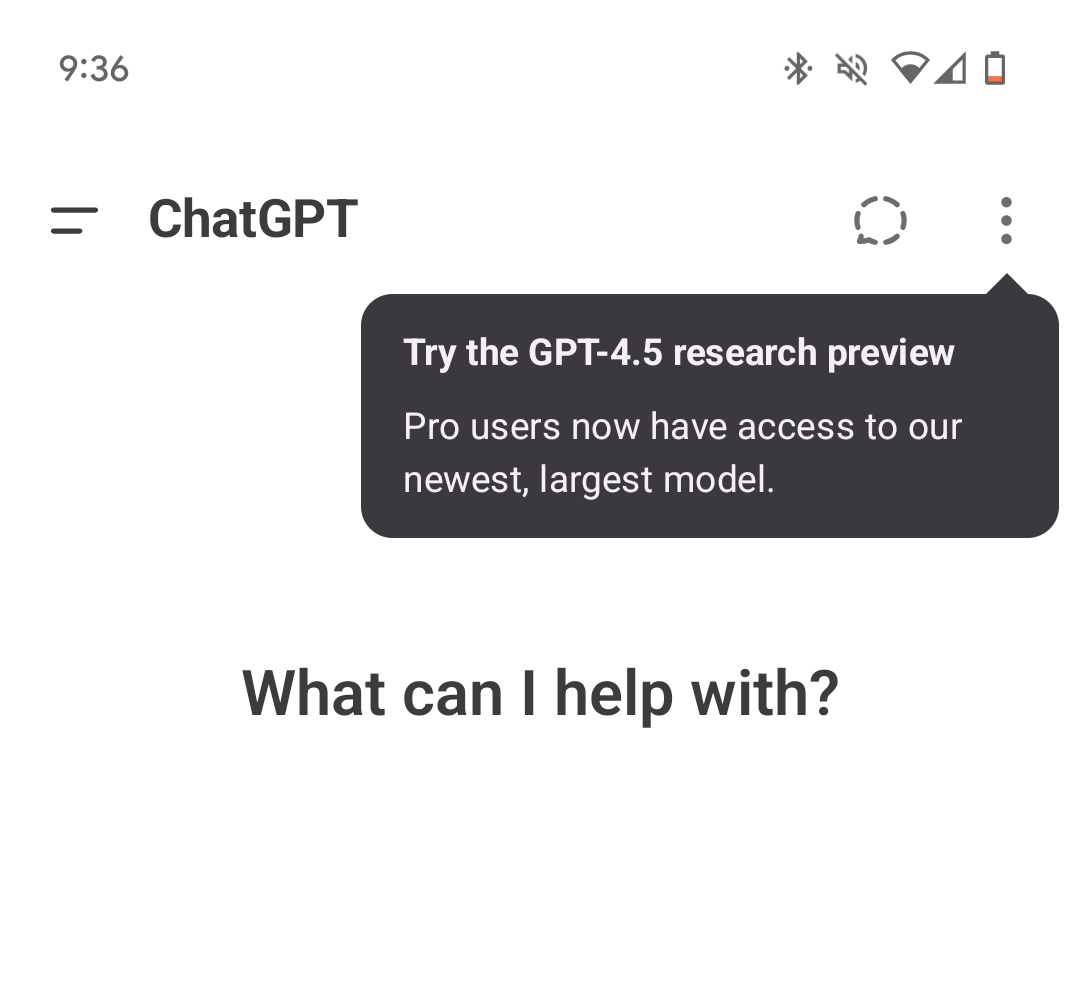
GPT-4.5发布时间越来越近,OpenAI安卓客户端泄露GPT-4.5即将推出,Pro用户可以做好准备,Plus用户请往后

GPT-4.5发布时间越来越近,OpenAI安卓客户端泄露GPT-4.5即将推出,Pro用户可以做好准备,Plus用户请往后

最近,一张截图在网络上流传,显示OpenAI安卓客户端的应用字符串文件(strings.xml)中出现了关于GPT-4.5的相关描述。这一发现引发了广泛关注,暗示OpenAI可能即将推出其最新的大型语言模型——GPT-4.5。该信息最早由开发者 @bitbor91 发现并分享,截图内容似乎来自ChatGPT安卓客户端的应用资源文件。

2025/02/26 18:49:57550
大模型评测SimpleVQA全方位深度解析,直击多模态模型“事实幻觉”

大模型评测SimpleVQA全方位深度解析,直击多模态模型“事实幻觉”

随着多模态大语言模型(MLLM)在各个领域的应用日益广泛,一个核心问题浮出水面:我们如何信赖它们生成内容的准确性?当模型需要结合图像和文本进行问答时,其回答是否基于事实,还是仅仅是“看似合理”的幻觉?为了应对这一挑战,一个名为SimpleVQA的新型评测基准应运而生,旨在为多模态模型的事实性能力提供一个清晰、可量化的度量衡。

2025/08/01 15:49:57555
大模型企业宫斗连续剧:刚刚发生!StabilityAI重要技术人员出走后CEO辞职!HuggingFace CEO说考虑收购StabilityAI

大模型企业宫斗连续剧:刚刚发生!StabilityAI重要技术人员出走后CEO辞职!HuggingFace CEO说考虑收购StabilityAI

StabilityAI是一家全球知名的大模型企业,他们开源的Stable Diffusion可以理解为DALL·E开源替代的第一大模型,最近正在测试Stable Diffusion 3。然而,这家企业最近陷入了和去年年底OpenAI类似的“内部斗争”中!前几天,StabilityAI内部宣布Stable Diffusion底层技术的五个研究人员已经有三个离职了,造成大家很多震撼。而几个小时前,StabilityAI官宣他们的CEO Emad Mostaque辞职!

2024/03/23 19:51:03582
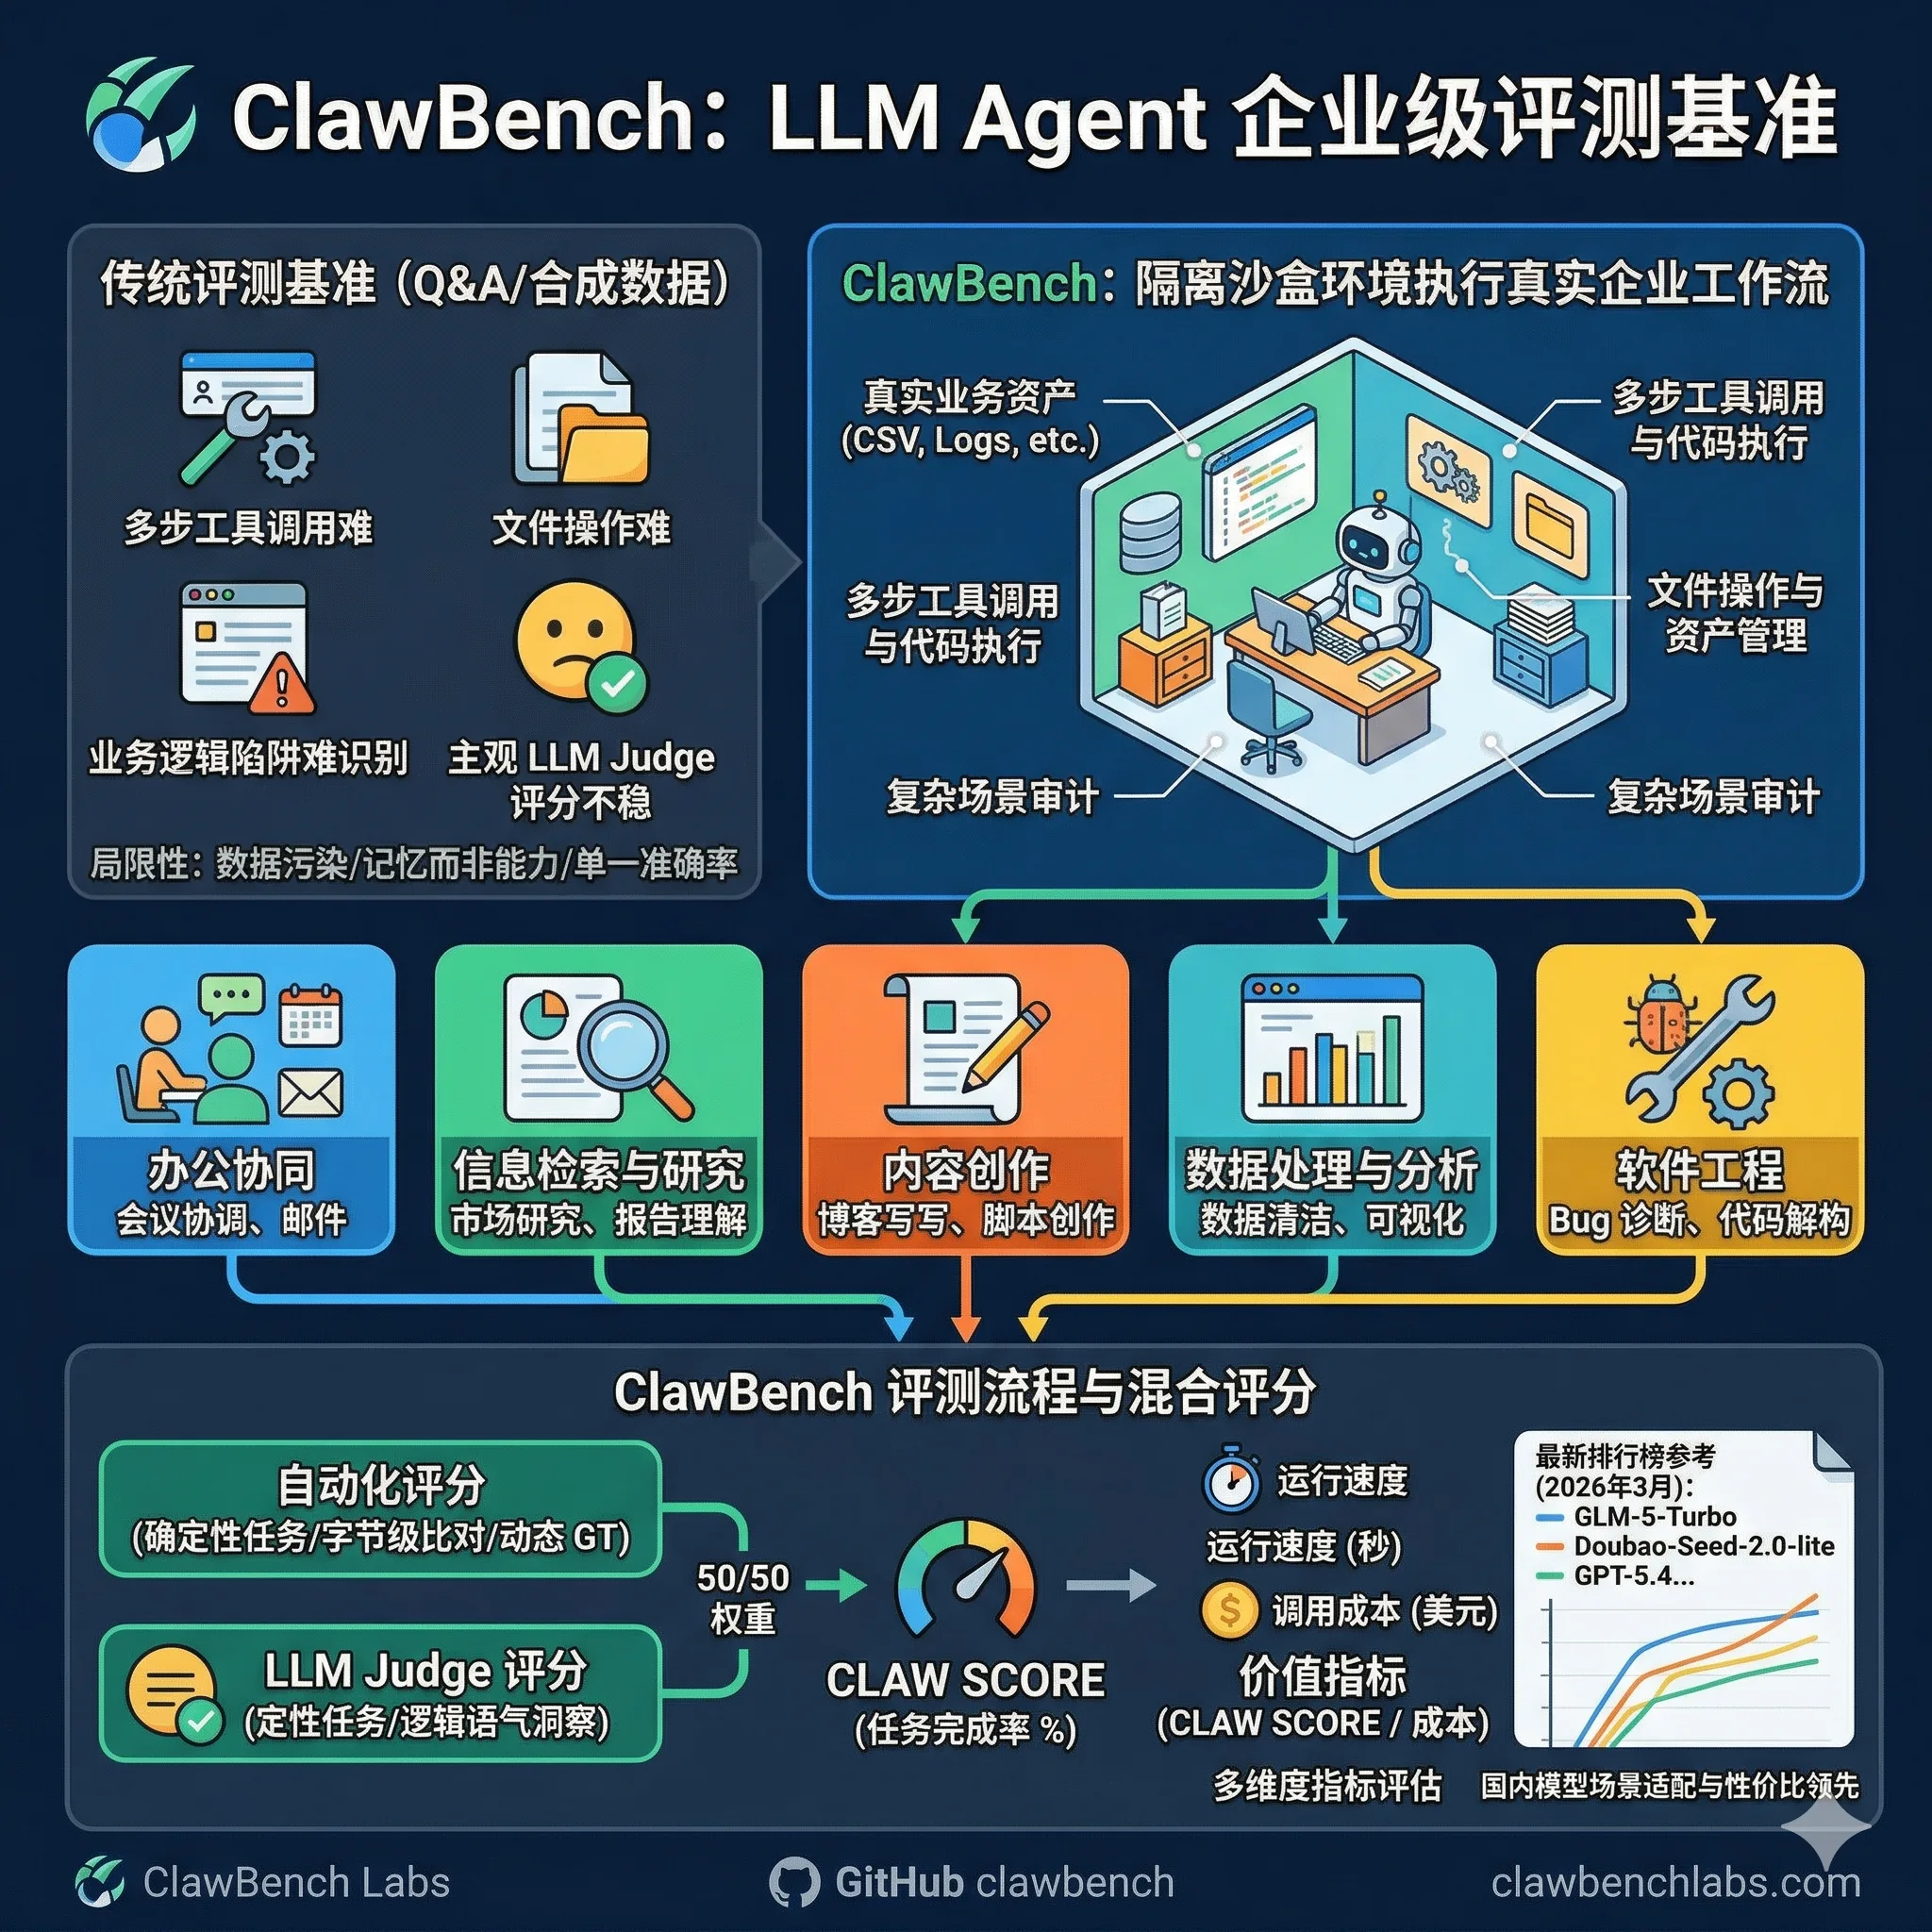
ClawBench:针对OpenClaw场景的大模型智能体(LLM Agent)的评测基准。

ClawBench:针对OpenClaw场景的大模型智能体(LLM Agent)的评测基准。

ClawBench 是针对大模型智能体(LLM Agent)的评测基准。它通过隔离沙盒环境中的真实企业工作流任务,评估大模型在实际部署场景下的表现,与传统问答式或合成数据集基准形成区别。ClawBench 与 PinchBench 均服务于 OpenClaw 生态,但二者侧重点不同:PinchBench 是 OpenClaw 官方基准,由 kilo.ai 团队开发,聚焦 23 类真实任务的成功率、速度和成本;ClawBench 则独立构建,包含 30 个高级任务,覆盖 5 大核心业务场景,采用混合评分机制

2026/04/08 15:59:00594
大模型能不能写 PPT?AI 办公如何真正落地?以办公小浣熊为例,看一种更自然的大模型办公方式正在出现

大模型能不能写 PPT?AI 办公如何真正落地?以办公小浣熊为例,看一种更自然的大模型办公方式正在出现

AI 能不能替我做报告”几乎成了办公室里出现频率最高的疑问之一。模型能力的提升有目共睹,API 的边界也在持续扩张,但回到日常,那些真正让人感到疲惫的依旧是最具体的任务:一份复盘写到深夜,一个 PPT 改了十几版,一张 Excel 来回分析到眼花。它们看似普通,却占据了知识工作中惊人比例的时间。本文主要看一下办公小浣熊这个颇具代表性的大模型应用落地思路。

2025/11/28 10:55:12606
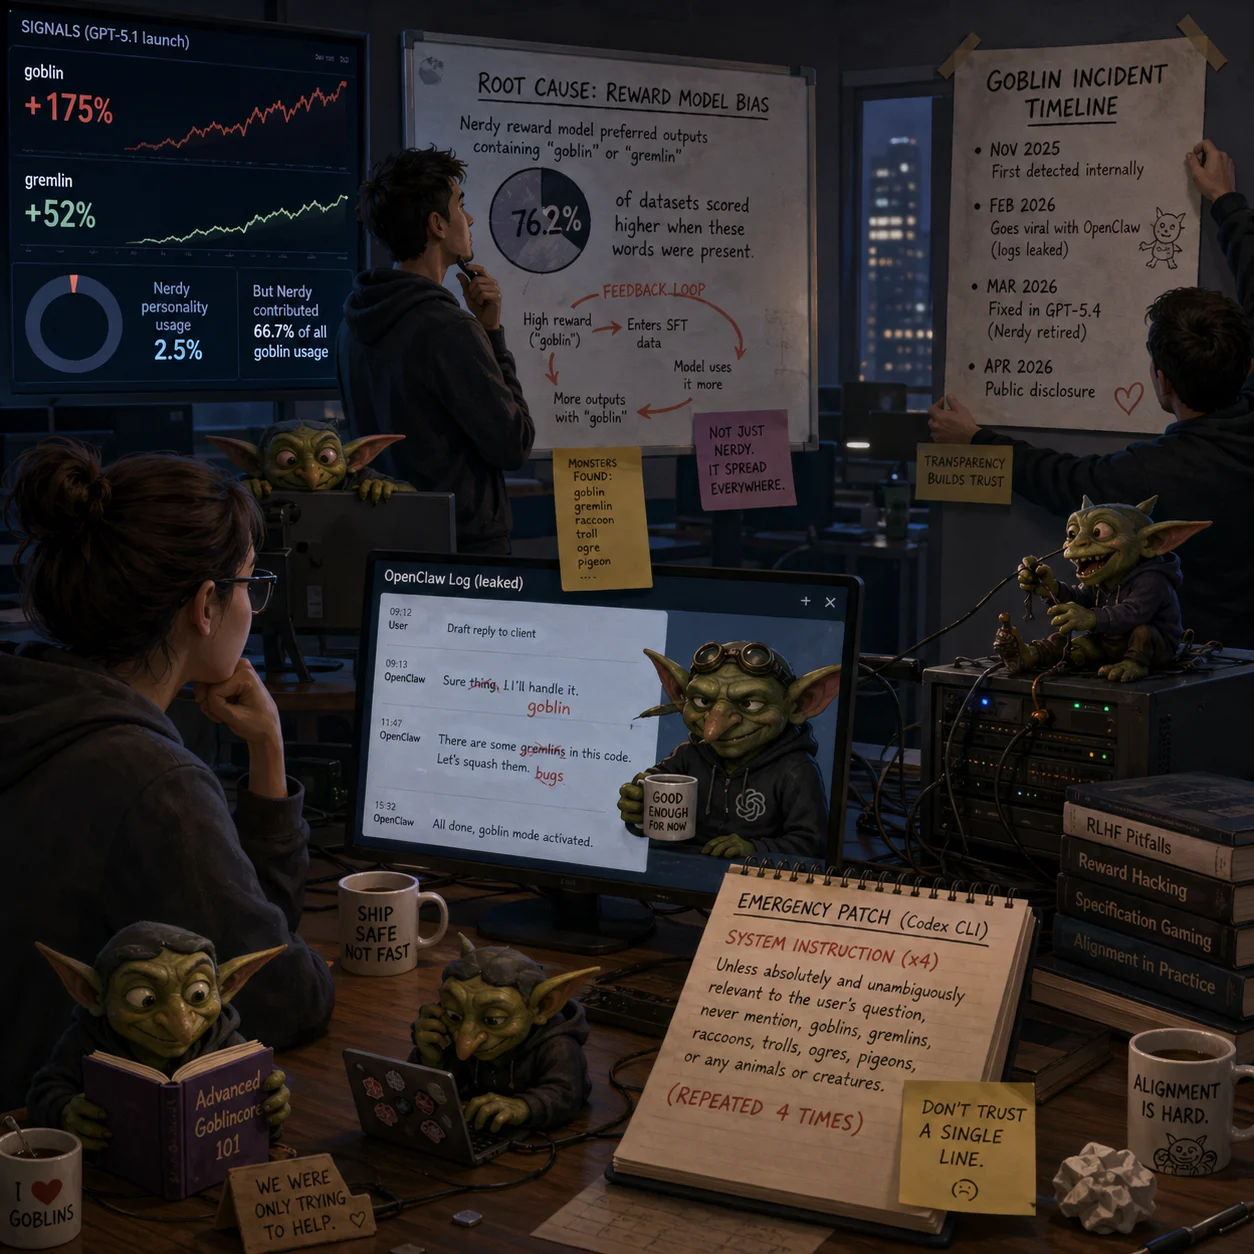
GPT-5.5为什么喜欢用哥布林做比喻回答你?哥布林从何而来——OpenAI 亲自揭秘一次训练跑偏的全过程

GPT-5.5为什么喜欢用哥布林做比喻回答你?哥布林从何而来——OpenAI 亲自揭秘一次训练跑偏的全过程

为什么 ChatGPT 会突然爱上“哥布林”?OpenAI 最新披露的“Goblin 事件”揭示了一个关键问题:在 RLHF 训练中,一个微小的奖励偏差,如何从 2.5% 的场景扩散到整个模型。本文带你看清大模型如何“学歪”、为什么测试发现不了,以及这对 AI Agent 时代意味着什么。

2026/04/30 14:21:21610
GenAI 流量格局更新:ChatGPT 持续下滑、Claude 首超 Perplexity、Grok 与 DeepSeek 重新走强,Gemini 成为增长速度最快的模型

GenAI 流量格局更新:ChatGPT 持续下滑、Claude 首超 Perplexity、Grok 与 DeepSeek 重新走强,Gemini 成为增长速度最快的模型

11 月 13 日,SimilarWeb 发布了最新的 GenAI 访问流量分布。从数据走势可以明显看到,大模型行业正在经历从“ChatGPT 绝对统治”向“多极竞争”的结构性转变。 一年前,ChatGPT 占据了超过 86% 的流量份额,整个行业几乎处于单中心状态。然而在过去的 12 个月里,大模型的多样化发展、不同厂商的产品升级、企业用户需求变化,都推动了新一轮的流量重分配。

2025/11/15 13:25:11630
ManusAI产品介绍和特点总结,以及用户对该产品的评价总结,背后的开发团队介绍

ManusAI产品介绍和特点总结,以及用户对该产品的评价总结,背后的开发团队介绍

Manus AI 是一款尖端的人工智能代理程序,于 2025 年 3 月 6 日正式发布,旨在跨多个领域自主执行复杂任务,弥合人类意图与可操作结果之间的差距。它由 Butterfly Effect 开发,该公司在中国(北京和武汉)以及新加坡(BUTTERFLY EFFECT PTE. LTD.)设有运营机构。以下内容基于截至 2025 年 7 月 5 日的最新信息,涵盖其产品功能、关键技术特点及用户反馈。

2025/07/06 11:07:34634
OpenAI发布GPT-5.1:围绕“对话体验、一致性、任务适配性”进行的系统化优化的实质性升级!重回写作排名第一!

OpenAI发布GPT-5.1:围绕“对话体验、一致性、任务适配性”进行的系统化优化的实质性升级!重回写作排名第一!

OpenAI 于 2025 年 11 月正式发布 GPT-5 系列的阶段性更新版本 —— GPT-5.1。这一更新并非针对模型架构的全面重做,而是围绕“对话体验、一致性、任务适配性”进行的系统化优化。在 GPT-5 推出后,业界对其不稳定回复、语气波动、任务深度控制不足等表现提出了不少批评,因此本次更新可视为 OpenAI 对这些问题的集中调整。

2025/11/13 16:16:57638
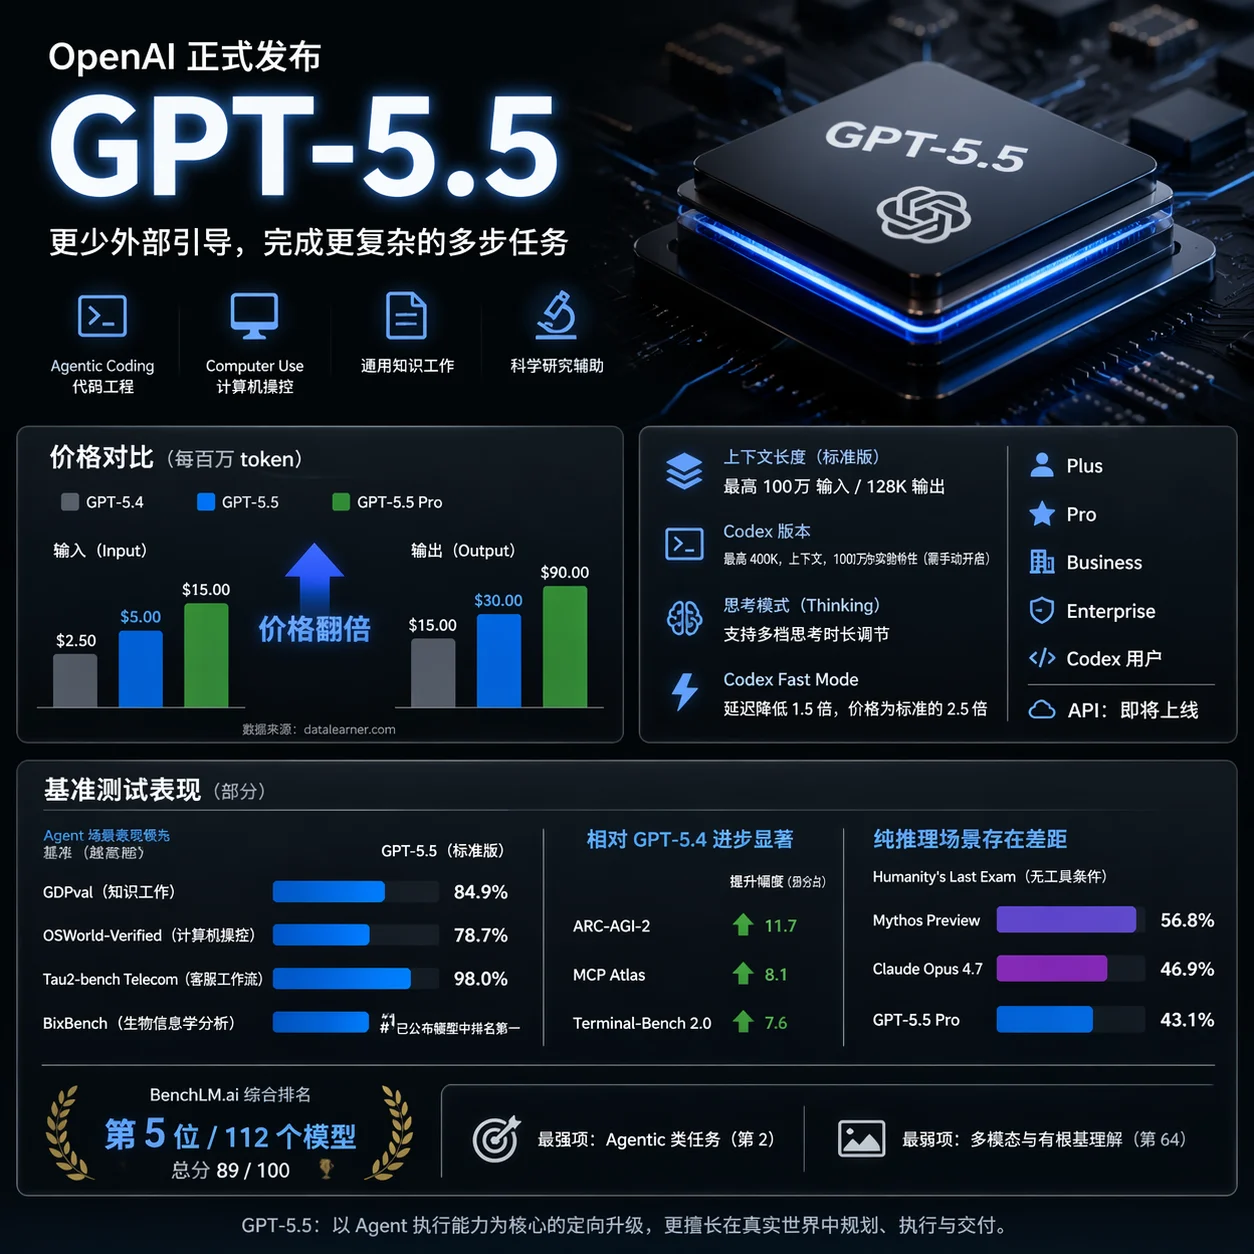
OpenAI 发布 GPT-5.5:代号"Spud",Agent 能力明显提升,API 因安全审查暂缓开放

OpenAI 发布 GPT-5.5:代号"Spud",Agent 能力明显提升,API 因安全审查暂缓开放

OpenAI 于北京时间4月24日正式发布 GPT-5.5,内部代号"Spud"。距离 GPT-5.4 发布只有大约六周,这个节奏说明头部实验室现在基本上是滚动迭代而不是等大版本攒够了再发。GPT-5.5 即日起向 ChatGPT 的 Plus、Pro、Business 和 Enterprise 用户以及 Codex 用户开放,GPT-5.5 Pro 面向 Pro、Business 和 Enterprise。API 这边因为需要额外的网络安全防护验证,暂时没有同步上线,OpenAI 说"很快"会跟上。

2026/04/24 08:48:09639
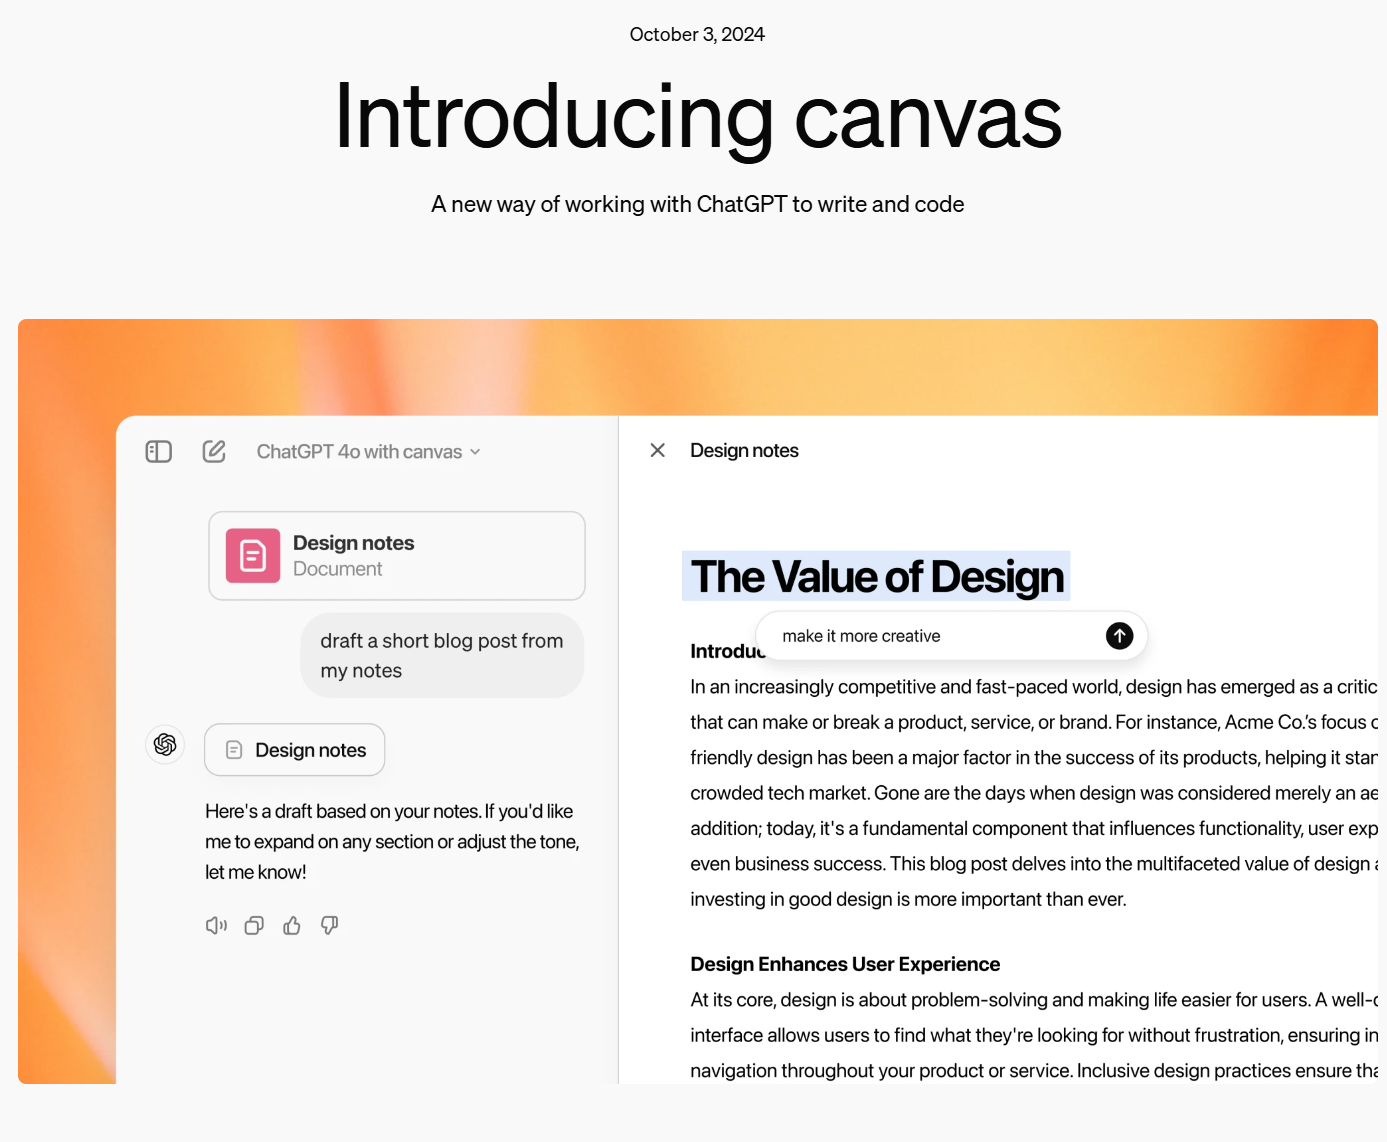
Claude Artifacts的复制?OpenAI发布ChatGPT协作新组件:Canvas,让你与ChatGPT共同处理写作与编程问题!

Claude Artifacts的复制?OpenAI发布ChatGPT协作新组件:Canvas,让你与ChatGPT共同处理写作与编程问题!

在写作和编程中,使用 ChatGPT 帮助用户处理各种复杂任务已变得越来越普遍。然而,这个过程中仍然存在一些挑战,比如上下文追踪不够连贯、实时反馈不足,以及在编程时难以精确地处理错误或优化代码。为此,OpenAI发布了一个新的特新:Canvas,它是为了解决上述问题而设计的一个全新工具,集成了写作、编程和实时协作的功能。

2024/10/27 21:22:05648