

原创博客
原创AI技术博客
探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。
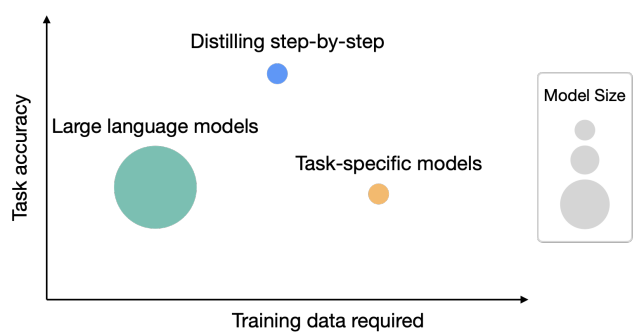
如何用7.7亿参数的蒸馏模型超过5400亿的大语言模型——Google提出新的模型蒸馏方法:逐步蒸馏(Distilling step-by-step)详解
华盛顿大学研究人员与Google的研究人员一起在5月3日公布了一个新的方法,即逐步蒸馏(Distilling step-by-step),这个方法最大的特点有2个:一是需要更少的数据来做模型的蒸馏(根据论文描述,平均只需要之前方法的一半数据,最多只需要15%的数据就可以达到类似的效果);而是可以获得更小规模的模型(最多可以比原来模型规模小2000倍!)
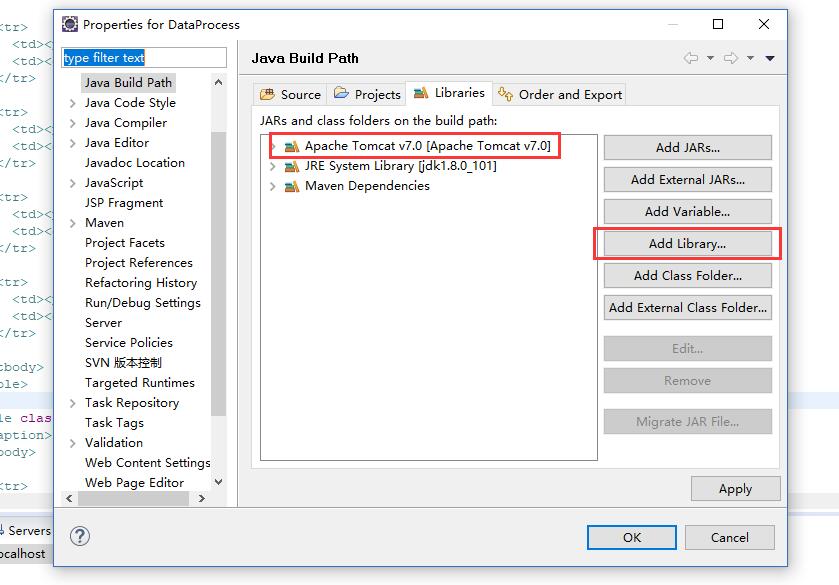
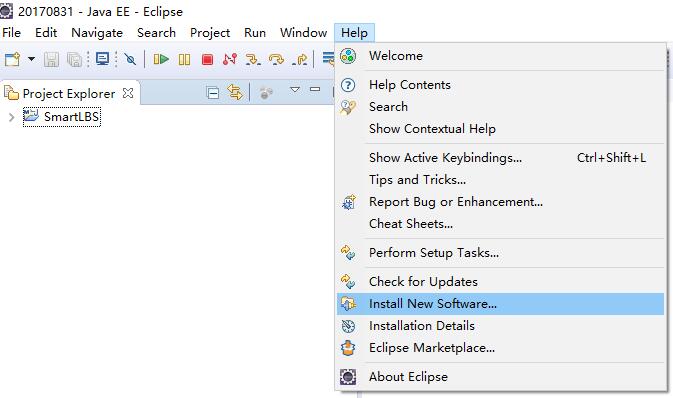
eclispe常见错误及其解决方案
eclipse创建导入项目的时候经常会发生各种错误。本篇博客将讲述常见的错误及其解决方案。
为初学者、中级和有经验的开发者提供70多个python项目
为初学者、中级和有经验的开发者提供70多个python项目, 10000, 小木, PythonHub今天在推上给大家分享了一个非常棒的项目,就是这个为为初学者、中级和有经验的开发者提供70多个python项目。 亲自动手实践一些项目可以增加我们的实际的编程技巧。每一次都做一点将会得到很多。很多人都在GitHub、Reddit或者是Quera上搜索过哪些项目可以让Python初学者、中级者增加经验的Python项目。这次它来了。
华为大模型生态重要一步!PyTorch最新2.1版本宣布支持华为昇腾芯片(HUAWEI Ascend)
大模型的发展一个重要的基础条件是底层硬件计算能力的大幅提高,特别是GPU的发展,与transformer架构的大模型训练非常契合。当前全球最大的GPU供应商英伟达系列的显卡几乎垄断了大模型训练与推理的所有GPU芯片市场。除了英伟达显卡本身算力强悍外,基于英伟达GPU之上构建的CUDA、PyTorch等平台软件生态也是非常重要的一环。而最新的PyTorch2.1版本发布的一个beta特性中包含了对华为昇腾芯片的原生支持,这也是大模型生态多样性发展的一个很重要的信号。
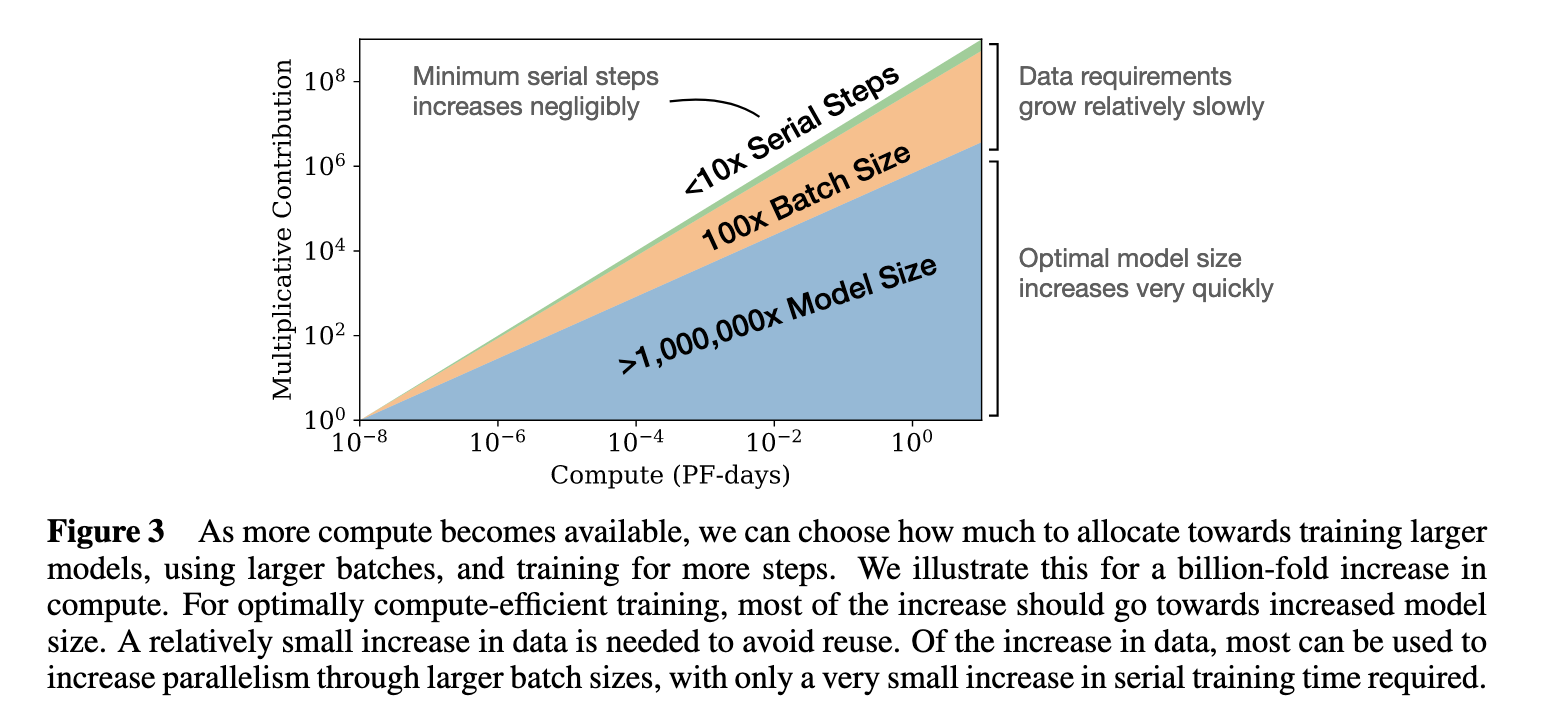
大型语言模型的新扩展规律(DeepMind新论文)——Training Compute-Optimal Large Language Models
3月29日,DeepMind发表了一篇论文,"Training Compute-Optimal Large Language Models",表明基本上每个人--OpenAI、DeepMind、微软等--都在用极不理想的计算方式训练大型语言模型。论文认为这些模型对计算的使用一直处于非常不理想的状态。并提出了新的模型缩放规律。

Terminal-Bench 评测全解析:一个用于评测大模型在终端环境使用工具能力的评测基准以及Terminal 1.0与 2.0 的完整对比
本文介绍 Terminal-Bench 的设计理念,深入讲解 core、Terminal-Bench Hard 与最新 Terminal-Bench 2.0 的区别,帮助开发者选择合适的 AI 终端评测基准。
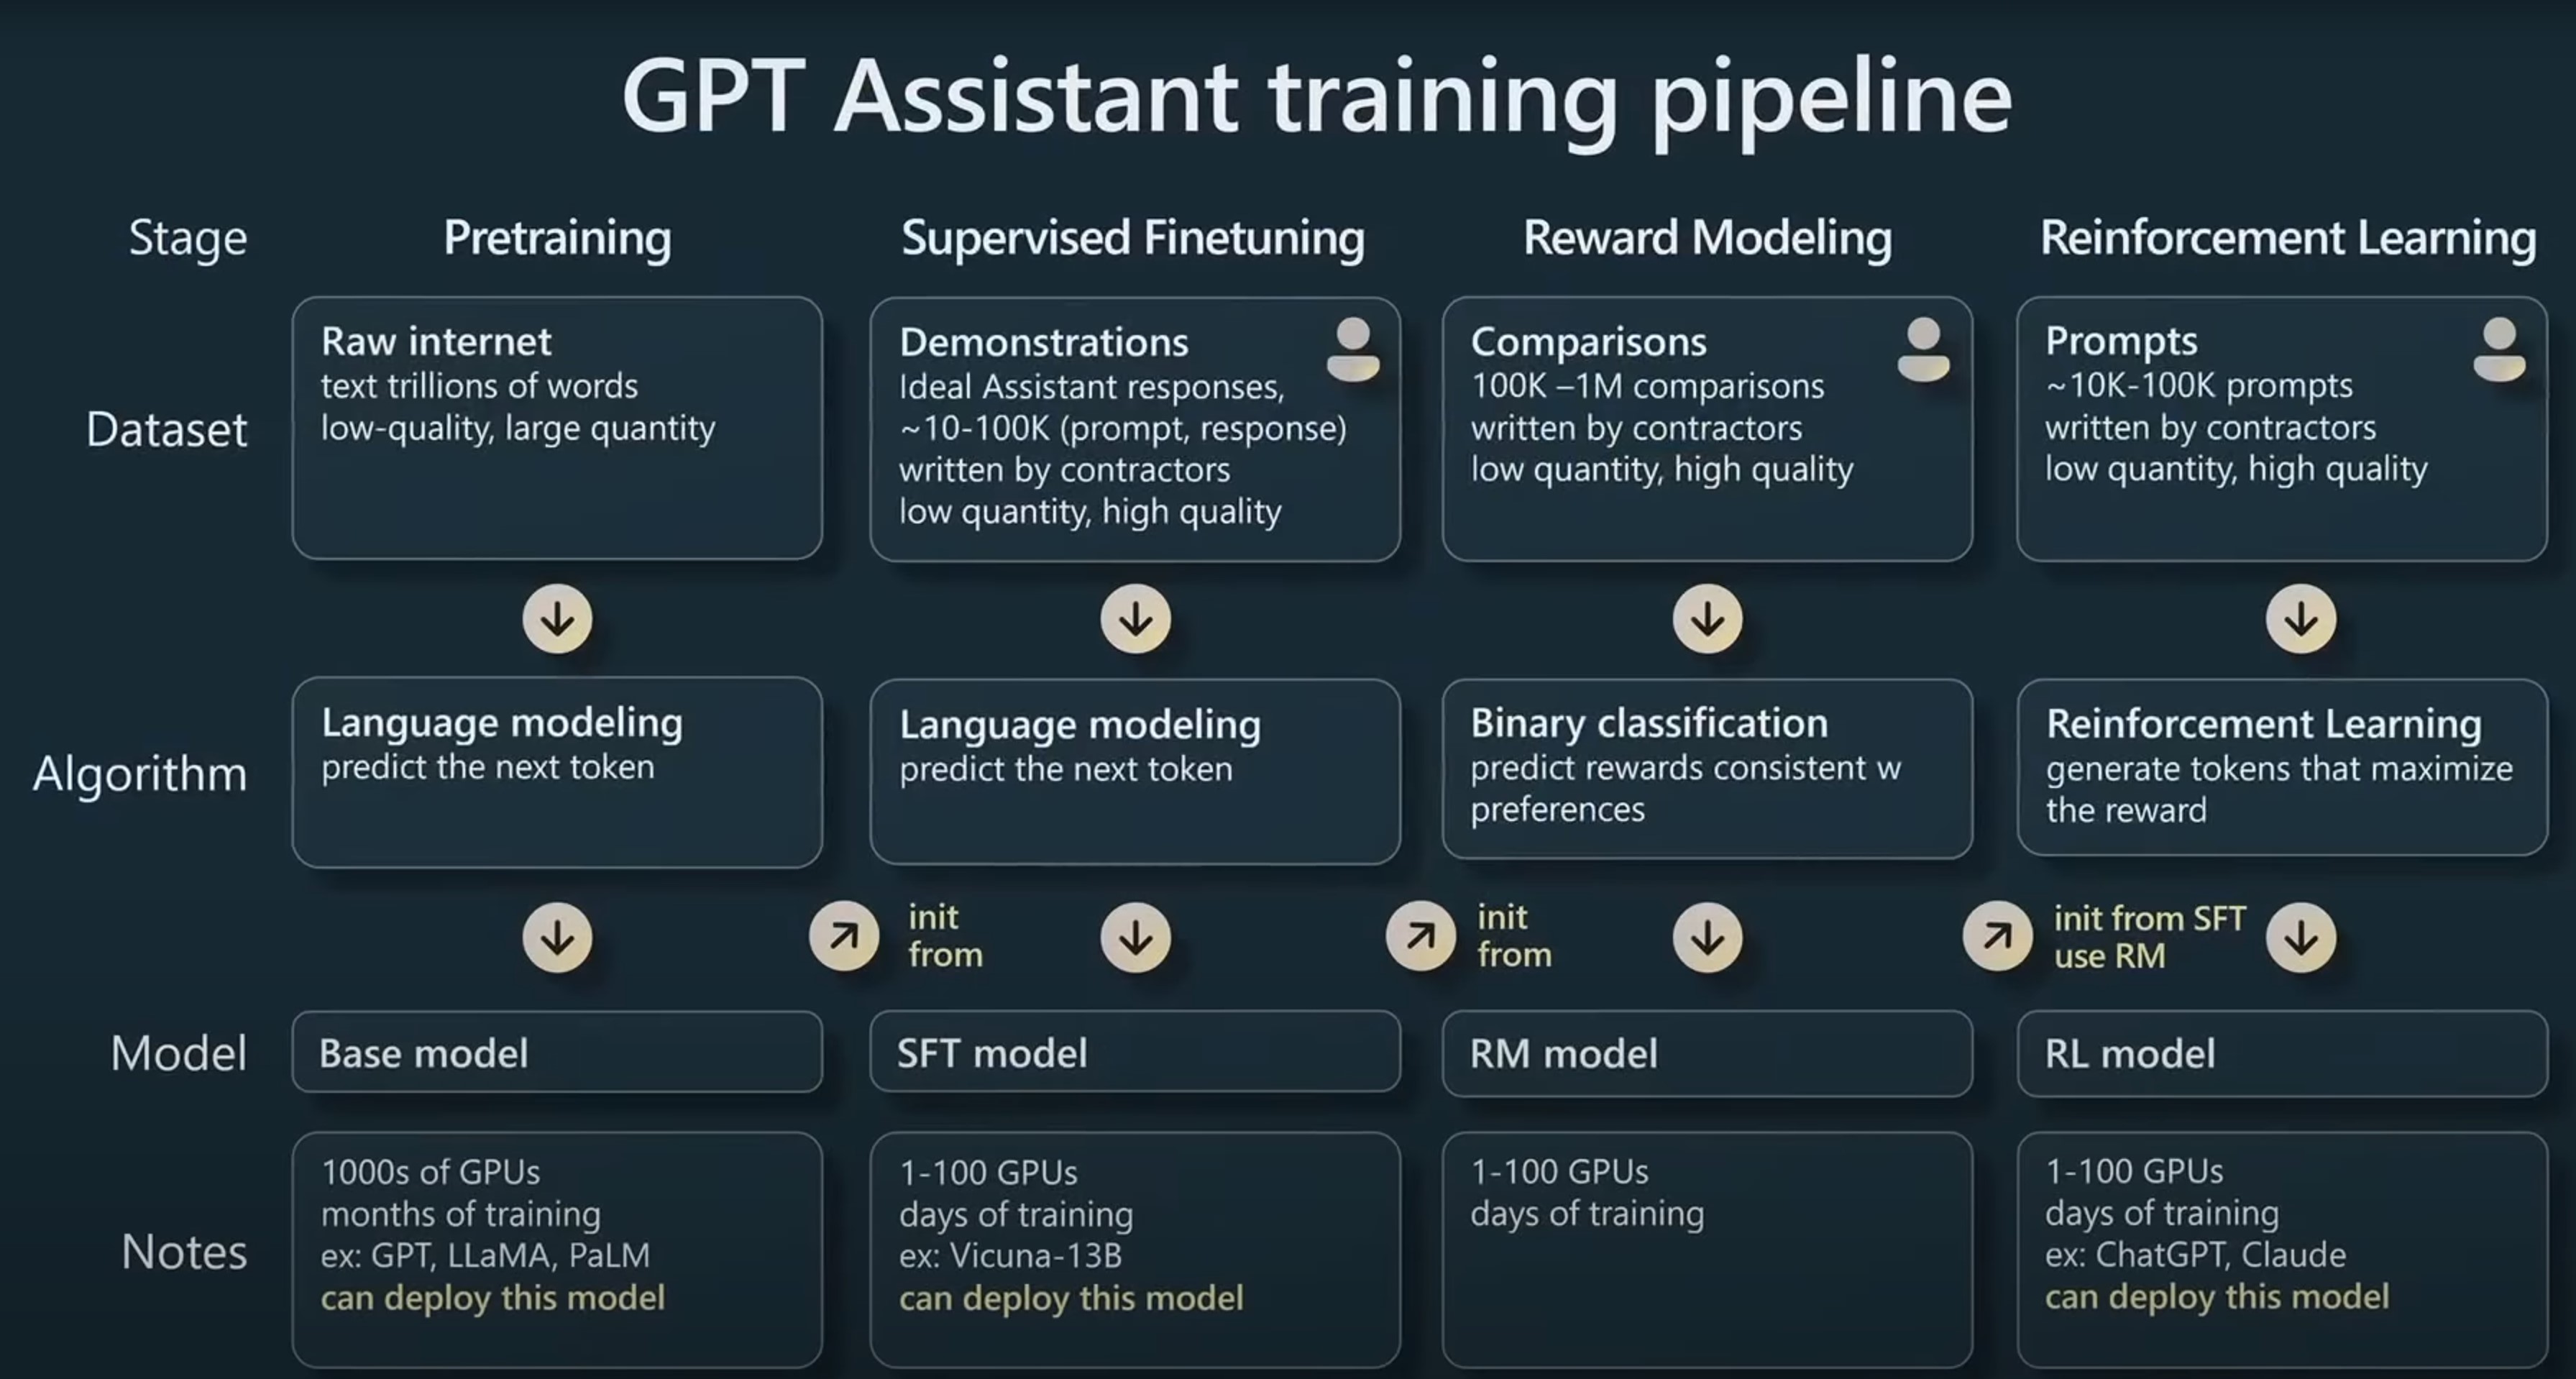
来自Microsoft Build 2023:大语言模型是如何被训练出来的以及语言模型如何变成ChatGPT——State of GPT详解
在今年的Microsoft Build 2023大会上,来自OpenAI的研究员Andrej Karpathy在5月24日的一场汇报中用了40分钟讲解了ChatGPT是如何被训练的,其中包含了训练一个能支持与用户对话的GPT的全流程以及涉及到的一些技术。信息含量丰富,本文根据这份演讲总结。
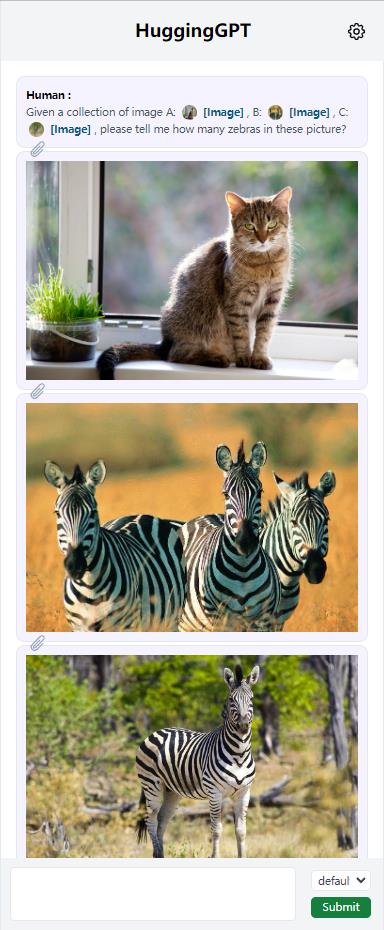
“GPT”的模型太多无法选择?让大模型帮你选择大模型!浙江大学发布HuggingGPT!
随着ChatGPT的火爆以及MetaAI开源了LLaMA,各家公司好像一夜之间都有了各种ChatGPT模型的研发实力。而针对不同任务和应用构建的LLM更是层出不穷。那么,如何选择合适的模型完成特定的任务,甚至是使用多个模型完成一个复杂的任务似乎仍然很困难。为此,浙江大学与微软亚洲研究院联合发布了一个大模型写作系统HuggingGPT,可以根据输入的任务帮我们选择合适的大模型解决!
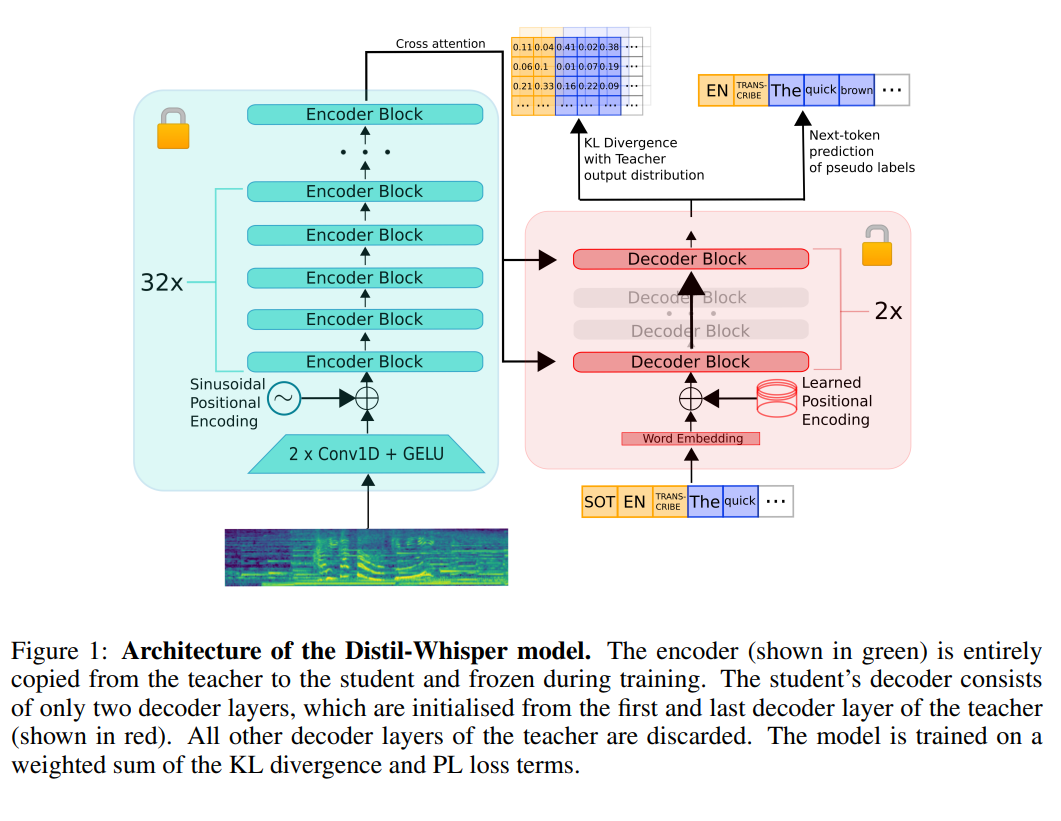
HuggingFace开源语音识别模型Distil-Whisper,基于OpenAI的Whisper-V2模型蒸馏,速度快6倍,参数小49%!
语音识别在实际应用中有非常多的应用。早先,OpenAI发布的Whisper模型是目前语音识别模型中最受关注的一类,也很可能是目前ChatGPT客户端语音识别背后的模型。HuggingFace基于Whisper训练并开源了一个全新的Distil-Whisper,它比Whisper-v2速度快6倍,参数小49%,而实际效果几乎没有区别。

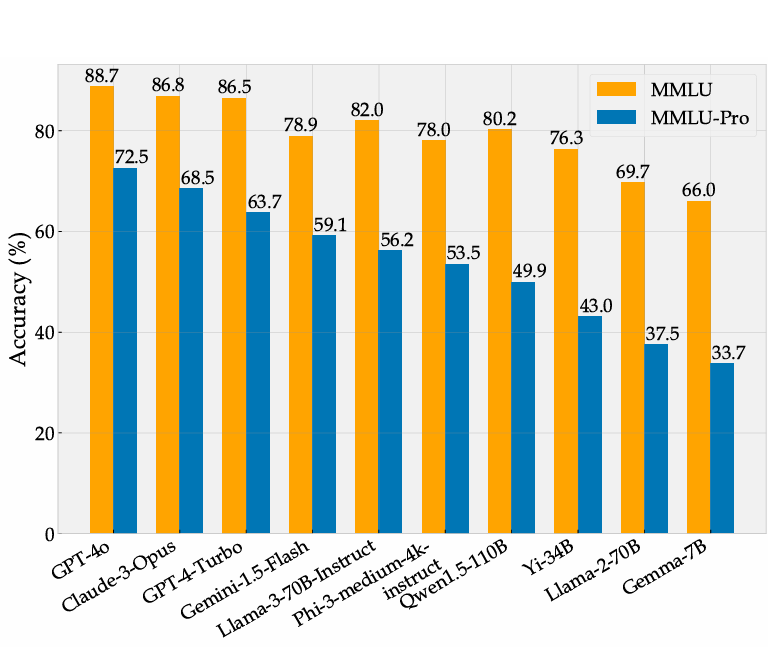
MMLU Pro大模型评测基准介绍:MMLU的进化版本,可以更好区分大模型普遍知识和推理能力的通用评测标准
大模型已经对很多行业产生了巨大的影响,如何准确评测大模型的能力和效果,已经成为业界亟待解决的关键问题。生成式AI模型,如大型语言模型(LLMs),能够生成高质量的文本、代码、图像等内容,但其评测却相对很困难。而此前很多较早的评测也很难区分当前最优模型的能力。 以MMLU评测为例,2023年3月份,GPT-4在MMLU获得了86.4分之后,将近2年后的2024年年底,业界最好的大模型在MMLU上得分也就90.5,提升十分有限。 为此,滑铁卢大学、多伦多大学和卡耐基梅隆大学的研究人员一起提出了MMLU P
帮助你提升知识和技能的17个数据科学项目(都是可以免费获取的)
数据科学项目为我们提供了很好的机会提升我们的技能和知识。这篇博客提供了17个数据科学的项目,都是可以免费获取的项目,大家可以通过这些诶项目学习数据科学相关知识。
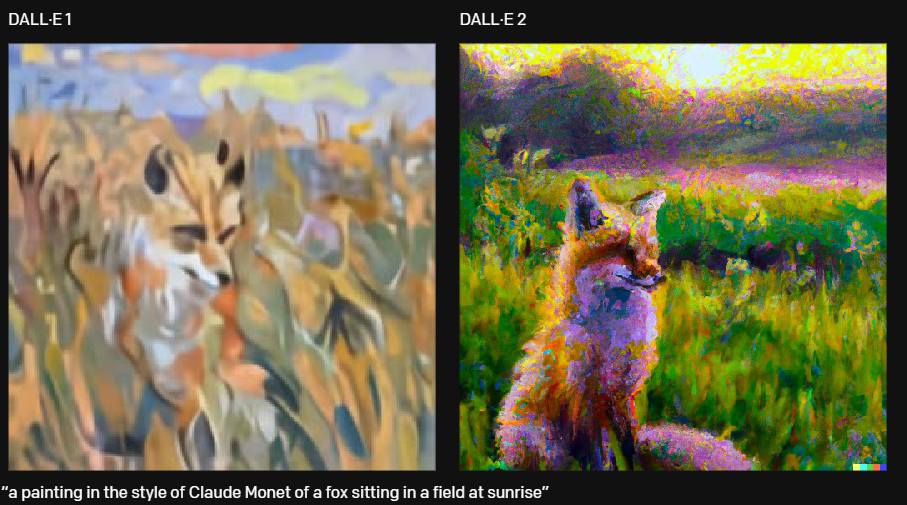
OpenAI第二代DALL·E发布,可以使用自然语言创造和编辑图片的模型
今天,时隔一年后,OpenAI发布了第二代的DALL·E模型。相比较第一代的模型,DALL·E 2,以4倍的分辨率生成更真实和准确的图像。
大数据环境下的处理系统与数据分析
随着互联网的高速发展,人类进入了一个信息爆炸的时代,每个人的生活都充满了结构化和非结构化的数据。另外,随着以博客、社交网络、基于位置的服务LBS为代表的新型信息发布方式的不断涌现,以及云计算、物联网技术的兴起,数据正以前所未有的速度在不断地增长和积累,数据已经渗透到当今每一个行业和业务职能领域成为重要的产生因素,以数据为驱动的大数据时代已经不可避免地到来。本文主要围绕大数据特征、处理系统、以及大数据分析来阐述大数据环境下的数据分析在思想、流程、方法等方面的转变,以及围绕此主题而出现的相关关键技术与方法。
强烈推荐斯坦福大学的深度学习示意图网站
CS 230 ― Deep Learning是斯坦福大学视觉实验室(Stanford Vision Lab)的Shervine Amidi老师开设的深度学习课程,他在课程网站上挂了一个关于深度学习示意图的网站,这里面包含了各种深度学习相关概念的示意图和动图,十分简单明了。