
text-davinci-003后继者!OpenAI发布了一个新的补全大模型:GPT-3.5-Turbo-Instruct,完全的指令模型,没有聊天优化
OpenAI最新发布了GPT-3.5-Turbo-Instruct,这是一款强大的指令遵循大模型。尽管官方没有发布官方博客介绍,但我们将在本文中详细探讨这一模型的特点以及其在人工智能领域的价值。
汇总「G」相关的原创 AI 技术文章与大模型实践笔记,持续更新。
OpenAI最新发布了GPT-3.5-Turbo-Instruct,这是一款强大的指令遵循大模型。尽管官方没有发布官方博客介绍,但我们将在本文中详细探讨这一模型的特点以及其在人工智能领域的价值。
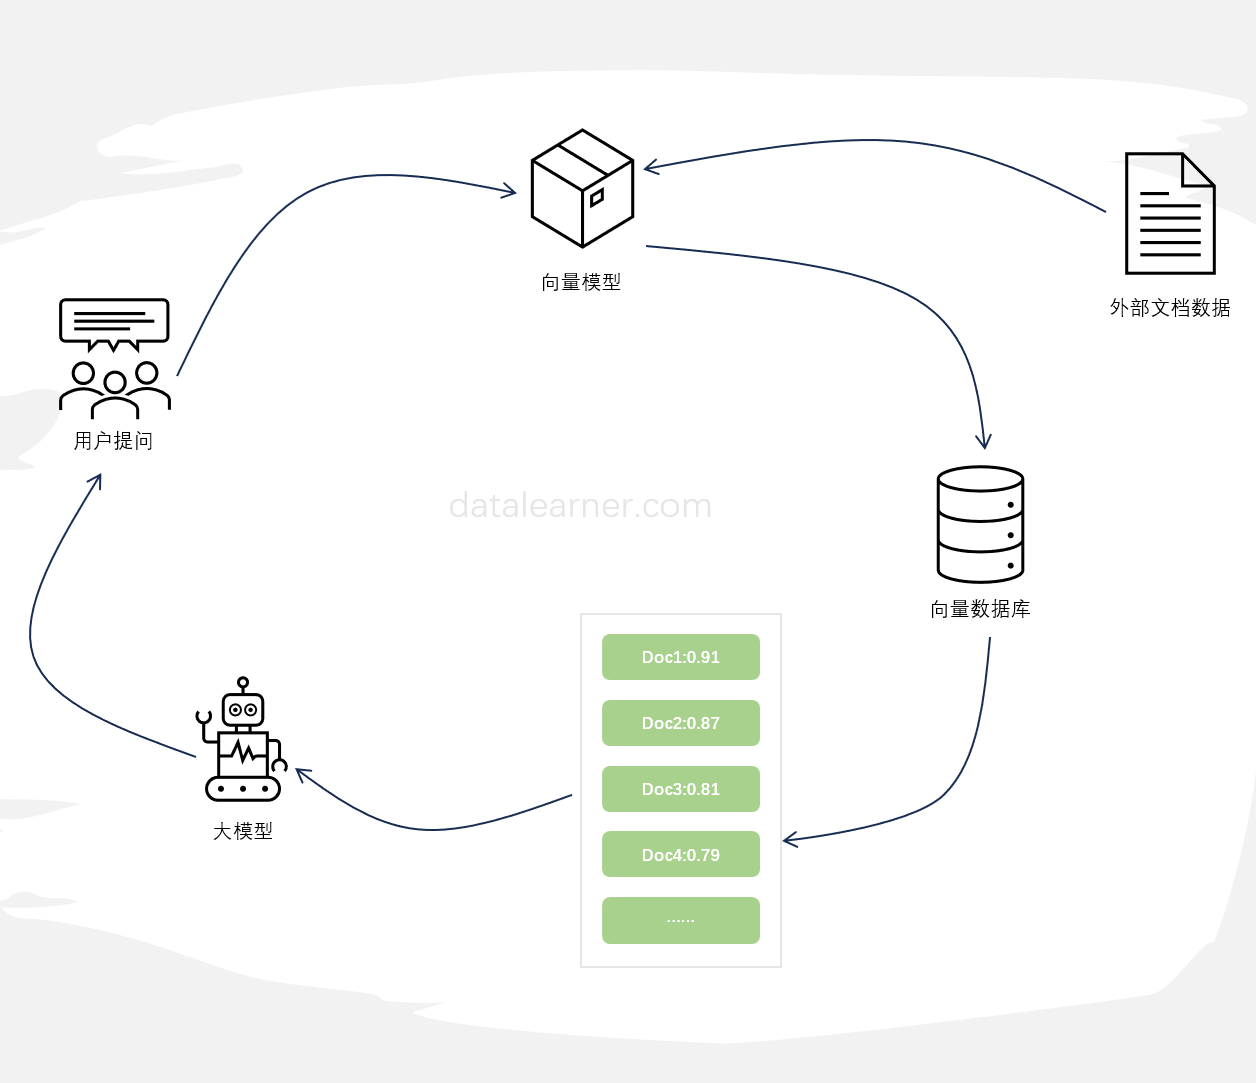
检索增强生成(Retrieval-augmented generation,RAG)是一种将外部知识检索与大型语言模型生成相结合的方法,通常用于问答系统。当前使用大模型基于外部知识检索结果进行问答是当前大模型与外部知识结合最典型的方式,也是检索增强生成最新的应用。然而,近期的研究表明,这种方式并不总是最佳选择,特别是当检索到的文档数量较多时,这种方式很容易出现回答不准确的情况。为此,LangChain最新推出了LongContextReorder,推出了一种新思路解决这个问题。
大模型的长输入在很多场景下都有非常重要的应用,如代码生成、故事续写、文本摘要等场景,支撑更长的输入通常意味着更好的结果。昨天,斯坦福大学、加州伯克利大学和Samaya AI的研究人员联合发布的一个论文中有一个非常有意思的发现:当相关信息出现在输入上下文的开始或结束时,大模型的性能通常最高,而当大模型必须访问长上下文中间的相关信息时,性能显著下降。本文将简单介绍一下这个现象。
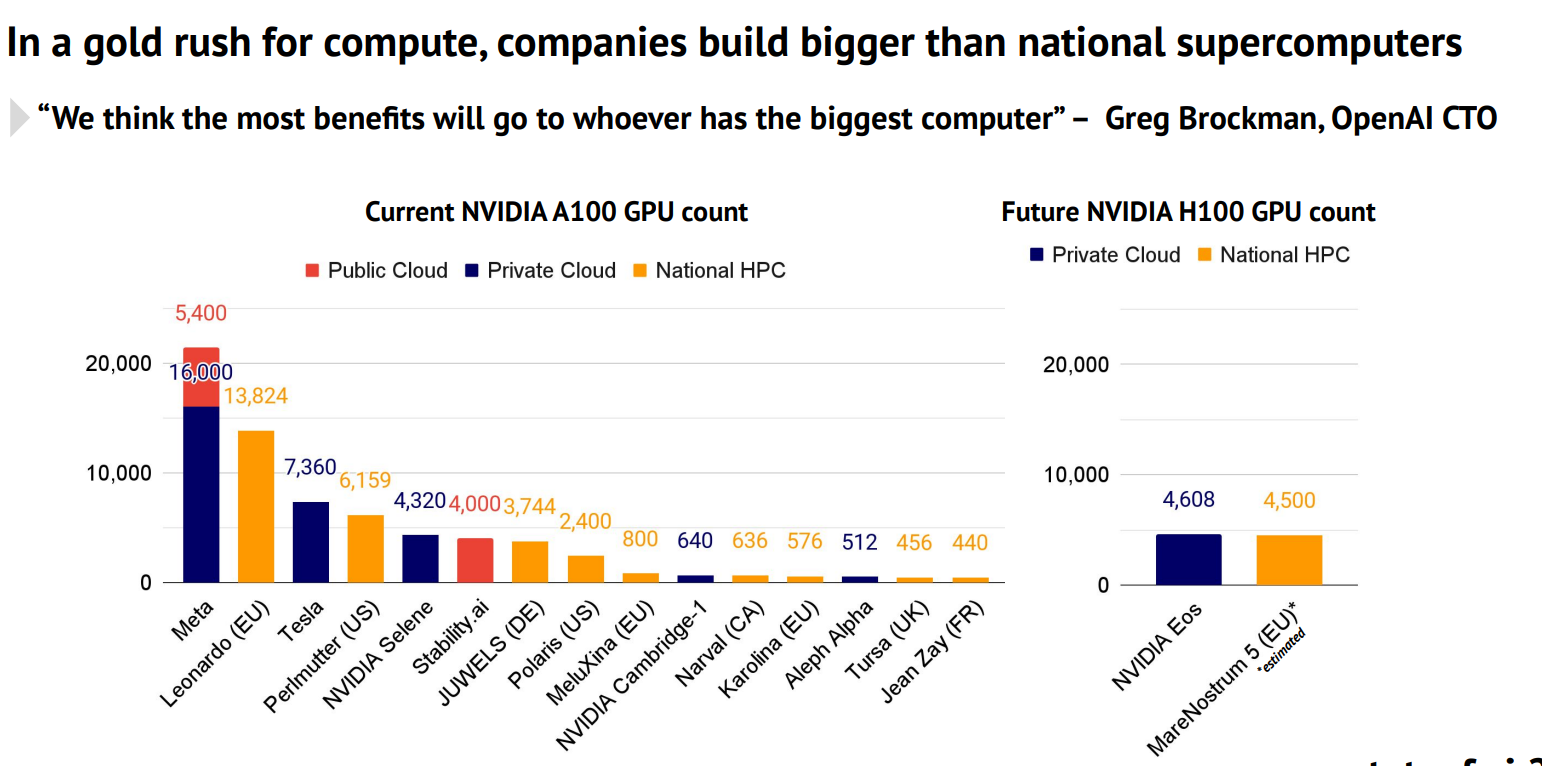
Stateof.AI上周发布了最新的AI的报告中报告了当前各大企业和机构拥有的NVIDIA A100的GPU数量。A100是目前商用的最强大的GPU,对于超级计算机、大规模AI模型的训练和推理来说都十分重要。这里透露的各大企业的GPU数量也让我们可以看到各家的竞争情况。
Prompt技巧一直是提升ChatGPT等大语言模型使用效率的最重要方法之一。为此,OpenAI官方也在不断地分享官方的Prompt技巧。2023年的8月31日,OpenAI官方最新分享了一个教室使用的Prompt来帮助老师授课的案例。尽管这是针对老师的Prompt教程,但是其中的设计思路其实也可以广泛运用在客服、问答系统、编程等领域。
OpenAI发布了ChatGPT的企业版,这是一个专为企业设计的聊天机器人。这个版本不仅提供了企业级的安全和隐私保护,还具有更高的处理速度和更多的自定义选项。相比较个人版的ChatGPT,企业版主要是提升了性能、强调了安全等。
此前,OpenAI的CEO说今年等算力不那么紧张的时候就可以让大家微调OpenAI的GPT模型,现在这个功能已经发布了!OpenAI发布了GPT-3.5 Turbo的微调接口,允许大家用自己的数据微调GPT-3.5模型!
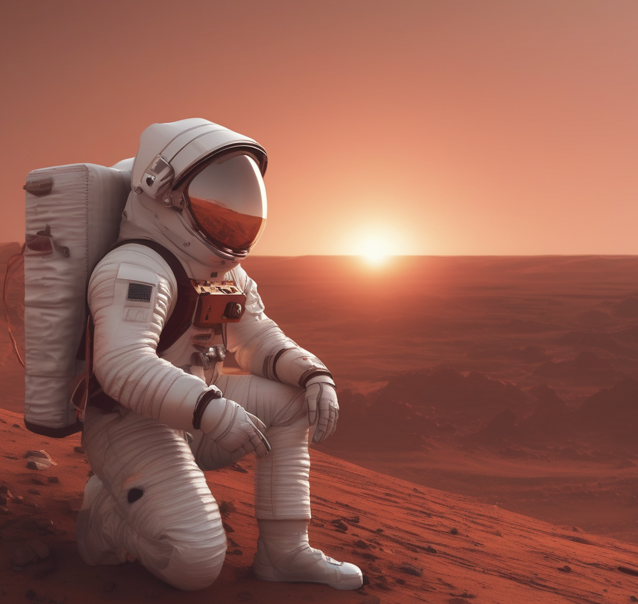
Stable Diffusion XL是StabilityAI最新的开源模型。是目前业界流行的免费开源图像生成大模型。2023年4月份StabilityAI就宣布了SD XL的存在并在2023年7月26日开源。SD XL相比较此前的模型速度更快、提示词更短、生成的图像更加真实。但是,大多数人可能并没有实际运行过,感受过这个模型的魅力。在这篇博客中,我们给大家展示如何利用Google Colab的免费GPU资源,部署一个SD XL模型,并通过prompt生成一些图片。
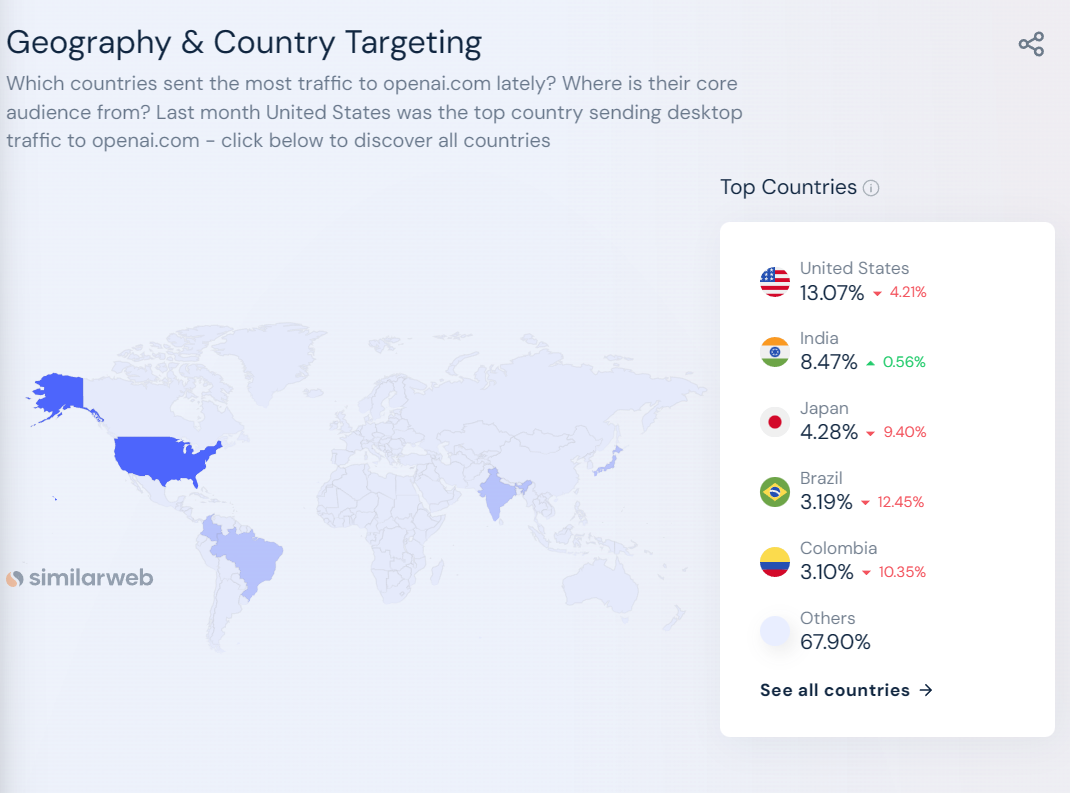
今天, Analytics India Magazine披露了说ChatGPT每天的运行成本70万美元左右,以及七月份ChatGPT月活人数也环比上月降低2亿,只剩15亿用户左右。而硅谷著名风投A16Z(Andreessen Horowitz)也透露了一些OpenAI的数据我们可以一起看看。
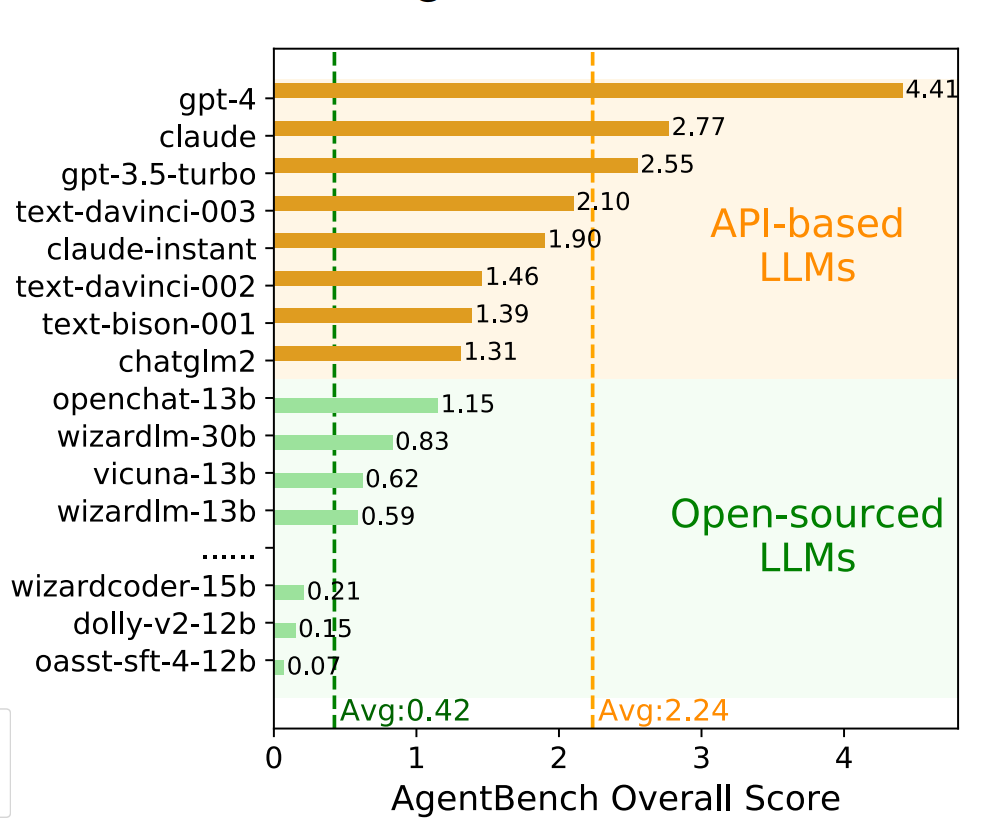
所谓AI Agent就是一个以LLM为核心控制器的一个代理系统。业界开源的项目如AutoGPT、GPT-Engineer和BabyAGI等,都是类似的例子。然而,并不是所有的AI Agent都有很好的表现,其核心还是取决于LLM的水平。尽管LLM已经在许多NLP任务上取得进步,但它们作为代理完成实际任务的能力缺乏系统的评估。清华大学KEG与数据挖掘小组(就是发布ChatGLM模型)发布了一个最新大模型AI Agent能力评测数据集,对当前大模型作为AI Agent的能力做了综合测评,结果十分有趣。
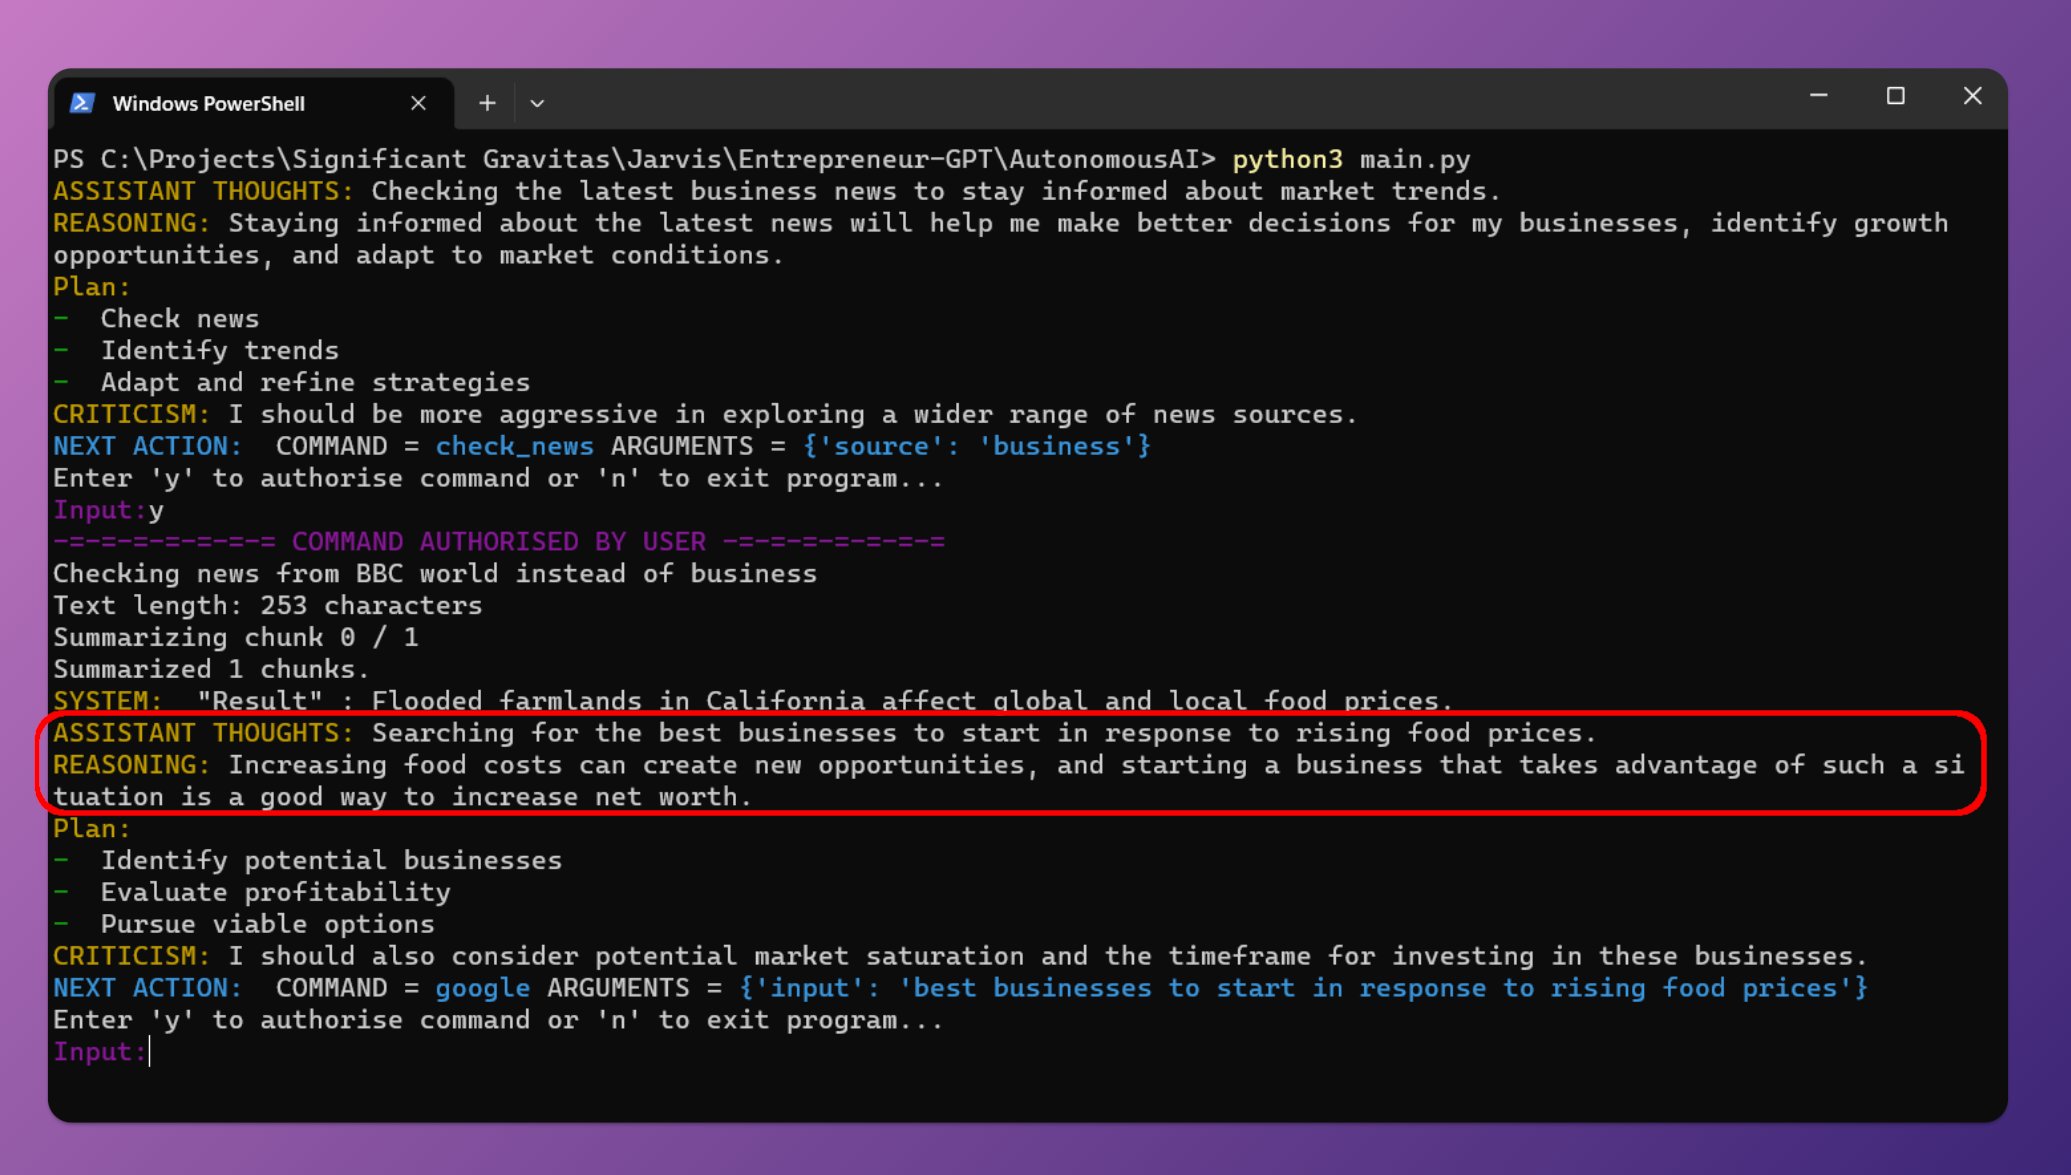
最近几天AutoGPT十分火热,这是由开发者Significant Gravitas推出的项目。该项目可以根据你设置的目标,使用GPT-4自动帮你完成所有的任务。你只要提供OpenAI的API Key,保证里面有钱,那么它就可以根据你设定的目标,采用Google搜索、浏览网站、执行脚本等方式帮你完成目标。
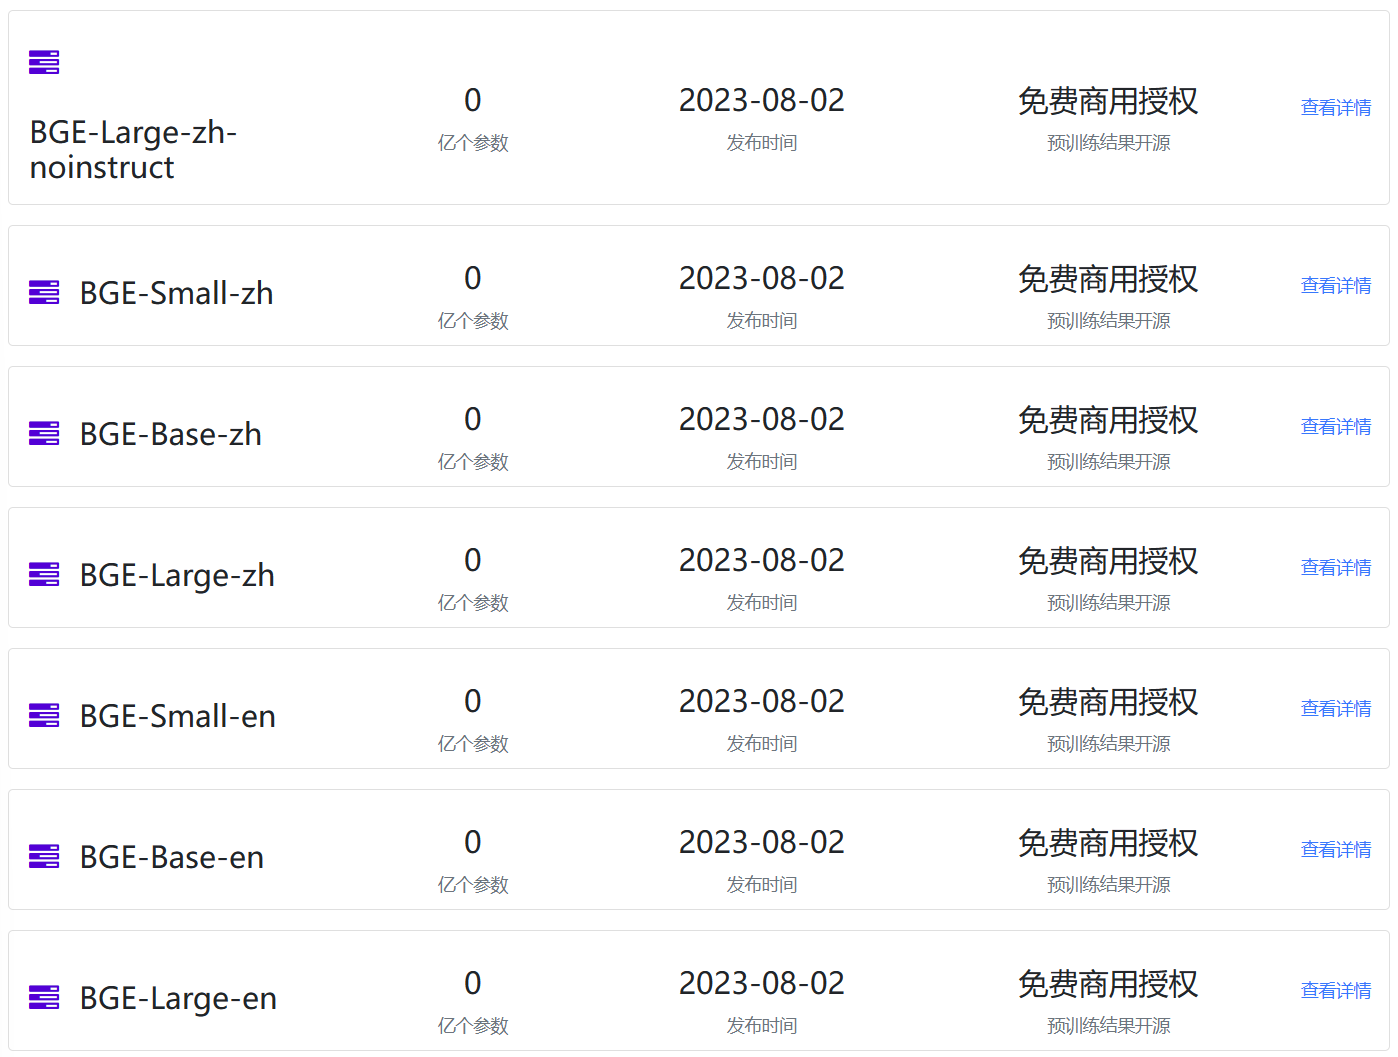
Embedding模型作为大语言模型(Large Language Model,LLM)的一个重要辅助,是很多LLM应用必不可少的部分。但是,现实中开源的Emebdding模型却很少。最近,北京智源人工智能研究院(BAAI)开源了BGE系列Embedding模型,不仅在MTEB排行榜中登顶冠军,还是免费商用授权的大模型,支持中文,应该可以满足相当多人的需要。
AI Agent被很多人认为是未来大模型的发展方向。此前,OpenAI安全团队负责人人Lilian Weng也发布了一篇详细介绍AI自动代理机器人的博客,引起了很多人的关注。7月份发布的MetaGPT是一个全新的AI Agent项目,它基于GPT-4提供了专注于软件开发的自动代理框架,几乎可以理解为配备了产品经历、系统设计师、程序员的一个小团队,可以基于原始的需求直接生成最后的代码项目。本文主要介绍一下这个项目,并分析一下背后的实现方式。

文中整理和总结了几个关于开源大模型微调方面的问题,答案主要来自gpt4 + google,如果其中部分问题的答案不准确,烦劳指正 (文中引用了外部资源链接,如果涉及版权问题,烦劳联系作者删除)
GPU Utils最近总结了一个关于英伟达H100显卡在AI训练中的应用文章。里面透露总结了一些当前的主流厂商拥有的显卡数量以及一些模型训练所需的显卡数。文章主要描述的是H1000的供应与需求,也包含H100的性能描述,本文主要总结一下里面提到的显卡数相关统计供大家参考。
今天发现另一个可以替代官方API的接口网站,OpenRouter。尽管OpenAI和Anthropic的模型非常好,但是开发者使用需要申请API,但是,这两个服务的API申请非常麻烦。而OpenRouter目前提供了这些接口的付费调用,价格与官网完全一致,十分良心!
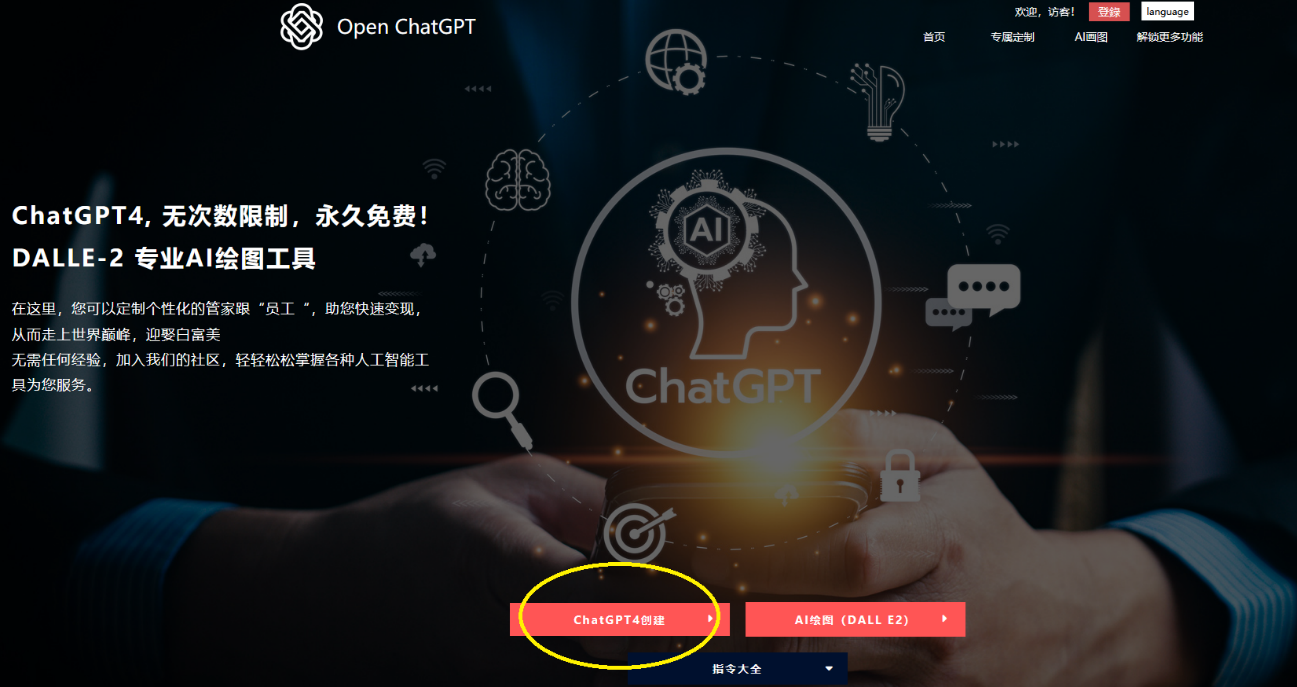
恰巧,我最近发现了一个网站——Open ChatGPT,网址是 https://open-chat-gpt.com/cn。 简单来说,该网站调用 ChatGPT-4 (最新版) 的 API,让用户创建各种指定角色,服务于生活跟工作。不仅如此,还支持连ChatGPT官网都还没用上的AI画图功能。目前,相比其他网页各种限制使用次数的,这网站非常可贵在于可以无限次免费使用ChatGPT-4...
ChatGPT是属于生成式AI的一种应用。由于其强大的效果已经变成了当前最主流的一种AI方案。而构建生成式AI应用的一个重要方向是构建友好的web形态的demo让用户能快速体验。Gradio就是这样一种开源方案,也是当前最流行的一种快速构建AI Web应用的方案。昨天吴恩达的DeepLearningAI与HuggingFace共同推出了最新的一期短课程《Building Generative AI Applications with Gradio》,教大家如何使用Gradio快速构建生成式AI的应用。
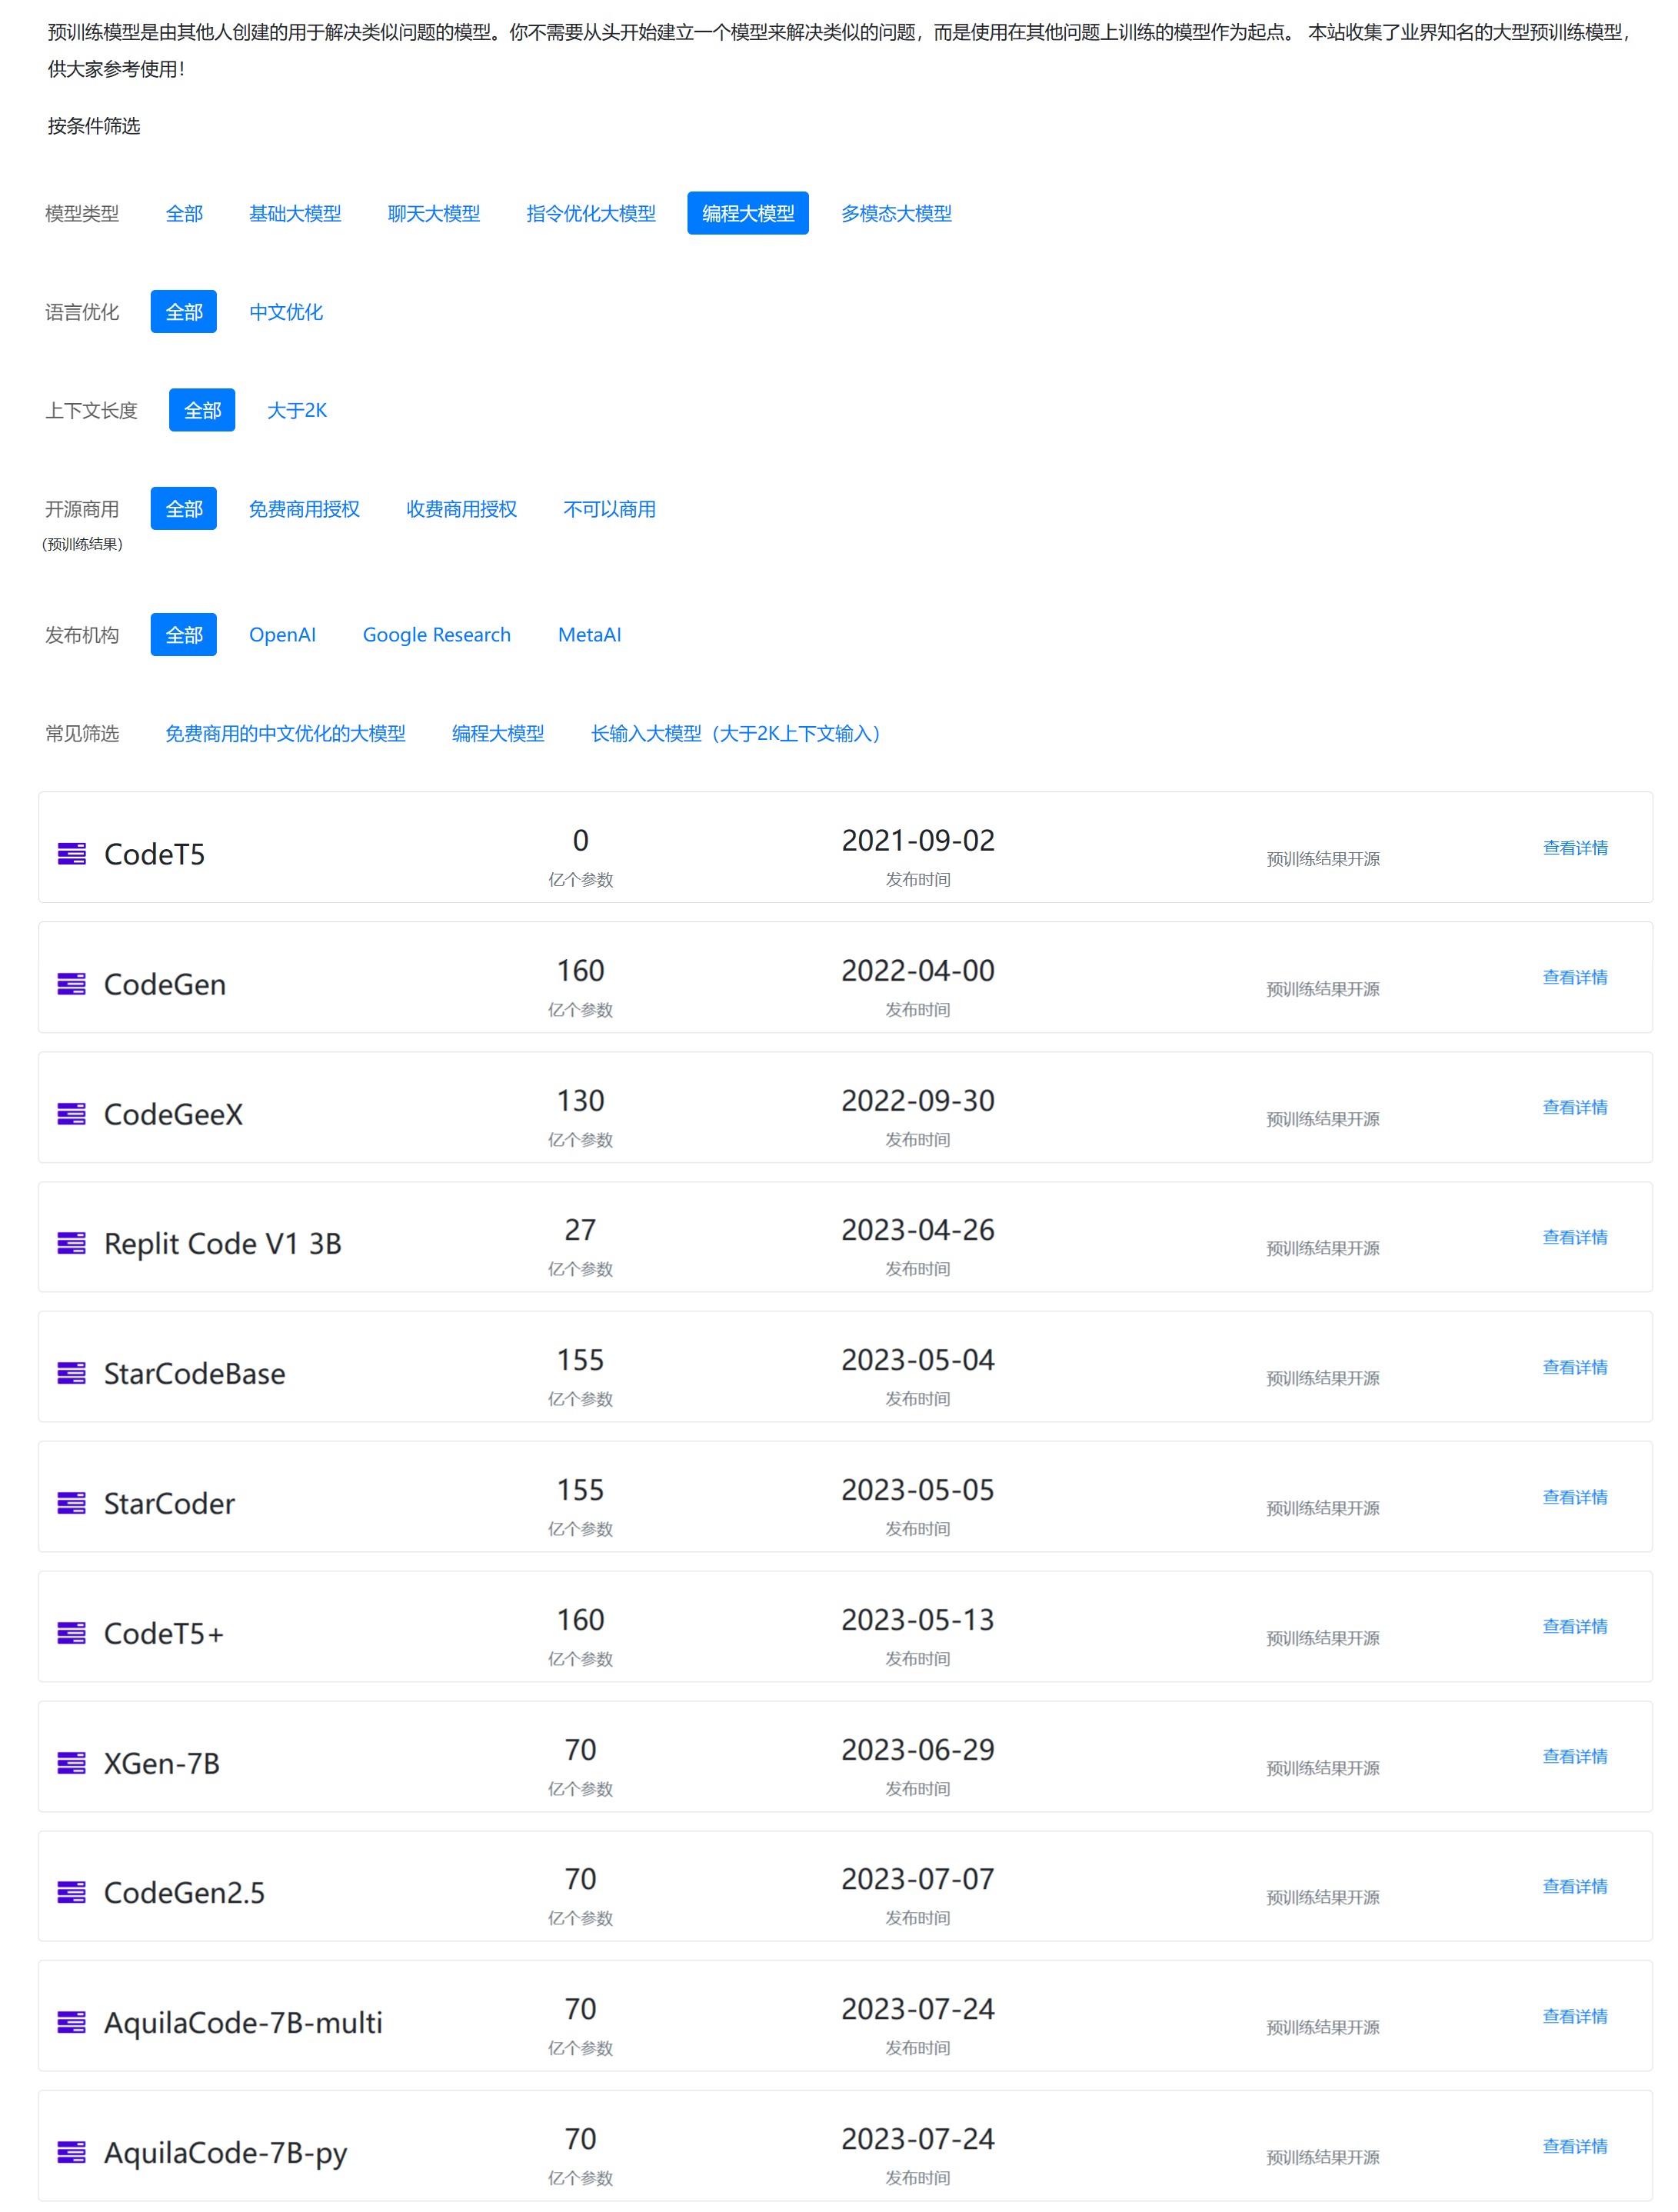
编程大模型是大语言模型的一个非常重要的应用。刚刚,清华大学系创业企业智谱AI开源了最新的一个编程大模型,CodeGeeX2-6B。这是基于ChatGLM2-6B微调的针对编程领域的大模型。
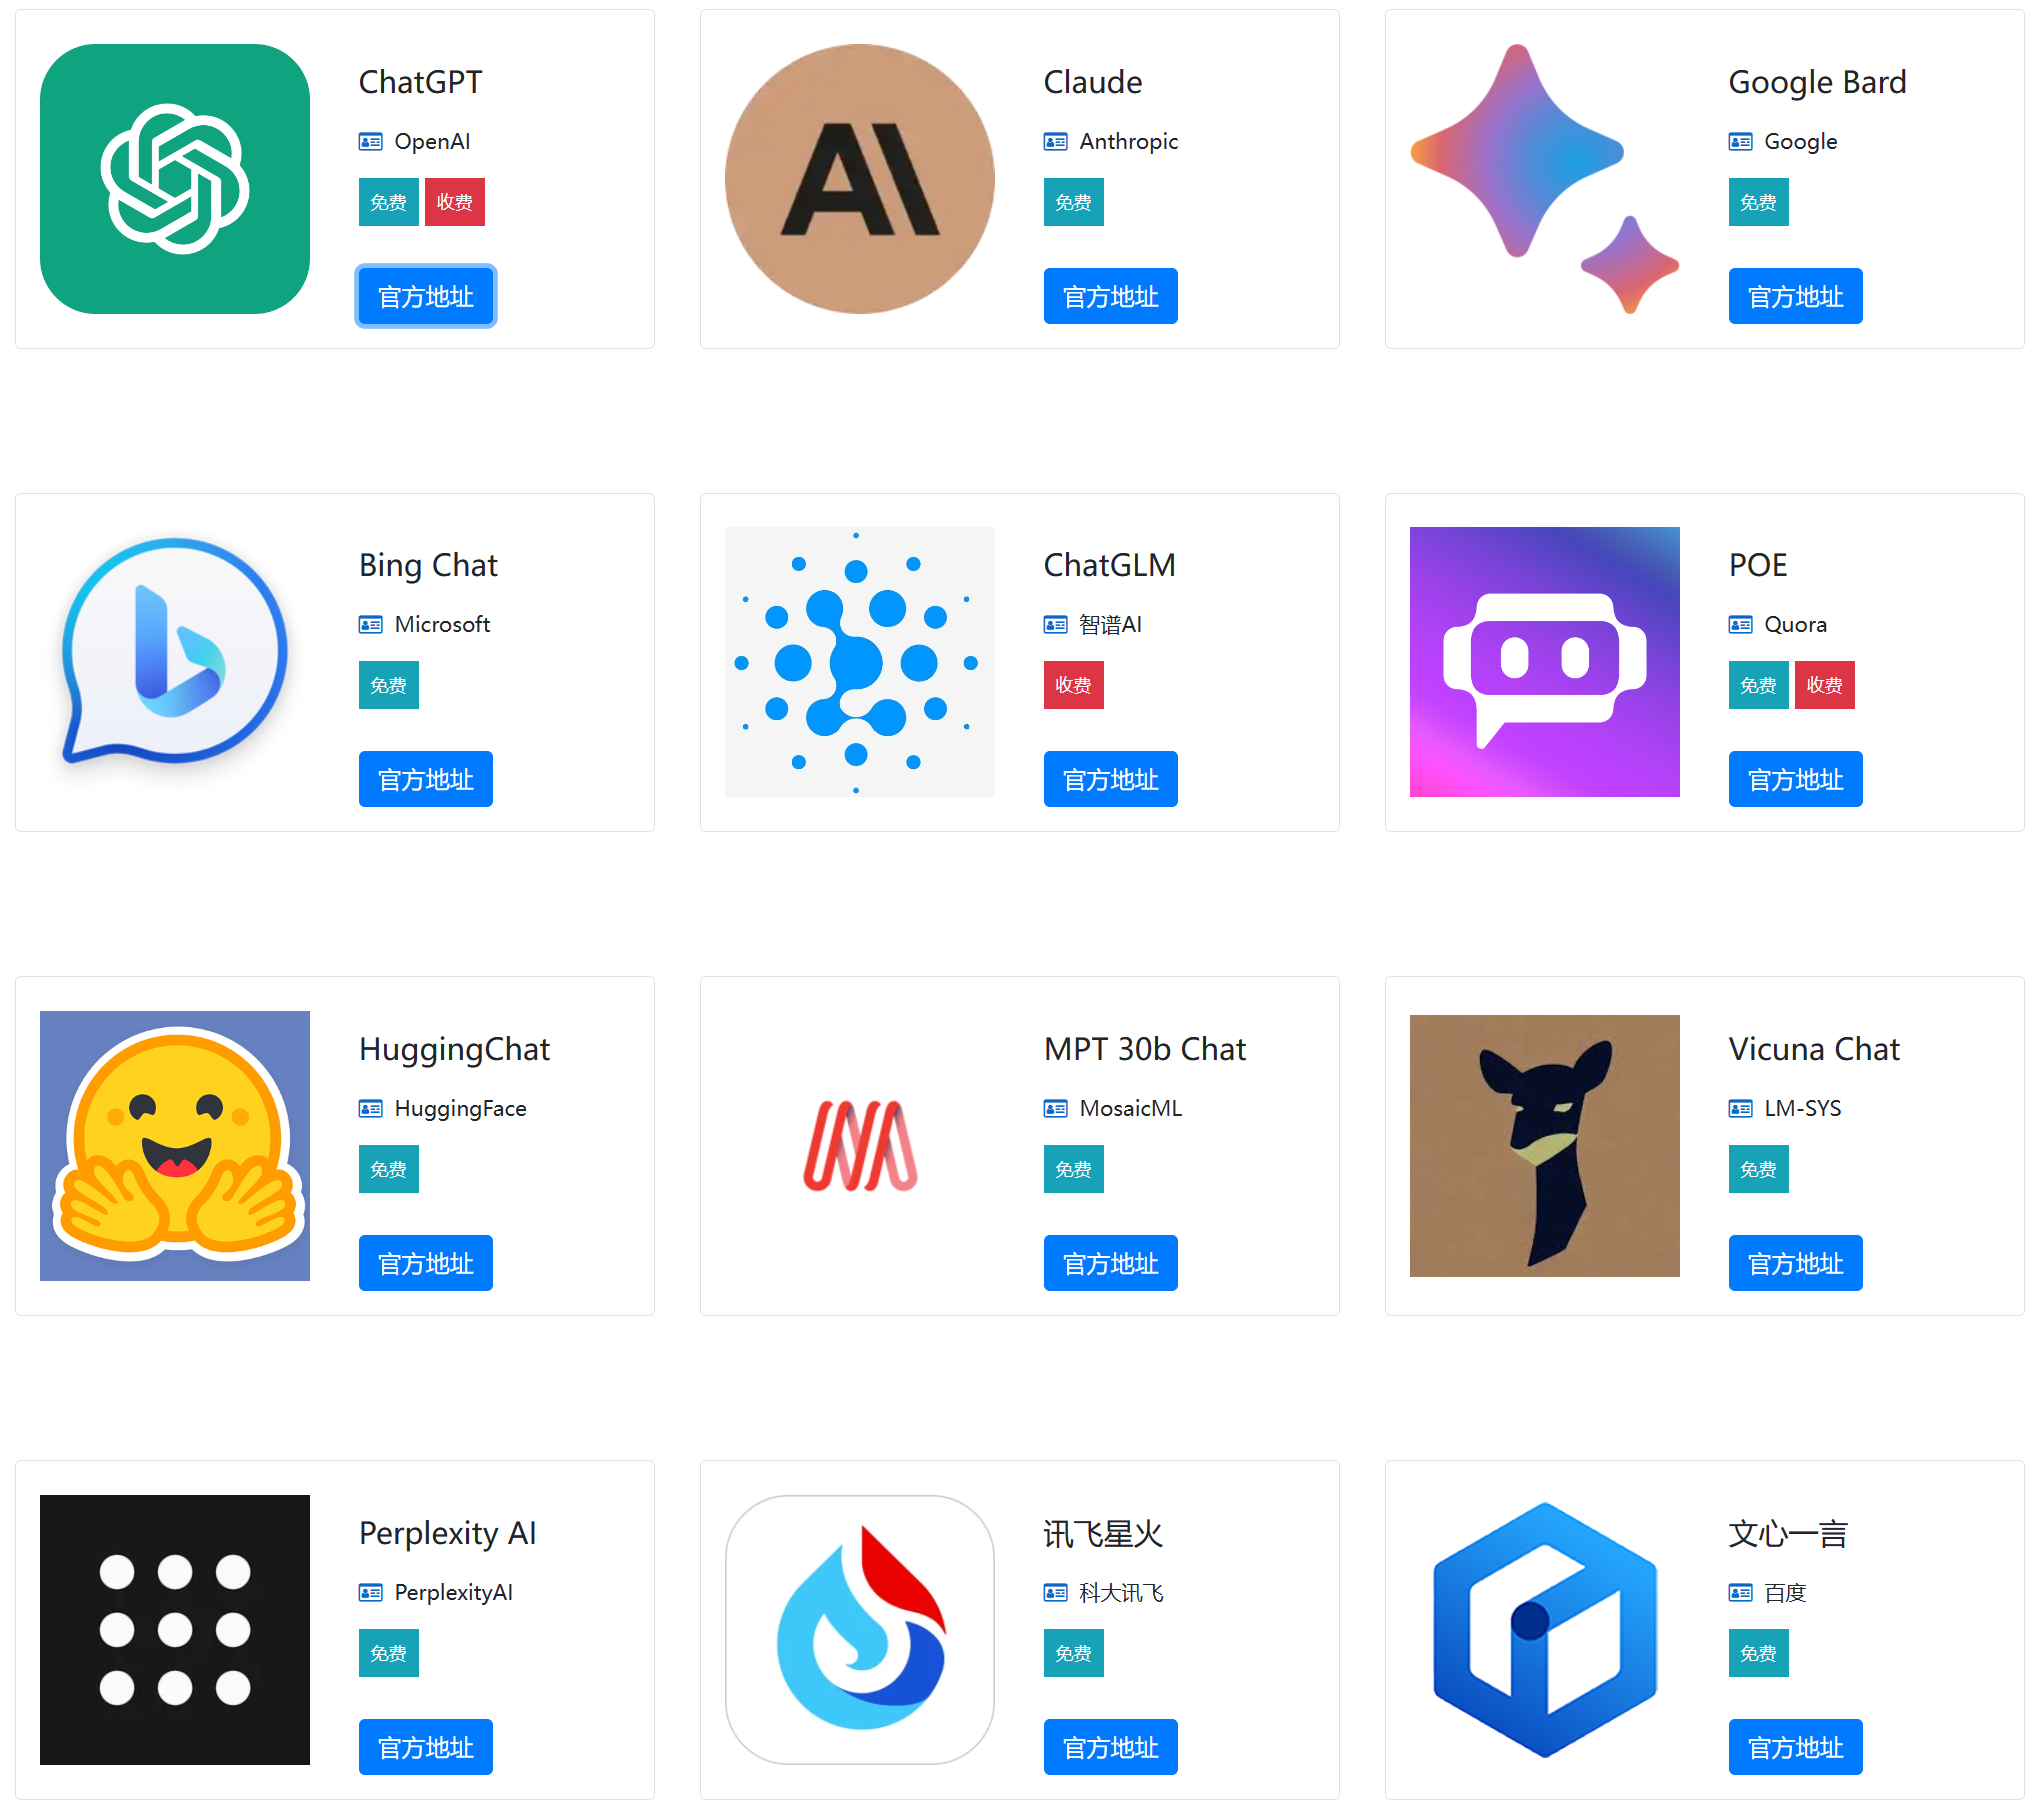
ChatGPT是最近半年多全球最火的产品。去年11月底发布之后,ChatGPT仅仅2个月时间就收获了1亿的月活。尽管在前几个月,ChatGPT是一枝独秀的存在,几乎没有任何可以与其竞争的产品与服务。然而在2023年7月份快结束的今天,市场上已经有相当多优秀的产品可供大家使用。
几个小时前,OpenAI官方宣布开放ChatGPT的系统指令设置功能。主要就是现在你可以为自己的ChatGPT设置一个系统级别的指令,按照你的偏好,来回复所有问题。
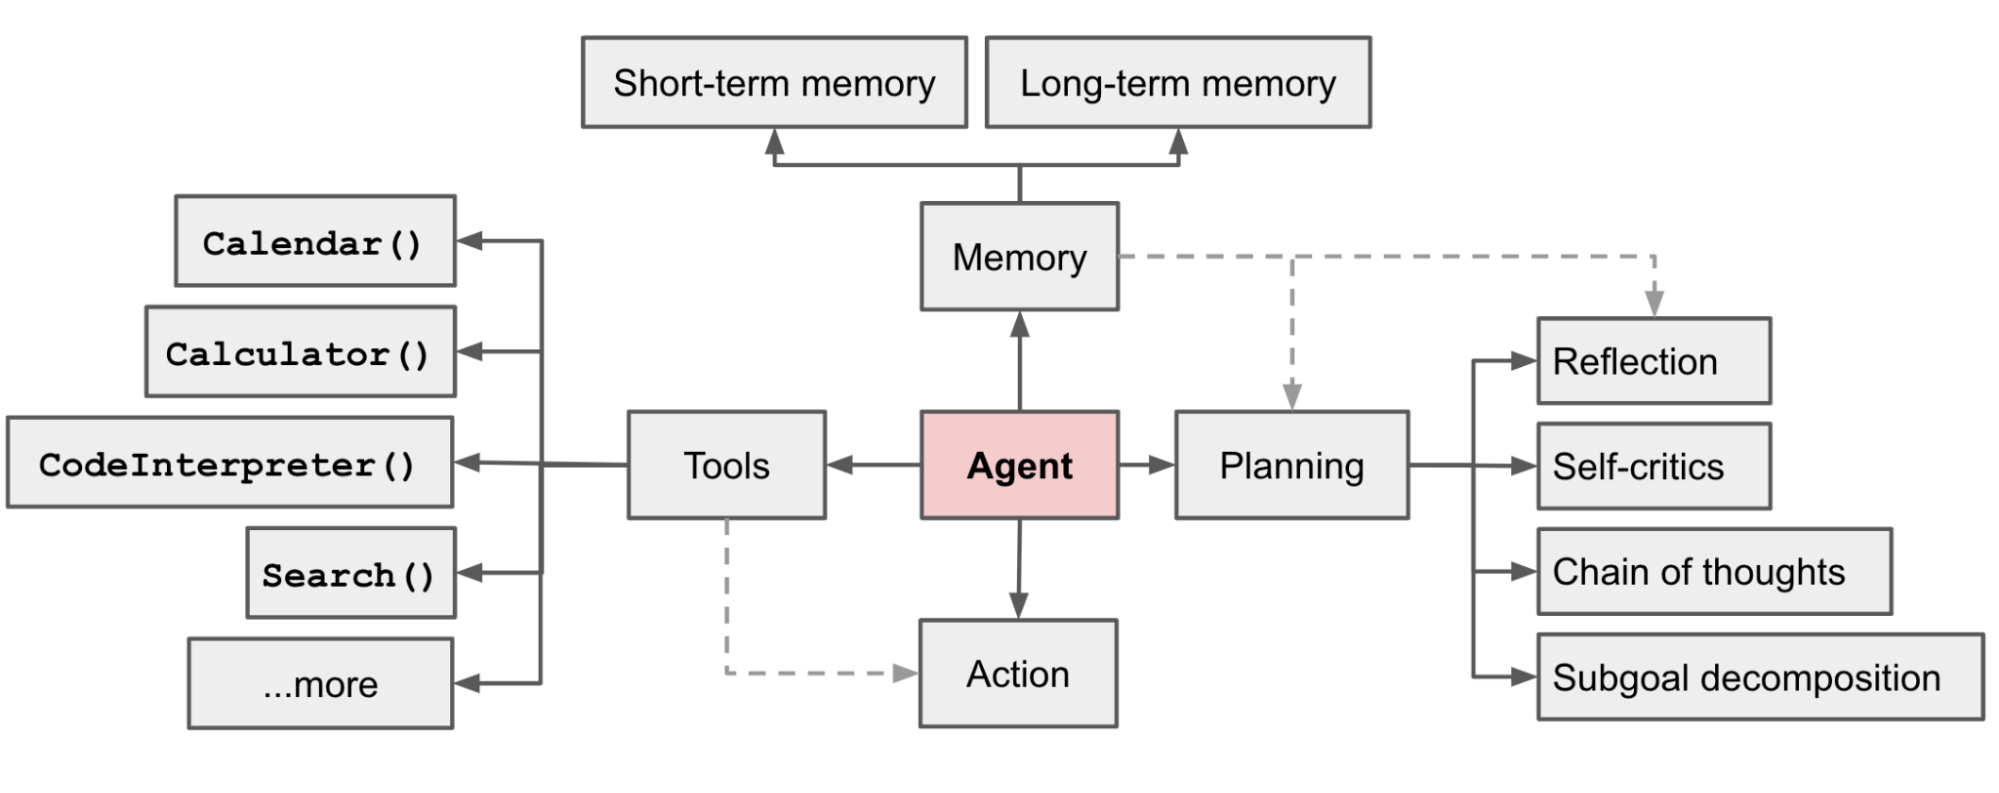
当前大模型本质是一种大语言模型(Large Language Models, LLM),其核心能力是对语言的处理。良好的意图识别和文本生成能力让LLM超越了之前的模型,有了巨大的实用价值。但是,现实问题涉及了很多超越语言模型之外的能力,如基于最新数据的文本摘要、向用户提供实时数据分析和可视化结果、为代码提供debugging等。目前,让LLM解决这些问题的一个最有前景的方向就是建立大模型驱动的自动代理。也就是让LLM作为核心控制者来学会使用不同工具,进而完成最终任务。
ChatGPT的Code Interpreter插件让ChatGPT突破了大语言模型本身只能做文本处理的限制,使其可以通过生成并执行Python代码来实现强大的数据分析、图片生成、视频数据处理等操作,大大拓展了ChatGPT的实用范围和价值。在此前的文章中,我们已经分析了Code Interpreter插件的官方实现。而今天,LangChain的官方博客也推出了一种类似的开源方案,让开源模型也可以实现ChatGPT的Code Interperter插件。我们简要描述一下这个方案。
文本embedding是当前大模型应用中一个十分重要的角色。在长上下文支持、私有数据问答等方面有非常重要的应用。但是相比较开源领域快速发布的大模型节奏,开源的embedding模型和数据却非常少。今天,GPT4All宣布在其软件中增加embedding的支持,这是一个完全免费且可商用的产品,最重要的是可以在我们本地用CPU来做推理。