DataLearner logo
Original Blog

Original AI Tech Blogs

Explore the latest AI and LLM news and technical articles, covering original content and practical cases in machine learning, deep learning, and natural language processing.

通俗易懂地解释OpenAI Sora视频生成的特点有哪些?Sora与此前的Stable Video Diffusion、Runway Gen2、Pika等有什么区别?OpenAI Sora的缺点是什么?

通俗易懂地解释OpenAI Sora视频生成的特点有哪些?Sora与此前的Stable Video Diffusion、Runway Gen2、Pika等有什么区别?OpenAI Sora的缺点是什么?

OpenAI的Sora模型是最近两天最火热的模型。它生成的视频无论是清晰度、连贯性和时间上都有非常好的结果。在Sora之前,业界已经有了很多视频生成工具和平台。但为什么Sora可以引起如此大的关注?Sora生成的视频与此前其它平台生成的视频到底有哪些区别?有很多童鞋似乎对这些问题依然有疑问,本文将以通俗的语言解释Sora的独特之处。
2024/02/17 23:55:051,634
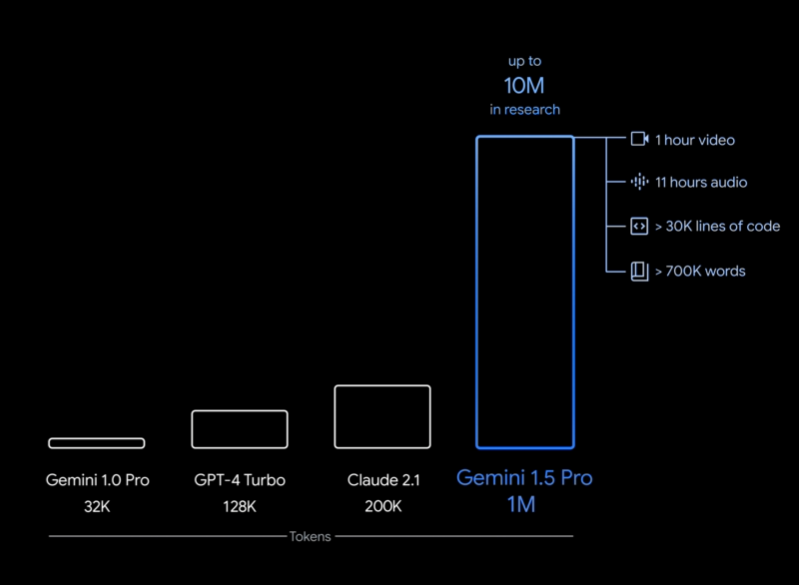
重磅!谷歌宣布发布Gemini 1.5 Pro,距离Gemini发布仅仅一个半月!最高支持1000万上下文长度,GSM8K评测全球第一

重磅!谷歌宣布发布Gemini 1.5 Pro,距离Gemini发布仅仅一个半月!最高支持1000万上下文长度,GSM8K评测全球第一

在2023年12月份,Google发布了Gemini系列大模型(参考:谷歌发布号称超过GPT-4V的大模型Gemini:4个版本,最大的Gemini的MMLU得分90.04,首次超过90的大模型),包含3个不同参数规模的版本。其中,Gemini Ultra号称在MMLU评测上超过了GPT-4,并且在月初也将Bard更名为Gemini,开放了Gemini Ultra的付费使用。刚刚,Google的CEO劈柴哥宣布发布了Gemini 1.5 Pro,这意味着仅仅一个半月,Gemini有了重大更新。

2024/02/16 00:04:221,682
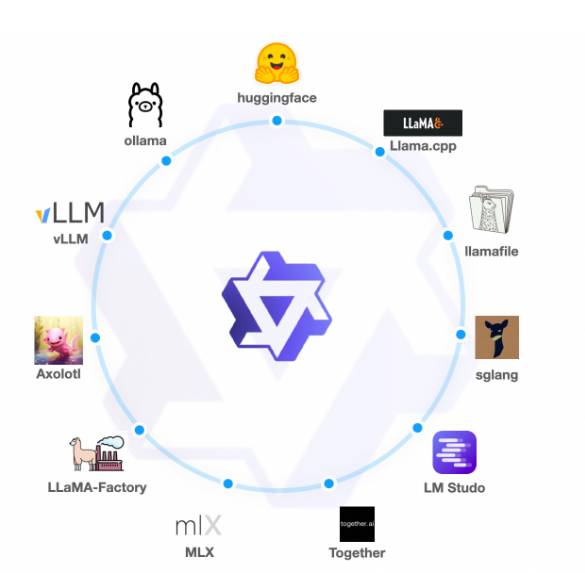
重磅!第二代通义千问大模型开源,阿里巴巴一口气开源了30个不同参数规模的模型,其中Qwen1.5-72B仅次于GPT-4.

重磅!第二代通义千问大模型开源,阿里巴巴一口气开源了30个不同参数规模的模型,其中Qwen1.5-72B仅次于GPT-4.

今天阿里巴巴开源了他们家第二代的Qwen系列大语言模型(准确说是1.5代),从官方给出的测评结果看,Qwen1.5系列大模型相比较第一代有非常明显的进步,其中720亿参数规模版本的Qwen1.5-72B-Chat在各项评测结果中都非常接近GPT-4的模型,在MT-Bench的得分中甚至超过了此前最为神秘但最接近GPT-4水平的Mistral-Medium模型。

2024/02/06 01:35:595,088
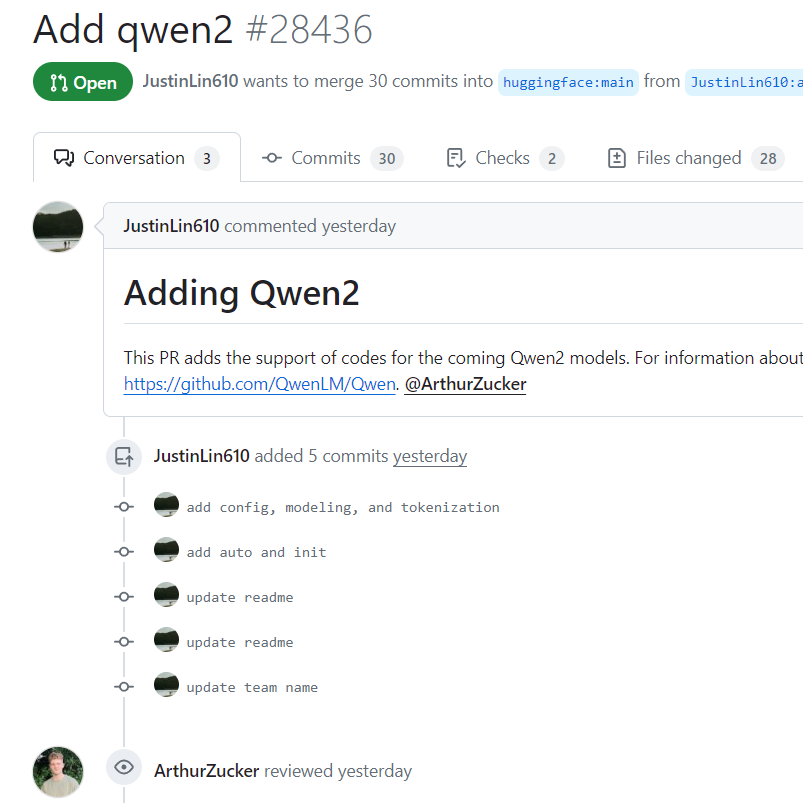
阿里巴巴的第二代通义千问可能即将发布:Qwen2相关信息已经提交HuggingFace官方的transformers库

阿里巴巴的第二代通义千问可能即将发布:Qwen2相关信息已经提交HuggingFace官方的transformers库

通义千问是阿里巴巴开源的一系列大语言模型。Qwen系列大模型最高参数量720亿,最低18亿,覆盖了非常多的范围,其各项评测效果也非常好。而昨天,Qwen团队的开发人员向HuggingFace的transformers库上提交了一段代码,包含了Qwen2的相关信息,这意味着Qwen2模型即将到来。

2024/01/31 12:50:162,024
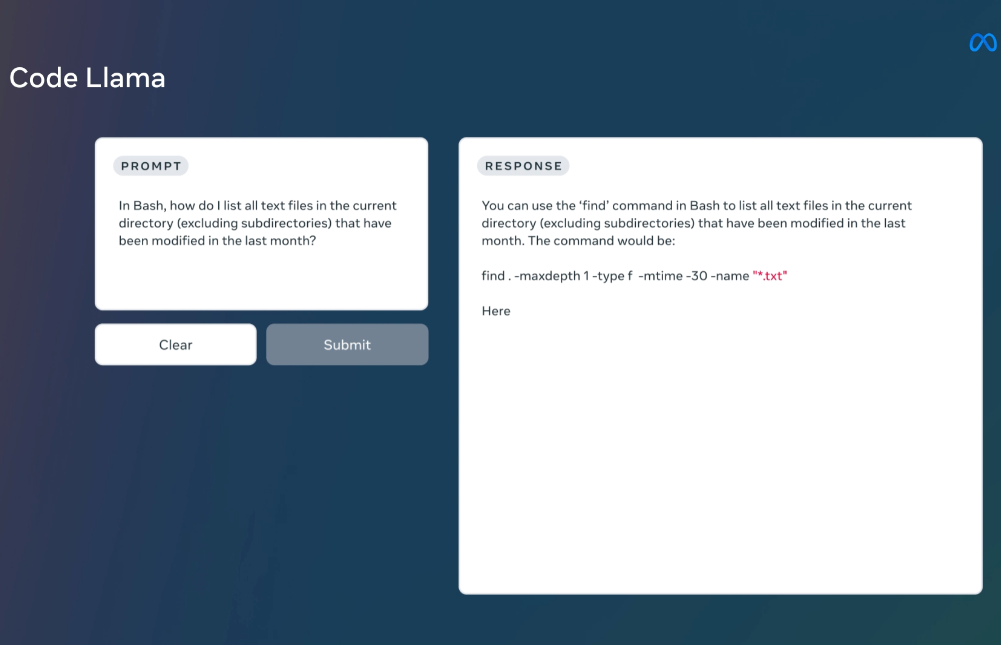
MetaAI官宣开源编程大模型CodeLLaMA!基于LLaMA2微调!超越OpenAI的Codex,最高支持10万tokens输入!

MetaAI官宣开源编程大模型CodeLLaMA!基于LLaMA2微调!超越OpenAI的Codex,最高支持10万tokens输入!

MetaAI发布的LLaMA系列开源大语言模型已经是开源大模型领域最重要的力量了。相当多的所谓开源大模型都是基于这个模型微调得到。在上个月,LLaMA2发布,吸引了全球非常多的关注,也有相当多的后续模型基于LLaMA2进行优化。而今天MetaAI再次开源全新的编程大模型——CodeLLaMA系列,这是MetaAI第一次发布编程大模型,本次发布的CodeLLaMA共有9个版本,分别是CodeLLaMA系列、针对Python优化的CodeLLaMA-Python系列和针对指令优化的CodeLLaMA-Inst

2024/01/30 10:31:514,929
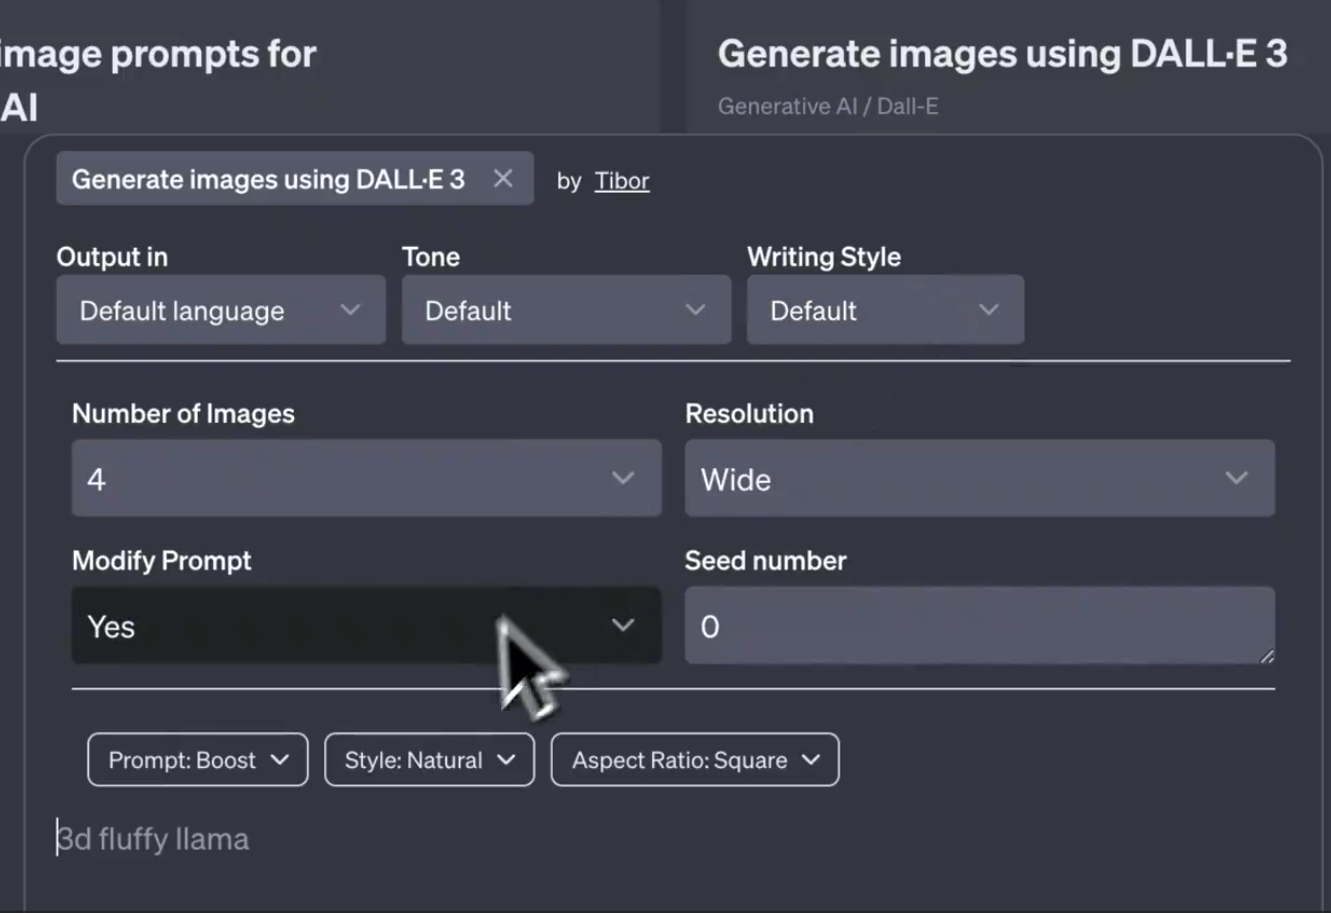
OpenAI即将推出DALL·E Controls功能,可以更加精细化控制DALL·E图片生成的效果

OpenAI即将推出DALL·E Controls功能,可以更加精细化控制DALL·E图片生成的效果

DALL·E3是OpenAI推出的文本生成图片服务,背后也是一个文生图大模型。此前,该模型只能通过对话的方式让模型生成图片结果。无法通过配置信息控制模型输出的效果,包括风格、比例等。而最新的截图显示,OpenAI可能即将推出DALL·E Controls功能,可以从不同的方面来控制图片生成的效果。

2024/01/27 08:49:55664
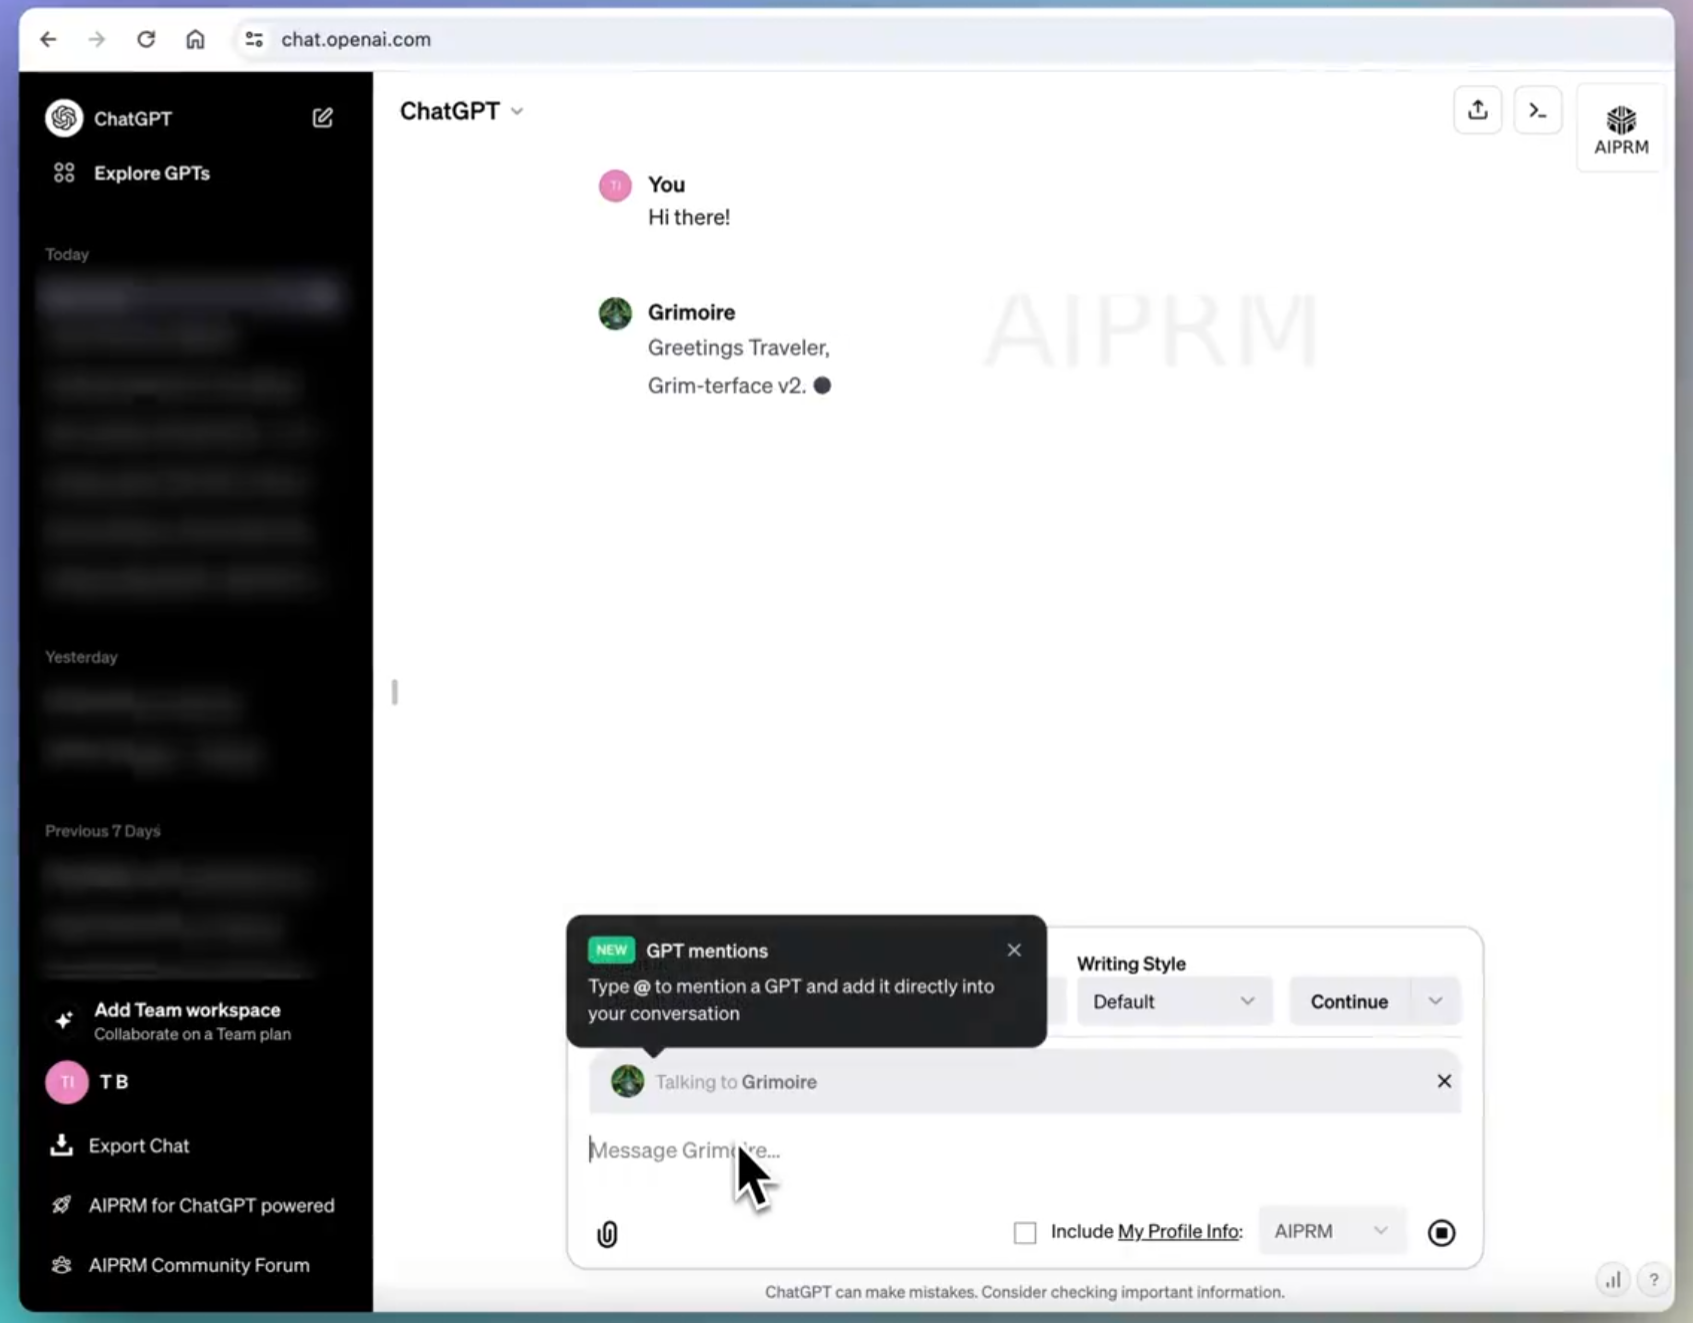
OpenAI隐藏的一个ChatGPT新功能:在对话框中@任意GPTs,获得回答!一个巨大的由各种GPT组成的聊天世界即将到来

OpenAI隐藏的一个ChatGPT新功能:在对话框中@任意GPTs,获得回答!一个巨大的由各种GPT组成的聊天世界即将到来

在最新的ChatGPT的前端代码中,有网友发现了一个OpenAI隐藏的或者正在测试的功能,即在ChatGPT的对话中可以@ 任意GPTs商店中公开的GPTs,然后由这个GPTs为用户当前的对话进行回复,这个功能不需要用户离开当前对话页面。这意味着在一次对话中,我们可以与几百万个不同的GPTs同时协作聊天,就像一个巨大的聊天群,里面有无数个各种各样的GPT一起为你解决问题。

2024/01/26 20:29:021,276
大语言模型的开发者运维LLMOps来临,比MLOps概念还要新:吴恩达联合Google云研发人员推出免费的LLMOps课程

大语言模型的开发者运维LLMOps来临,比MLOps概念还要新:吴恩达联合Google云研发人员推出免费的LLMOps课程

MLOps的主要目标是创建一个更有效、可重复和可靠的机器学习工作流程。现在,随着大语言模型的流行,LLMOps概念也随之提出。即如何高效地开发大模型应用,包括自动化管理升级如prompt、模型评估等。为此,吴恩达联合Google的研发人员推出了最新的大模型短课LLMOps,帮助大家学习大语言模型开发过程中的自动化测试、自动化Prompt管理等一系列实践,提高大模型应用开发的效率和质量。

2024/01/21 21:37:30803
智谱AI发布国产最强大模型GLM4,理解评测与数学能力仅次于Gemini Ultra和GPT-4,编程能力超过Gemini-pro,还有对标GPTs商店的GLMs

智谱AI发布国产最强大模型GLM4,理解评测与数学能力仅次于Gemini Ultra和GPT-4,编程能力超过Gemini-pro,还有对标GPTs商店的GLMs

GLM4是智谱AI发布的第四代基座大语言模型,全称General Language Model,最早由清华大学KEG小组再2021年发布。这个基座模型也是著名的开源国产大模型ChatGLM系列的基座模型。本次发布的第四代GLM4的能力相比此前的基座模型提升了60%,已经与世界最强模型Gemini Ultra和GPT-4接近!

2024/01/17 22:27:217,001
DeepSeekAI开源国产第一个基于混合专家技术的大模型:DeepSeekMoE-16B,未来还有1450亿参数的MoE大模型

DeepSeekAI开源国产第一个基于混合专家技术的大模型:DeepSeekMoE-16B,未来还有1450亿参数的MoE大模型

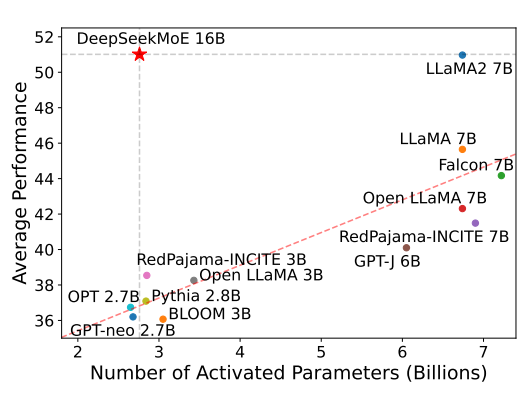
混合专家(Mixture of Experts)是大模型一种技术,这个技术将大模型划分为不同的子专家模型,每次推理只选择部分专家网络进行推理,在降低成本的同时保证模型的效果。此前Mistral开源的Mixtral-8×7B-MoE大模型被证明效果很好,推理速度很棒。而幻方量化旗下的DeepSeek刚刚开源了可能是国产第一个MoE技术的大模型,DeepSeek-MoE 16B。

2024/01/11 15:04:102,597
MistralAI发布了Mixtral  8×7B MoE模型的论文,更详细的参数和对比结果~

MistralAI发布了Mixtral 8×7B MoE模型的论文,更详细的参数和对比结果~

在人工智能快速发展的今天,创新型模型如Mixtral 8x7B的出现,不仅推动了技术的进步,还为未来的AI应用开辟了新的可能性。这款基于Sparse Mixture of Experts(SMoE)架构的模型,不仅在技术层面上实现了创新,还在实际应用中展示了卓越的性能。尽管一个月前这个模型就发布,但是MistralAI今天才上传了这个模型的论文,我们可以看到更详细的信息。

2024/01/09 12:39:171,267
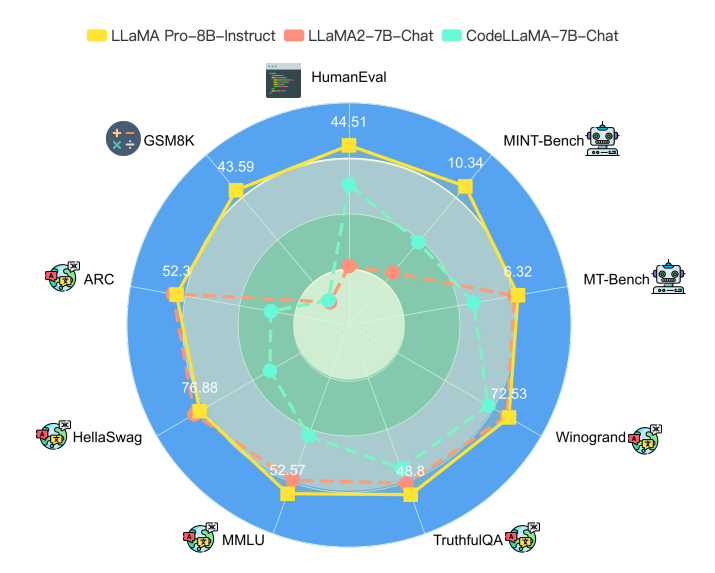
如何解决大模型微调过程中的知识遗忘?香港大学提出有监督微调新范式并开源新模型LLaMA Pro

如何解决大模型微调过程中的知识遗忘?香港大学提出有监督微调新范式并开源新模型LLaMA Pro

大语言模型一个非常重要的应用方式就是微调(fine-tuning)。微调通常需要改变模型的预训练结果,即对预训练结果的参数继续更新,让模型可以在特定领域的数据集或者任务上有更好的效果。但是微调一个严重的副作用是可能会让大模型遗忘此前预训练获得的知识。为此,香港大学研究人员推出了一种新的微调方法,可以保证模型原有能力的基础上提升特定领域任务的水平,并据此开源了一个新的模型LLaMA Pro。

2024/01/09 12:09:471,914
OpenAI的GPTs是如何被创建的?OpenAI的GPT Builder的工作原理和核心Prompt介绍

OpenAI的GPTs是如何被创建的?OpenAI的GPT Builder的工作原理和核心Prompt介绍

GPTs是OpenAI推出的用户自定义的GPT功能,这里的GPTs可以认为是specific GPT。用户创建GPTs主要是通过OpenAI提供的GPT Builder完成。GPT Builder提供的最基本的能力就是基于对话的方式来帮助用户创建GPTs。那么,这个对话式的GPT背后的指令是什么?官方设置了什么样的Prompt来让GPT帮助普通用户建立GPTs呢?本文基于官方最新的博客介绍一下。

2024/01/05 22:53:041,371
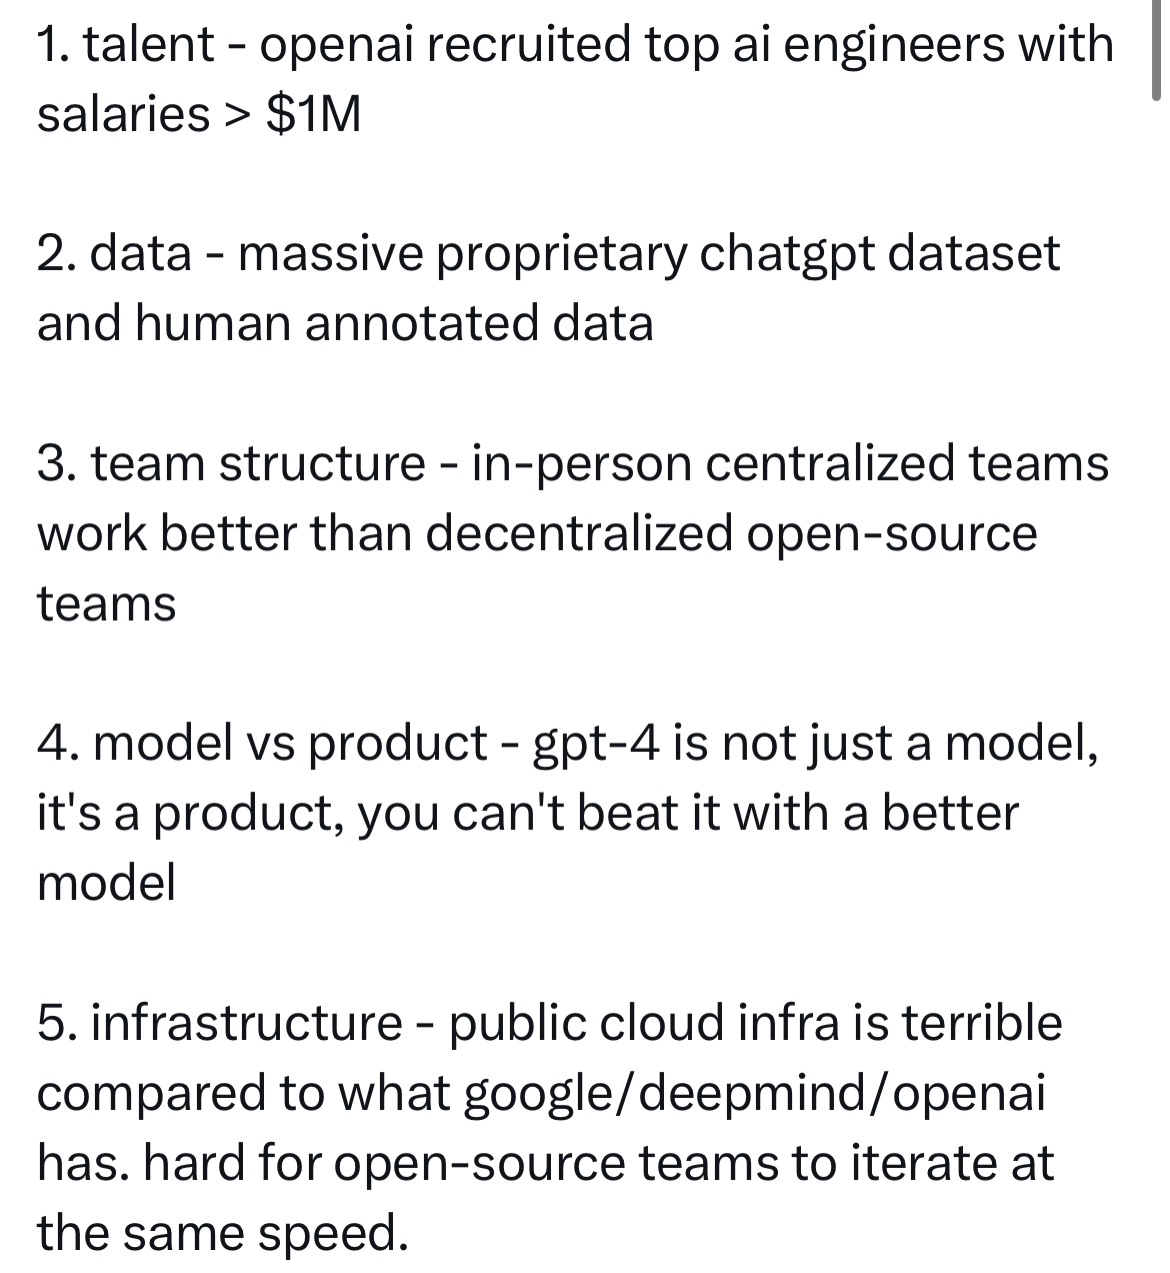
Google前AI研究人员认为2024年可能不会出现能与GPT-4竞争的开源模型/产品

Google前AI研究人员认为2024年可能不会出现能与GPT-4竞争的开源模型/产品

OpenAI在2023年3月份发布了GPT-4,10个月过去了,目前也没有任何一家产品或者模型可以打败GPT-4。但是,很多人都对2024年抱有非常好的期待,认为2024年会出现能与GPT-4竞争的大模型。包括MistralAI的CEO也说他们会在2024年发布性能媲美GPT-4的大模型。但是,Google前AI研究人员,GalileoAI的联合创始人认为2024年也不会出现这种情况。

2024/01/02 10:54:48773
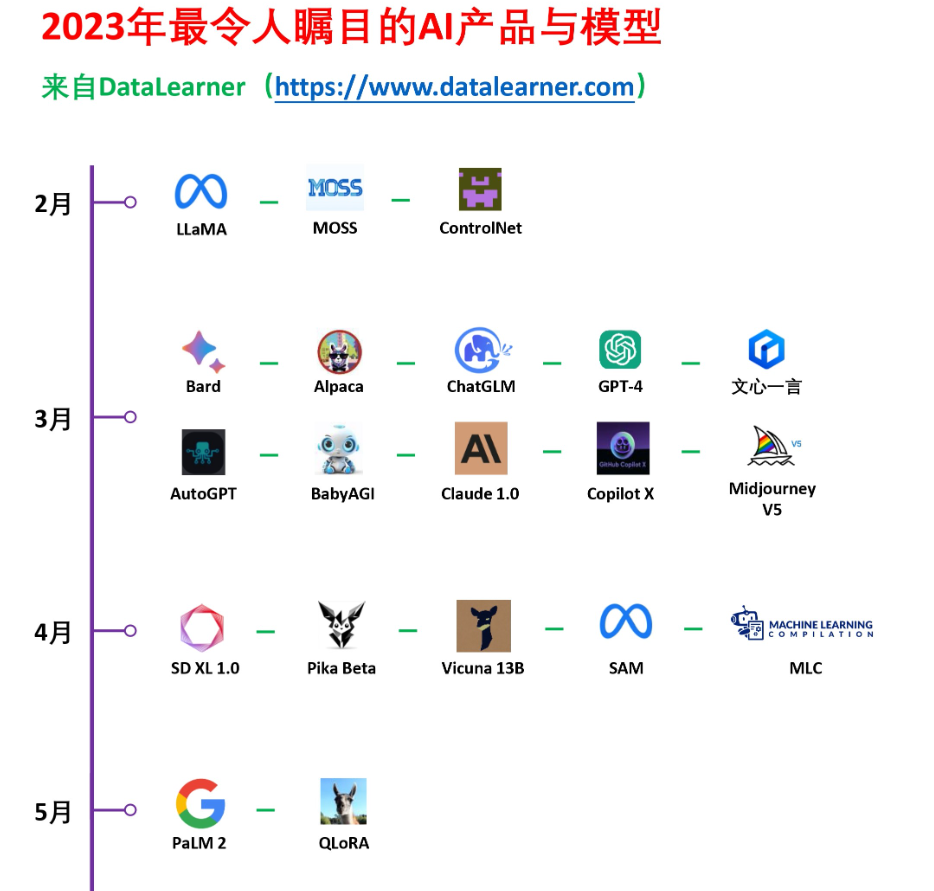
2023年度巨献,一图总结2023年最重要的AI相关的产品和技术~共48个产品或技术上榜

2023年度巨献,一图总结2023年最重要的AI相关的产品和技术~共48个产品或技术上榜

2022年11月底,ChatGPT横空出世,全球都被这样一个“好像”有智能的产品吸引力。随后,工业界、科研机构开始疯狂投入大模型。在2023年,这个被称为大模型元年的年份,有很多令人瞩目的AI产品与模型发布。2023年,DataLearner收集了大量的大模型,并发布了很多大模型相关的技术博客,在即将结束的2023年,我们以这个『2023年最令人瞩目的AI产品』结束本年的技术分享。

2023/12/29 13:02:561,111