DataLearner 标志
原创博客

原创AI技术博客

探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。

向量大模型新选择,阿里开源向量大模型Qwen-Embedding和重排序大模型Qwen-Reranker,开源向量检索能力第一名!完全免费开源。

向量大模型新选择,阿里开源向量大模型Qwen-Embedding和重排序大模型Qwen-Reranker,开源向量检索能力第一名!完全免费开源。

阿里巴巴Qwen团队发布了全新的Qwen3 Embedding系列模型,这是一套基于Qwen3基础模型构建的专用文本向量与重排(Reranking)模型。该系列模型凭借Qwen3强大的多语言理解能力,在多项文本向量与重排任务的Benchmark上达到了SOTA水平,其中8B尺寸的向量模型在MTEB多语言排行榜上排名第一。Qwen3 Reranker模型在多个评测基准上同样大幅超越了现有的主流开源竞品。
2025/06/08 22:01:381,748
数学推理能力超过ChatGPT-3.5:微软与中科院研究人员合作最新的开源大模型WizardMath发布!开源模型第一,免费商用授权!

数学推理能力超过ChatGPT-3.5:微软与中科院研究人员合作最新的开源大模型WizardMath发布!开源模型第一,免费商用授权!

WizardLM是微软联合北京大学开源的一个大语言模型。此前,发布的WizardLM和WizardCoder都是业界开源领域最强的大模型。其中,前者是针对指令优化的大模型,而后者则是针对编程优化的大模型。而此次WizardMath则是他们发布的第三个大模型系列,主要是针对数学推理优化的大模型。在GSM8K的评测上,WizardMath得分超过了ChatGPT-3.5、Claude Instant-1等闭源商业模型,得分十分逆天!

2023/08/13 23:45:441,745
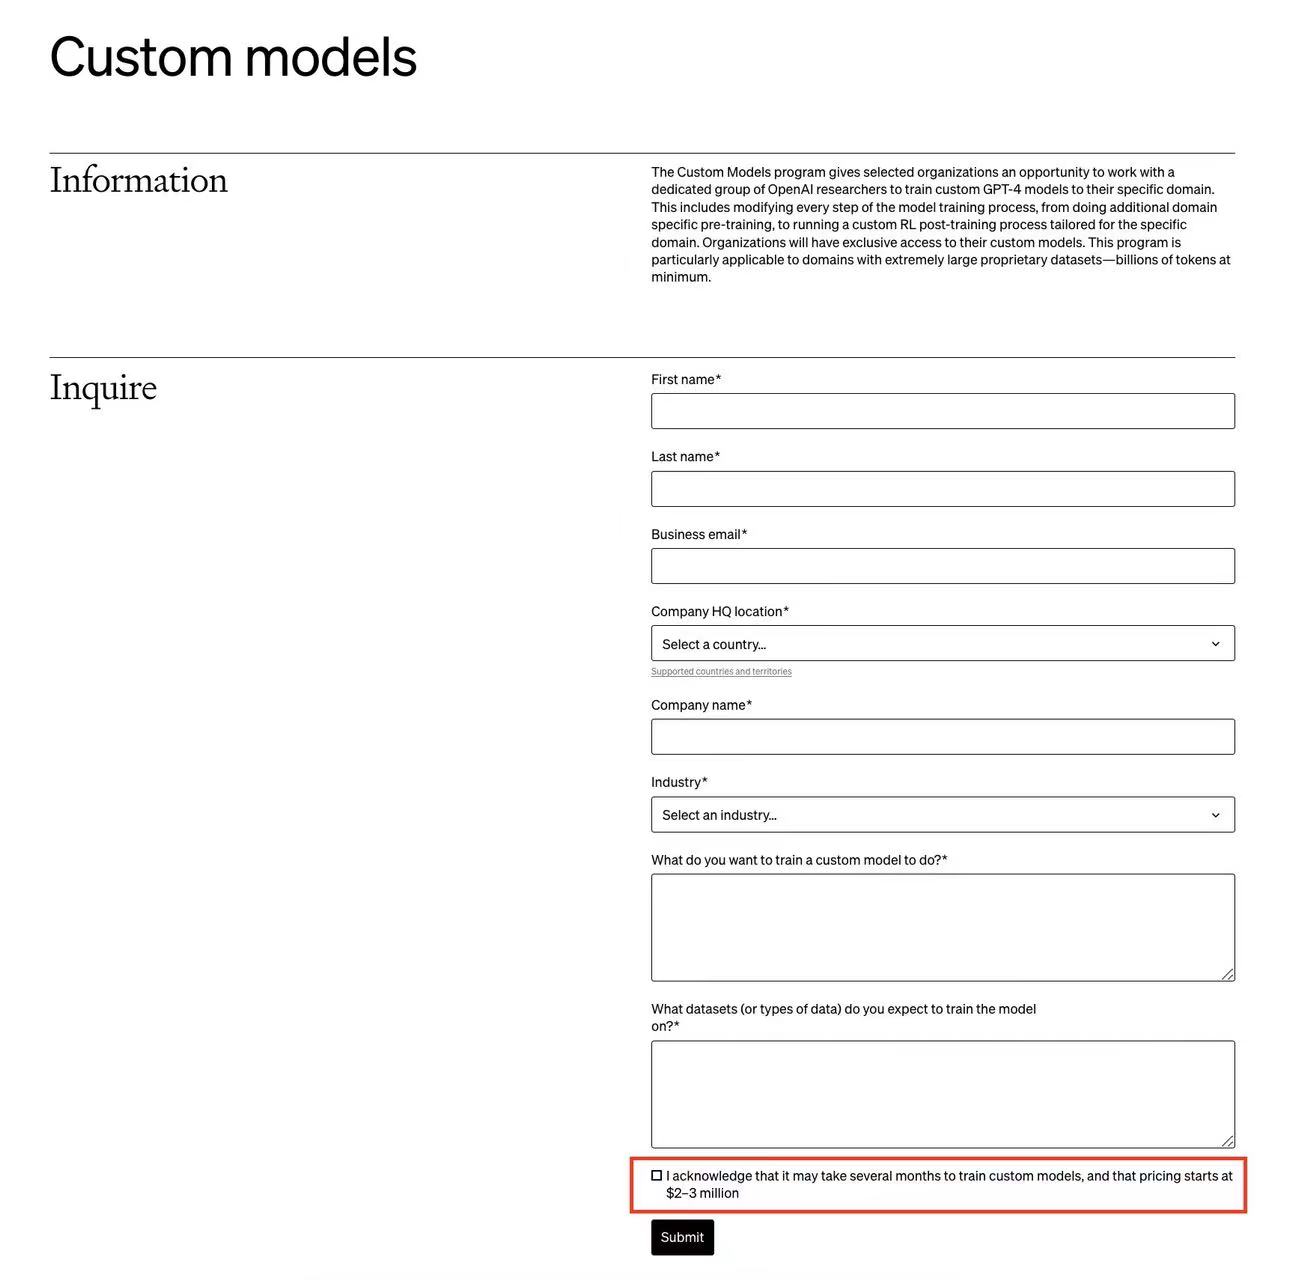
为企业单独定制训练一个GPT-4要多少钱?OpenAI说几个月,200-300万美元起步!

为企业单独定制训练一个GPT-4要多少钱?OpenAI说几个月,200-300万美元起步!

OpenAI的开发者日发布了许多更新。其中,普通用户可以微调GPT-4是非常值得期待的功能之一。但是,OpenAI还有一个针对企业的定制化GPT-4的训练服务,称为Custom Models。而这项为企业单独定制的GPT-4训练服务最新截图显示,需要几个月来训练模型,而且费用是200-300万美元起步!

2023/11/07 19:51:131,732
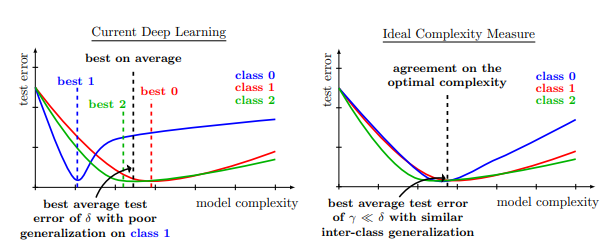
正则化和数据增强对模型的影响并不总是好的:The Effects of Regularization and Data Augmentation are Class Dependent

正则化和数据增强对模型的影响并不总是好的:The Effects of Regularization and Data Augmentation are Class Dependent

正则化是一种基本技术,通过限制模型的复杂性来防止过度拟合并提高泛化性能。目前的深度网络严重依赖正则化器,如数据增强(DA)或权重衰减,并采用结构风险最小化,即交叉验证,以选择最佳的正则化超参数。然而,正则化和数据增强对模型的影响也不一定总是好的。来自Meta AI研究人员最新的论文发现,正则化是否有效与类别高度相关。

2022/04/11 22:52:181,731
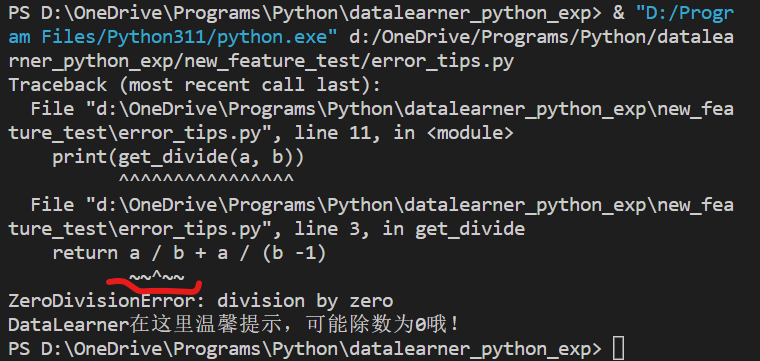
Python3.11最新特性来了,多个好特性提升!

Python3.11最新特性来了,多个好特性提升!

上个月Python的3.11版本发布了第一个beta版本,3.11带来了很多非常棒的新特性,例如错误提示更加具体,可以定位到具体代码位置等,十分友好,建议大家关注。这里简单为大家介绍一下。

2022/07/02 18:11:461,730
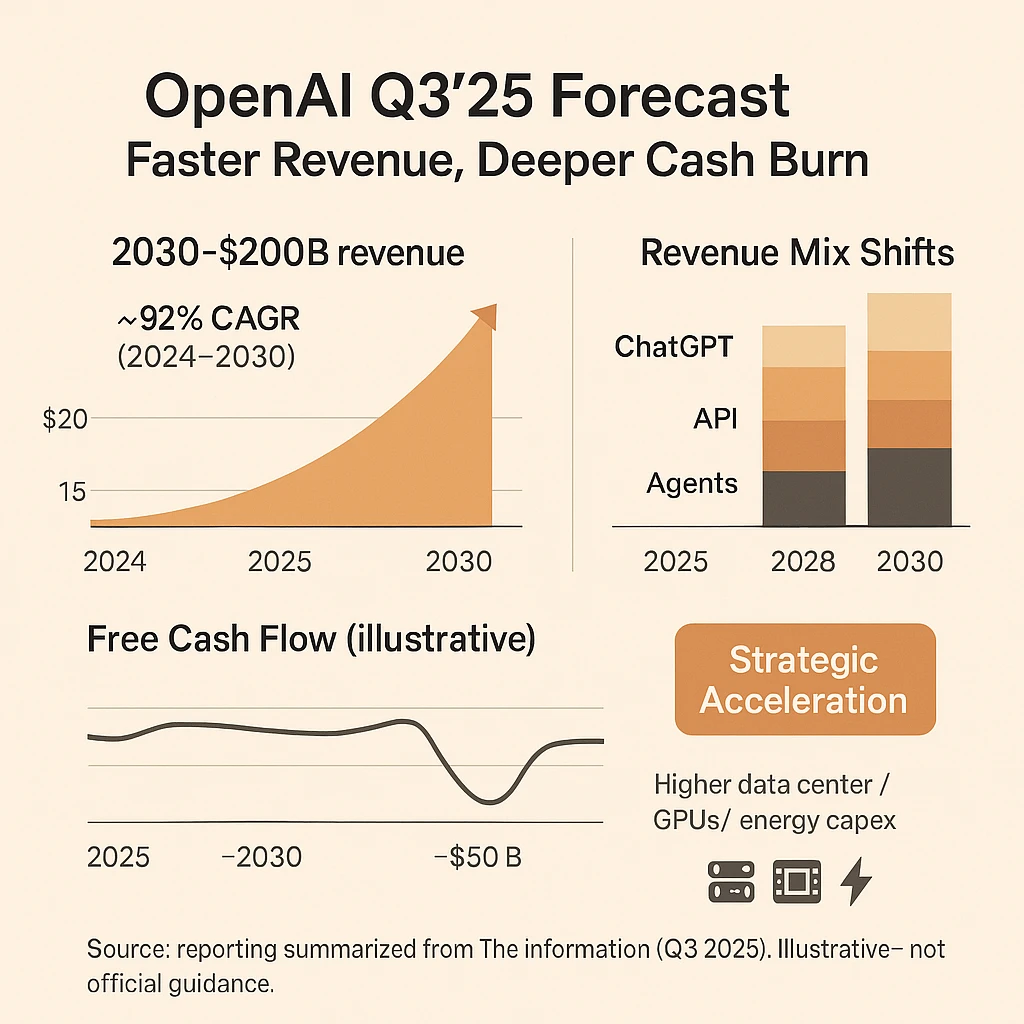
OpenAI收入大揭秘:2024年收入40亿美金,2030年预计达到2000亿,年均复合增长超90%!ChatGPT占比将逐年下降!

OpenAI收入大揭秘:2024年收入40亿美金,2030年预计达到2000亿,年均复合增长超90%!ChatGPT占比将逐年下降!

根据TheInformaiton的披露,近期OpenAI更新了他们最新财务预测(截至2025年第三季度)。这份收入预测展示了当前OpenAI的收入情况,并描绘了一幅引人注目的未来图景。与2025年第一季度OpenAI自己的预测相比,新数据不仅上调了收入预期,也揭示了公司因基础设施投入而面临的巨大现金消耗压力。本文将简单解读一下这份数据,包括OpenAI的收入情况,不同产品占比,如ChatGPT的比重等。

2025/09/06 20:21:001,722
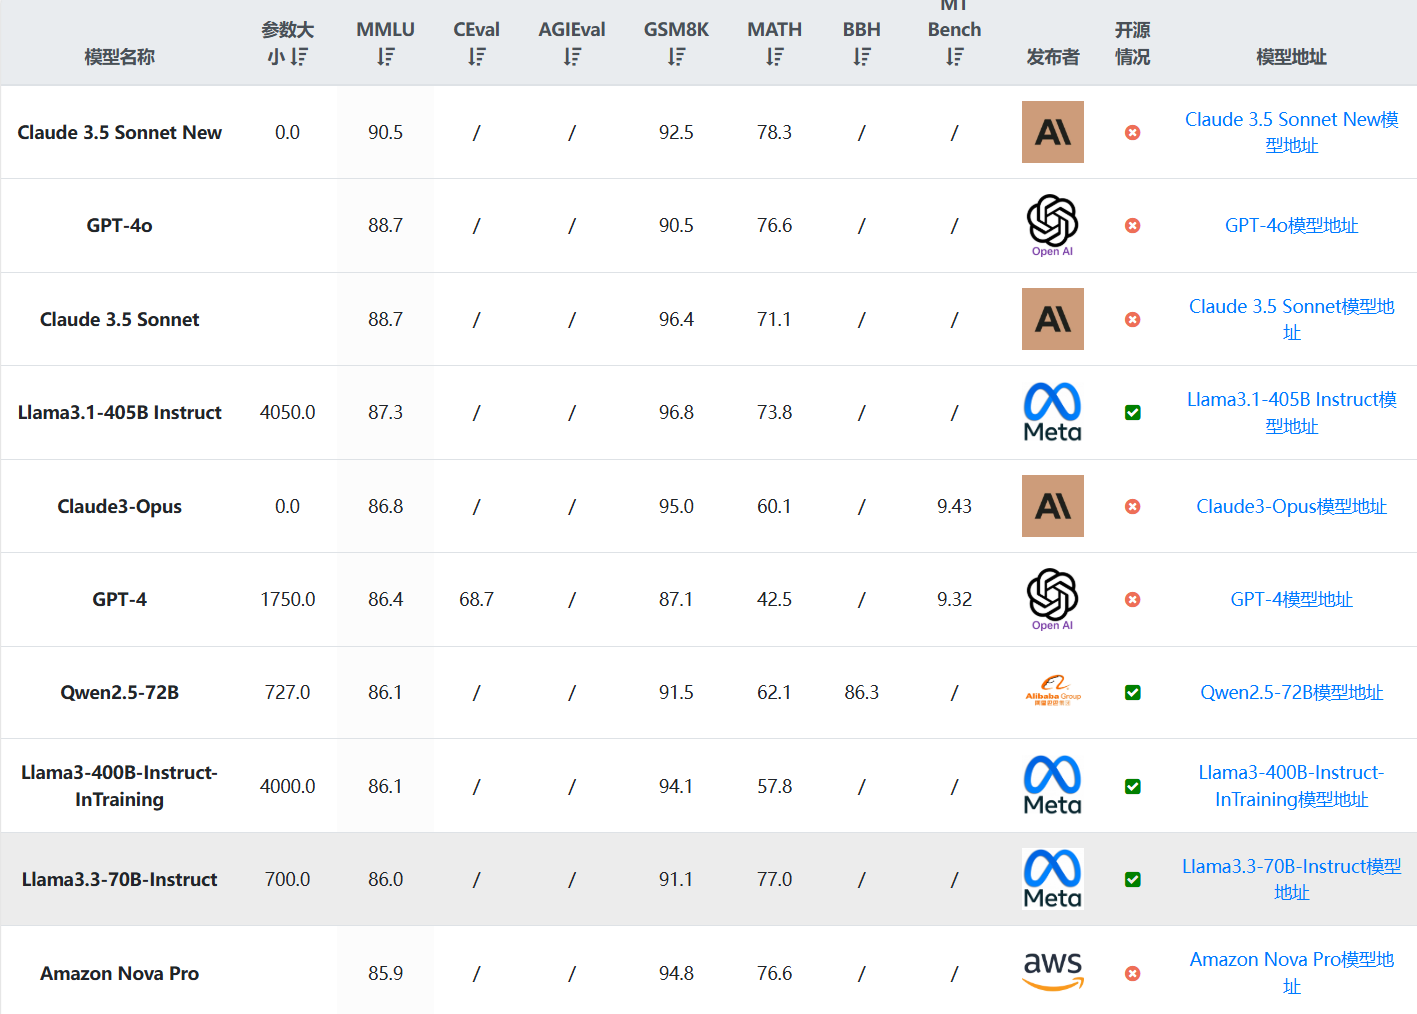
Meta开源Llama3.3-70B-Instruct模型:大模型后训练的佳作,性能超越4050亿参数规模的Llama3.1-405B大模型!

Meta开源Llama3.3-70B-Instruct模型:大模型后训练的佳作,性能超越4050亿参数规模的Llama3.1-405B大模型!

Llama系列大语言模型一直是开源领域的大模型标杆,Llama3系列大模型自从开源之后一直在不断更新。最早的Llama3模型于2024年4月开源,此后,几乎每个三个月都有一个新版本发布。就在昨天,Meta开源了最新的Llama3.3-70B模型,这是Llama3.3系列目前唯一开源的模型。尽管该模型的参数规模仅仅700亿,但是在多项评测基准上已经超过了4050亿参数规模的Llama3.1-405B,后者是Llama系列模型中参数规模最大的一个,也是业界开源模型中参数规模最高的模型之一。

2024/12/08 22:35:451,711
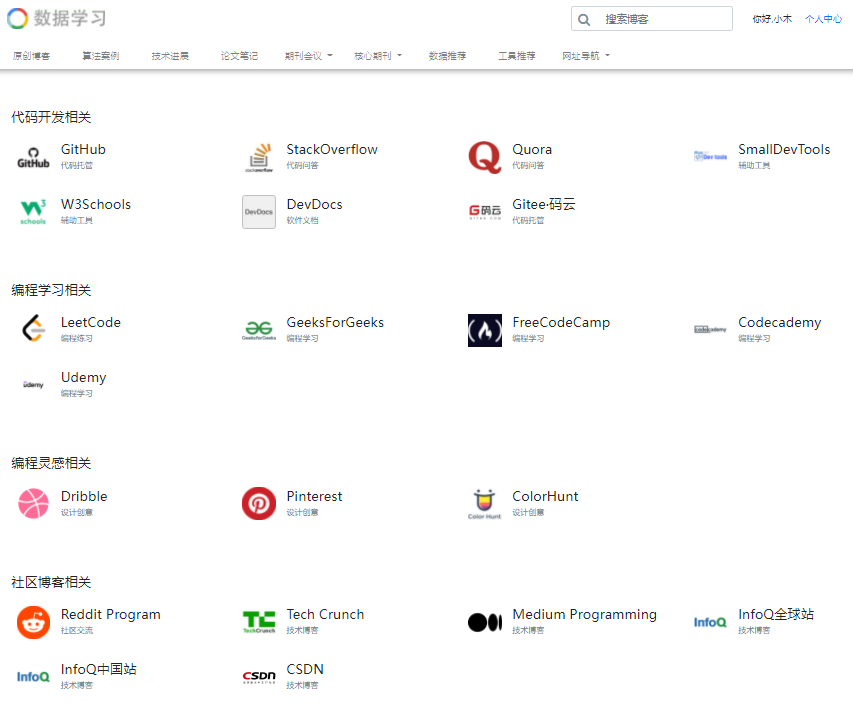
2022年程序员必备的网站收藏

2022年程序员必备的网站收藏

大家都知道,编程的开发离不开互联网的支持,不管是编程的学习还是bug的修复,都需要社区和外部的支持。因此,我们全新开通了一个程序必备网站列表栏目,为大家提供一站式访问目录。也欢迎评论,大家可以说一下你们写代码时候喜欢用的网站,我们也会更新上去。在这里我们挑选几个必备网站简单介绍一下。

2022/03/27 21:55:191,705
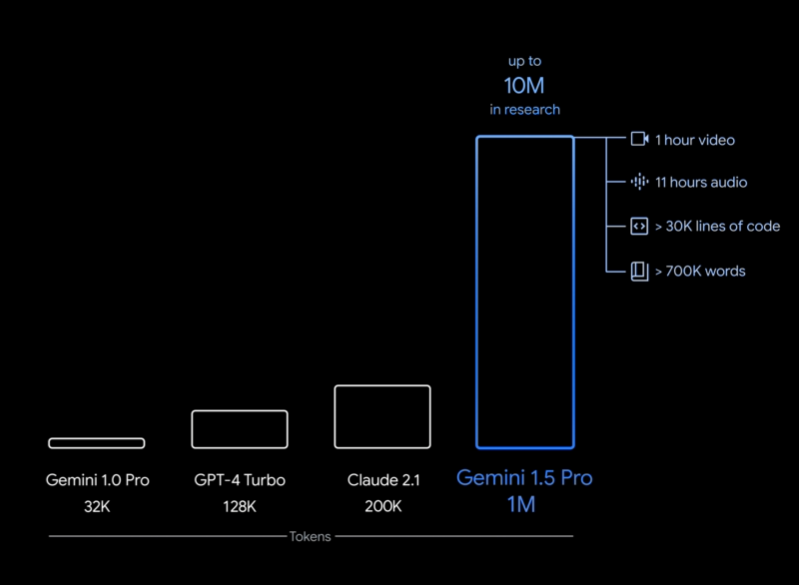
重磅!谷歌宣布发布Gemini 1.5 Pro,距离Gemini发布仅仅一个半月!最高支持1000万上下文长度,GSM8K评测全球第一

重磅!谷歌宣布发布Gemini 1.5 Pro,距离Gemini发布仅仅一个半月!最高支持1000万上下文长度,GSM8K评测全球第一

在2023年12月份,Google发布了Gemini系列大模型(参考:谷歌发布号称超过GPT-4V的大模型Gemini:4个版本,最大的Gemini的MMLU得分90.04,首次超过90的大模型),包含3个不同参数规模的版本。其中,Gemini Ultra号称在MMLU评测上超过了GPT-4,并且在月初也将Bard更名为Gemini,开放了Gemini Ultra的付费使用。刚刚,Google的CEO劈柴哥宣布发布了Gemini 1.5 Pro,这意味着仅仅一个半月,Gemini有了重大更新。

2024/02/16 00:04:221,703
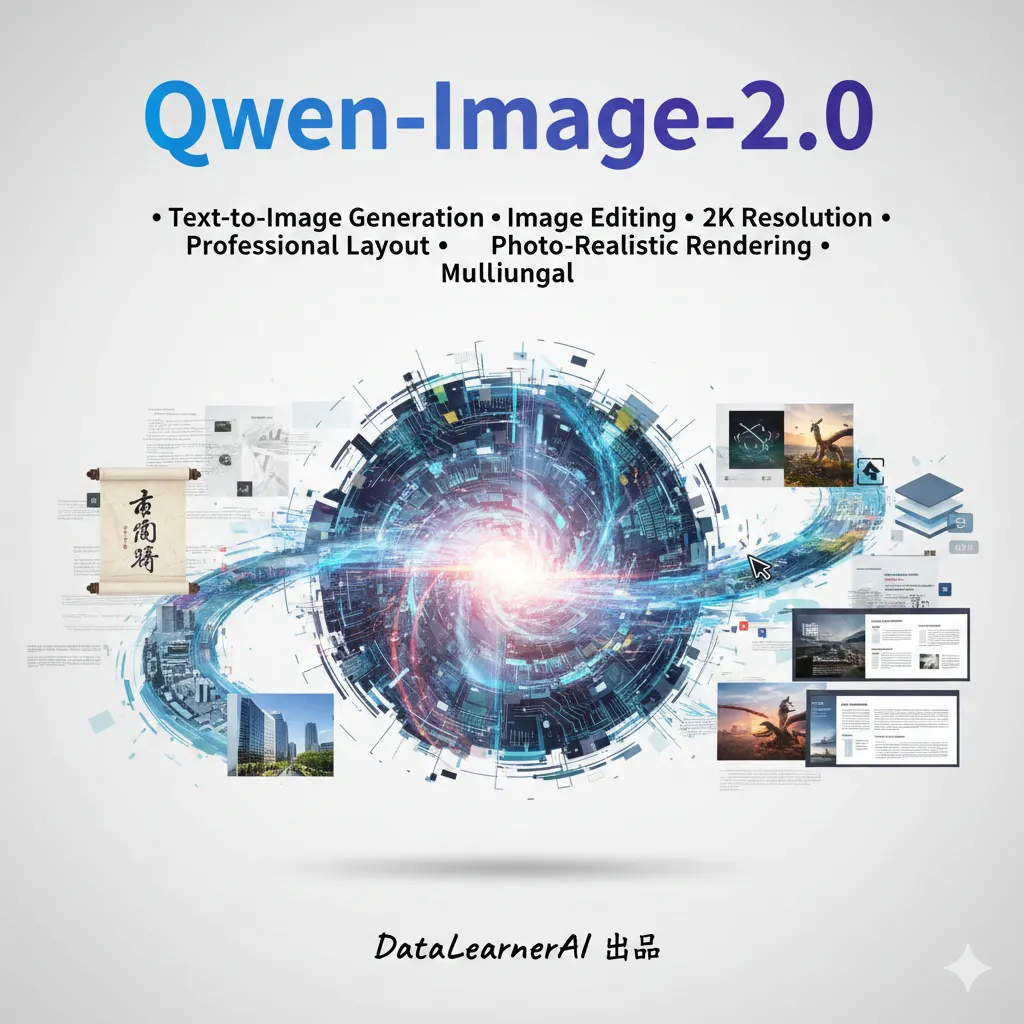
阿里发布第二代图像大模型:Qwen-Image-2.0,融合文本生成图片、图片编辑为一体全球目前排名第三!中文渲染很棒!但不开源~

阿里发布第二代图像大模型:Qwen-Image-2.0,融合文本生成图片、图片编辑为一体全球目前排名第三!中文渲染很棒!但不开源~

就在刚刚,阿里宣布发布Qwen-Image-2.O模型,该模型是Qwen Image系列的最新版本,这个模型综合了此前的文本生成图片和图片编辑的能力,在文本渲染、生成PPT图片方面大幅提升。不过相比较之前的Qwen Image系列,该版本的模型并没有开源,目前在官网可以免费使用。

2026/05/03 14:22:391,693
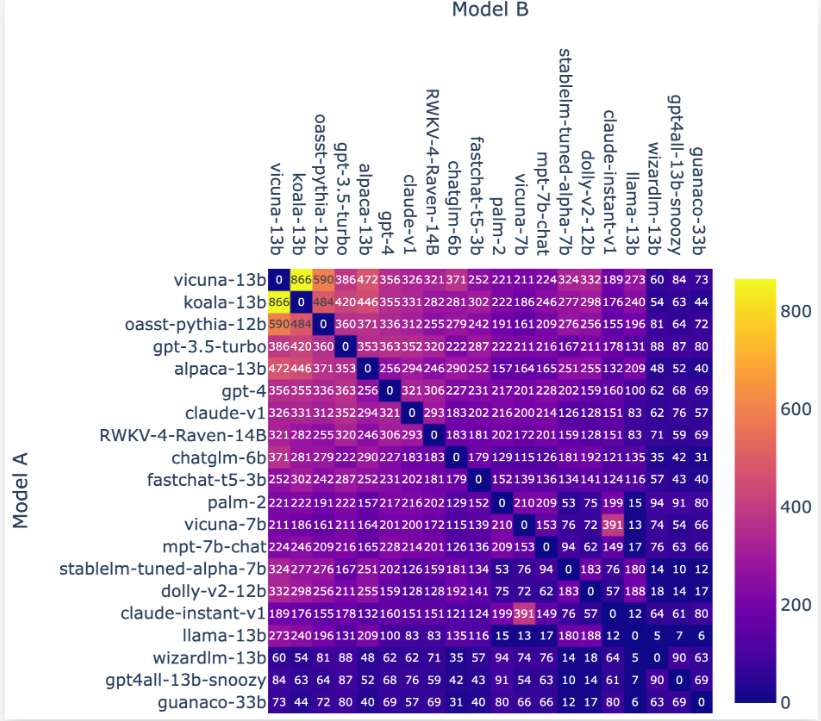
LM-SYS开源包含人类偏好的3.3万条真实对话语料:可用于RLHF的训练过程!

LM-SYS开源包含人类偏好的3.3万条真实对话语料:可用于RLHF的训练过程!

LM-SYS全称Large Model Systems Organization,是由加利福尼亚大学伯克利分校的学生和教师与加州大学圣地亚哥分校以及卡内基梅隆大学合作共同创立的开放式研究组织。该团队在2023年3月份成立,目前的工作是建立大模型的系统,是聊天机器人Vicuna的发布团队。今天开源 了包含3.3万包含真实人类偏好的对话数据集和3000条专家标注的对话数据集:Chatbot Arena Conversation Dataset和MT-bench人工注释对话数据集。

重磅!OpenAI发布最强推理模型“OpenAI o1”(代号草莓),大模型逻辑推理能力大幅提升,官方宣称超越部分人类博士水平!

重磅!OpenAI发布最强推理模型“OpenAI o1”(代号草莓),大模型逻辑推理能力大幅提升,官方宣称超越部分人类博士水平!

OpenAI发布了一个全新的针对逻辑推理优化的大语言模型o1模型。官方宣称其推理能力相比较当前的大语言模型(GPT-4o)有了大幅提升。OpenAI宣称o1模型在编程竞赛问题(Codeforces)中排名第89百分位,在美国数学奥林匹克(AIME)的资格赛中位列美国前500名,并且在物理、 生物和化学问题的基准测试(GPQA)上超越了人类博士水平的准确率。

2024/09/13 07:37:511,691
又一个国产开源大模型发布:前腾讯创始人创业公司元象发布XVERSE-13B,超过Baichuan-13B,与ChatGLM2-12B齐平!但免费商用授权!

又一个国产开源大模型发布:前腾讯创始人创业公司元象发布XVERSE-13B,超过Baichuan-13B,与ChatGLM2-12B齐平!但免费商用授权!

XVERSE-13B是元象开源的一个大语言模型,发布一周后就登顶HuggingFace流行趋势榜。该模型最大的特点是支持多语言,其中文和英文水平都十分优异,在评测结果上超过了Baichuan-13B,与ChatGLM2-12B差不多,不过ChatGLM2-12B是收费模型,而XVERSE-13B是免费商用授权!

2023/08/14 09:57:081,689
如何让Nano Banana Pro生成更好的图片?Nano Banana Pro 提示词写作官方教程

如何让Nano Banana Pro生成更好的图片?Nano Banana Pro 提示词写作官方教程

Google 最新推出的 Nano Banana Pro(Gemini 3 Pro Image) 不只是一次“图像质量提升”,而是让普通用户也能借助专业级提示词,生成具备排版、构图、品牌、摄影语言的作品。 在这个版本中,最关键的能力不是模型本身,而是: 它对结构化、专业化 Prompt 的响应能力非常强。 写对提示词,效果天差地别。 本文将完全聚焦于: 怎么写提示词,才能让 Nano Banana Pro 生出最好的图。

2025/11/21 01:21:061,676
Google Gemini Pro 1.5重大更新:新增音频理解、单次处理任何格式数据、更强大的函数调用和JSON模式,DataLeanrerAI实测音频理解能力优秀,且免费使用!

Google Gemini Pro 1.5重大更新:新增音频理解、单次处理任何格式数据、更强大的函数调用和JSON模式,DataLeanrerAI实测音频理解能力优秀,且免费使用!

Gemini是谷歌发布的一系列大语言模型。最早是2023年12月发布1.0版本,在2023年2月中旬,劈柴哥亲自宣布Gemini Pro升级到1.5版本。Gemini 1.5 Pro是一个全新的MoE模型(Mixture of Experts,混合专家),在各项评测结果中都接近Gemini Ultra 1.0的水平。而在今天,Gemini Pro 1.5再次迎来重大更新,包括音频理解、无限制文件阅读以及更好地指令遵从性等。本文将介绍这次更新,并做一些简单的实际测试。

2024/04/10 22:12:191,651