
原创博客
原创AI技术博客
探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。
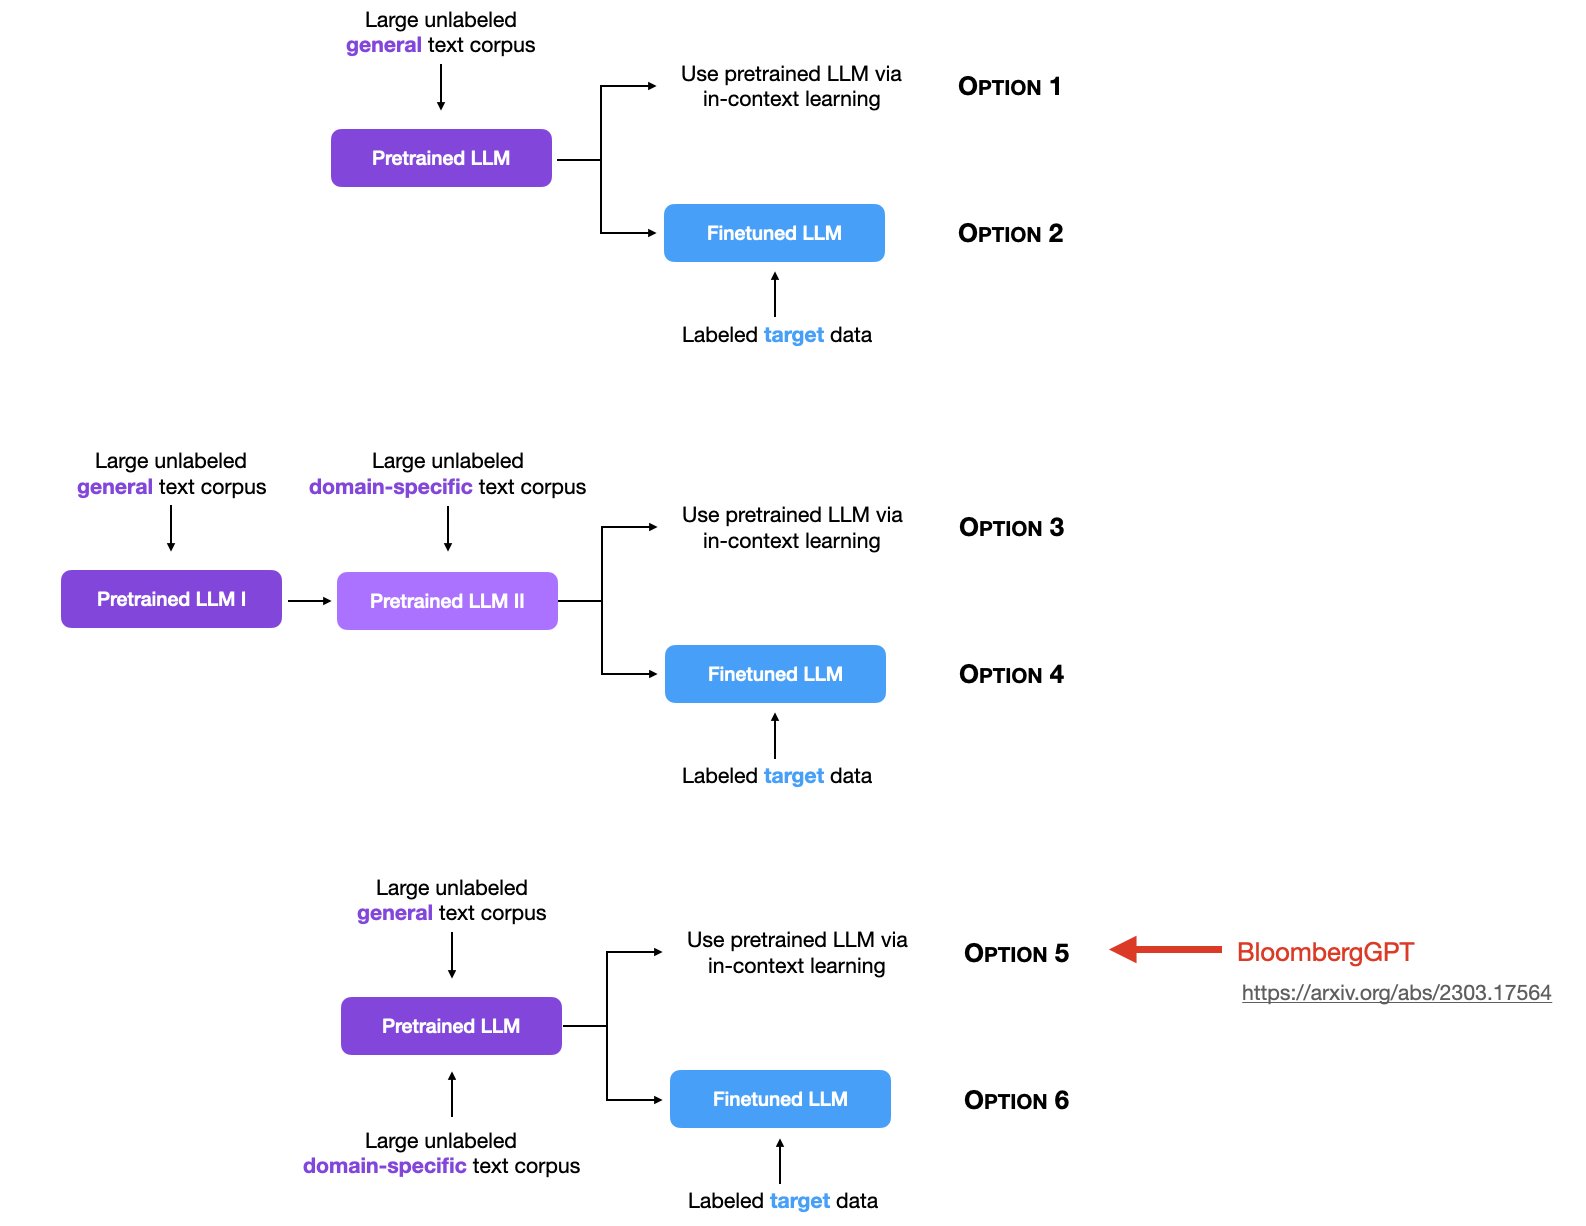
6种大模型的使用方式总结,使用领域数据集持续做无监督预训练可能是一个好选择
Sebastian Raschka是LightningAI的首席科学家,也是前威斯康星大学麦迪逊分校的统计学助理教授。他在大模型领域有非常深的简介,也贡献了许多有价值的内容。在最新的一期统计中,他总结了6种大模型的使用方法,引起了广泛的讨论。其中,关于使用领域数据集做无监督预训练是目前讨论较少,但十分重要的一个方向。
通俗易懂地解释OpenAI Sora视频生成的特点有哪些?Sora与此前的Stable Video Diffusion、Runway Gen2、Pika等有什么区别?OpenAI Sora的缺点是什么?
OpenAI的Sora模型是最近两天最火热的模型。它生成的视频无论是清晰度、连贯性和时间上都有非常好的结果。在Sora之前,业界已经有了很多视频生成工具和平台。但为什么Sora可以引起如此大的关注?Sora生成的视频与此前其它平台生成的视频到底有哪些区别?有很多童鞋似乎对这些问题依然有疑问,本文将以通俗的语言解释Sora的独特之处。
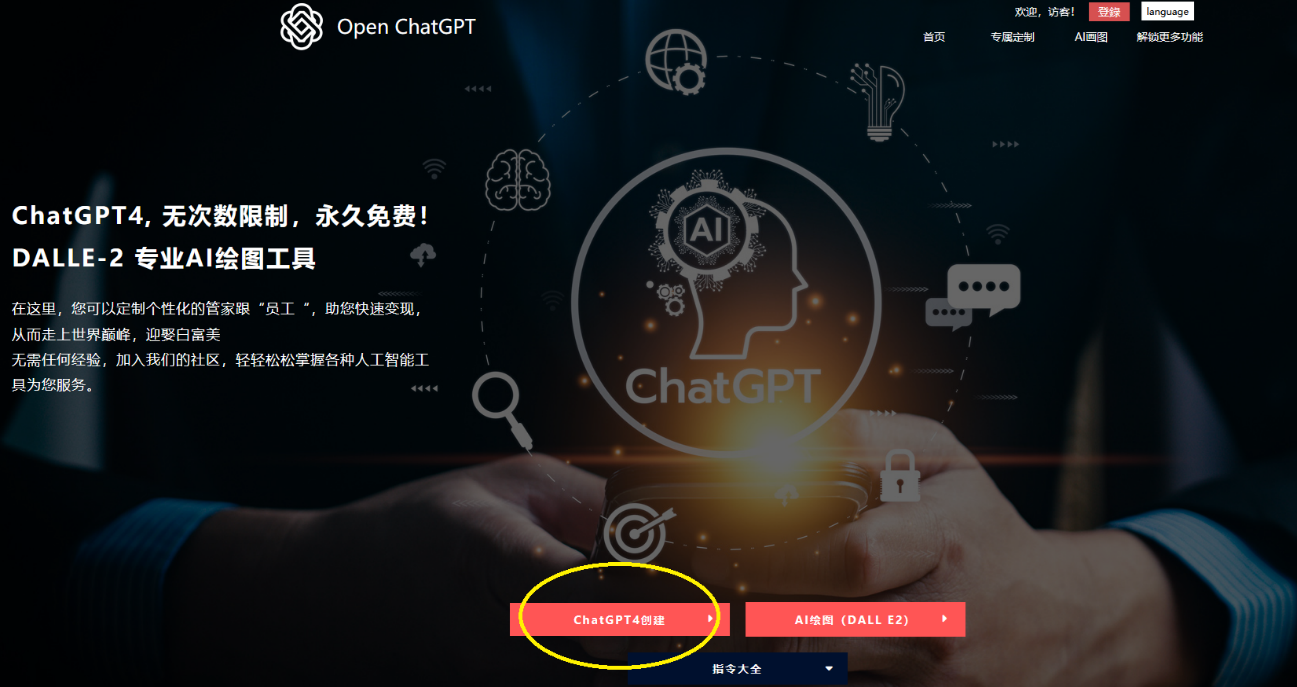
Open ChatGPT:一个整合了GPT-4和多模态能力的ChatGTP服务商,免费可用,月租也很合理~
恰巧,我最近发现了一个网站——Open ChatGPT,网址是 https://open-chat-gpt.com/cn。 简单来说,该网站调用 ChatGPT-4 (最新版) 的 API,让用户创建各种指定角色,服务于生活跟工作。不仅如此,还支持连ChatGPT官网都还没用上的AI画图功能。目前,相比其他网页各种限制使用次数的,这网站非常可贵在于可以无限次免费使用ChatGPT-4...
MBA与数据分析师危矣?最新内测版本的ChatGPT已经可以针对excel自动做数据分析和异常分析了!
2023年3月23日OpenAI官方宣布ChatGPT即将支持Plugin模式。这是一种用插件的方式来解锁ChatGPT的能力,包括让ChatGPT可以浏览网页、从本地商店订购食材等。今天,沃顿商学院教授Ethan Mollick在推特上公布了自己收到了ChatGPT内测邀请,并使用它的代码解释器(Python Interpreter)插件让ChatGPT针对一份excel数据完成了非常专业的数据分析的工作。
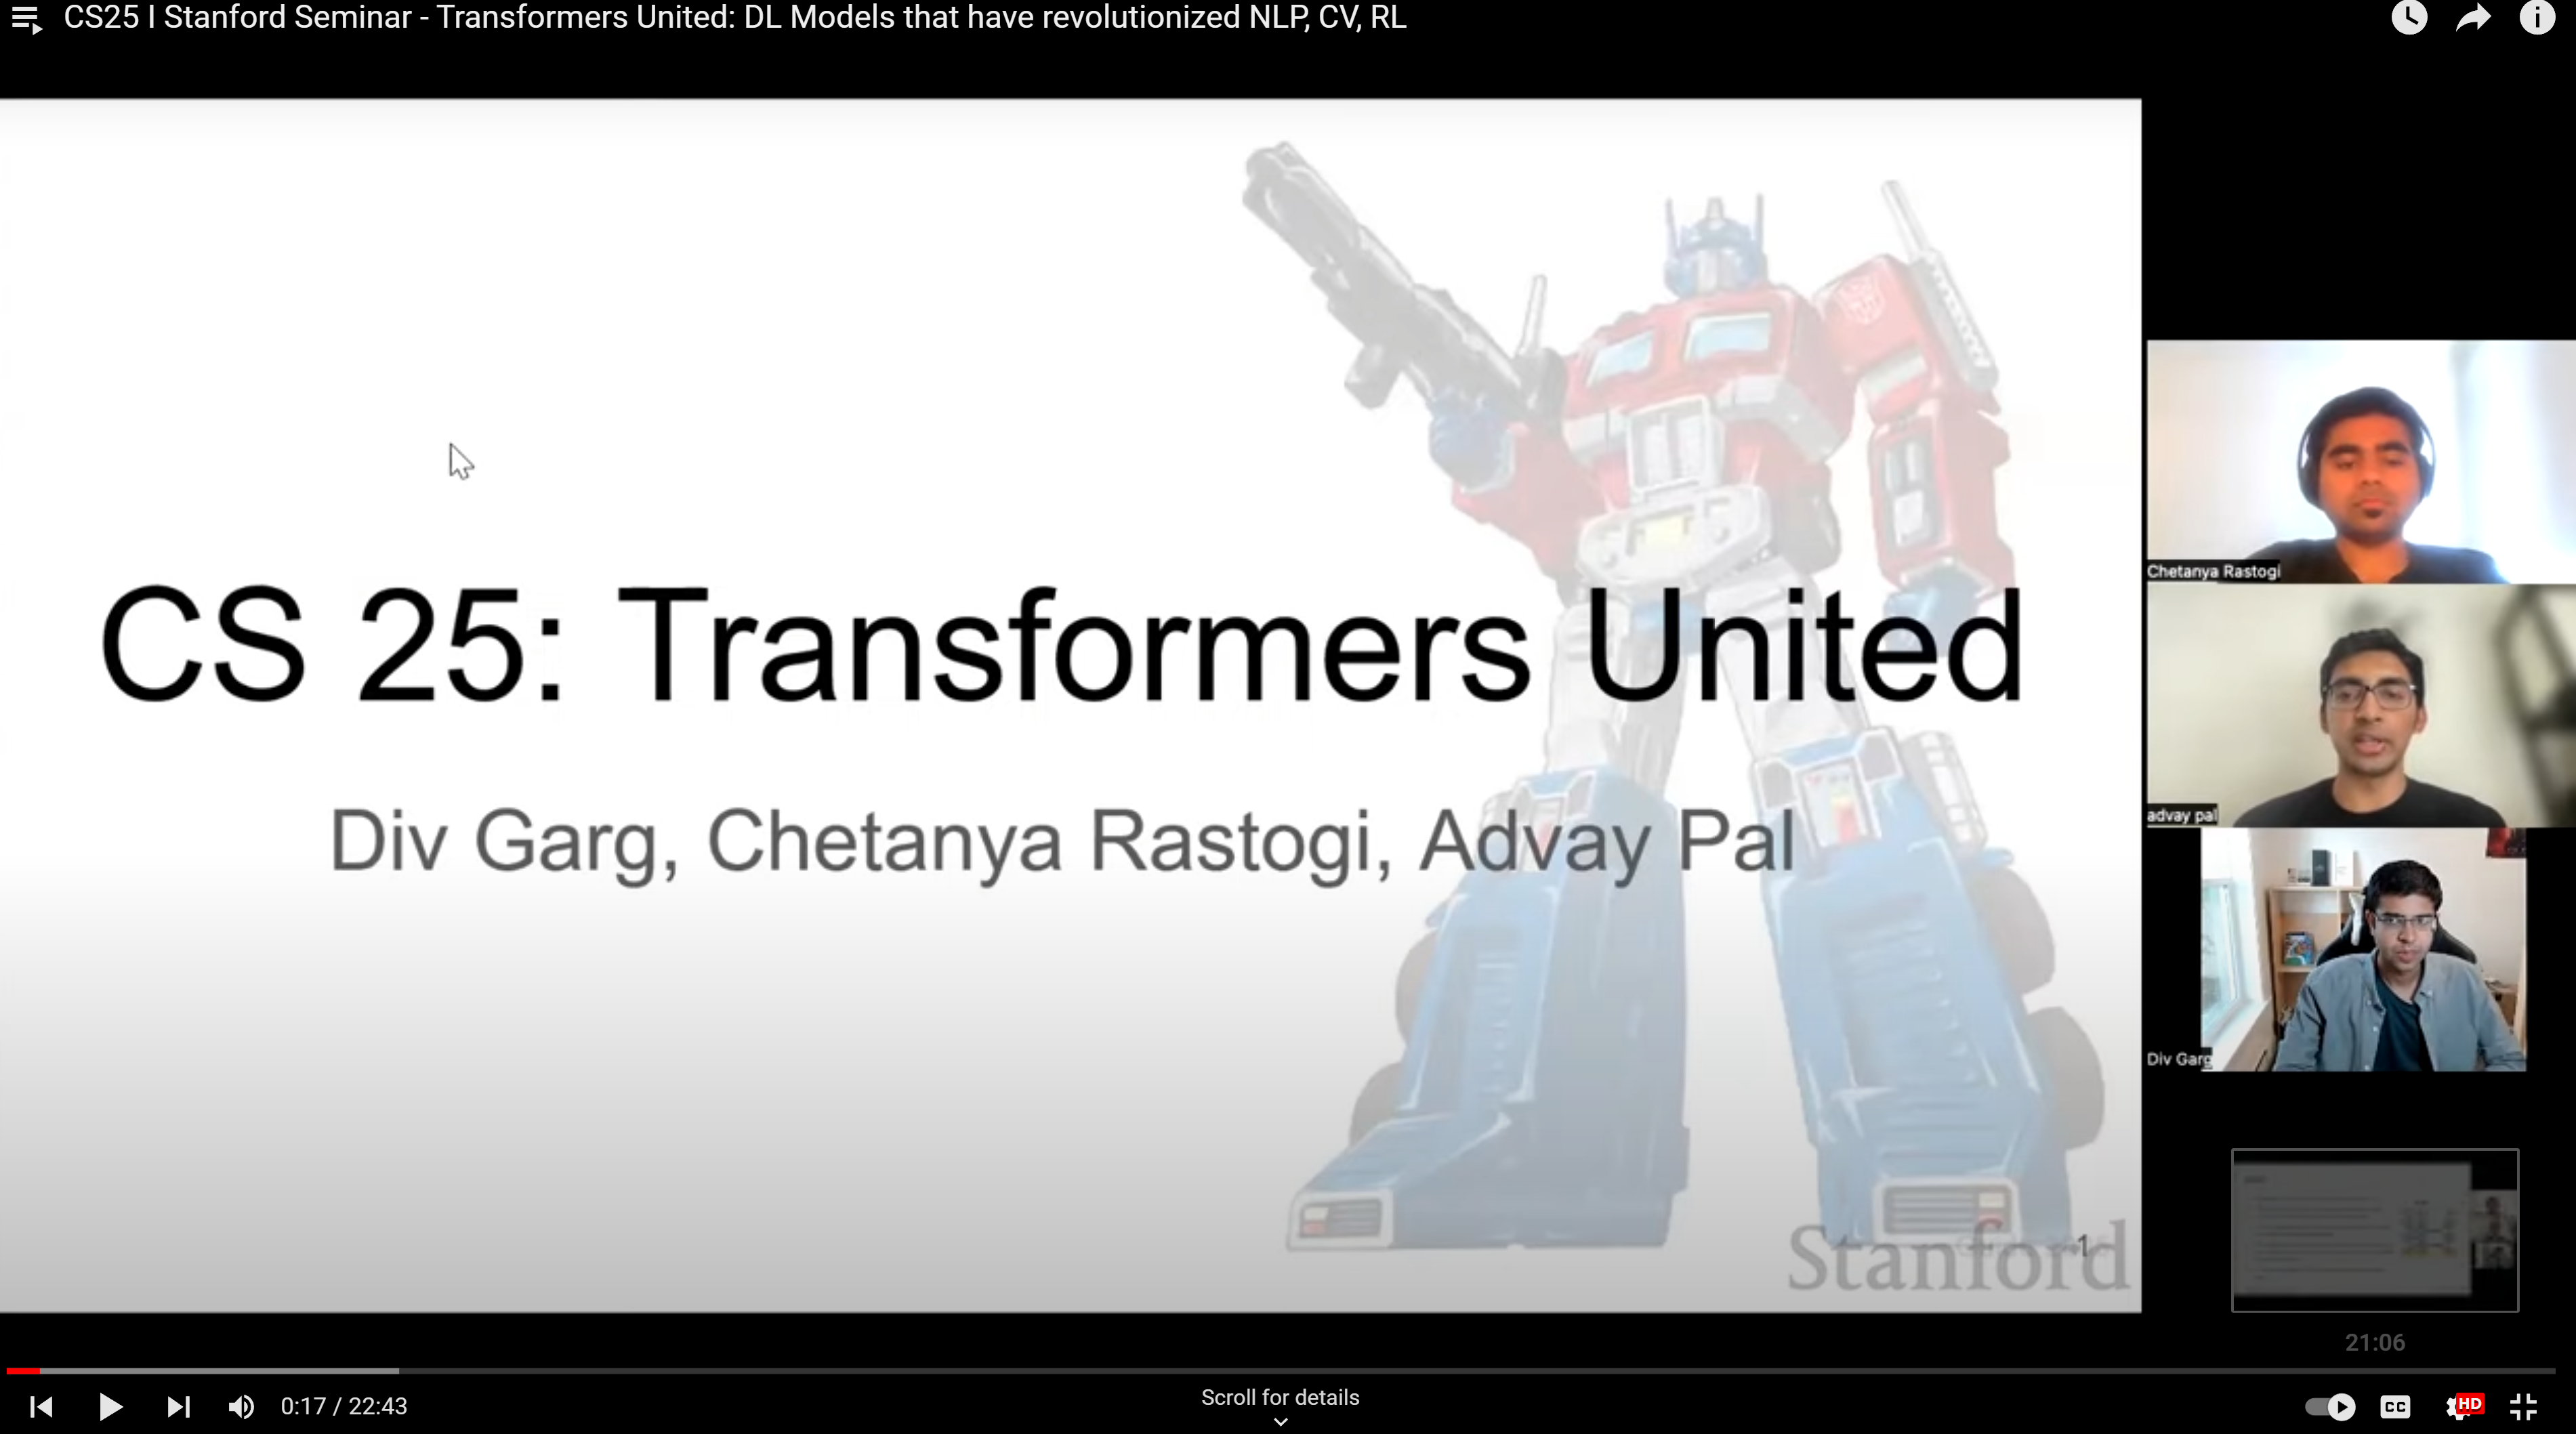
斯坦福(Stanford)最新公开了全球第一个Transformers相关的课程!
重磅福利,斯坦福大学在去年秋季开设了应该是全球第一个transformers相关的课程,授课人员来自OpenAI、Google Brain、Facebook人工智能实验室、DeepMind甚至是牛津大学的业界与学术界的一线大牛。而这两天,这门课相关视频也都公开了,大家可以去观看学习了!
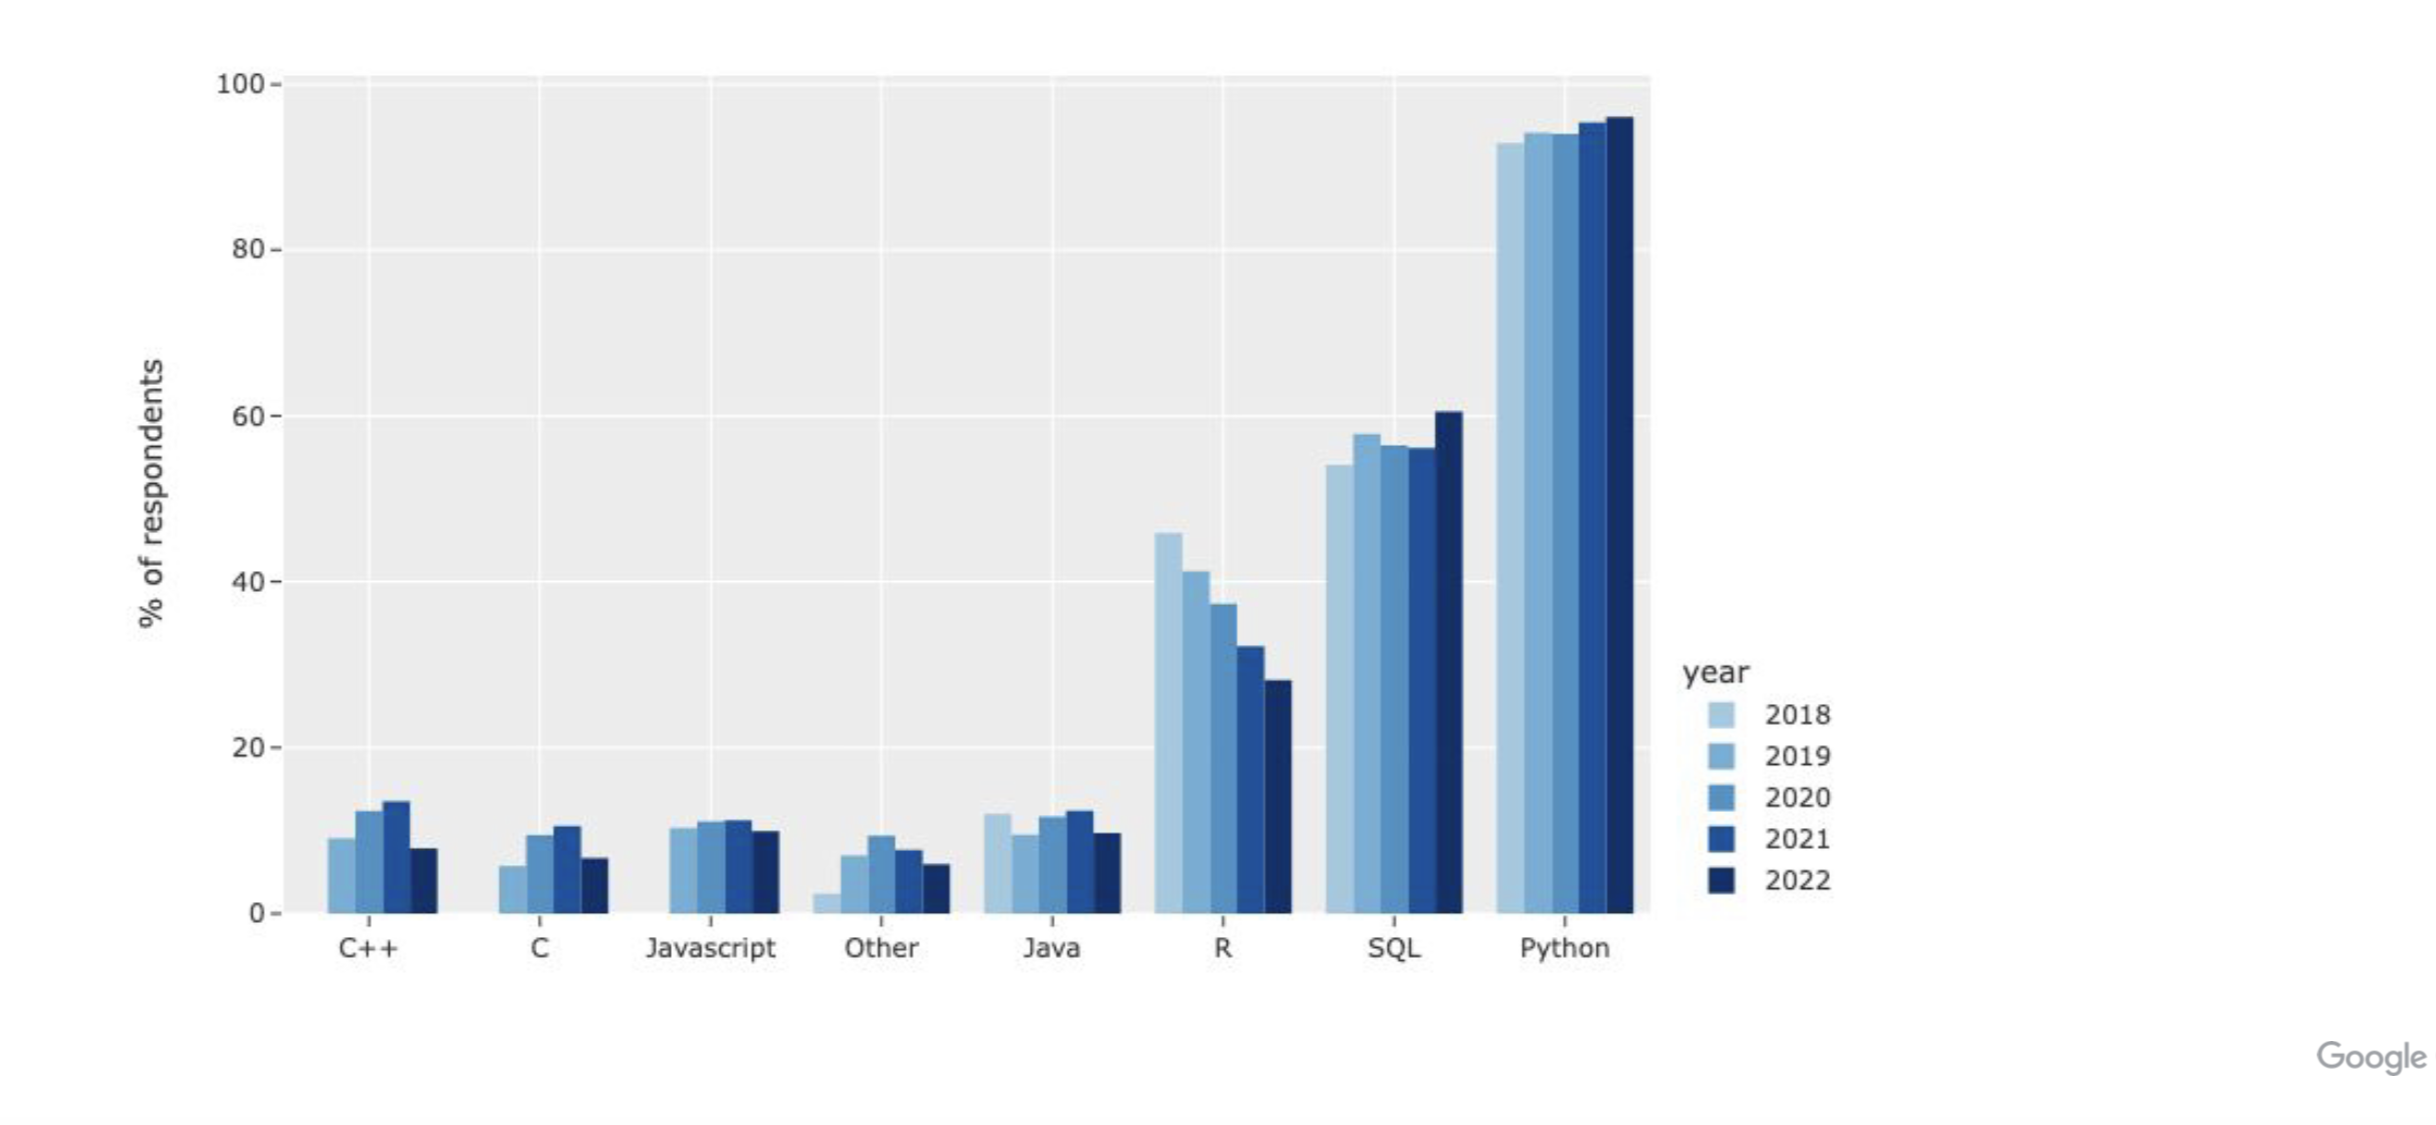
Kaggle 2022调查报告出炉!看看过去一年数据科学家都在干啥!
kaggle是各类机器学习竞赛的著名平台,上面聚集了大量的机器学习比赛和数据集,也有大量的数据处理相关专业人员。每年官方都会向平台用户发放问卷,调查数据科学家的工具使用和平台采用情况。今年的调查结果也在两天前发出,有很多有意思的结论。
如何评估大模型的Agent能力?τ²-Bench:评估双控对话智能体的新标准
为了解决大模型的Agent操作依赖交互和人工处理这个问题,普林斯顿大学与 Sierra Research 的研究团队在 2025 年 6 月提出了 τ²-Bench(Tau-Squared Benchmark),并发布了论文《τ²-Bench: Evaluating Conversational Agents in a Dual-Control Environment》。 它是对早期 τ-Bench 的扩展版本,旨在建立一种标准化方法,评估智能体在与用户共同作用于环境时的表现。

模型不能停,阿里又又又又要开源新模型:Qwen3-Next-80B-A3B
继阿里刚发布Qwen3-ASR模型之后,Qwen团队又在社区提交了全新的Qwen3-Next代码。这意味着阿里即将开源Qwen3家族的新成员。这个模型最大的特点是架构变化很大,与此前Qwen系列很不一样。
重磅!阿里开源325亿参数规模的推理大模型QwQ-32B:性能接近DeepSeek R1满血版,参数更低,免费商用授权!
就在几个小时前,阿里巴巴开源了最新的一个推理大模型,QwQ-32B,该模型拥有类似o1、DeepSeek R1模型那样的推理能力,但是参数仅325亿,以Apache 2.0开源协议开源,这意味着大家可以完全免费商用。
文本理解与代码补全都很强!Salesforce开源支持8K上下文输入的大语言模型XGen-7B!
Salesforce是全球最大的CRM企业,但是在开源大模型领域,它也是一个不可忽视的力量。今天,Salesforce宣布开源全新的XGen-7B模型,是一个同时在文本理解和代码补全任务上都表现很好的模型,在MMLU任务和代码生成任务上都表现十分优秀。最重要的是,它的2个基座模型XGen-7B-4K-Base和XGen-7B-8K-Base都是完全开源可商用的大模型。
Google发布第二代Gemini大语言模型,首个登场的Gemini 2 Flash Experimental,评测结果显示其能力已经超越上一代的Gemini 1.5 Pro!
Gemini是谷歌发布的一系列大模型的名称,是谷歌前期大模型Bard产品的替代品。从Gemini 1.0发布开始,每一次发布都获得了不错的反响。今天,Google发布了最新一代的Gemini 2.0模型,首个产品是其参数规模较小的Gemini 2.0 Flash,它的推理速度是Gemini 1.5 Pro的2倍,但是各项评测结果上的表现却超过了Gemini 1.5 Pro。该模型完全免费提供给大家使用。
Google发布Gemini 2.0 Pro:MMLU Pro评测超过DeepSeek V3略低于DeepSeek R1,最高上下文长度支持200万tokens!开发者每天免费50次请求!
2025年2月5日,Google官方宣布Gemini 2.0 Pro版本上线,Gemini系列是谷歌最新一代大模型的品牌名称。Google最早在2024年12月中旬发布了Gemini 2.0系列的第一个模型Gemini 2.0 Flash,当时试用的人都普遍反应这个模型速度又快,结果友好,让Google摆脱了此前大模型很落后的印象。今天,Gemini 2.0 Pro上线,其能力更强。
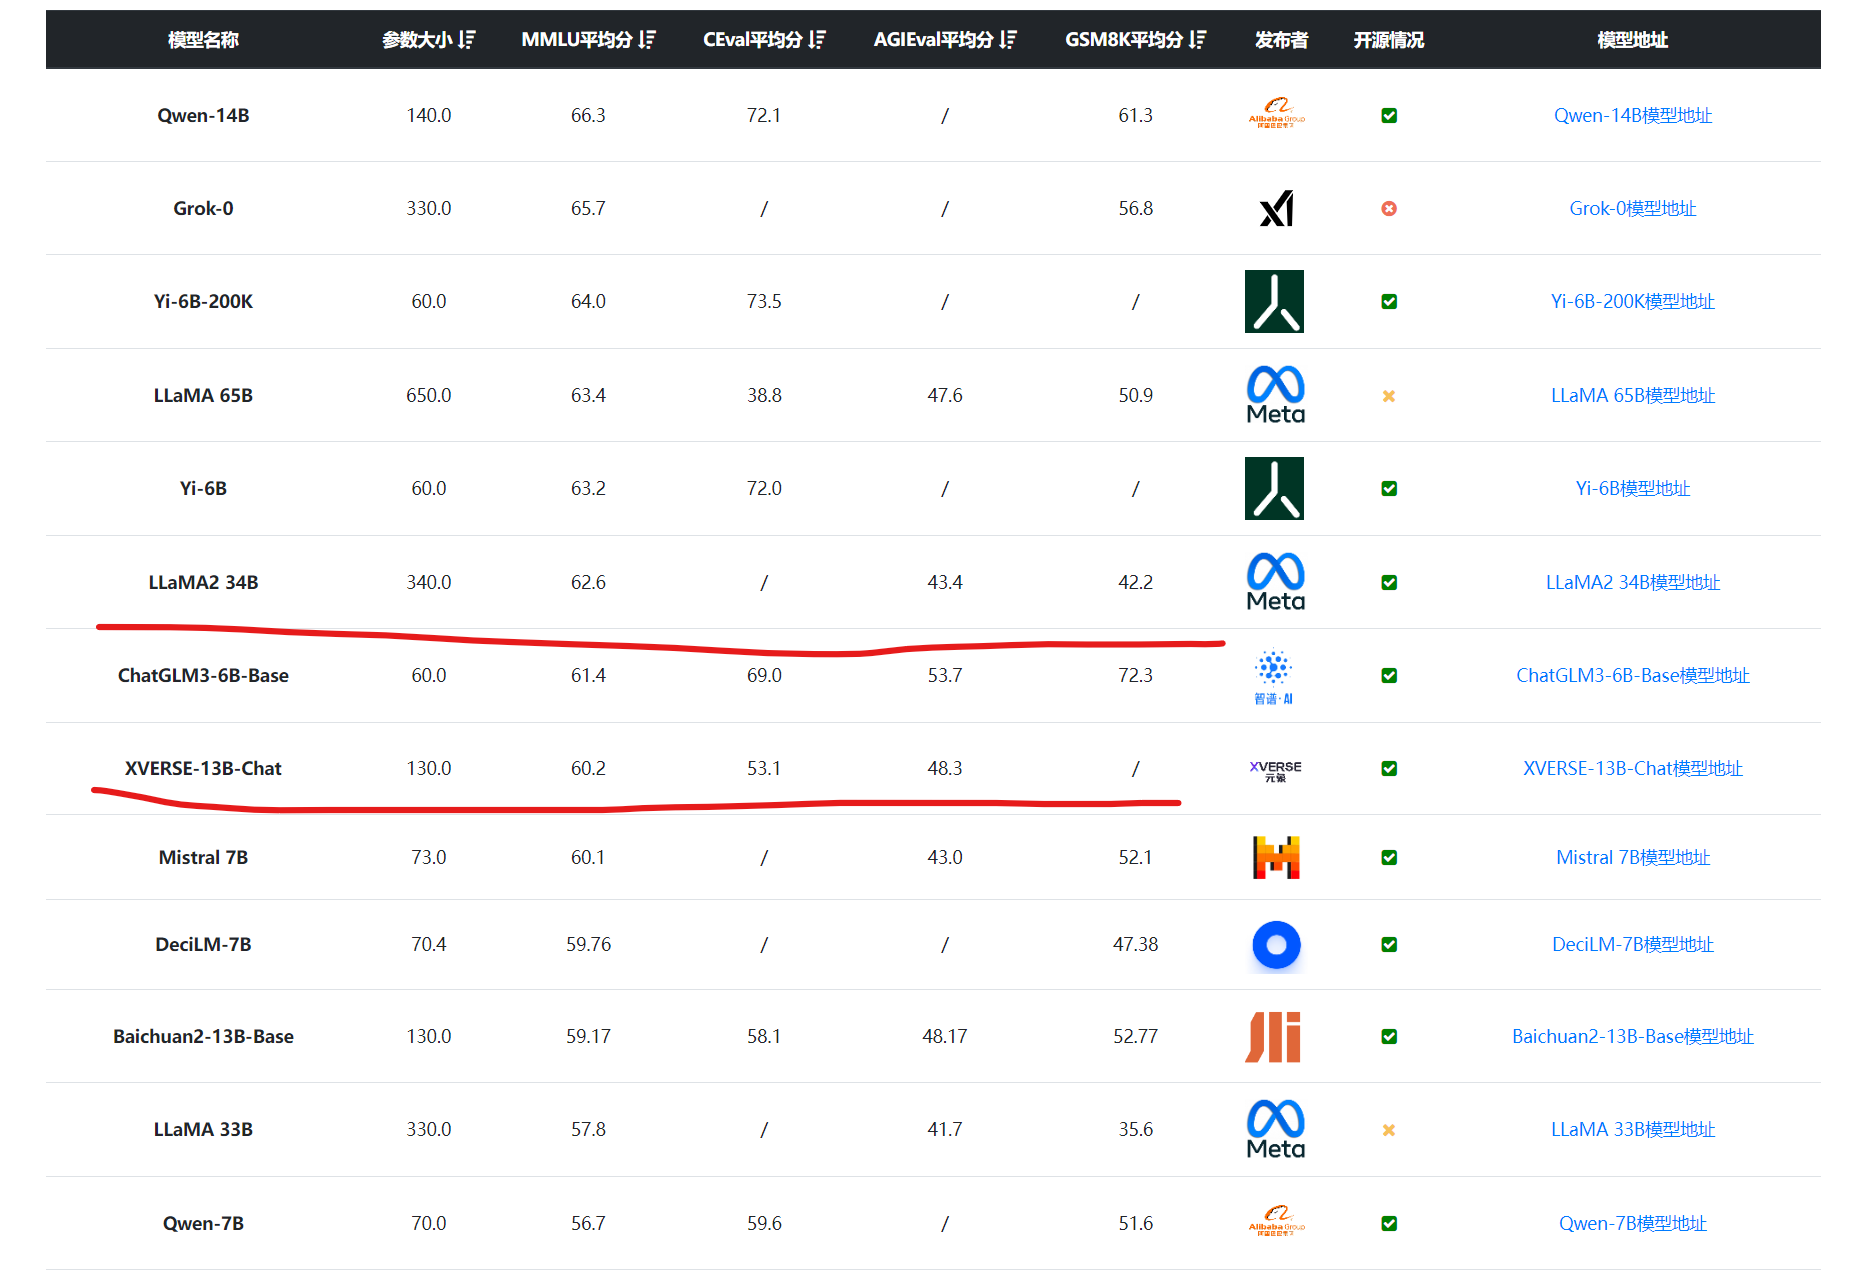
国产全球最长上下文大语言模型开源:XVERSE-13B-256K,一次支持25万字输入,免费商用授权~
深圳的元象科技开源了一个最高上下文256K的大语言模型XVERSE-13B-256K,可以一次性处理25万字左右,是目前上下文长度最高的大模型,而且这个模型是以Apache2.0协议开源,完全免费商用授权。
MiniMaxAI开源MiniMax M2模型:Artificial Analysis评测显示综合智能得分超过Claude Opus 4.1,开源第一,全球第五。
MiniMax正式开源MiniMax M2模型,该模型定位是“Mini 模型,Max 编码与代理工作流”。最大的特点是2300亿总参数量,但是每次推理仅激活100亿,类似于10B模型。这款模型非常火爆,原因在于这么小的激活参数数量,推理速度很快,但是其评测结果非常优秀。
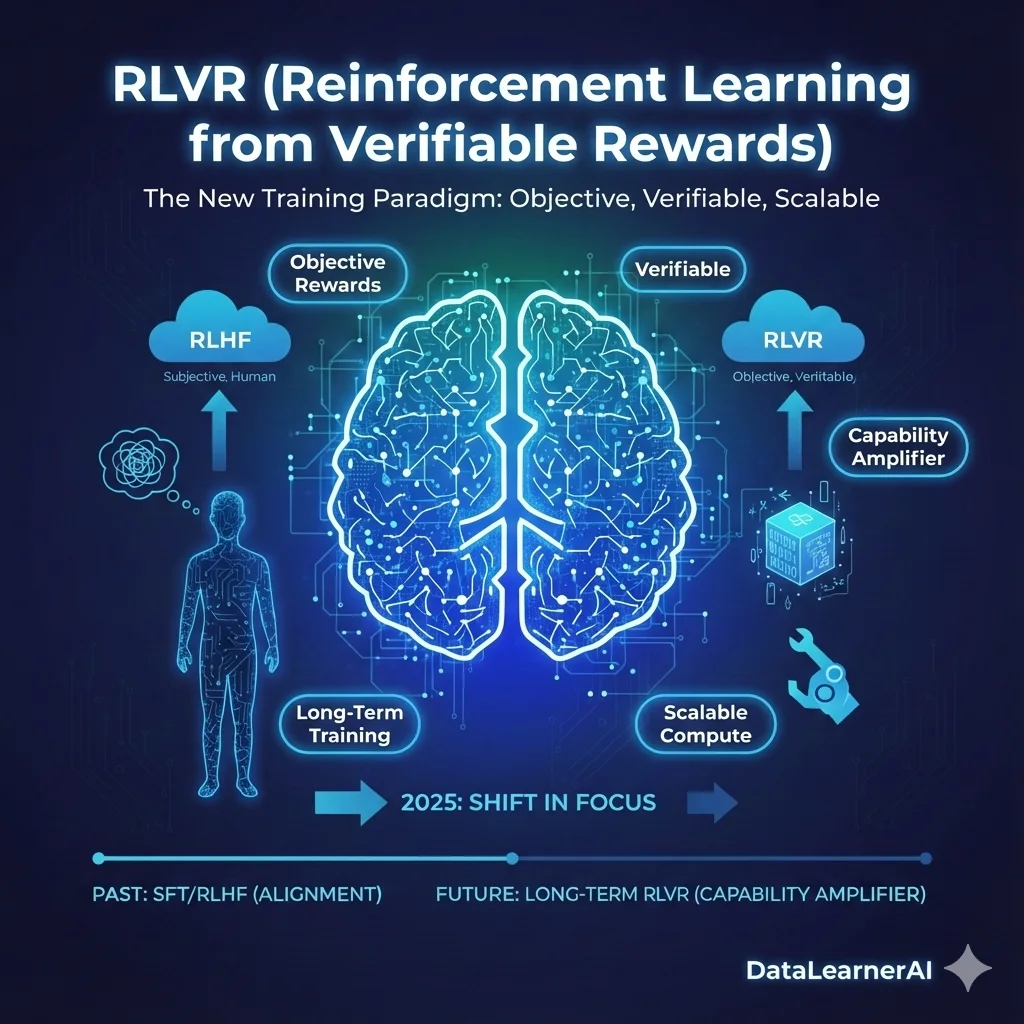
基于可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards, RLVR)的介绍:为什么 2025 年,大模型训练的重心开始发生迁移?
过去几年,大语言模型的训练路线相对稳定:更大的模型、更长的预训练、更精细的指令微调与人类反馈对齐。这套方法在很长一段时间内持续奏效,也塑造了人们对“模型能力如何提升”的基本认知。但在 2025 年前后,一种并不算新的训练思路突然被推到台前,并开始占据越来越多的计算资源与工程关注度,这就是**基于可验证奖励的强化学习(Reinforcement Learning from Verifiable Rewards,RLVR)**。
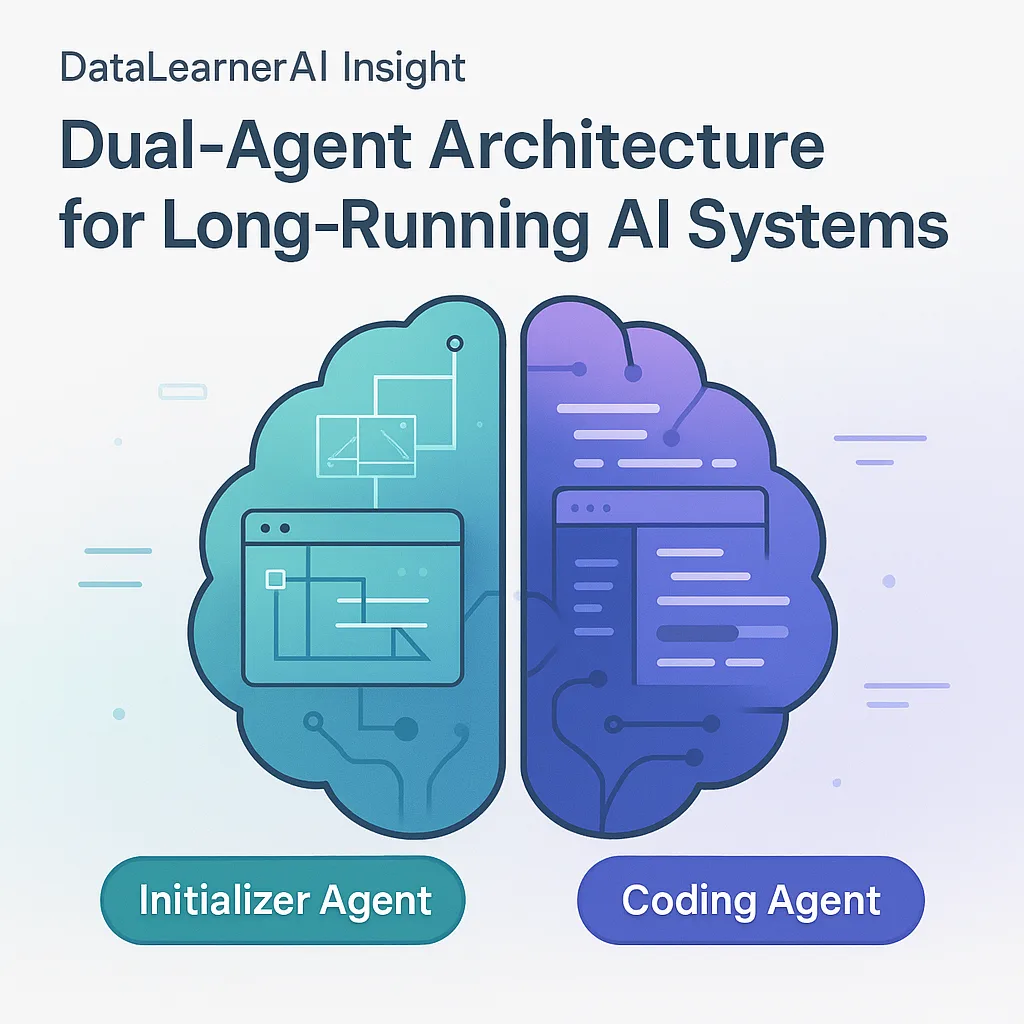
Anthropic 最新 Agent 工程方案:使用双 Agent 架构让 AI 实现真正的长时自主工作
就在昨天,Anthropic 发布了一套非常重要的工程方案,专门针对这些挑战而设计:基于“Initializer Agent + Coding Agent”的双 Agent 架构。
重磅!Meta将PyTorch移交给Linux基金会!
昨天,Meta的Zuckerberg宣布,将PyTorch由Meta AI移交给Linux Foundation托管。这意味着PyTorch从今天起从Meta独立,并作为Linux Foundation下的一个项目。
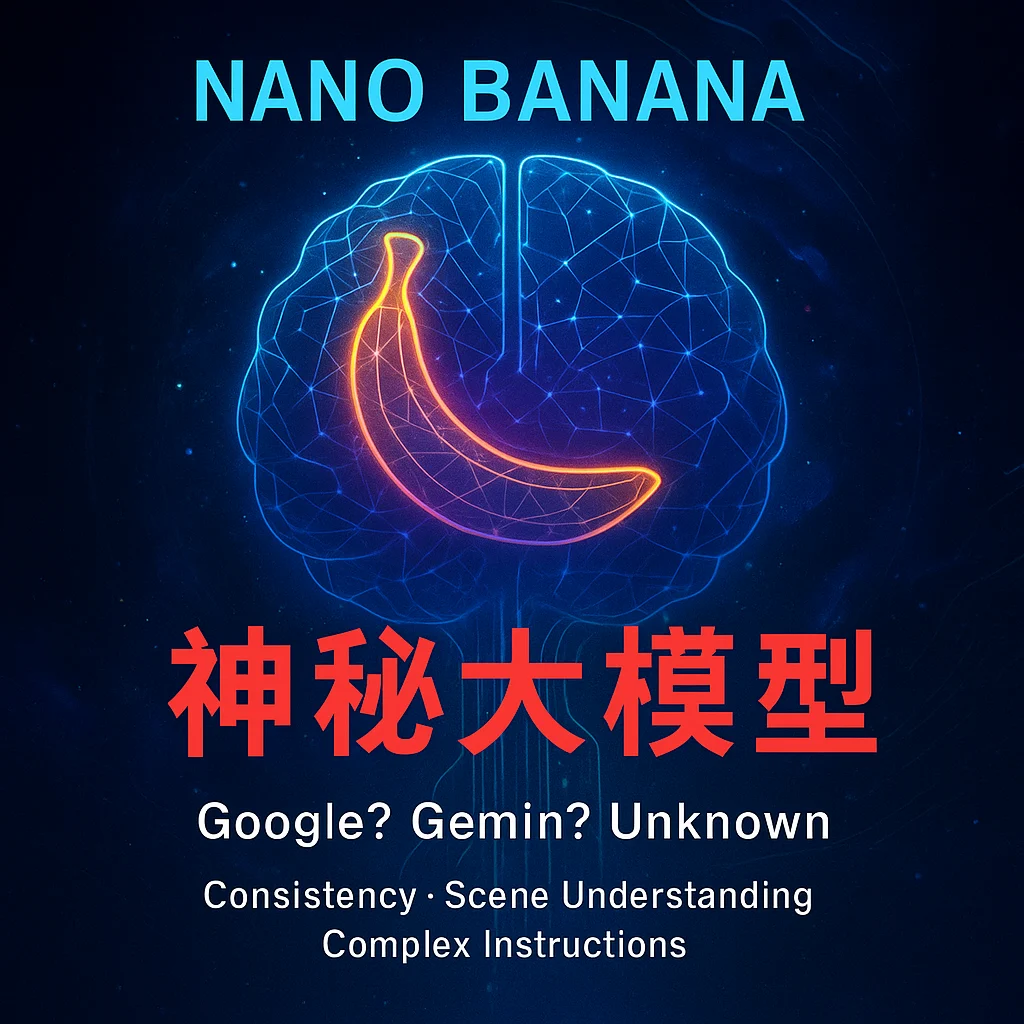
神秘的图片生成和编辑大模型Nano Banana是什么?背后是Google吗?什么时候发布?能否颠覆Adobe
最近,一个代号 “Nano Banana” 的神秘图像生成与编辑大模型突然在社交网络上掀起风暴。与之前所有模型截然不同,它似乎拥有「记忆面孔」的魔法:无论角度、光影如何变化,人物的面容始终一致;它还能读懂照片里的故事,精准捕捉场景氛围,并服从多步骤、高复杂度的指令。然而,它像幽灵一样没有身世——没有官方文档,没有作者署名,甚至没有一行技术白皮书。极致的神秘感与惊人的效果形成巨大反差,像磁铁般吸住了整个社区的目光:它究竟出自谁手?能力边界到底在哪儿? 本文会介绍一下这个模型当前已知的信息,以及如何使用。
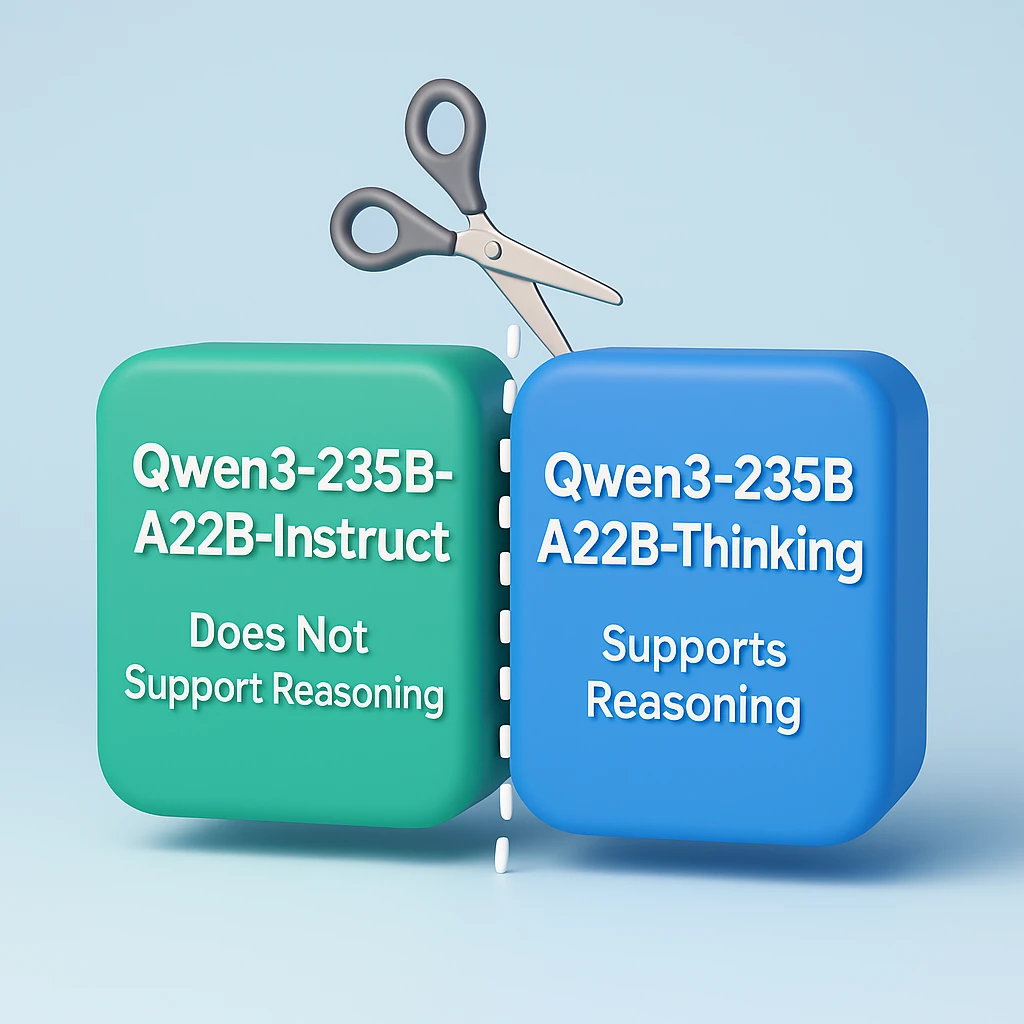
阿里发布Qwen3小幅更新版本,放弃混合思考模式,发布全新的2个版本Qwen3-235B-A22B-2507模型,1/5的参数,性能直逼Kimi K2,推理模式版本评测结果接近o3
阿里今天开源了一个Qwen3-235B-A22B模型的小幅更新版本,命名为Qwen3-235B-A22B-Thinking-2507,这是一个只支持带推理过程的模型,而四天前,阿里还开源了Qwen3-235B-A22B-Instruct-2507,一个不支持推理过程的模型。这2个版本模型去除了Qwen3此前的一个模型的混合架构模式(即一个模型同时支持thinking和non-thinking),而是拆分成2个不同的版本。阿里官方说这是从社区获得了反馈之后决策的。
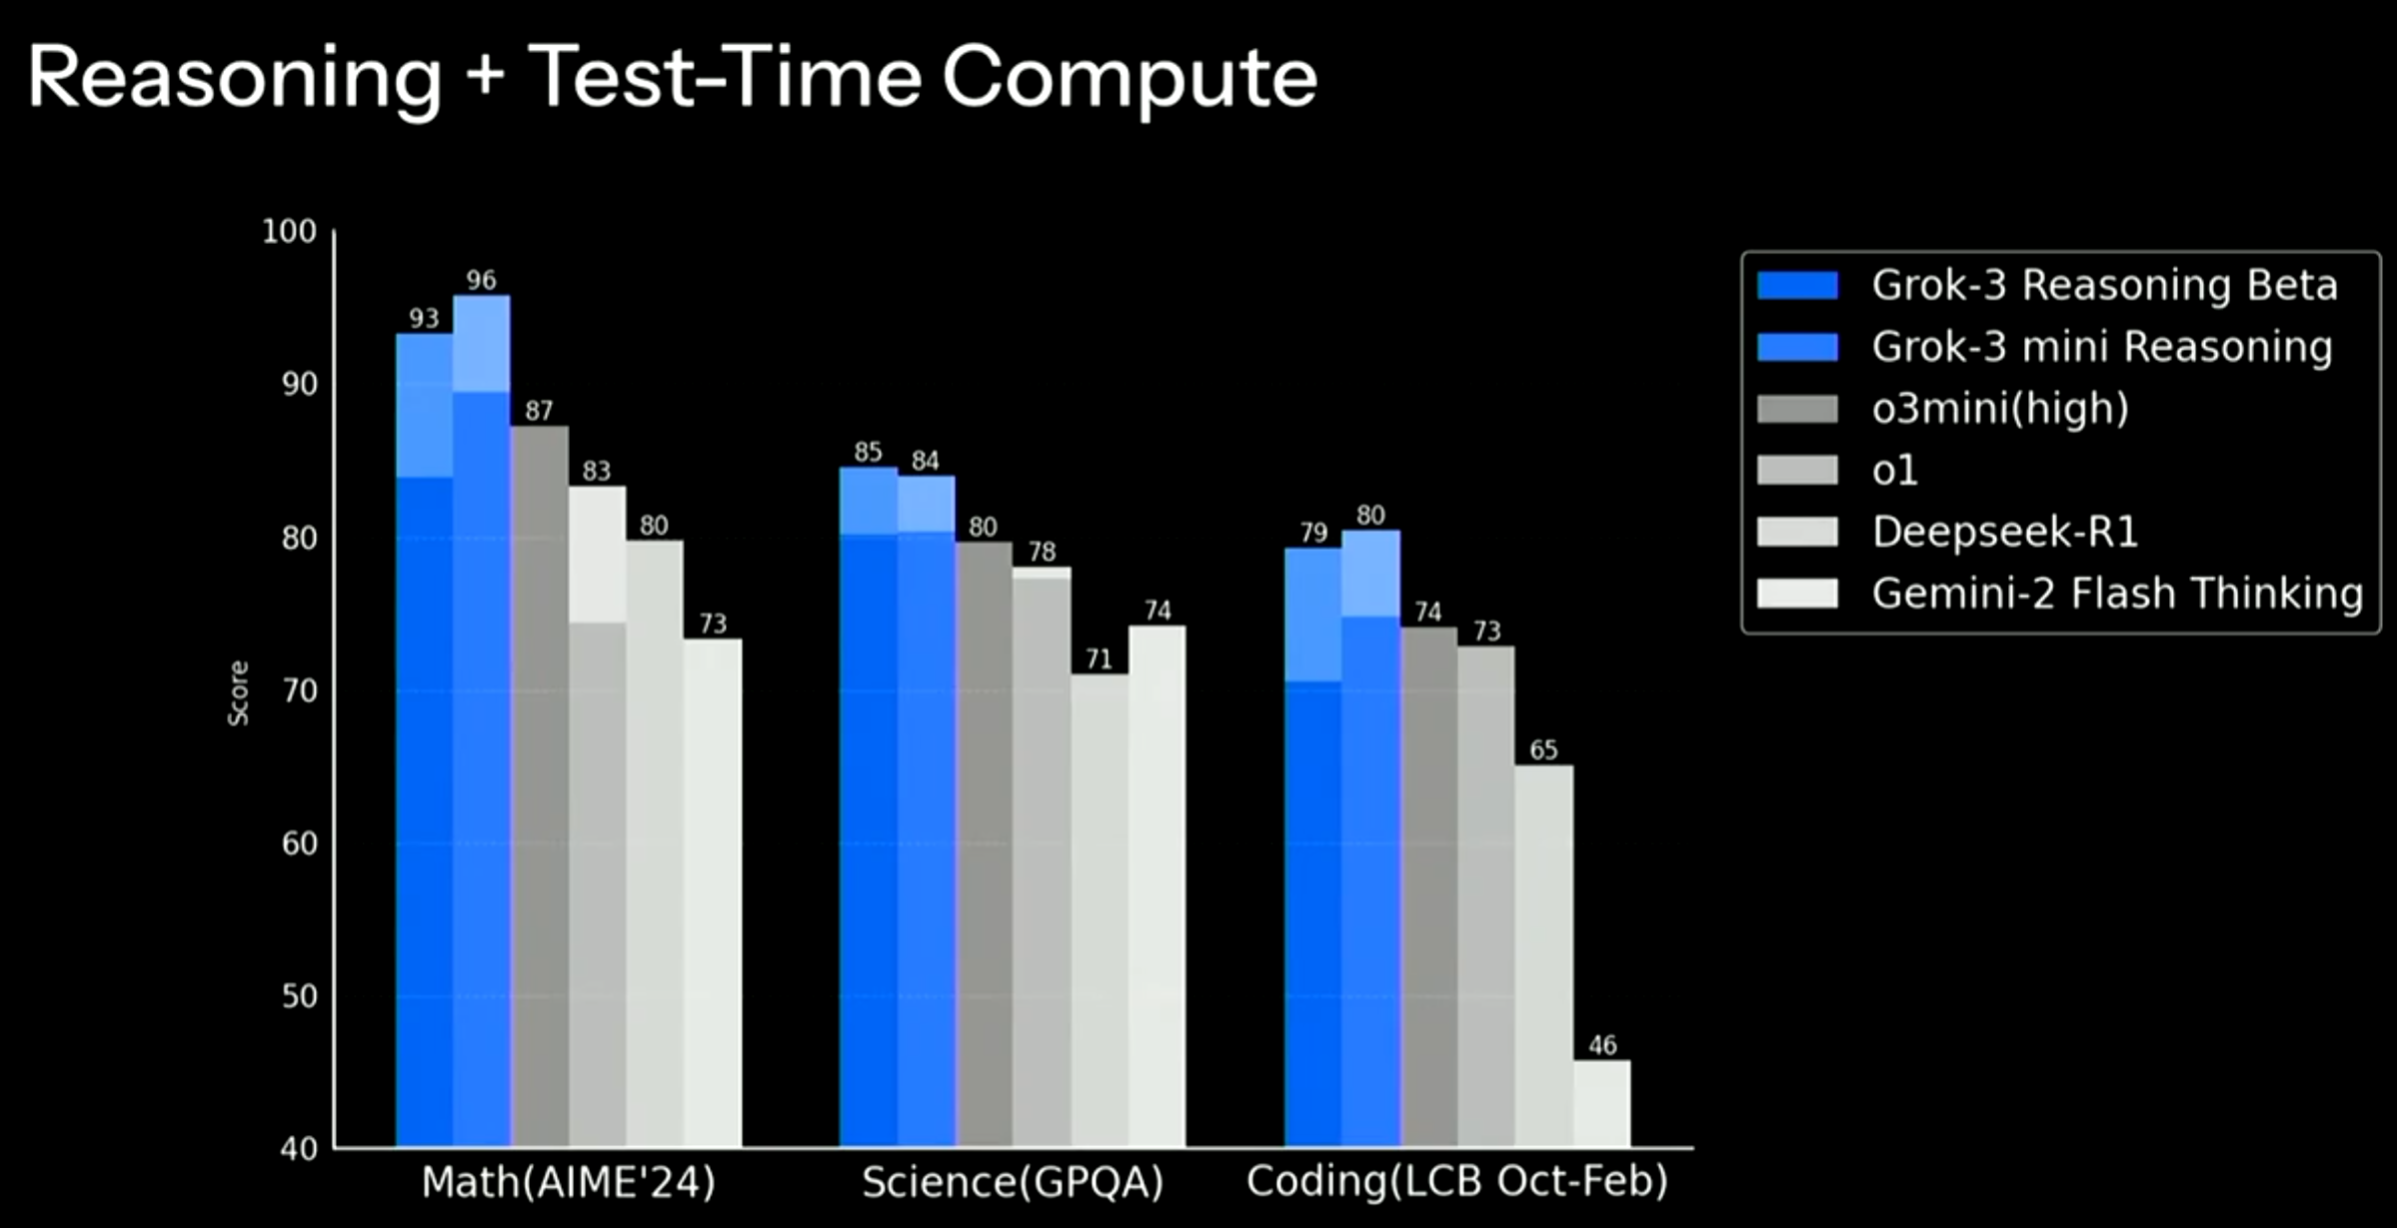
Grok3发布!马斯克旗下大模型企业xAI发布Grok3、Grok3-mini,支持Deep Research、语音交互和“思考”模式的推理大模型,推理模式评测结果全球最强
今天马斯克旗下的xAI公司发布了最新一代大语言模型Grok3,基于20万张GPU集群训练,各方面的提升都非常明显。在主流评测上都超过了现有的大模型。
Qwen Code介绍和使用:阿里开源的命令行AI编程助手,免费开源,支持最高100万的上下文!
阿里巴巴的 Qwen Code 是一款开源的命令行 AI 工具,旨在提升开发者的编程效率,特别适用于处理大型代码库和复杂的开发任务。 2025年8月9日,阿里宣布提供每天2000次的免费Qwen Code服务,应该是满足大多数开发者的日常需求了。

百度文心一言发布,功能尝鲜概览
今天下午,百度发布了文心一言大模型。这是一次对百度来说十分重要的发布会,也几乎是国内当前唯一一家将大模型作为一种大规模的服务推向市场的公司。本文主要介绍刚刚发布的文心一眼相关的能力。