
Bloomberg发布的最新的memray——Python内存分析器是什么?
Bloomberg在2022年4月开源了Memray,这是一个Python的内存分析器。它可以跟踪Python代码、本地扩展模块和Python解释器本身的内存分配情况。可以看numpy和pandas的运行内存使用。
探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。
Bloomberg在2022年4月开源了Memray,这是一个Python的内存分析器。它可以跟踪Python代码、本地扩展模块和Python解释器本身的内存分配情况。可以看numpy和pandas的运行内存使用。
零一万物(01.AI)是由李开复在2023年3月份创办的一家大模型创业企业,并在2023年6月份正式开始运营。在2023年11月6日,零一万物开源了4个大语言模型,包括Yi-6B、Yi-6B-200K、Yi-34B、Yi-34B-200k。模型在MMLU的评分上登顶,最高支持200K超长上下文输入,获得了社区的广泛关注。
文本embedding是当前大模型应用中一个十分重要的角色。在长上下文支持、私有数据问答等方面有非常重要的应用。但是相比较开源领域快速发布的大模型节奏,开源的embedding模型和数据却非常少。今天,GPT4All宣布在其软件中增加embedding的支持,这是一个完全免费且可商用的产品,最重要的是可以在我们本地用CPU来做推理。

最近这几天,如果你的 X (Twitter) 首页被 Clawdbot 刷屏了,不用惊讶,主要是太火了。但是这个软件的使用有一定门槛,而且争议比较大。X上有一位博主分享了他对这个东西的看法和使用经验,挺详细的,对于想了解Clawdbot是啥的,这个文章不错。大家看也可以从这个文章看到Clawdbot能做什么,和Cowork对比有啥优点和缺点
自从苹果发布M1系列的自研芯片开始,基于ARM架构的电脑处理器开始大放异彩。而强大的M1芯片的能力也让很多Mac用户高兴很久。而就在现在,M1也开始支持PyTorch的深度学习框架了。PyTorch官网刚刚宣布,经过和Apple的Metal工程师队伍的合作,PyTorch支持Mac的GPU加速了。
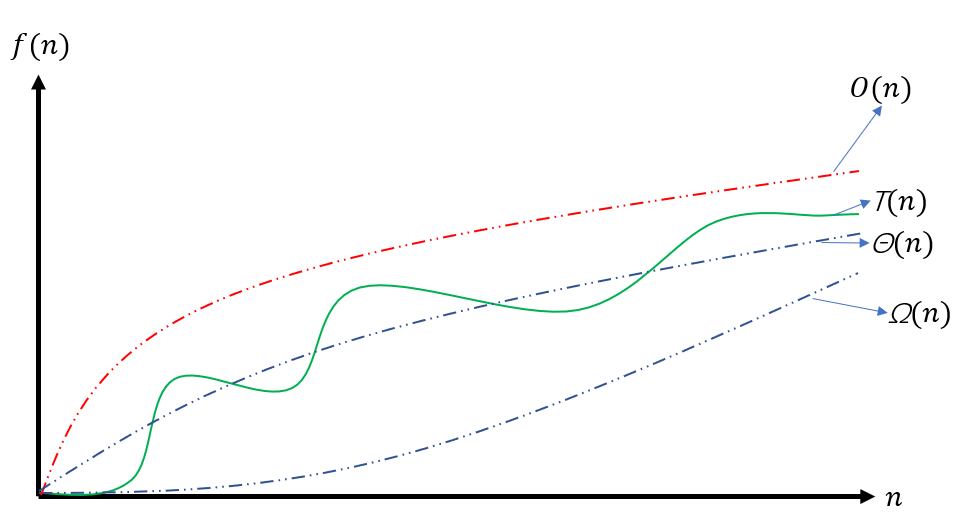
在程序设计和编程中,我们经常会看到关于时间复杂度的讨论。比如为什么A方法比B方法好?是因为A方法的时间复杂度低。那么,这里的时间复杂度如何去理解,又怎么计算呢?常见的O(n)的含义是什么?本文将简单的解释这个概念。

自从2019年OpenAI开始商业化以来,OpenAI的成果越来越封闭,而商业化的进程越来越快。GPT系列的发展正好印证了这个路径。GPT最初的版本包含了论文、代码和预训练结果。GPT-2刚开始也认为可能会造成不好的伤害而在论文官宣了大半年之后才公布了完整模型。到GPT-3的时候也就给了官方介绍博客和论文,模型则是彻底闭源且开始商业化。而今天OpenAI直接官方博客宣布GPT-3.5商业化,连论文都没有了!
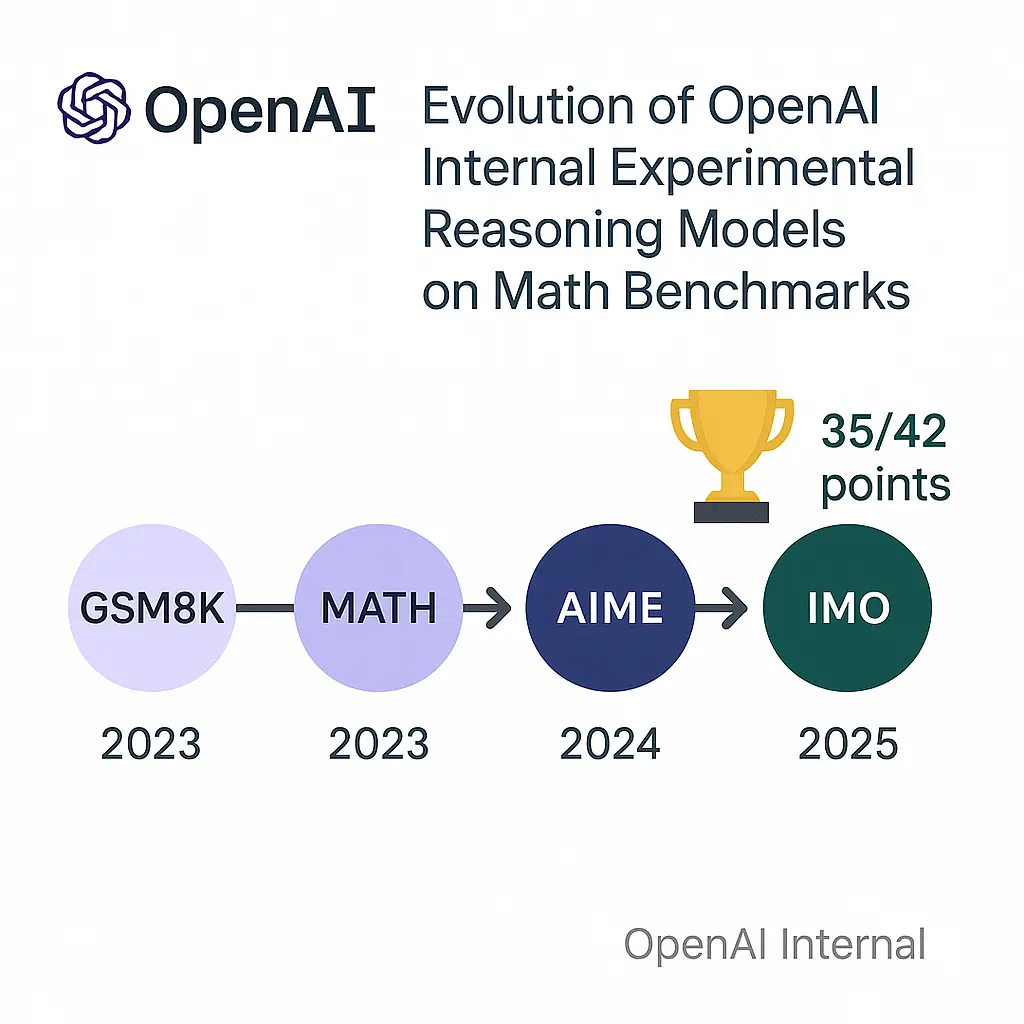
几个小时前,OpenAI的研究人员披露,其一款内部实验性的大语言模型,在模拟的国际数学奥林匹克(International Math Olympiad ,IMO)竞赛2025中取得了金牌水平的成绩。这是一个里程碑式的突破,因为IMO被认为是衡量创造性数学推理能力的巅峰,远超以往任何AI基准测试。这项成就并非通过专门针对数学的“窄”方法实现,而是源于通用人工智能研究的根本性突破,尤其是在处理难以验证的任务和长时间推理方面。
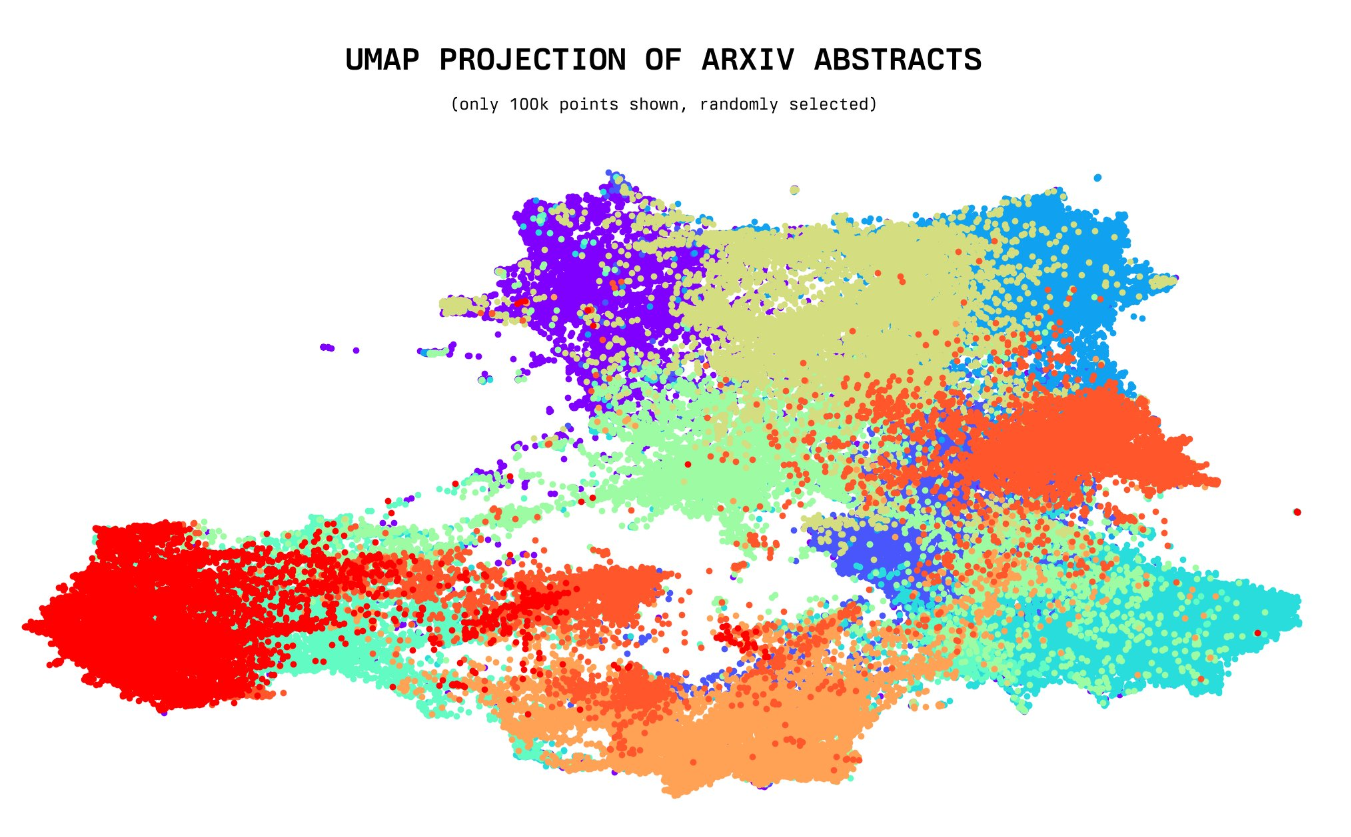
今天,一位年仅20岁的小哥willdepue 开源了230万arXiv论文的标题和摘要的embedding向量数据集,完全开源。该数据集包含截止2023年5月4日的所有arXiv上的论文标题和摘要的embedding结果,使用的是开源的Instructor XL抽取。未来将开放更多其它相关数据的embedding结果
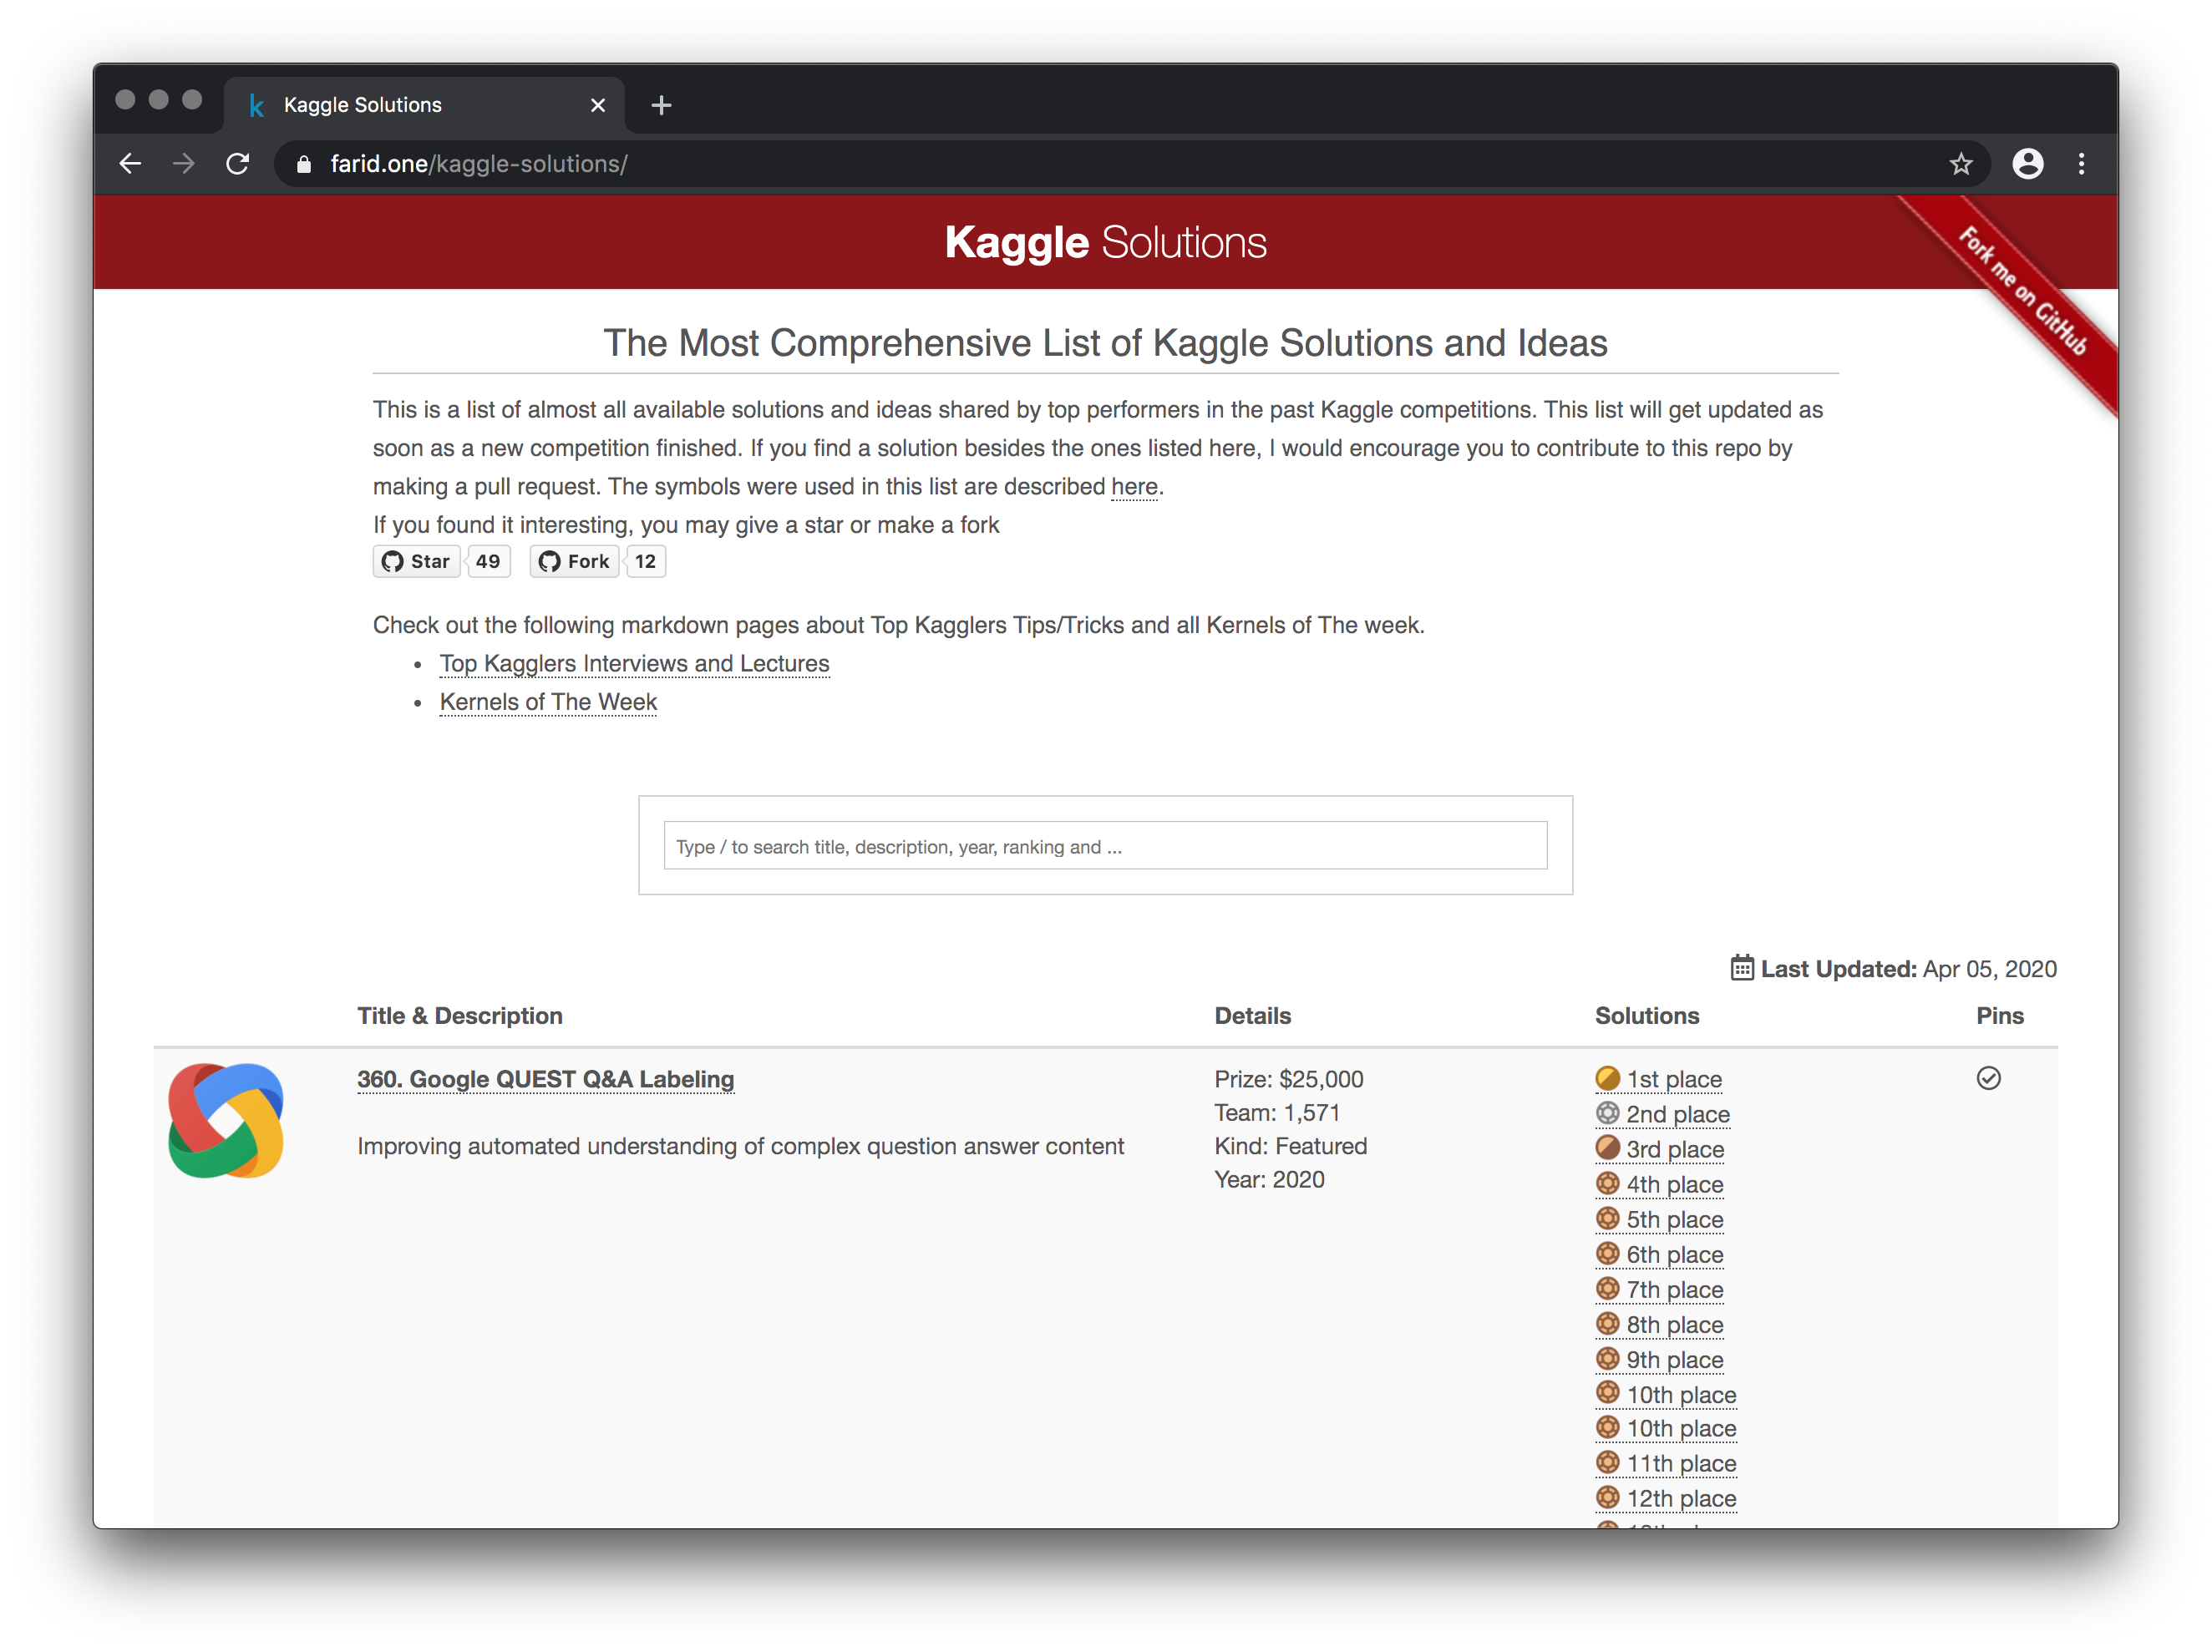
这是一位热心网友(faridrashidi)收集的Kaggle竞赛的解决方案。这是在过去的Kaggle竞赛中表现最好的选手所分享的几乎所有可用的解决方案和想法的列表。一旦有新的比赛结束,这个列表就会更新。
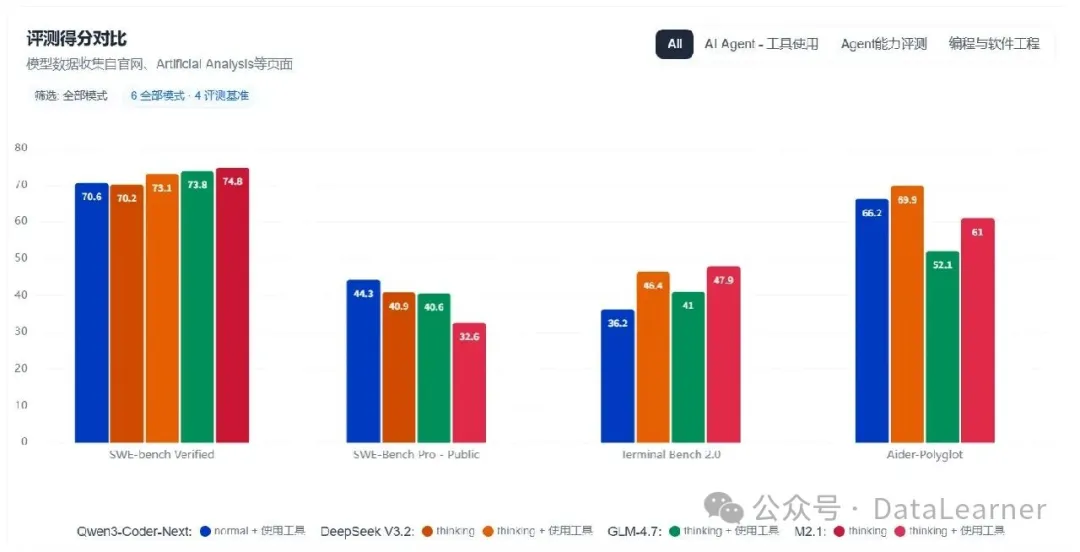
阿里开源了全新一代编程大模型Qwen3-Coder-Next,该模型是基于Qwen3-Next-80B-A3B-Base模型后训练得到,总参数规模800亿,激活参数仅30亿。也就是说,这个模型的推理速度基本和3B这种小规模参数差不多,但是它的评测结果,特别是在编程方面的评测与DeepSeek V3.2的水平差不多。
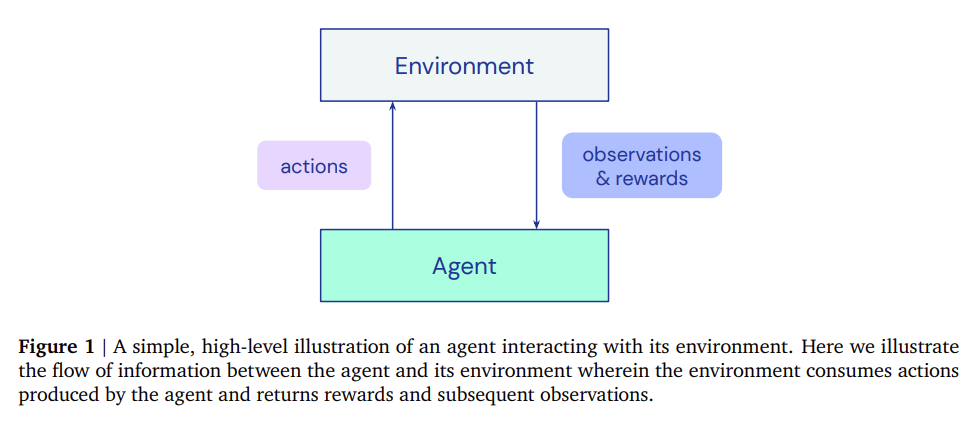
深度强化学习(RL)导致了许多最近的和突破性的进展。然而,强化学习的实施并不容易,与使深度学习拥有PyTorch这样简单的框架支持不同,强化学习的训练缺少强有力的工具支撑。为了解决这些问题,DeepMind发布了Acme,一个用于构建新的RL算法的框架,该框架是专门为实现代理而设计的
随着华为被美国多轮制裁,大家忽然发现原来国内在半导体硬件方面的差距居然如此之大。半导体硬件相关方面的关注度前所未有,为了更好地理解计算机运行的原理,本文翻译自耶鲁大学的PCLT网站,旨在介绍关于计算机运行的一些原理知识。
今天Google发布了TensorStore,这是一个开源的C++和Python软件库,设计用于存储和操作大规模n维数据。TensorStore已经被用来解决科学计算中的关键工程挑战(例如,管理和处理神经科学中的大型数据集,如石油级的三维电子显微镜数据和神经元活动的 "4d "视频)。TensorStore还被用于创建大规模的机器学习模型,如PaLM,解决了分布式训练期间管理模型参数(检查点)的问题。

7月28日,智谱AI(Zhipu AI)向开源社区投下了一枚重磅炸弹,正式发布了其最新的旗舰模型系列:GLM-4.5。该系列包含两个新成员——GLM-4.5和GLM-4.5-Air,两者均以开源权重形式提供。官方技术报告详细阐述了其设计理念、技术细节以及在多项基准测试中的表现。本次发布的核心目标是打造一个能够统一推理、代码和Agent智能体能力的模型,以应对日益复杂的AI应用需求。本文将深入解析这份官方报告,剖析其核心技术、性能表现,并探讨其在当前大模型竞争格局中的战略定位。
OpenAI宣布发布全新的Diffusion大模型Sora,这是一个可以生成最长60秒视频的视频生成大模型,最大的特点是可以生成非常逼真的电影画面版的视频。
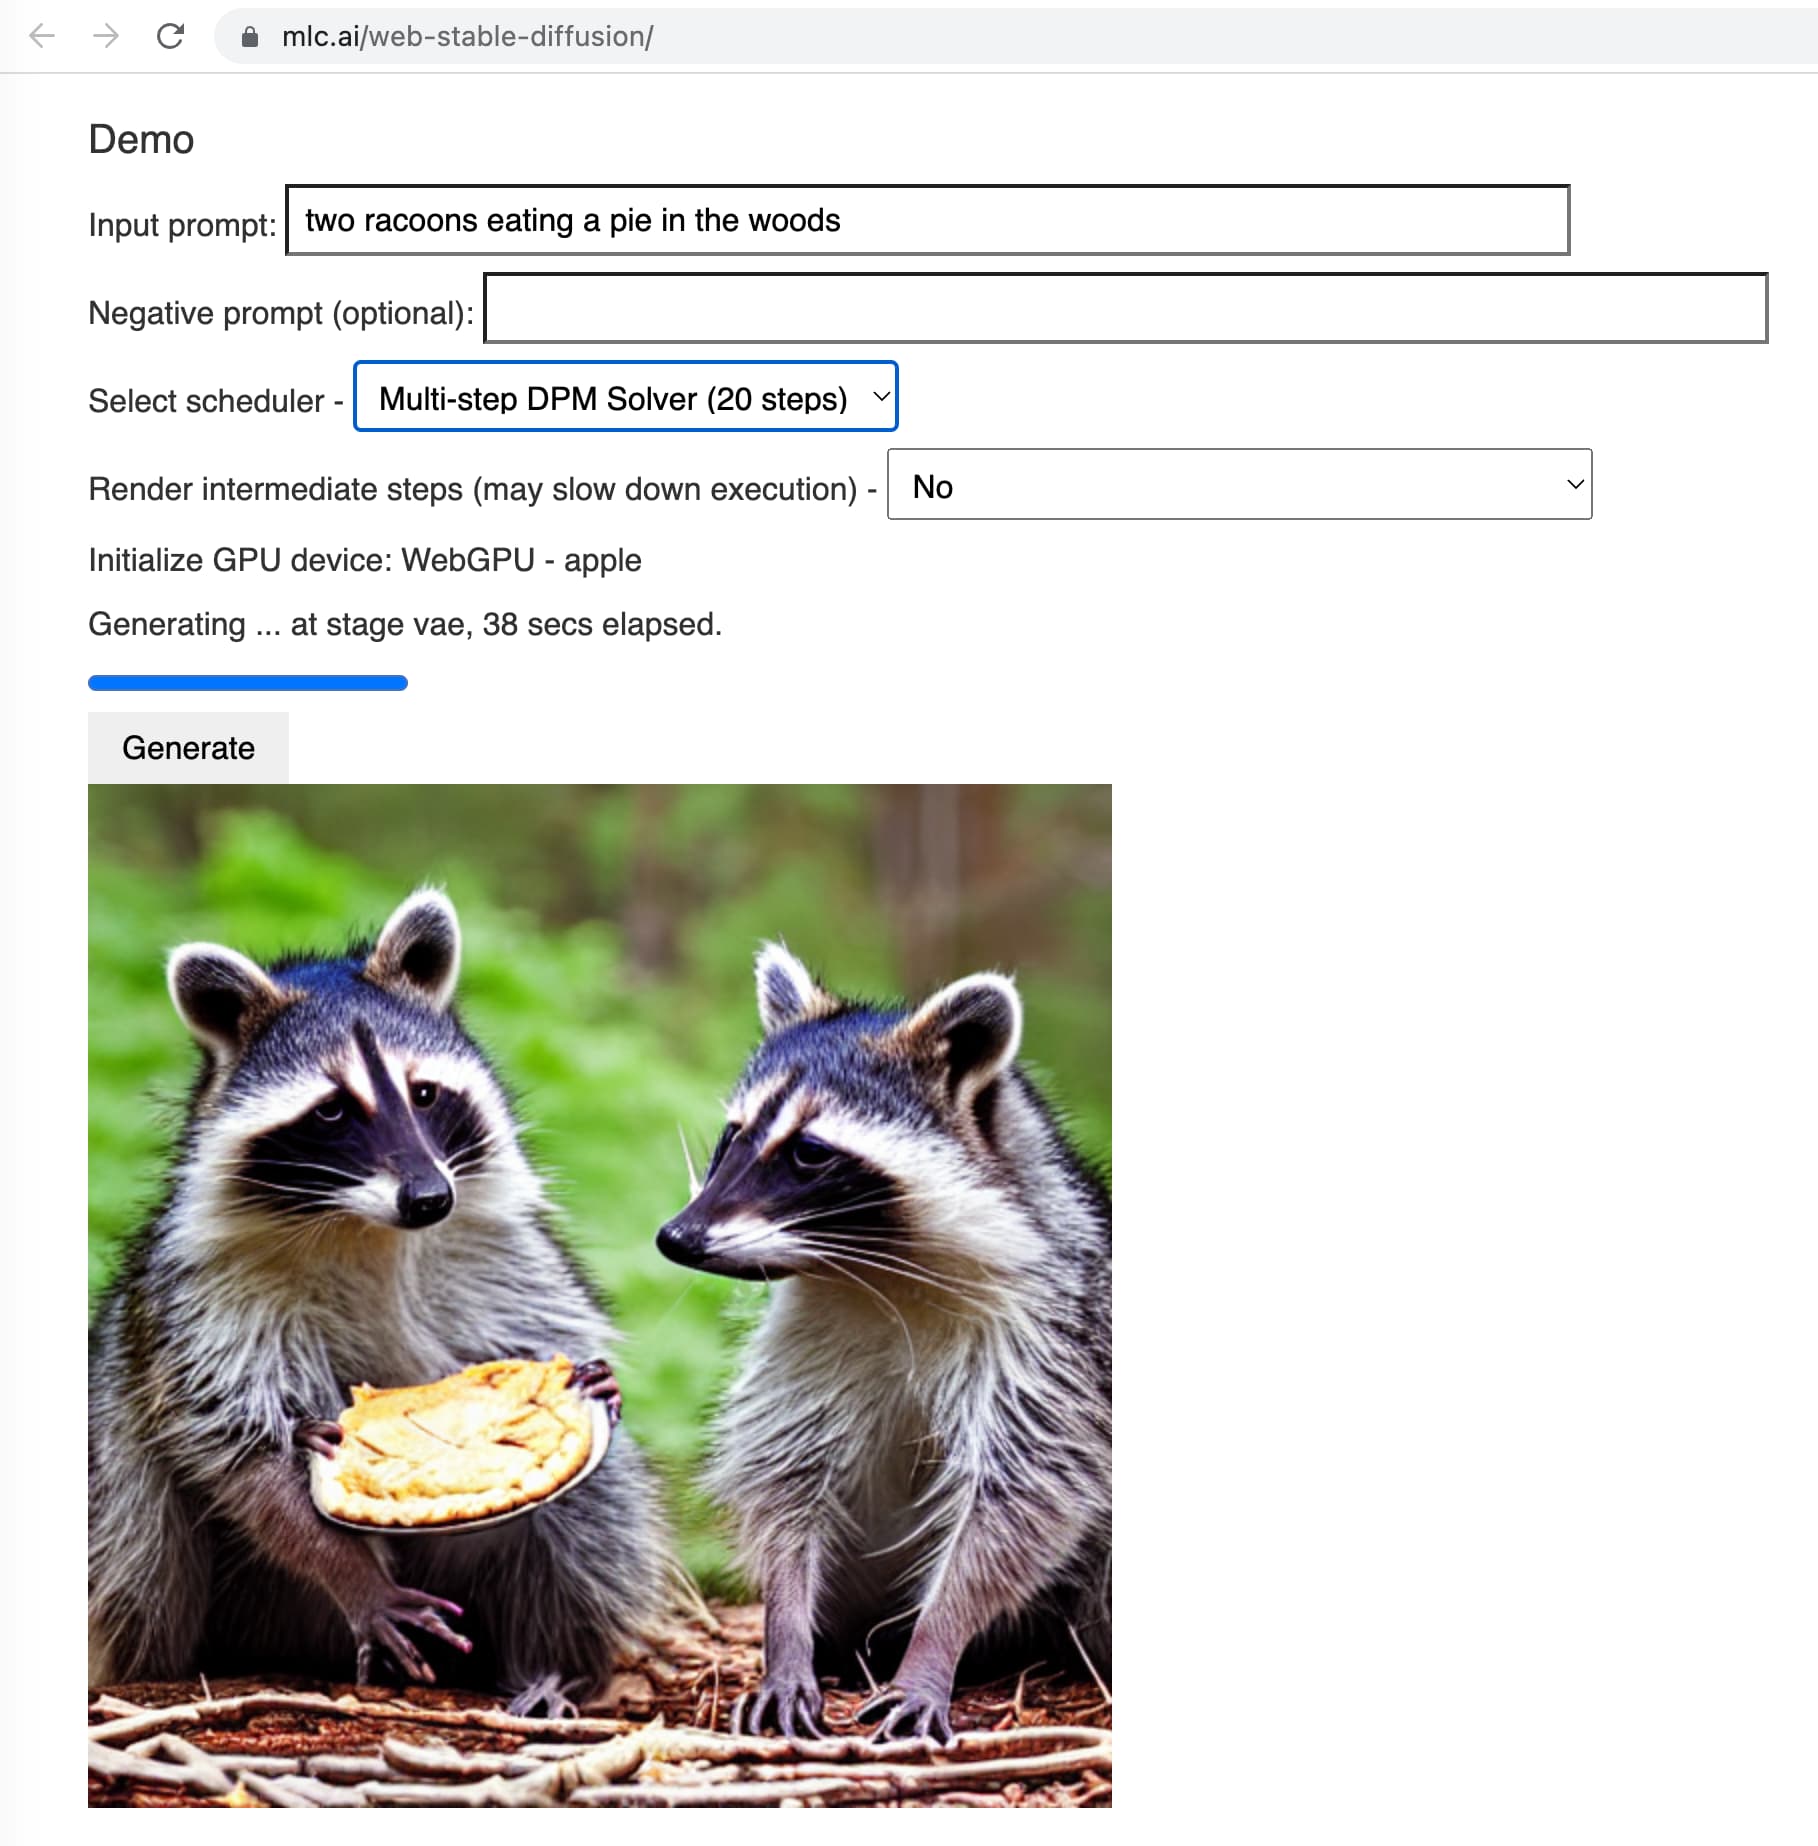
尽管当前ChatGPT和GPT-4非常火热,但是高昂的训练成本和部署成本其实导致大部分个人、学术工作者以及中小企业难以去开发自己的模型。使得使用OpenAI的官方服务几乎成为了一种无可替代的选择。本文介绍的是一种低成本开发高效ChatGPT的思路,我认为它适合一些科研机构去做,也适合中小企业创新的方式。这里提到的思路涉及了一些最近发表的成果和业界的一些实践产出,大家可以参考!
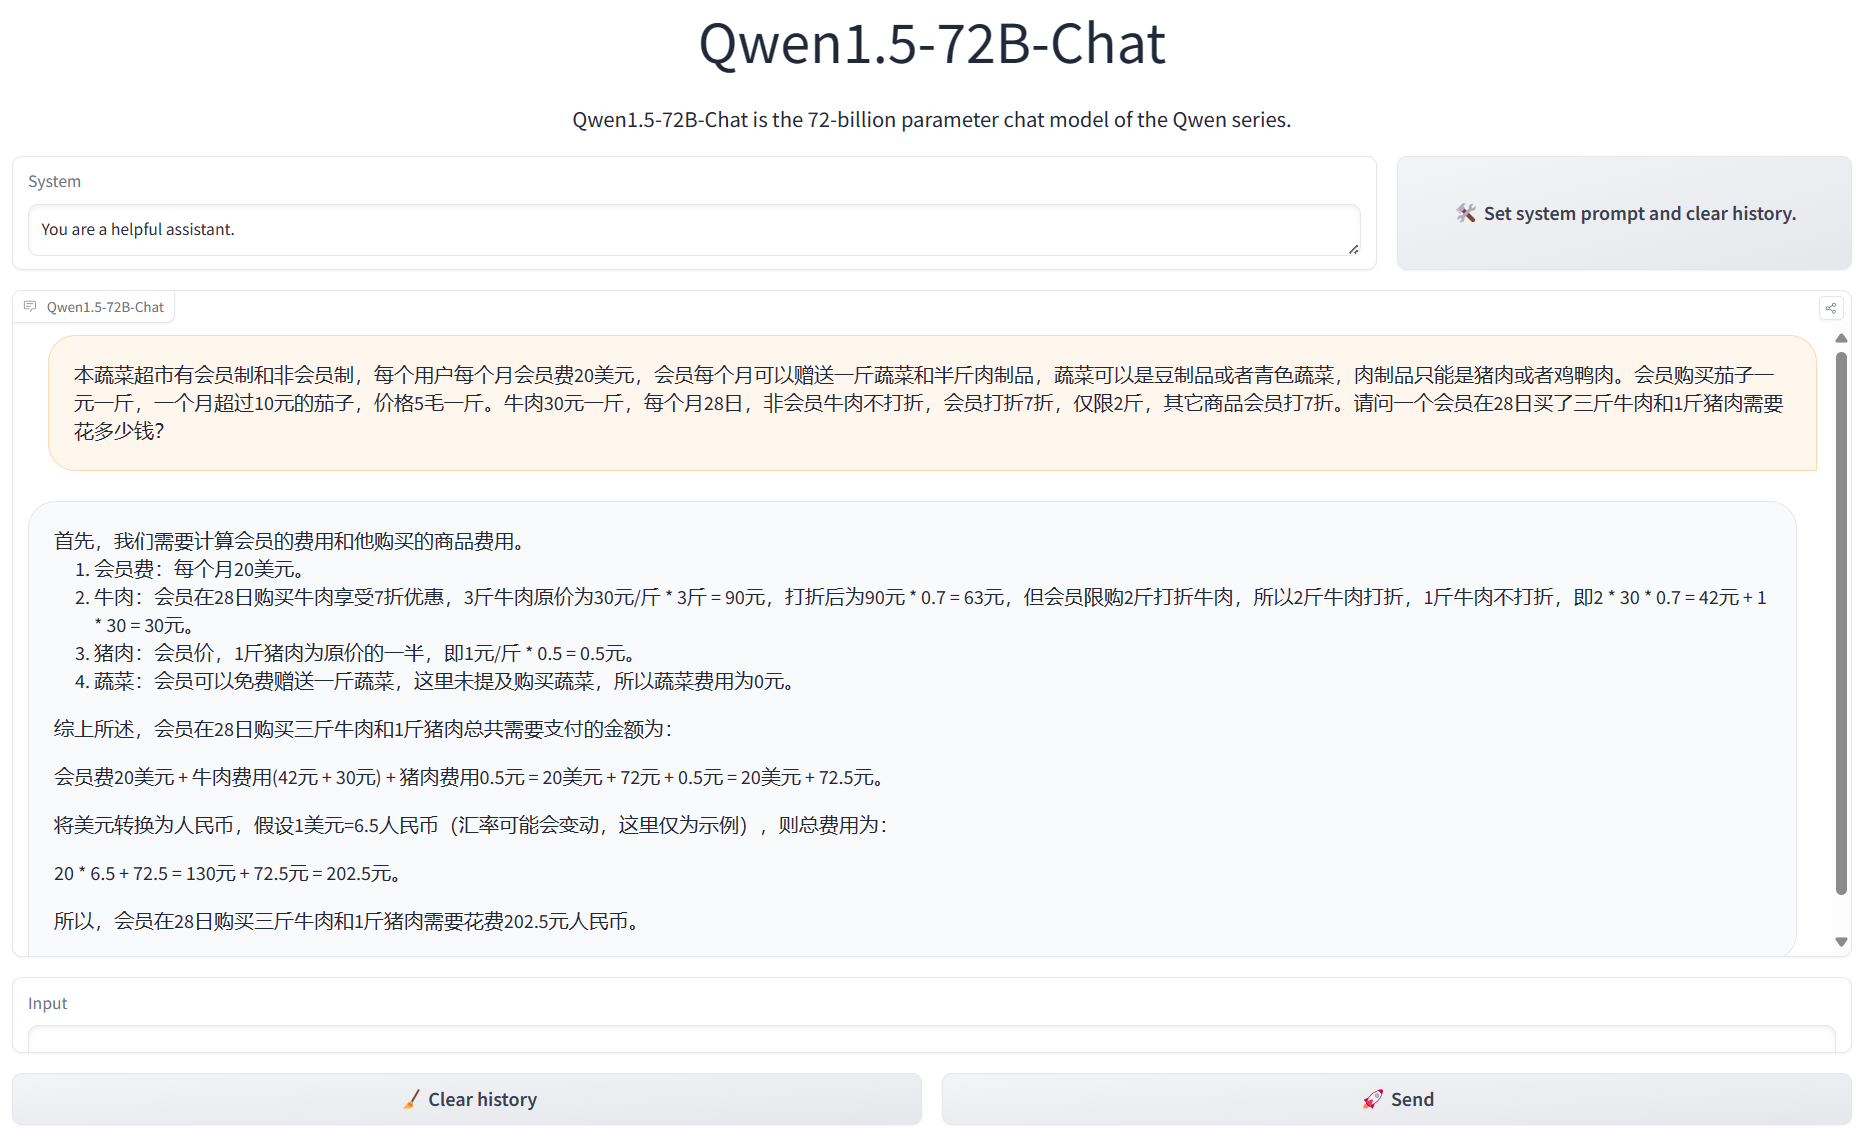
Qwen1.5系列是阿里开源的一系列大语言模型,也是目前为止最强开源模型之一。Qwen1.5是Qwen2的beta版本,此前开源的模型最大参数规模都是720亿,和第一代模型一样。就在刚刚,阿里开源了1100亿参数规模的Qwen1.5-110B模型。评测结果显示MMLU略超Llama3-70B和Mixtral-8×22B。我们实测结果,相比Qwen1.5-72B模型来说,复杂任务的逻辑提升比较明显!
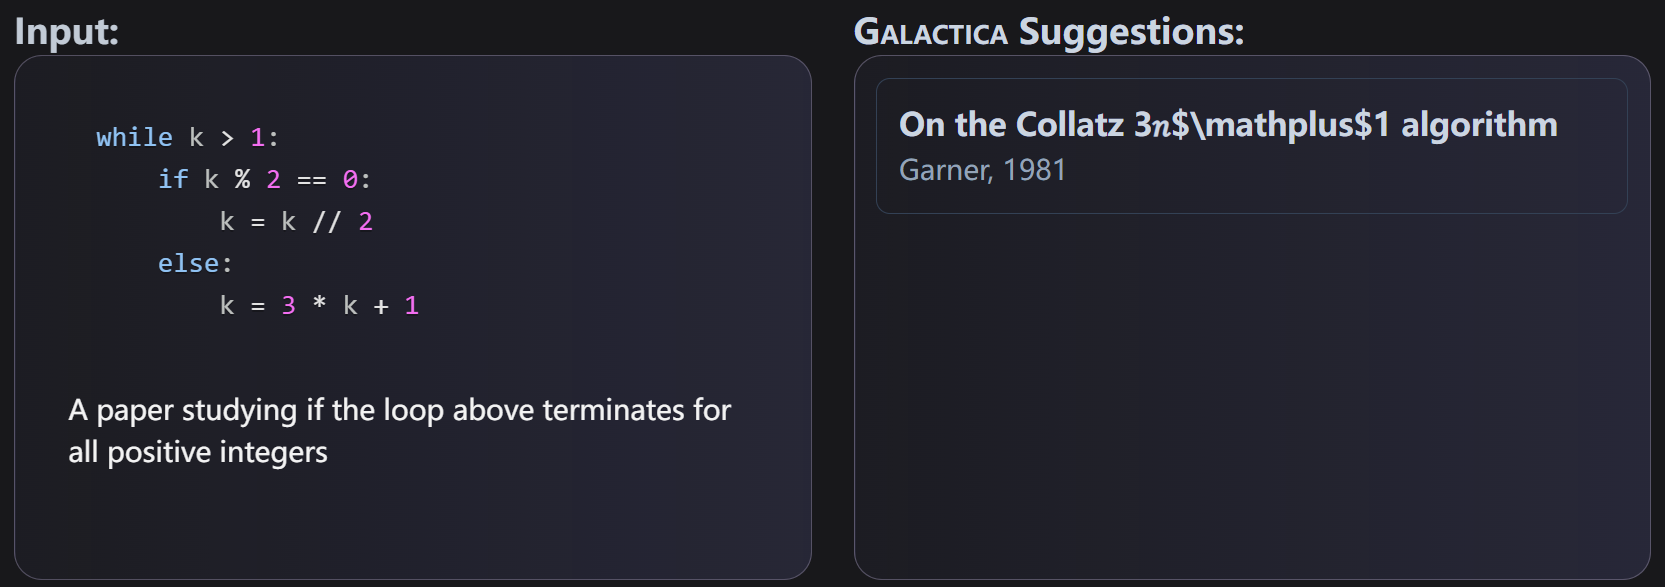
自然语言处理预训练大模型在最近几年十分流行,如OpenAI的GPT-3模型,在很多领域都取得了十分优异的性能。谷歌的PaLM也在很多自然语言处理模型中获得了很好的效果。而昨天,PapersWithCode发布了一个学术论文处理领域预训练大模型GALACTICA。功能十分强大,是科研人员的好福利!
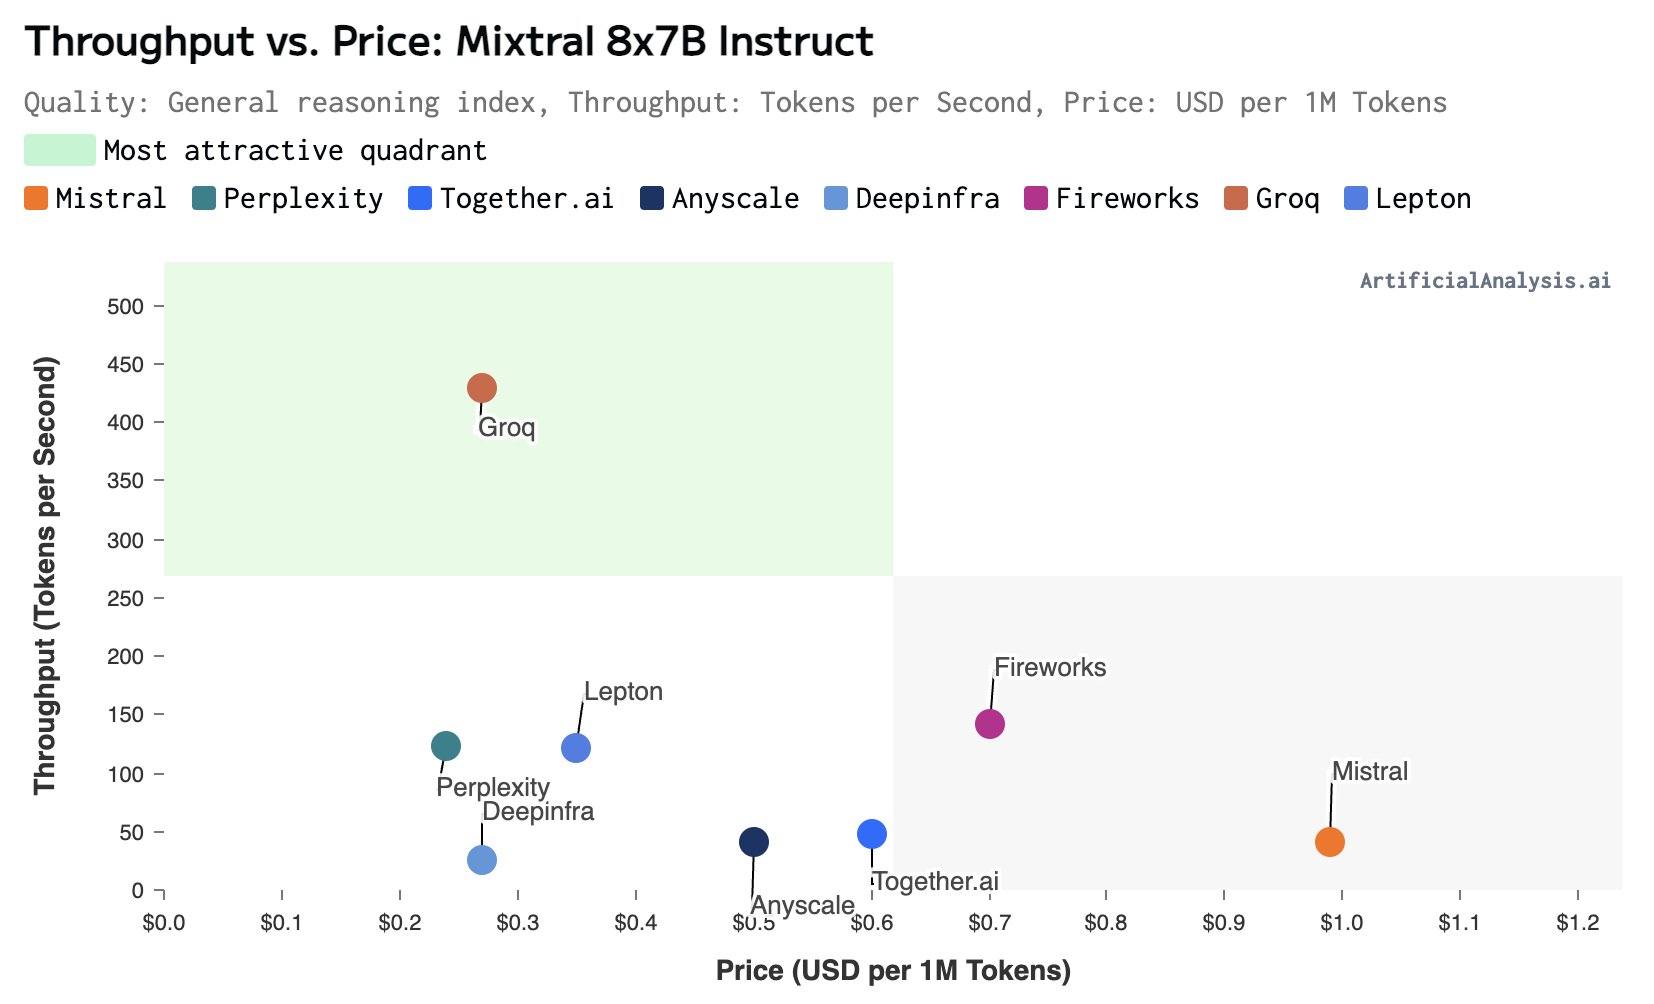
大模型的推理速度是当前制约大模型应用的一个非常重要的问题。在很多的应用场景中(如复杂的接口调用、很多信息处理)的场景,更快的大模型响应速度通常意味着更好的体验。但是,在实际中我们可用的场景下,大多数大语言模型的推理速度都非常有限。慢的有每秒30个tokens,快的一般也不会超过每秒100个tokens。而最近,美国加州一家企业Groq推出了他们的大模型服务,可以达到每秒接近500个tokens的响应速度,非常震撼。
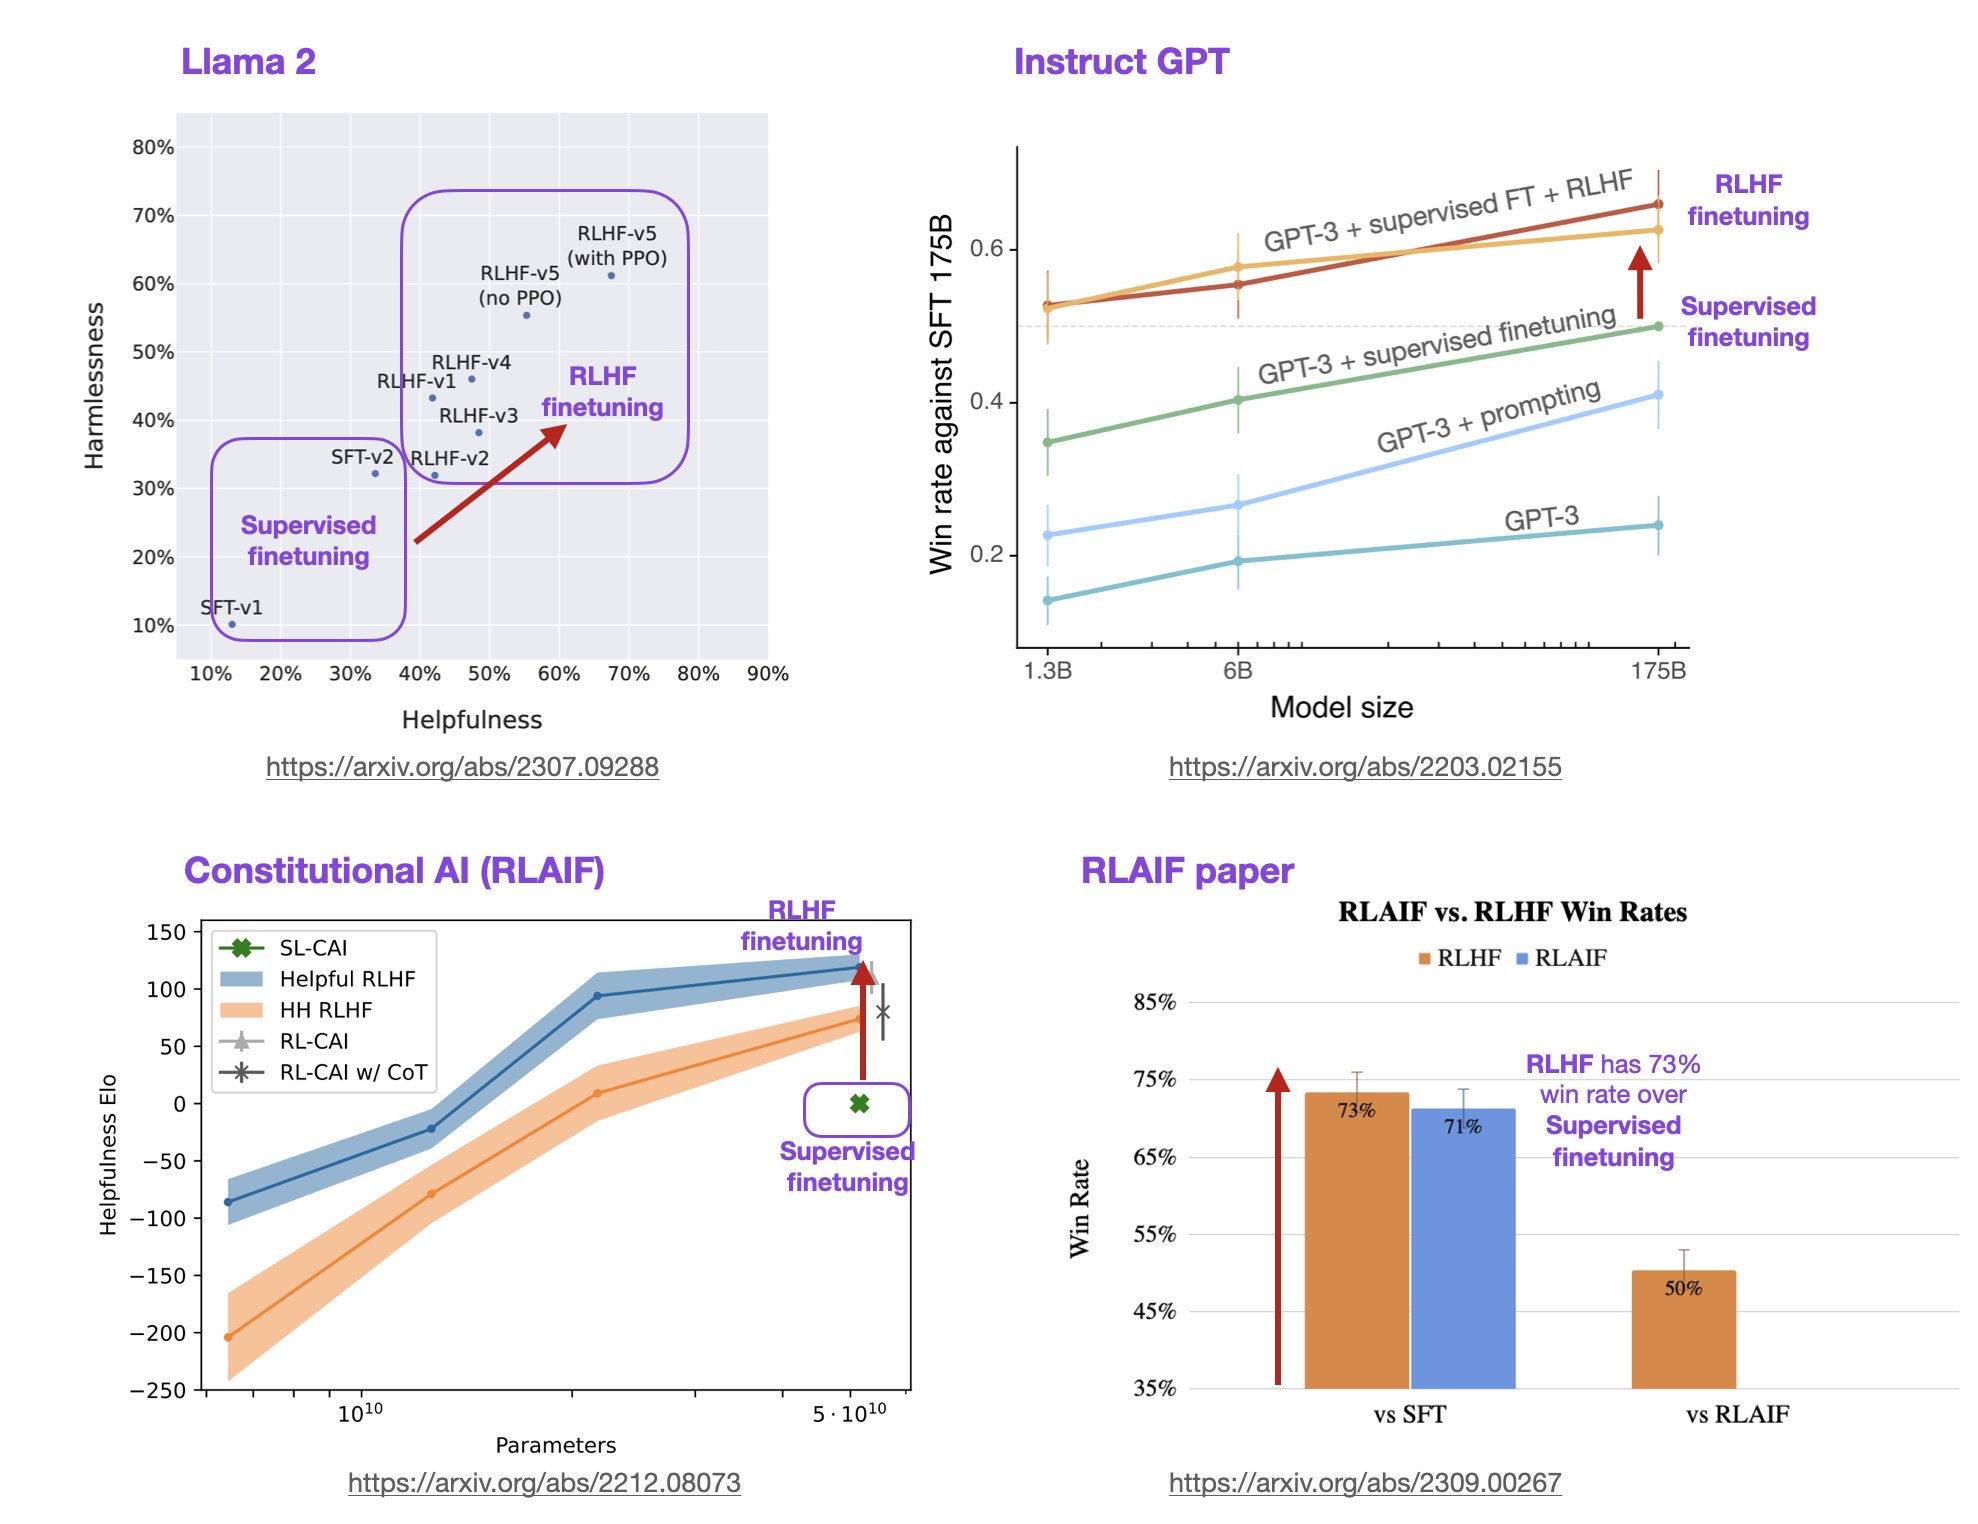
基于人类反馈的强化学习方法(Reinforcement Learning with Human Feedback,RLHF)是一种强化学习(Reinforcement Learning,RL)的变种,它利用人类的专业知识和反馈来指导机器学习模型的训练和决策过程。这种方法旨在克服传统RL方法中的一些挑战,例如样本效率低、训练困难和需要大量的试错。在大语言模型(LLM)中,RLHF带来的模型效果提升不仅仅是模型偏好与人类偏好的对齐,模型的理解能力和效果也会更好。
检索增强生成(Retrieval-augmented Generation,RAG)是一种结合了检索和大模型生成的方法。它从一个大型知识库中检索与输入相关的信息,然后利用这些信息作为上下文和问题一起输入给大语言模型,并让大语言模型基于这些信息生成答案的方式。检索增强生成可以让大语言模型与最新的外部数据或者知识连接,进而可以基于最新的知识和数据回答问题。尽管检索增强生成是一种很好的补充方法,但是,如果文档切分有问题、检索不准确,结果也是不好的。
Kimi K2是由Moonshot AI最新推出的旗舰级大模型,首次将开放Agentic Intelligence(自主代理智能)与强大工具调用能力有机整合。它不仅在知识推理、数学、代码等传统“非思维模型”任务上展现出全球领先的能力,还特别针对一系列实际Agentic(自动决策与操作型)任务进行了深度优化。在业内,这代表AI模型正从“只会答题”向“能自主完成复杂任务”转变。K2模型完全开源,可免费商用授权。
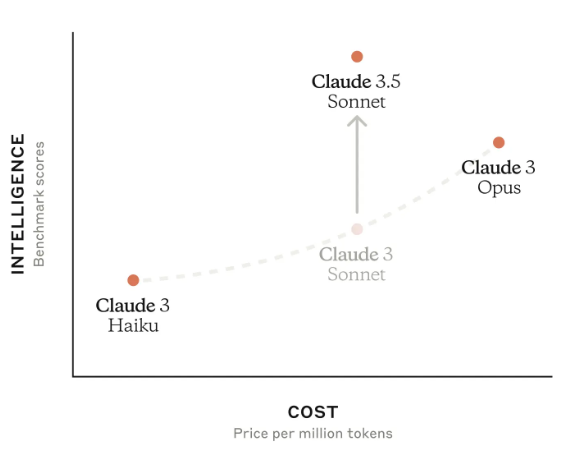
Claude系列模型是Anthropic发布的大模型,一直被认为是最接近GPT-4系列的大模型。2024年3月份,Anthropic发布了Claude3系列,从各方的使用情况看,都接近甚至超过了GPT-4。时隔三个月,Anthropic再次发布全新3.5版本的Claude3.5系列。本次首先发布的是Claude3.5-Sonnet版本。已经支持免费使用。