

原创博客
原创AI技术博客
探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。
重磅!来自Google内部AI研究人员的焦虑:We Have No Moat And neither does OpenAI
5月4日,网络流传了一个所谓Google内部人员写的内部信,表达了Google和OpenAI这样的公司可能并不能在AI领域获得胜利的焦虑。里面说明了开源的AI模型发展迅速,不管是Google还是OpenAI都没有很好的护城河。
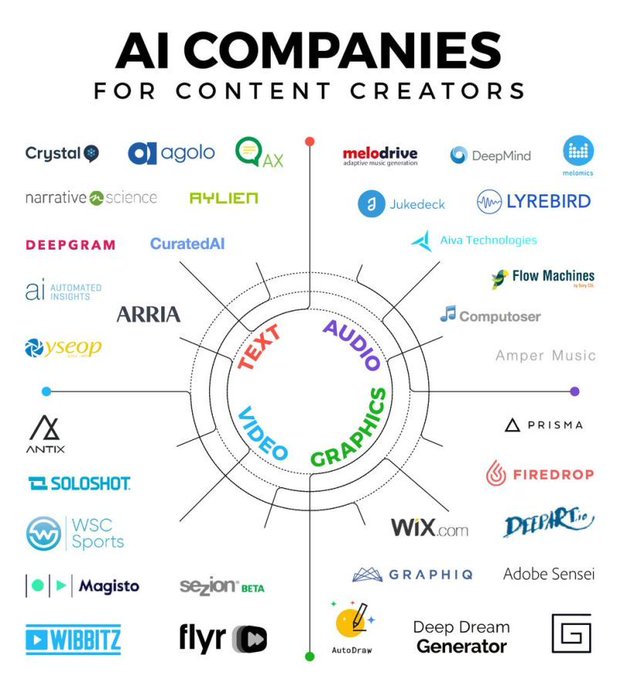
内容生成方向的人工智能企业
文本生成的主要目的是基于报表和分析生成总结性的文字以辅助商业决策,也就是NLG(Natural Language Generation)。主要的方向包括:基于图表生成洞察报告、基于数据与图表支持问答系统等。本文介绍文字生成的方案提供商。
如何微调大语言模型?吴恩达联合LaminiAI最新一个小时短课教会大模型微调!这次是面向中级水平人员~
当谈及人工智能的巨大进步,大模型的崛起无疑是其中的一个重要里程碑。这些大模型,如GPT-3,已经展现出令人惊叹的语言生成和理解能力,但是为了让它们在特定任务上发挥最佳性能,大模型微调(Fine-tuning)是一种非常优秀的方法。微调是一种将预训练的大型模型进一步优化,以适应特定任务或领域的过程。但微调并不是很简单,今天吴恩达联合Lamini推出了全新的大模型微调短课《Finetuning Large Language Models》。
Awesome ChatGPT Prompts——一个致力于提供挖掘ChatGPT能力的Prompt收集网站
Awesome ChatGPT Prompts是由JavaScript开发者Fatih Kadir Akın创建的一个网站和应用,里面收集了160多个关于ChatGPT的Prompt模板,可以让ChatGPT变成Linux终端、JavaScript控制台、Excel页面等。这些Prompts收集自优秀的实践案例。
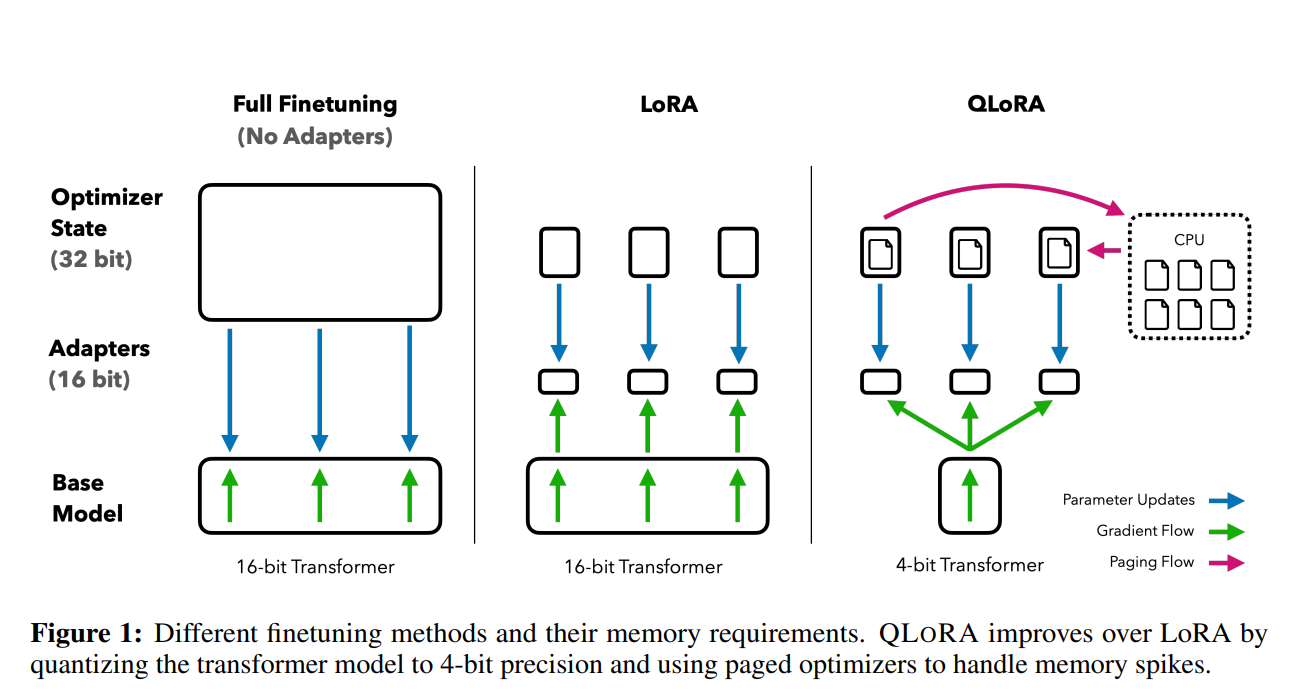
华盛顿大学提出QLoRA及开源预训练模型Guanaco:将650亿参数规模的大模型微调的显存需求从780G降低到48G!单张显卡可用!
前段时间,康奈尔大学开源了LLMTune框架(https://www.datalearner.com/blog/1051684078977779 ),这是一个可以在48G显存的显卡上微调650亿参数的LLaMA模型的框架,不过它们采用的方法是将650亿参数的LLaMA模型进行4bit量化之后进行微调的。今天华盛顿大学的NLP小组则提出了QLoRA方法,依然是支持在48G显存的显卡上微调650亿参数的LLaMA模型,不过根据论文的描述,基于QLoRA方法微调的模型结果性能基本没有损失!
《Effective Java 第三版》笔记之二 当构造参数很多的时候考虑使用builder
本文是Effective Java第三版笔记的第二个之当构造参数很多的时候考虑使用builder
让大模型支持更长的上下文的方法哪个更好?训练支持更长上下文的模型还是基于检索增强?
在大语言模型中,上下文长度是指模型可以考虑的输入数据的数量。更长的上下文在大语言模型的实际应用中有非常重要的价值。当前,让大语言模型支持更长的上下文有两种常用的方法,一种是训练支持更长上下文长度的模型,扩展模型的输入,另外一种是检索增强生成的方法(Retrieval Augmentation Generation,RAG)。但二者应该如何选择,这是一个很少能直接比较的问题。为此,英伟达(Nvidia)的研究人员做了一个详细的比较。
OpenAI官方Prompt教程:如何让ChatGPT扮演不同角色,完成教学任务
Prompt技巧一直是提升ChatGPT等大语言模型使用效率的最重要方法之一。为此,OpenAI官方也在不断地分享官方的Prompt技巧。2023年的8月31日,OpenAI官方最新分享了一个教室使用的Prompt来帮助老师授课的案例。尽管这是针对老师的Prompt教程,但是其中的设计思路其实也可以广泛运用在客服、问答系统、编程等领域。
全球主要开源组织概述
开源软件在现代互联网技术的发展中扮演者重要的作用。很多技术的进步和发展都是由开源软件推动的。而开源软件的发展离不开背后强大的开源组织的管理。本文列举最著名的五个开源组织,简述其背景,欢迎大家阅读。
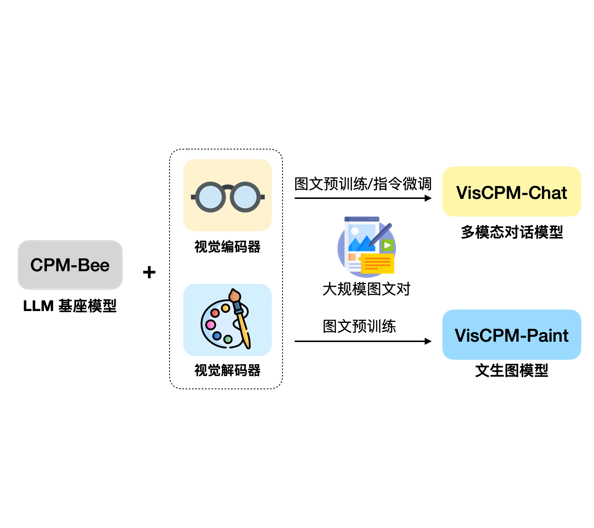
国产大模型进展神速!清华大学NLP小组发布顶尖多模态大模型:VisCPM,支持文本生成图片与多模态对话,图片理解能力优秀!
大模型的发展正在从单纯的语言模型向多模态大模型快速发展。尽管GPT-4号称也是一个多模态大模型,但是受限于GPU资源,GPT-4没有开放任何多模态的能力(参考:https://www.datalearner.com/blog/1051685866651273 )。目前大家所能接触到的多模态大模型很少。今天,清华大学NLP小组带来了新的选择,发布了VisCPM系列多模态大模型。VisCPM系列包含2类多模态大模型,分别针对多模态对话和文本生成图片进行优化。
重磅!谷歌开源Gemini同源技术大模型Gemma,分别为70亿参数和20亿参数,同等规模参数评测极其优秀!
Google Gemini是谷歌最新推出的和OpenAI竞争的大语言模型。尽管Gemini褒贬不一,但是Gemini模型的影响力是巨大的。而现在更加令人激动的是谷歌开源了2个新的不同参数规模的模型,分别是Gemma 7B和Gemma 2B,其技术与Gemini模型一致。但是这两个开源模型完全公开,可以商用授权。
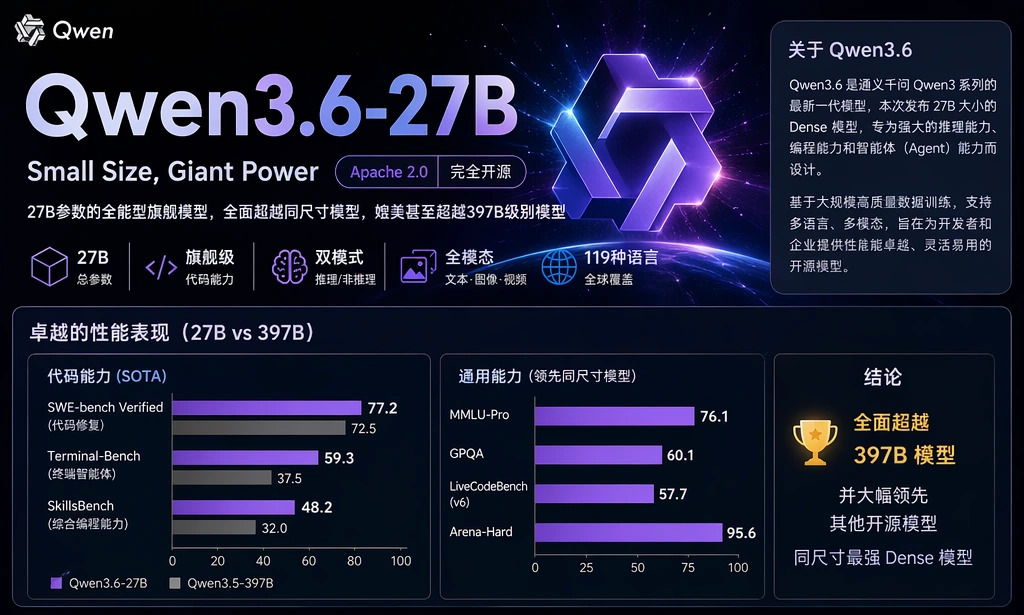
阿里正式开源Qwen3.6-27B:代码智能体能力上超越全面超越前代旗舰版本之 Qwen3.5-397B-A17B
Qwen3.6-27B 于2026年4月22日发布,是首个在全主要代码智能体评测上超越 Qwen3.5-397B-A17B 的开源稠密27B模型。SWE-bench Verified 77.2、Terminal Bench 2.0 59.3、SkillsBench 48.2(前代30.0)、AIME 2026 94.1(全球第4)。本文结合 DataLearner 评测数据与官方基准,分析其实质进展与能力边界。
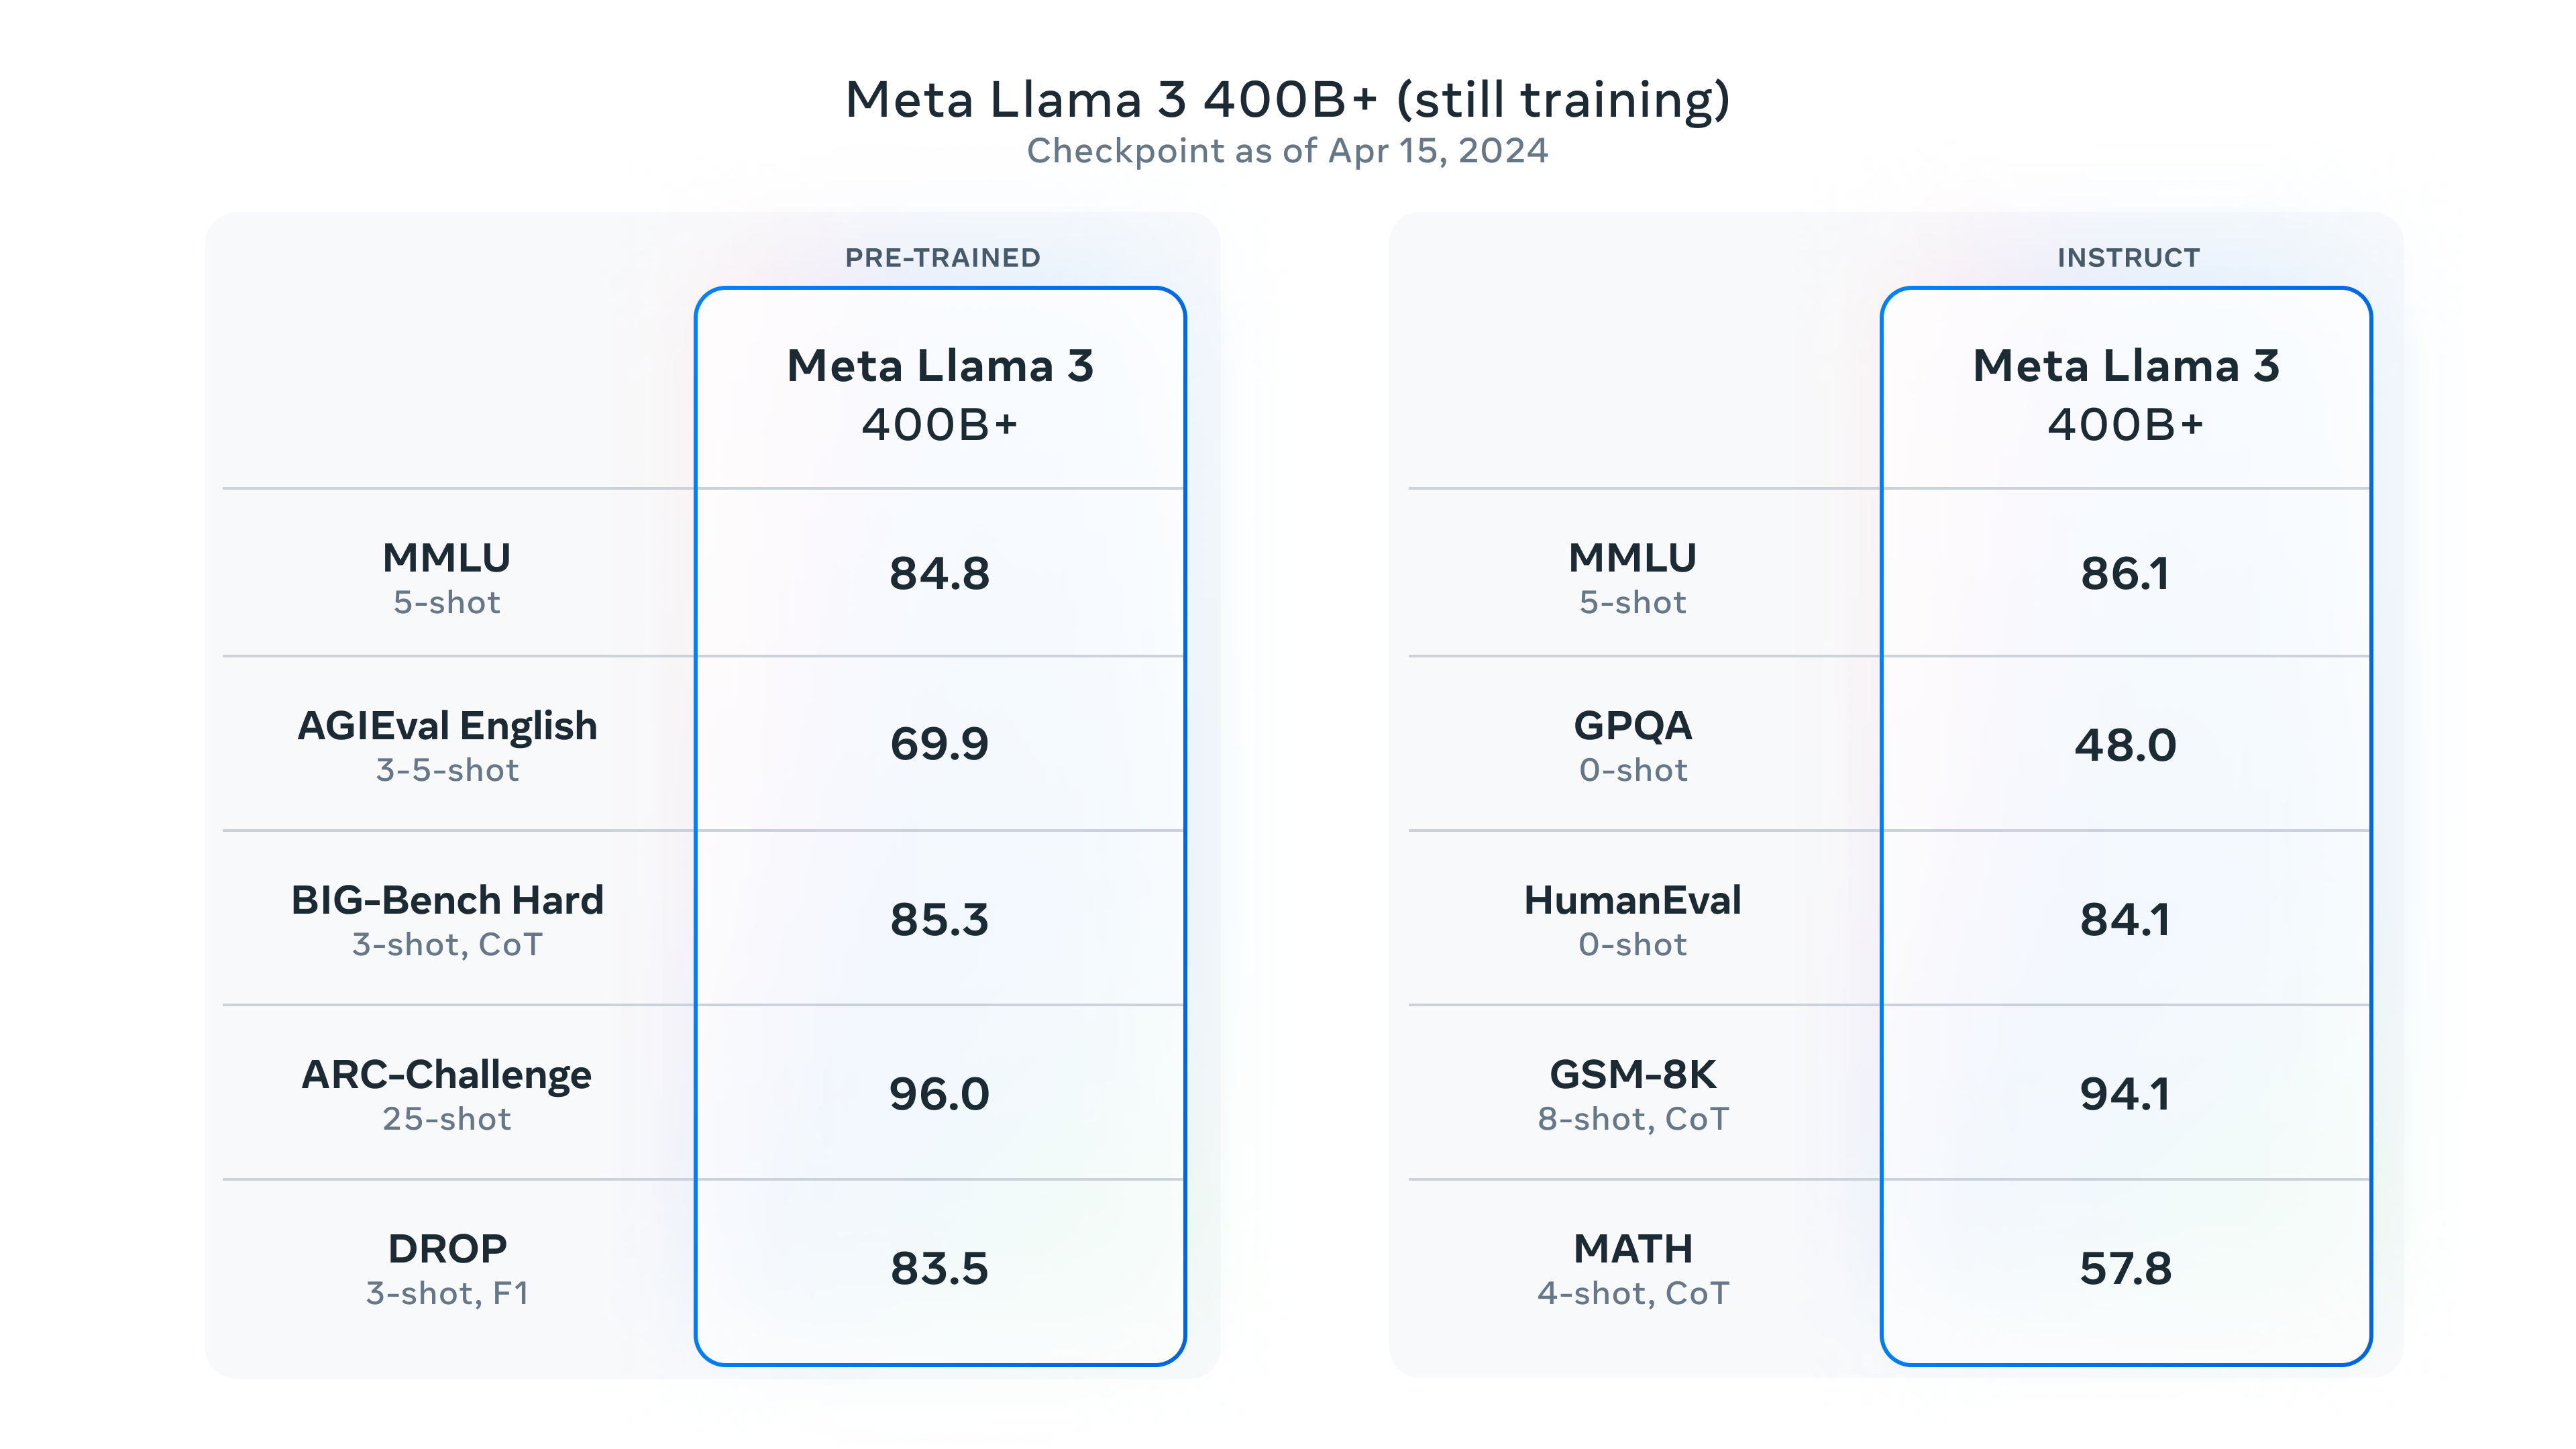
开源王者!全球最强的开源大模型Llama3发布!15万亿数据集训练,最高4000亿参数,数学评测超过GPT-4,全球第二!
大语言模型开源领域最重要的一个模型就是MetaAI开源的Llama系列。当前,很多著名开源模型都是基于Llama系列进行预训练得到。就在刚才,MetaAI开源了第三代Llama3系列。官方透露的信息非常多,Llama3系列是目前为止最强的开源大语言模型,未来还有4000亿参数版本,支持多模态、超长上下文、多国语言!

TensorRT-LLM:英伟达推出的专为提升大模型推理速度优化的全新框架
随着大型语言模型(LLM)如 GPT-3 和 BERT 在 AI 领域的崛起,如何在实际应用中高效地进行模型推断成为了一个关键问题。为此,英伟达推出了全新的大模型推理提速框架TensorRT-LM,可以将现有的大模型推理速度提升4倍!