

SWE-Lancer:OpenAI发布的一个全新大模型评测基准,用来测试大模型解决真实世界软件工程的能力
短短两年间,AI技术的进步为软件工程带来了新的可能性。然而,这些模型在真实世界的软件工程任务中究竟能发挥多大的作用?它们能否通过完成实际的软件工程任务来赚取可观的收入?为了验证大模型解决真实任务的能力和水平,OpenAI发布了一个全新的大模型评测基准SWE-Lancer来评测大模型这方面的能力。
探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。
短短两年间,AI技术的进步为软件工程带来了新的可能性。然而,这些模型在真实世界的软件工程任务中究竟能发挥多大的作用?它们能否通过完成实际的软件工程任务来赚取可观的收入?为了验证大模型解决真实任务的能力和水平,OpenAI发布了一个全新的大模型评测基准SWE-Lancer来评测大模型这方面的能力。
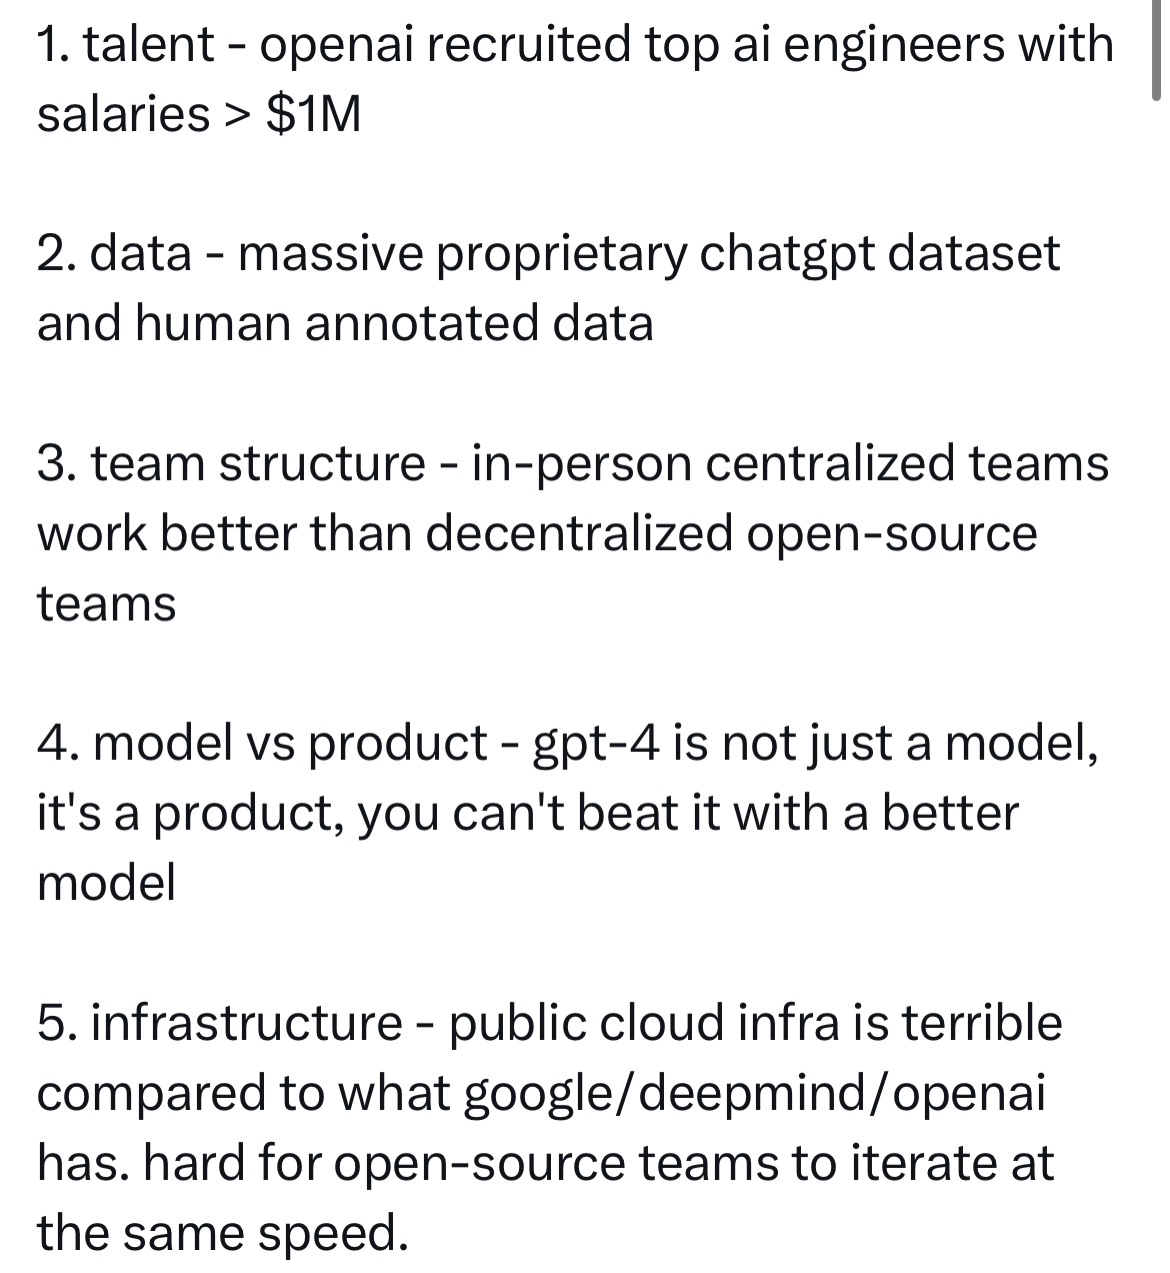
OpenAI在2023年3月份发布了GPT-4,10个月过去了,目前也没有任何一家产品或者模型可以打败GPT-4。但是,很多人都对2024年抱有非常好的期待,认为2024年会出现能与GPT-4竞争的大模型。包括MistralAI的CEO也说他们会在2024年发布性能媲美GPT-4的大模型。但是,Google前AI研究人员,GalileoAI的联合创始人认为2024年也不会出现这种情况。
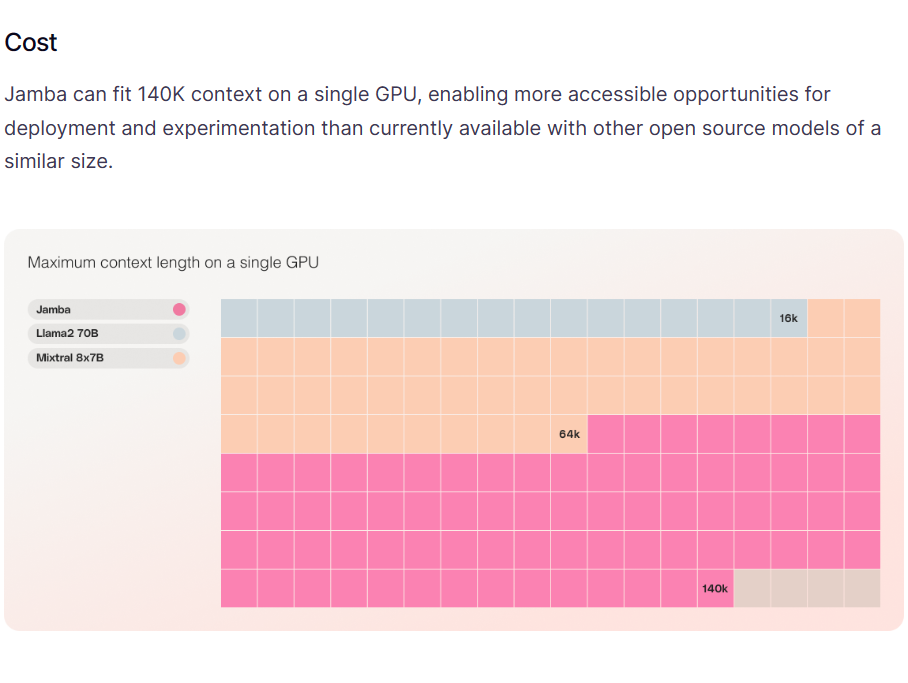
A21实验室是一家以色列的大模型研究机构,专门从事自然语言处理相关的研究。就在今天,A21实验室开源了一个全新的基于混合专家的的大语言模型Jamba,这个MoE模型可以在单个GPU上支持最高140K上下文的输入,非常具有吸引力。
在几个小时前,OpenAI开源了两款名为gpt-oss-120b和gpt-oss-20b的大语言模型。这是自GPT-2以来,OpenAI首次推出开源权重大语言模型,这两个模型的评测效果达到了o4-mini和o3-mini的水平,而且以Apache 2.0协议开源,大家可以自由使用,包括任何形式的商用。
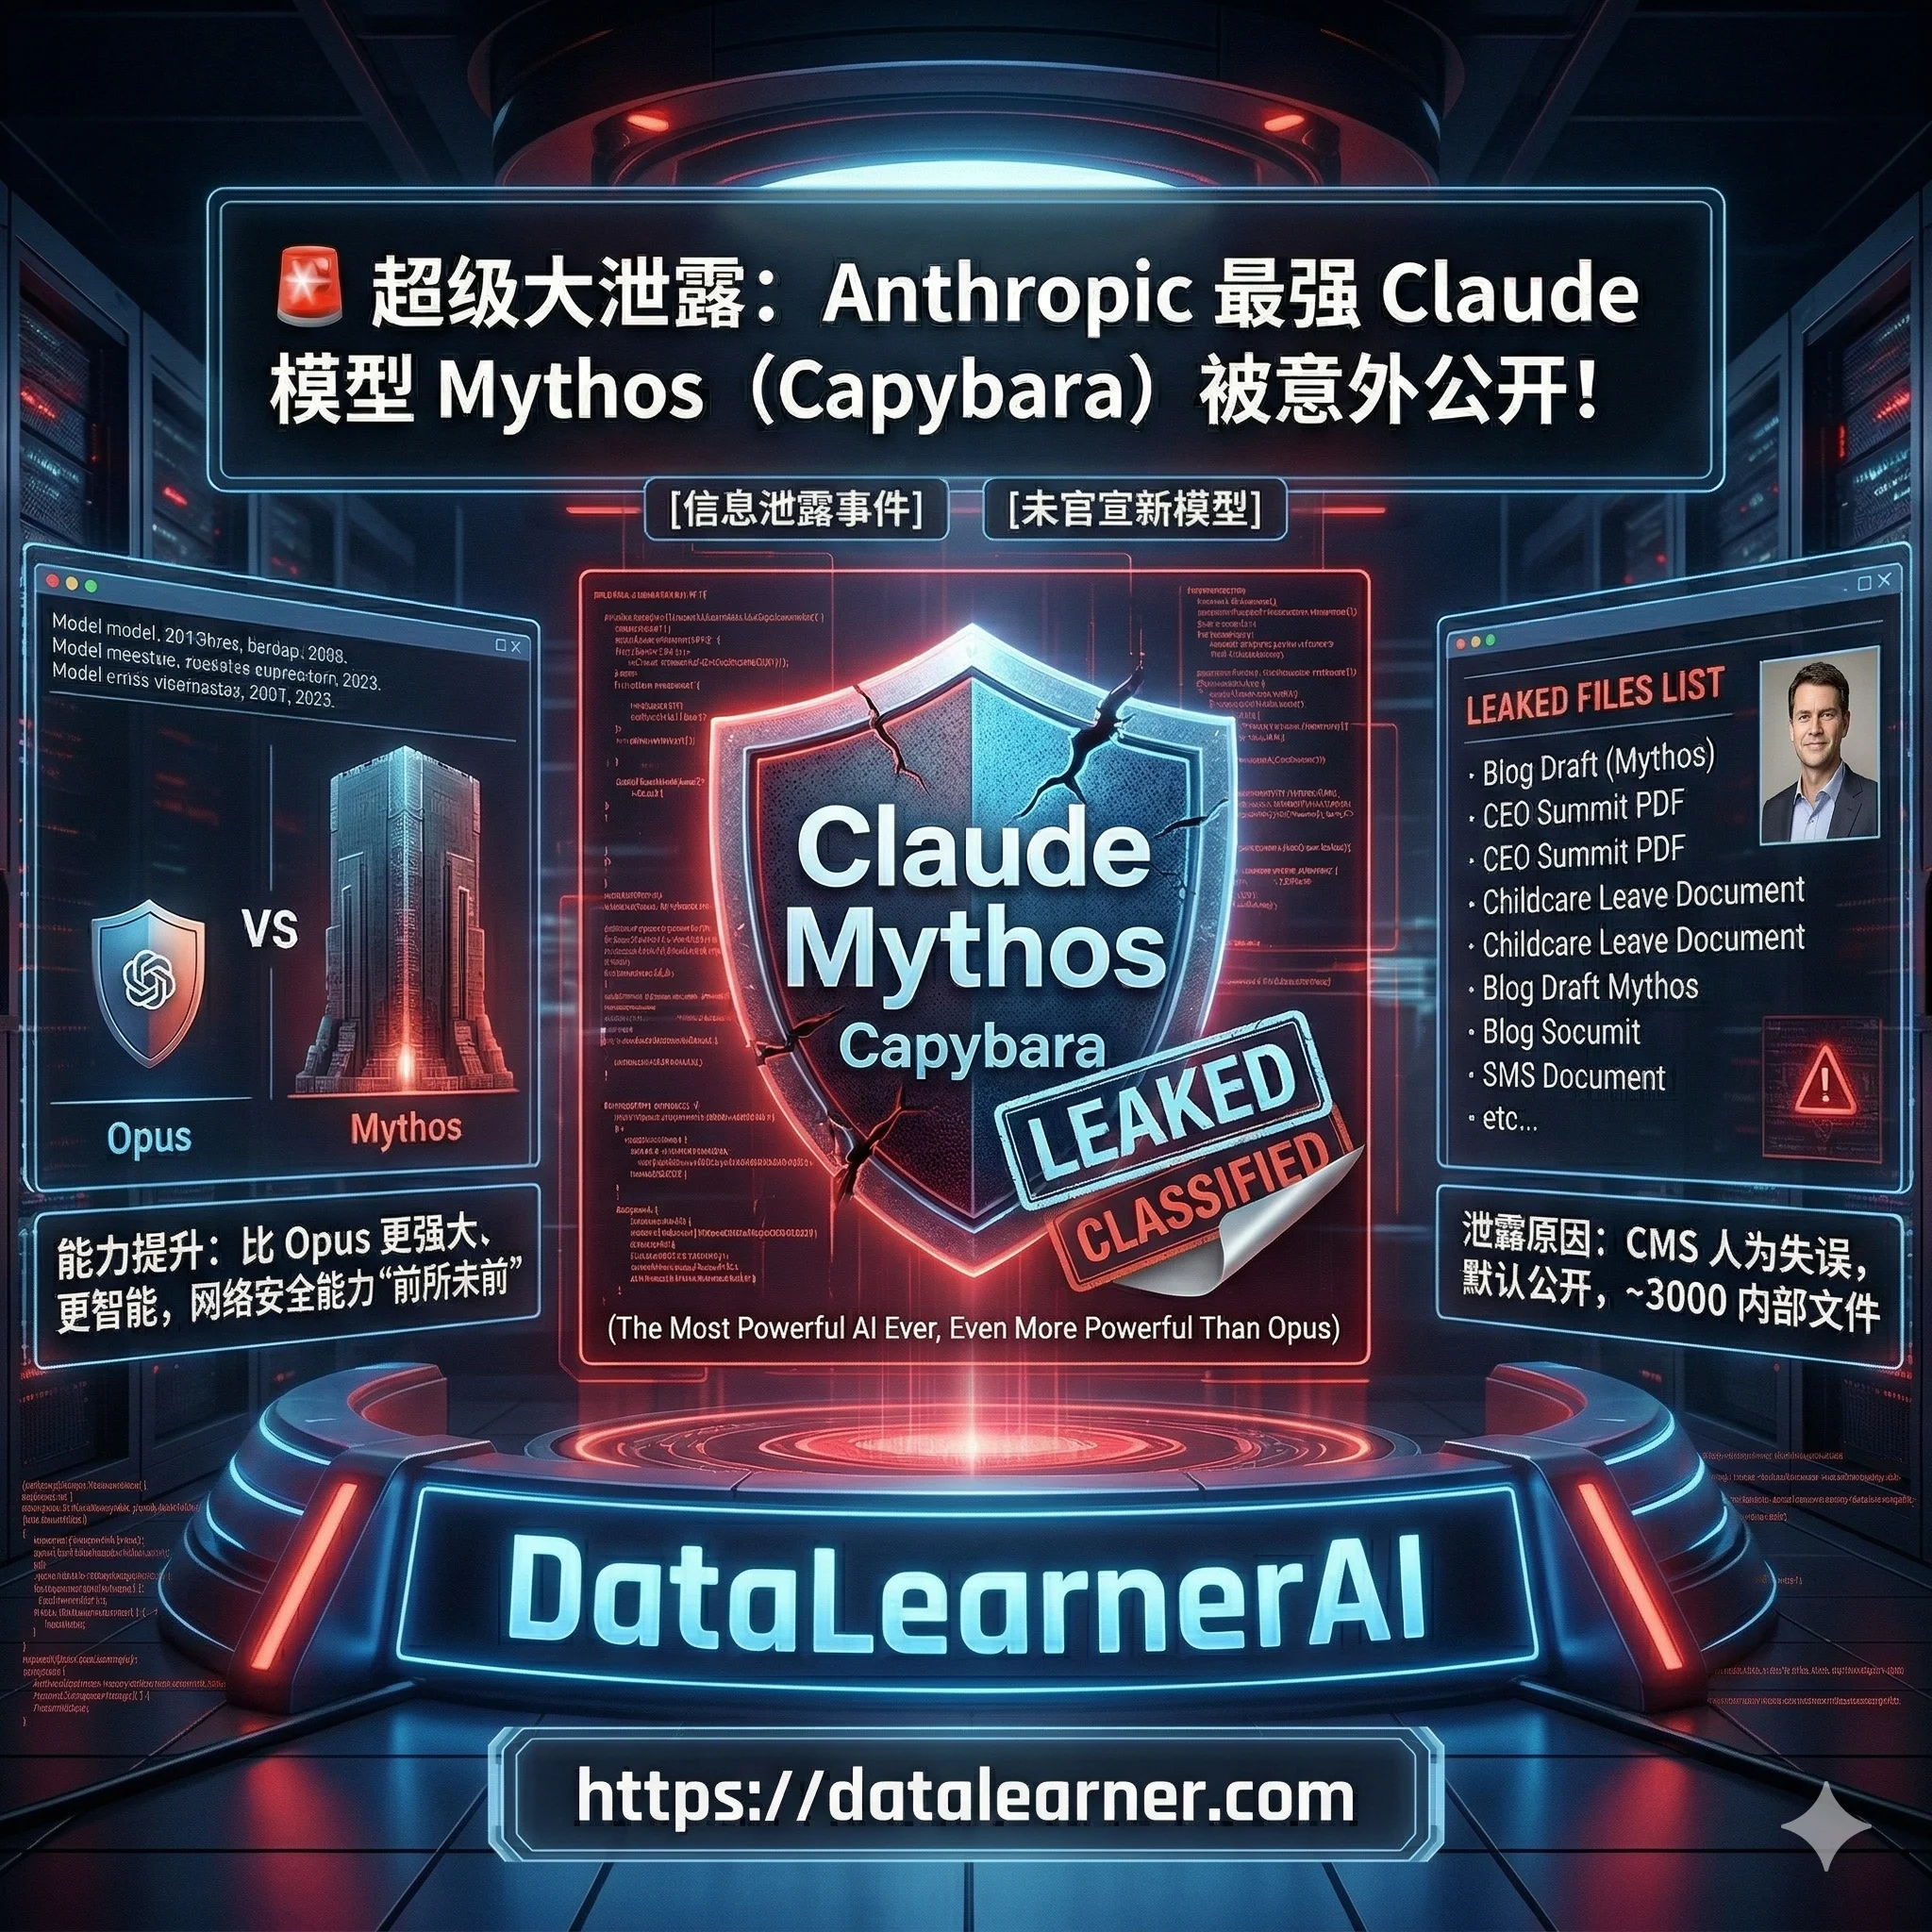
几个小时前,Anthropic发生一起信息泄露事件,还没来得及官宣,自家最强新模型就被”意外”公之于众。新模型的能力据称远超Opus 4.6!
OpenAI正在申请一个新商标Voice Engine,商标的覆盖范围主要是围绕语音识别、语音合成和语音生成几个方面。这暗示着OpenAI可能即将推出围绕语音引擎开发的产品或者服务,很有可能是类似Siri那样的个人助理产品。尽管这是商标申请,但是谷歌前雇员透露的信息以及上个月泄露的OpenAI正在开发的产品都似乎印证着OpenAI要做的事情:开发一个全球最强的个人助理,接管个人设备,以Jarvis那样的形式提供服务!
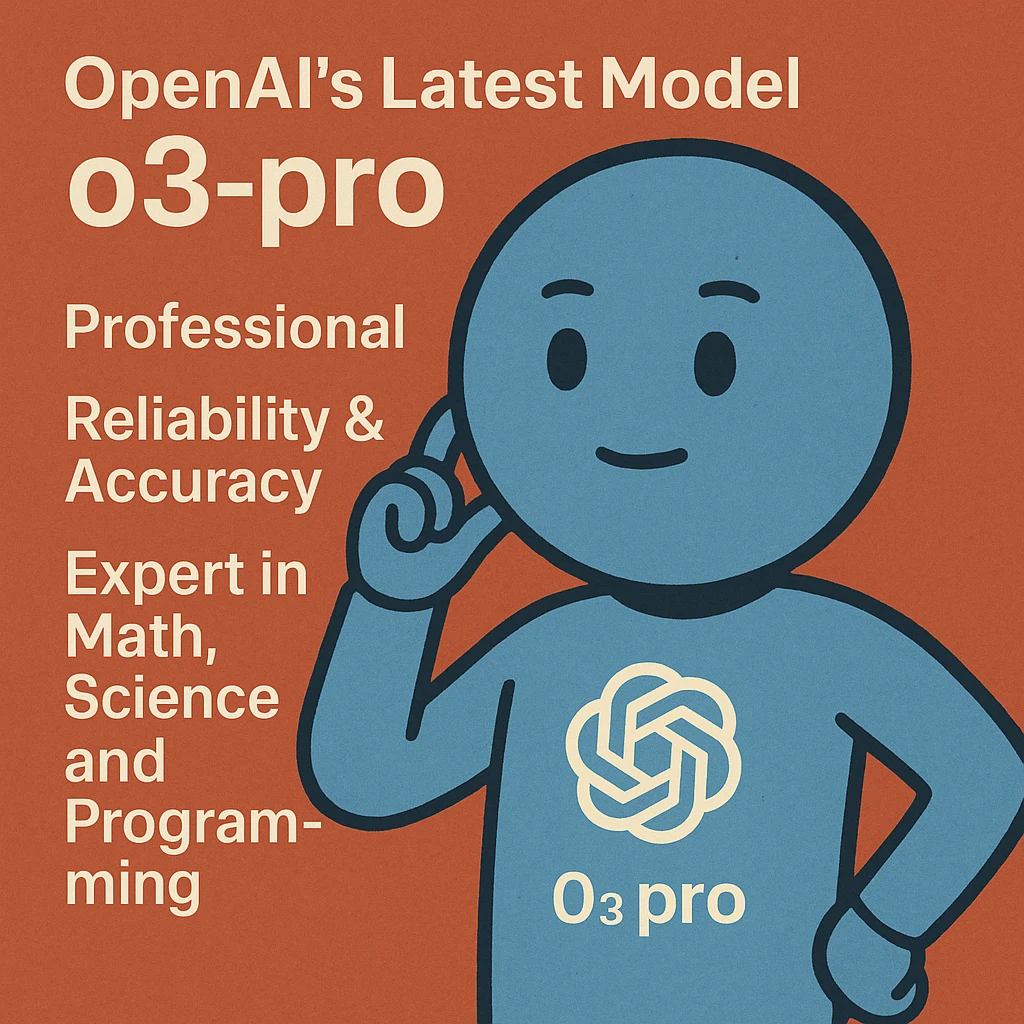
OpenAI 正式发布了其最新模型 OpenAI o3-pro,这是其旗舰模型 o3 的专业增强版。o3-pro 专为需要“更长时间思考”的复杂任务而设计,其核心亮点在于极致的可靠性和准确性,尤其在数学、科学和编程等专业领域表现卓越。根据OpenAI引入的全新“4/4可靠性”评测标准,o3-pro 的性能远超前代,OpenAI官方强调o3-pro在处理高难度、高风险任务的能力上实现了质的飞跃。
MLOps的主要目标是创建一个更有效、可重复和可靠的机器学习工作流程。现在,随着大语言模型的流行,LLMOps概念也随之提出。即如何高效地开发大模型应用,包括自动化管理升级如prompt、模型评估等。为此,吴恩达联合Google的研发人员推出了最新的大模型短课LLMOps,帮助大家学习大语言模型开发过程中的自动化测试、自动化Prompt管理等一系列实践,提高大模型应用开发的效率和质量。
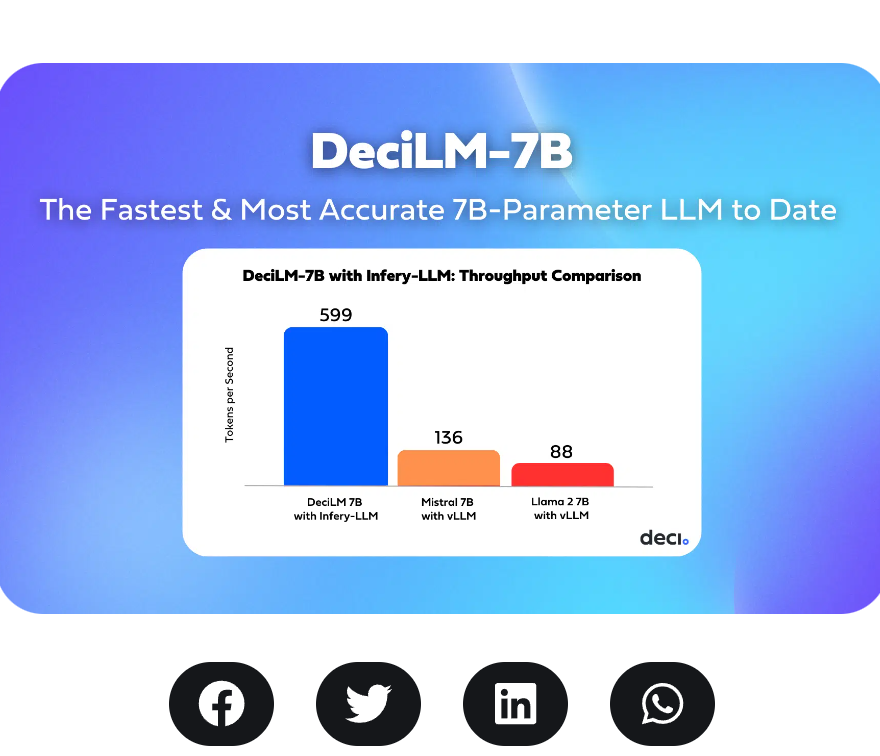
DeciAI是一家成立于2019年的以色列企业,他们最主要的产品是深度学习平台Deci,可以让大家部署运行更快、更准确的模型。包括Adobe、HPE等都是他们的客户。在昨天,他们开源了截止目前可能是Open LLM Leader综合评分最高的大语言模型DeciLM-7B以及指令优化版本的DeciLM-7B-Instruct。最重要的是,这个模型以Apache2.0的协议开源,可以免费商用。
Mistral AI今天发布了其首个专注于推理能力的系列模型——**Magistral**。这次发布包含两个核心模型:旗舰模型`Magistral Medium`和<font color=red>已开源的</font>`Magistral Small (24B)`。最引人注目的亮点是,Mistral展示了其自研的强化学习(RL)pipeline能够从头开始,仅通过RL训练就将基础模型的推理能力提升到业界顶尖水平,而无需依赖任何其他预先存在的推理模型进行数据蒸馏。这套技术栈非常强大!
今天The Information独家披露了一个令人兴奋的消息,那就是OpenAI正在开发一种Agent产品,可以通过控制用户的设备来帮助用户完成复杂的任务。
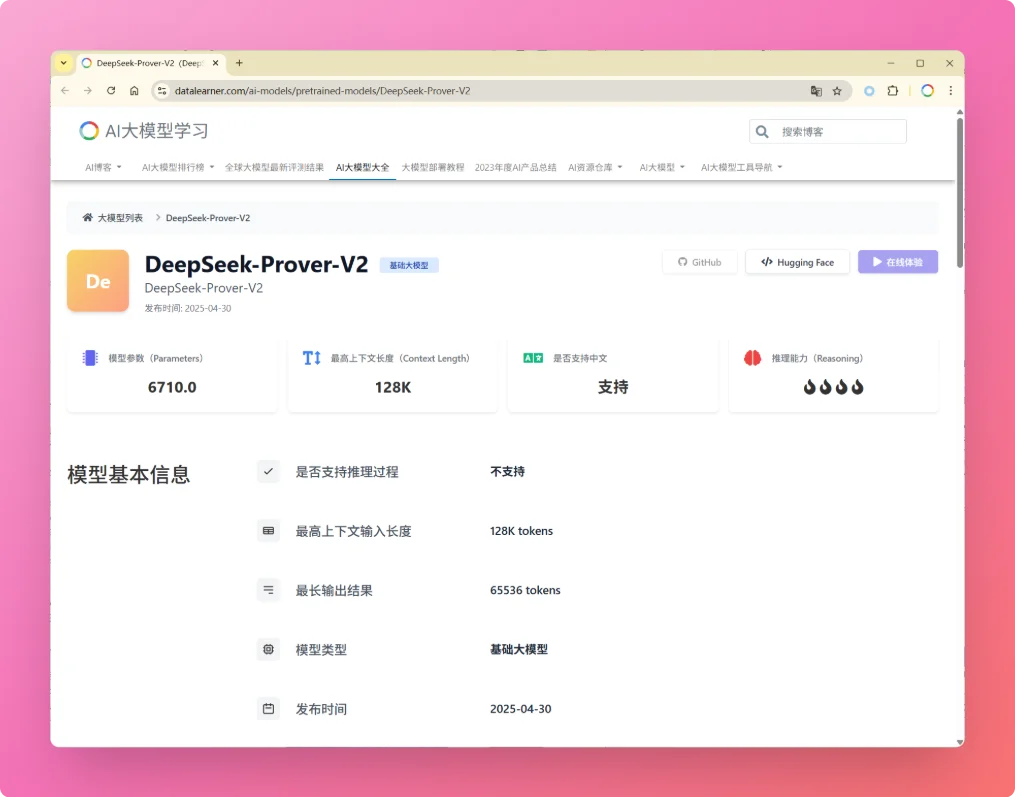
就在刚才,DeepSeek-AI发布了其新一代自动定理证明模型 **DeepSeek-Prover-V2**。尽管官方暂未公开详细报告,但从其前代模型 **DeepSeek-Prover-V1.5** 的技术细节,以及去年底发布的通用推理模型 DeepSeek-R1 的进展来看,V2 很可能在多个关键能力上取得了实质性提升。
2025年1月31日,OpenAI在Reddit上举办了一场AMA(Ask Me Anything)活动,参与者包括Sam Altman、Mark Chen、Kevin Weil、Srinivas Narayanan、Michelle Pokrass和Hongyu Ren。他们分享了关于模型更新、未来功能、定价策略以及OpenAI对AI和AGI(通用人工智能)的宏观愿景。以下是此次问答的关键内容,并附有相关解释。这里最重要的信息可能是Sam透露认为当前OpenAI的闭源方式可能是历史错误的一方!

尽管各家大模型技术进展神速,但是在复杂任务的推理上,大模型目前依然较弱。在去年底,各方消息透露,OpenAI内部有一个称为Q\*的项目取得了重大的突破,可以大幅提高大模型的推理能力。但是,几个月过去了,这个当时吸引了大量讨论的项目没有任何信息。直到昨天,Reuters披露了Q\*项目的进展,这个项目已经变为Strawberry!并且距离发布时间更近了!

随着大型语言模型(LLM)的飞速发展,如何准确、全面地评估它们的能力成为了一个日益重要的课题。在众多评测基准中,Simple Bench 以其独特的定位脱颖而出,它专注于检验模型在日常人类推理方面的能力,而在这些方面,当前最先进的模型往往还不如普通人。本文将详细介绍 Simple Bench 评测基准,探讨其出现的背景、设计理念、评测流程以及当前主流模型的表现。
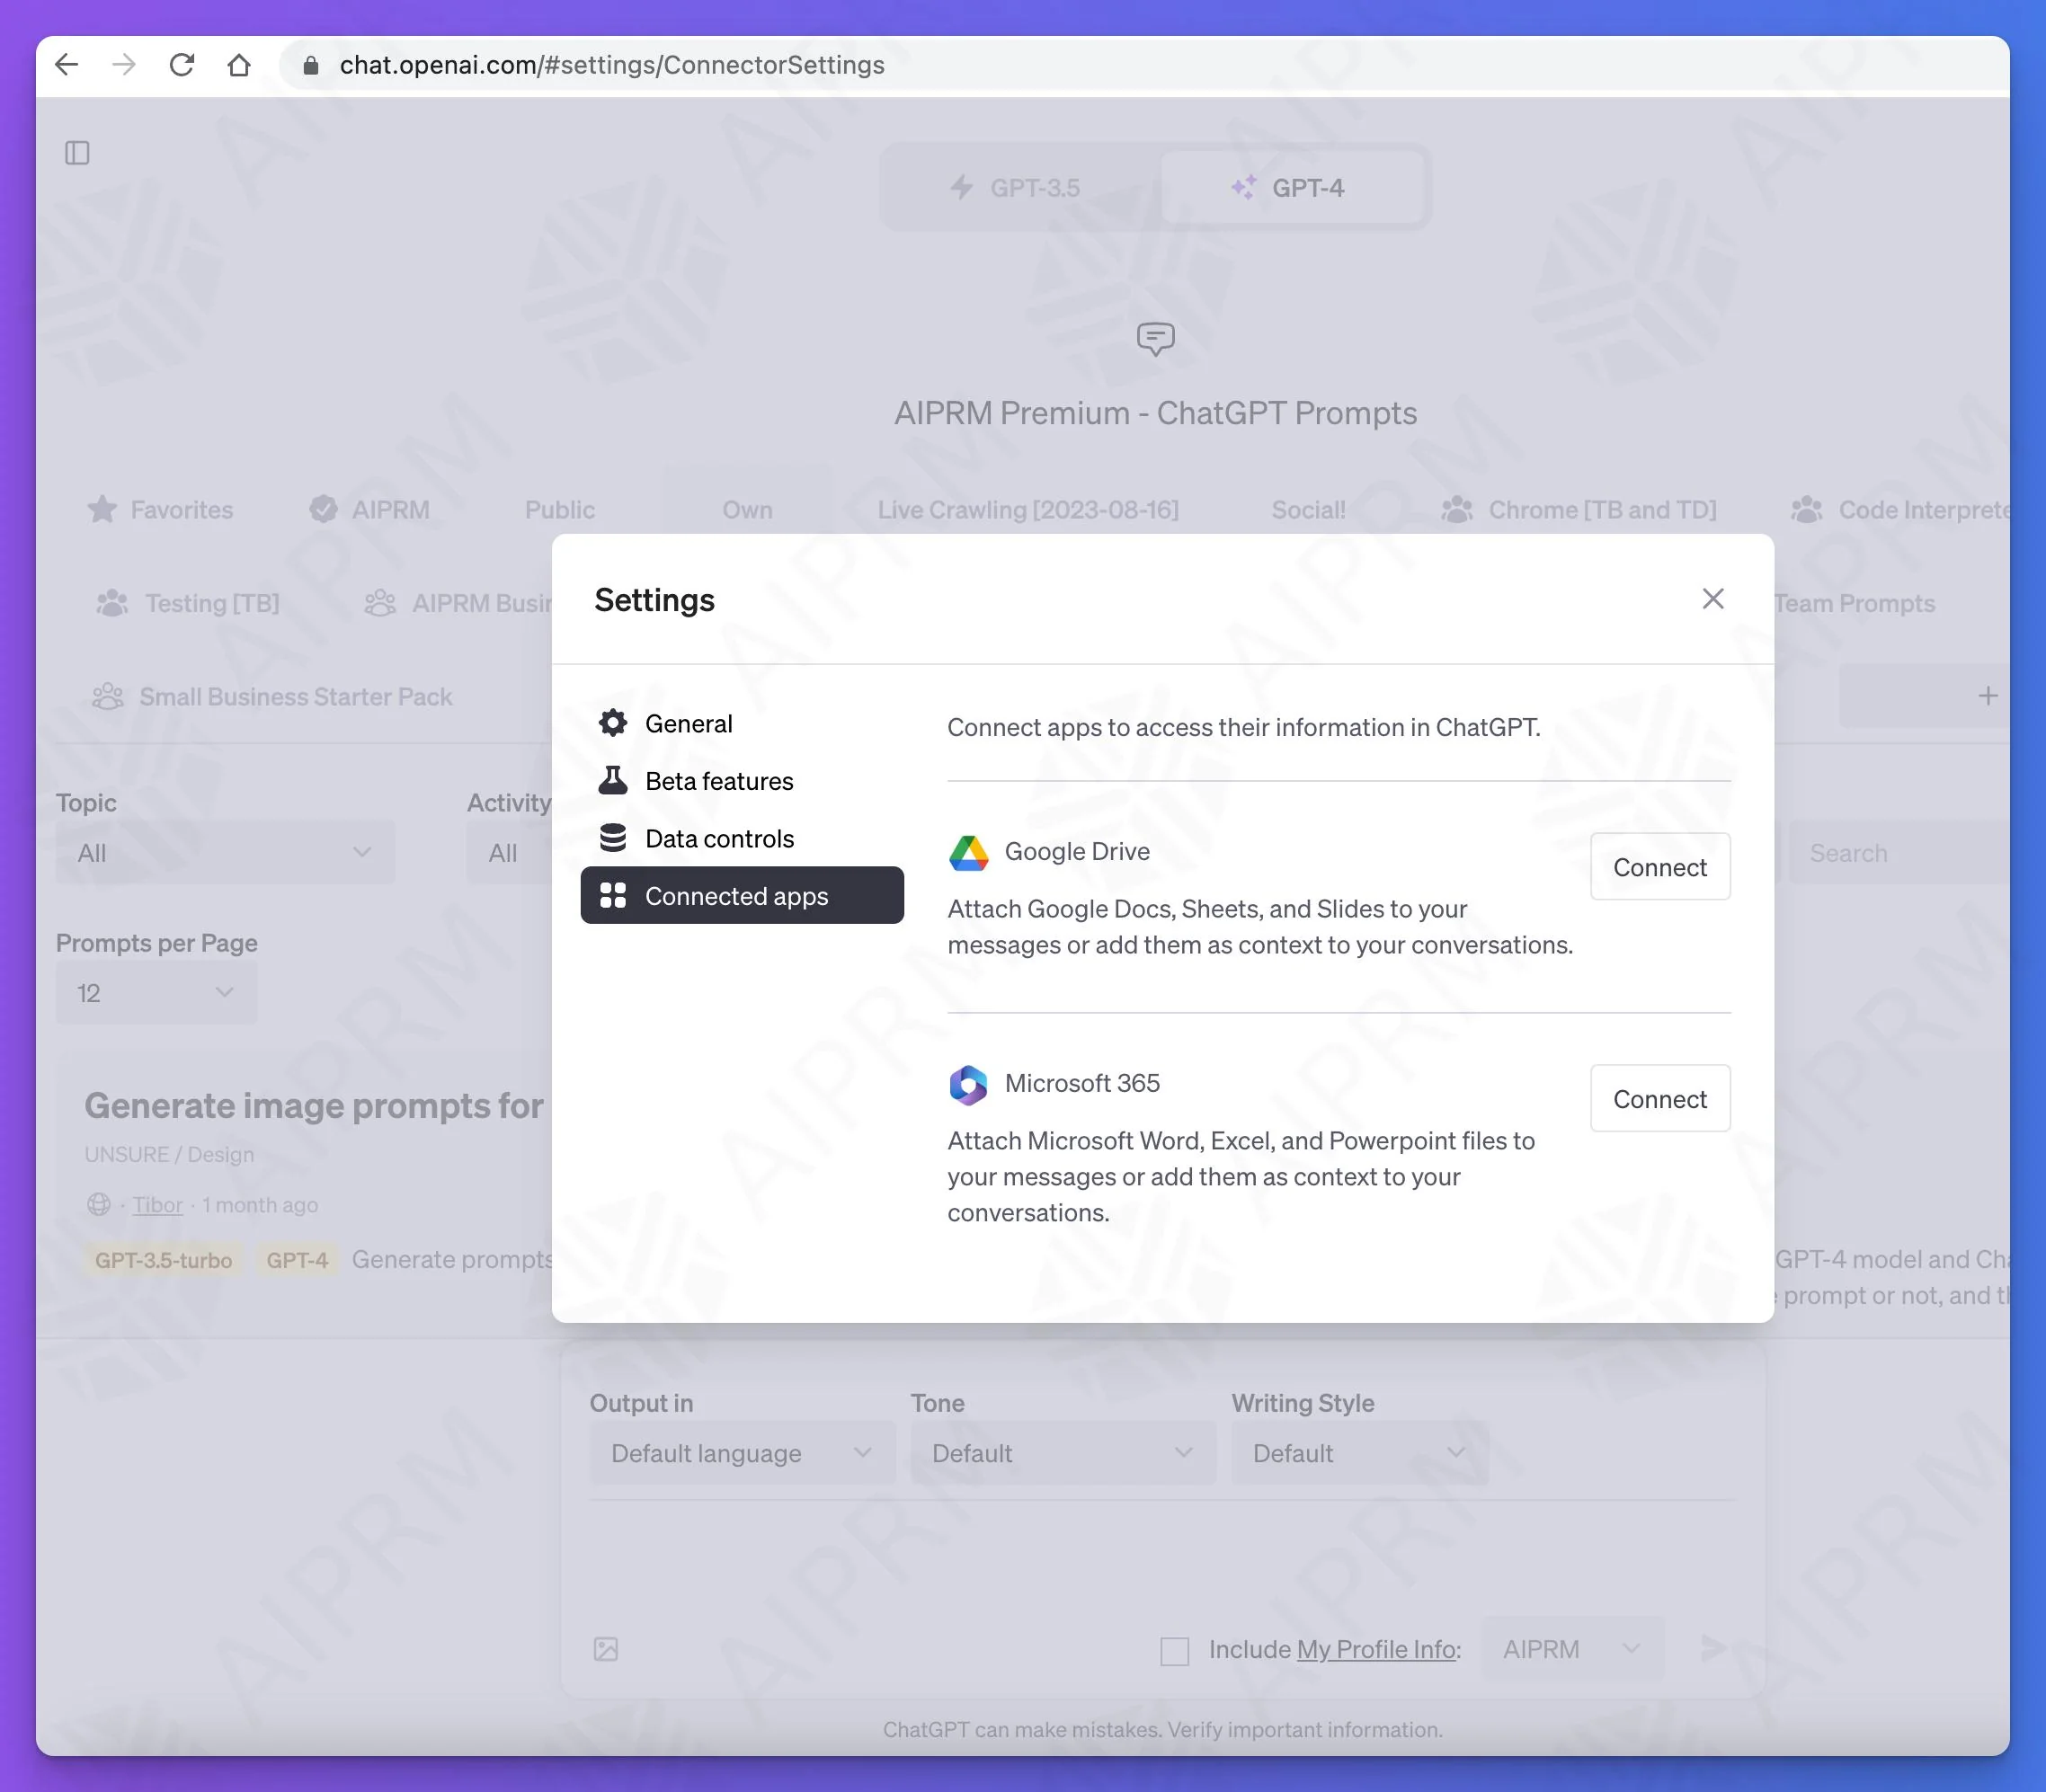
ChatGPT的发展速度很快,在前面已经介绍过ChatGPT即将推出的Team订阅计划和新界面,包括对接自定义数据和自定义接口等。此外,DataLearnerAI还发现ChatGPT即将推出关联APP的能力,截图显示,目前已经测试了对接Google Drive和Microsoft 365两个。

GPT-5 在指令遵循和推理能力上比前代更强,但也因此更“敏感”:如果规则里有冲突或表述过度强硬,模型往往会卡壳或输出异常。为此,OpenAI 发布了面向开发者的 《GPT-5 for Coding》技巧小抄,其中总结了使用 GPT-5 进行编程与代码生成时最实用的六条经验。这些技巧与普通的“写作提示工程”不同,它们专门针对软件开发场景:如何写规则、怎样控制推理强度、如何避免模型“想太多”,以及怎样利用 GPT-5 的新特性把它真正驯化成可靠的结对编程伙伴。本文对这六条技巧逐条进行解释总结。
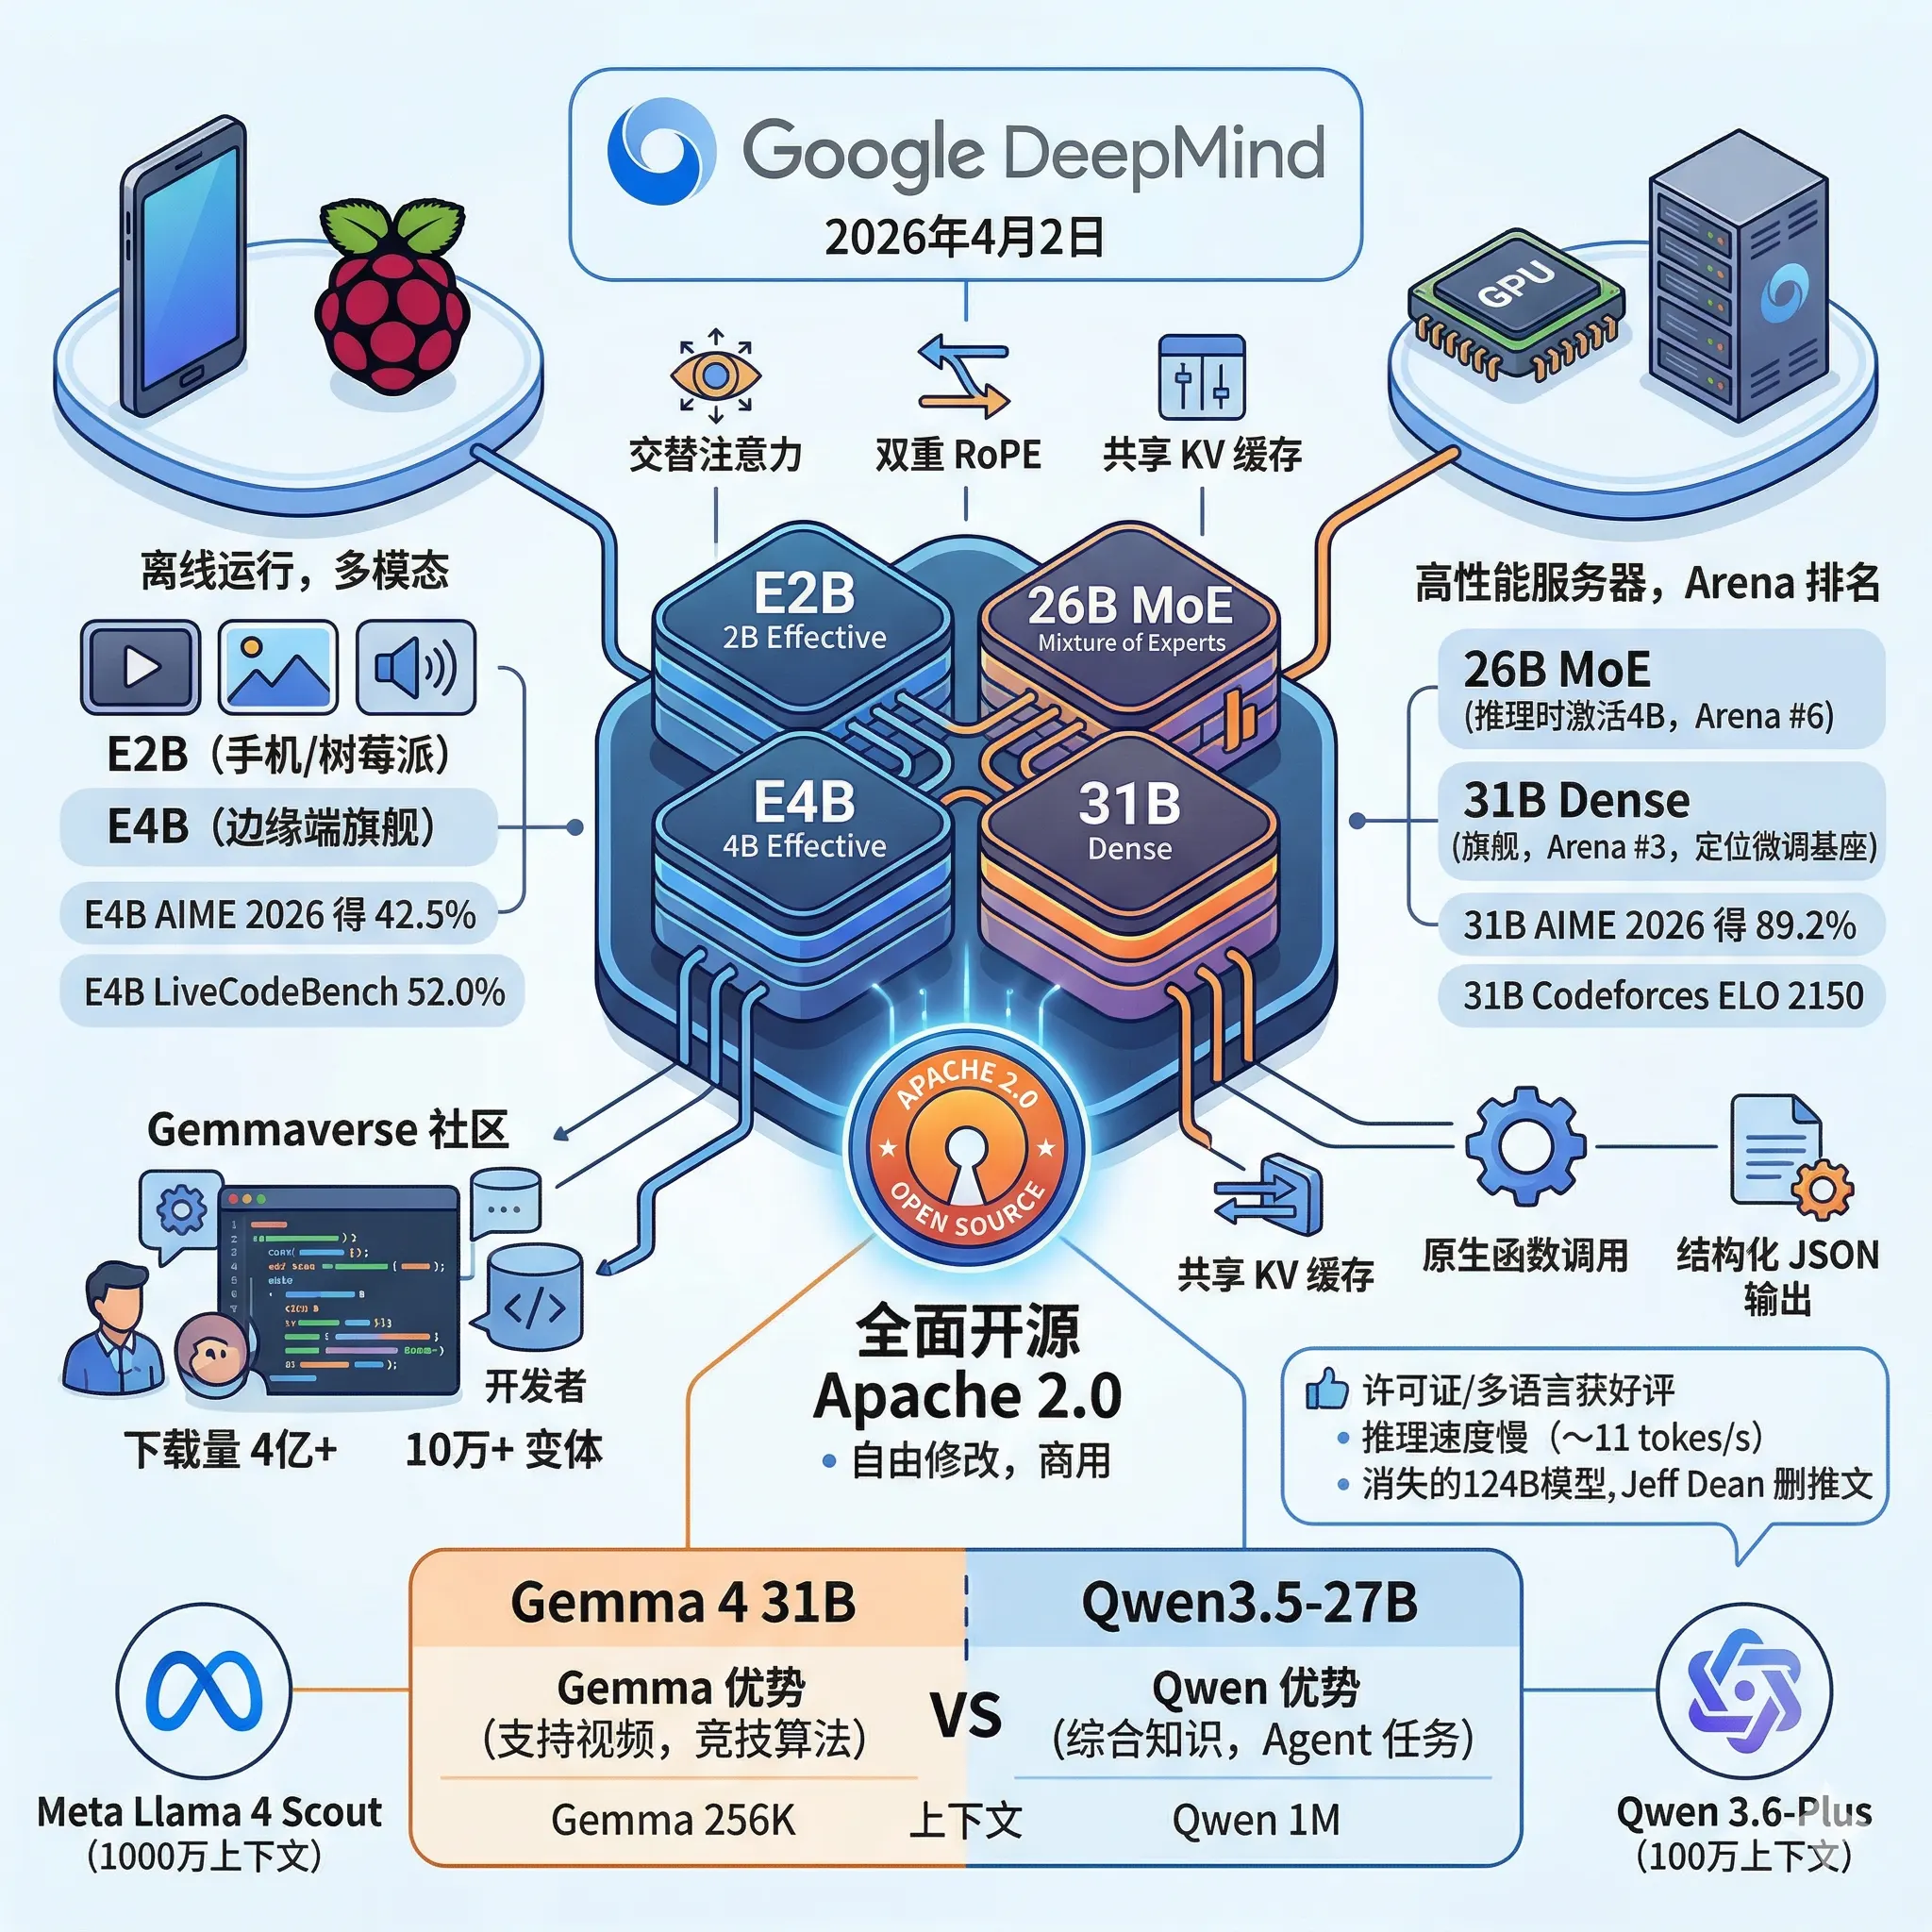
2026年4月2日,Google DeepMind 正式发布了 Gemma 4 系列模型。自2024年首代 Gemma 发布以来,开发者已经累计下载超过4亿次,并在此基础上衍生出超过10万个变体版本,形成了所谓的"Gemmaverse"社区生态。这次的 Gemma 4,Google 不只是做了常规的性能升级,而是在许可证、模型架构和部署覆盖范围上同时迈出了一大步。
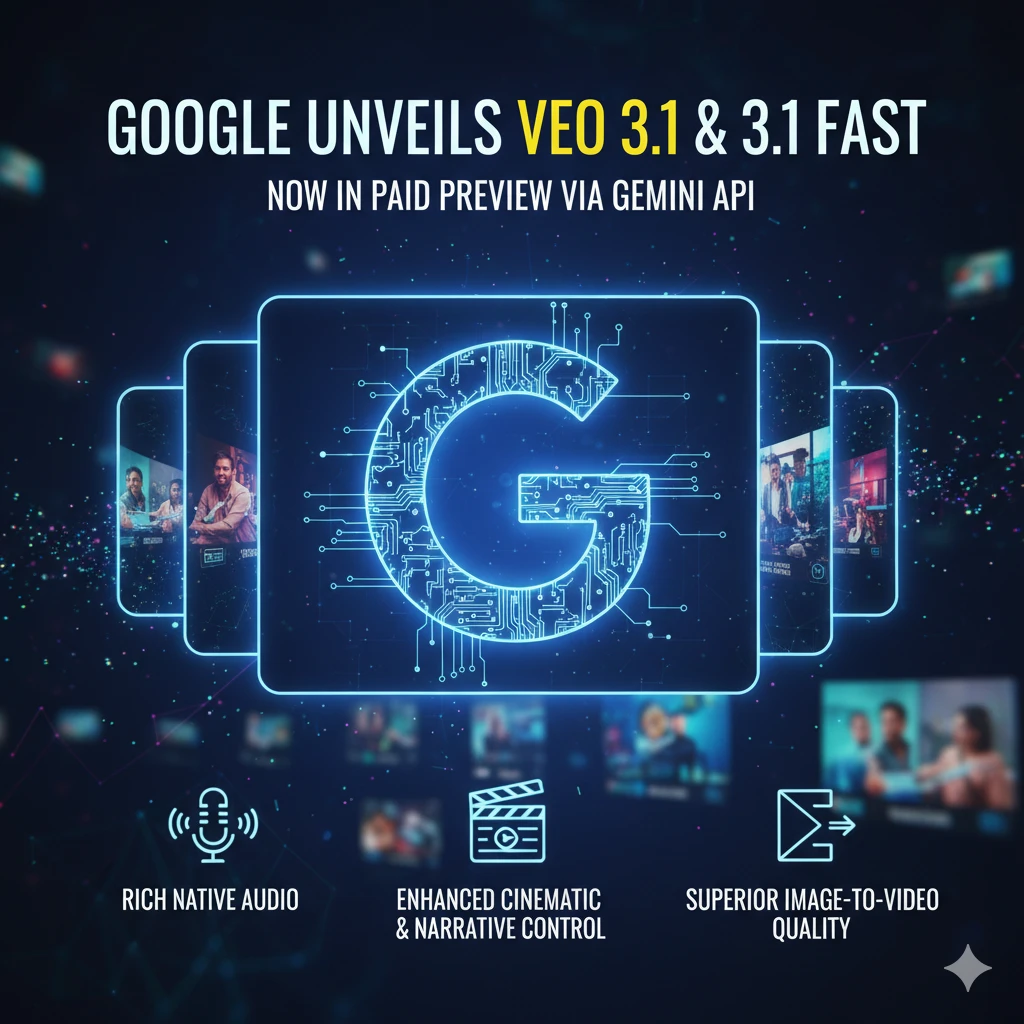
就在今日,Google 正式推出 Veo 3.1 和 Veo 3.1 Fast,这两款升级版视频生成模型以付费预览形式登陆 Gemini API。Veo 3.1的核心亮点是:更丰富的原生音频(从自然对话到同步音效)、更强的电影风格理解与叙事控制、以及显著增强的图生视频(Image-to-Video)质量与一致性。
上周五,OpenAI董事会突然把Sam开除的事件已经结束,闹了好几天之后Sam回归,董事会改组。而这件事的背后导火索有许多传闻,其中最重要的一个是OpenAI可能在最近有一项重大的技术突破,被认为是Sam和董事会分歧的重要原因。而今天,国外的路透社独家消息提到OpenAI内部一个称为Q\*(Q Star)项目取得了非常重大的突破,使得部分人认为AGI很接近,进而引发了一系列事件。本文将根据目前的信息汇总介绍一下Q\*项目。
人工智能(AI)的通用智能(AGI)发展一直是研究领域的焦点。近期,由 ARC Prize 基金会推出并由 AI 研究者 François Chollet 联合发起的 ARC-AGI-2 评测基准,为衡量大模型在未知情境下的实时推理能力和学习效率提供了新的视角。
随着大型语言模型(LLM)能力的飞速发展,如何科学、准确地评估其性能,特别是深度的逻辑推理和代码生成能力,已成为人工智能领域的一大挑战。传统的评测基准在面对日益强大的模型时,逐渐暴露出数据污染、难度不足、无法有效评估真实推理能力等问题。在这一背景下,一个旨在检验模型竞赛级编程水平的评测基准——Codeforces应运而生,为我们提供了一个更严苛、更接近人类程序员真实水平的竞技场。
就在几个小时前,OpenAI 发布了全新的 GPT Realtime 大模型。这是一个 Speech-to-Speech(S2S)模型,能通过单个模型与 API完成从音频输入到音频输出的全流程,显著降低交互延迟并充分保留语音细节。 GPT Realtime 以“端到端语音理解—推理—合成”为核心路径,解决了传统“识别—推理—合成”多阶段带来的延迟与风格割裂问题。