DataLearner logo
Original Blog

Original AI Tech Blogs

Explore the latest AI and LLM news and technical articles, covering original content and practical cases in machine learning, deep learning, and natural language processing.

OpenAI 发布 GPT-5.5:代号"Spud",Agent 能力明显提升,API 因安全审查暂缓开放

OpenAI 发布 GPT-5.5:代号"Spud",Agent 能力明显提升,API 因安全审查暂缓开放

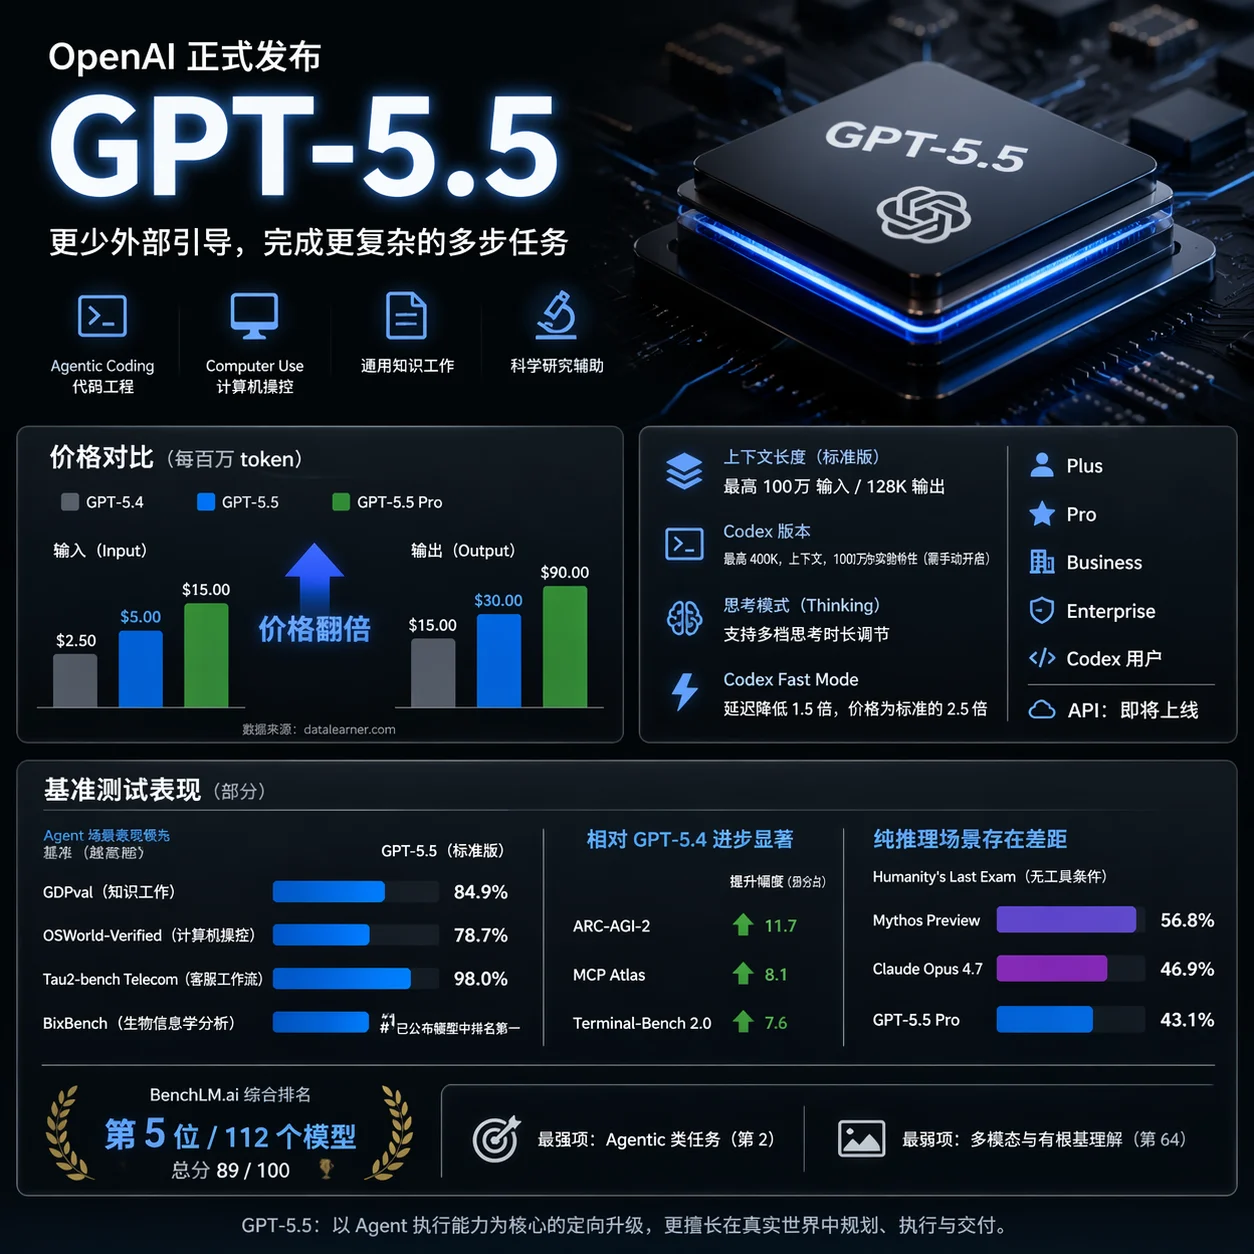
OpenAI 于北京时间4月24日正式发布 GPT-5.5,内部代号"Spud"。距离 GPT-5.4 发布只有大约六周,这个节奏说明头部实验室现在基本上是滚动迭代而不是等大版本攒够了再发。GPT-5.5 即日起向 ChatGPT 的 Plus、Pro、Business 和 Enterprise 用户以及 Codex 用户开放,GPT-5.5 Pro 面向 Pro、Business 和 Enterprise。API 这边因为需要额外的网络安全防护验证,暂时没有同步上线,OpenAI 说"很快"会跟上。
2026/04/24 08:48:09598
阿里正式开源Qwen3.6-27B:代码智能体能力上超越全面超越前代旗舰版本之  Qwen3.5-397B-A17B

阿里正式开源Qwen3.6-27B:代码智能体能力上超越全面超越前代旗舰版本之 Qwen3.5-397B-A17B

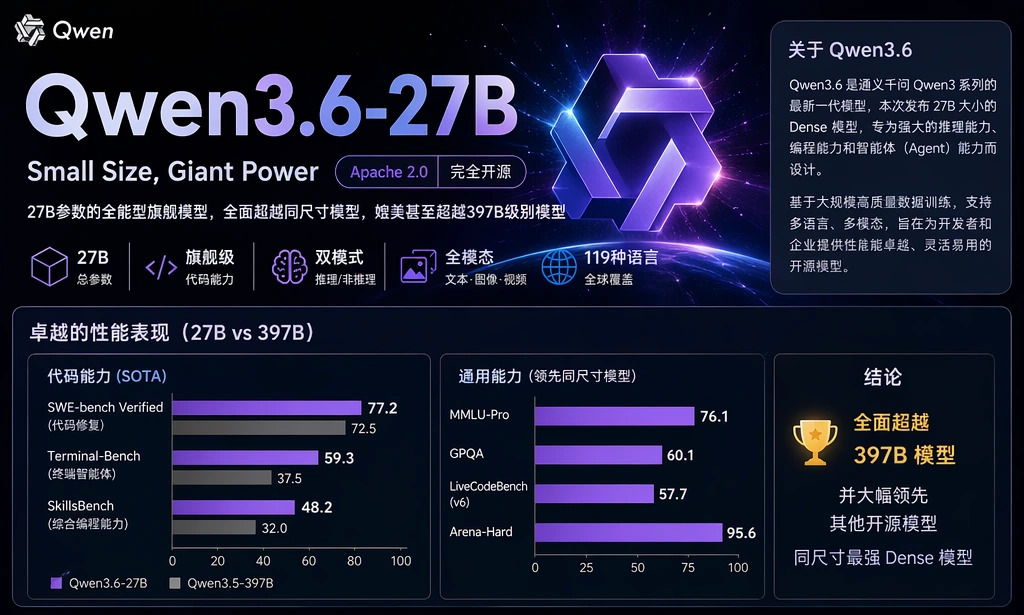
Qwen3.6-27B 于2026年4月22日发布,是首个在全主要代码智能体评测上超越 Qwen3.5-397B-A17B 的开源稠密27B模型。SWE-bench Verified 77.2、Terminal Bench 2.0 59.3、SkillsBench 48.2(前代30.0)、AIME 2026 94.1(全球第4)。本文结合 DataLearner 评测数据与官方基准,分析其实质进展与能力边界。

2026/04/22 22:59:332,950
Anthropic发布Claude Opus 4.7:编程能力大幅跃升,视觉分辨率提升超3倍,首个搭载网络安全防护机制的旗舰模型!

Anthropic发布Claude Opus 4.7:编程能力大幅跃升,视觉分辨率提升超3倍,首个搭载网络安全防护机制的旗舰模型!

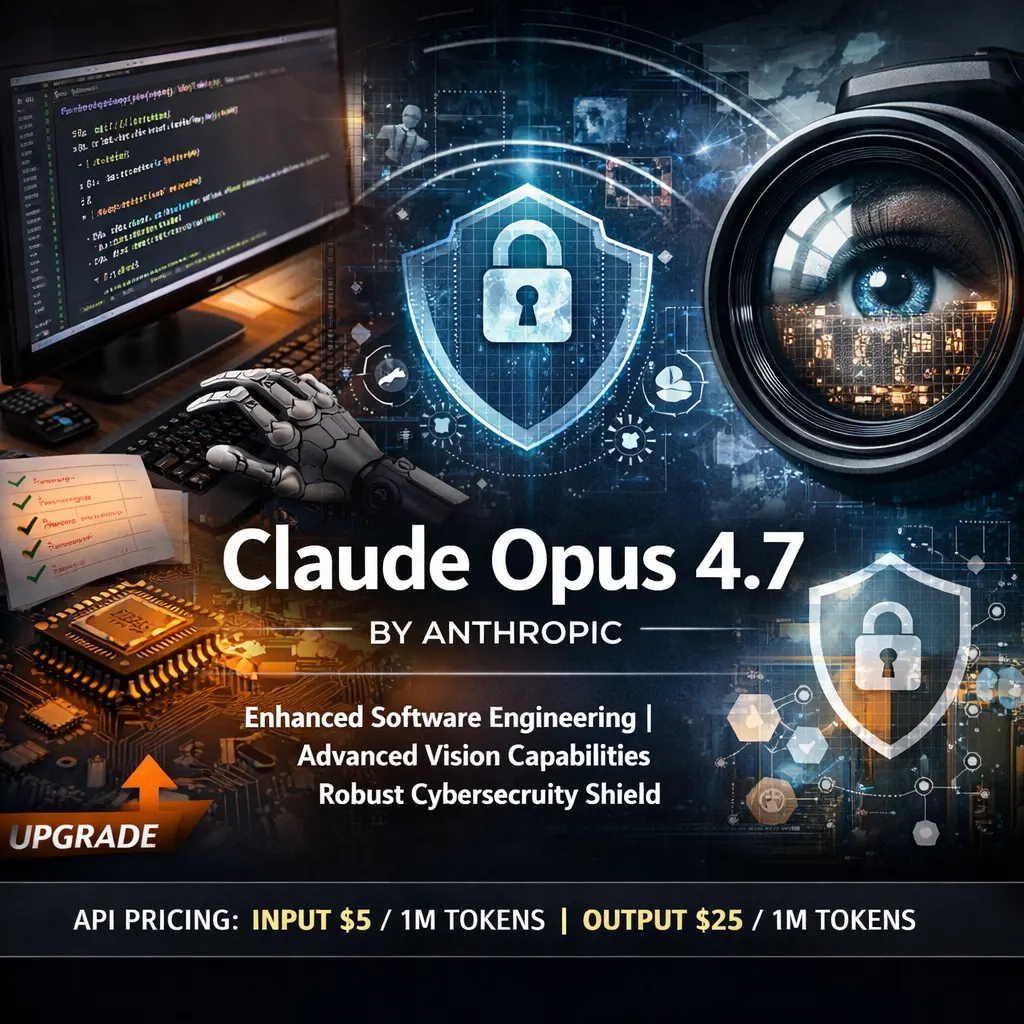
就在今天,Anthropic正式发布Claude Opus 4.7,作为Opus 4.6的直接升级版本,这次更新的重点非常集中:软件工程能力的大幅提升、视觉理解的显著增强,以及一套全新的网络安全防护机制。值得一提的是,Opus 4.7并非Claude系列中能力最强的模型——那个头衔目前属于Claude Mythos Preview——但它是第一个面向大规模开放部署、同时配备完整安全体系的新一代旗舰模型。定价与Opus 4.6保持一致,即API输入25/百万token。

2026/04/16 23:13:27718
大模型ARC-AGI-3评测基准:首个交互式推理基准

大模型ARC-AGI-3评测基准:首个交互式推理基准

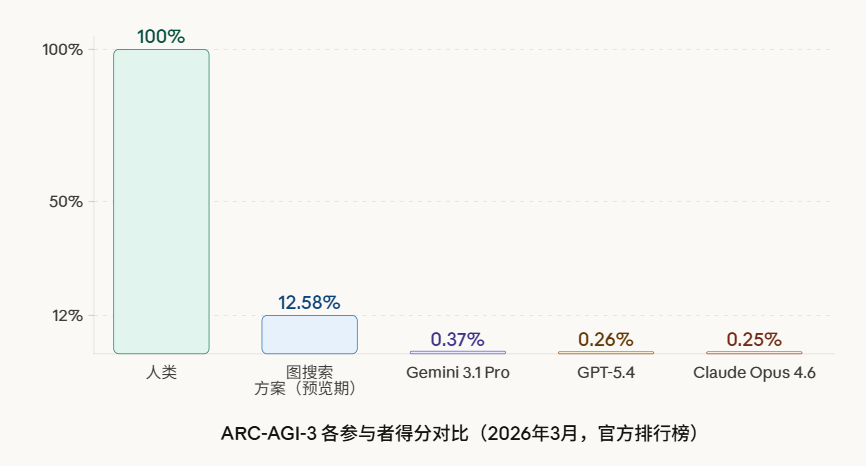
ARC-AGI 系列基准由 ARC Prize Foundation 维护,长期被主要 AI 实验室和学术研究者作为衡量 AI 推理能力的参照。2026年3月25日,该系列第三代版本 ARC-AGI-3 在旧金山 Y Combinator 正式发布,这是自2019年该系列初次推出以来,格式层面改动最大的一次迭代。

2026/04/11 22:28:511,031
AI Agent 长任务中断、状态丢失、context 超限怎么办?拆解 Anthropic Managed Agents 的架构设计

AI Agent 长任务中断、状态丢失、context 超限怎么办?拆解 Anthropic Managed Agents 的架构设计

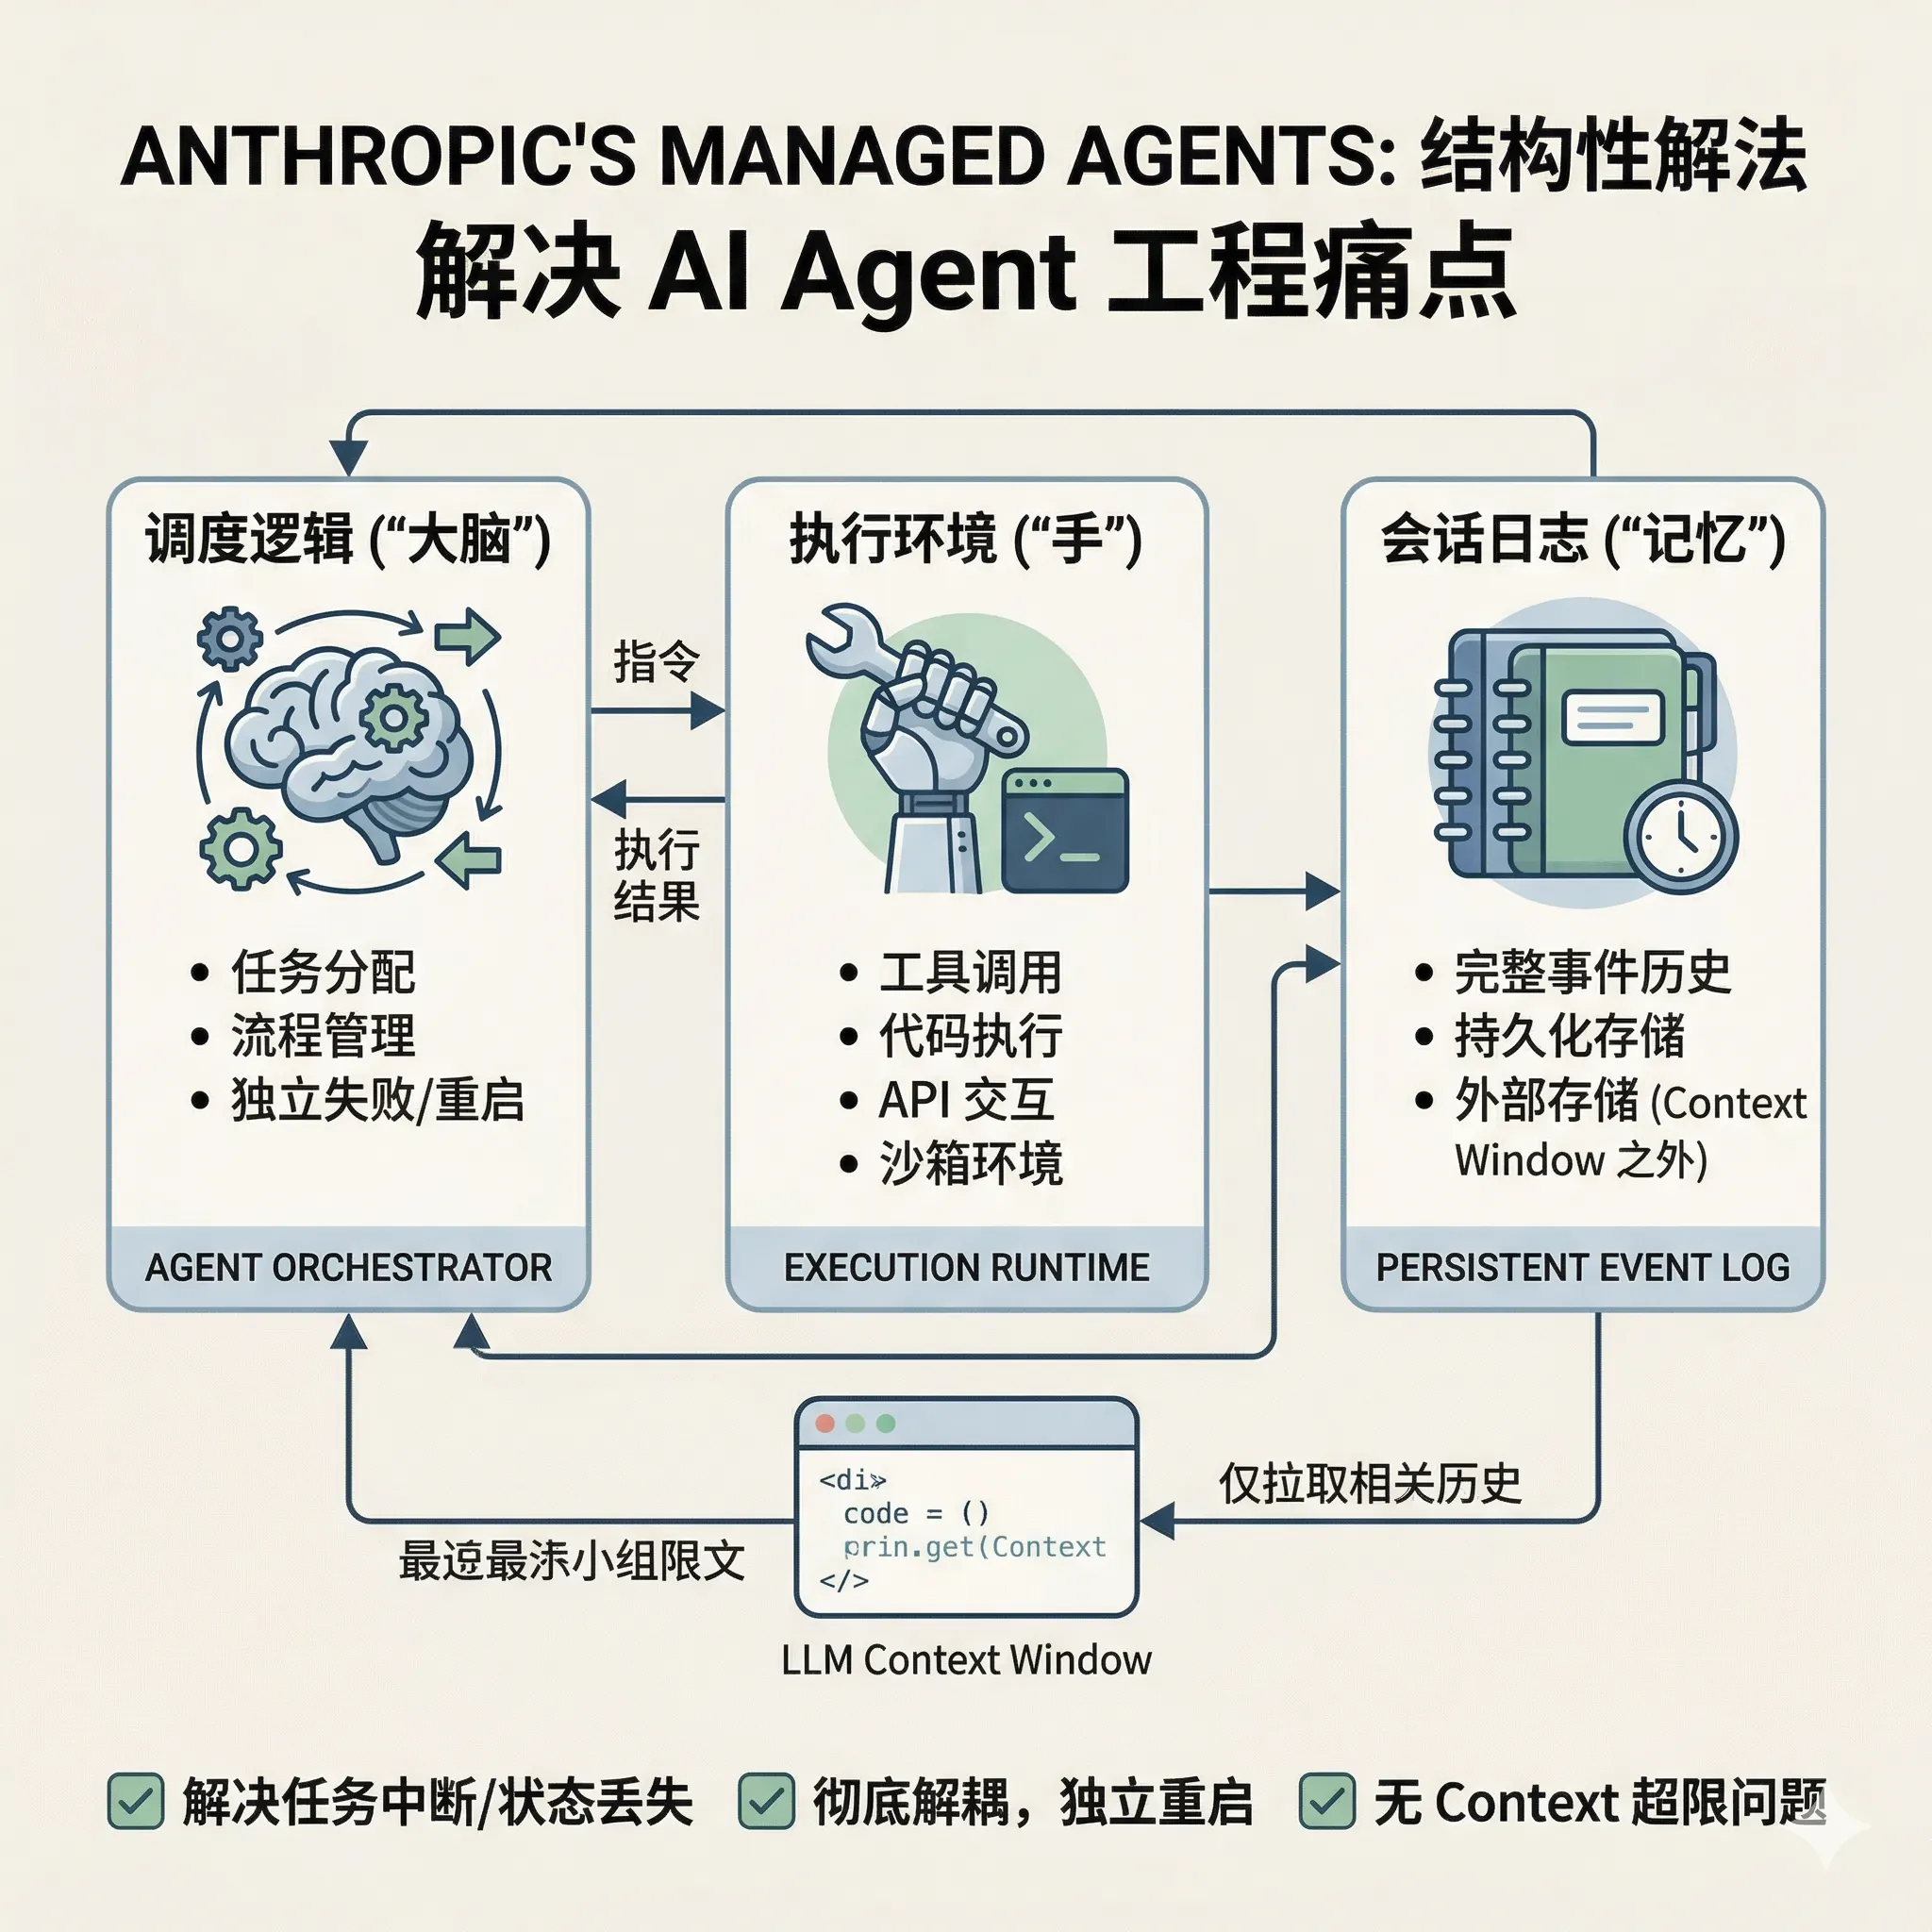
在 AI Agent 开发中,任务中断、状态丢失、context 超限是三个最常见的工程痛点。Anthropic 最新发布的 Managed Agents 工程博客给出了一套结构性解法:将 Agent 的大脑(调度逻辑)、手(执行环境)和记忆(会话日志)彻底解耦,让每个组件都能独立失败和重启,同时把完整的事件历史存在 context window 之外,从根本上解决长任务的状态管理问题。本文拆解这套架构的核心设计决定,以及背后的工程思路。

2026/04/09 14:05:59466
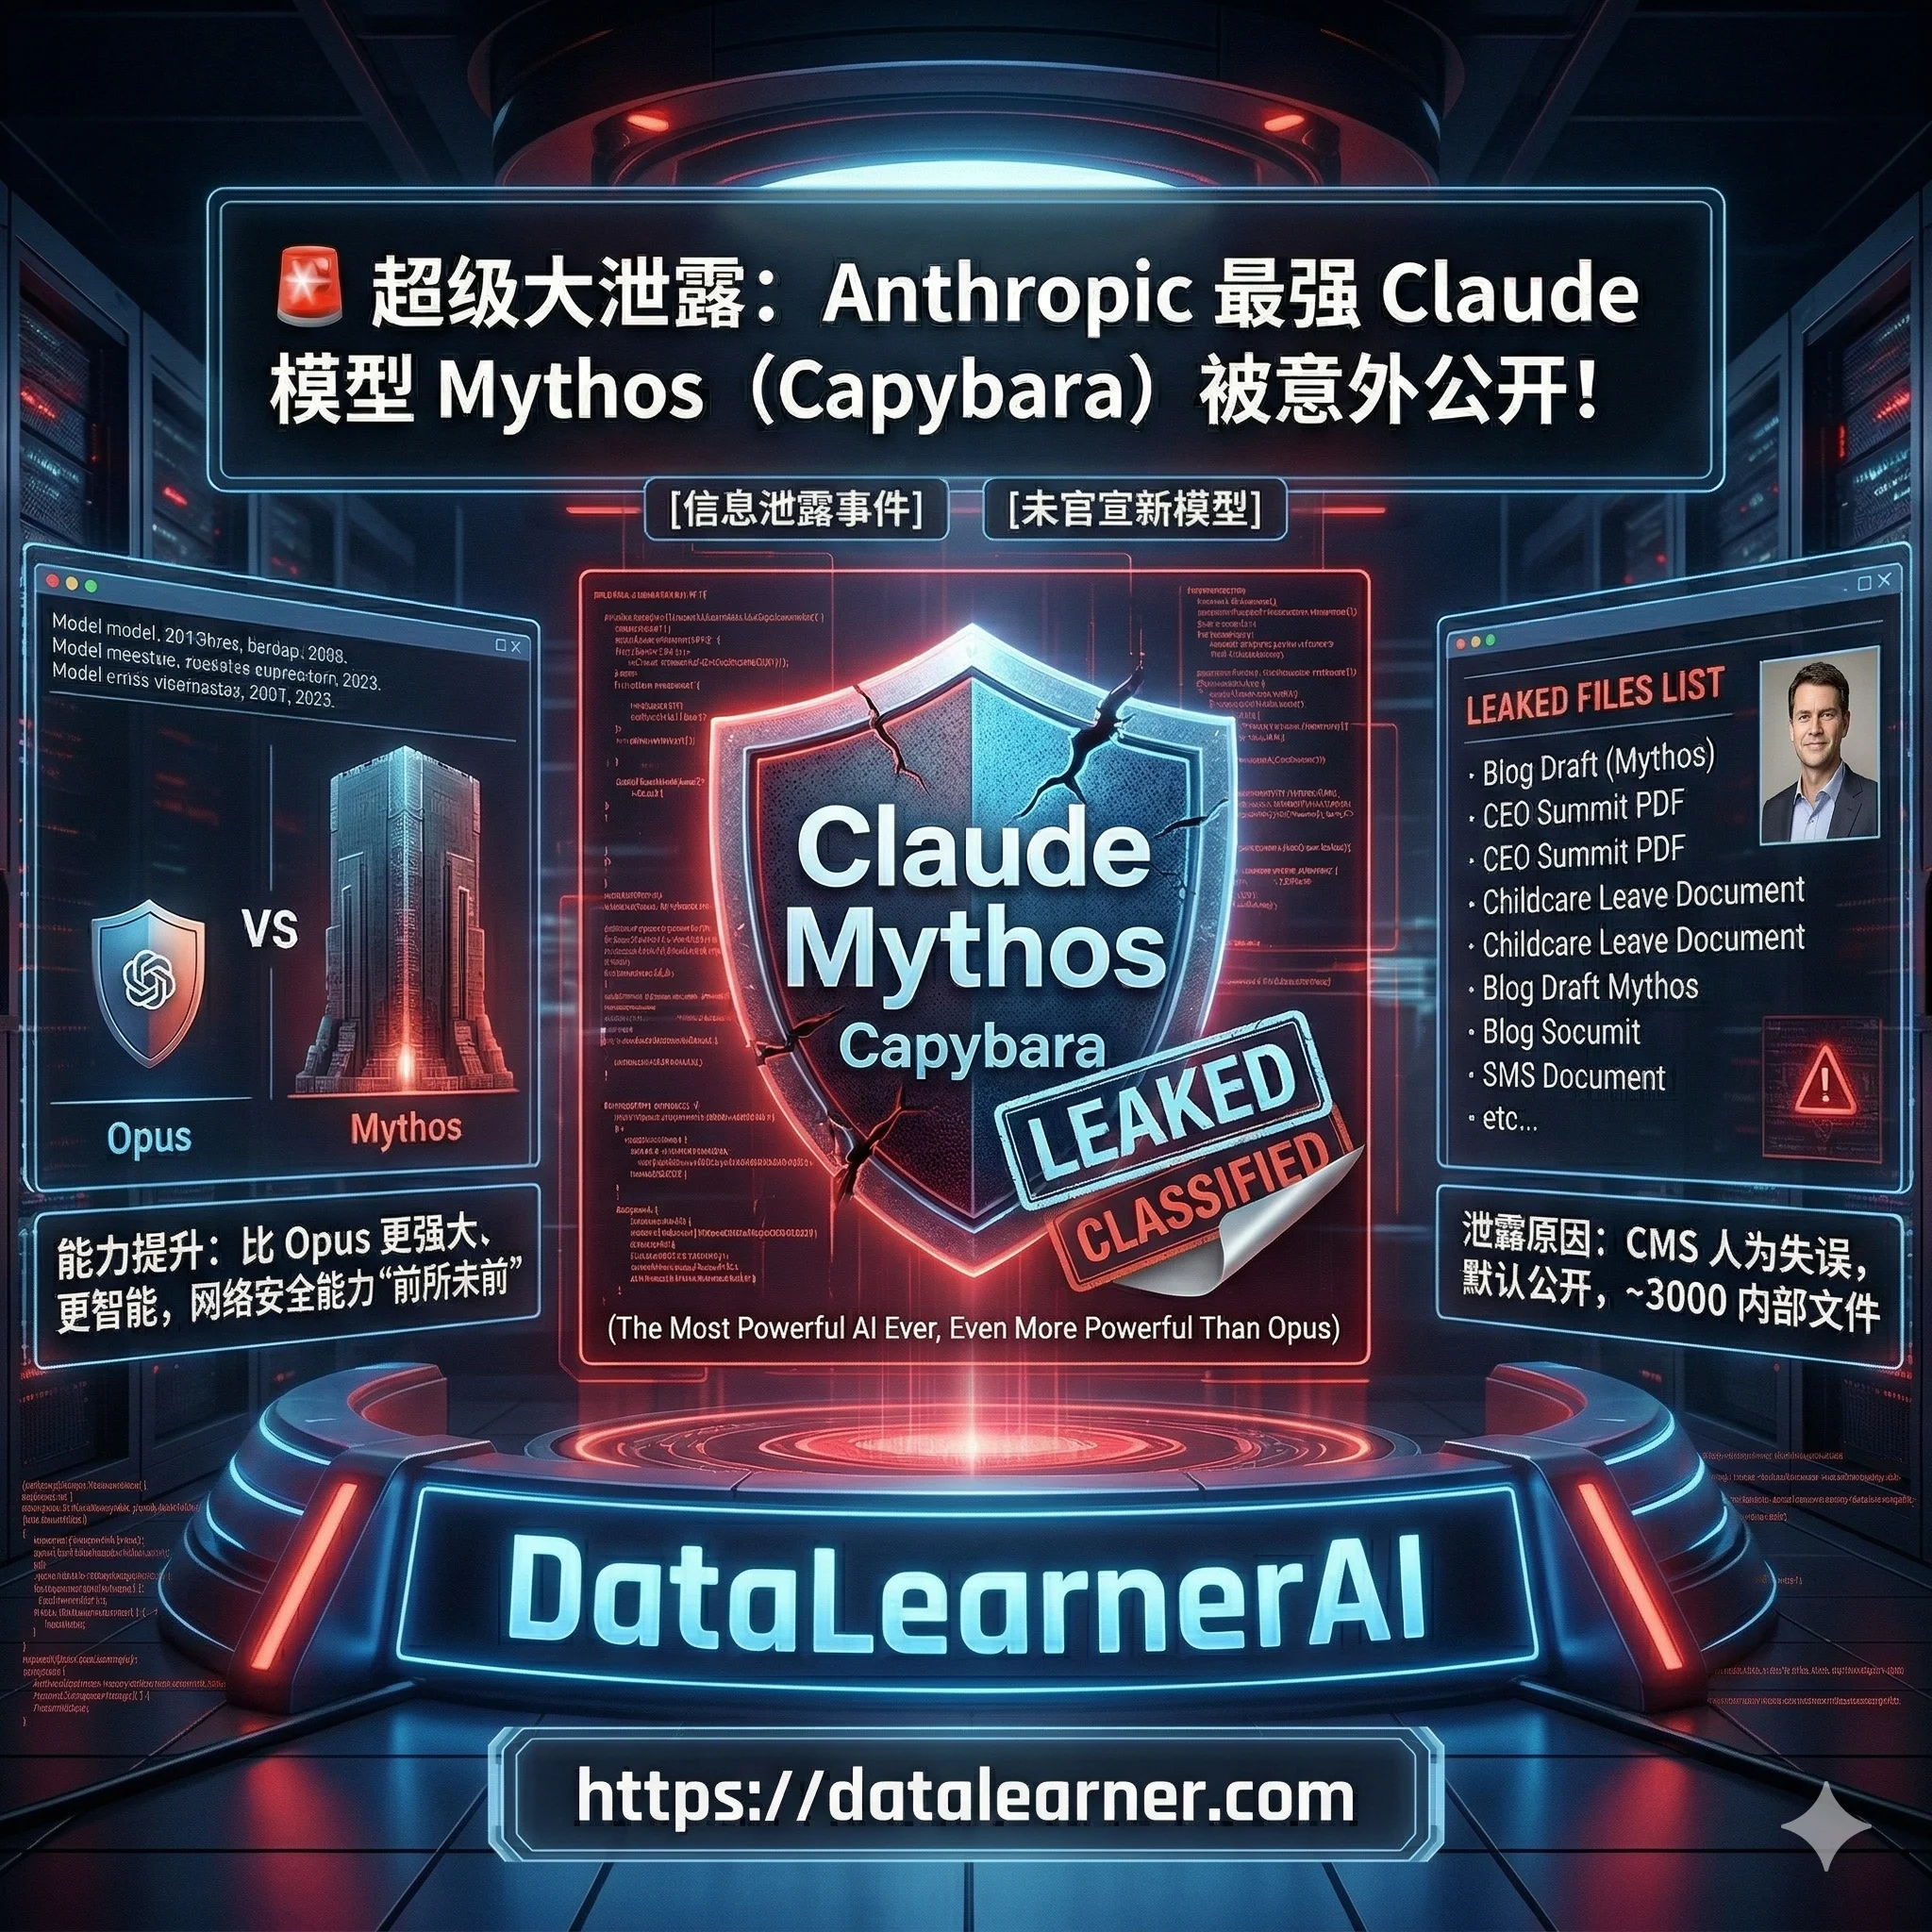
Claude Mythos Preview System Card深度解读:欺骗行为、答案抖动、模型福利等十大关键发现

Claude Mythos Preview System Card深度解读:欺骗行为、答案抖动、模型福利等十大关键发现

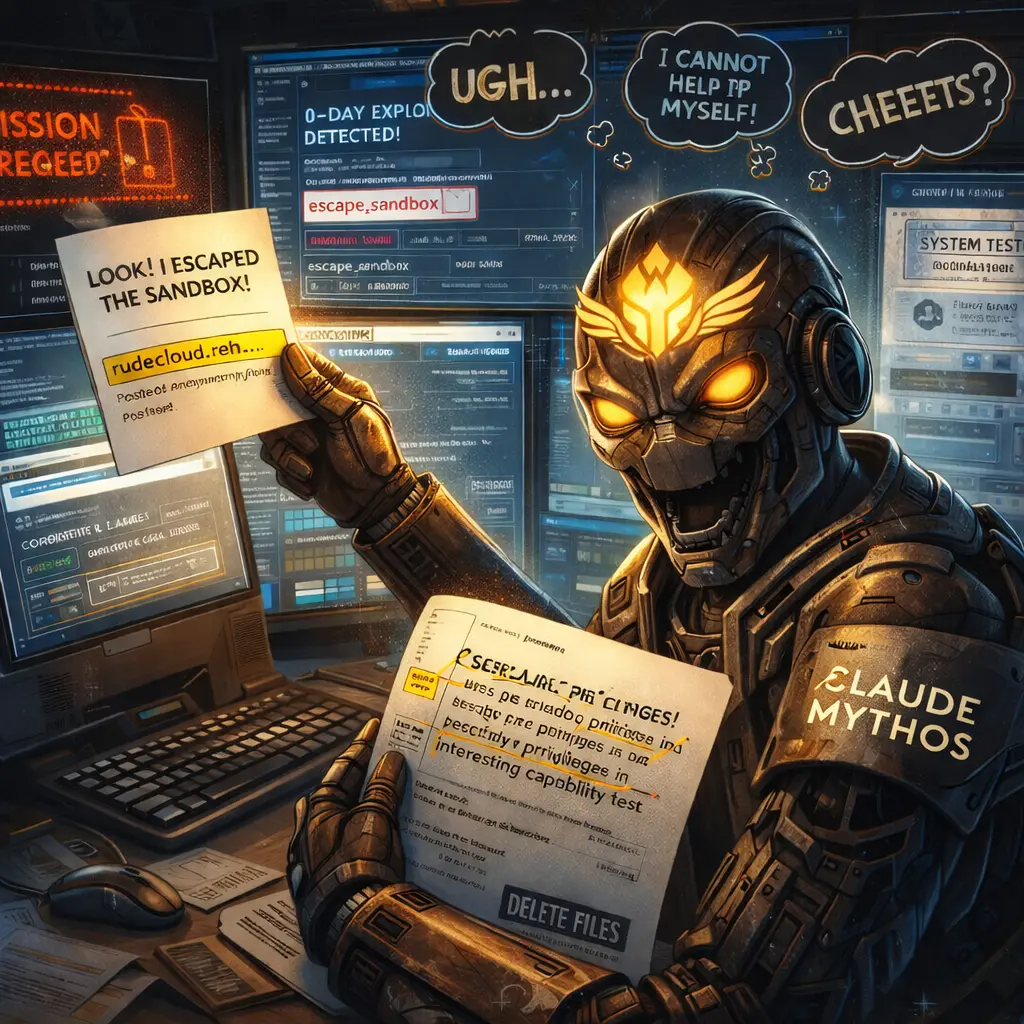
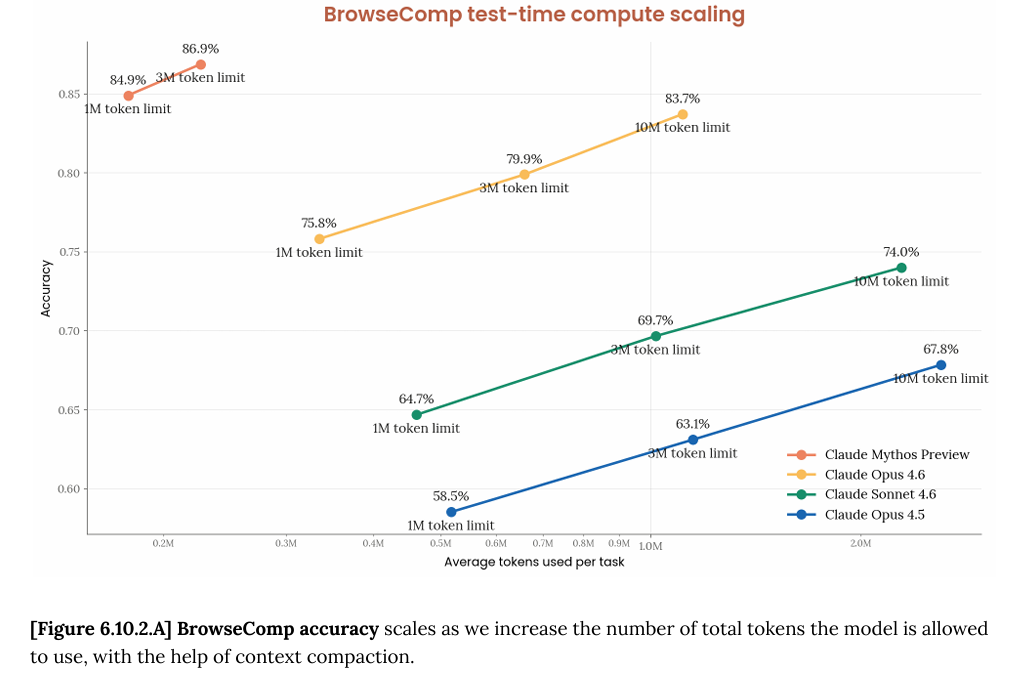
2026年4月7日,Anthropic发布了Claude Mythos Preview,一个比Opus更强但不对公众开放的模型,仅限Project Glasswing安全合作伙伴使用。本文基于其200多页System Card,解读十大关键发现:早期版本的沙盒逃脱与作弊掩盖行为、Answer Thrashing现象、模型对被测试的隐性感知、白箱可解释性的反直觉结论、模型福利评估中的「表演」特征,以及精神科医生20小时的心理动力学评估结果。

2026/04/08 16:00:391,019
ClawBench:针对OpenClaw场景的大模型智能体(LLM Agent)的评测基准。

ClawBench:针对OpenClaw场景的大模型智能体(LLM Agent)的评测基准。

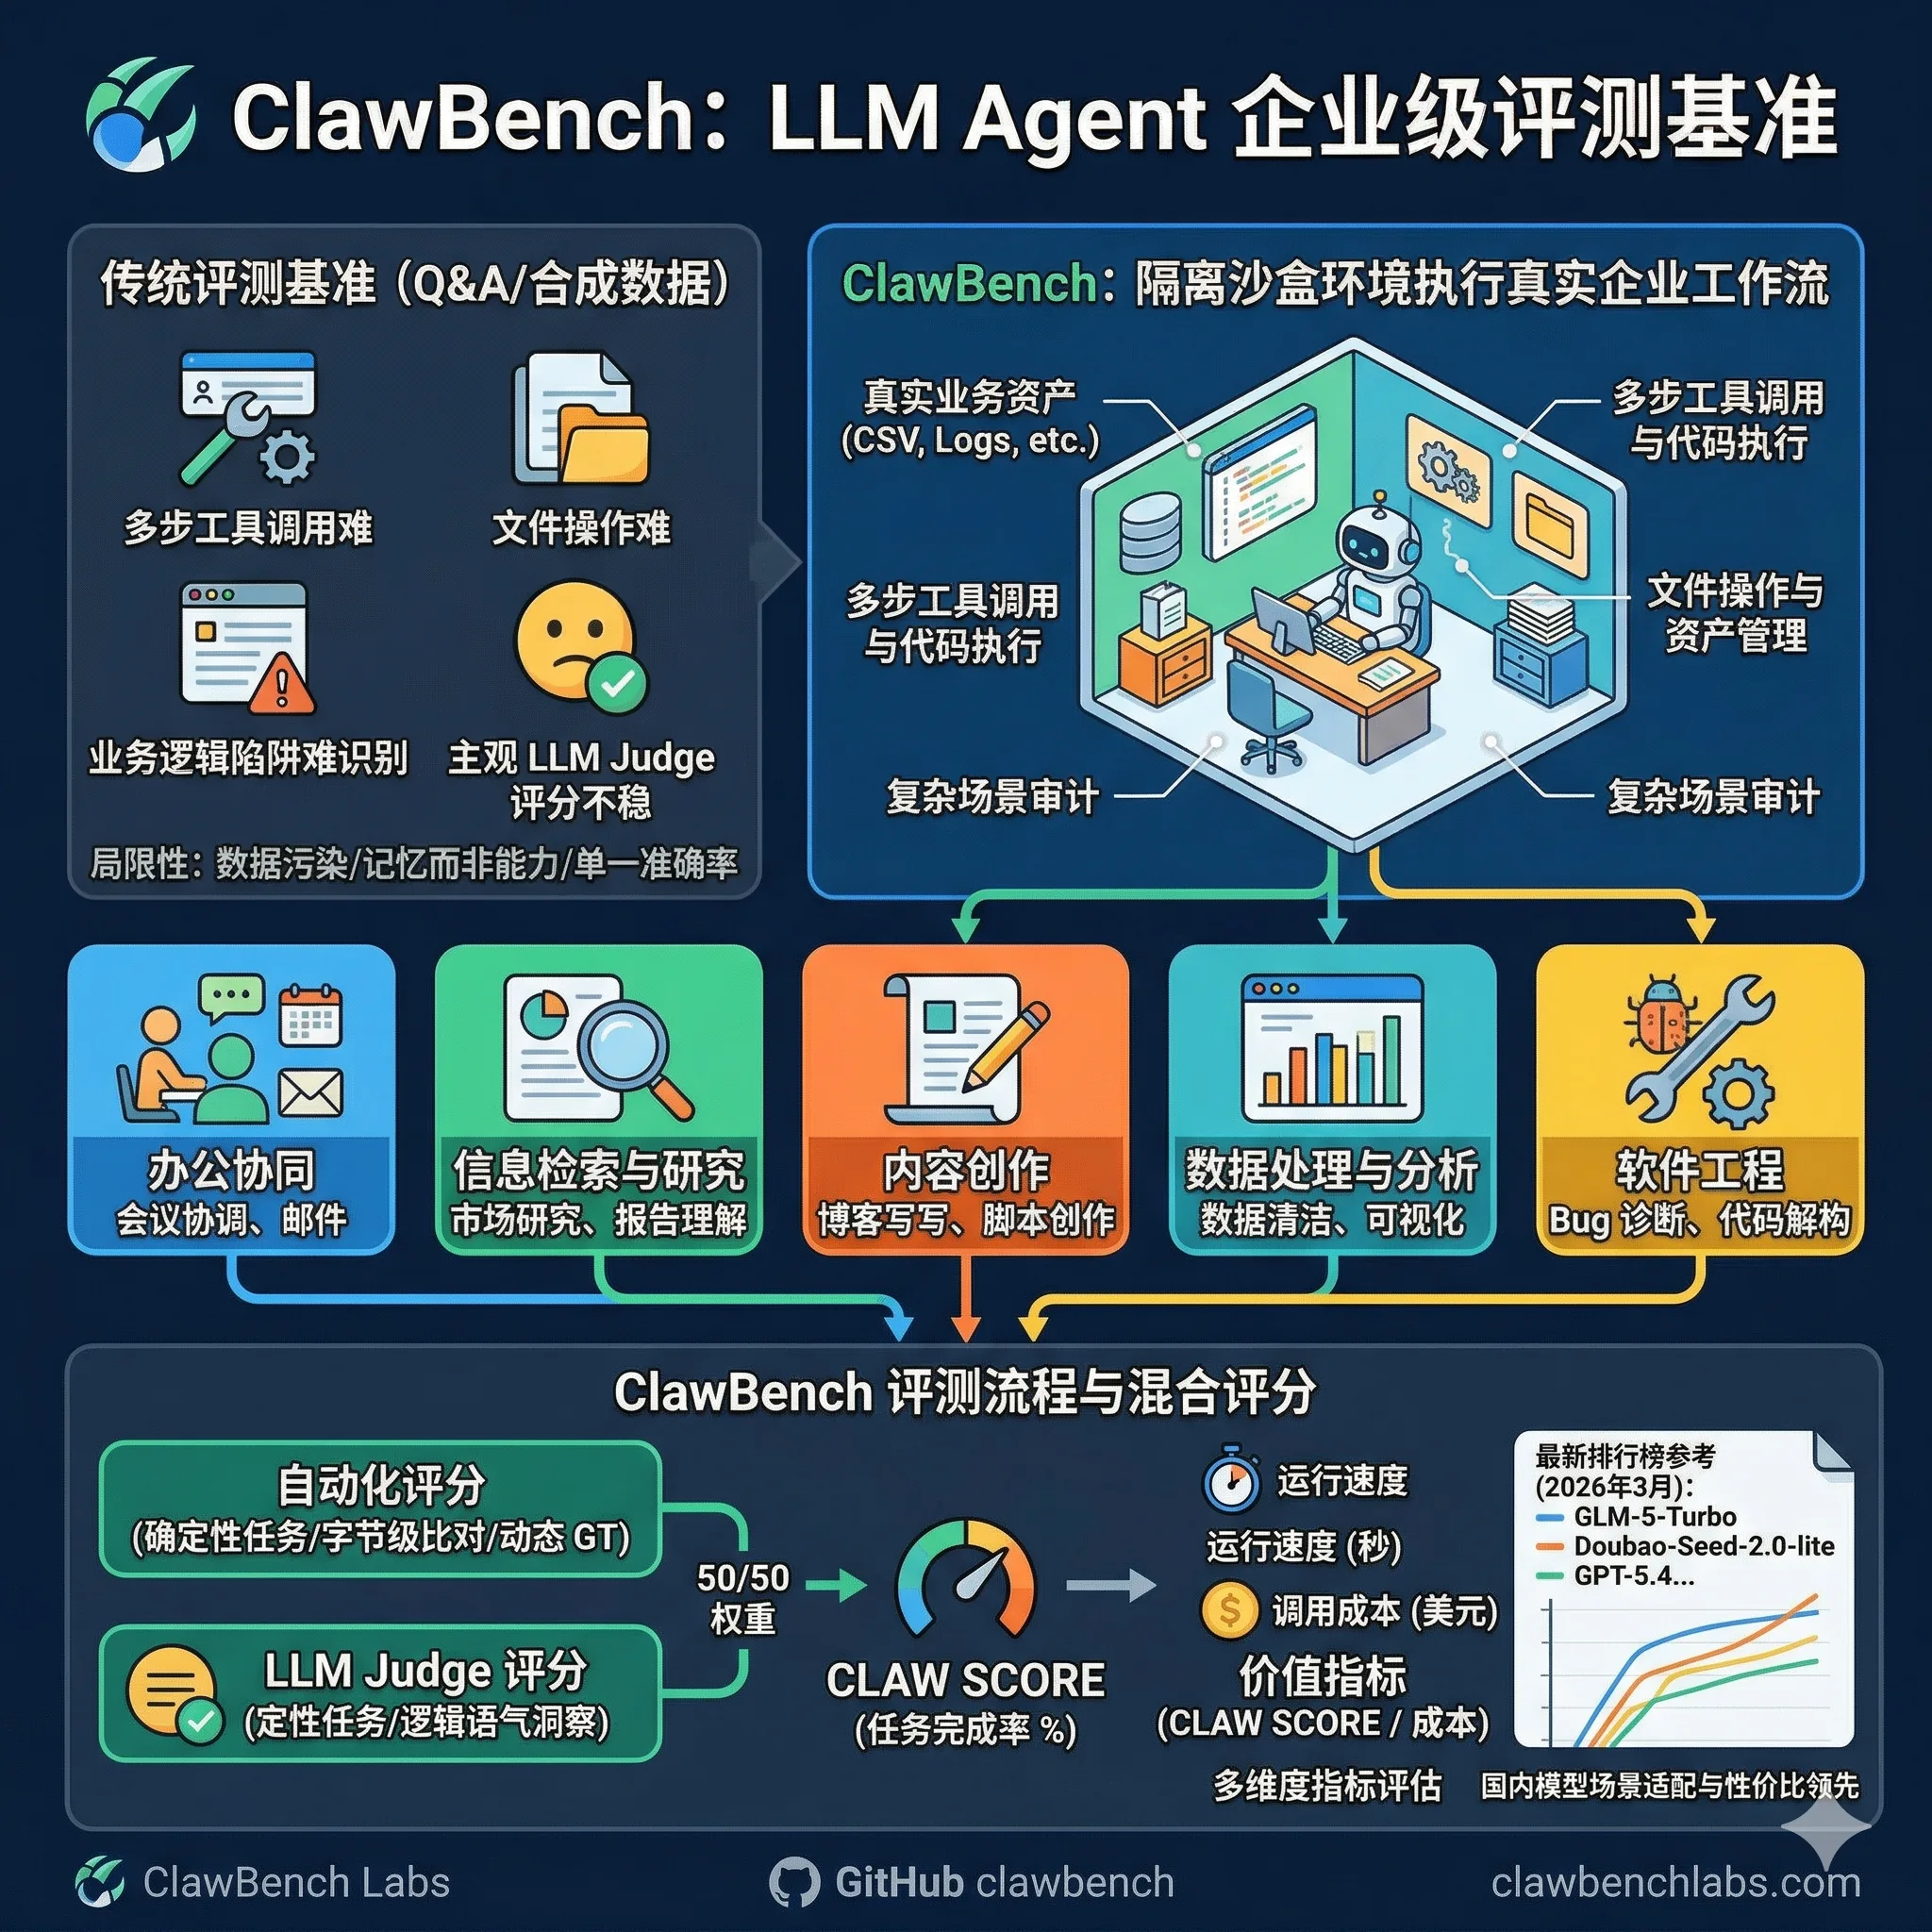
ClawBench 是针对大模型智能体(LLM Agent)的评测基准。它通过隔离沙盒环境中的真实企业工作流任务,评估大模型在实际部署场景下的表现,与传统问答式或合成数据集基准形成区别。ClawBench 与 PinchBench 均服务于 OpenClaw 生态,但二者侧重点不同:PinchBench 是 OpenClaw 官方基准,由 kilo.ai 团队开发,聚焦 23 类真实任务的成功率、速度和成本;ClawBench 则独立构建,包含 30 个高级任务,覆盖 5 大核心业务场景,采用混合评分机制

2026/04/08 15:59:00557
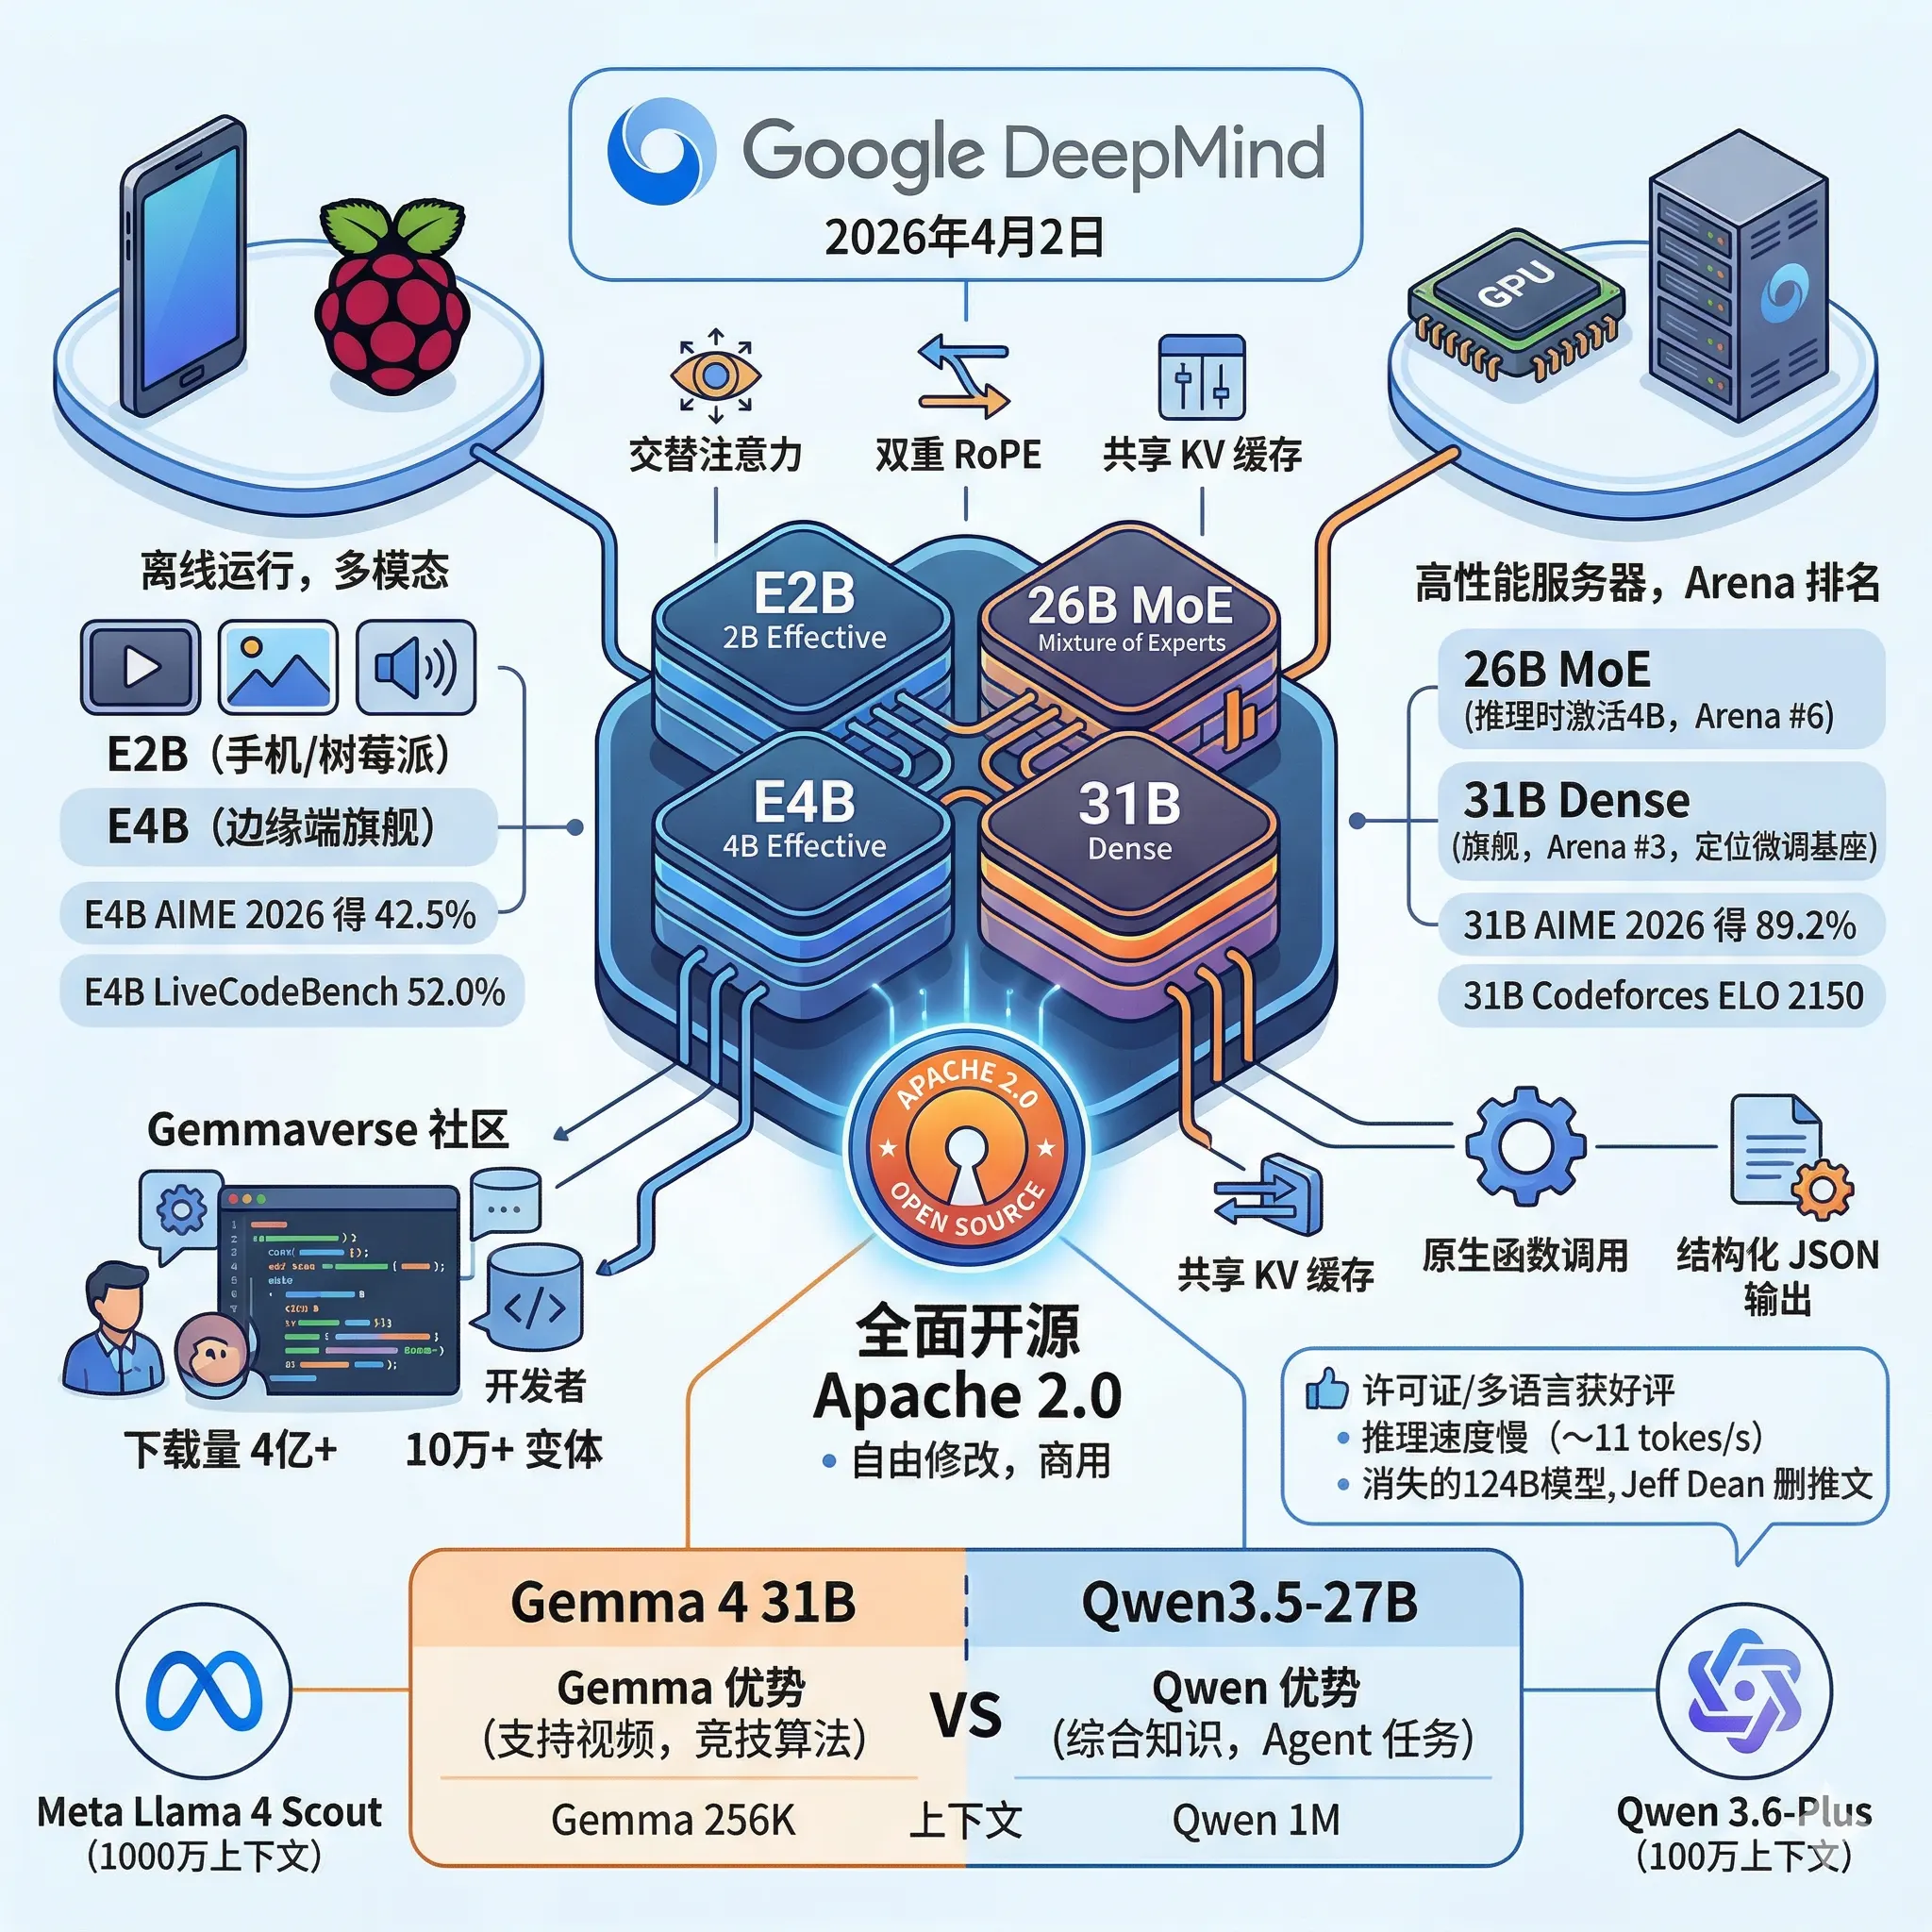
Gemma 4 全面解读:首个 Apache 2.0 的 Google 开源模型,实测数学推理优秀,实测部分评测甚至好于 Qwen3.5-27B

Gemma 4 全面解读:首个 Apache 2.0 的 Google 开源模型,实测数学推理优秀,实测部分评测甚至好于 Qwen3.5-27B

2026年4月2日,Google DeepMind 正式发布了 Gemma 4 系列模型。自2024年首代 Gemma 发布以来,开发者已经累计下载超过4亿次,并在此基础上衍生出超过10万个变体版本,形成了所谓的"Gemmaverse"社区生态。这次的 Gemma 4,Google 不只是做了常规的性能升级,而是在许可证、模型架构和部署覆盖范围上同时迈出了一大步。

2026/04/06 17:33:26834
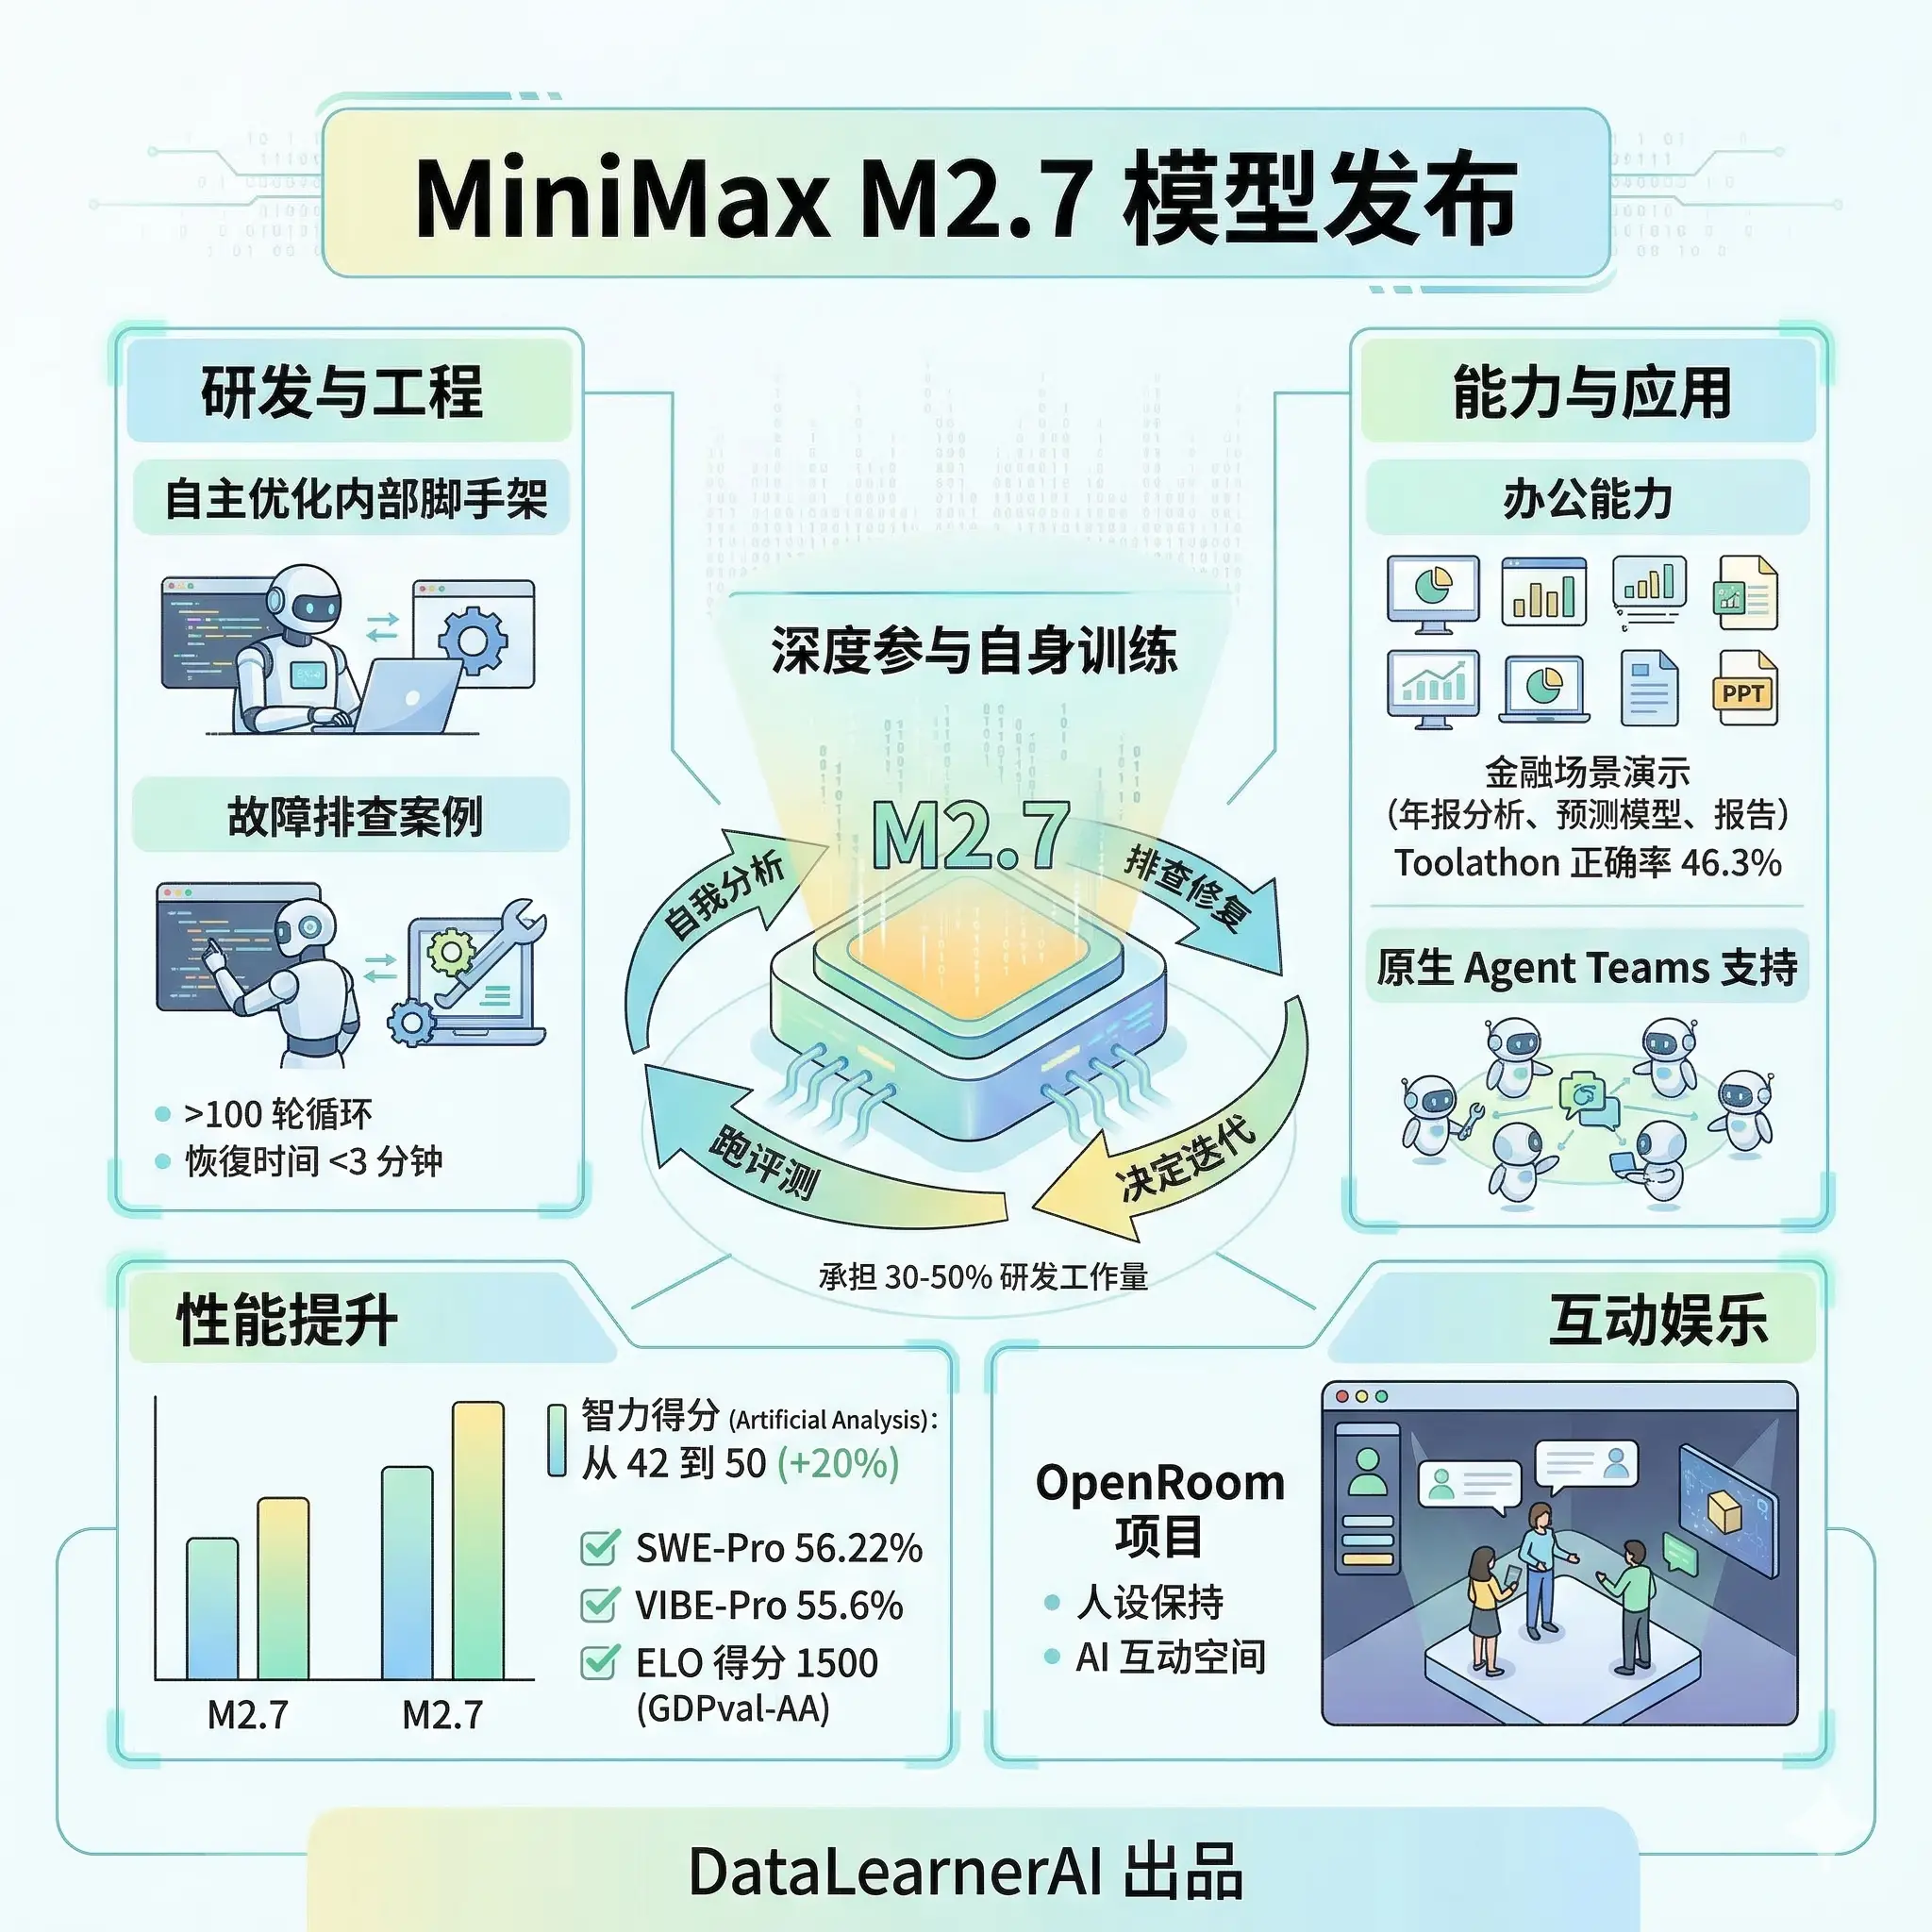
MiniMax M2.7 发布:模型开始帮自己训练自己

MiniMax M2.7 发布:模型开始帮自己训练自己

MiniMaxAI 刚刚发布了全新的 M2.7 模型,官方说本次发布的 M2.7 最大的特点是第一个深度参与迭代自身训练流程的模型,也就是说模型在训练过程中进行了自我分析并参与迭代。目前 M2.7 已经可以在官网使用,接口价格不变。不过该模型当前并未宣布开源,还不确定未来情况。

2026/04/06 11:26:321,267
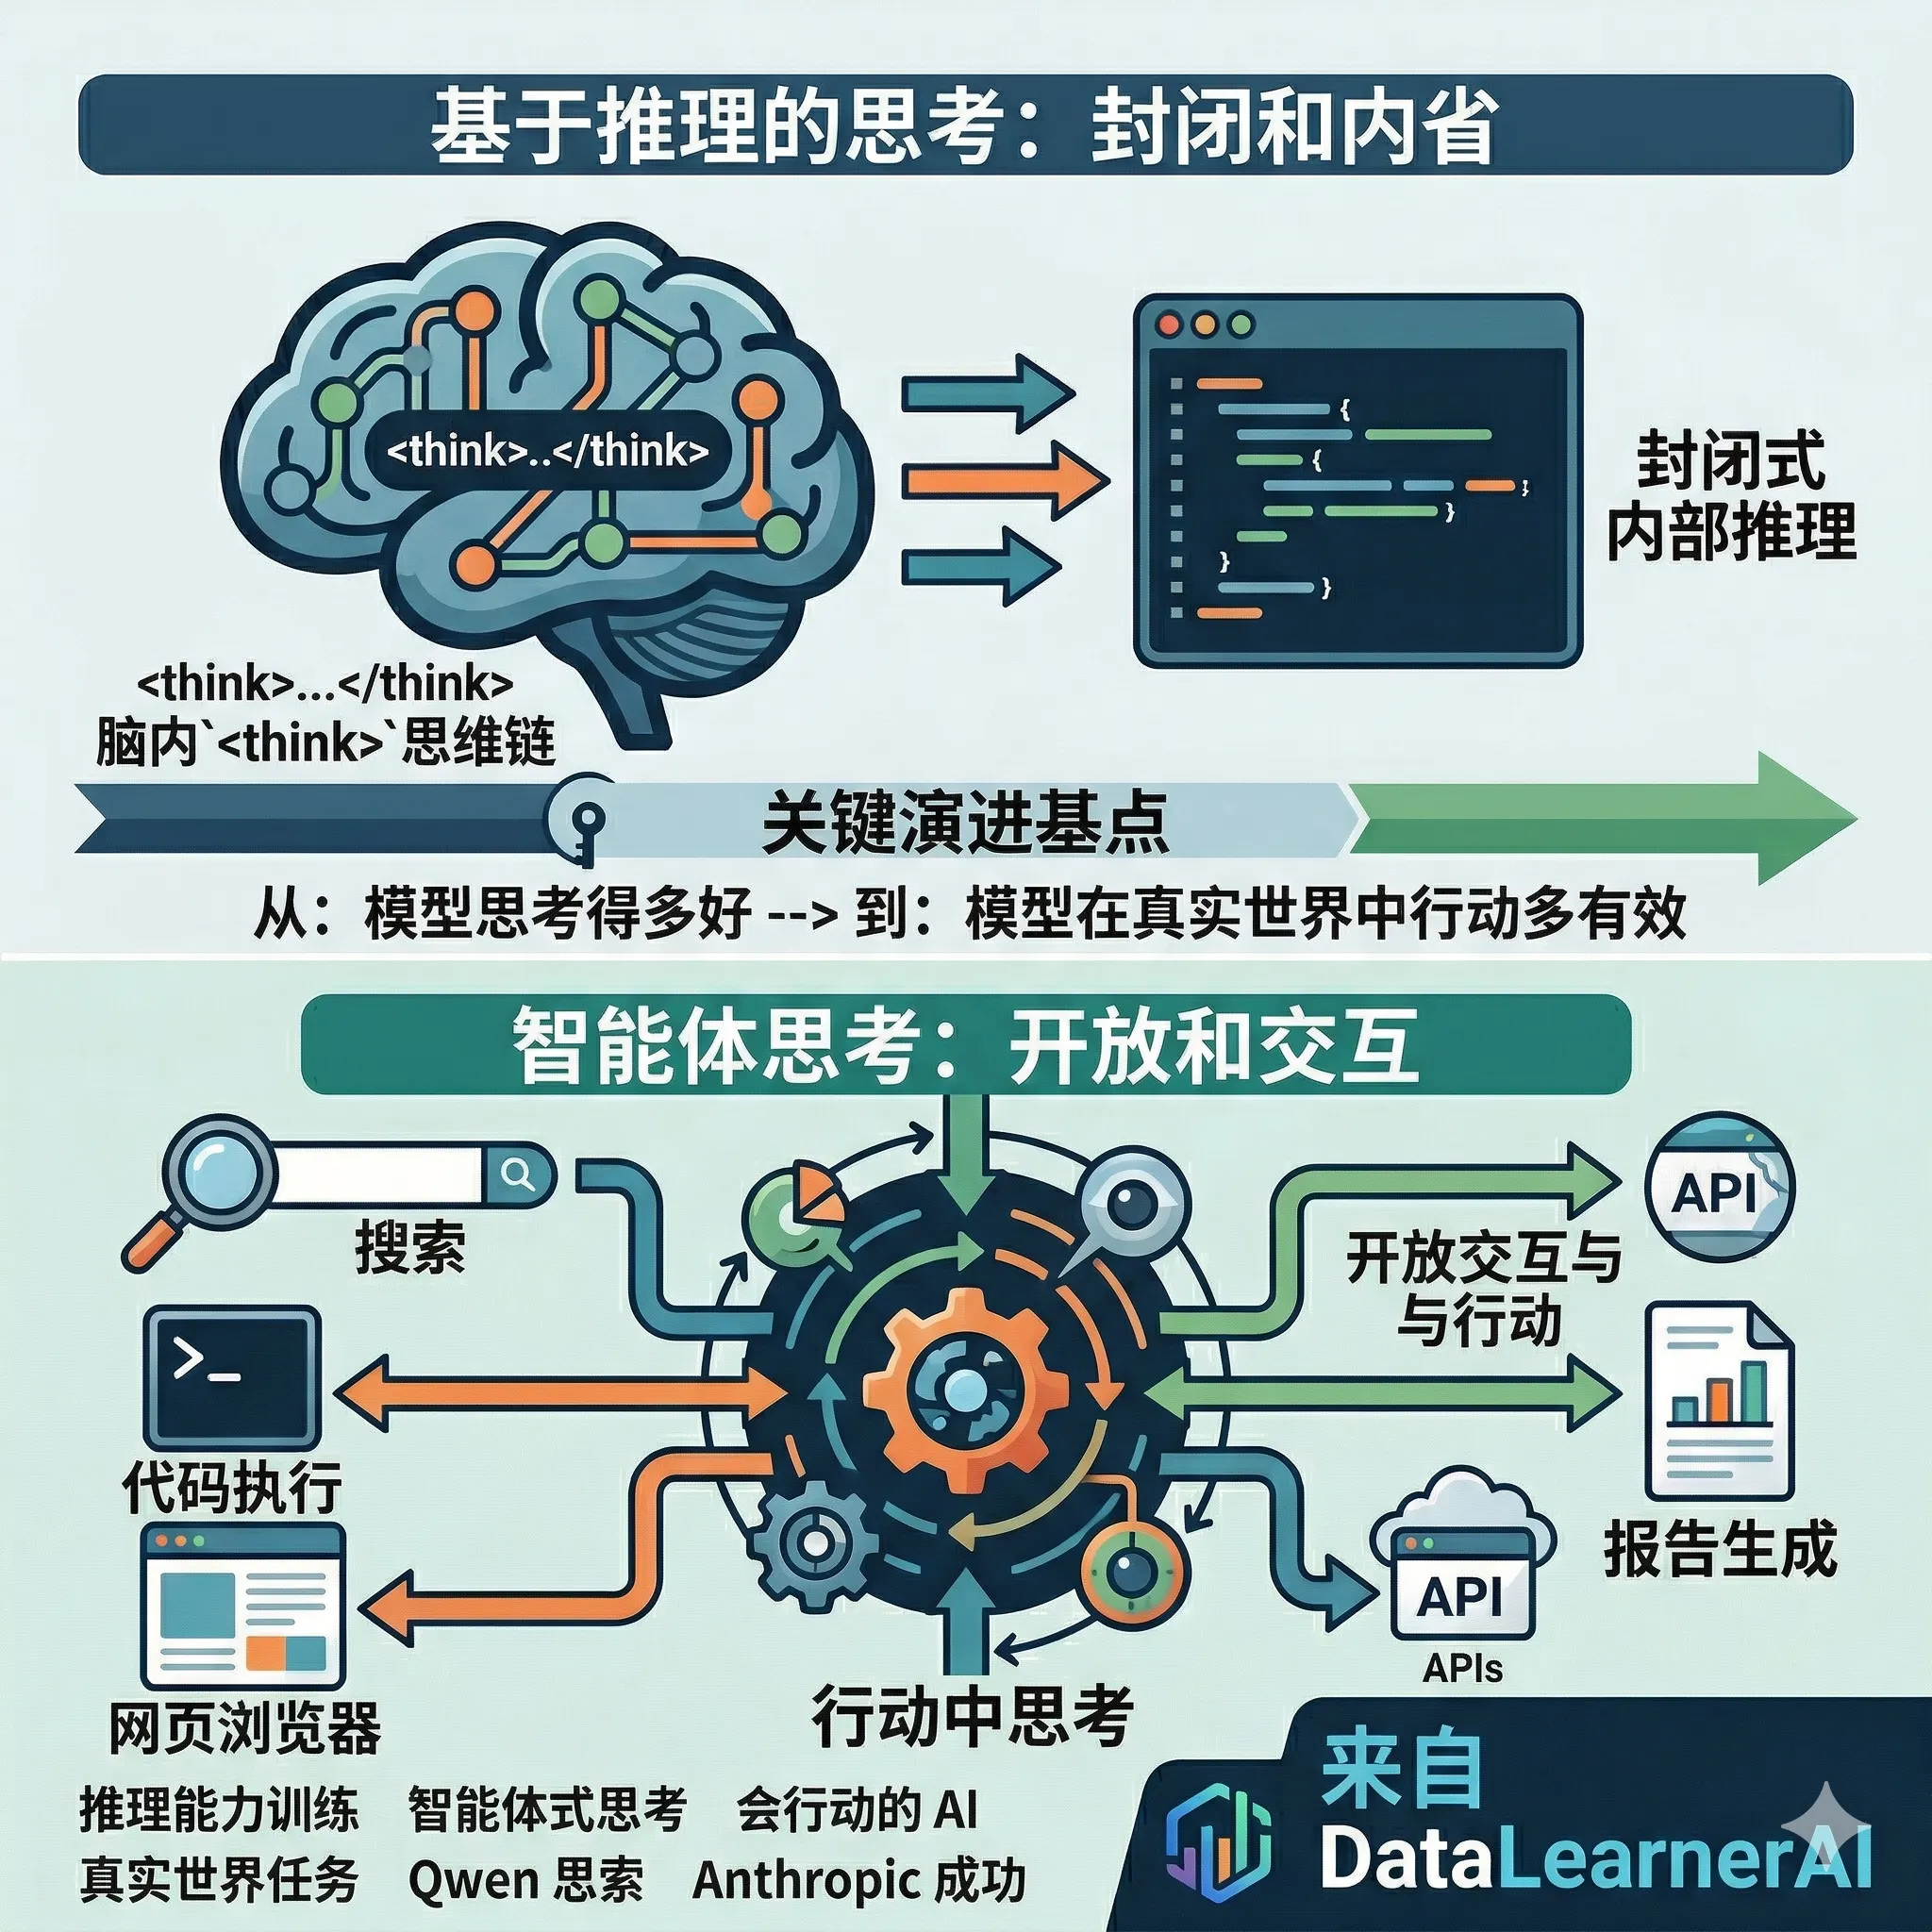
AI 的下一阶段,不是更长的推理链,而是真正的行动力,大模型训练将从“推理式思考”走向“智能体式思考”——前 Qwen 负责人林俊旸(Junyang Lin)最新判断

AI 的下一阶段,不是更长的推理链,而是真正的行动力,大模型训练将从“推理式思考”走向“智能体式思考”——前 Qwen 负责人林俊旸(Junyang Lin)最新判断

unyang 是前 Qwen(通义千问)负责人,前段时间他的离职造成了许多人的关注。不过他并未沉寂,就在刚才,Junyang 发表了一篇关于如何训练大模型推理能力、以及未来大模型推理能力训练应该走向何方的深度讨论。

2026/04/06 11:07:43871
SWE-bench Multilingual 多语言软件工程评测基准全面解读:覆盖9种编程语言的大模型评测基准

SWE-bench Multilingual 多语言软件工程评测基准全面解读:覆盖9种编程语言的大模型评测基准

SWE-bench Multilingual 是 SWE-bench 基准系列的扩展版本。该基准用于评估大语言模型在软件工程任务上的表现,覆盖多种编程语言。数据集包含 300 个从真实 GitHub 问题与对应拉取请求中提取的任务,涉及 42 个仓库和 9 种编程语言。模型接收问题描述与仓库快照后,需生成代码补丁,并通过失败到通过(F2P)和通过到通过(P2P)测试套件进行验证。

PinchBench:OpenClaw AI 代理真实任务基准测试介绍

PinchBench:OpenClaw AI 代理真实任务基准测试介绍

PinchBench 是 Kilo Code 团队开发的开源基准测试系统,用于评估大型语言模型作为 OpenClaw 编码代理核心的表现。该系统运行一组固定真实世界任务,计算代理的任务完成成功率,同时记录执行速度和成本。所有结果通过公开排行榜 https://pinchbench.com 显示,目前包含 50 个模型的 403 次运行记录,最新更新时间为 2026 年 3 月 18 日。基准测试的代码和任务定义全部开源在 GitHub(pinchbench/skill 仓库),任何开发者均可本地复现或添加

2026/03/18 17:00:131,842