DataLearner 标志
原创博客

原创AI技术博客

探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。

重磅!谷歌宣布发布Gemini 1.5 Pro,距离Gemini发布仅仅一个半月!最高支持1000万上下文长度,GSM8K评测全球第一

重磅!谷歌宣布发布Gemini 1.5 Pro,距离Gemini发布仅仅一个半月!最高支持1000万上下文长度,GSM8K评测全球第一

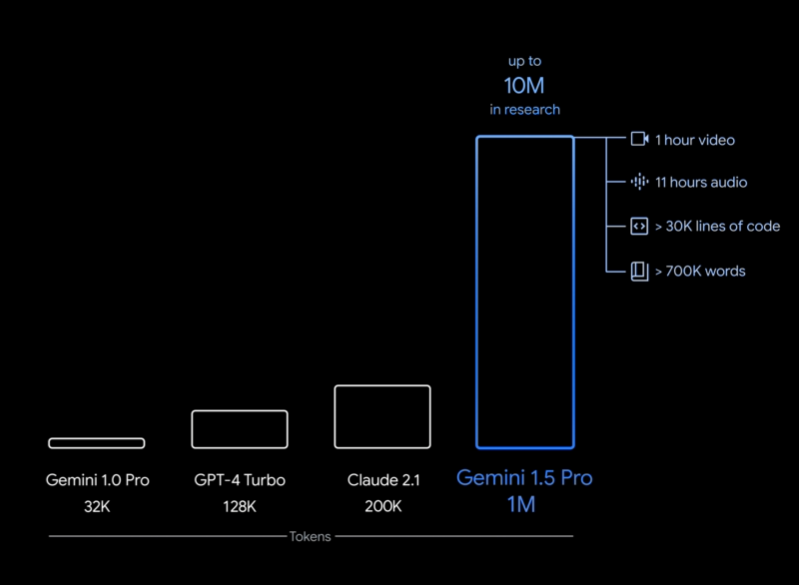
在2023年12月份,Google发布了Gemini系列大模型(参考:谷歌发布号称超过GPT-4V的大模型Gemini:4个版本,最大的Gemini的MMLU得分90.04,首次超过90的大模型),包含3个不同参数规模的版本。其中,Gemini Ultra号称在MMLU评测上超过了GPT-4,并且在月初也将Bard更名为Gemini,开放了Gemini Ultra的付费使用。刚刚,Google的CEO劈柴哥宣布发布了Gemini 1.5 Pro,这意味着仅仅一个半月,Gemini有了重大更新。
2024/02/16 00:04:221,707
Meta开源Llama3.3-70B-Instruct模型:大模型后训练的佳作,性能超越4050亿参数规模的Llama3.1-405B大模型!

Meta开源Llama3.3-70B-Instruct模型:大模型后训练的佳作,性能超越4050亿参数规模的Llama3.1-405B大模型!

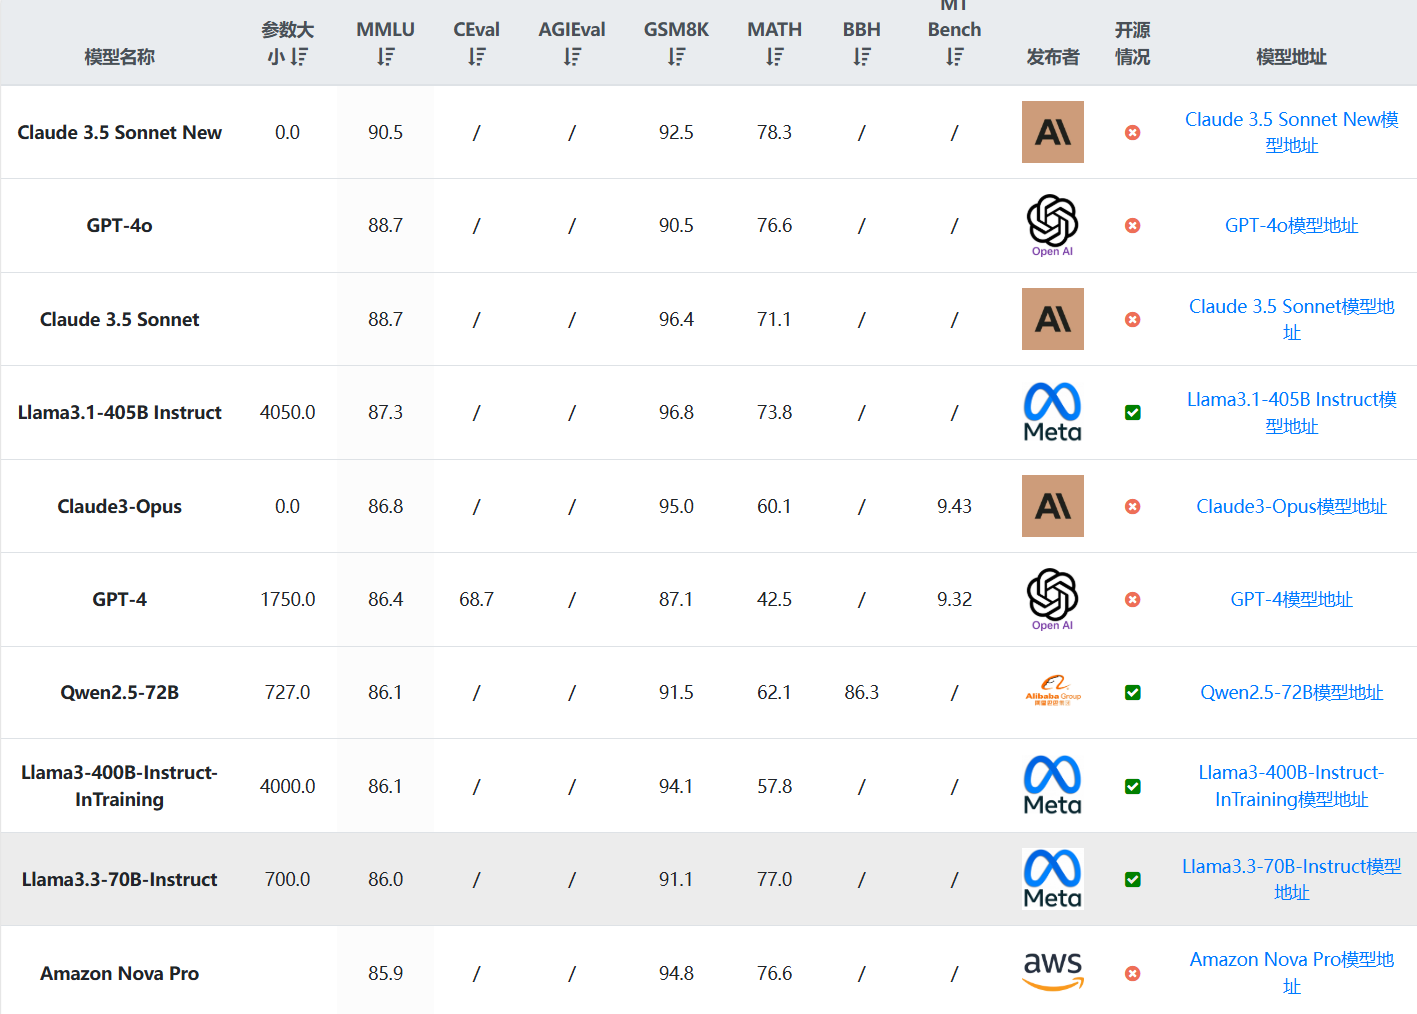
Llama系列大语言模型一直是开源领域的大模型标杆,Llama3系列大模型自从开源之后一直在不断更新。最早的Llama3模型于2024年4月开源,此后,几乎每个三个月都有一个新版本发布。就在昨天,Meta开源了最新的Llama3.3-70B模型,这是Llama3.3系列目前唯一开源的模型。尽管该模型的参数规模仅仅700亿,但是在多项评测基准上已经超过了4050亿参数规模的Llama3.1-405B,后者是Llama系列模型中参数规模最大的一个,也是业界开源模型中参数规模最高的模型之一。

2024/12/08 22:35:451,712
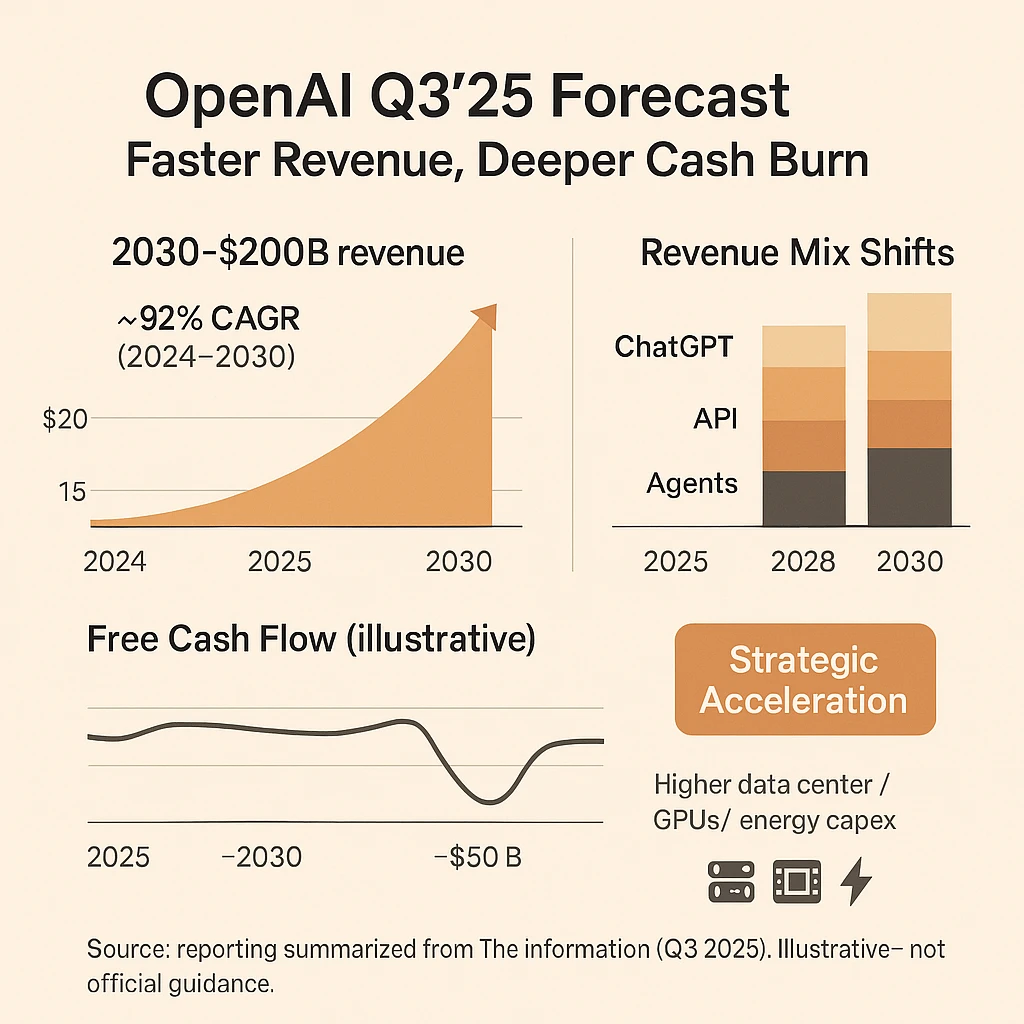
OpenAI收入大揭秘:2024年收入40亿美金,2030年预计达到2000亿,年均复合增长超90%!ChatGPT占比将逐年下降!

OpenAI收入大揭秘:2024年收入40亿美金,2030年预计达到2000亿,年均复合增长超90%!ChatGPT占比将逐年下降!

根据TheInformaiton的披露,近期OpenAI更新了他们最新财务预测(截至2025年第三季度)。这份收入预测展示了当前OpenAI的收入情况,并描绘了一幅引人注目的未来图景。与2025年第一季度OpenAI自己的预测相比,新数据不仅上调了收入预期,也揭示了公司因基础设施投入而面临的巨大现金消耗压力。本文将简单解读一下这份数据,包括OpenAI的收入情况,不同产品占比,如ChatGPT的比重等。

2025/09/06 20:21:001,726
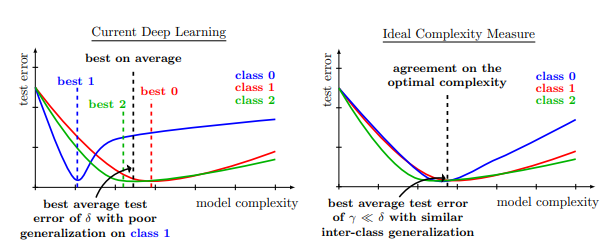
正则化和数据增强对模型的影响并不总是好的:The Effects of Regularization and Data Augmentation are Class Dependent

正则化和数据增强对模型的影响并不总是好的:The Effects of Regularization and Data Augmentation are Class Dependent

正则化是一种基本技术,通过限制模型的复杂性来防止过度拟合并提高泛化性能。目前的深度网络严重依赖正则化器,如数据增强(DA)或权重衰减,并采用结构风险最小化,即交叉验证,以选择最佳的正则化超参数。然而,正则化和数据增强对模型的影响也不一定总是好的。来自Meta AI研究人员最新的论文发现,正则化是否有效与类别高度相关。

2022/04/11 22:52:181,734
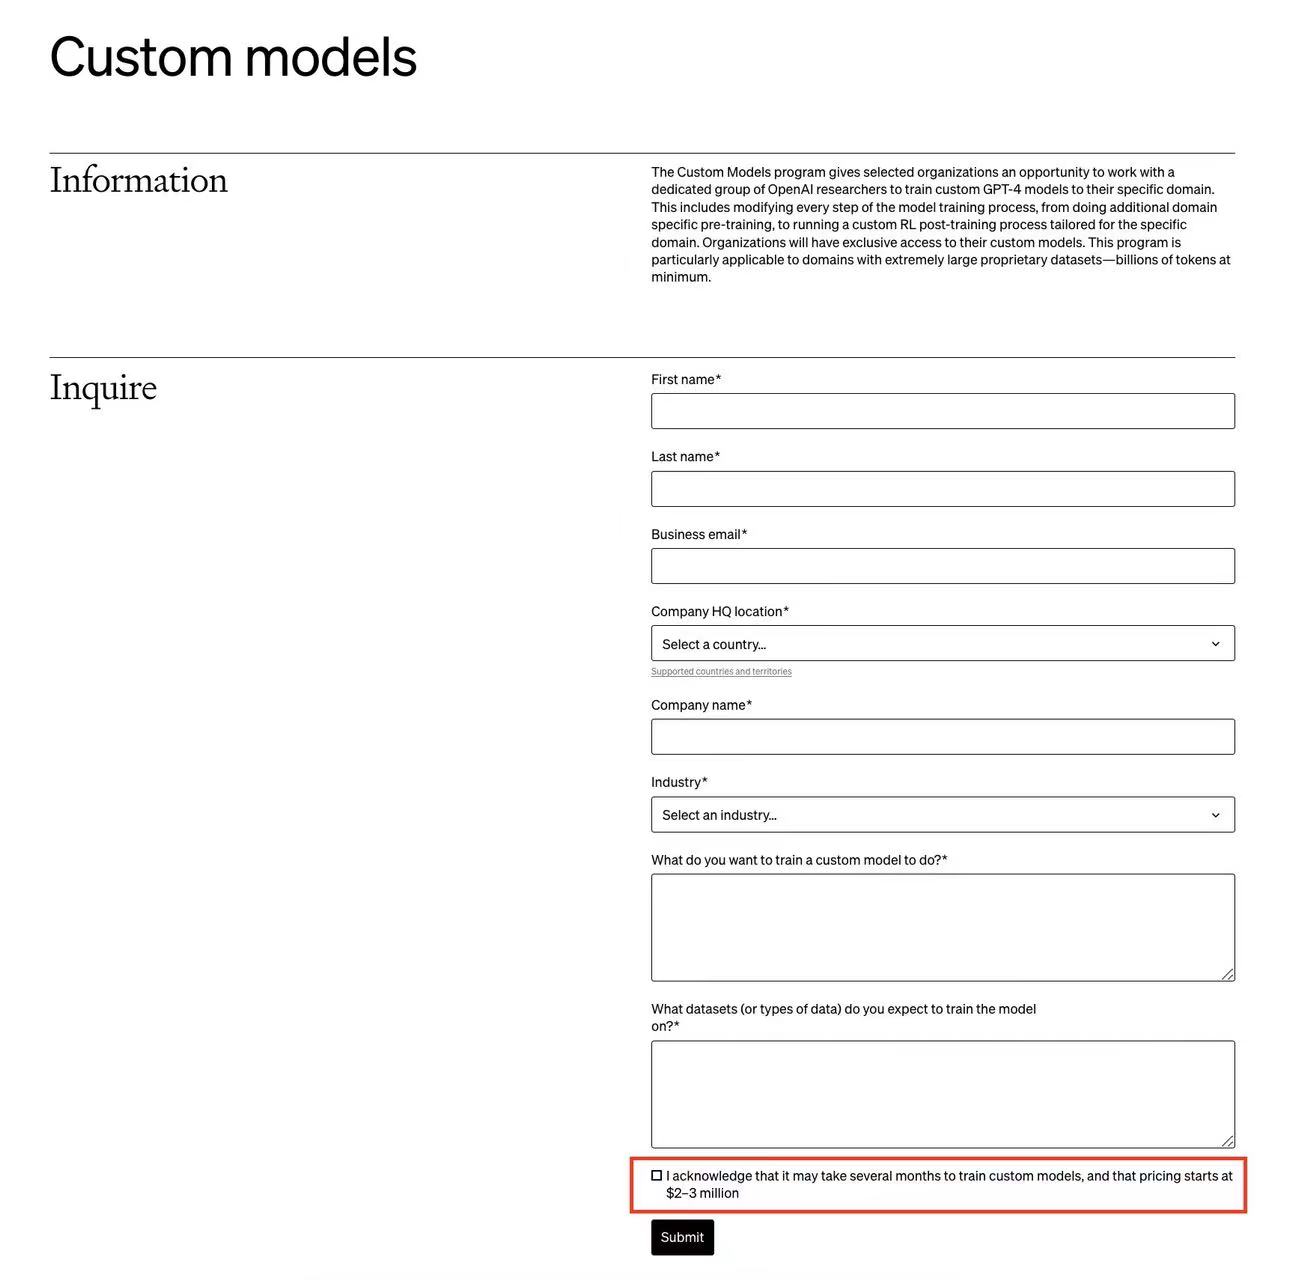
为企业单独定制训练一个GPT-4要多少钱?OpenAI说几个月,200-300万美元起步!

为企业单独定制训练一个GPT-4要多少钱?OpenAI说几个月,200-300万美元起步!

OpenAI的开发者日发布了许多更新。其中,普通用户可以微调GPT-4是非常值得期待的功能之一。但是,OpenAI还有一个针对企业的定制化GPT-4的训练服务,称为Custom Models。而这项为企业单独定制的GPT-4训练服务最新截图显示,需要几个月来训练模型,而且费用是200-300万美元起步!

2023/11/07 19:51:131,736
Python3.11最新特性来了,多个好特性提升!

Python3.11最新特性来了,多个好特性提升!

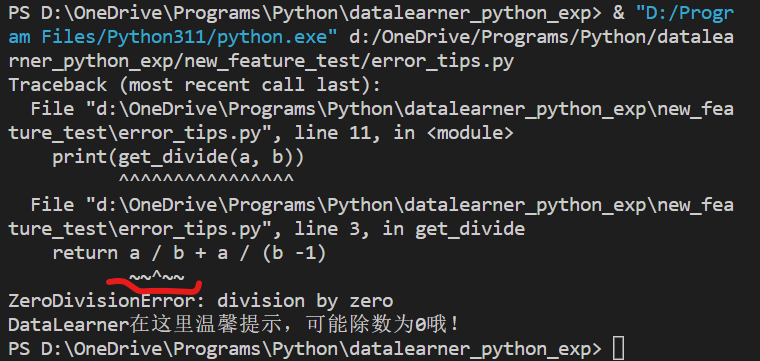
上个月Python的3.11版本发布了第一个beta版本,3.11带来了很多非常棒的新特性,例如错误提示更加具体,可以定位到具体代码位置等,十分友好,建议大家关注。这里简单为大家介绍一下。

2022/07/02 18:11:461,737
数学推理能力超过ChatGPT-3.5:微软与中科院研究人员合作最新的开源大模型WizardMath发布!开源模型第一,免费商用授权!

数学推理能力超过ChatGPT-3.5:微软与中科院研究人员合作最新的开源大模型WizardMath发布!开源模型第一,免费商用授权!

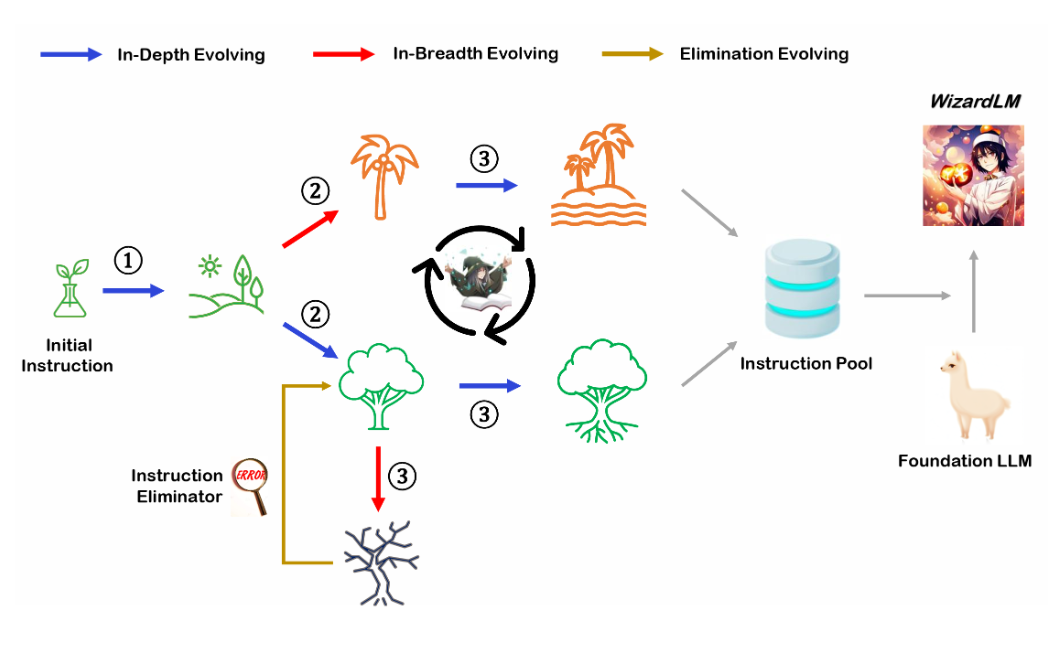
WizardLM是微软联合北京大学开源的一个大语言模型。此前,发布的WizardLM和WizardCoder都是业界开源领域最强的大模型。其中,前者是针对指令优化的大模型,而后者则是针对编程优化的大模型。而此次WizardMath则是他们发布的第三个大模型系列,主要是针对数学推理优化的大模型。在GSM8K的评测上,WizardMath得分超过了ChatGPT-3.5、Claude Instant-1等闭源商业模型,得分十分逆天!

2023/08/13 23:45:441,747
Anthropic发布Claude3.5-Sonnet模型,超过Claude3系列所有模型的能力,并且支持多模态!

Anthropic发布Claude3.5-Sonnet模型,超过Claude3系列所有模型的能力,并且支持多模态!

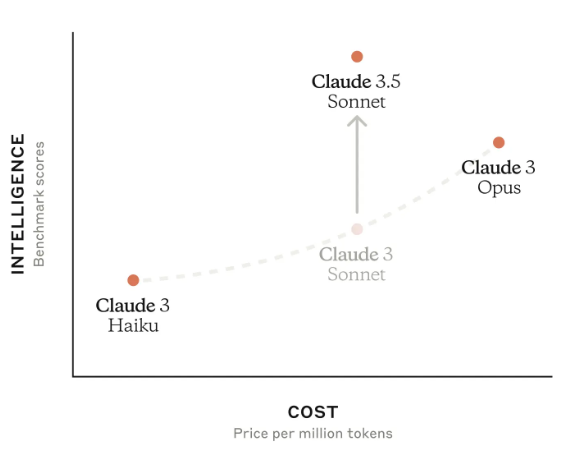
Claude系列模型是Anthropic发布的大模型,一直被认为是最接近GPT-4系列的大模型。2024年3月份,Anthropic发布了Claude3系列,从各方的使用情况看,都接近甚至超过了GPT-4。时隔三个月,Anthropic再次发布全新3.5版本的Claude3.5系列。本次首先发布的是Claude3.5-Sonnet版本。已经支持免费使用。

2024/06/20 23:36:261,751
向量大模型新选择,阿里开源向量大模型Qwen-Embedding和重排序大模型Qwen-Reranker,开源向量检索能力第一名!完全免费开源。

向量大模型新选择,阿里开源向量大模型Qwen-Embedding和重排序大模型Qwen-Reranker,开源向量检索能力第一名!完全免费开源。

阿里巴巴Qwen团队发布了全新的Qwen3 Embedding系列模型,这是一套基于Qwen3基础模型构建的专用文本向量与重排(Reranking)模型。该系列模型凭借Qwen3强大的多语言理解能力,在多项文本向量与重排任务的Benchmark上达到了SOTA水平,其中8B尺寸的向量模型在MTEB多语言排行榜上排名第一。Qwen3 Reranker模型在多个评测基准上同样大幅超越了现有的主流开源竞品。

2025/06/08 22:01:381,752
Kimi开源K2大模型:全球首个开源可商用的1万亿参数规模大模型,MoE架构,评测结果与DeepSeekV3相当,但模型文件有1TB!

Kimi开源K2大模型:全球首个开源可商用的1万亿参数规模大模型,MoE架构,评测结果与DeepSeekV3相当,但模型文件有1TB!

Kimi K2是由Moonshot AI最新推出的旗舰级大模型,首次将开放Agentic Intelligence(自主代理智能)与强大工具调用能力有机整合。它不仅在知识推理、数学、代码等传统“非思维模型”任务上展现出全球领先的能力,还特别针对一系列实际Agentic(自动决策与操作型)任务进行了深度优化。在业内,这代表AI模型正从“只会答题”向“能自主完成复杂任务”转变。K2模型完全开源,可免费商用授权。

2025/07/12 09:36:271,760
检索增强生成中的挑战详解:哪些因素影响了检索增强生成的质量?需要如何应对?

检索增强生成中的挑战详解:哪些因素影响了检索增强生成的质量?需要如何应对?

检索增强生成(Retrieval-augmented Generation,RAG)是一种结合了检索和大模型生成的方法。它从一个大型知识库中检索与输入相关的信息,然后利用这些信息作为上下文和问题一起输入给大语言模型,并让大语言模型基于这些信息生成答案的方式。检索增强生成可以让大语言模型与最新的外部数据或者知识连接,进而可以基于最新的知识和数据回答问题。尽管检索增强生成是一种很好的补充方法,但是,如果文档切分有问题、检索不准确,结果也是不好的。

2023/10/27 11:46:081,766
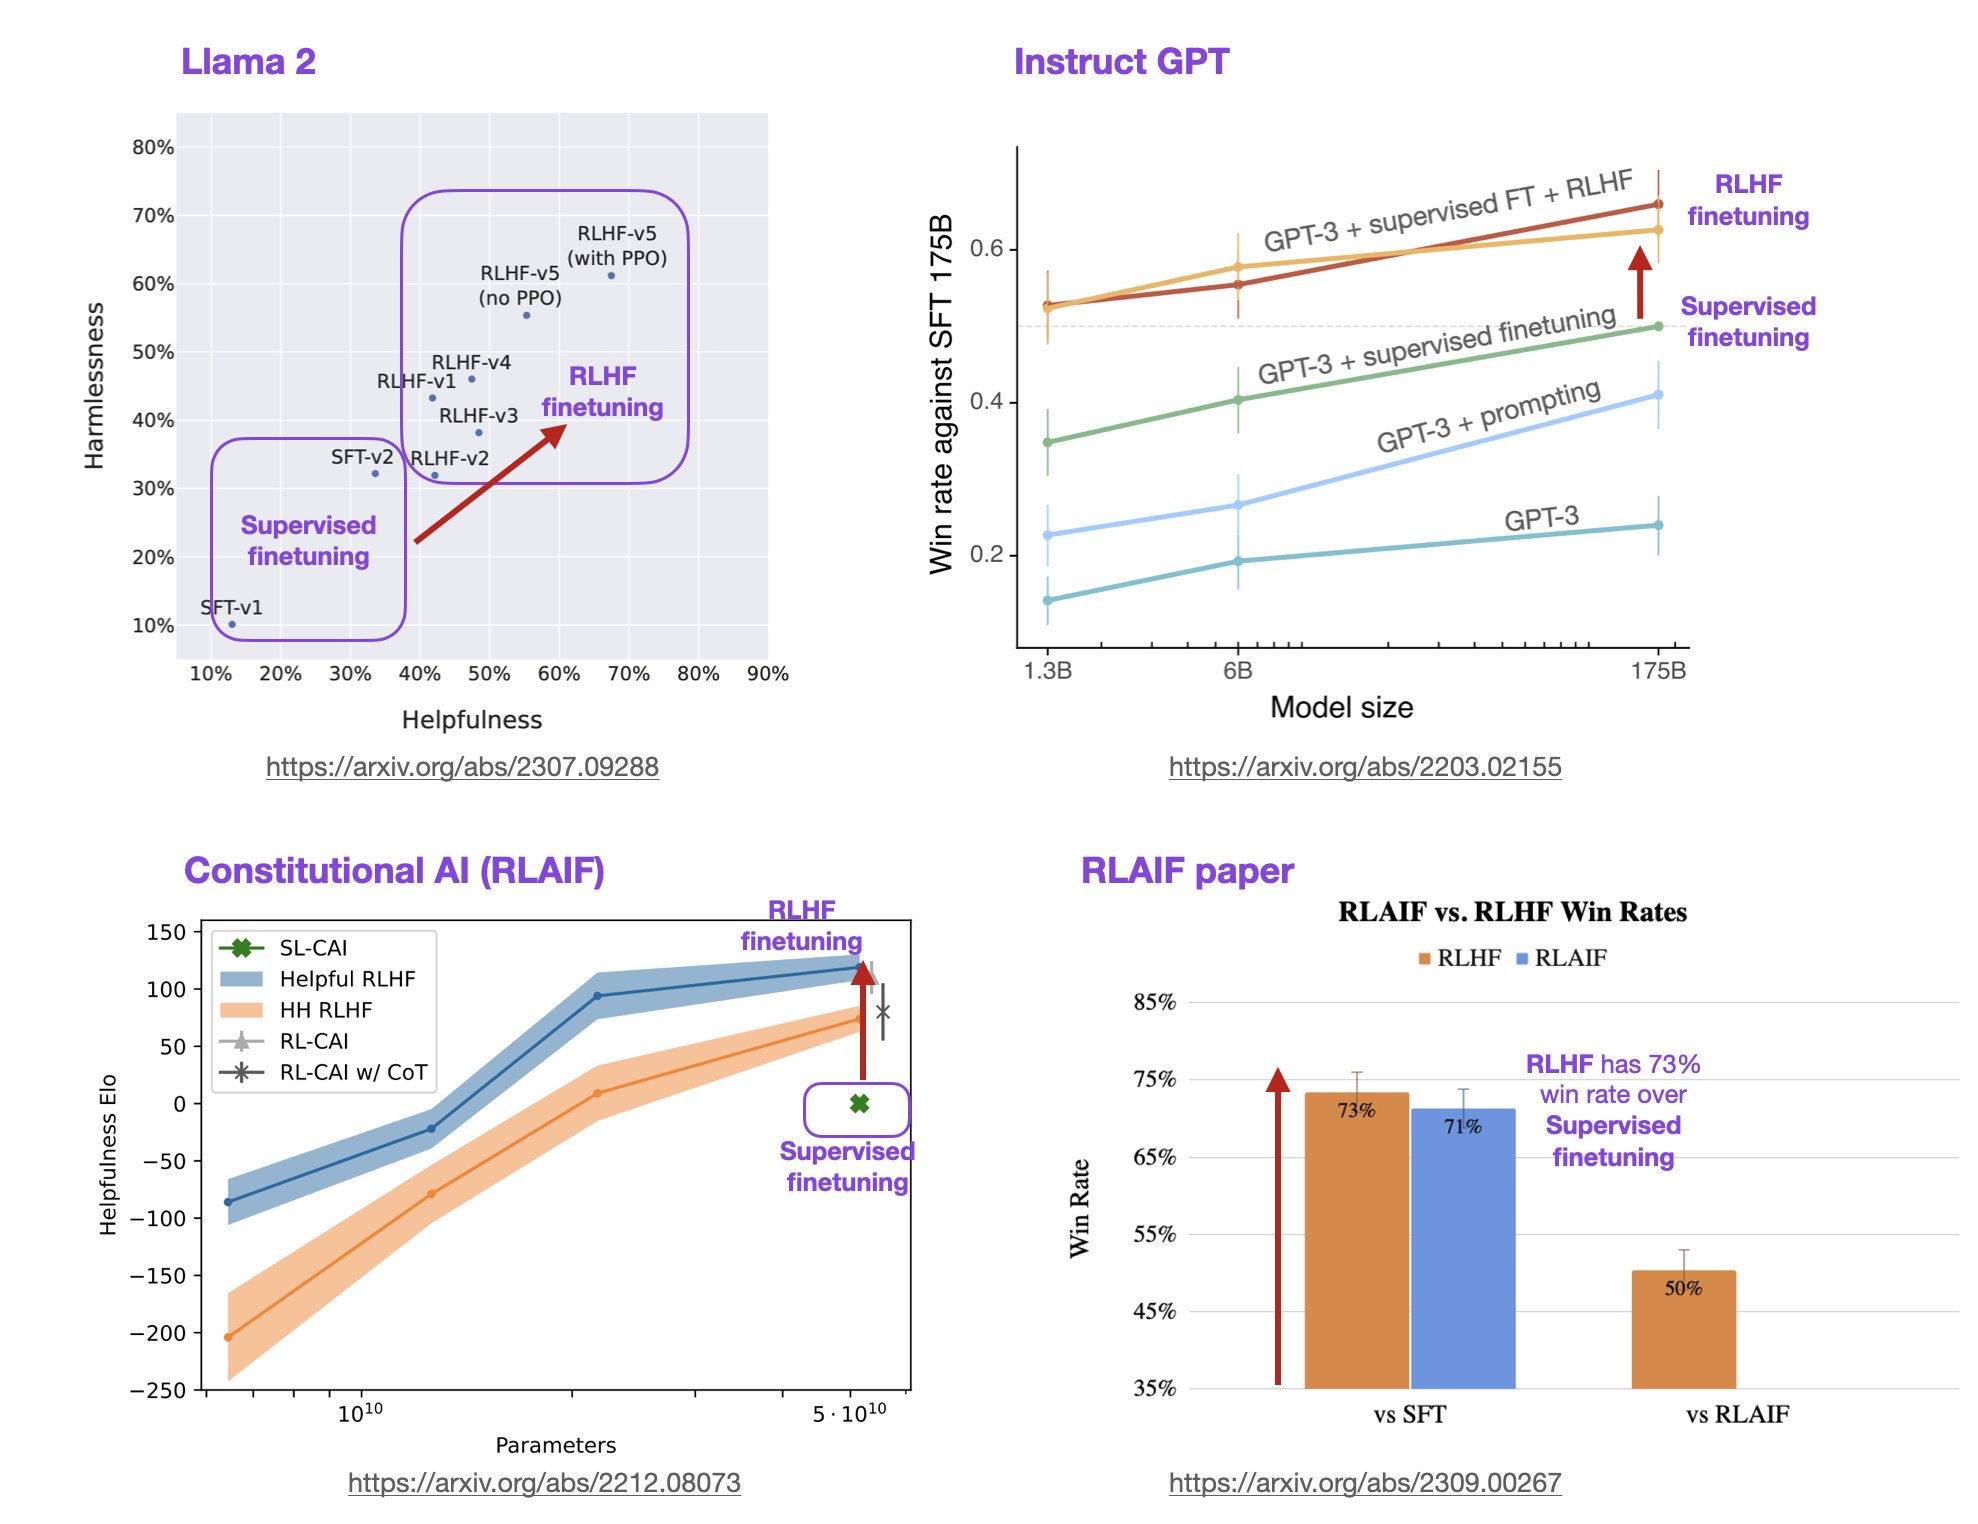
UWMadison前统计学教授详解大模型训练最重要的方法RLHF,RLHF原理、LLaMA2的RLHF详解以及RLHF替代方法

UWMadison前统计学教授详解大模型训练最重要的方法RLHF,RLHF原理、LLaMA2的RLHF详解以及RLHF替代方法

基于人类反馈的强化学习方法(Reinforcement Learning with Human Feedback,RLHF)是一种强化学习(Reinforcement Learning,RL)的变种,它利用人类的专业知识和反馈来指导机器学习模型的训练和决策过程。这种方法旨在克服传统RL方法中的一些挑战,例如样本效率低、训练困难和需要大量的试错。在大语言模型(LLM)中,RLHF带来的模型效果提升不仅仅是模型偏好与人类偏好的对齐,模型的理解能力和效果也会更好。

2023/09/15 08:05:401,772
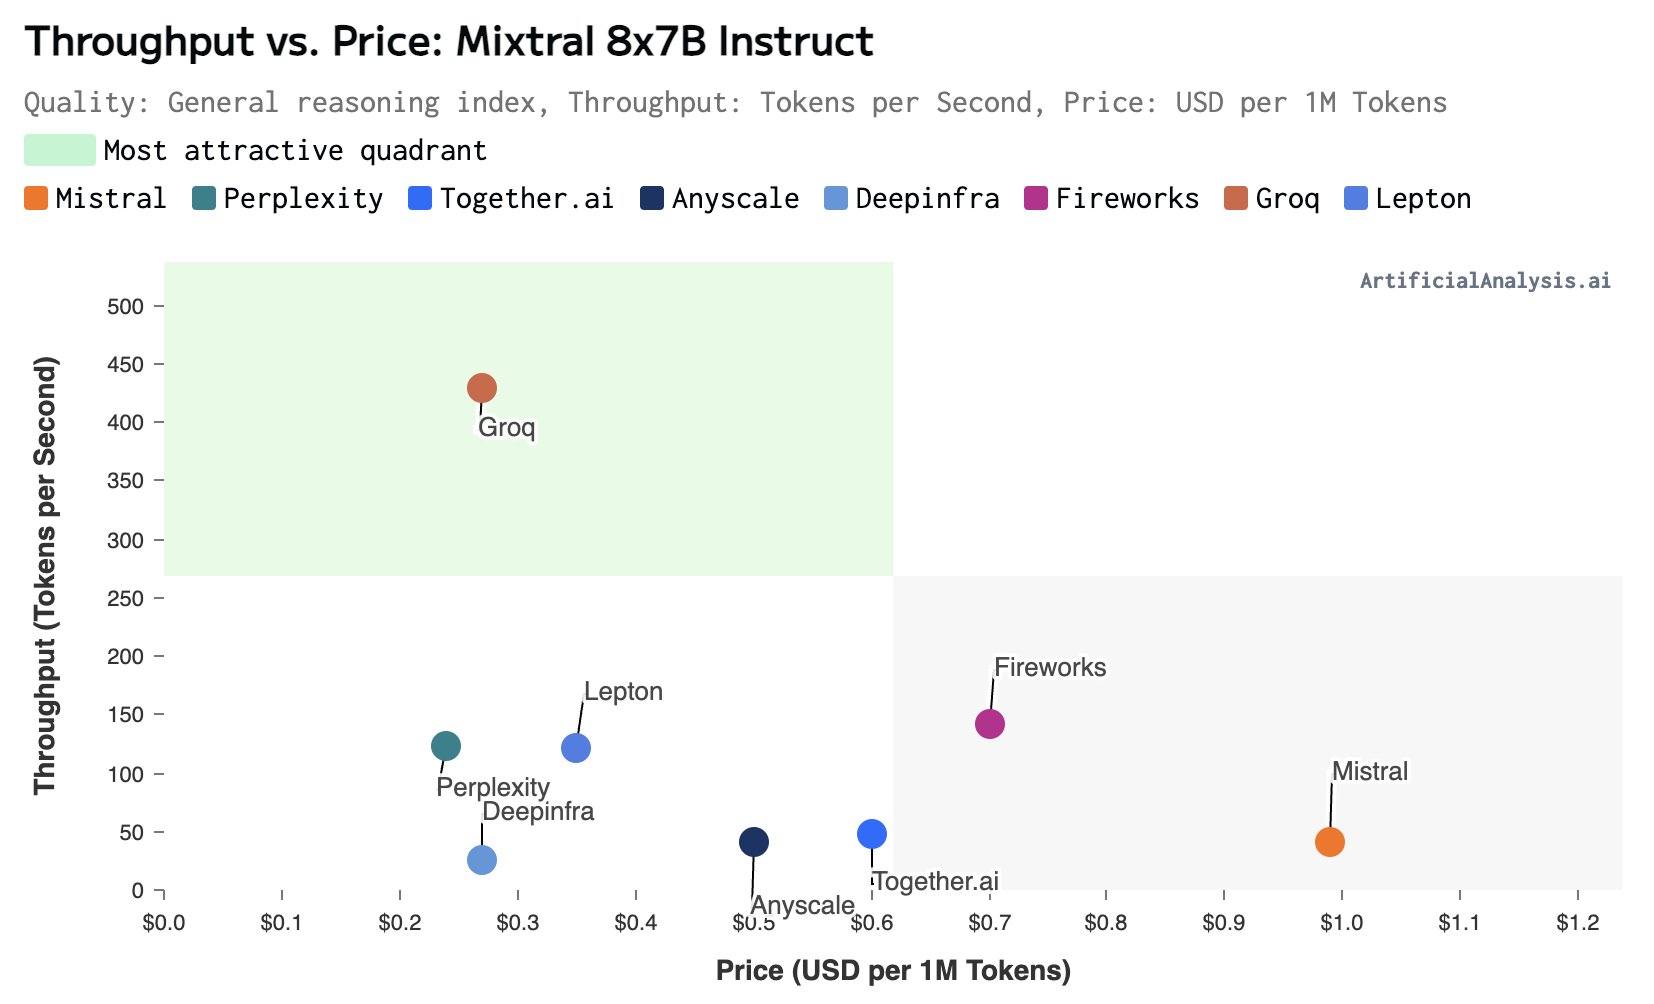
截止目前可能是全球最快的大语言模型推理服务:实机演示Groq公司每秒500个tokens输出的450亿参数的Mixtral 8×7B模型

截止目前可能是全球最快的大语言模型推理服务:实机演示Groq公司每秒500个tokens输出的450亿参数的Mixtral 8×7B模型

大模型的推理速度是当前制约大模型应用的一个非常重要的问题。在很多的应用场景中(如复杂的接口调用、很多信息处理)的场景,更快的大模型响应速度通常意味着更好的体验。但是,在实际中我们可用的场景下,大多数大语言模型的推理速度都非常有限。慢的有每秒30个tokens,快的一般也不会超过每秒100个tokens。而最近,美国加州一家企业Groq推出了他们的大模型服务,可以达到每秒接近500个tokens的响应速度,非常震撼。

2024/02/19 18:25:081,789
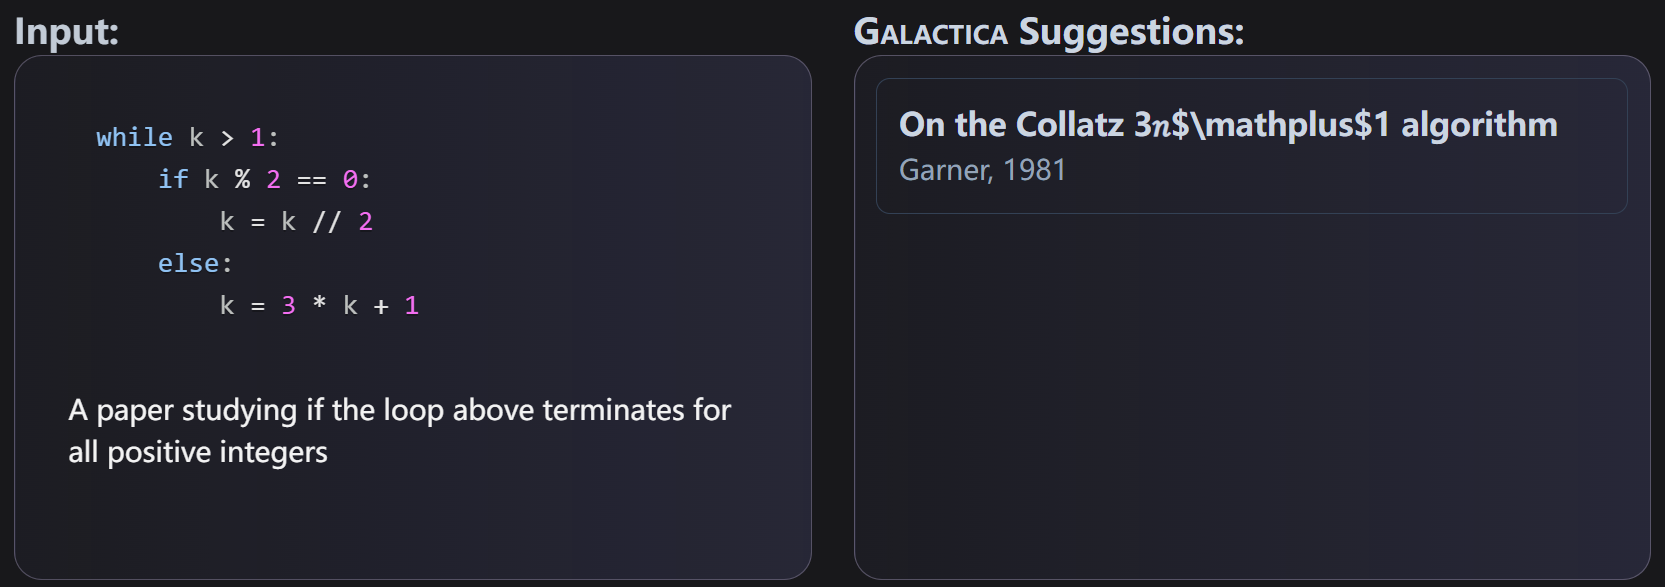
重磅!学术论文处理预训练大模型GALACTICA发布!

重磅!学术论文处理预训练大模型GALACTICA发布!

自然语言处理预训练大模型在最近几年十分流行,如OpenAI的GPT-3模型,在很多领域都取得了十分优异的性能。谷歌的PaLM也在很多自然语言处理模型中获得了很好的效果。而昨天,PapersWithCode发布了一个学术论文处理领域预训练大模型GALACTICA。功能十分强大,是科研人员的好福利!

2022/11/17 23:06:241,792
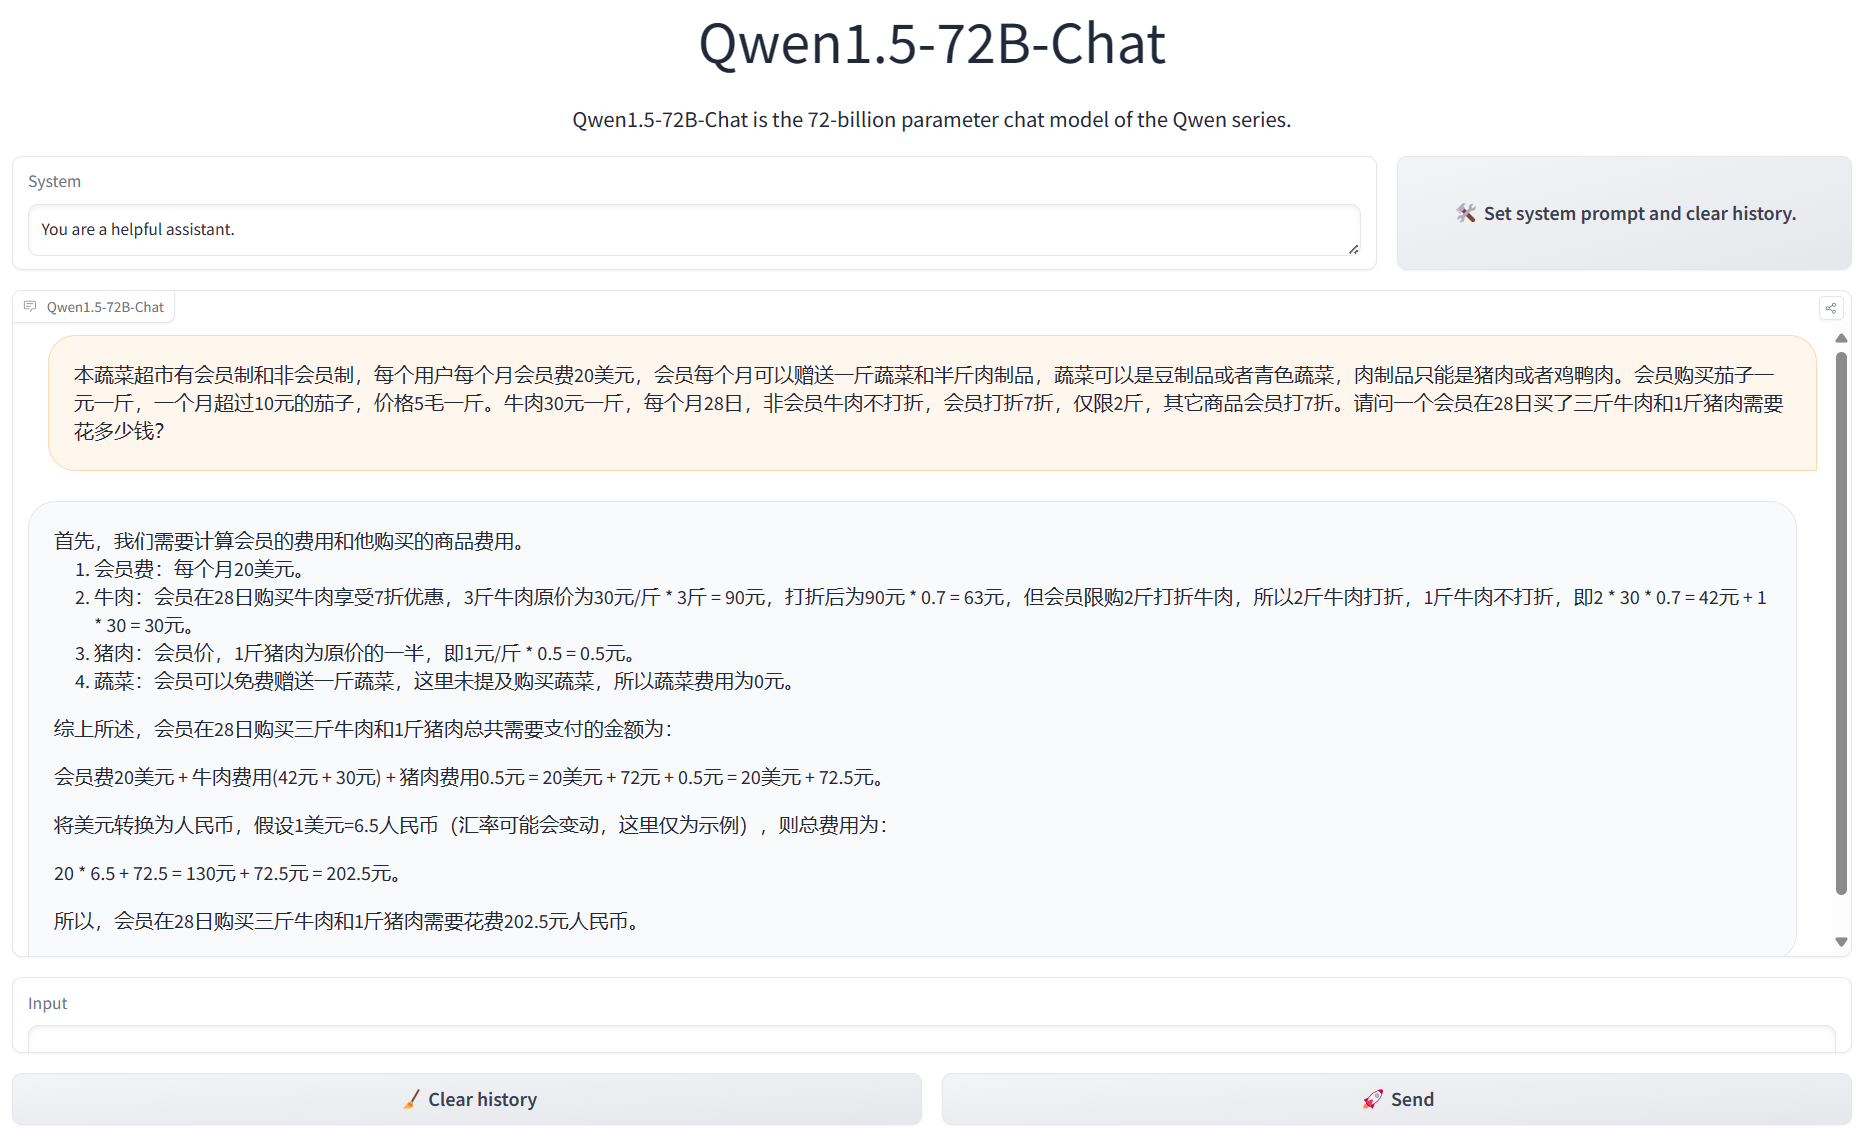
阿里开源截止目前为止参数规模最大的Qwen1.5-110B模型:MMLU评测接近Llama-3-70B,略超Mixtral-8×22B!

阿里开源截止目前为止参数规模最大的Qwen1.5-110B模型:MMLU评测接近Llama-3-70B,略超Mixtral-8×22B!

Qwen1.5系列是阿里开源的一系列大语言模型,也是目前为止最强开源模型之一。Qwen1.5是Qwen2的beta版本,此前开源的模型最大参数规模都是720亿,和第一代模型一样。就在刚刚,阿里开源了1100亿参数规模的Qwen1.5-110B模型。评测结果显示MMLU略超Llama3-70B和Mixtral-8×22B。我们实测结果,相比Qwen1.5-72B模型来说,复杂任务的逻辑提升比较明显!

2024/04/26 22:15:341,795
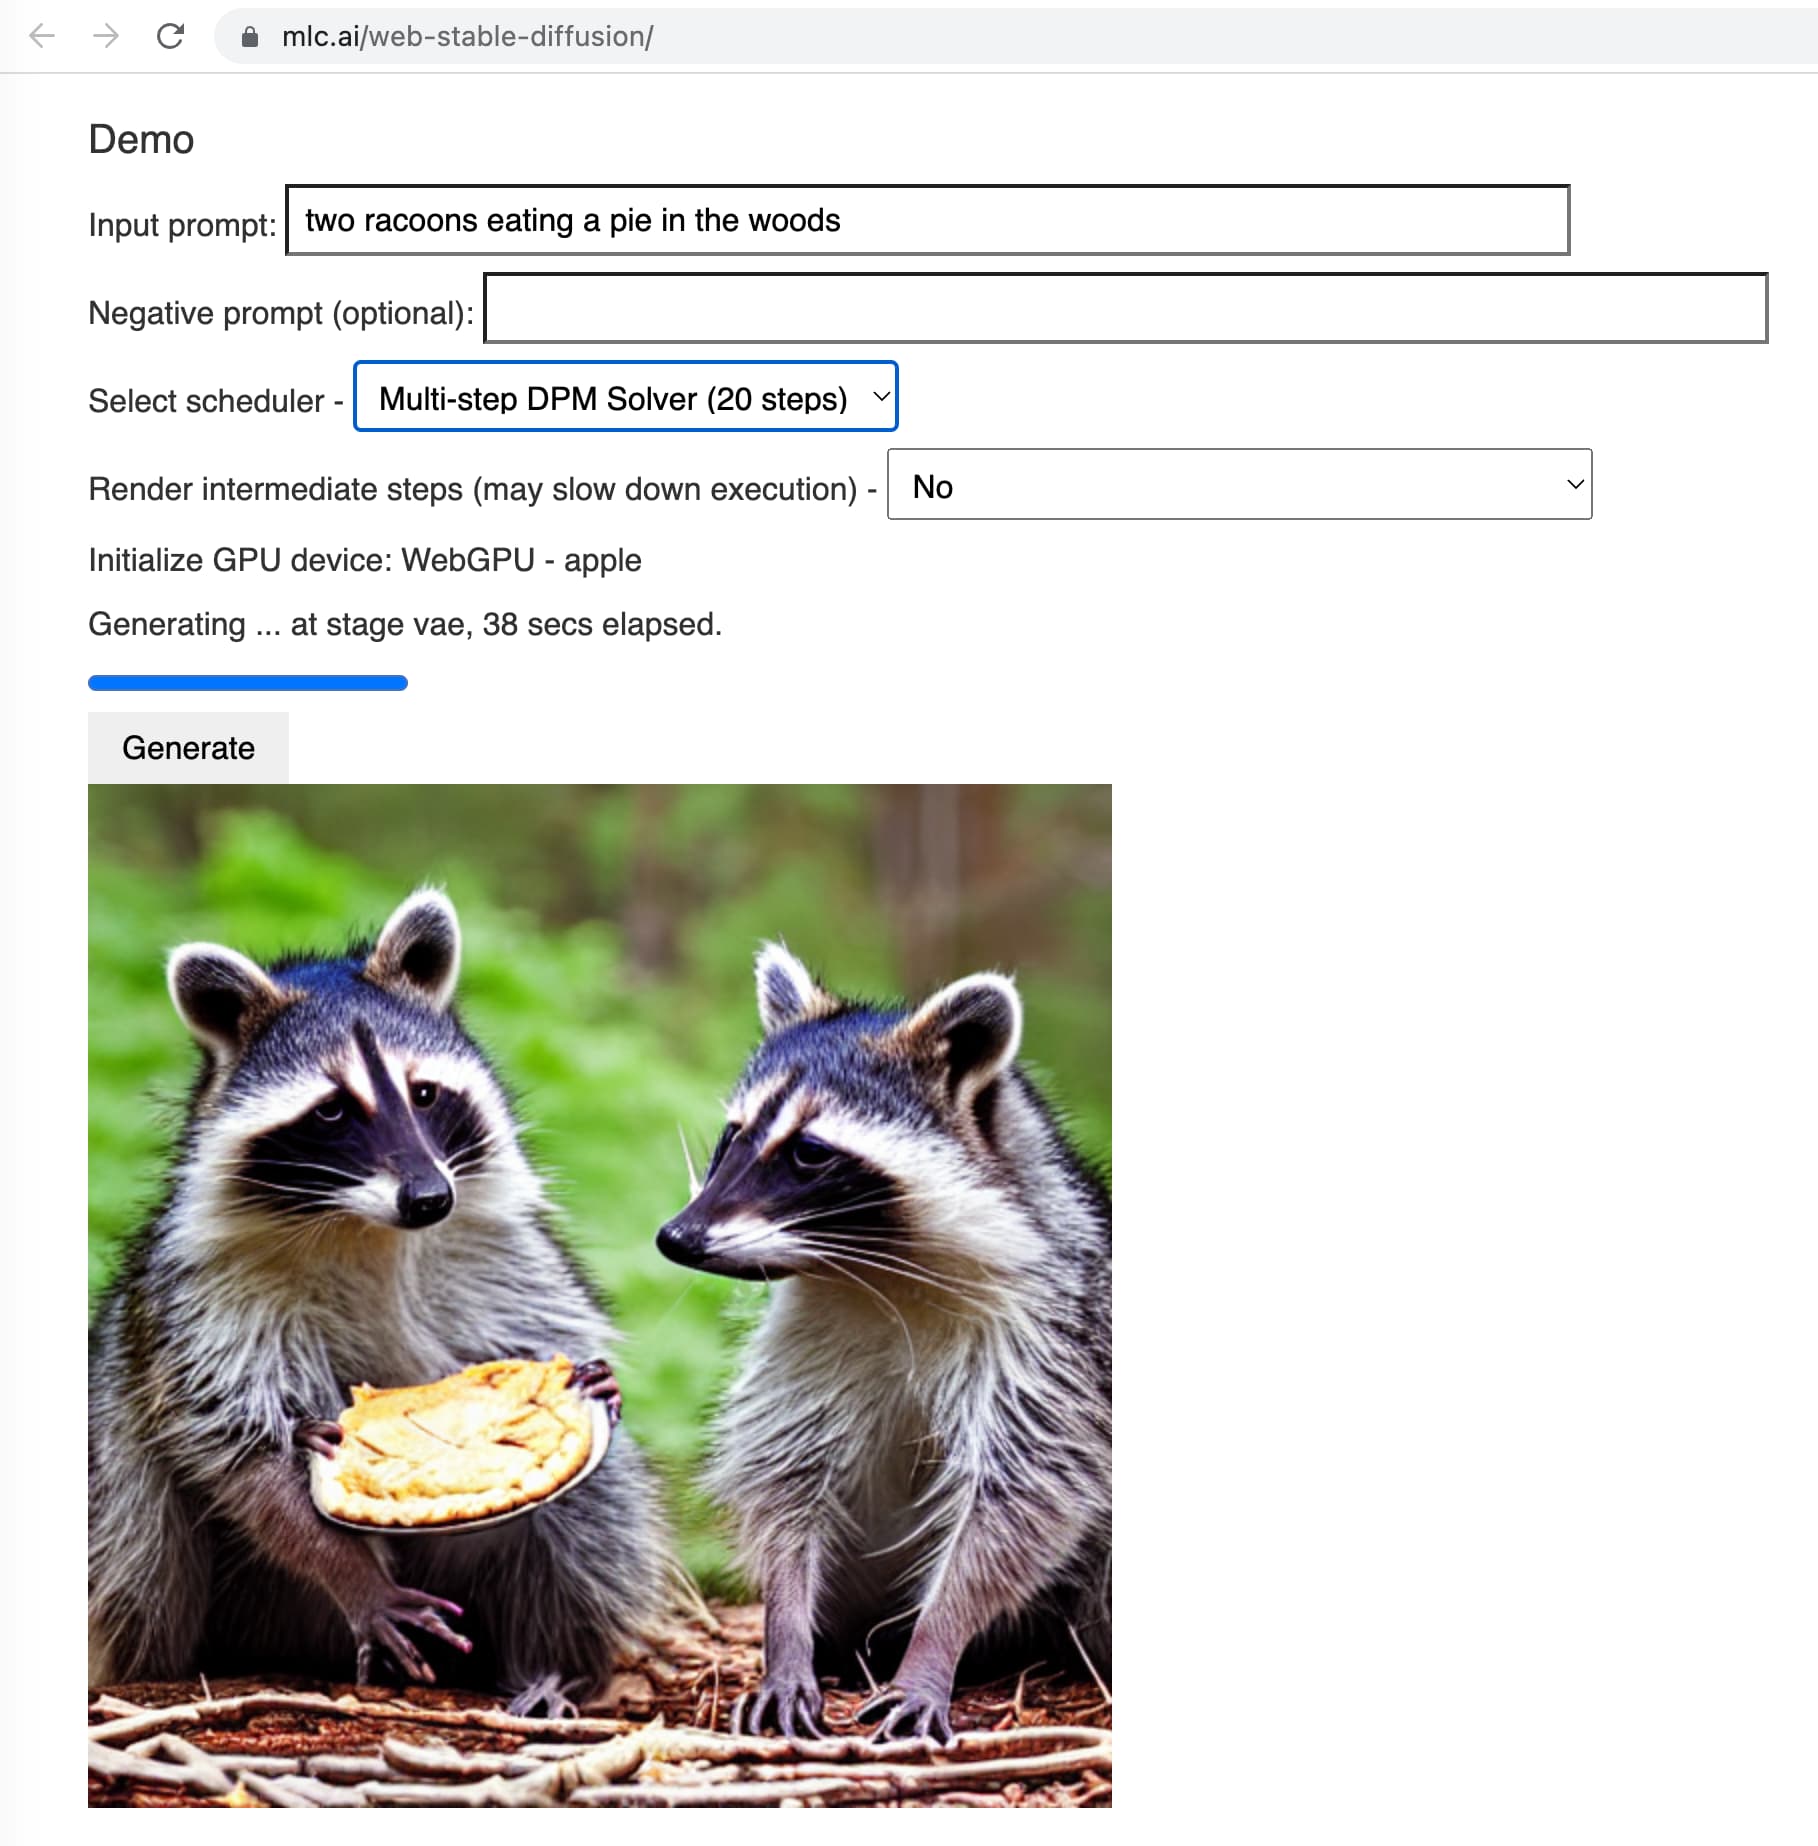
能否用85000美元从头开始训练一个打败ChatGPT的模型,并在浏览器中运行?

能否用85000美元从头开始训练一个打败ChatGPT的模型,并在浏览器中运行?

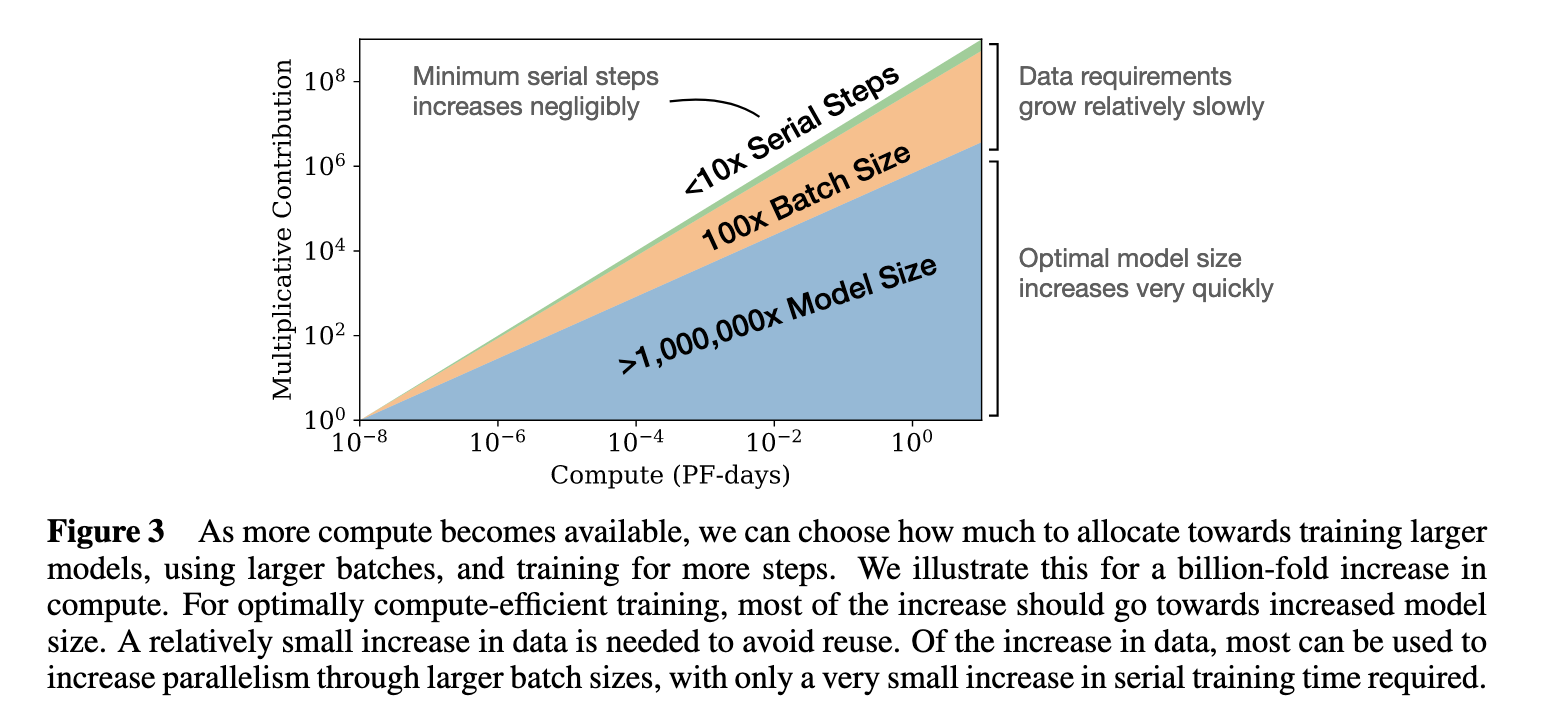
尽管当前ChatGPT和GPT-4非常火热,但是高昂的训练成本和部署成本其实导致大部分个人、学术工作者以及中小企业难以去开发自己的模型。使得使用OpenAI的官方服务几乎成为了一种无可替代的选择。本文介绍的是一种低成本开发高效ChatGPT的思路,我认为它适合一些科研机构去做,也适合中小企业创新的方式。这里提到的思路涉及了一些最近发表的成果和业界的一些实践产出,大家可以参考!

2023/04/24 22:47:181,797
【计算机硬件知识简介】之CPU指令集

【计算机硬件知识简介】之CPU指令集

随着华为被美国多轮制裁,大家忽然发现原来国内在半导体硬件方面的差距居然如此之大。半导体硬件相关方面的关注度前所未有,为了更好地理解计算机运行的原理,本文翻译自耶鲁大学的PCLT网站,旨在介绍关于计算机运行的一些原理知识。

2021/09/21 15:51:031,803
Zhipu AI重磅发布GLM-4.5系列:技术深度解析与多维度性能评测

Zhipu AI重磅发布GLM-4.5系列:技术深度解析与多维度性能评测

7月28日,智谱AI(Zhipu AI)向开源社区投下了一枚重磅炸弹,正式发布了其最新的旗舰模型系列:GLM-4.5。该系列包含两个新成员——GLM-4.5和GLM-4.5-Air,两者均以开源权重形式提供。官方技术报告详细阐述了其设计理念、技术细节以及在多项基准测试中的表现。本次发布的核心目标是打造一个能够统一推理、代码和Agent智能体能力的模型,以应对日益复杂的AI应用需求。本文将深入解析这份官方报告,剖析其核心技术、性能表现,并探讨其在当前大模型竞争格局中的战略定位。

2025/07/29 11:06:251,805
谷歌官方高性能大规模高维数据处理库TensorStore发布!

谷歌官方高性能大规模高维数据处理库TensorStore发布!

今天Google发布了TensorStore,这是一个开源的C++和Python软件库,设计用于存储和操作大规模n维数据。TensorStore已经被用来解决科学计算中的关键工程挑战(例如,管理和处理神经科学中的大型数据集,如石油级的三维电子显微镜数据和神经元活动的 "4d "视频)。TensorStore还被用于创建大规模的机器学习模型,如PaLM,解决了分布式训练期间管理模型参数(检查点)的问题。

2022/09/24 10:15:501,806
强化学习进入分布式时代——DeepMind分布式强化学习框架ACME发布

强化学习进入分布式时代——DeepMind分布式强化学习框架ACME发布

深度强化学习(RL)导致了许多最近的和突破性的进展。然而,强化学习的实施并不容易,与使深度学习拥有PyTorch这样简单的框架支持不同,强化学习的训练缺少强有力的工具支撑。为了解决这些问题,DeepMind发布了Acme,一个用于构建新的RL算法的框架,该框架是专门为实现代理而设计的

2022/09/24 20:58:031,808