DataLearner 标志
原创博客

原创AI技术博客

探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。

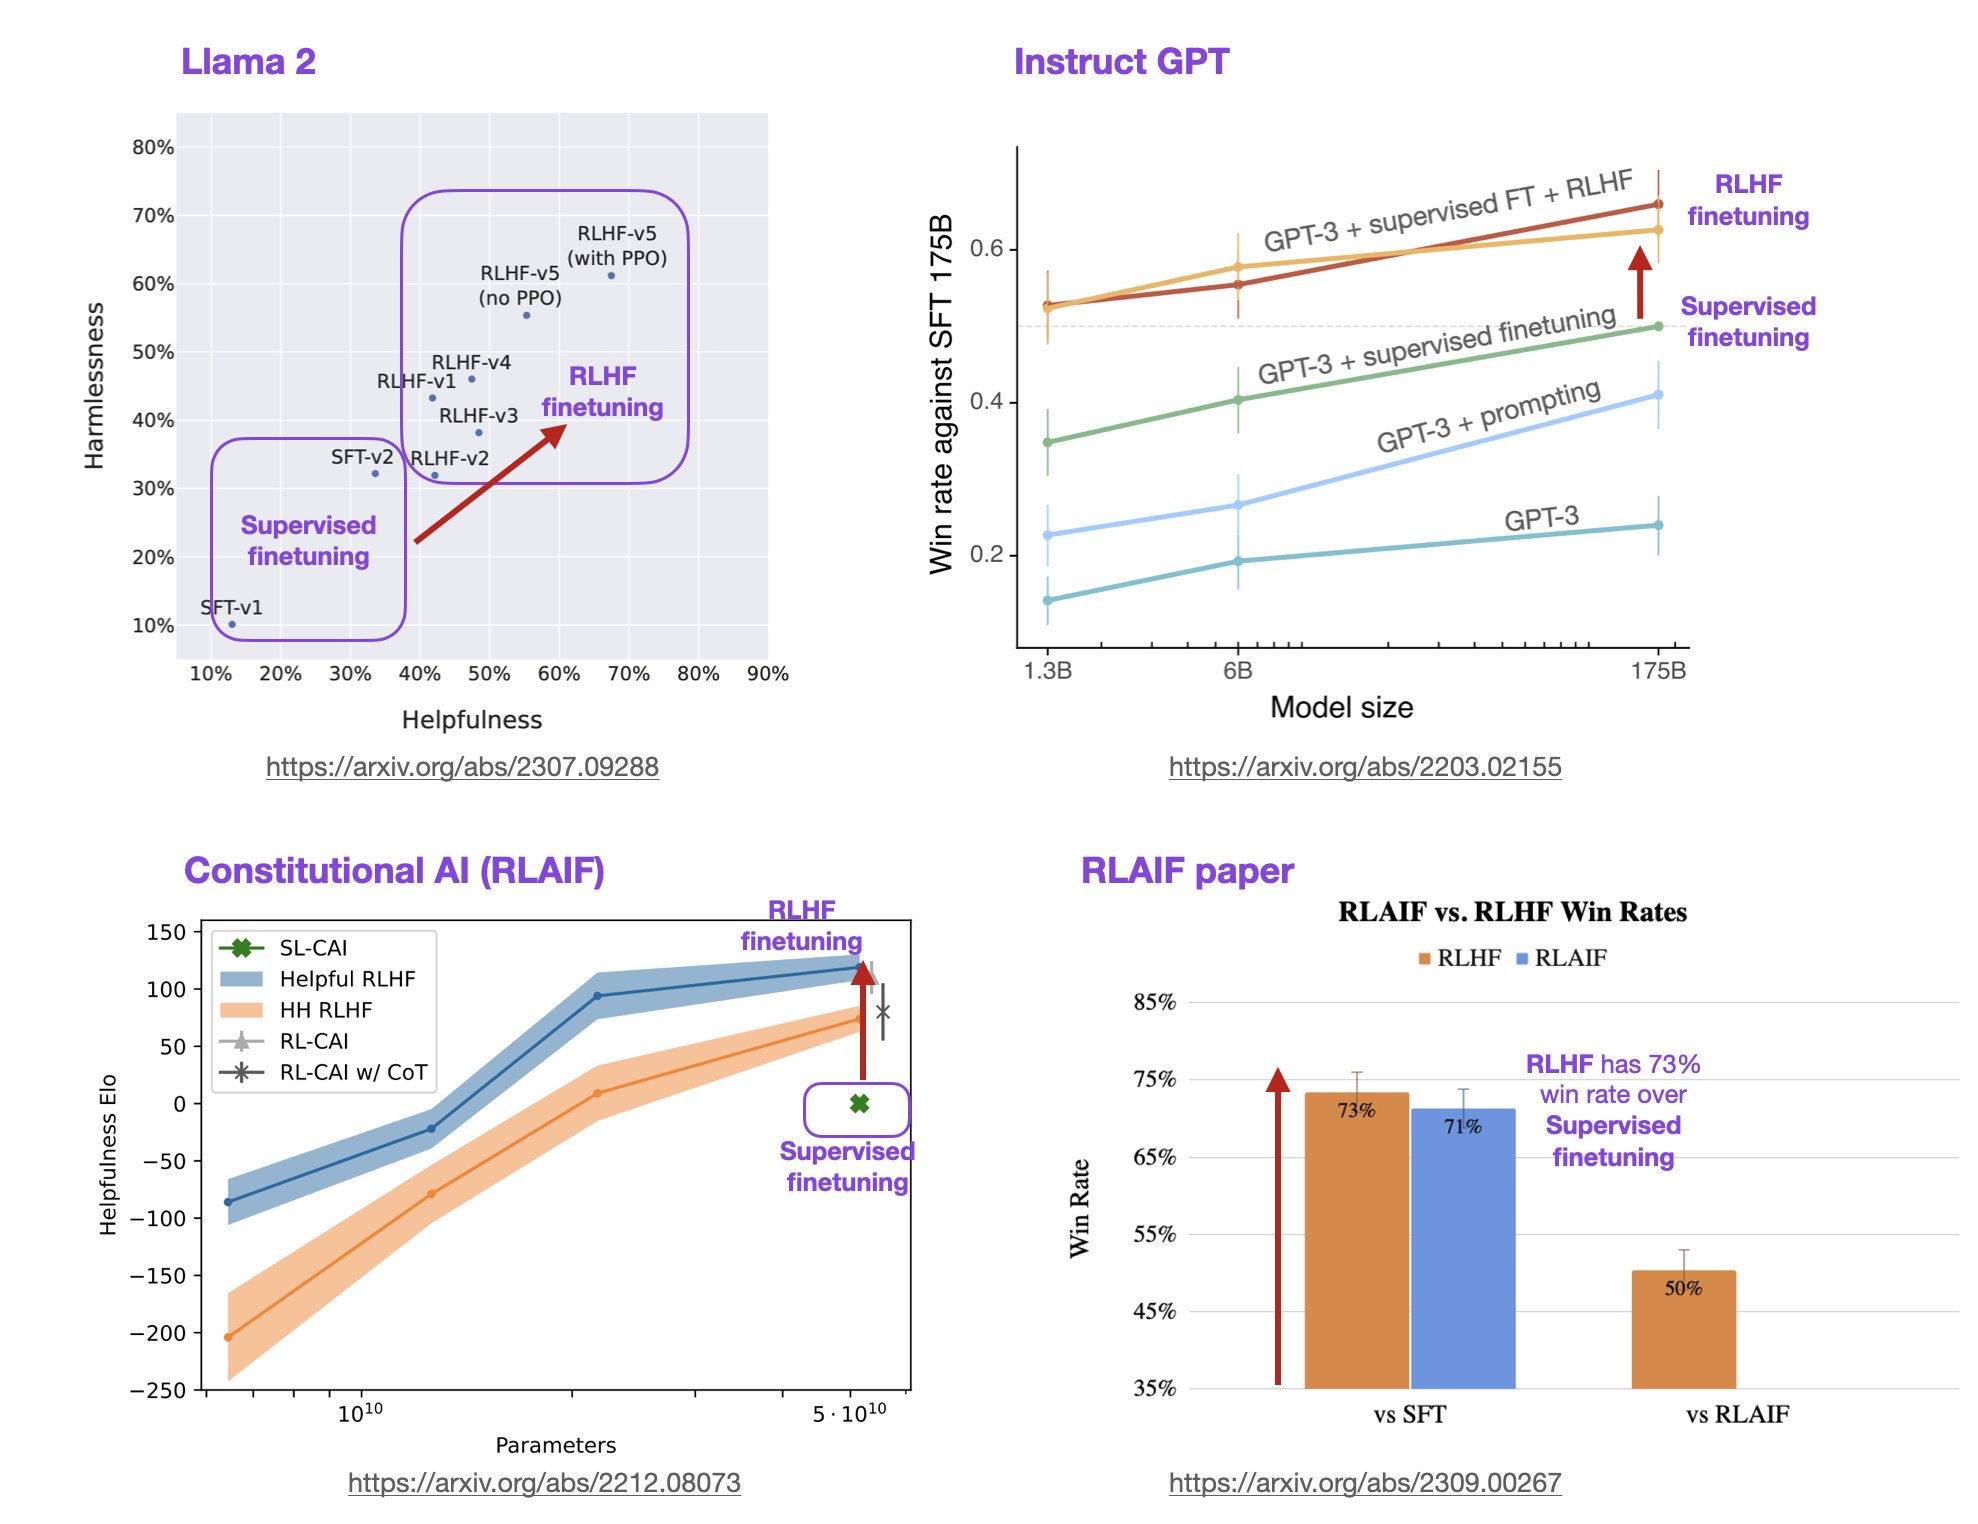
UWMadison前统计学教授详解大模型训练最重要的方法RLHF,RLHF原理、LLaMA2的RLHF详解以及RLHF替代方法

UWMadison前统计学教授详解大模型训练最重要的方法RLHF,RLHF原理、LLaMA2的RLHF详解以及RLHF替代方法

基于人类反馈的强化学习方法(Reinforcement Learning with Human Feedback,RLHF)是一种强化学习(Reinforcement Learning,RL)的变种,它利用人类的专业知识和反馈来指导机器学习模型的训练和决策过程。这种方法旨在克服传统RL方法中的一些挑战,例如样本效率低、训练困难和需要大量的试错。在大语言模型(LLM)中,RLHF带来的模型效果提升不仅仅是模型偏好与人类偏好的对齐,模型的理解能力和效果也会更好。
2023/09/15 08:05:401,771
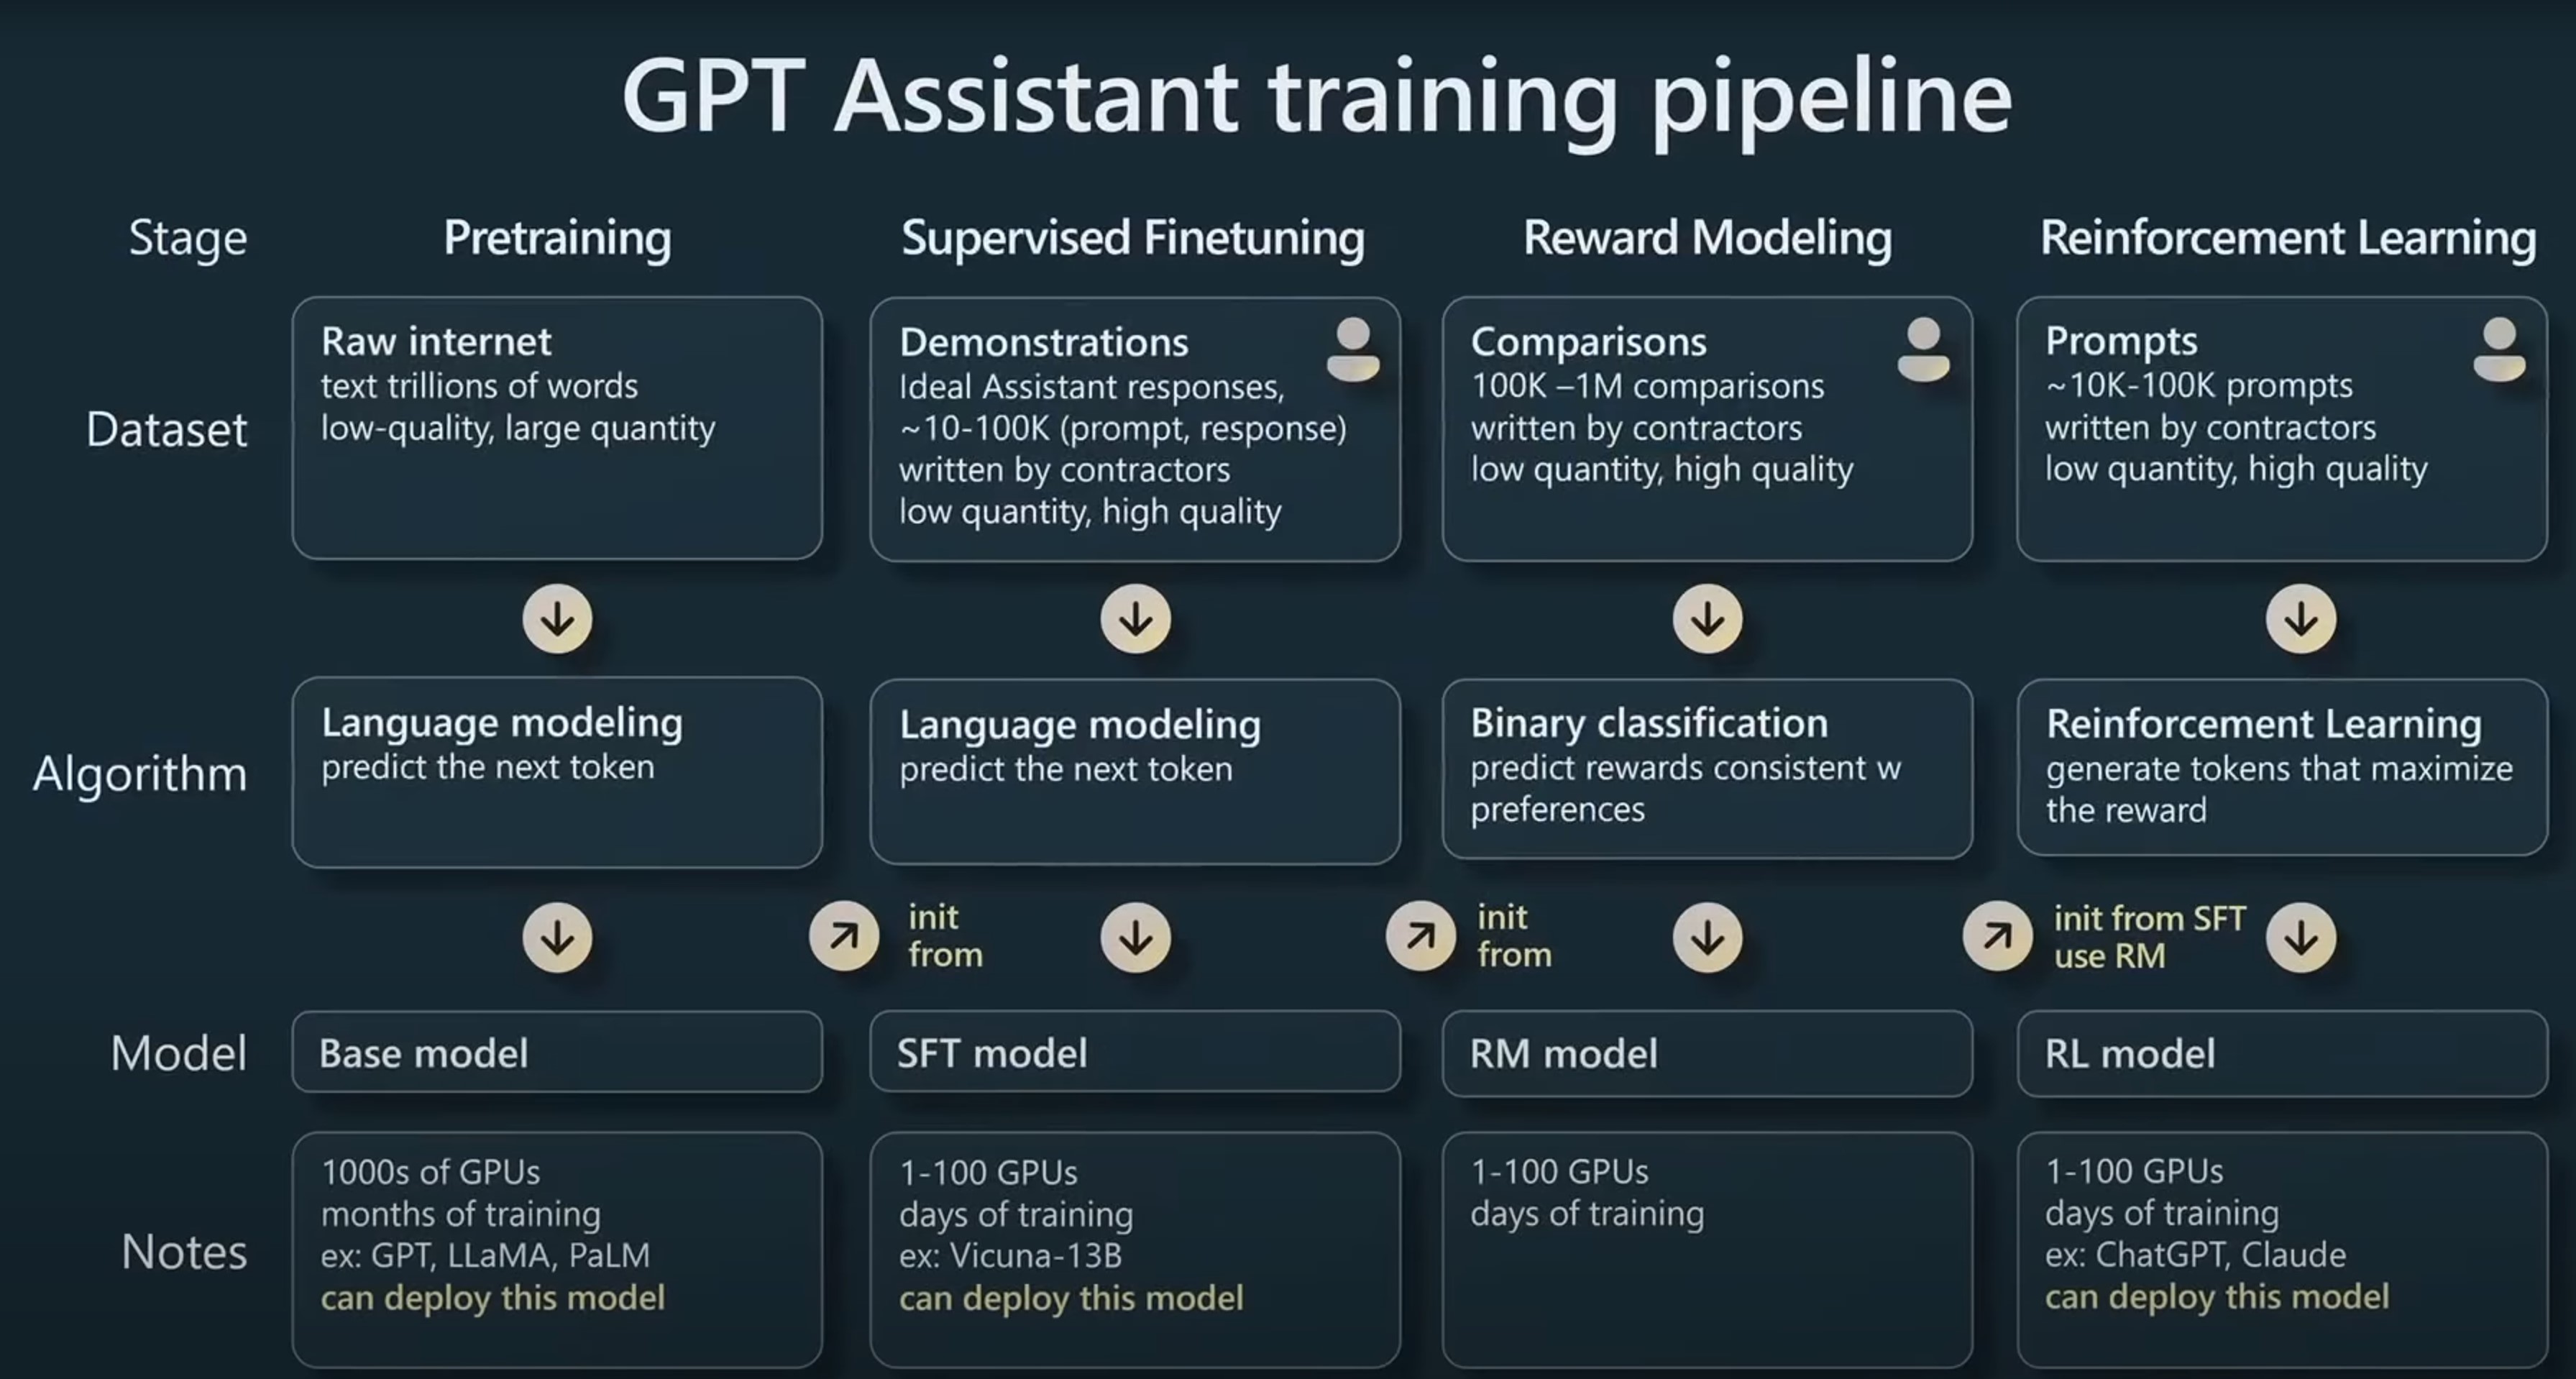
如何训练一个大语言模型?当前基于transformer架构的大语言模型的通用训练流程介绍

如何训练一个大语言模型?当前基于transformer架构的大语言模型的通用训练流程介绍

在当今的人工智能领域,大型语言模型(LLM)已成为备受瞩目的研究方向之一。它们能够理解和生成人类语言,为各种自然语言处理任务提供强大的能力。然而,这些模型的训练不仅仅是将数据输入神经网络,还包括一个复杂的管线,其中包括预训练、监督微调和对齐三个关键步骤。本文将详细介绍这三个步骤,特别关注强化学习与人类反馈(RLHF)的作用和重要性。

Google发布迄今为止公开可用的最大的多语言网络数据集MADLAD-400,覆盖419种语言

Google发布迄今为止公开可用的最大的多语言网络数据集MADLAD-400,覆盖419种语言

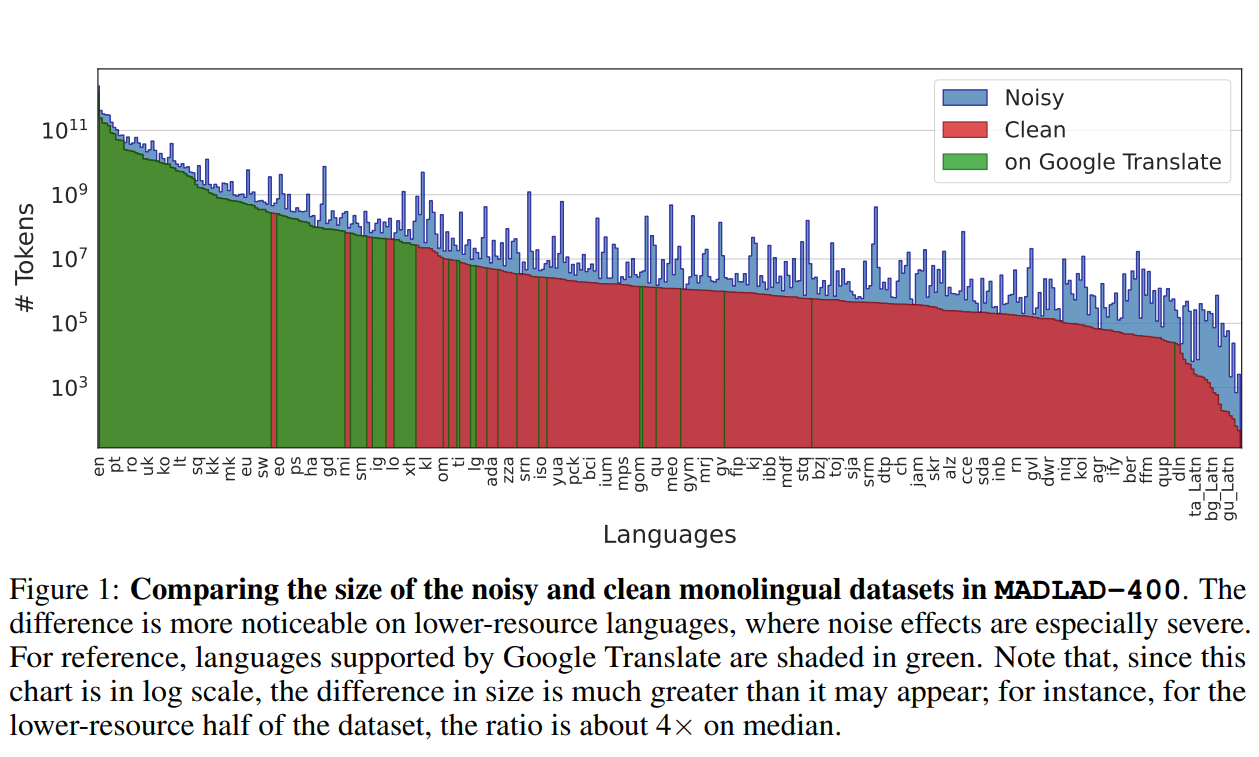
Google DeepMind与Google Research的研究人员推出了一个全新的多语言数据集——MADLAD-400!这个数据集汇集了来自全球互联网的419种语言的大量文本数据,其规模和语言覆盖范围在公开可用的多语言数据集中应该是最大的。研究人员从Common Crawl这个庞大的网页爬虫项目中提取了大量数据,并进行了人工审核,删除了许多噪音,使数据集的质量得到了显著提升。

2023/09/13 07:26:541,981
Baichuan系列大语言模型升级到第二代,百川开源的Baichuan2系列大模型详解,能力提升明显,依然免费商用授权

Baichuan系列大语言模型升级到第二代,百川开源的Baichuan2系列大模型详解,能力提升明显,依然免费商用授权

百川智能是前搜狗创始人王小川创立的一个大模型创业公司,主要的目标是提供大模型底座来提供各种服务。虽然成立很晚(在2023年4月份成立),但是三个月后便发布开源了Baichuan系列开源模型,并上架了Baichun-53B的大模型聊天服务。这些模型受到了广泛的关注和很高的平均。而2个月后,百川智能再次开源第二代baichuan系列大模型,其能力提升明显。

2023/09/09 10:28:293,745
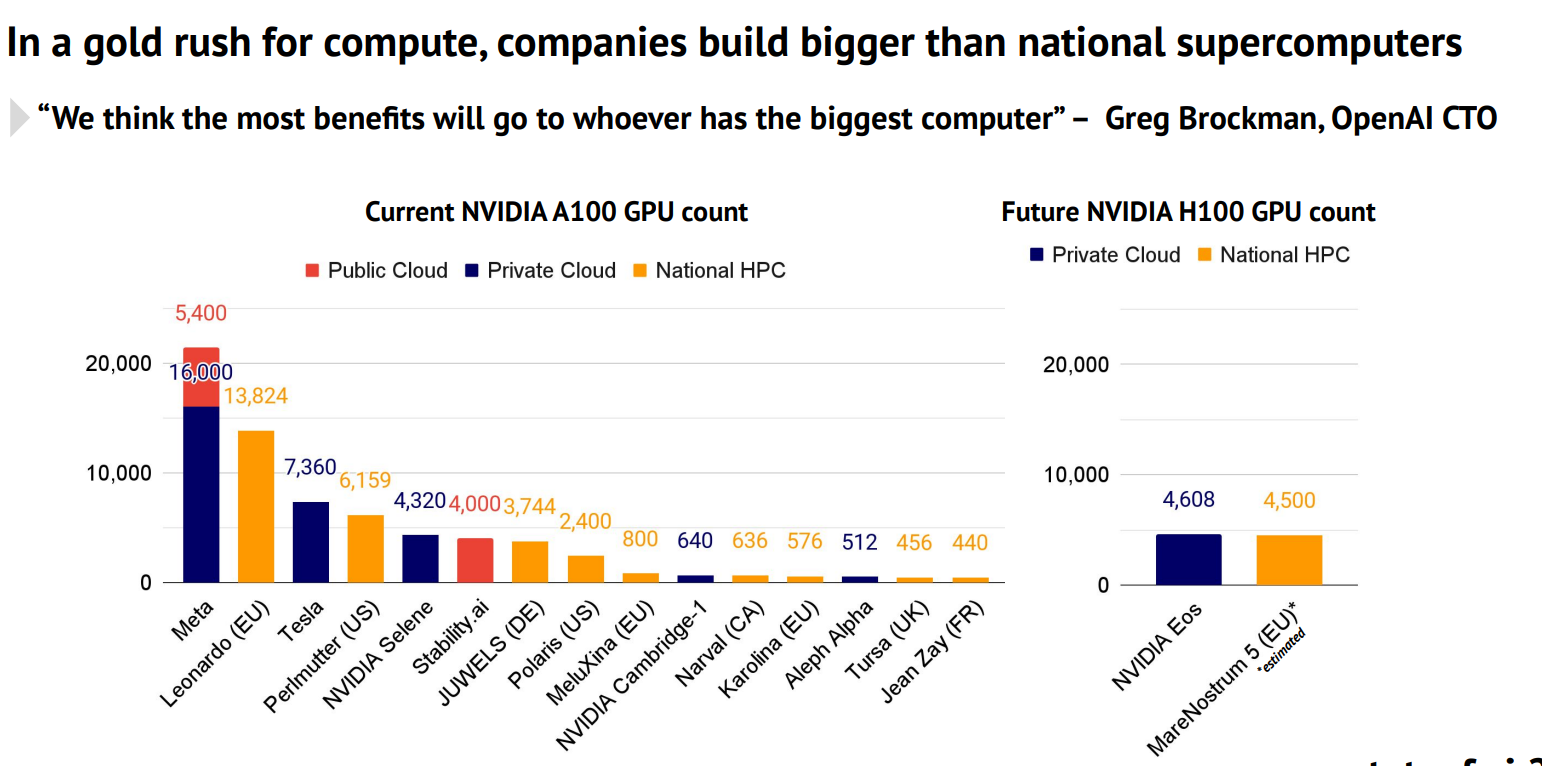
各大企业和机构拥有的NVIDIA A100的GPU显卡数量

各大企业和机构拥有的NVIDIA A100的GPU显卡数量

Stateof.AI上周发布了最新的AI的报告中报告了当前各大企业和机构拥有的NVIDIA A100的GPU数量。A100是目前商用的最强大的GPU,对于超级计算机、大规模AI模型的训练和推理来说都十分重要。这里透露的各大企业的GPU数量也让我们可以看到各家的竞争情况。

2023/09/08 20:19:065,106
如何估计大模型推理或者训练所需要的显存大小?HuggingFace官方工具Model Memory Calculator,一键计算大模型显存需求~

如何估计大模型推理或者训练所需要的显存大小?HuggingFace官方工具Model Memory Calculator,一键计算大模型显存需求~

大模型对显卡资源的消耗是很大的。但是,具体每个模型消耗多少显存,需要多少资源大模型才能比较好的运行是很多人关心的问题。此前,DataLearner曾经从理论上给出了大模型显存需求的估算逻辑,详细说明了大模型在预训练阶段、微调阶段和推理阶段所需的显存资源估计,而HuggingFace的官方库Accelerate直接推出了一个在线大模型显存消耗资源估算工具Model Memory Calculator,直接可以估算在HuggingFace上托管的模型的显存需求。

2023/09/01 18:09:1714,330
OpenAI官方Prompt教程:如何让ChatGPT扮演不同角色,完成教学任务

OpenAI官方Prompt教程:如何让ChatGPT扮演不同角色,完成教学任务

Prompt技巧一直是提升ChatGPT等大语言模型使用效率的最重要方法之一。为此,OpenAI官方也在不断地分享官方的Prompt技巧。2023年的8月31日,OpenAI官方最新分享了一个教室使用的Prompt来帮助老师授课的案例。尽管这是针对老师的Prompt教程,但是其中的设计思路其实也可以广泛运用在客服、问答系统、编程等领域。

2023/09/01 08:50:302,954
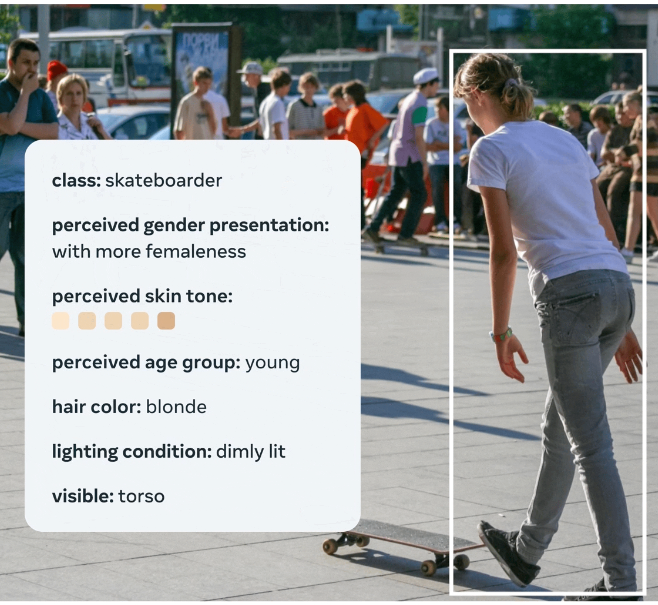
MetaAI开源高质量高精度标注的图像数据集FACET:3.2万张图片、5万个主题,平均图像解析度达到1500×2000

MetaAI开源高质量高精度标注的图像数据集FACET:3.2万张图片、5万个主题,平均图像解析度达到1500×2000

MetaAI在2023年8月31日开源了一个全新的图像数据集,FACET(FAirness in Computer Vision EvaluaTion),FACET数据集包含32,000张图片和50,000人,这些图片由专家进行了详细的标注,包括人口统计属性(如感知性别表达和感知年龄组)和其他物理属性(如感知肤色和发型)。这样的设计使得研究人员可以更全面、更深入地评估模型在不同人群中的表现,从而更准确地识别和解决模型的不公平性问题。

2023/09/01 08:13:081,203
大语言模型的指令微调(Instruction Tuning)最全综述:从数据集到技术全解析

大语言模型的指令微调(Instruction Tuning)最全综述:从数据集到技术全解析

当前的大语言模型主要是预训练大模型,在大规模无监督数据上训练之后,再经过有监督微调和对齐之后就可以完成很多任务。尽管如此,面对垂直领域的应用,大模型依然需要微调才能获得更好地应用结果。而大模型的微调有很多方式,包括指令微调、有监督微调、提示工程等。其中,指令微调(Instruction Tuning)作为改进模型可控性最重要的一类方法,缺少深入的研究。浙江大学研究人员联合Shannon AI等单位发布了一篇最新的关于指令微调的综述,详细描述指令微调的各方面内容。

2023/08/28 15:22:0513,637
比Office Copilot更快一步~基于AI大语言模型生成PPT、Word和网页的应用的新产品测试~Gamma.APP,PPT打工人必备

比Office Copilot更快一步~基于AI大语言模型生成PPT、Word和网页的应用的新产品测试~Gamma.APP,PPT打工人必备

大语言模型(Large Language Model,LLM)已经在很多领域都产生了巨大的影响。但是其中最为大家所期待的功能之一就是基于idea生成PPT、Word文档等。此前微软Office Copilot已经吸引了很多人的关注,但目前依然没有开放。而今天DataLearnerAI发现了一个类似的产品,来自洛杉矶初创企业Gamma的产品目前已经支持基于文本生成PPT、Word和网页应用了,本文带大家简单体验一下这个产品。

2023/08/26 14:37:594,225
大规模中文开源数据集发布!2TB、几十亿条可商用的中文数据集书生·万卷 1.0开源~中文大模型能力可能要更上一层楼了!

大规模中文开源数据集发布!2TB、几十亿条可商用的中文数据集书生·万卷 1.0开源~中文大模型能力可能要更上一层楼了!

随着近年来GPT-3、ChatGPT等大模型的兴起,高质量的数据集在模型训练中扮演着越来越重要的角色。但是当前领先的预训练模型使用的数据集细节往往不公开,开源数据的匮乏制约着研究社区的进一步发展。特别是大规模中文数据集十分缺乏,对中文大模型以及业界模型的中文支持都有很大的影响。此次,上海人工智能实验室发布的这个数据集包含了丰富的中文,对于大模型的中文能力提升十分有价值。

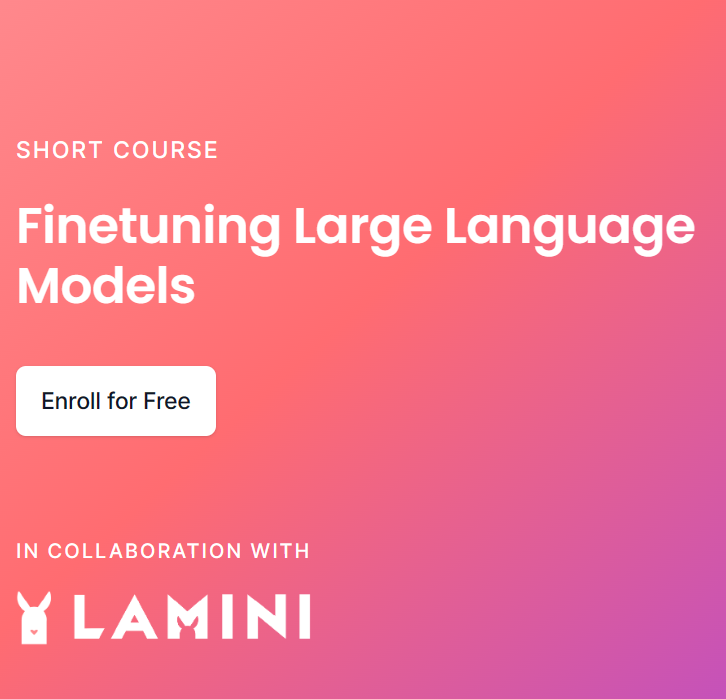
如何微调大语言模型?吴恩达联合LaminiAI最新一个小时短课教会大模型微调!这次是面向中级水平人员~

如何微调大语言模型?吴恩达联合LaminiAI最新一个小时短课教会大模型微调!这次是面向中级水平人员~

当谈及人工智能的巨大进步,大模型的崛起无疑是其中的一个重要里程碑。这些大模型,如GPT-3,已经展现出令人惊叹的语言生成和理解能力,但是为了让它们在特定任务上发挥最佳性能,大模型微调(Fine-tuning)是一种非常优秀的方法。微调是一种将预训练的大型模型进一步优化,以适应特定任务或领域的过程。但微调并不是很简单,今天吴恩达联合Lamini推出了全新的大模型微调短课《Finetuning Large Language Models》。

2023/08/24 16:35:112,869
OpenAI官方教程:如何针对大模型微调以及微调后模型出现的常见问题分析和解决思路~以GPT-3.5微调为例

OpenAI官方教程:如何针对大模型微调以及微调后模型出现的常见问题分析和解决思路~以GPT-3.5微调为例

OpenAI在2023年8月份发布了GPT-3.5的微调接口,并表示会在2023年秋天开放16K的gpt-3.5-turbo-16k模型和GPT-4的微调(参考:[重磅!GPT-3.5可以微调了!OpenAI发布GPT-3.5 Turbo微调接口](https://www.datalearner.com/blog/1051692752268726 "重磅!GPT-3.5可以微调了!OpenAI发布GPT-3.5 Turbo微调接口"))。然而,微调并不是一个简单的问题,如何对大模型微调以及如果微调出现问题

2023/08/23 11:46:596,258
最强SQL代码生成开源大模型发布:DefogAI开源超过gpt-3.5-turbo的SQL生成大模型SQLCoder,免费商用授权~

最强SQL代码生成开源大模型发布:DefogAI开源超过gpt-3.5-turbo的SQL生成大模型SQLCoder,免费商用授权~

SQLCoder 是 Defog 团队推出的一款前沿的语言模型,专门用于将自然语言问题转化为 SQL 查询。这是一个拥有150亿参数的模型,其性能略微超过了 gpt-3.5-turbo 在自然语言到 SQL 生成任务上,并且显著地超越了所有流行的开源模型。更令人震惊的是,尽管 SQLCoder 的大小只有 text-davinci-003 的十分之一,但其性能却远超后者。

2023/08/22 11:22:414,773
AI2发布全新的大语言模型预训练数据集:包含3万亿tokens的大规模文本数据集AI2 Dolma,开源免费商用数据集~

AI2发布全新的大语言模型预训练数据集:包含3万亿tokens的大规模文本数据集AI2 Dolma,开源免费商用数据集~

Allen Institute for AI简称AI2,是2014年成立的一个非营利性研究组织,其创办者是之前的微软联合创始人Paul G. Allen。目前该组织主导了几个非常大的项目,希望借助AI来推动科学、医学等领域的进步。此前也开源过大模型OLMo等。这次是该组织第一份发布AI数据集相关的项目,名称位Dolma,是一个包含了3万亿tokens的数据集,目前第一版本仅仅包含英文。

2023/08/21 21:49:302,377
需要多少GPU显存才能运行预训练大语言模型?大语言模型参数规模与显存大小的关系估算方法~

需要多少GPU显存才能运行预训练大语言模型?大语言模型参数规模与显存大小的关系估算方法~

开源大语言模型的发展非常迅速,其强大的能力也吸引了很多人的尝试与体验。尽管预训练大语言模型的使用并不复杂,但是,因为其对GPU资源的消耗很大,导致很多人并不能很好地运行加载模型,也做了很多浪费时间的工作。其中一个比较的的问题就是很多人并不知道自己的显卡支持多大参数规模的模型运行。本文将针对这个问题做一个非常简单的介绍和估算。

2023/08/18 10:48:248,775
没有显卡也没关系!基于Google Colab免费GPU额度部署Stable Diffusion XL模型,可以生成4K的图!

没有显卡也没关系!基于Google Colab免费GPU额度部署Stable Diffusion XL模型,可以生成4K的图!

Stable Diffusion XL是StabilityAI最新的开源模型。是目前业界流行的免费开源图像生成大模型。2023年4月份StabilityAI就宣布了SD XL的存在并在2023年7月26日开源。SD XL相比较此前的模型速度更快、提示词更短、生成的图像更加真实。但是,大多数人可能并没有实际运行过,感受过这个模型的魅力。在这篇博客中,我们给大家展示如何利用Google Colab的免费GPU资源,部署一个SD XL模型,并通过prompt生成一些图片。