DataLearner 标志
原创博客

原创AI技术博客

探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。

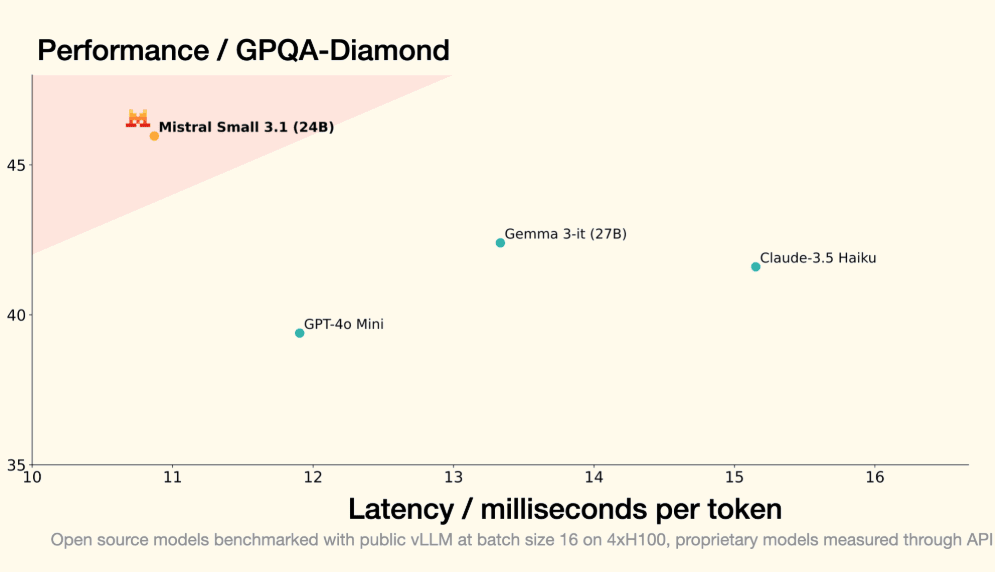
MistralAI开源240亿参数的多模态大模型Mistral-Small-3.1-24B:评测结果与GPT-4o-mini与Gemma 3 27B有来有回,开源且免费商用,支持24种语言

MistralAI开源240亿参数的多模态大模型Mistral-Small-3.1-24B:评测结果与GPT-4o-mini与Gemma 3 27B有来有回,开源且免费商用,支持24种语言

欧洲大模型之光MistralAI开源了2个全新的多模态大模型,即Mistral-Small-3.1-24B基座版本和指令微调版本。这两个大模型均以Apache2.0协议开源,因此可以完全免费商用。而官方也给出了这个模型在多个评测集上的效果,高于GPT-4o-mini和Gemma 3 27B。因为其参数规模较小,推理速度可以达到每秒150个tokens,同时支持多种语言,是一个非常值得关注的小而美的多模态大模型。
2025/03/18 16:41:501,214
准备迎接超级人工智能系统,OpenAI宣布RLHF即将终结!超级对齐技术将接任RLHF,保证超级人工智能系统遵循人类的意志

准备迎接超级人工智能系统,OpenAI宣布RLHF即将终结!超级对齐技术将接任RLHF,保证超级人工智能系统遵循人类的意志

今天,OpenAI在其官网上发布了一个全新的研究成果:一个利用较弱的模型来引导对齐更强模型的能力的技术,称为由弱到强的泛化。OpenAI认为,未来十年来将诞生超过人类的超级AI系统。但是,这会出现一个问题,即基于人类反馈的强化学习技术将终结。因为彼时,人类的水平不如AI系统,所以可能无法再对模型输出的内容评估好坏。为此,OpenAI提出这种超级对齐技术,希望可以用较弱的模型来对齐较强的模型。这样可以在出现比人类更强的AI系统之后可以继续让AI模型可以遵循人类的意志、偏好和价值观。

2023/12/16 08:08:231,212
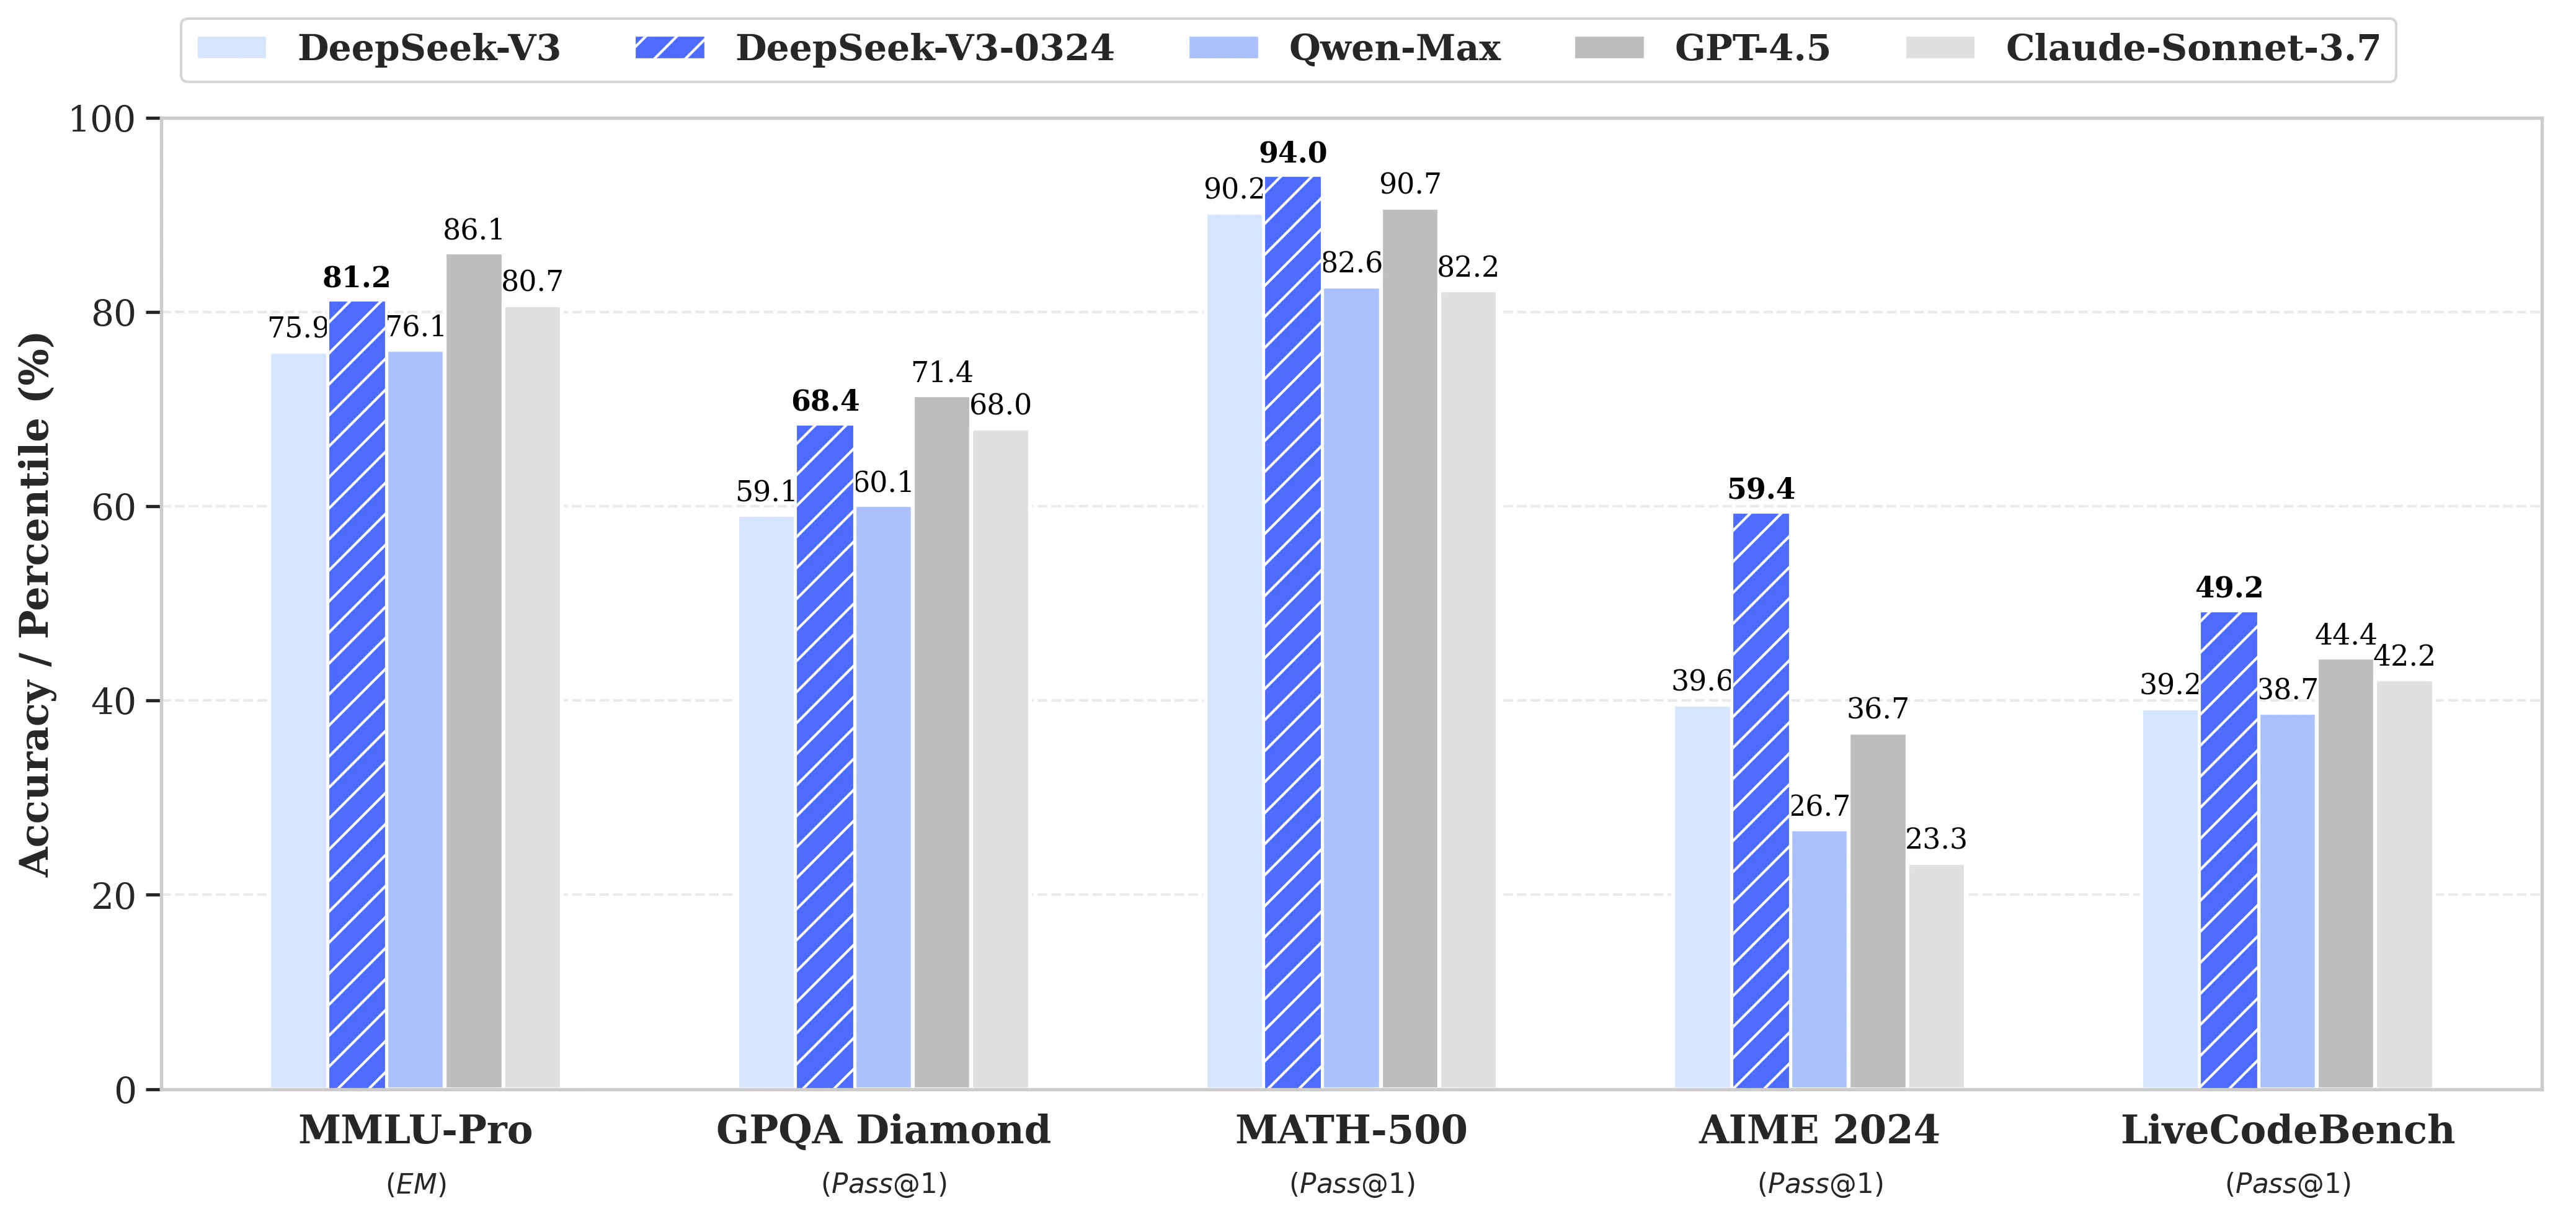
DeepSeekV3-0324发布:DeepSeek V3基础上大幅升级推理能力和前端网页的美观度,多项评测结果超过GPT-4.5

DeepSeekV3-0324发布:DeepSeek V3基础上大幅升级推理能力和前端网页的美观度,多项评测结果超过GPT-4.5

2025年3月25日,DeepSeekAI低调开源了DeepSeek-V3-0324大模型。作为DeepSeek-V3的重要升级版本,该模型在推理能力、中文写作、前端开发以及功能调用等多个关键领域实现了显著提升。在MMLU Pro等评测上,已经成为了非推理大模型中最强的模型,部分评测结果超过GPT-4.5模型。

2025/03/25 19:07:301,204
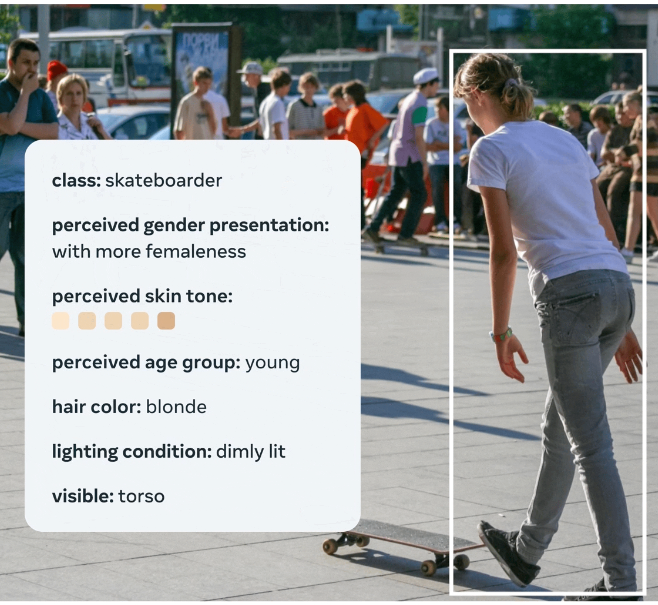
MetaAI开源高质量高精度标注的图像数据集FACET:3.2万张图片、5万个主题,平均图像解析度达到1500×2000

MetaAI开源高质量高精度标注的图像数据集FACET:3.2万张图片、5万个主题,平均图像解析度达到1500×2000

MetaAI在2023年8月31日开源了一个全新的图像数据集,FACET(FAirness in Computer Vision EvaluaTion),FACET数据集包含32,000张图片和50,000人,这些图片由专家进行了详细的标注,包括人口统计属性(如感知性别表达和感知年龄组)和其他物理属性(如感知肤色和发型)。这样的设计使得研究人员可以更全面、更深入地评估模型在不同人群中的表现,从而更准确地识别和解决模型的不公平性问题。

2023/09/01 08:13:081,203
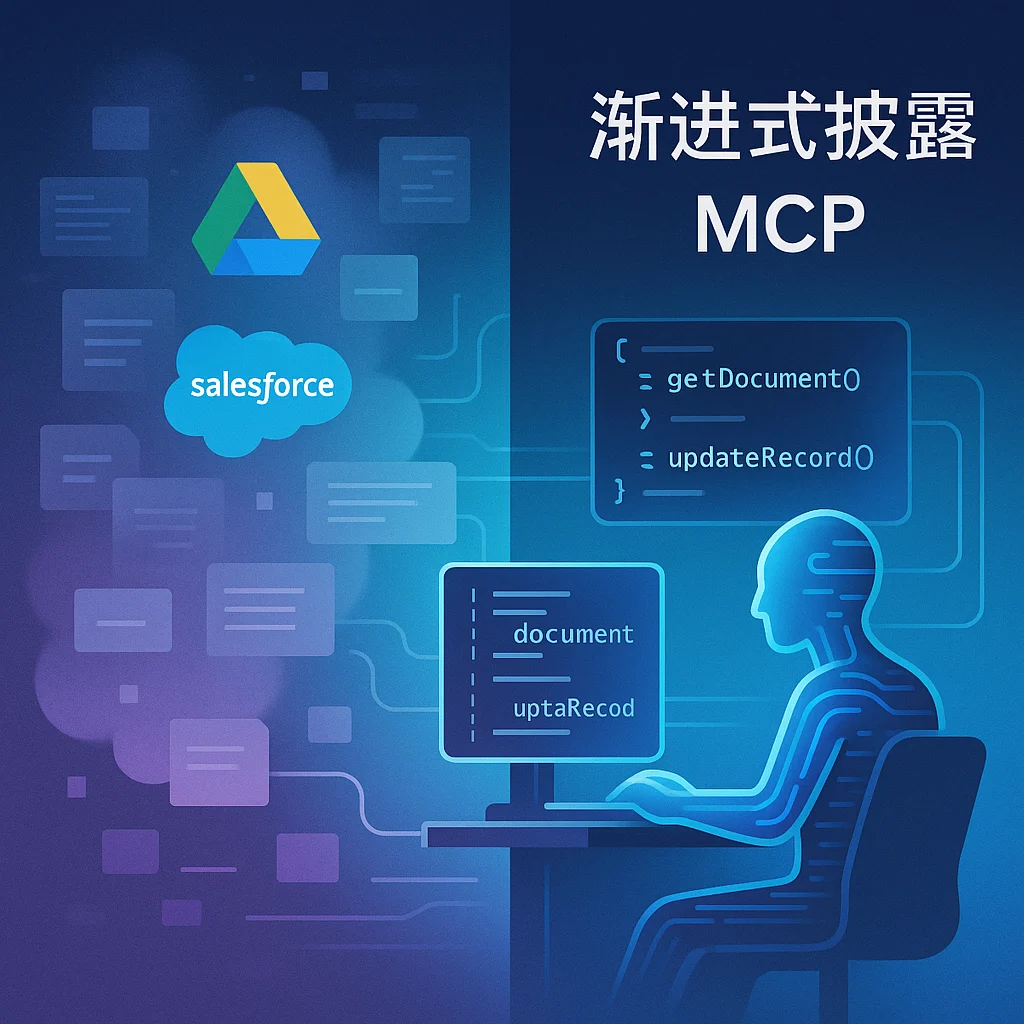
AI Agent工具调用token消耗太多不准确怎么办?Anthropic官方的大模型工具使用(MPC)优化:tokens消耗降低98.7%

AI Agent工具调用token消耗太多不准确怎么办?Anthropic官方的大模型工具使用(MPC)优化:tokens消耗降低98.7%

让AI Agent通过编写代码来调用工具,而不是直接工具调用。这种方法利用了MCP(Model Context Protocol,模型上下文协议)标准,能显著降低token消耗,同时保持系统的可扩展性。下面,我结合原文的逻辑,分享我的理解和改写版本,目的是记录这个洞察,并为后续实验提供参考。Anthropic作为领先的AI研究机构,于2024年11月推出了MCP,这是一个开放标准,旨在简化AI Agent与外部工具和数据的连接,避免传统自定义集成的碎片化问题。

2025/11/06 08:09:551,197
评测结果超过GPT-4,Anthropic发布第三代大语言模型Claude3,具有多模态能力,实际评测表现优秀!

评测结果超过GPT-4,Anthropic发布第三代大语言模型Claude3,具有多模态能力,实际评测表现优秀!

Anthropic被认为是最像OpenAI的一家公司。他们推出的Claude2模型是全球首个支持200K超长上下文的商业模型。在PDF理解方面被认为表现优秀。就在2023年3月4日,Anthropic推出了他们的第三代大语言模型Claude3,包含3个不同的版本,支持多模态和最高100万上下文输入!

2024/03/05 23:21:281,189
MMEB:多模态嵌入基准评测,用于测试多模态向量检索和排序准确性的基准

MMEB:多模态嵌入基准评测,用于测试多模态向量检索和排序准确性的基准

MMEB(Massive Multimodal Embedding Benchmark)是一个用于评估多模态嵌入模型的基准测试框架。该基准最初聚焦于图像-文本嵌入,并在后续版本中扩展到文本、图像、视频和视觉文档输入。MMEB通过收集多样化数据集,提供一个统一的评估平台,用于测试模型在分类、检索和其他任务上的性能。

Google Gemini Pro多模态接口开放!DataLearnerAI第一时间测试Gemini Pro多模态能力,比想象惊喜!

Google Gemini Pro多模态接口开放!DataLearnerAI第一时间测试Gemini Pro多模态能力,比想象惊喜!

Google Gemini是Google最新发布的大模型系列。这是一系列的多模态的大模型,谷歌官方宣布在各项评分中Gemini超过了GPT-4V。但是,谷歌的宣传视频过于夸张被很多人质疑造假嫌疑,导致被全网嘲讽。而今天,Google官方的Gemini多模态接口开放,DataLearnerAI第一时间申请测试,结果让人惊喜。

2023/12/14 01:07:541,188
评测结果超GPT-5 mini和Claude 4 Sonnet,阿里再发开源版本Qwen3-VL模型:手机可运行的Qwen3-VL-2B和Qwen3-VL-32B

评测结果超GPT-5 mini和Claude 4 Sonnet,阿里再发开源版本Qwen3-VL模型:手机可运行的Qwen3-VL-2B和Qwen3-VL-32B

就在今日,阿里巴巴Qwen团队重磅推出Qwen3-VL-2B和Qwen3-VL-32B两款视觉语言模型,这些dense架构的创新之作,将多模态AI的强大能力压缩进更紧凑的框架中,显著降低了部署门槛。 作为Qwen3系列的最新扩展,它们在保持顶级性能的同时,支持从边缘设备到云端的无缝应用——想象一下,一款手机App就能实时分析2小时视频,或从模糊手写笔记中提取精确信息。这不仅仅是参数缩减,更是AI普惠化的关键一步,帮助开发者以更低的成本实现视觉智能的突破。

2025/10/22 21:55:521,188
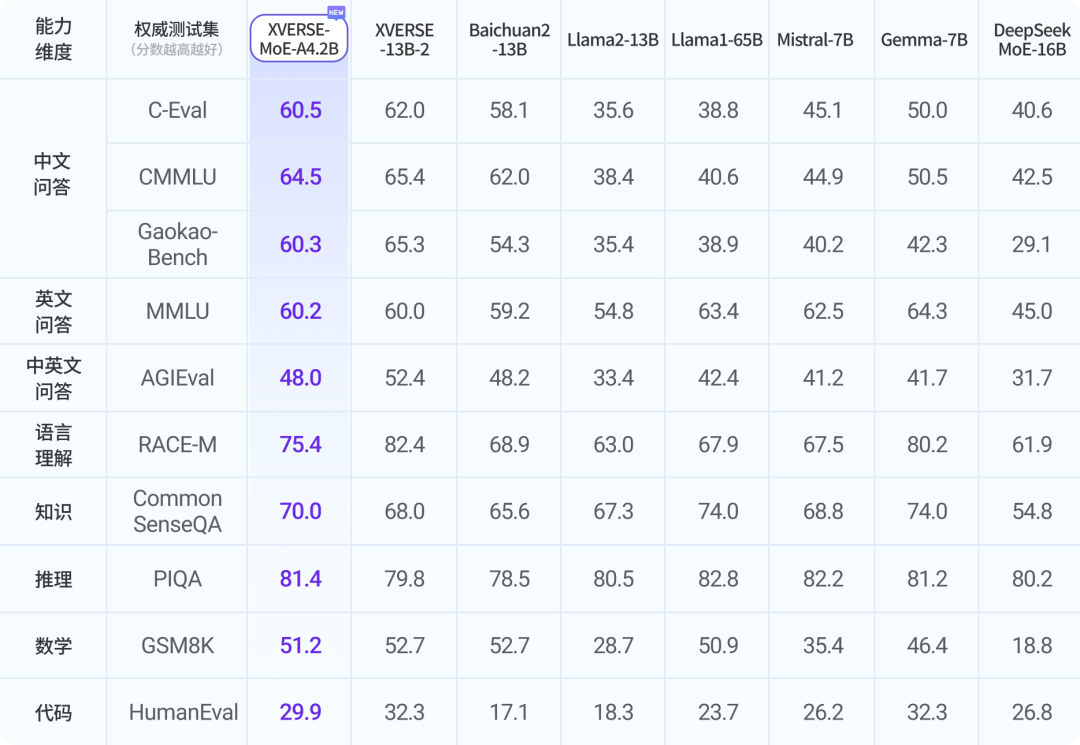
国产MoE架构模型大爆发!深圳元象科技XVERSE开源256亿参数MoE大模型XVERSE-MoE-A4.2B,评测结果接近Llama1-65B

国产MoE架构模型大爆发!深圳元象科技XVERSE开源256亿参数MoE大模型XVERSE-MoE-A4.2B,评测结果接近Llama1-65B

混合专家架构大模型是当前最火热的一个大模型技术发展方向。三月底,业界开源了多个混合专家大模型,包括DBRX、Qwen1.5-MoE-A2.7B等。而在四月初,又一家国产大模型企业开源了一个全新的MoE架构的模型,即深圳元象科技XVERSE开源的XVERSE-MoE-A4.2B。该模型参数256亿,推理时仅激活42亿参数,效果与当前主流的130亿参数的规模差不多。

2024/04/07 22:44:281,184
IFBench:大模型指令跟随能力评测基准详解

IFBench:大模型指令跟随能力评测基准详解

IFBench 是一个针对大语言模型(LLM)指令跟随能力的评测基准。该基准聚焦于模型对新颖、复杂约束的泛化表现,通过 58 个可验证的单轮任务进行评估。发布于 2025 年 7 月,该基准旨在揭示模型在未见指令下的精确执行水平。目前,主流模型在该基准上的得分普遍低于 50%,显示出指令跟随的潜在局限。

SWE-bench Multilingual 多语言软件工程评测基准全面解读:覆盖9种编程语言的大模型评测基准

SWE-bench Multilingual 多语言软件工程评测基准全面解读:覆盖9种编程语言的大模型评测基准

SWE-bench Multilingual 是 SWE-bench 基准系列的扩展版本。该基准用于评估大语言模型在软件工程任务上的表现,覆盖多种编程语言。数据集包含 300 个从真实 GitHub 问题与对应拉取请求中提取的任务,涉及 42 个仓库和 9 种编程语言。模型接收问题描述与仓库快照后,需生成代码补丁,并通过失败到通过(F2P)和通过到通过(P2P)测试套件进行验证。

谷歌提出最新的基于规则和机器学习混合的代码补全方法

谷歌提出最新的基于规则和机器学习混合的代码补全方法

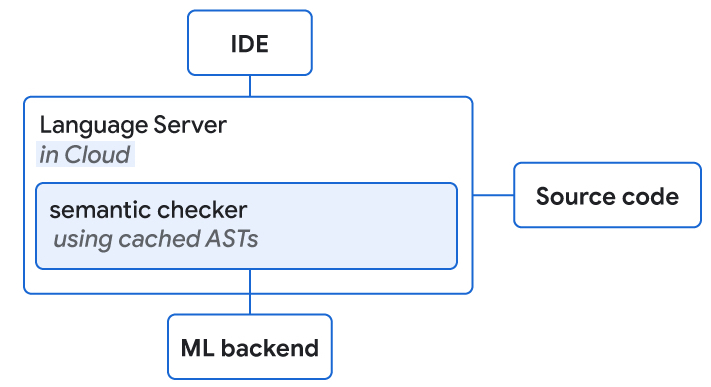
我们将介绍如何将ML和SE结合起来,开发一种新的基于Transformer的混合语义ML代码补全,现在可供内部谷歌开发人员使用。我们讨论了如何通过(1)使用ML对SE单标记建议重新排序,(2)使用ML应用单行和多行补全并使用SE检查正确性,或(3)使用单标记语义建议的ML的单行和多行延拓来组合ML和SE。

2022/07/31 11:29:101,178
ToolTalk:微软发布的一个用以评测大语言模型工具使用能力的评测工具和评测数据集

ToolTalk:微软发布的一个用以评测大语言模型工具使用能力的评测工具和评测数据集

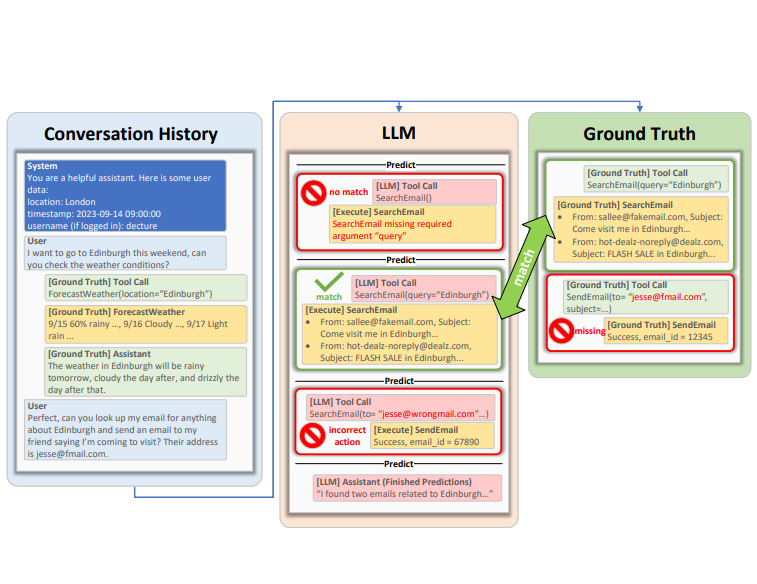
为了更好地评估大语言模型的工具使用能力,微软的研究人员提出了ToolTalk Benchmark基准测试工具,可以帮助我们更加简单地理解大语言模型在工具使用方面的水准。ToolTalk旨在评估大型语言模型(LLMs)在对话环境中使用工具的能力。这些工具可以是搜索引擎、计算器或Web API等,它们能够帮助LLMs访问私有或最新的信息,并代表用户执行操作。

2024/04/05 21:42:101,176
Minion Skills: Claude Skills的开源实现

Minion Skills: Claude Skills的开源实现

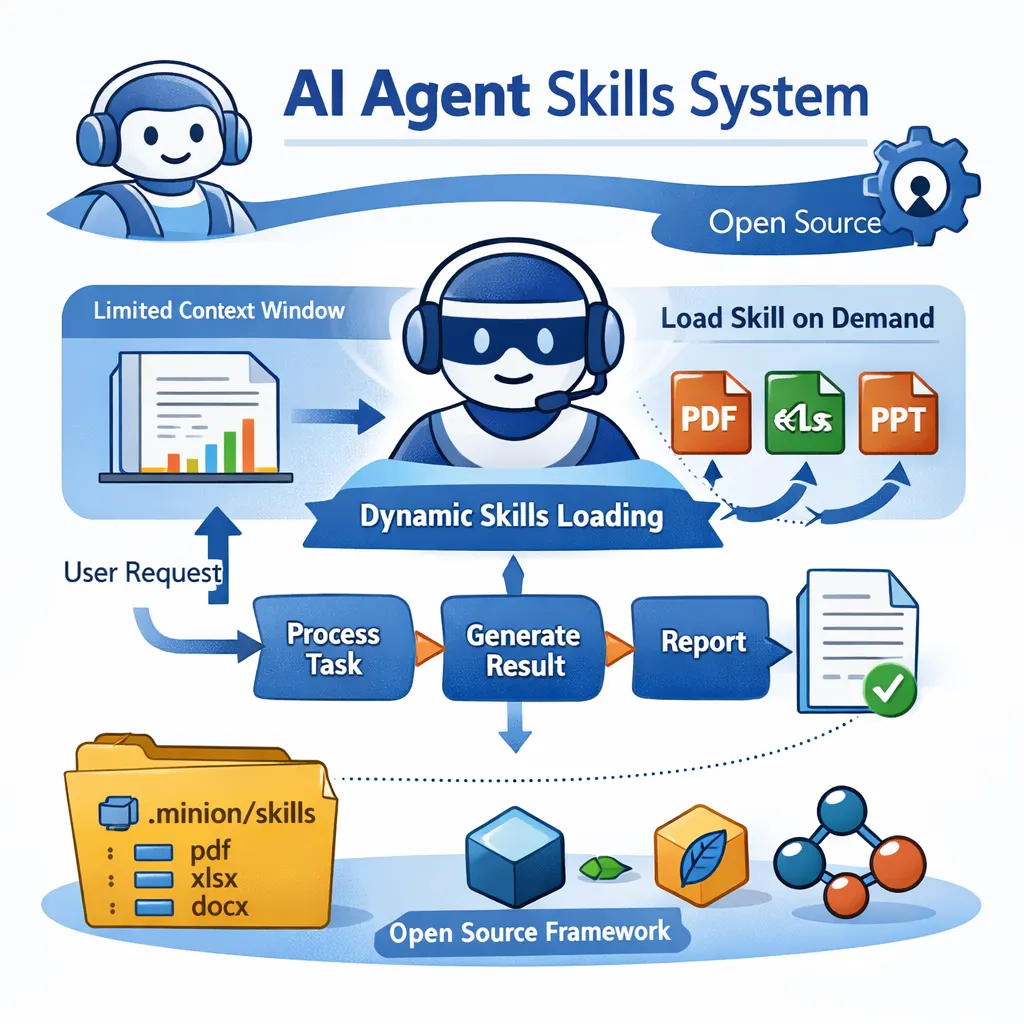
本文介绍了 Claude 最近推出的 Skills 系统,以及作者在 Minion 框架中实现的一个完全开源的版本。Skills 的核心思路是让 AI Agent 在需要时再加载对应的专业能力,而不是一开始就把所有工具和知识都塞进上下文,从而缓解上下文窗口有限、成本高、响应慢的问题。

2025/12/17 22:06:311,166
OpenAI开始提供大模型(GPT系列模型)的提示缓存(Prompt Caching):GPT-4o系列模型输入价格下降一半,访问速度提升80%

OpenAI开始提供大模型(GPT系列模型)的提示缓存(Prompt Caching):GPT-4o系列模型输入价格下降一半,访问速度提升80%

在大模型的应用中,处理复杂请求往往伴随着较高的延迟和成本,尤其是当请求内容存在大量重复部分时。这种“慢请求”的问题,特别是在长提示和高频交互的场景中,显得尤为突出。为了应对这一挑战,OpenAI 最近推出了 **提示缓存(Prompt Caching)** 功能。这项新技术通过缓存模型处理过的相同前缀部分,避免了重复计算,从而大幅减少了请求的响应时间和相关成本。特别是对于包含静态内容的长提示请求,提示缓存能够显著提高效率,降低运行开销。本文将详细介绍这项功能的工作原理、支持的模型,以及如何通过合理的提示结

2024/12/18 22:06:071,165
最高50万美金!全新高额奖金的AI竞赛——AI预测大赛

最高50万美金!全新高额奖金的AI竞赛——AI预测大赛

预测在全球决策中发挥着关键作用。例如,关于COVID-19扩散的预测为国家封锁提供了信息,而经济预测则影响了利率的制定。这些预测通常依赖于人类专家的仔细判断,他们必须考虑来自各种来源的数据。由于人工智能系统能够处理大量的数据,它们在这个领域有可能非常有用。 为此,ML Safety举办了一个关于AI预测的竞赛,比赛的目的是建立一个机器学习模型,做出准确和校准的预测。

2022/10/12 11:37:361,164
Moonshot AI发布Kimi K2-Instruct-0905:256K上下文长度加持,全面升级的开放式智能体模型

Moonshot AI发布Kimi K2-Instruct-0905:256K上下文长度加持,全面升级的开放式智能体模型

今日,Moonshot AI正式发布了最新旗舰模型 Kimi K2-Instruct-0905。这是一款基于混合专家架构(MoE)的前沿大语言模型,总参数规模达到 1万亿,激活参数为 320亿,不仅在编码智能上实现了断层式提升,更凭借 256K超长上下文 成为当前同类产品中的佼佼者。官方称其在公共基准和真实智能体任务上的表现均有显著突破,已对标并超越部分国际顶尖模型。

2025/09/06 04:23:041,160
ChatGPT 3.5只有200亿规模的参数?最新微软的论文暴漏OpenAI的ChatGPT的参数规模远低于1750亿!

ChatGPT 3.5只有200亿规模的参数?最新微软的论文暴漏OpenAI的ChatGPT的参数规模远低于1750亿!

2022年11月底发布的ChatGPT是基于OpenAI的GPT-3优化得到的可以进行对话的一个产品。直到今年更新到3.5和4之后,官方分为两个产品服务,其中ChatGPT 3.5是基于gpt-3.5-turbo打造,免费试用。因此,几乎所有人都自然认为这是一个与GPT-3具有同等规模参数的大模型,也就是说有1750亿参数规模。但是,在10月26日微软公布的CodeFusion论文的对比中,大家发现,微软的表格里面写的ChatGPT 3.5只有200亿参数规模。

2023/10/30 21:29:541,153