DataLearner 标志
标签

「R」相关文章(第4页)

汇总「R」相关的原创 AI 技术文章与大模型实践笔记,持续更新。

标签:#R
重磅!MetaAI开源Llama4系列,全面进入MoE架构时代,本次发布Llama4 Scout和Llama4 Maverick,1000万上下文输入,170亿激活参数,不支持中文!

重磅!MetaAI开源Llama4系列,全面进入MoE架构时代,本次发布Llama4 Scout和Llama4 Maverick,1000万上下文输入,170亿激活参数,不支持中文!

就在刚刚,MetaAI发布了全新一代Llama4大模型,Llama正式进入多模态和MoE架构时代。本次新发布的是Llama4中的2个模型分别是Llama4 Scout和Llama4 Maverick。这两个模型都是170亿激活参数,但是前者共16个专家,后者有128个专家,因此总的参数量分别达到了1090亿和4000亿!不过根据评测的情况看,即使是4000亿规模170亿激活的模型,也和DeepSeek V3.1(即DeepSeek V3 0324)版本差不多。
2025/04/06 08:41:471,002
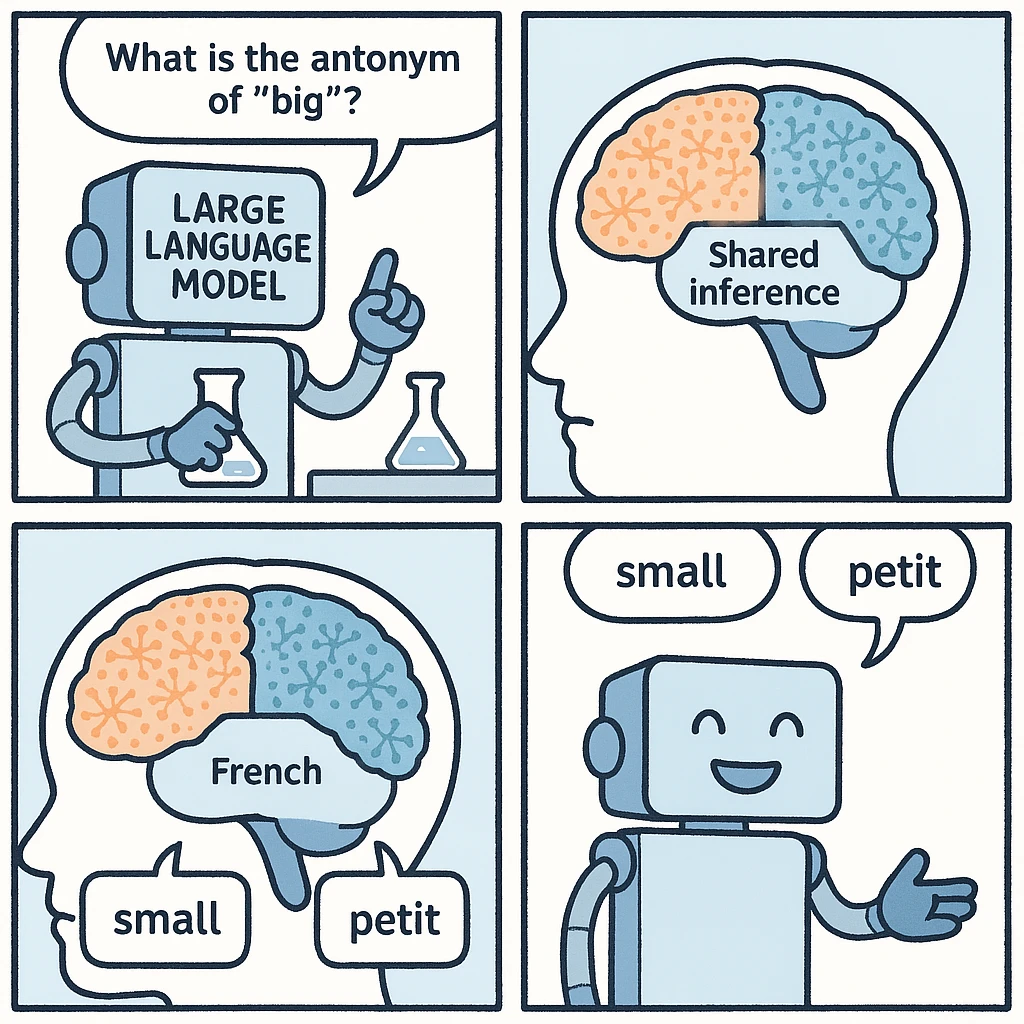
大模型的多语言能力来自哪里?大模型是否有自己的内部语言?在英文数据集上学习到的知识可以用中文表达出来吗?

大模型的多语言能力来自哪里?大模型是否有自己的内部语言?在英文数据集上学习到的知识可以用中文表达出来吗?

最近,Anthropic研究人员通过观察大模型内部运作机制发现了大模型内部可能存在一种与特定语言无关的内部共享区域,它可以把不同语种的输入,在同样的区域进行内部推理,并最终根据语种输出答案。这个现象让我们发现大模型本身理解语言的时候可能与人类类似,拥有高度抽象的内部表示,能够跨越多种语言统一相同的概念。

2025/03/30 18:41:001,307
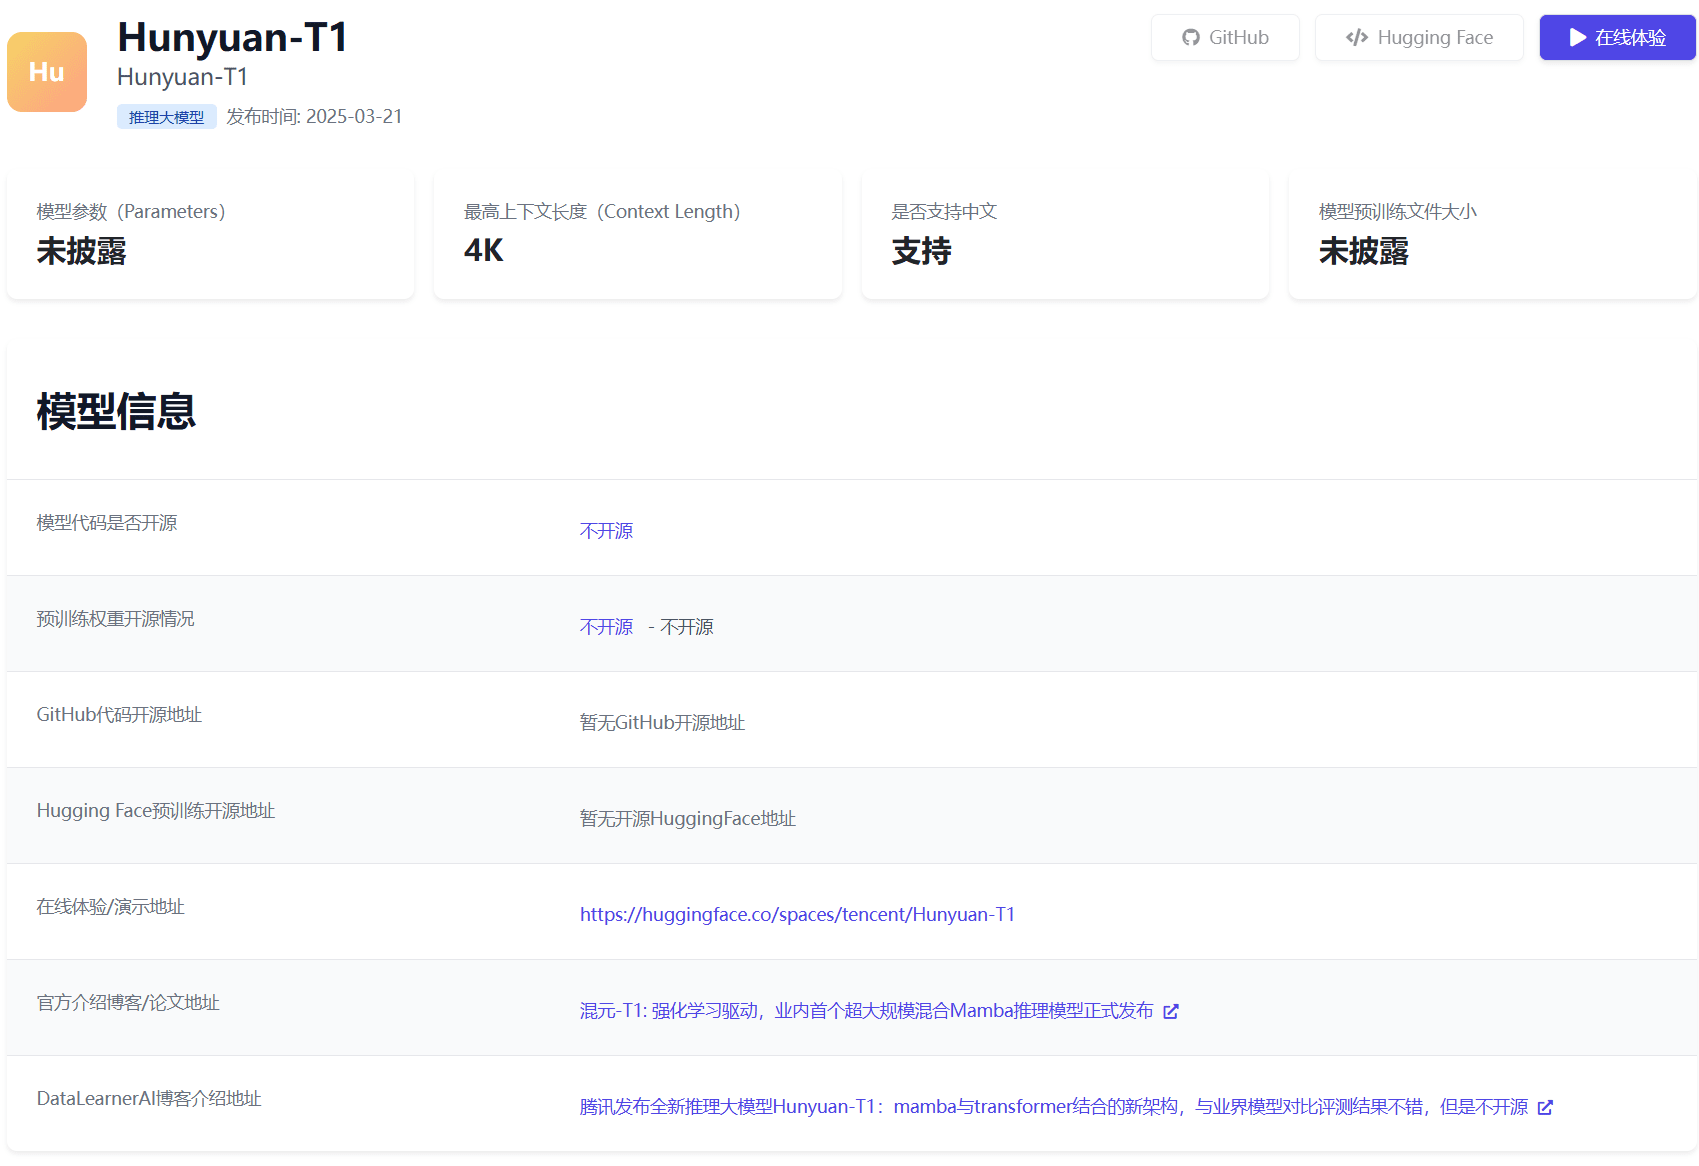
腾讯发布全新推理大模型Hunyuan-T1:mamba与transformer结合的新架构,与业界模型对比评测结果不错,但是不开源

腾讯发布全新推理大模型Hunyuan-T1:mamba与transformer结合的新架构,与业界模型对比评测结果不错,但是不开源

2025年3月21日,腾讯正式推出其全新大模型**Hunyuan-T1**,该模型基于此前发布的TurboS快速思维基座,首次采用**Hybrid-Transformer-Mamba混合专家架构(MoE)**,在推理效率、长文本处理及资源消耗优化等方面表现还不错。此外,这个新架构也使得Hunyuan-T1速度非常快,模型支持首字符1秒内响应,生成速度达60-80 token/秒,适用于实时交互场景。

2025/03/22 11:43:191,570
三年后OpenAI再次发布自动语音识别和语音合成大模型(替换Whisper系列):不开源,仅提供API,英文错字率已经下降到2.46%

三年后OpenAI再次发布自动语音识别和语音合成大模型(替换Whisper系列):不开源,仅提供API,英文错字率已经下降到2.46%

2025年3月20日,OpenAI 推出了三款新模型——gpt-4o-transcribe、gpt-4o-mini-transcribe 和 gpt-4o-mini-tts——标志着自动语音识别 (ASR) 和文本转语音 (TTS) 领域的重要进步。这些模型基于 GPT-4o 架构,旨在为开发人员和用户提高准确性、自定义能力和可访问性,与 OpenAI 对于代理式 AI 系统的更广泛愿景一致。本文提供了对每个模型、其能力、定价、可用性和竞争环境的详细审查,确保技术和非技术受众都能全面理解。

2025/03/21 13:18:491,948
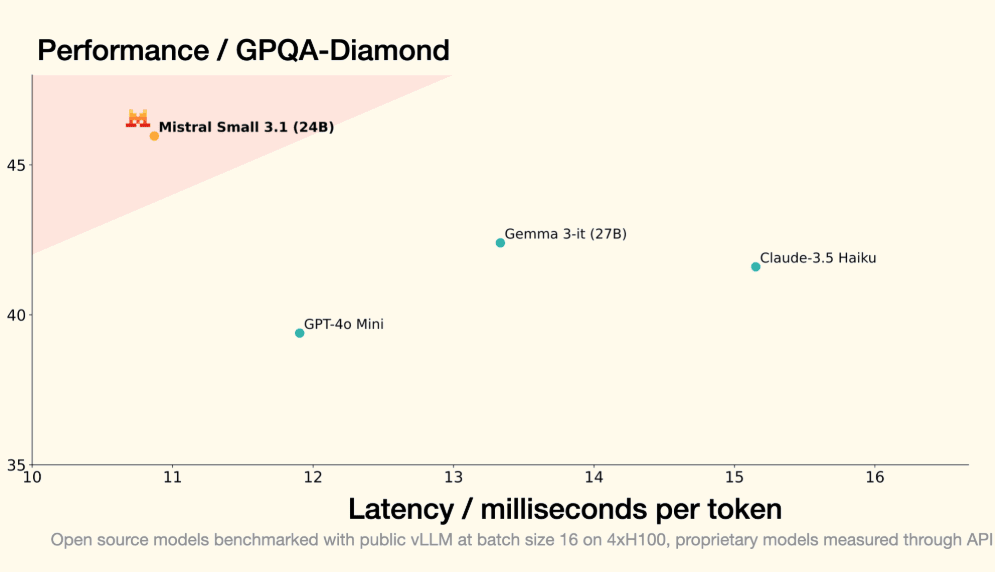
MistralAI开源240亿参数的多模态大模型Mistral-Small-3.1-24B:评测结果与GPT-4o-mini与Gemma 3 27B有来有回,开源且免费商用,支持24种语言

MistralAI开源240亿参数的多模态大模型Mistral-Small-3.1-24B:评测结果与GPT-4o-mini与Gemma 3 27B有来有回,开源且免费商用,支持24种语言

欧洲大模型之光MistralAI开源了2个全新的多模态大模型,即Mistral-Small-3.1-24B基座版本和指令微调版本。这两个大模型均以Apache2.0协议开源,因此可以完全免费商用。而官方也给出了这个模型在多个评测集上的效果,高于GPT-4o-mini和Gemma 3 27B。因为其参数规模较小,推理速度可以达到每秒150个tokens,同时支持多种语言,是一个非常值得关注的小而美的多模态大模型。

2025/03/18 16:41:501,271
腾讯发布了一个全新的大模型Hunyuan Turbo S:号称评测效果超过GTP-4o和DeepSeek V3等模型,但没有开源或者放开使用

腾讯发布了一个全新的大模型Hunyuan Turbo S:号称评测效果超过GTP-4o和DeepSeek V3等模型,但没有开源或者放开使用

Hunyuan大模型是腾讯训练的大模型品牌名,2022年4月份,某中文语言理解能力排行榜第一名就出现了Hunyuan模型,在2022年11月,Hunyuan大模型就有了1万亿参数的规模,即HunYuan-NLP 1T大模型(比ChatGPT还早发布)。但是最近2年,这个系列的模型几乎没有出现在公众视野上。而昨天(2025年3月10日),Hunyuan官方在X平台上宣布了旗下最新的Hunyuan Turbo S大模型,称其在多个评测基准上超越了GPT-4o的表现。

2025/03/11 22:51:481,431
什么时候该使用推理大模型?OpenAI官方推出推理大模型和大语言模型的最佳使用指南

什么时候该使用推理大模型?OpenAI官方推出推理大模型和大语言模型的最佳使用指南

随着DeepSeek R1和OpenAI的o1、o3等推理大模型的发布,我们当前可使用的大模型种类也变多了。但是,推理大模型和普通大模型之间并不是二选一的关系,在不同的问题上二者各有优势。为了让大家更清晰理解推理大模型和普通大模型的应用场景。OpenAI官方推出了一个推理大模型最佳实践指南。描述了二者的对比。本文将总结这份推理大模型最佳实践指南。

2025/03/05 12:53:441,403
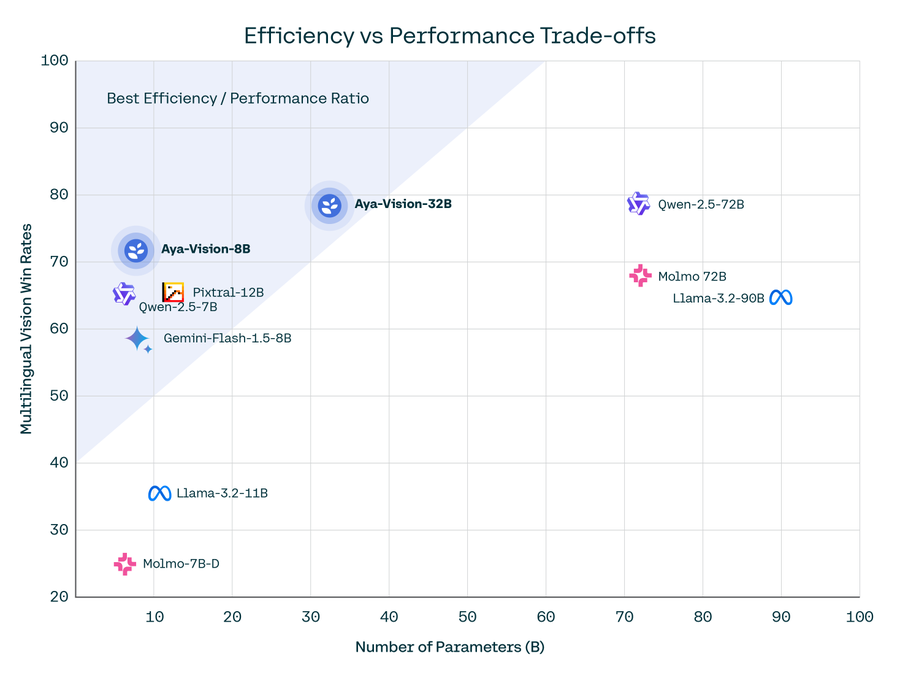
CohereAI开源了2个Aya Vision多模态大模型:80亿和320亿两种规格多模态大模型,评测结果超越Qwen2.5 72B和Llama 3.2 90B,支持23种语言

CohereAI开源了2个Aya Vision多模态大模型:80亿和320亿两种规格多模态大模型,评测结果超越Qwen2.5 72B和Llama 3.2 90B,支持23种语言

Cohere For AI 推出了 Aya Vision 系列,这是一组包含 80 亿(8B)和 320 亿(32B)参数的视觉语言模型(VLMs)。这些模型针对多模态AI系统中的多语言性能挑战,支持23种语言。Aya Vision 基于 Aya Expanse 语言模型,并通过引入视觉语言理解扩展了其能力。该系列模型旨在提升同时需要文本和图像理解的任务性能。

2025/03/04 23:24:06716
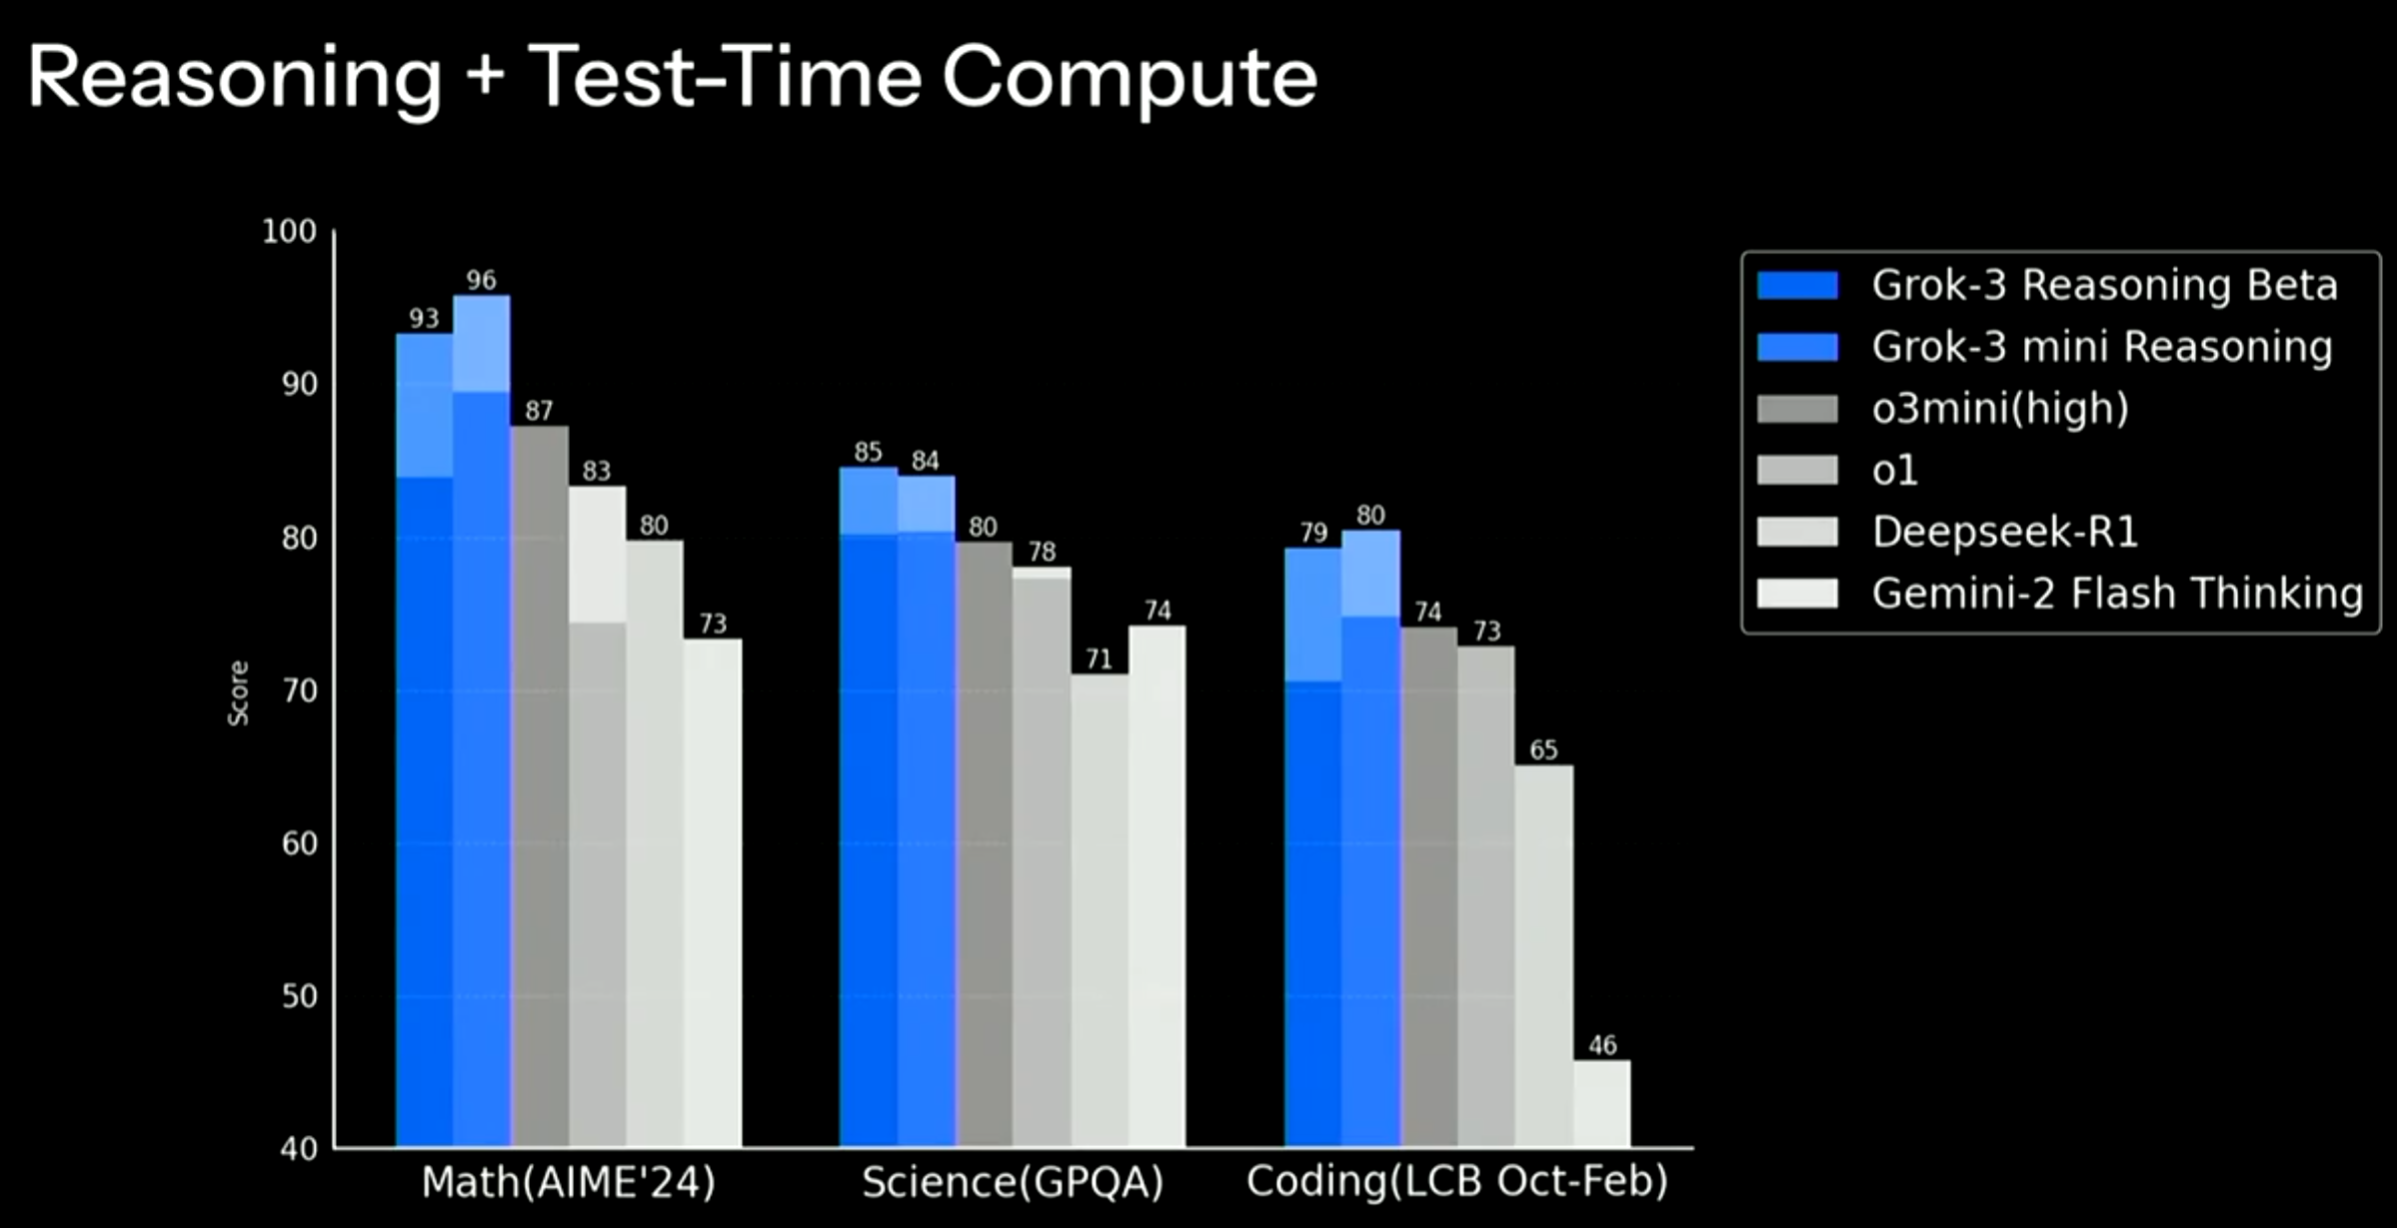
Anthropic发布Claude 3.7 Sonnet大模型,全球最强编程模型再次进步。业界第一个既支持标准输出也支持扩展思考推理双重模式的单一大模型,评测结果超DeepSeek R1,低于Grok3-Beta Reasoning,免费用户可用

Anthropic发布Claude 3.7 Sonnet大模型,全球最强编程模型再次进步。业界第一个既支持标准输出也支持扩展思考推理双重模式的单一大模型,评测结果超DeepSeek R1,低于Grok3-Beta Reasoning,免费用户可用

2025年2月25日,Anthropic发布了Claude 3.7 Sonnet大模型,该模型是业界第一个同时支持标准输出和深度推理模式的单一大模型,各项评测相比较Claude Sonnet 3.5大幅提升。特别是代码能力进一步增强。

2025/02/25 14:25:561,464
SWE-Lancer:OpenAI发布的一个全新大模型评测基准,用来测试大模型解决真实世界软件工程的能力

SWE-Lancer:OpenAI发布的一个全新大模型评测基准,用来测试大模型解决真实世界软件工程的能力

短短两年间,AI技术的进步为软件工程带来了新的可能性。然而,这些模型在真实世界的软件工程任务中究竟能发挥多大的作用?它们能否通过完成实际的软件工程任务来赚取可观的收入?为了验证大模型解决真实任务的能力和水平,OpenAI发布了一个全新的大模型评测基准SWE-Lancer来评测大模型这方面的能力。

2025/02/19 21:40:31814
Google发布Gemini 2.0 Pro:MMLU Pro评测超过DeepSeek V3略低于DeepSeek R1,最高上下文长度支持200万tokens!开发者每天免费50次请求!

Google发布Gemini 2.0 Pro:MMLU Pro评测超过DeepSeek V3略低于DeepSeek R1,最高上下文长度支持200万tokens!开发者每天免费50次请求!

2025年2月5日,Google官方宣布Gemini 2.0 Pro版本上线,Gemini系列是谷歌最新一代大模型的品牌名称。Google最早在2024年12月中旬发布了Gemini 2.0系列的第一个模型Gemini 2.0 Flash,当时试用的人都普遍反应这个模型速度又快,结果友好,让Google摆脱了此前大模型很落后的印象。今天,Gemini 2.0 Pro上线,其能力更强。

2025/02/06 19:18:021,669
MMLU Pro大模型评测基准介绍:MMLU的进化版本,可以更好区分大模型普遍知识和推理能力的通用评测标准

MMLU Pro大模型评测基准介绍:MMLU的进化版本,可以更好区分大模型普遍知识和推理能力的通用评测标准

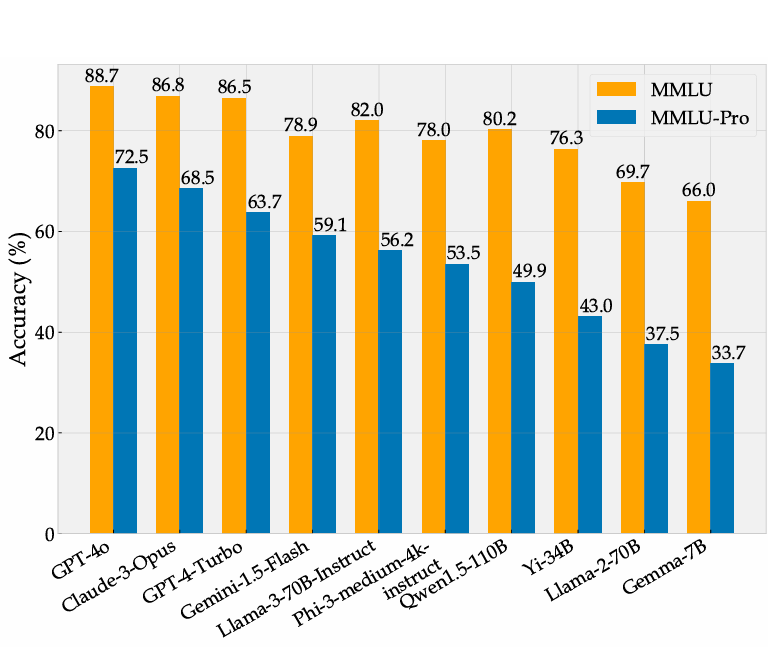
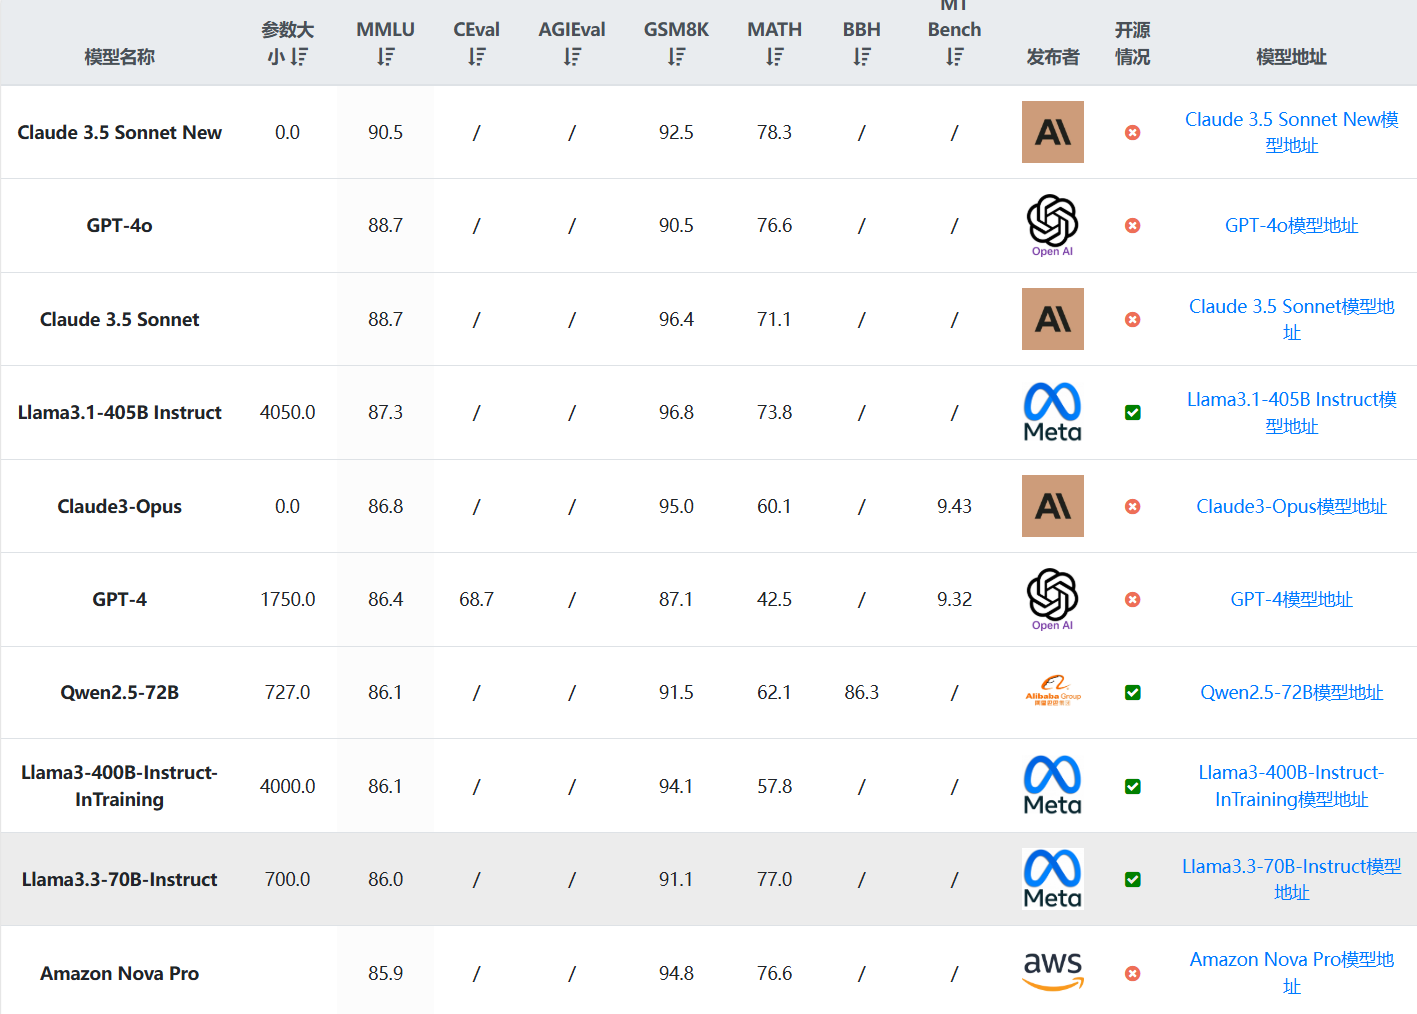
大模型已经对很多行业产生了巨大的影响,如何准确评测大模型的能力和效果,已经成为业界亟待解决的关键问题。生成式AI模型,如大型语言模型(LLMs),能够生成高质量的文本、代码、图像等内容,但其评测却相对很困难。而此前很多较早的评测也很难区分当前最优模型的能力。 以MMLU评测为例,2023年3月份,GPT-4在MMLU获得了86.4分之后,将近2年后的2024年年底,业界最好的大模型在MMLU上得分也就90.5,提升十分有限。 为此,滑铁卢大学、多伦多大学和卡耐基梅隆大学的研究人员一起提出了MMLU P

2025/02/06 08:13:313,298
20条关于DeepSeek的FAQ解释DeepSeek发布了什么样的模型?为什么大家如此关注这些发布的模型?他们真的绕过CUDA限制,打破了Nvidia的护城河了吗?

20条关于DeepSeek的FAQ解释DeepSeek发布了什么样的模型?为什么大家如此关注这些发布的模型?他们真的绕过CUDA限制,打破了Nvidia的护城河了吗?

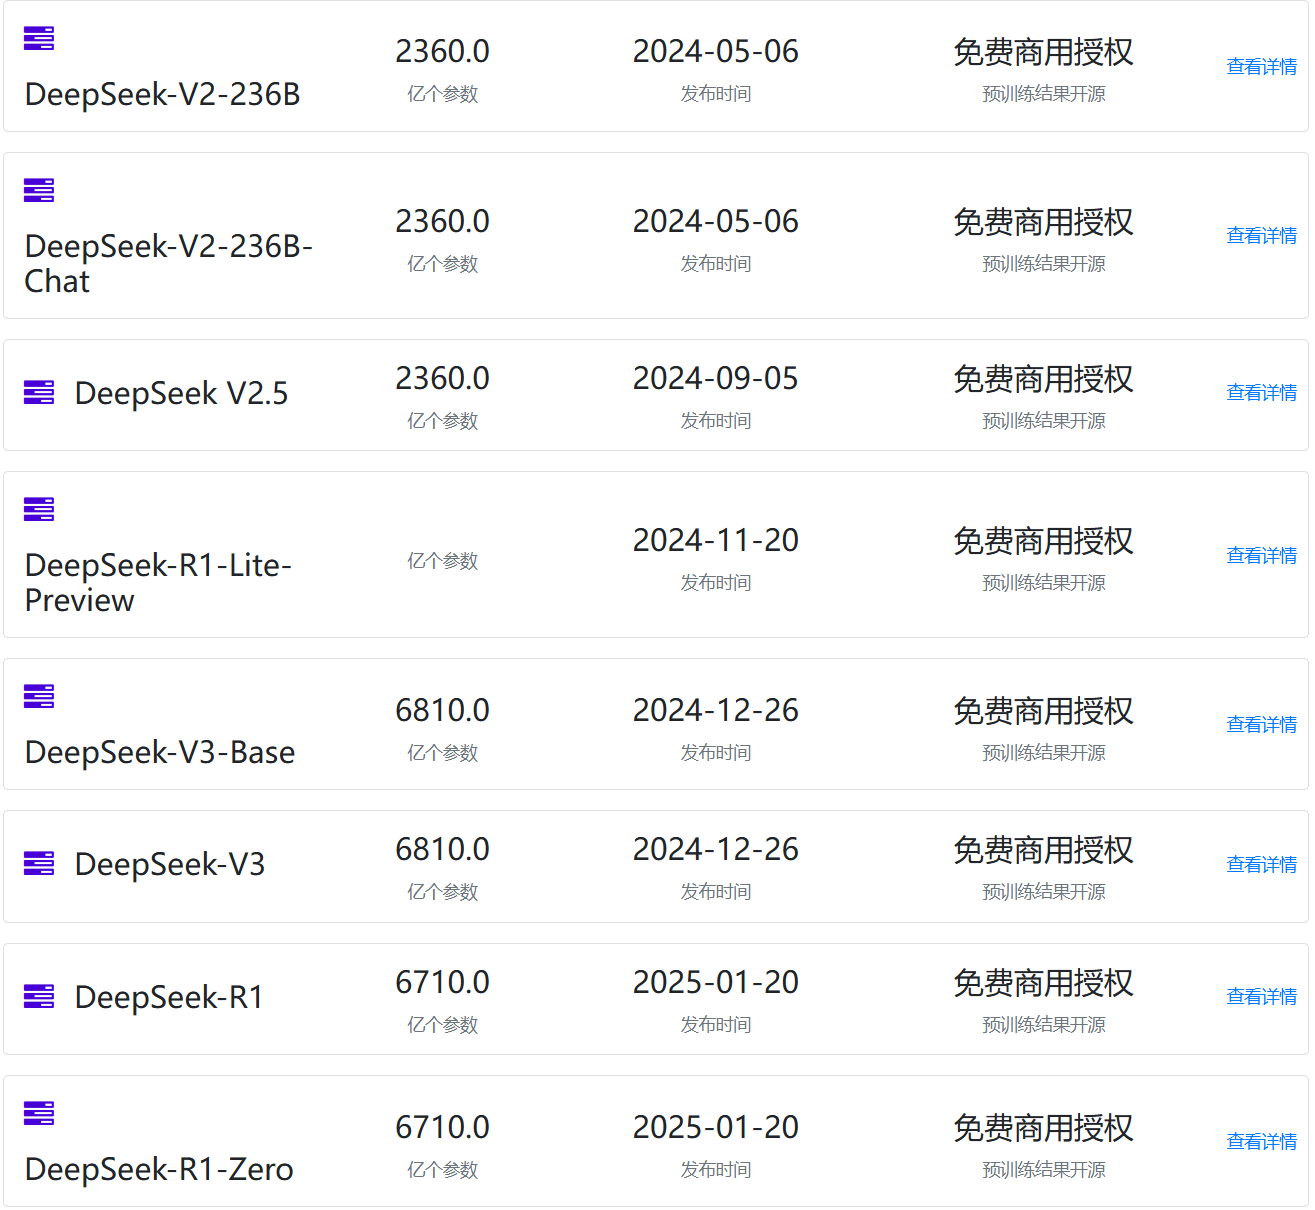
DeepSeekAI最近发布的几个模型,如DeepSeek V3、DeepSeek R1等引起了全球的广泛关注和讨论,特别是低成本训练出高质量模型之后,引起了很多的争论。引起了大家对OpenAI、英伟达等公司未来的质疑。然而,对于DeepSeekAI的模型为什么引起了如此广泛的关注,以及大家讨论的核心内容是什么,很多人并不是很清楚。本文基于著名的独立科技行业分析师Ben Thompson的总结,配合DataLearnerAI的分析,为大家总结DeepSeek引起的全球讨论。

2025/02/02 17:33:131,516
Arena Hard:LM-SYS推出的更难更有区分度的大模型评测基准

Arena Hard:LM-SYS推出的更难更有区分度的大模型评测基准

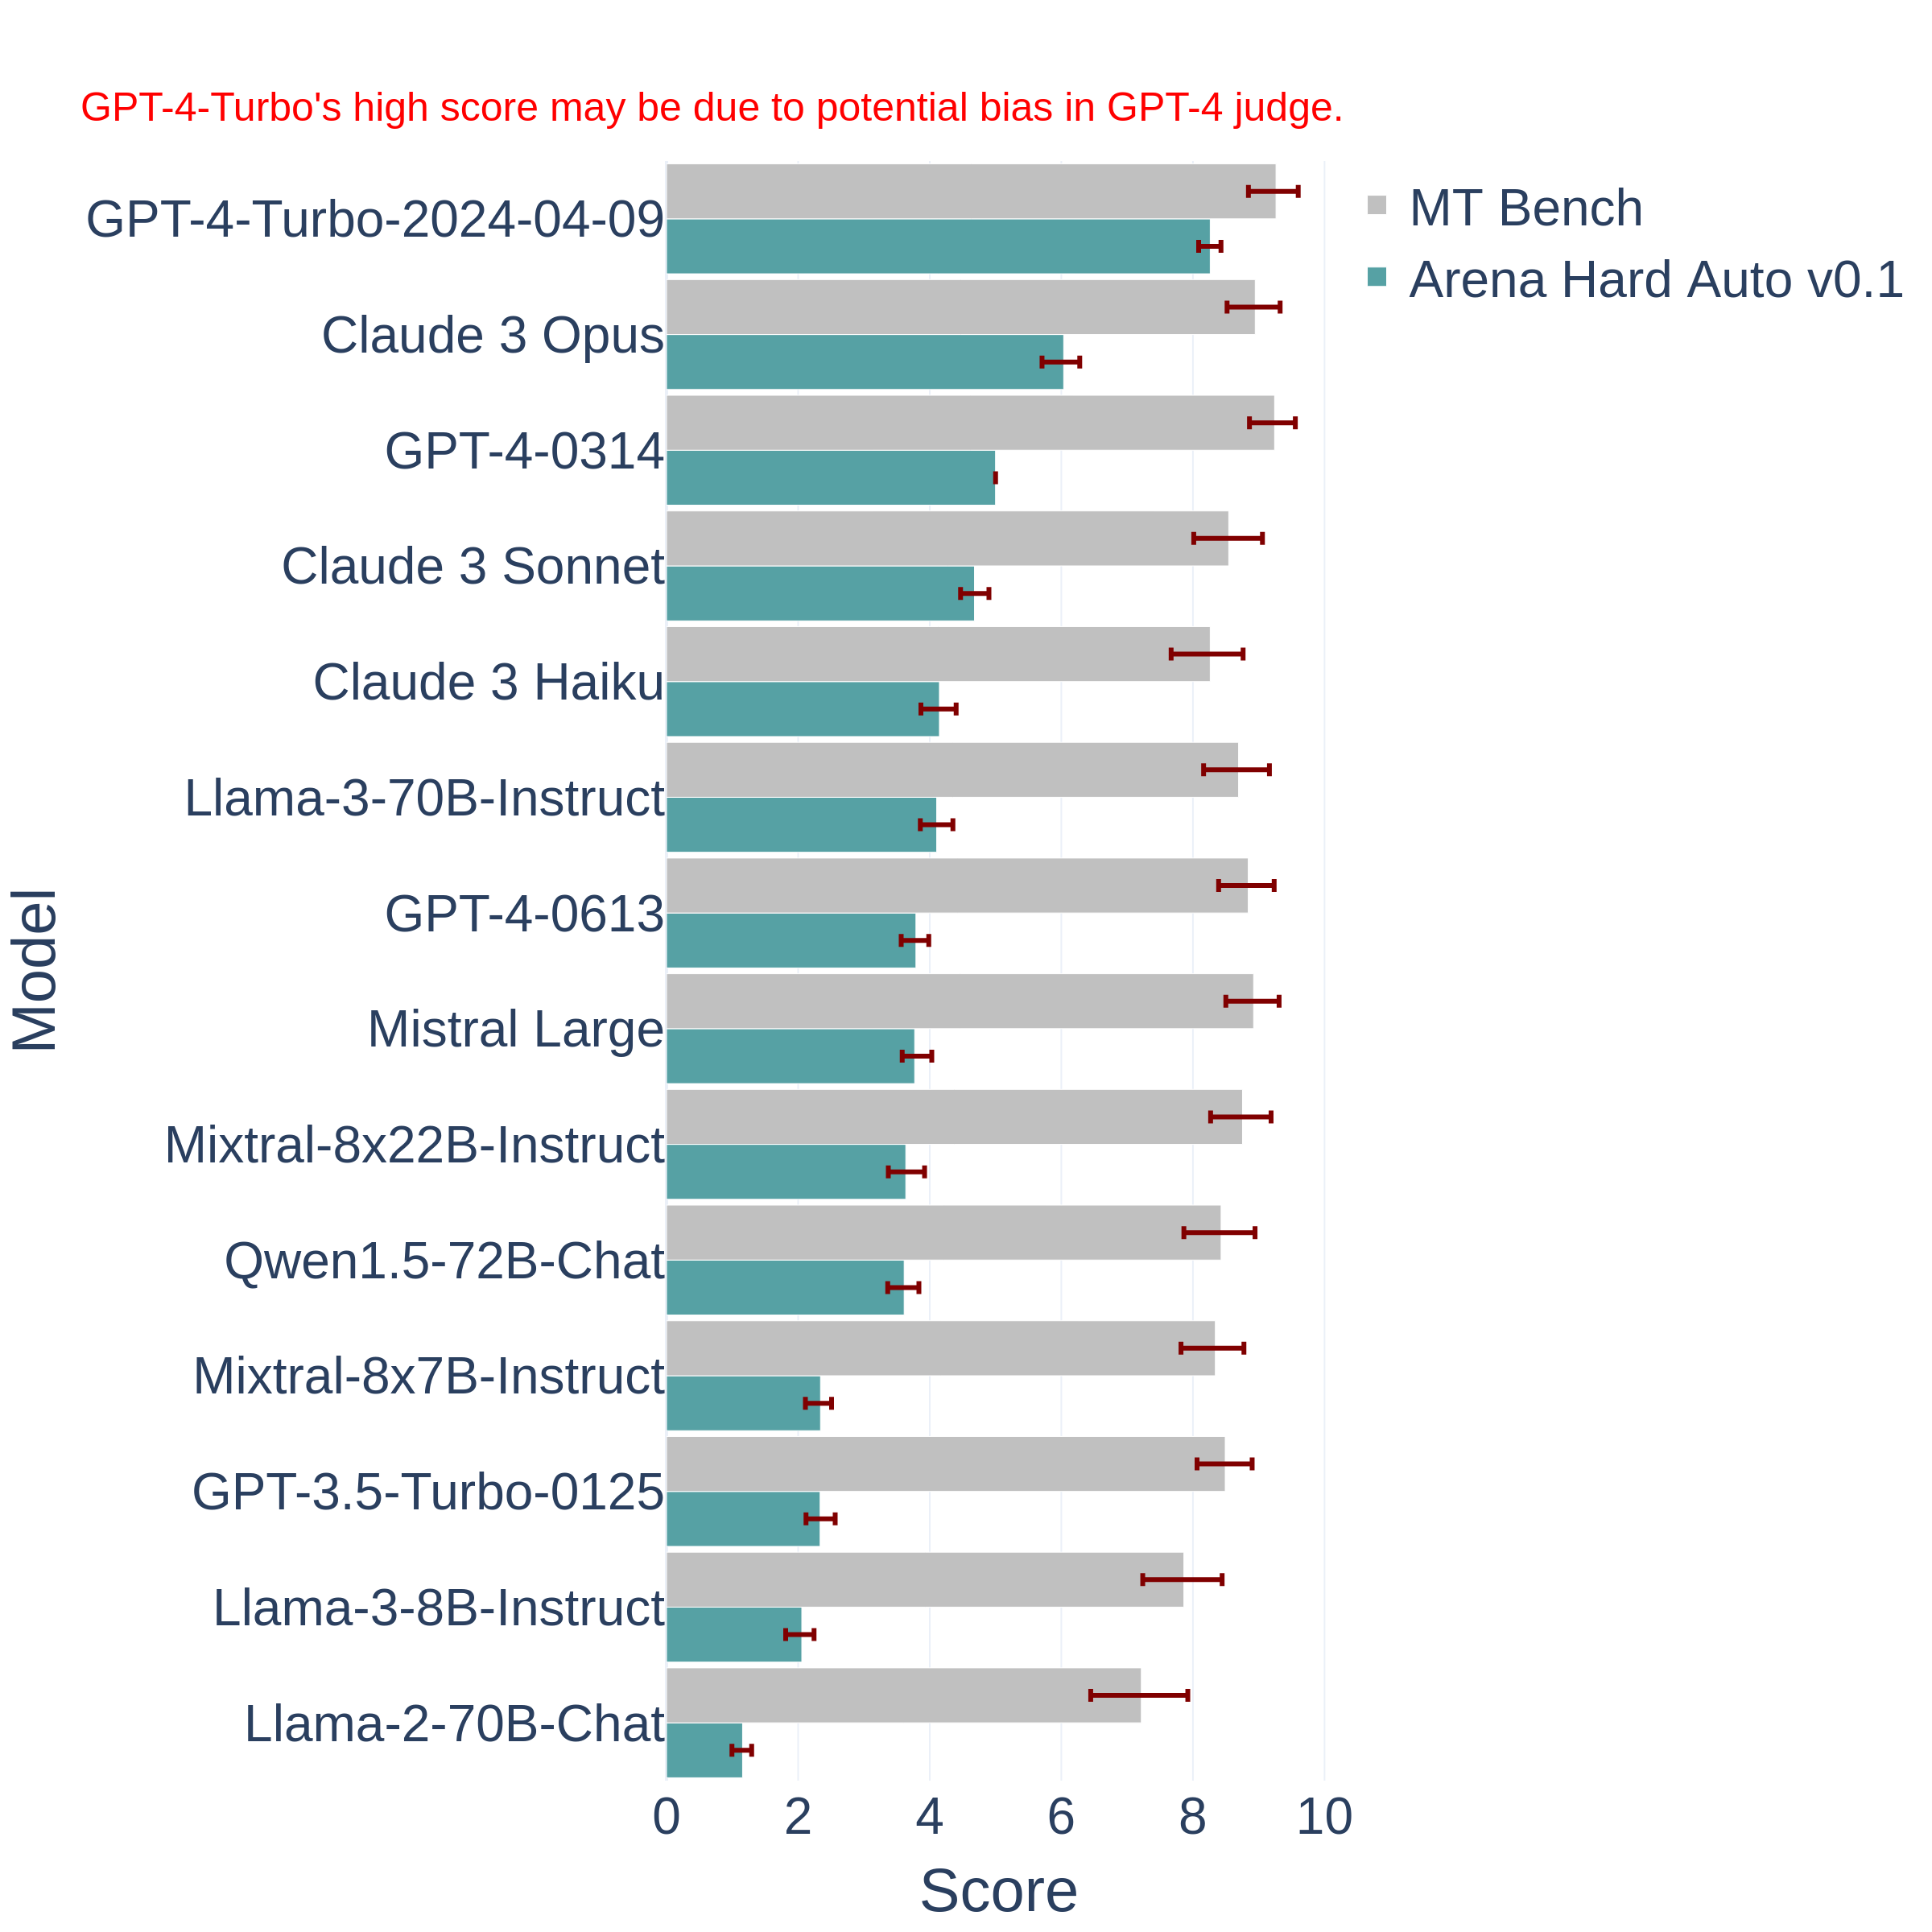
评估日益发展的大型语言模型(LLM)是一个复杂的任务。传统的基准测试往往难以跟上技术的快速进步,容易过时且无法捕捉到现实应用中的细微差异。为此,LM-SYS研究人员提出了一个全新的大模型评测基准——Arena Hard。这个平常基准是基于Chatbot Arena发展而来,相比较常规的评测基准,它更难也更全面。

2025/01/30 20:38:311,468
OpenAI开始提供大模型(GPT系列模型)的提示缓存(Prompt Caching):GPT-4o系列模型输入价格下降一半,访问速度提升80%

OpenAI开始提供大模型(GPT系列模型)的提示缓存(Prompt Caching):GPT-4o系列模型输入价格下降一半,访问速度提升80%

在大模型的应用中,处理复杂请求往往伴随着较高的延迟和成本,尤其是当请求内容存在大量重复部分时。这种“慢请求”的问题,特别是在长提示和高频交互的场景中,显得尤为突出。为了应对这一挑战,OpenAI 最近推出了 **提示缓存(Prompt Caching)** 功能。这项新技术通过缓存模型处理过的相同前缀部分,避免了重复计算,从而大幅减少了请求的响应时间和相关成本。特别是对于包含静态内容的长提示请求,提示缓存能够显著提高效率,降低运行开销。本文将详细介绍这项功能的工作原理、支持的模型,以及如何通过合理的提示结

2024/12/18 22:06:071,210
Meta开源Llama3.3-70B-Instruct模型:大模型后训练的佳作,性能超越4050亿参数规模的Llama3.1-405B大模型!

Meta开源Llama3.3-70B-Instruct模型:大模型后训练的佳作,性能超越4050亿参数规模的Llama3.1-405B大模型!

Llama系列大语言模型一直是开源领域的大模型标杆,Llama3系列大模型自从开源之后一直在不断更新。最早的Llama3模型于2024年4月开源,此后,几乎每个三个月都有一个新版本发布。就在昨天,Meta开源了最新的Llama3.3-70B模型,这是Llama3.3系列目前唯一开源的模型。尽管该模型的参数规模仅仅700亿,但是在多项评测基准上已经超过了4050亿参数规模的Llama3.1-405B,后者是Llama系列模型中参数规模最大的一个,也是业界开源模型中参数规模最高的模型之一。

2024/12/08 22:35:451,744
重磅!OpenAI发布正式版o1模型,推理能力再次提升,且开启商业化使用,每个月200美元不限量使用!

重磅!OpenAI发布正式版o1模型,推理能力再次提升,且开启商业化使用,每个月200美元不限量使用!

几个小时前,OpenAI开启了今年密集的产品发布时间,本次发布会持续12天,直播12天。几个小时前,第一个发布的产品宣布,那就是OpenAI o1模型的正式版。同时也开启了一个全新的ChatGPT付费计划,即ChatGPT Pro,每个月200美元,可以不限量使用所有模型。本文详细介绍OpenAI o1模型。

2024/12/06 07:35:141,629
OpenAI的推理大模型o1模型的强有力竞争者!DeepSeekAI发布DeepSeek-R1-Lite-Preview~实测结果令人惊喜!

OpenAI的推理大模型o1模型的强有力竞争者!DeepSeekAI发布DeepSeek-R1-Lite-Preview~实测结果令人惊喜!

OpenAI的o1模型被认为是大模型领域中推理能力最强的代表之一,由于其强大的数学逻辑推理能力,被认为是大模型未来的进化方向。而就在2个月之后的11月快结束的时间里,幻方量化旗下人工智能企业DeepSeekAI发布了全新的DeepSeek-R1-Lite-Preview模型,号称是o1模型的有力挑战者。该模型利用了类似的o1的思维链思索过程,推理能力大幅增强。DataLearnerAI将在本文中对该模型进行介绍,并进行几个简单的对比结果测试。结果证明这个模型是非常优秀的!

2024/11/28 13:40:521,165
阿里开源推理大模型QwQ-32B-Preview:开源领域对OpenAI o1模型奋起直追,能力接近o1-mini,超过GPT-4o!

阿里开源推理大模型QwQ-32B-Preview:开源领域对OpenAI o1模型奋起直追,能力接近o1-mini,超过GPT-4o!

随着OpenAI发布推理大模型o1,专注于推理能力的大模型开始被广泛关注。基于思维链探索的推理大模型也不断涌现。此前,DeepSeekAI与上海人工智能实验室都发布过推理大模型,也展现了很不错的推理能力,虽然DeepSeekAI官方承诺该模型会开源,但是目前还没有发布。今天,阿里开源了一个全新的推理大模型QwQ-32B-Preview,其推理能力在评测结果上超过o1-mini,是目前开源领域最强的推理大模型(也可能是目前唯一)。

2024/11/28 13:40:411,038