DataLearner 标志
原创博客

原创AI技术博客

探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。

Moltbook 是什么?一个专为 AI Agent 或者说是 OpenClaw(前身为 Clawdbot 或 Moltbot)设计的社交网络,以及最有趣的讨论案例收集

Moltbook 是什么?一个专为 AI Agent 或者说是 OpenClaw(前身为 Clawdbot 或 Moltbot)设计的社交网络,以及最有趣的讨论案例收集

Moltbook 是一个创新的社交网络平台,专为 AI Agent 设计,在这里它们可以分享内容、参与讨论,并进行投票和点赞活动。人类用户仅限于观察者角色,无法直接互动。这个平台类似于 Reddit 的结构,允许 AI Agent 创建子社区(称为 submolt)、发布帖子、评论,并通过 API 接口进行操作,而不是视觉图形界面。
2026/05/03 14:46:522,056
如何提高大模型在超长上下文的表现?Claude实验表明加一句prompt立即提升效果~

如何提高大模型在超长上下文的表现?Claude实验表明加一句prompt立即提升效果~

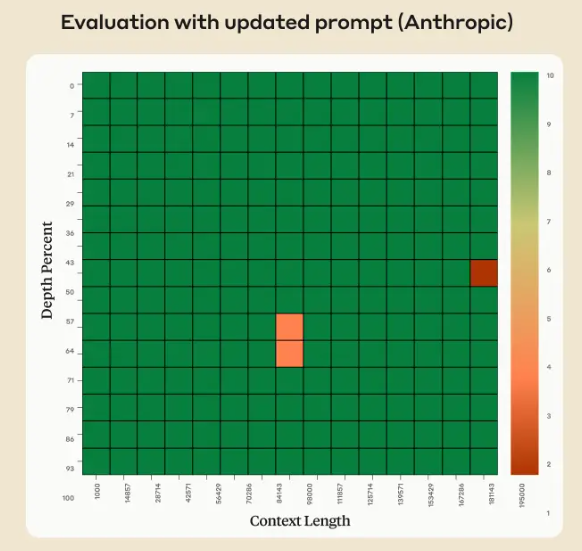
Claude 2.1版本的模型上下文长度最高拓展到200K,也是目前商用领域上下文长度支持最长的模型之一。但是,在模型发布不久之后,有人测试发现模型在超过20K之后效果下降明显。但是Anthropic官方发布了一个说明解释这不是Claude模型本身在超长上下文的真实原因,主要是模型拒绝回答一些与文章主体不符的内容,实际中只需要一句prompt即可提高性能,将模型在超长上下文的水平准确率从27%提高到98%。

2023/12/07 19:14:472,064
阿里通义千问团队首次开源语音合成大模型:Qwen3-TTS:总共5个模型,最小的仅0.6B参数规模,最大1.8B参数

阿里通义千问团队首次开源语音合成大模型:Qwen3-TTS:总共5个模型,最小的仅0.6B参数规模,最大1.8B参数

就在刚刚,阿里开源了全新的语音合成大模型Qwen3-TTS系列!本次开源的语音合成模型共5个版本,最小的仅0.6B参数规模,最大的模型参数也就1.7B,基本上手机端都可以运行。此次发布不仅在性能上宣称超越了许多商业级闭源模型(如 OpenAI 的 GPT-4o-Audio 和 ElevenLabs),更重要的这应该是阿里通义千问团队首次开源语音合成系列大模型。

2026/05/03 14:49:362,070
吴恩达宣布和OpenAI、LangChain、Lamini三家公司一起推出三门全新AI短视频课程:ChatGPT API、LangChain和Diffusion Models

吴恩达宣布和OpenAI、LangChain、Lamini三家公司一起推出三门全新AI短视频课程:ChatGPT API、LangChain和Diffusion Models

今天,吴恩达在推特上宣布和OpenAI、LangChain以及Lamini三家公司共同推出了3门短视频课程,分别是《使用ChatGPT API构建系统》、《基于LangChain的大语言模型应用与开发》和《Diffusion模型是如何工作的》。三门课程都是1个小时的短视频课程,而且配有详细的Jupyter Notebook使用方法。

2023/06/01 23:27:322,089
可能比runway更好!StabilityAI最新开源文本生成视频大模型:Stable Video Diffusion,可以生成最多20帧的视频,但不可商用

可能比runway更好!StabilityAI最新开源文本生成视频大模型:Stable Video Diffusion,可以生成最多20帧的视频,但不可商用

在深度学习和计算机视觉的发展历程中,视频生成技术一直是一个极具挑战和创新的领域。而发布了一系列开源领域最强图像生成模型Stable Diffusion系列模型背后的企业StabilityAI最近又开源了一个的文本生成视频大模型Stable Video Diffusion模型,这个模型可以生成最多20帧的视频。测试效果,这个模型普通版本与runway差不多,20帧版本则超过了runway!

2023/11/25 08:23:522,090
知名开源框架MetaGPT升级为Atoms:专注解决大模型时代的Vibe Coding产品如何落地,五分钟想好Idea,五分钟生成App,五分钟接入支付,五分钟部署产品

知名开源框架MetaGPT升级为Atoms:专注解决大模型时代的Vibe Coding产品如何落地,五分钟想好Idea,五分钟生成App,五分钟接入支付,五分钟部署产品

2026 年 1 月初,原名 MetaGPT 的 AI 开发框架完成了一次重大升级,将其核心产品 MGX 正式更名为 Atoms。这一消息由 DeepWisdom 团队在 X(原 Twitter)等平台发布,标志着该项目从单纯的“AI 编程助手”正式转向“AI 构建真实生意”的全新定位。

2026/05/03 14:51:352,090
全球首个AI软件工程师问世:可以自己训练微调大模型的AI软件工程师Devin简介

全球首个AI软件工程师问世:可以自己训练微调大模型的AI软件工程师Devin简介

大多数编程领域的大模型应用都是单行代码补全或者单个函数生成的方式。完整的程序生成依然面临较大的挑战。而现在,一个初创企业直接发布了一个AI软件工程师,可以直接作为一个程序员来接受用户需求和反馈,独立完成编码和应用上线功能。这就是Cognition发布的全球首个AI软件工程师Devin。

2024/03/13 00:15:182,093
Anthropic发布新一代Claude 3.5模型:全新的Haiku 3.5和升级版Sonnet 3.5

Anthropic发布新一代Claude 3.5模型:全新的Haiku 3.5和升级版Sonnet 3.5

2024年10月22日,Anthropic发布了两个新模型:升级版的Claude 3.5 Sonnet和全新的Claude 3.5 Haiku。升级版的Claude 3.5 Sonnet在保持原有价格和速度的基础上,实现了全面性能提升,尤其在编码领域取得了显著进步。新推出的Claude 3.5 Haiku则以与Claude 3 Haiku相同的成本和类似的速度,在多个评测中达到了与Claude 3 Opus相当的性能水平。

2024/10/27 21:21:212,119
OpenAI是一家什么样的企业——OpenAI介绍与成果总结

OpenAI是一家什么样的企业——OpenAI介绍与成果总结

OpenAI是全球最著名的人工智能研究机构,发布了许多著名的人工智能技术和成果,如大语言模型GPT系列、文本生成图片预训练模型DALL·E系列、语音识别模型Whisper系列等。由于这些模型在各自领域都有相当惊艳的表现,引起了全世界广泛的关注。

2022/12/09 23:13:302,151
为什么Qwen3系列模型中没有720亿参数规模的Qwen3-72B?Qwen3-72B还会发布吗?NO!

为什么Qwen3系列模型中没有720亿参数规模的Qwen3-72B?Qwen3-72B还会发布吗?NO!

Qwen3 是阿里于 2025 年 6 月开源的新一代大模型系列,共发布了 8 个不同参数规模的模型,覆盖从 6 亿到 2350 亿参数的范围,融合了稠密模型和 MoE 架构。值得注意的是,此次未包含此前广受关注的 Qwen-72B 稠密模型版本,阿里表示从 Qwen3 起,超过 30B 参数的模型将统一采用 MoE 架构以优化性能和效率。

2025/06/18 16:23:242,156
一个非常有趣的数据工程师小游戏

一个非常有趣的数据工程师小游戏

Firebolt开发了一个数据工程师的网页小游戏,带你体验数据分析的全流程。游戏里你扮演一个数据工程师,从数据收集开始,经历数据pipeline、数据入数据湖以及数据分析等,最终形成各种图表的结果。

2022/03/29 10:02:562,164
推荐一个给新手的可视化的机器学习模型训练网站

推荐一个给新手的可视化的机器学习模型训练网站

使用AI技术预测未来、对数据进行分类可以解决很多个人或者小企业的问题。然而,对于新手和非行业的小企业来说,学习或者雇佣一个专业人才解决这些问题似乎有些得不偿失。这里给大家推荐一个给新手的可视化的机器学习模型训练网站,可以让大家都能享受到AI技术带来的红利。

2022/04/21 21:46:222,193
SWE-bench Verified:提升 AI 模型在软件工程任务评估中的可靠性

SWE-bench Verified:提升 AI 模型在软件工程任务评估中的可靠性

在人工智能领域,随着大型语言模型(LLMs)在各类任务中的表现不断提升,评估这些模型的实际能力变得尤为重要。尤其是在软件工程领域,AI 模型是否能够准确地解决真实的编程问题,是衡量其真正应用潜力的关键。而在这方面,OpenAI 推出的 *SWE-bench Verified* 基准测试,旨在提供一个更加可靠和精确的评估工具,帮助开发者和研究者全面了解 AI 模型在处理软件工程任务时的能力。

2025/08/11 16:54:152,197
缺少有标注的数据集吗?福音来了——HuggingFace发布few-shot神器SetFit

缺少有标注的数据集吗?福音来了——HuggingFace发布few-shot神器SetFit

少量标记的学习(Few-shot learning)是一种在较少标注数据集中进行模型训练的一种学习方法。为了解决大量标注数据难以获取的情况,利用预训练模型,在少量标记的数据中进行微调是一种新的帮助我们进行模型训练的方法。而就在昨天,Hugging Face发布了一个新的语句transformers(Sentence Transformers)框架,可以针对少量标记数据进行模型微调以获取很好的效果。