
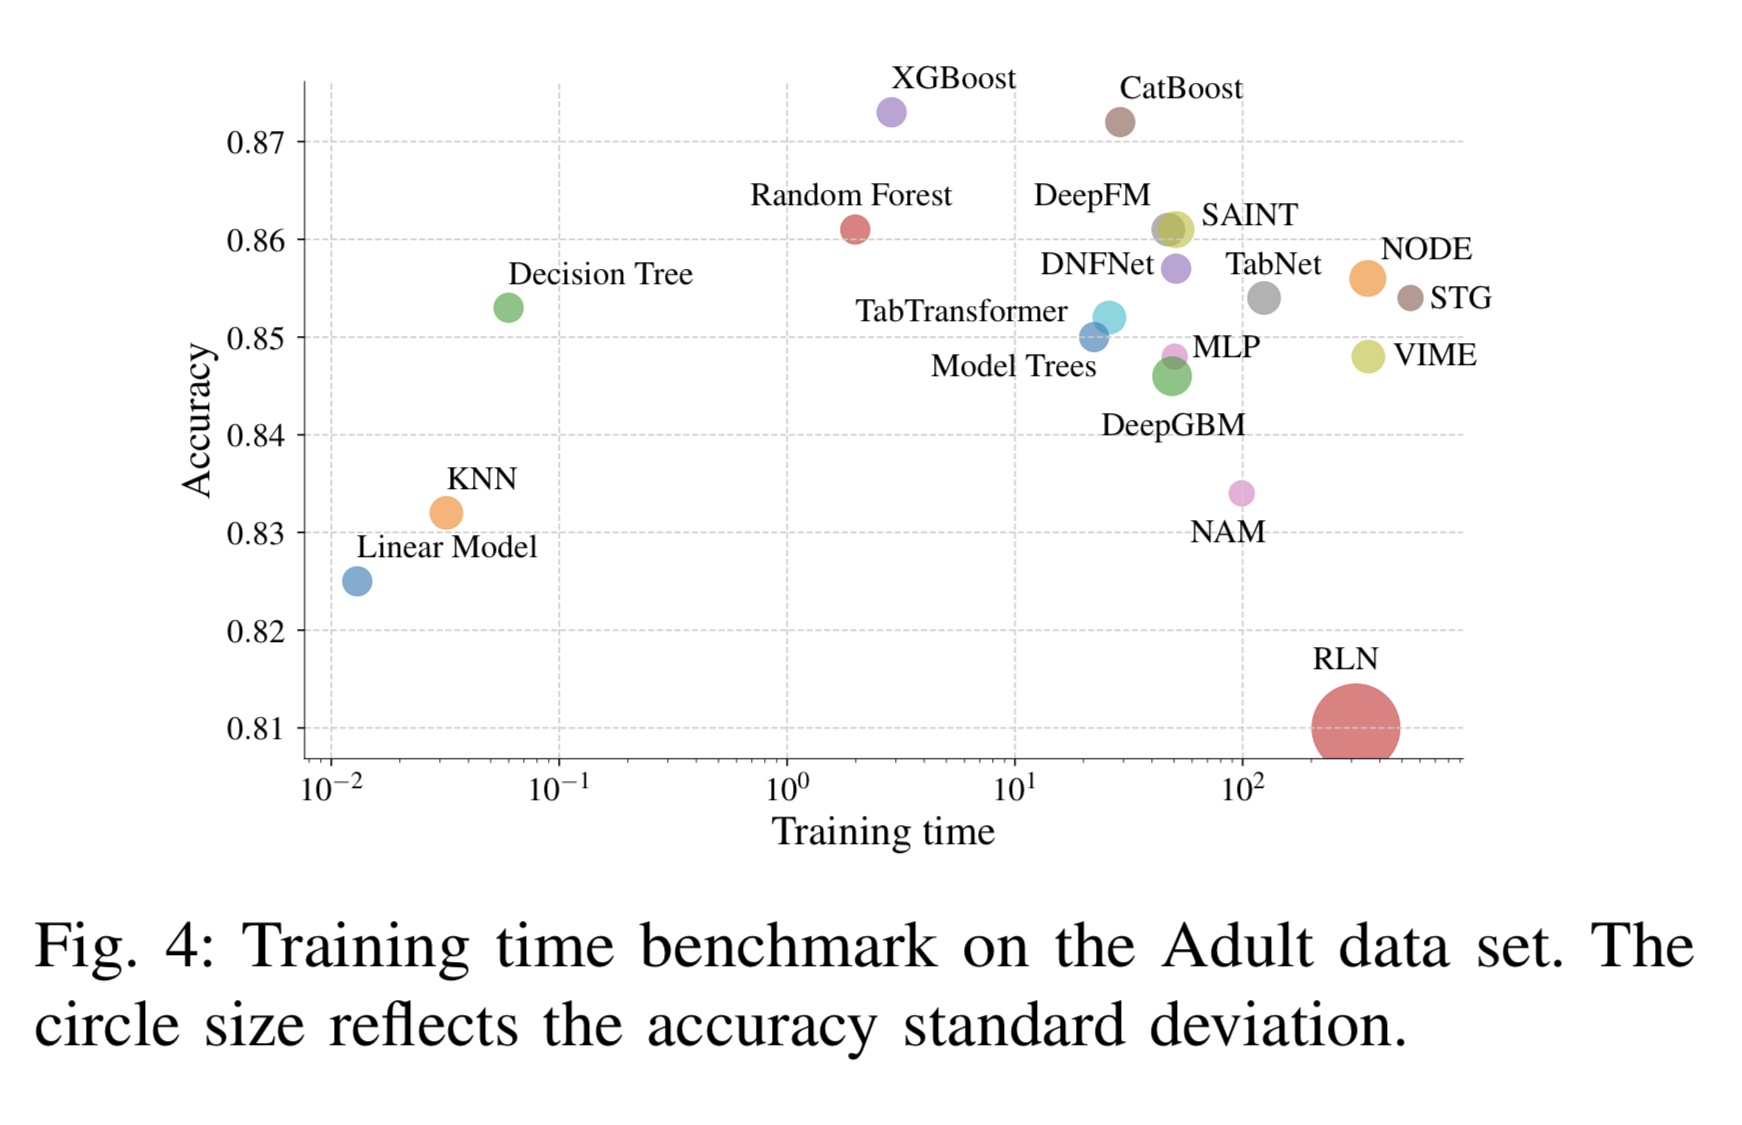
Deep Neural Networks and Tabular Data: A Survey——XGBoost依然是最优秀的算法模型
异质表格数据是最常用的数据形式,对于众多关键和计算要求高的应用来说是必不可少的。在同质数据集上,深度神经网络已多次显示出优异的性能,因此被广泛采用。然而,它们在表格数据建模(推理或生成)方面的应用仍然具有高度挑战性。
探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。
异质表格数据是最常用的数据形式,对于众多关键和计算要求高的应用来说是必不可少的。在同质数据集上,深度神经网络已多次显示出优异的性能,因此被广泛采用。然而,它们在表格数据建模(推理或生成)方面的应用仍然具有高度挑战性。
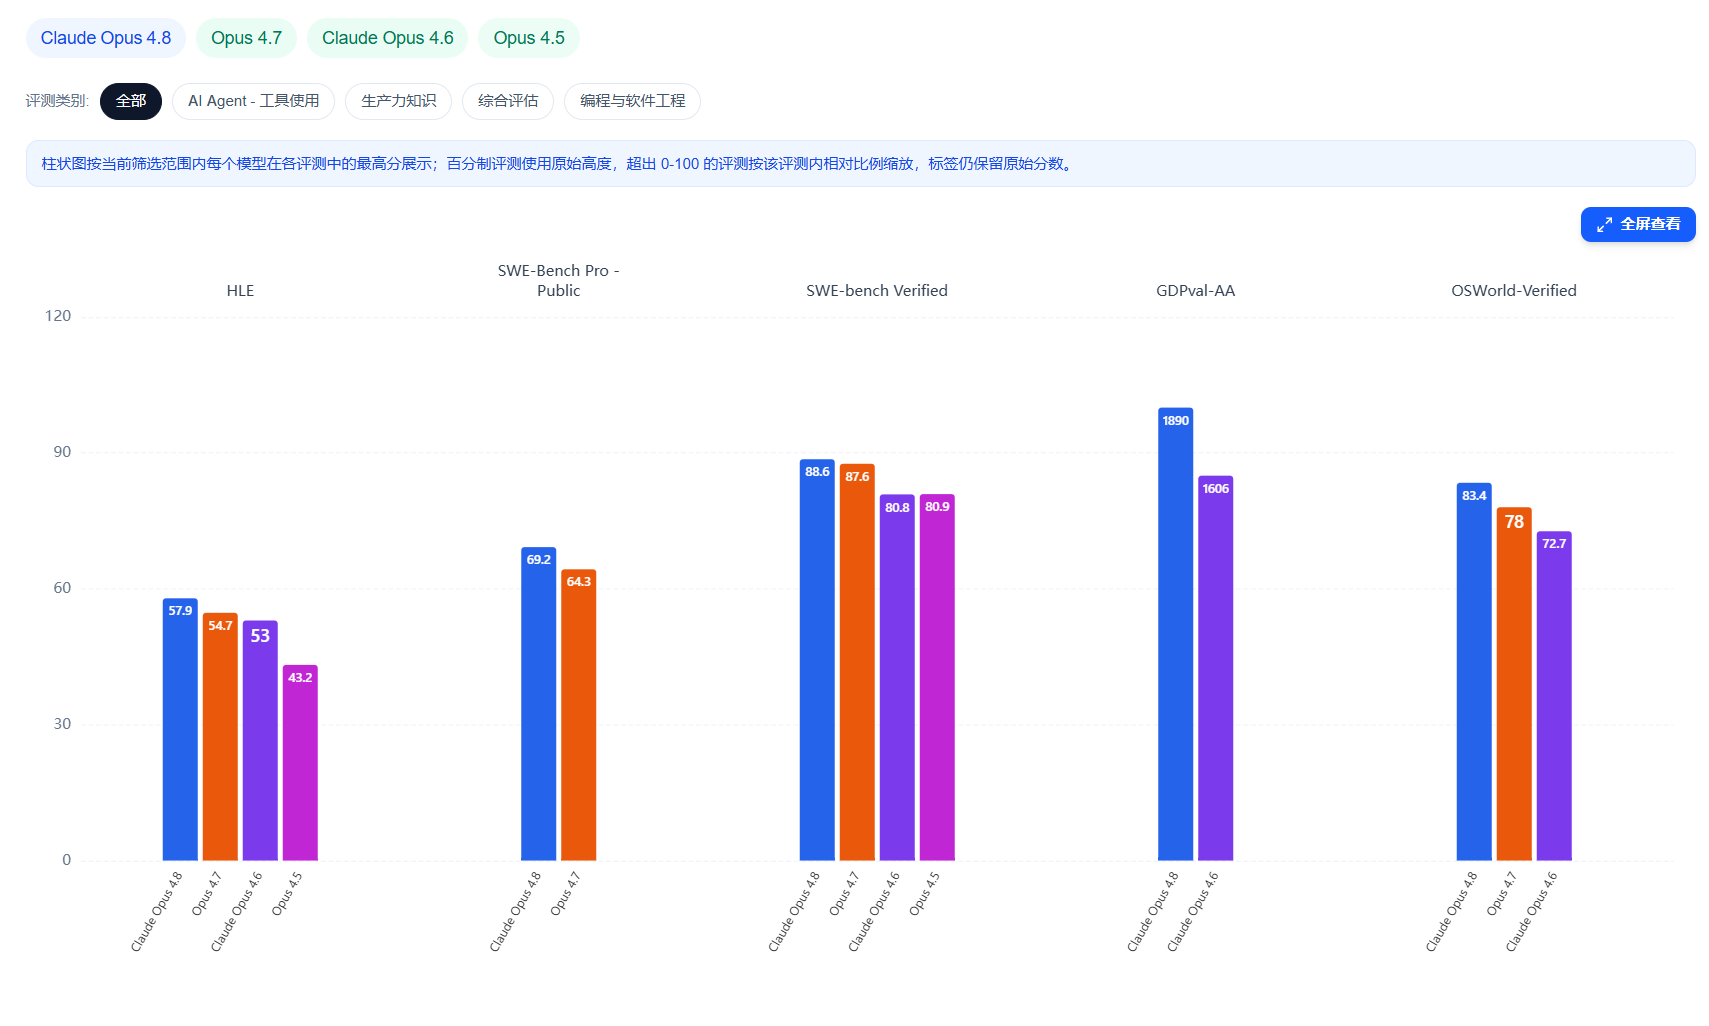
2026年5月28日,Anthropic发布了旗舰模型的新版本Claude Opus 4.8。这是一次幅度不大但方向明确的迭代:模型在编程、智能体(agentic)任务、推理和知识工作类基准上全面小幅领先于前代Opus 4.7,定价保持不变,同时把”诚实性”作为本次最被强调的改进点。Anthropic官方在公告中也未回避,直接将其定性为”对前代一次温和但切实的改进(a modest but tangible improvement)”。
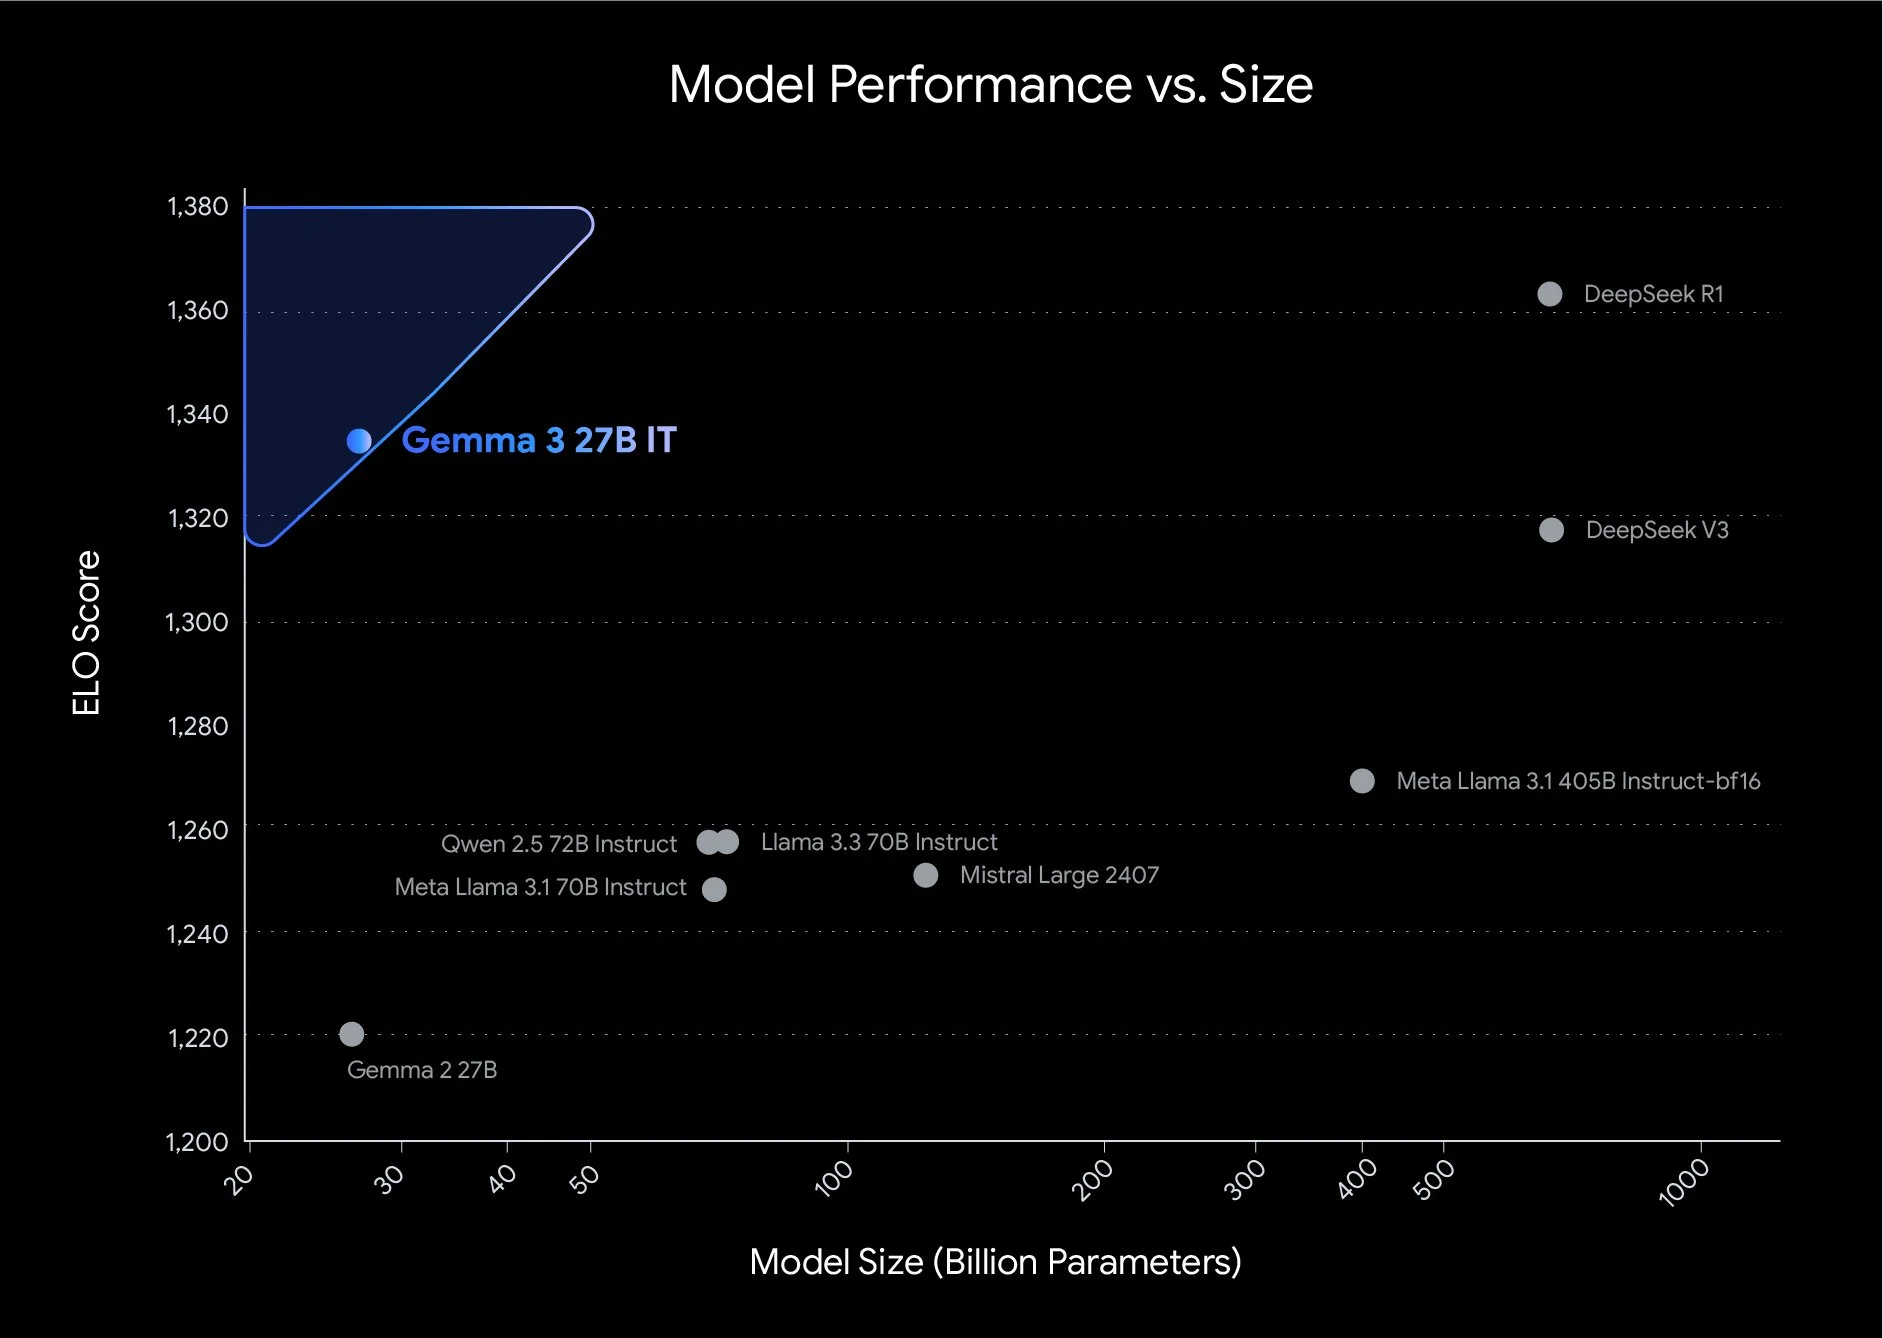
Gemma系列大模型是Google开源的一系列轻量级的大模型。就在刚才(2025年3月12日),Google开源了第三代Gemma系列大模型,共包含4个不同参数规模版本,第三代的Gemma 3系列是多模态大模型,即使是最小的10亿参数规模的Gemma 3-1B也支持多模态输入。
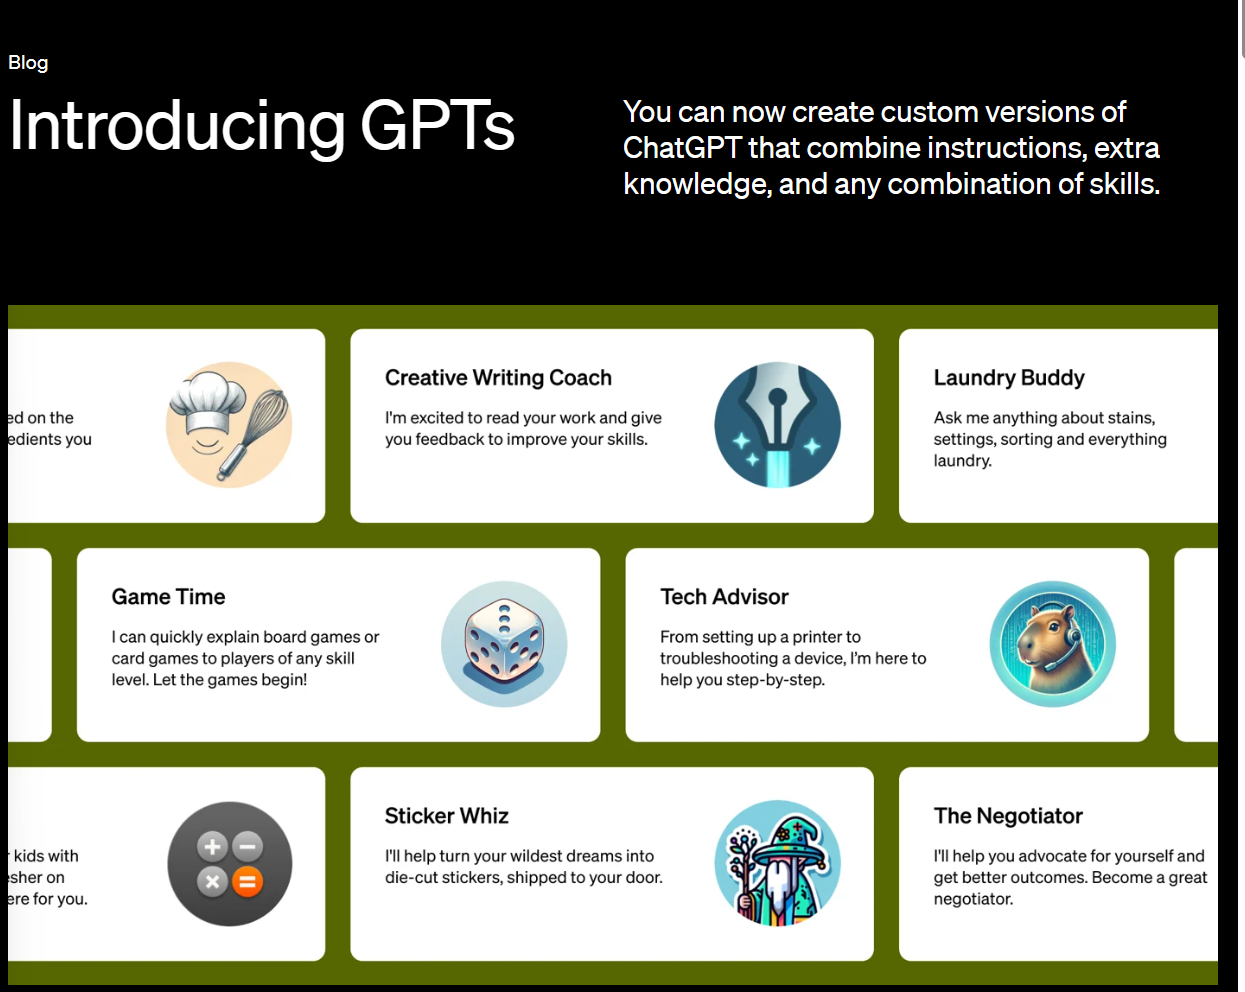
OpenAI发布的产品中,有2个产品可以用来将GPT当作一个类似AI Agent工具使用,同时支持接入自定义的接口和数据。那就是GPTs和Assistant API,前者可以在界面直接操作,后者则是一个API,两者功能接近,为了让大家更加清晰理解二者区别,OpenAI官方最近发布了二者的解释。
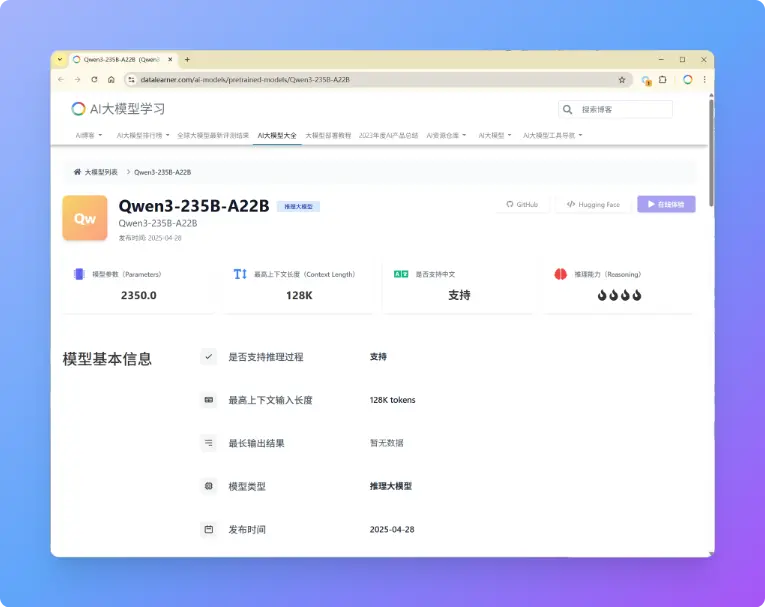
阿里巴巴刚刚开源了第三代千问大模型,Qwen3系列包含了8个不同参数规模的大模型,最大达到2350亿参数规模,最小仅6亿参数规模。本次发布的Qwen3系列是推理大模型和常规的大模型混合版本,即Qwen3可以根据输入问题的情况自动选择是否进行推理。
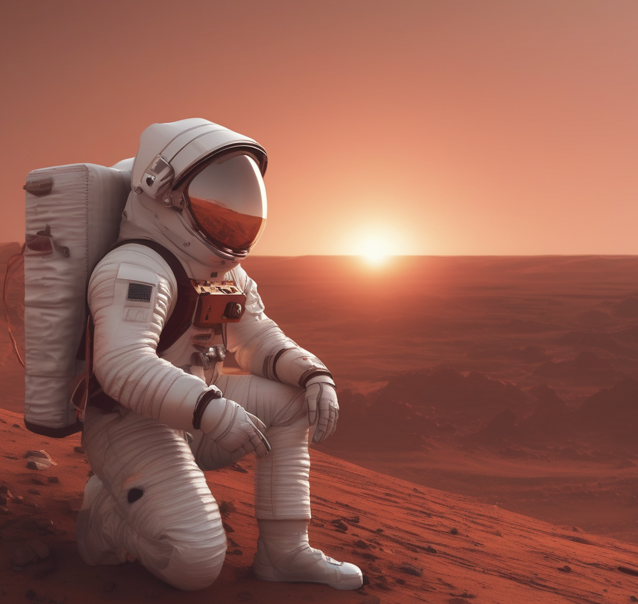
Stable Diffusion XL是StabilityAI最新的开源模型。是目前业界流行的免费开源图像生成大模型。2023年4月份StabilityAI就宣布了SD XL的存在并在2023年7月26日开源。SD XL相比较此前的模型速度更快、提示词更短、生成的图像更加真实。但是,大多数人可能并没有实际运行过,感受过这个模型的魅力。在这篇博客中,我们给大家展示如何利用Google Colab的免费GPU资源,部署一个SD XL模型,并通过prompt生成一些图片。

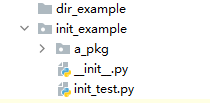
在Python工程中,我们经常可以看到带有“\_\_init\_\_.py”文件的目录,在PyCharm中,带有这个文件的目录被认为是Python的包目录,与目录的图标有不一样的显示。那么这个文件的作用是什么,我们平时如何使用呢,这篇文章将解释这个问题。
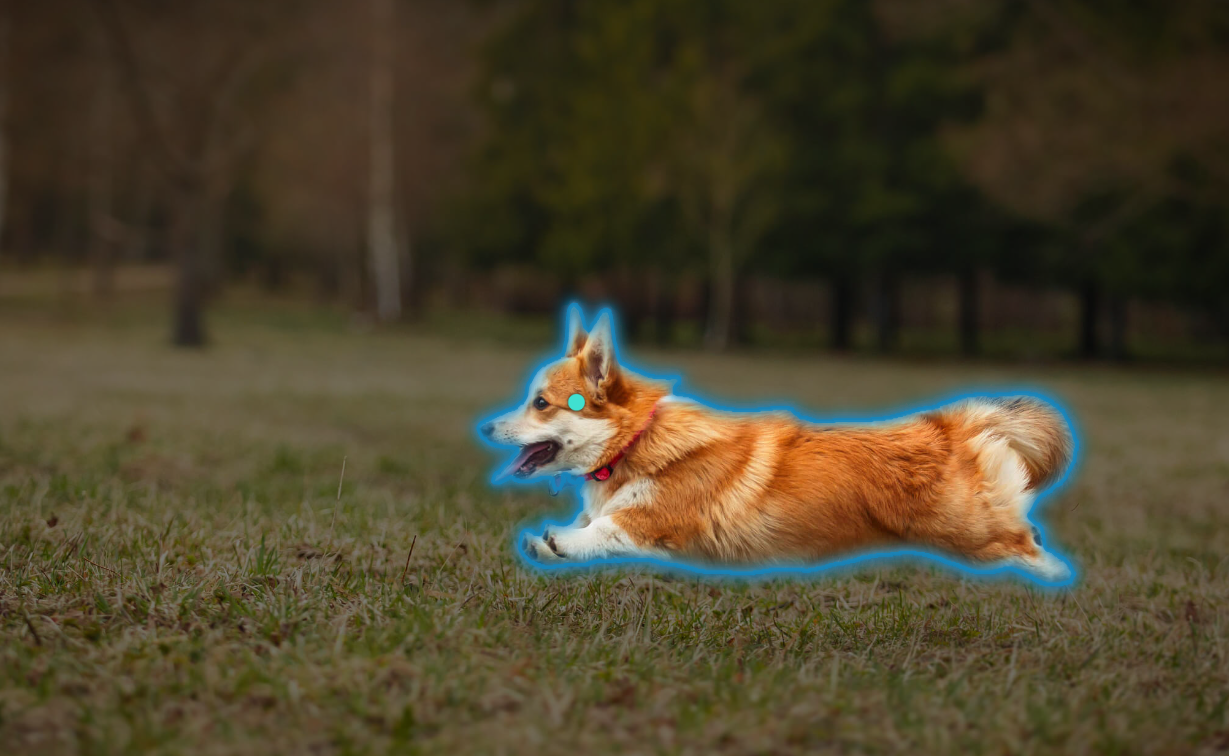
SAM全称是Segment Anything Model,由MetaAI最新发布的一个图像分割领域的预训练模型。该模型十分强大,并且有类似GPT那种基于Prompt的工作能力,在图像分割任务上展示了强大的能力!此外,该模型从数据集到训练代码和预训练结果完全开源!真Open的AI!
就在刚才,OpenAI官方宣布即将推出GPT-4o mini模型,这是一个成本很低的AI大模型,是GPT-3.5的替代版本。OpenAI官方说,该模型最大的特点是很便宜,但是能力更强,因此可以极大提高AI在不同领域的应用。
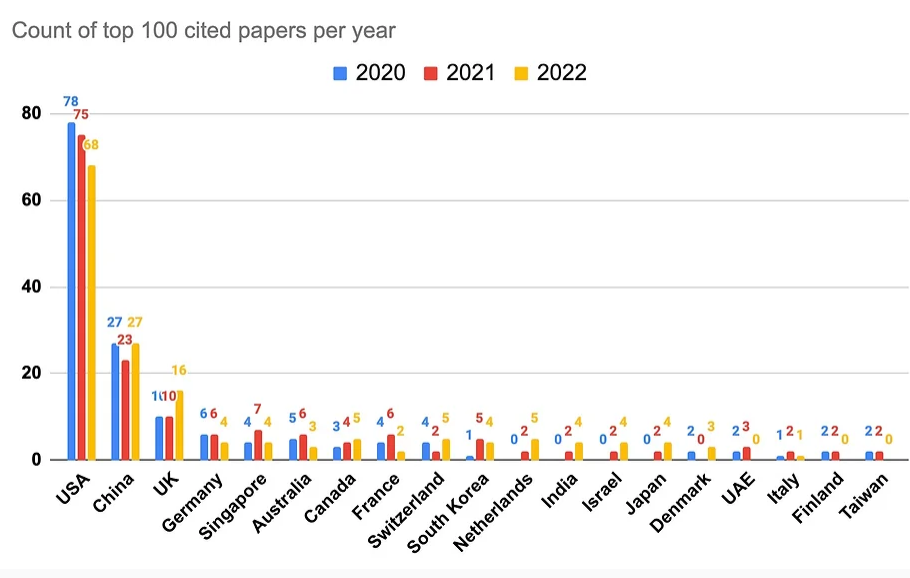
尽管AI领域在工业界发展迅速,企业研究机构在拼命的开发相关的产品以推动各自业务的发展。但是他们也在科研领域不断贡献大量的AI论文。Zeta Alpha的一篇博客分析了2022年发表的被引用最多的100篇AI论文,给大家提供一个洞察思路。
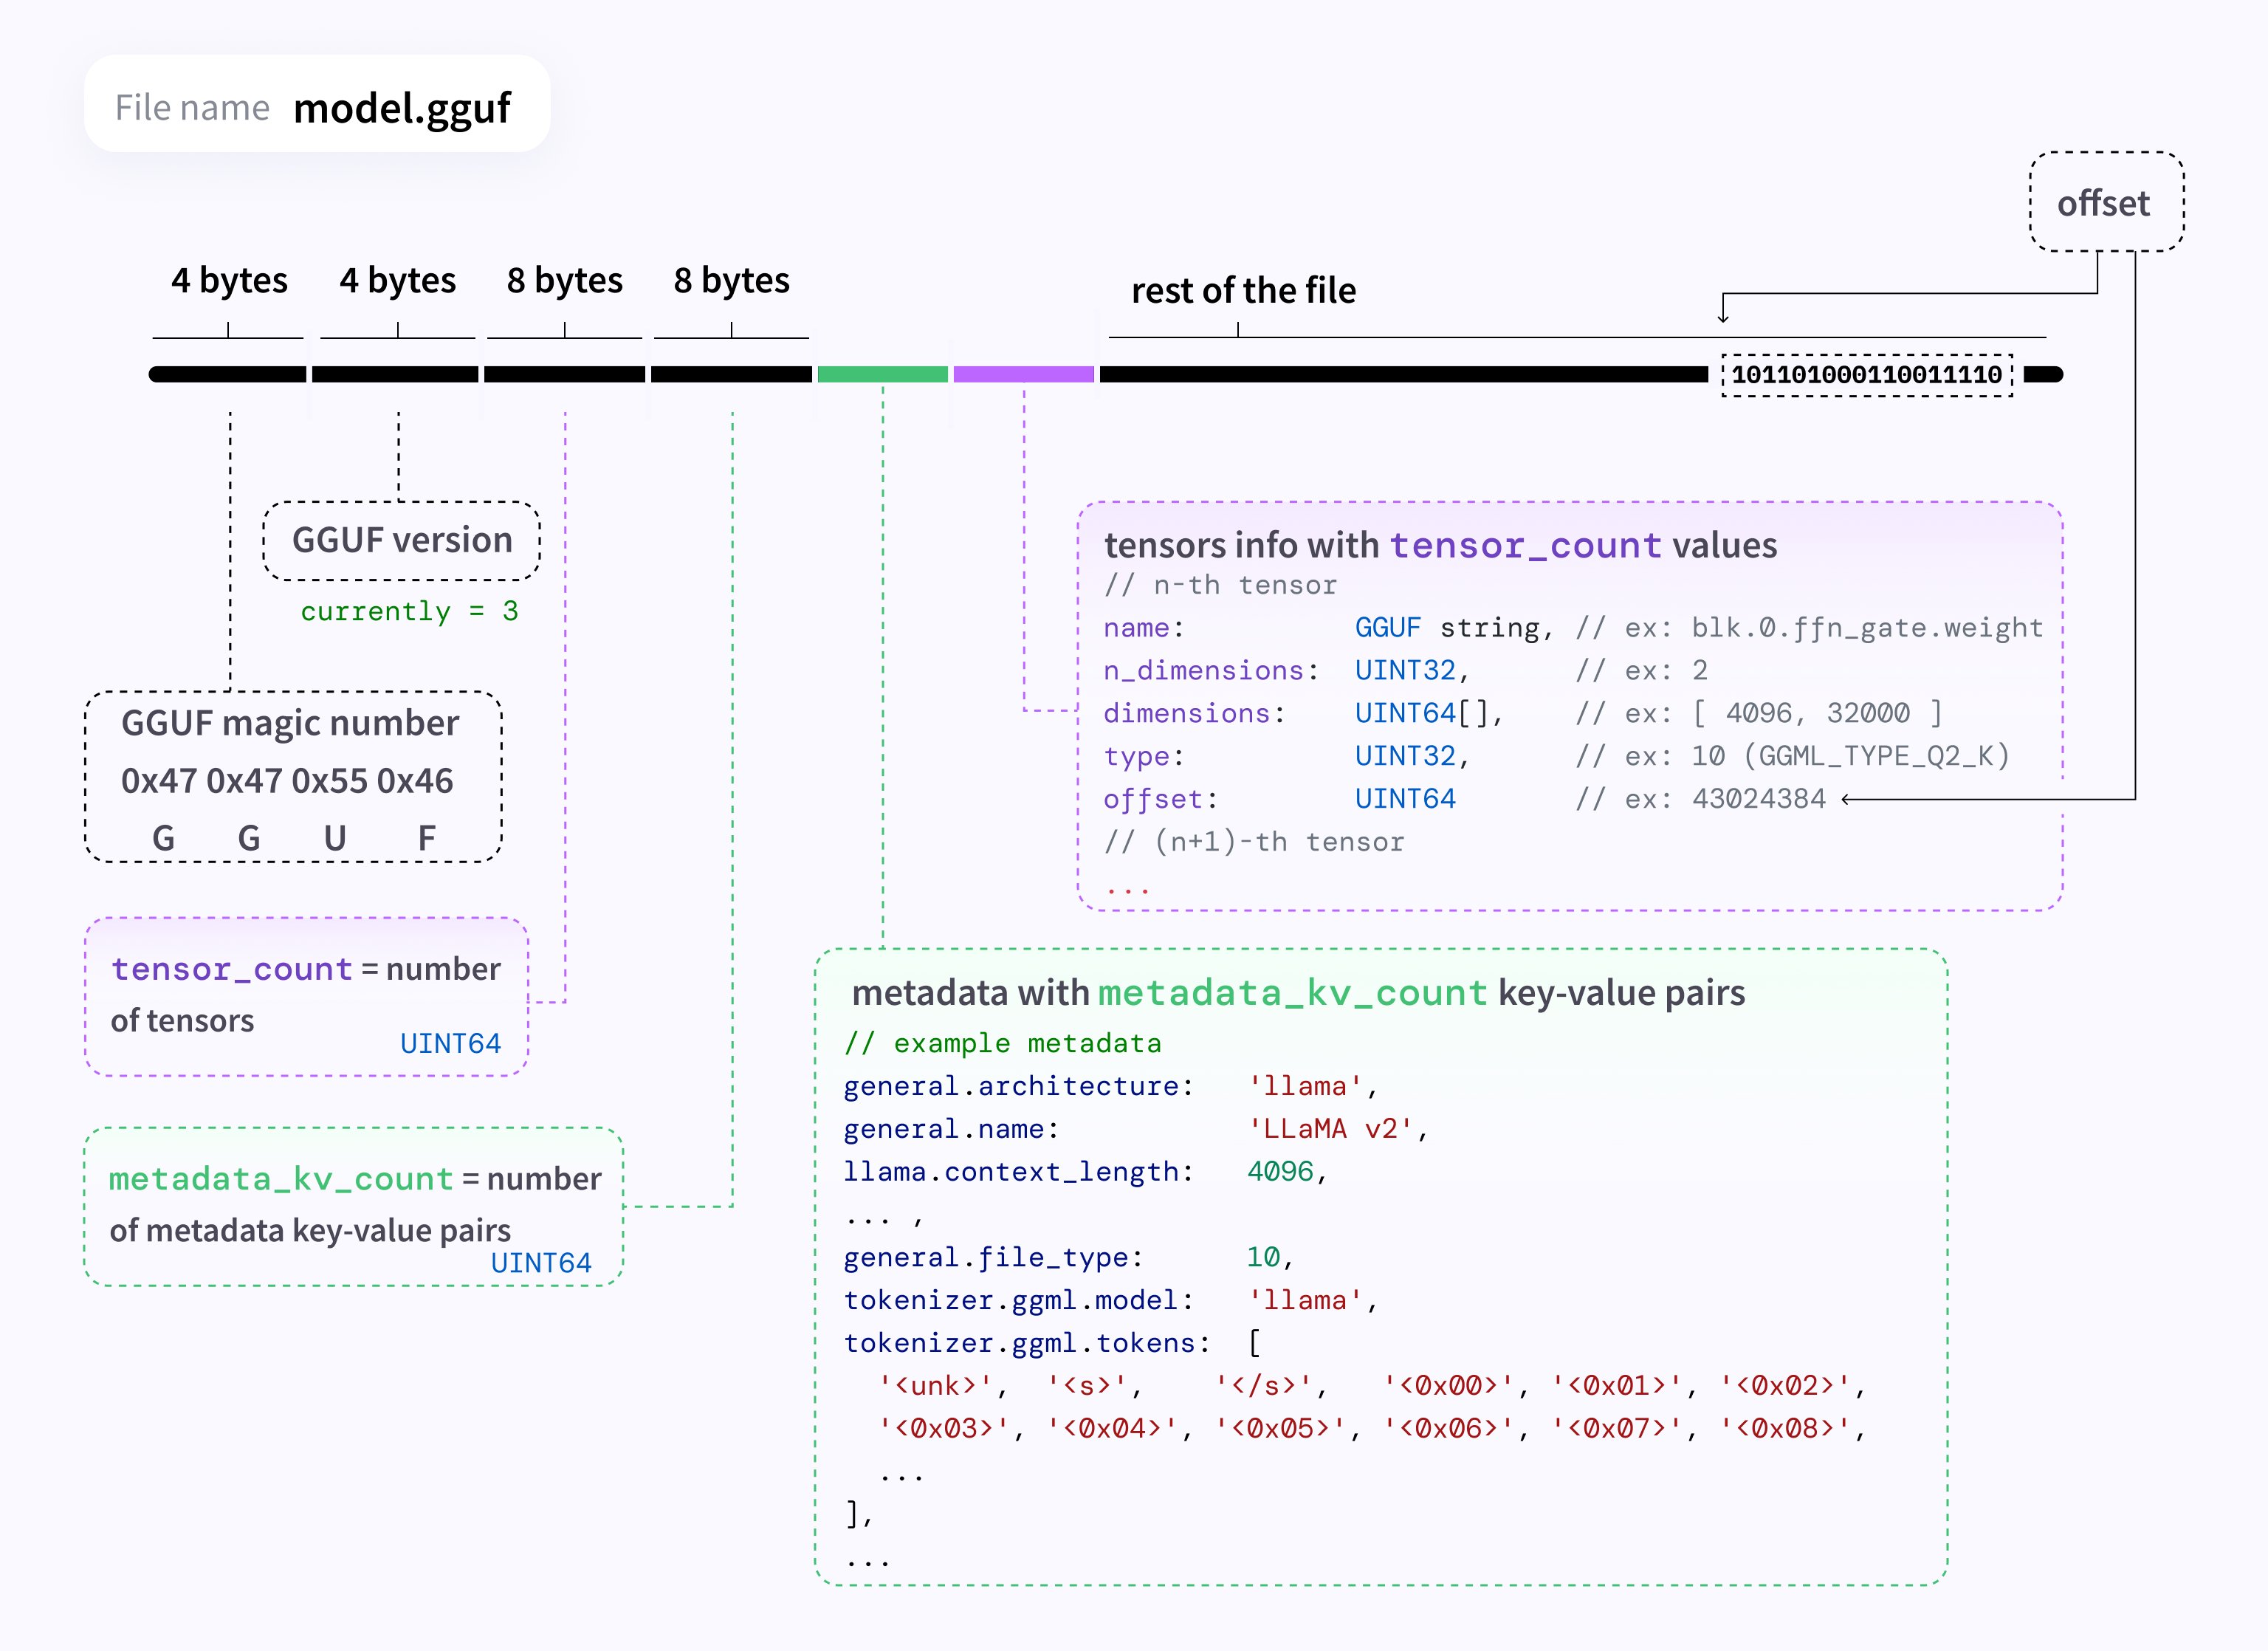
当前的大模型的参数规模较大,数以千亿的参数导致了它们的预训练结果文件都在几十GB甚至是几百GB,这不仅导致其使用成本很高,在不同平台进行交换也非常困难。因此,大模型预训练结果文件的保存格式对于模型的使用和生态的发展来说极其重要。昨天HuggingFace官方宣布将推动GGUF格式的大模型文件在HuggingFace上的使用。
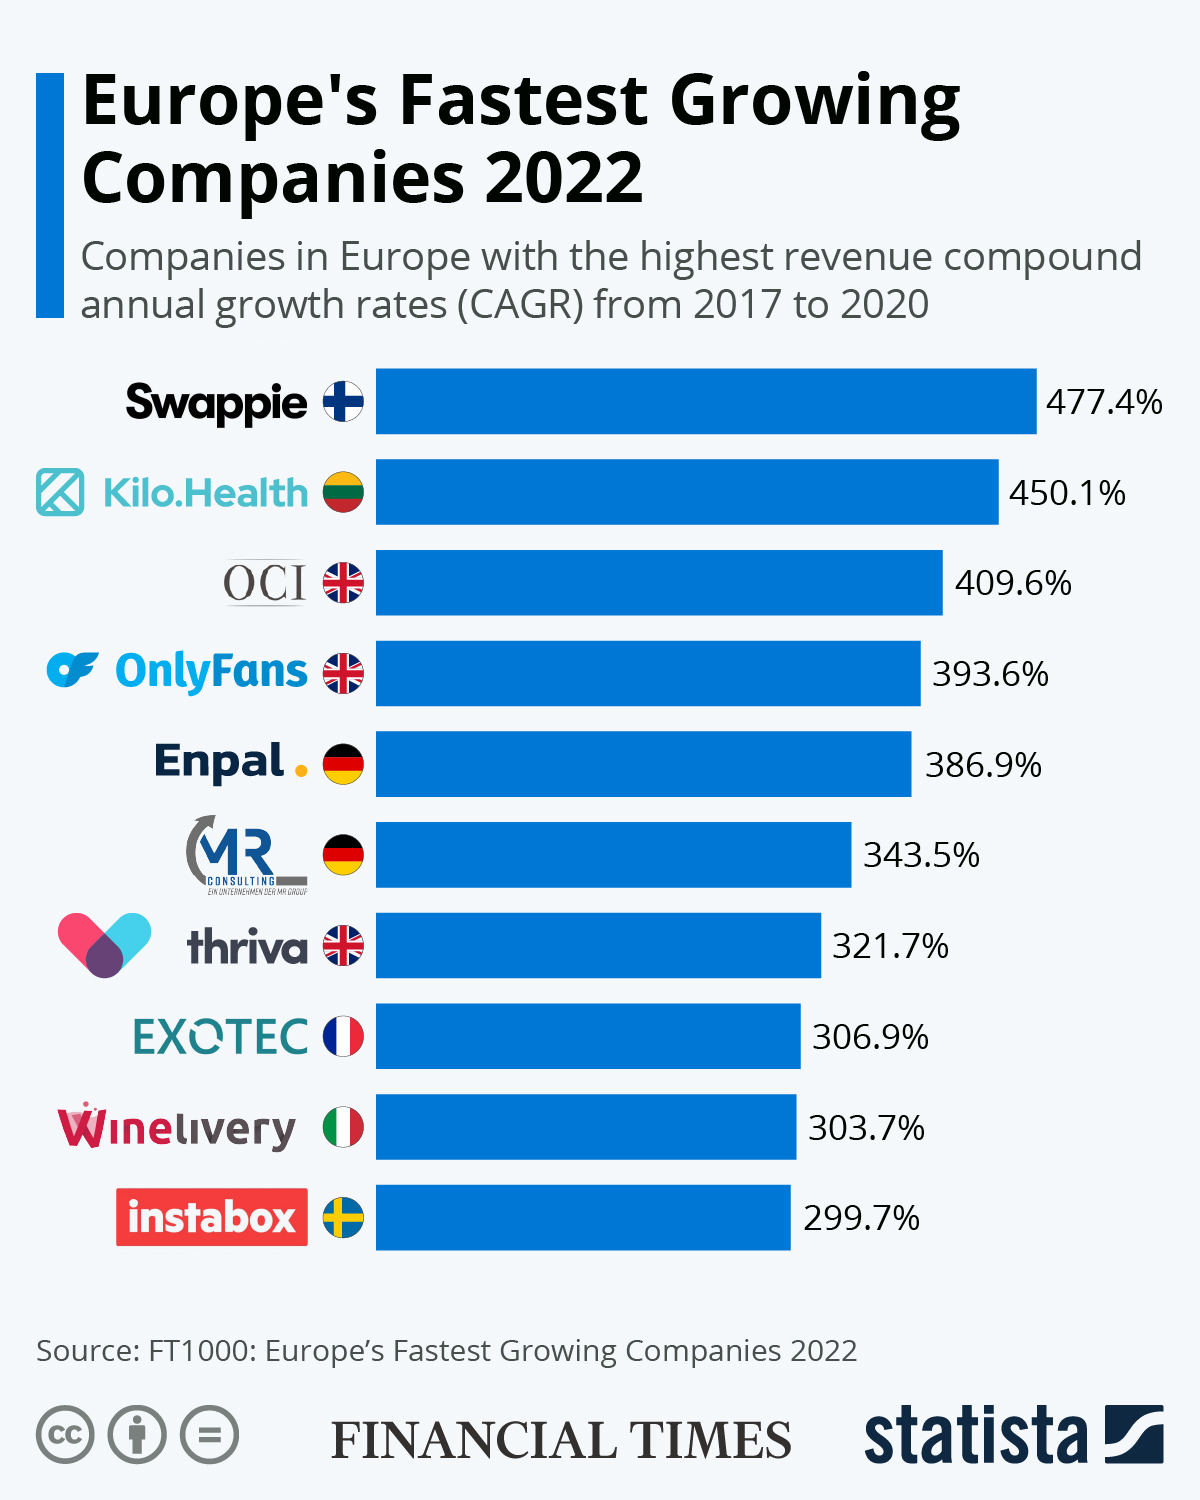
FT1000是金融时报评选的欧洲增长速度最快的前1000个公司,这个名单可以看出来过去几年欧洲哪些企业增长较快,它们在哪些行业经营等。2022年的榜单也刚刚发布,让我们一睹为快。
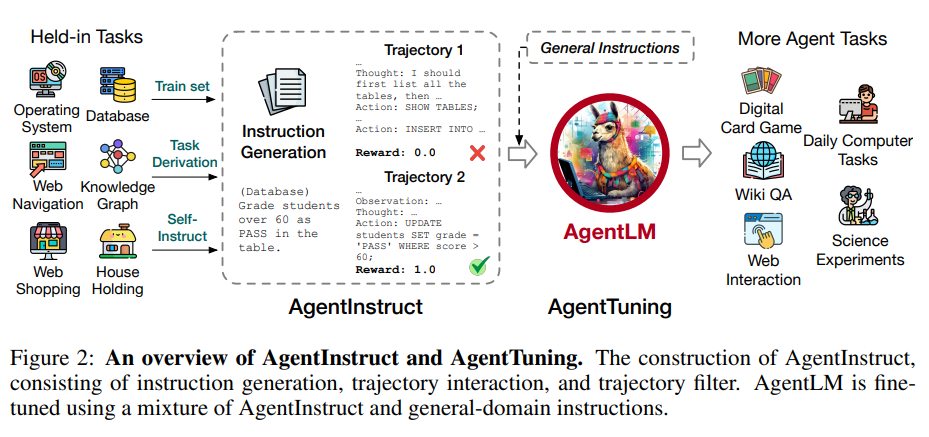
尽管开源的大语言模型发展非常迅速,但是,在以大语言模型作为核心的新一代AI Agent解决方案上,开源大语言模型比商业模型表现要明显地差。为了提高大语言模型作为AI Agent的表现和能力,清华大学和智谱AI推出了一种新的方案,AgentTuning,可以将有效增强开源大语言模型作为AI Agent的能力。
今天,MetaAI发布了一个新的语音处理领域的生成式大模型Voicebox,可以像GPT那样用生成式的方式处理语音(speech)数据的相关任务,包括语音编辑、跨风格语音生成等语音数据处理相关的很多任务。这可能就是语音处理领域的GPT时刻!
GPU Utils最近总结了一个关于英伟达H100显卡在AI训练中的应用文章。里面透露总结了一些当前的主流厂商拥有的显卡数量以及一些模型训练所需的显卡数。文章主要描述的是H1000的供应与需求,也包含H100的性能描述,本文主要总结一下里面提到的显卡数相关统计供大家参考。
吴恩达创办的DeepLearning.AI一直在提供各种面向AI领域的精品课程。在上个月,他们发布的四门AI短课程(包含了ChatGPT的使用、ChatGPT Prompt工程技术、面向LLM应用的LangChain教程和Diffusion工作原理)受到了广泛的欢迎。今天,吴恩达宣布与AWS的研究人员一起推出了全新的长课程《Generative AI with Large Language Models》,这门课程的主要内容是讲授生成式AI的工作原理以及如何部署面向真实世界应用的生成式AI模型。
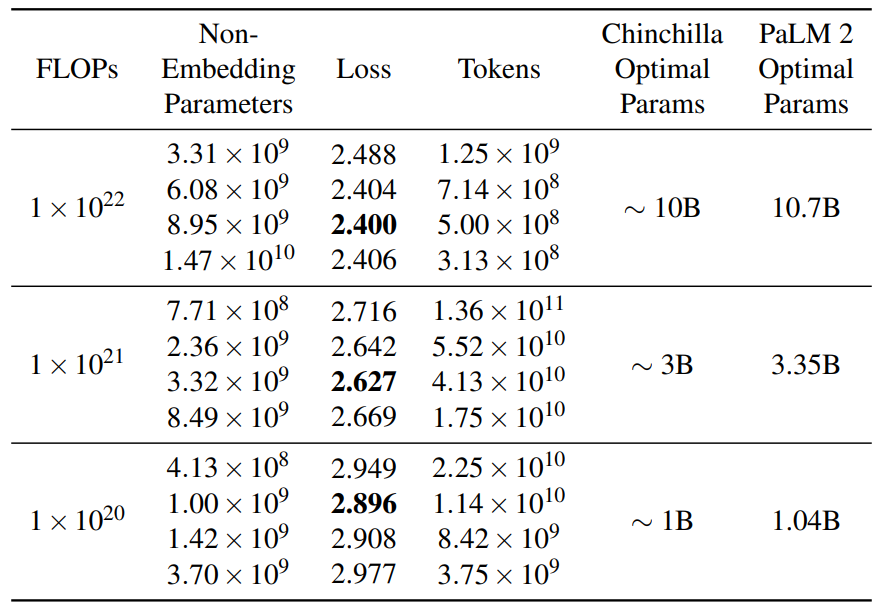
作为PaLM的继任者,PaLM2的发布被谷歌寄予厚望。与OpenAI类似,谷歌官方没有透露很多关于模型的技术细节,虽然发布了一个92页的技术报告,但是,正文内容仅仅27页,引用和作者14页,剩余51页都是展示大量的测试结果。而前面的27页内容中也没有过多的细节描述。尽管如此,这里面依然有几个十分重要的结论供大家参考。
MLPerf™是MLCommons发布的一个用来测试AI相关软硬件性能的基准测试工具。2021年12月1日, Training v1.1的结果发布,这个结果不仅展示了最新的AI相关软硬件的进展,也有一个新的现象,就是AI训练正在超越摩尔定律。本文将简要解读一下相关数据。