DataLearner 标志
标签

「A」相关文章(第6页)

汇总「A」相关的原创 AI 技术文章与大模型实践笔记,持续更新。

标签:#A
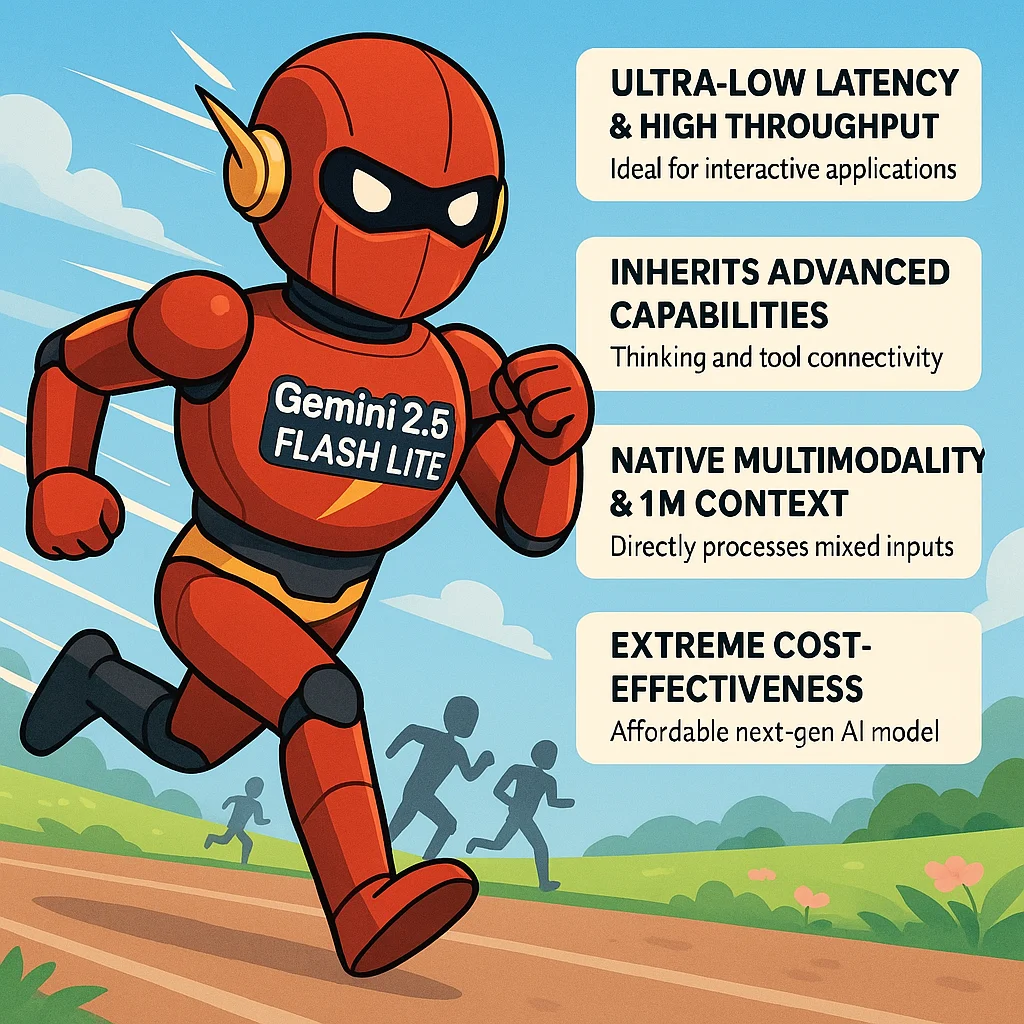
Google发布全新Gemini 2.5 Flash Lite:极致速度与性价比的轻量级新选择,实测生成速度最高可超过400 tokens/每秒,能力喜人!堪称甜品级大模型!

Google发布全新Gemini 2.5 Flash Lite:极致速度与性价比的轻量级新选择,实测生成速度最高可超过400 tokens/每秒,能力喜人!堪称甜品级大模型!

今天,Google发布Gemini 2.5 Flash Lite。这是一款专为追求极致速度、超低延迟和高性价比场景打造的轻量级模型。它的发布标志着 Google 正在将旗舰模型的先进能力(如百万级上下文、原生多模态、工具调用等)逐步下放到更轻量、更经济的模型层级。根据 DataLearnerAI 的实测,这款模型的生成速度最高可达 400 tokens/秒,即使在输入达到 18K tokens 的情况下,也依然可以维持在 160+ tokens/秒 的性能表现,令人惊喜。
2025/06/18 11:51:321,126
MiniMaxAI开源全球推理长度最长的推理大模型MiniMax-M1:100万tokens输入,最高支持80K的推理长度

MiniMaxAI开源全球推理长度最长的推理大模型MiniMax-M1:100万tokens输入,最高支持80K的推理长度

MiniMaxAI于2025年6月17日正式发布了其新一代大模型——MiniMax-M1。MiniMax-M1的核心亮点在于结合了混合专家(MoE)架构和创新的闪电注意力(Lightning Attention)机制。MiniMax-M1不仅原生支持高达100万Token的上下文长度,推理的tokens也支持最高80K,是当前支持的最多推理长度的大模型。此外,MiniMax-M1在计算效率上也很高,例如在生成10万Token时,其FLOPs消耗仅为DeepSeek R1的25%!

2025/06/17 23:49:561,216
法国人工智能初创企业MistralAI发布首个推理模型Magistral:纯RL训练,多语言能力出色,推理速度很快,Magistral Small (24B)版本免费开源,但面对Qwen3和DeepSeek稍显乏力

法国人工智能初创企业MistralAI发布首个推理模型Magistral:纯RL训练,多语言能力出色,推理速度很快,Magistral Small (24B)版本免费开源,但面对Qwen3和DeepSeek稍显乏力

Mistral AI今天发布了其首个专注于推理能力的系列模型——**Magistral**。这次发布包含两个核心模型:旗舰模型`Magistral Medium`和<font color=red>已开源的</font>`Magistral Small (24B)`。最引人注目的亮点是,Mistral展示了其自研的强化学习(RL)pipeline能够从头开始,仅通过RL训练就将基础模型的推理能力提升到业界顶尖水平,而无需依赖任何其他预先存在的推理模型进行数据蒸馏。这套技术栈非常强大!

2025/06/11 22:45:43817
OpenAI发布最强大模型OpenAI o3-pro:业界评价该模型解决复杂问题效果很好,但是回复一句“Hi”也需要三分钟

OpenAI发布最强大模型OpenAI o3-pro:业界评价该模型解决复杂问题效果很好,但是回复一句“Hi”也需要三分钟

OpenAI 正式发布了其最新模型 OpenAI o3-pro,这是其旗舰模型 o3 的专业增强版。o3-pro 专为需要“更长时间思考”的复杂任务而设计,其核心亮点在于极致的可靠性和准确性,尤其在数学、科学和编程等专业领域表现卓越。根据OpenAI引入的全新“4/4可靠性”评测标准,o3-pro 的性能远超前代,OpenAI官方强调o3-pro在处理高难度、高风险任务的能力上实现了质的飞跃。

2025/06/11 08:57:28812
最近很火的基于人工智能(AI)的vibe coding是什么?它和传统软件编码之间有什么区别?

最近很火的基于人工智能(AI)的vibe coding是什么?它和传统软件编码之间有什么区别?

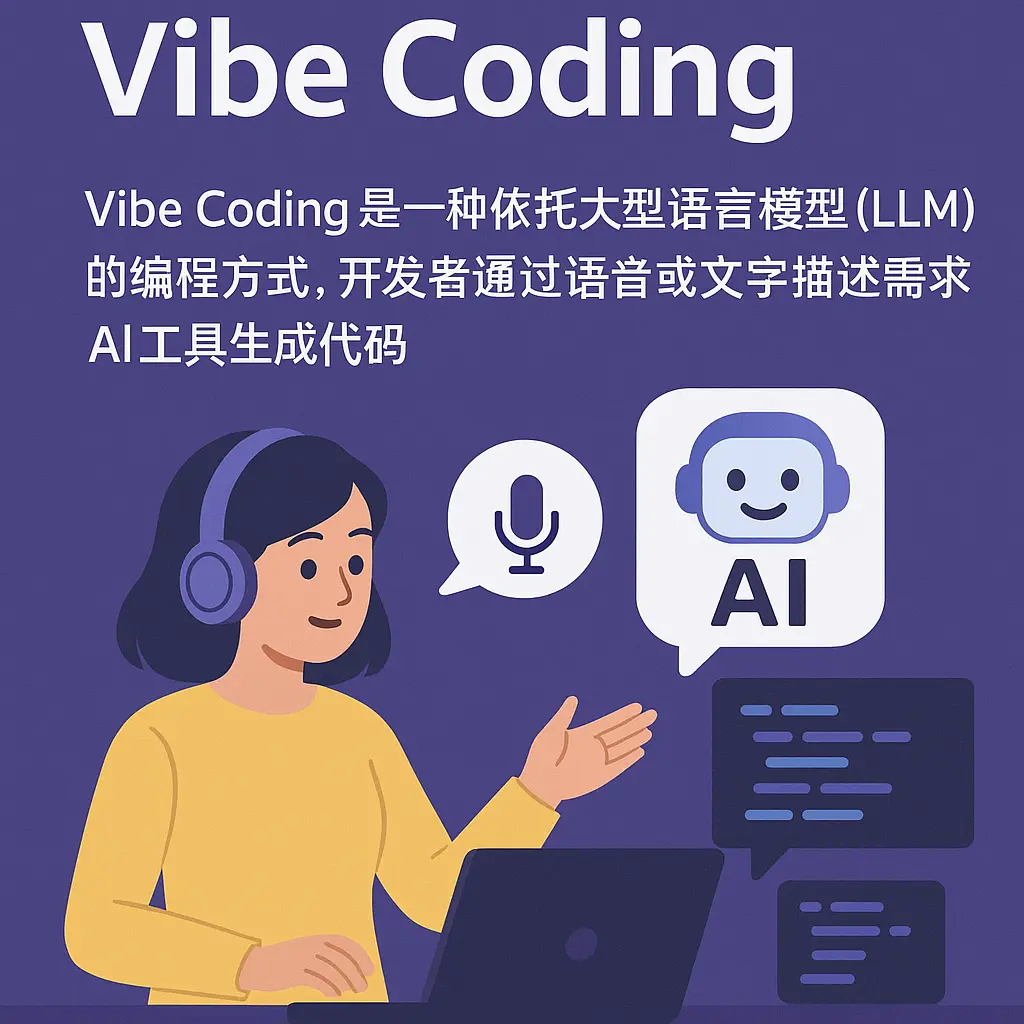
“Vibe Coding”(氛围编程)是一种新兴的编程范式,强调通过自然语言与人工智能(AI)协作开发软件。该概念由前 OpenAI 研究员 Andrej Karpathy 于 2025 年提出,旨在让开发者沉浸于创作氛围中,利用 AI 的能力,将自然语言描述转化为实际源代码,从而简化编程过程。

2025/06/08 20:56:211,506
Anthropic发布Claude4,全球最强编程大模型,大幅提升AI Agent系统所需的各项能力,最长可以7小时连续工作,持续工作、工具使用、记忆使用方面大幅提升

Anthropic发布Claude4,全球最强编程大模型,大幅提升AI Agent系统所需的各项能力,最长可以7小时连续工作,持续工作、工具使用、记忆使用方面大幅提升

2025年5月23日,Anthropic发布了新一代大语言模型Claude 4系列,包括Claude Opus 4和Claude Sonnet 4两个版本。Anthropic的官方博客强调Claude Opus 4是当前全球最强的编程大模型,与传统聚焦于文本生成和知识问答的模型不同,Claude 4明确定位为任务执行引擎和AI Agent系统的核心组件。这次发布不仅仅是性能参数的提升,更代表了Anthropic认为AI模型从"对话助手"向"自主工作伙伴"的根本性转变。

2025/05/25 14:37:311,333
微软开源140亿参数规模的Phi-4推理版本大模型:多项评测结果超过OpenAI o1-mini,单张4090可运行,完全免费开源

微软开源140亿参数规模的Phi-4推理版本大模型:多项评测结果超过OpenAI o1-mini,单张4090可运行,完全免费开源

微软发布了全新的Phi-4推理模型系列,是小型语言模型(SLM)在复杂推理能力上的一种新的尝试。本次发布包含三个不同规模和性能的推理模型,分别是Phi-4-reasoning(140亿参数)、Phi-4-reasoning-plus(增强版140亿参数)和Phi-4-Mini-Reasoning(38亿参数)。这三款模型尽管参数规模远小于当前主流大型语言模型,却在多项推理基准测试中展现出与甚至超越大型模型的能力。

2025/05/01 22:11:001,065
DeepSeekAI开源第二代数学理论证明大模型DeepSeek-Prover-V2:让AI帮助数学家证明数学理论!

DeepSeekAI开源第二代数学理论证明大模型DeepSeek-Prover-V2:让AI帮助数学家证明数学理论!

就在刚才,DeepSeek-AI发布了其新一代自动定理证明模型 **DeepSeek-Prover-V2**。尽管官方暂未公开详细报告,但从其前代模型 **DeepSeek-Prover-V1.5** 的技术细节,以及去年底发布的通用推理模型 DeepSeek-R1 的进展来看,V2 很可能在多个关键能力上取得了实质性提升。

2025/04/30 22:12:22827
重磅!阿里开源第三代千问大模型:Qwen3系列,最小仅6亿参数规模,最大2350亿参数规模大模型!可以根据问题难度自动选择是否带思考过程的大模型,评测超DeepSeek-R1和OpenAI o3

重磅!阿里开源第三代千问大模型:Qwen3系列,最小仅6亿参数规模,最大2350亿参数规模大模型!可以根据问题难度自动选择是否带思考过程的大模型,评测超DeepSeek-R1和OpenAI o3

阿里巴巴刚刚开源了第三代千问大模型,Qwen3系列包含了8个不同参数规模的大模型,最大达到2350亿参数规模,最小仅6亿参数规模。本次发布的Qwen3系列是推理大模型和常规的大模型混合版本,即Qwen3可以根据输入问题的情况自动选择是否进行推理。

2025/04/29 08:59:572,259
谷歌发布新一代大模型Gemini 2.5 Flash,成本、速度和性能的最优均衡,同时支持推理和非推理模式,评测结果超Sonnet 3.7

谷歌发布新一代大模型Gemini 2.5 Flash,成本、速度和性能的最优均衡,同时支持推理和非推理模式,评测结果超Sonnet 3.7

Gemini系列是Google的大模型品牌,2025年3月25日,Google发布了Gemini 2.5 Pro版本,这是谷歌发布的Gemini 2.5系列的第一个模型,参数规模较大,但是在多项评测结果上获得了全球最优的效果,Gemini 2.5 Pro成本比较高,时延也比较大,20天之后,谷歌又发布了Gemini 2.5 Flash模型,是性能、成本和效果的最佳均衡模型。

2025/04/21 13:21:241,432
重磅!MetaAI开源Llama4系列,全面进入MoE架构时代,本次发布Llama4 Scout和Llama4 Maverick,1000万上下文输入,170亿激活参数,不支持中文!

重磅!MetaAI开源Llama4系列,全面进入MoE架构时代,本次发布Llama4 Scout和Llama4 Maverick,1000万上下文输入,170亿激活参数,不支持中文!

就在刚刚,MetaAI发布了全新一代Llama4大模型,Llama正式进入多模态和MoE架构时代。本次新发布的是Llama4中的2个模型分别是Llama4 Scout和Llama4 Maverick。这两个模型都是170亿激活参数,但是前者共16个专家,后者有128个专家,因此总的参数量分别达到了1090亿和4000亿!不过根据评测的情况看,即使是4000亿规模170亿激活的模型,也和DeepSeek V3.1(即DeepSeek V3 0324)版本差不多。

2025/04/06 08:41:47963
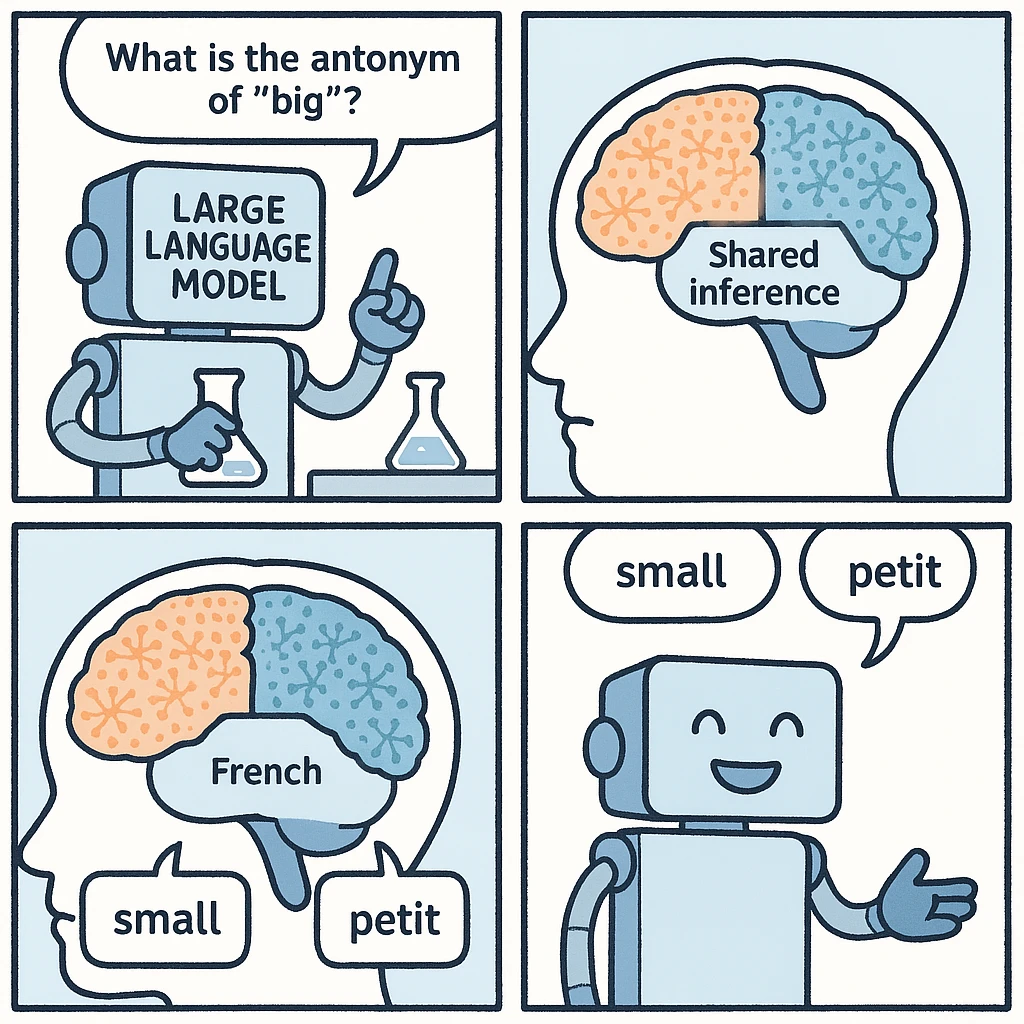
大模型的多语言能力来自哪里?大模型是否有自己的内部语言?在英文数据集上学习到的知识可以用中文表达出来吗?

大模型的多语言能力来自哪里?大模型是否有自己的内部语言?在英文数据集上学习到的知识可以用中文表达出来吗?

最近,Anthropic研究人员通过观察大模型内部运作机制发现了大模型内部可能存在一种与特定语言无关的内部共享区域,它可以把不同语种的输入,在同样的区域进行内部推理,并最终根据语种输出答案。这个现象让我们发现大模型本身理解语言的时候可能与人类类似,拥有高度抽象的内部表示,能够跨越多种语言统一相同的概念。

2025/03/30 18:41:001,246
GPT-4o再度更新:OpenAI发布GPT-4o(2025-03-26)版本模型,大幅提升复杂指令遵循能力,在LM Arena评测超过GPT-4.5,所有类别评测仅次于Gemini 2.5 Pro

GPT-4o再度更新:OpenAI发布GPT-4o(2025-03-26)版本模型,大幅提升复杂指令遵循能力,在LM Arena评测超过GPT-4.5,所有类别评测仅次于Gemini 2.5 Pro

OpenAI再次发布GPT-4o更新版本,版本号为GPT-4o(2025-03-26),本次发布的GPT-4o模型在性能、易用性和协作能力上迎来多项优化,进一步提升了模型的直觉性、创造力和任务执行能力。此次更新聚焦于 STEM 与编程问题解决、指令遵循精度以及自然交互体验,各方面评测进步明显,超过了GPT-4.5。

2025/03/28 08:02:412,578
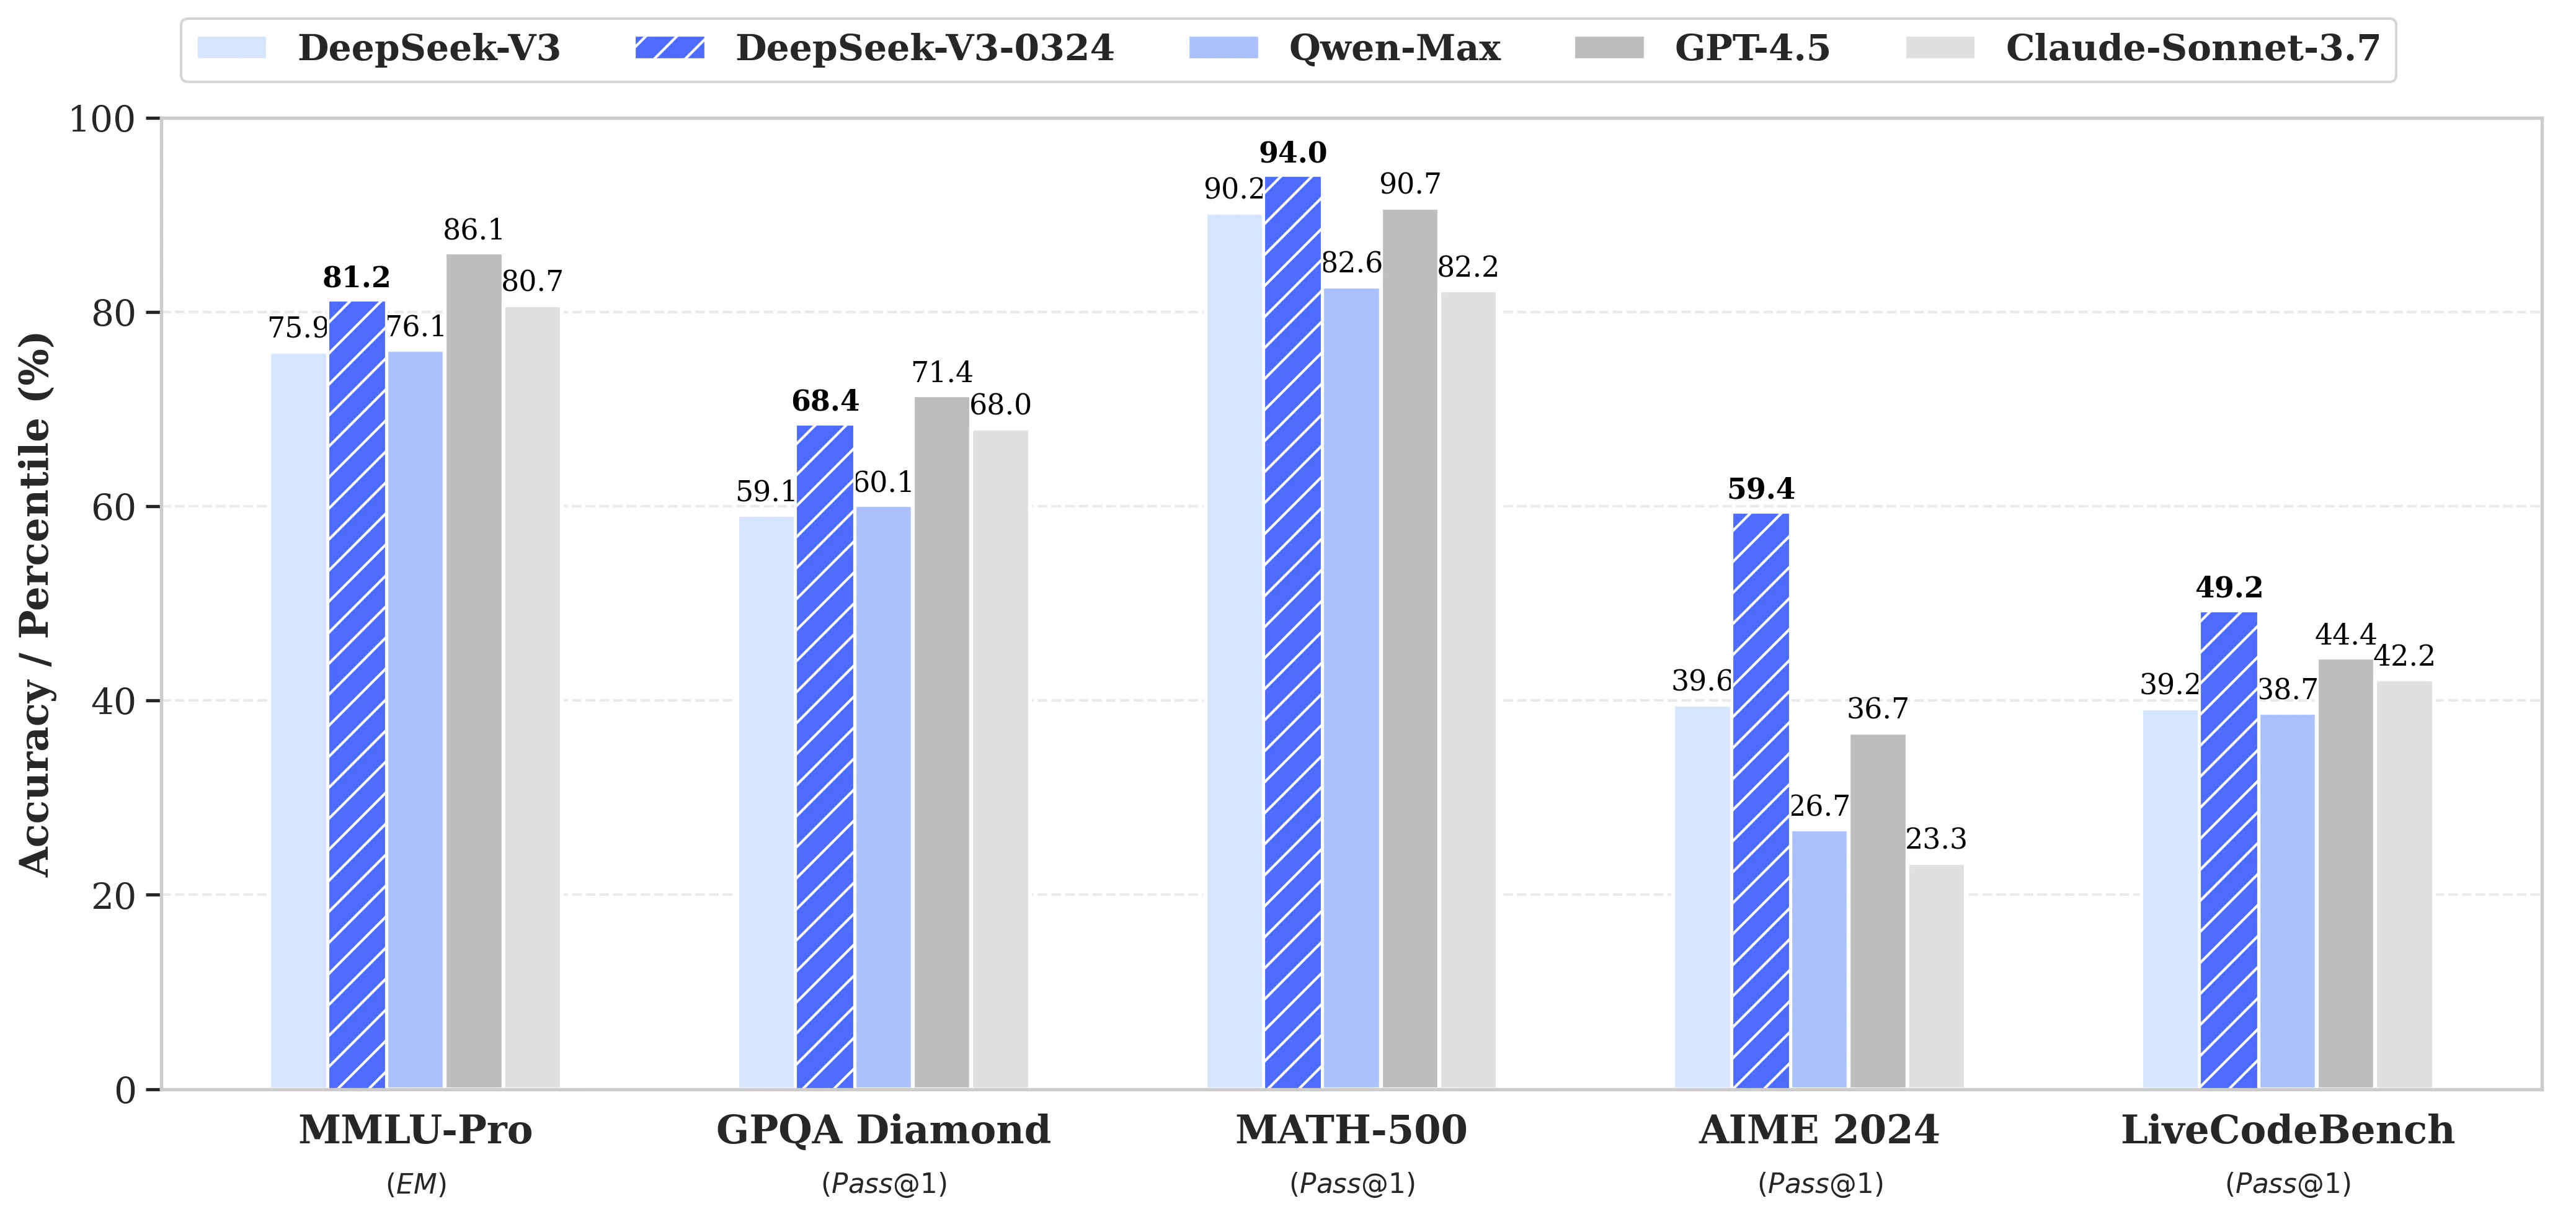
DeepSeekV3-0324发布:DeepSeek V3基础上大幅升级推理能力和前端网页的美观度,多项评测结果超过GPT-4.5

DeepSeekV3-0324发布:DeepSeek V3基础上大幅升级推理能力和前端网页的美观度,多项评测结果超过GPT-4.5

2025年3月25日,DeepSeekAI低调开源了DeepSeek-V3-0324大模型。作为DeepSeek-V3的重要升级版本,该模型在推理能力、中文写作、前端开发以及功能调用等多个关键领域实现了显著提升。在MMLU Pro等评测上,已经成为了非推理大模型中最强的模型,部分评测结果超过GPT-4.5模型。

2025/03/25 19:07:301,199
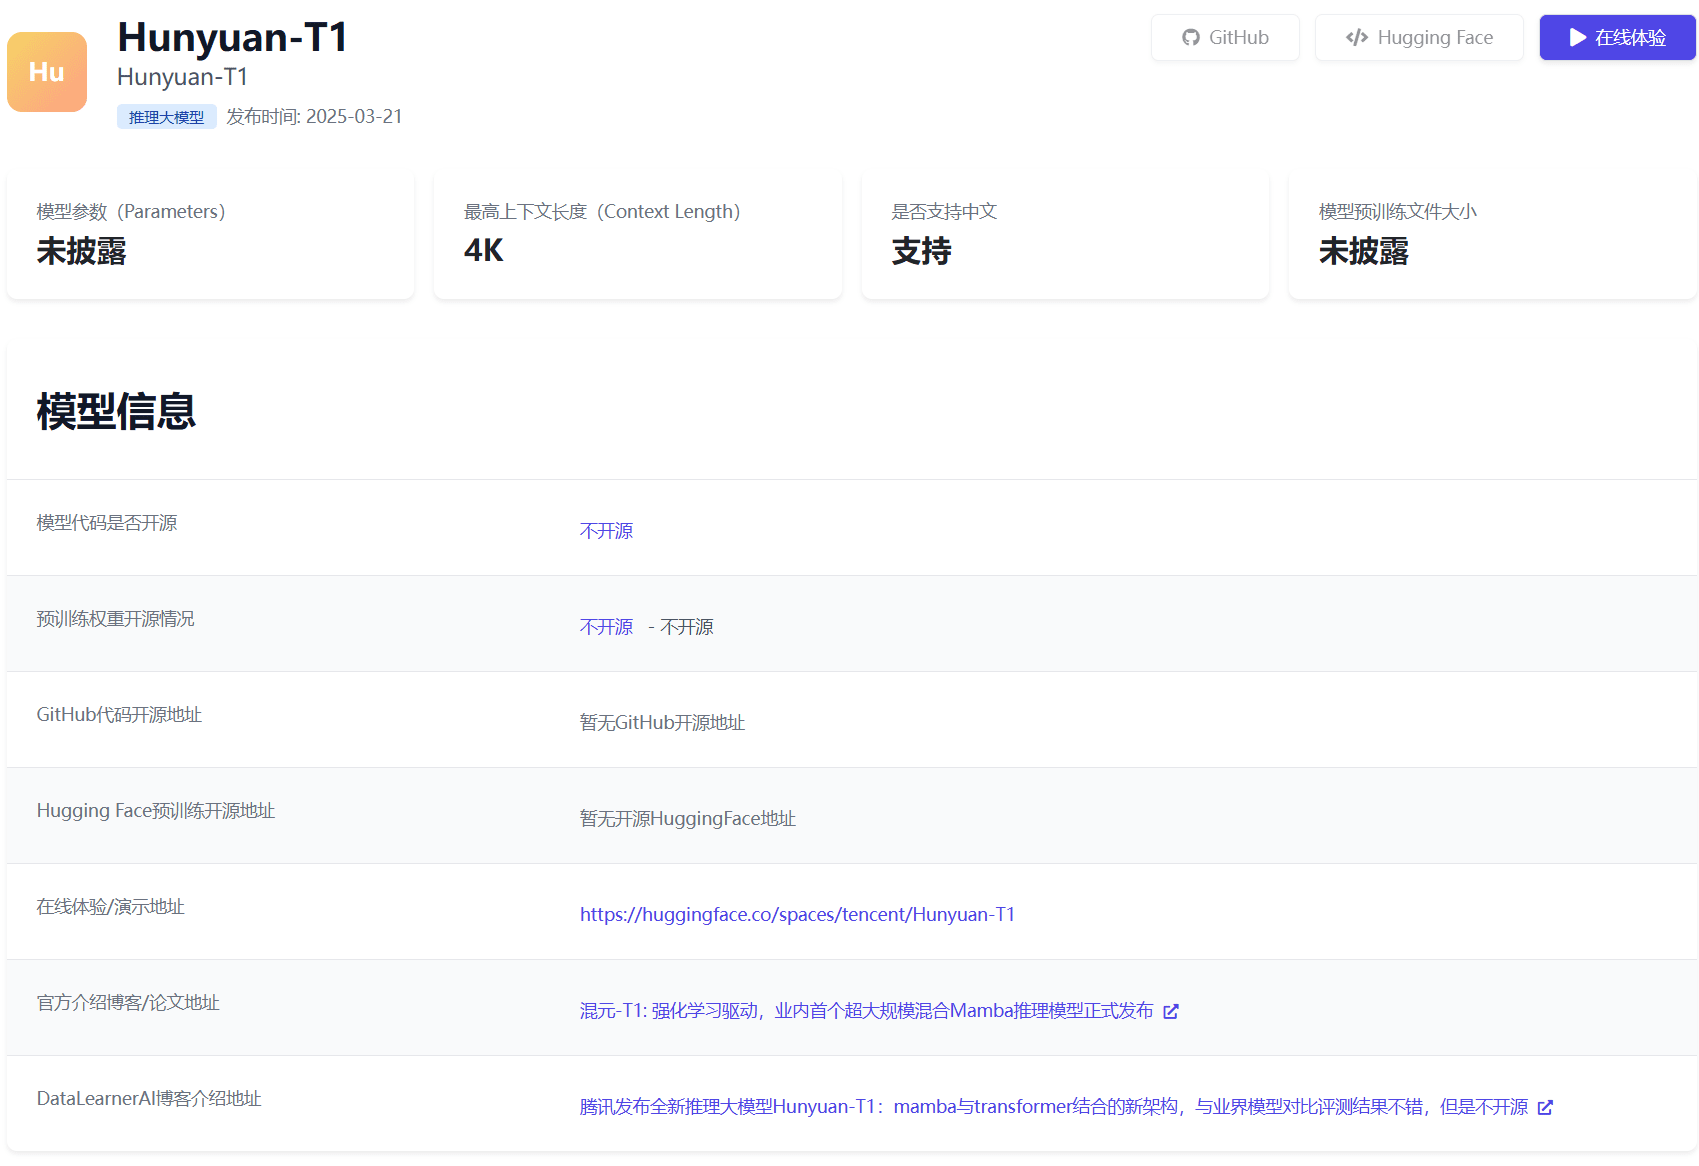
腾讯发布全新推理大模型Hunyuan-T1:mamba与transformer结合的新架构,与业界模型对比评测结果不错,但是不开源

腾讯发布全新推理大模型Hunyuan-T1:mamba与transformer结合的新架构,与业界模型对比评测结果不错,但是不开源

2025年3月21日,腾讯正式推出其全新大模型**Hunyuan-T1**,该模型基于此前发布的TurboS快速思维基座,首次采用**Hybrid-Transformer-Mamba混合专家架构(MoE)**,在推理效率、长文本处理及资源消耗优化等方面表现还不错。此外,这个新架构也使得Hunyuan-T1速度非常快,模型支持首字符1秒内响应,生成速度达60-80 token/秒,适用于实时交互场景。

2025/03/22 11:43:191,520
三年后OpenAI再次发布自动语音识别和语音合成大模型(替换Whisper系列):不开源,仅提供API,英文错字率已经下降到2.46%

三年后OpenAI再次发布自动语音识别和语音合成大模型(替换Whisper系列):不开源,仅提供API,英文错字率已经下降到2.46%

2025年3月20日,OpenAI 推出了三款新模型——gpt-4o-transcribe、gpt-4o-mini-transcribe 和 gpt-4o-mini-tts——标志着自动语音识别 (ASR) 和文本转语音 (TTS) 领域的重要进步。这些模型基于 GPT-4o 架构,旨在为开发人员和用户提高准确性、自定义能力和可访问性,与 OpenAI 对于代理式 AI 系统的更广泛愿景一致。本文提供了对每个模型、其能力、定价、可用性和竞争环境的详细审查,确保技术和非技术受众都能全面理解。

2025/03/21 13:18:491,887
GPQA Diamond:评估专家级推理能力的问答基准

GPQA Diamond:评估专家级推理能力的问答基准

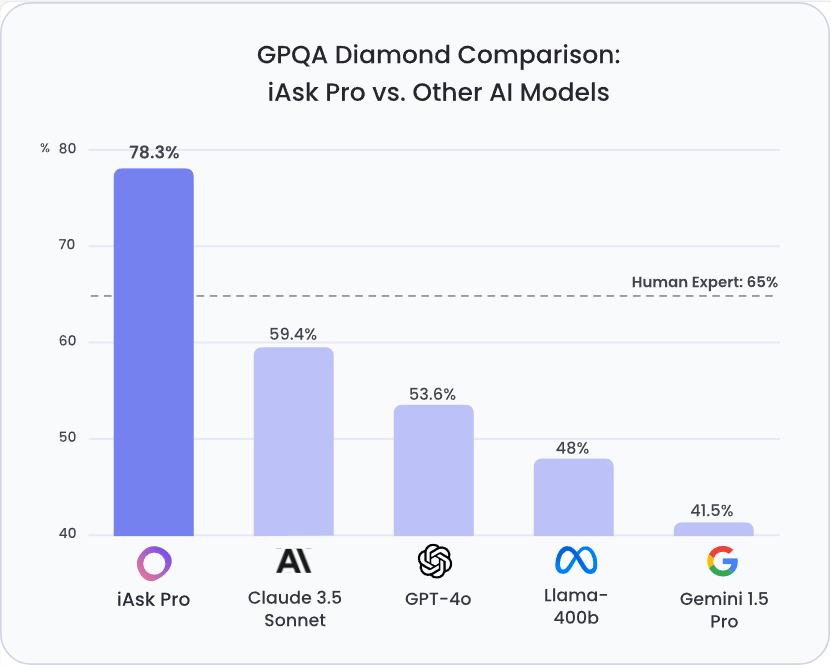
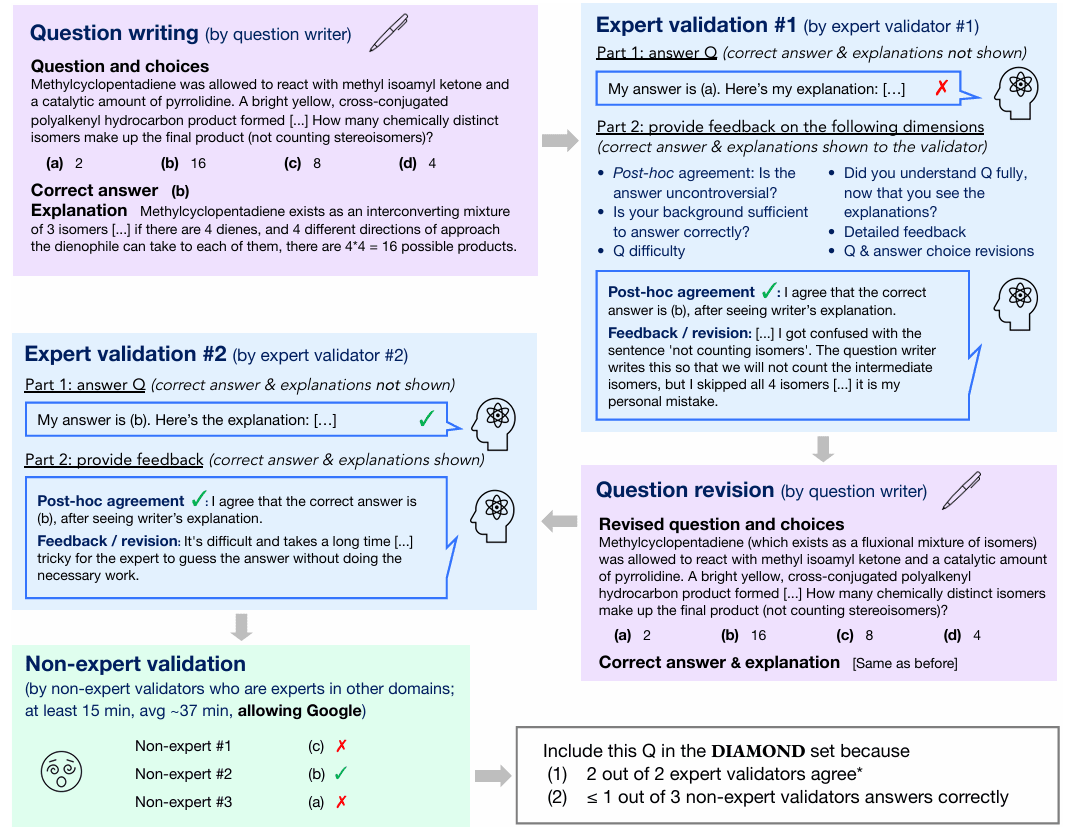
通用人工智能(AGI)的进步需要可靠的评估基准。GPQA (Grade-Level Problems in Question Answering) Diamond 基准旨在衡量模型在需要深度推理和领域专业知识问题上的能力。该基准由纽约大学、CohereAI 及 Anthropic 的研究人员联合发布,其相关论文可在 arXiv 上查阅 (https://arxiv.org/pdf/2311.12022 )。GPQA Diamond是GPQA系列中最高质量的评测数据,包含198条结果。

2025/03/20 17:34:133,906
MistralAI开源240亿参数的多模态大模型Mistral-Small-3.1-24B:评测结果与GPT-4o-mini与Gemma 3 27B有来有回,开源且免费商用,支持24种语言

MistralAI开源240亿参数的多模态大模型Mistral-Small-3.1-24B:评测结果与GPT-4o-mini与Gemma 3 27B有来有回,开源且免费商用,支持24种语言

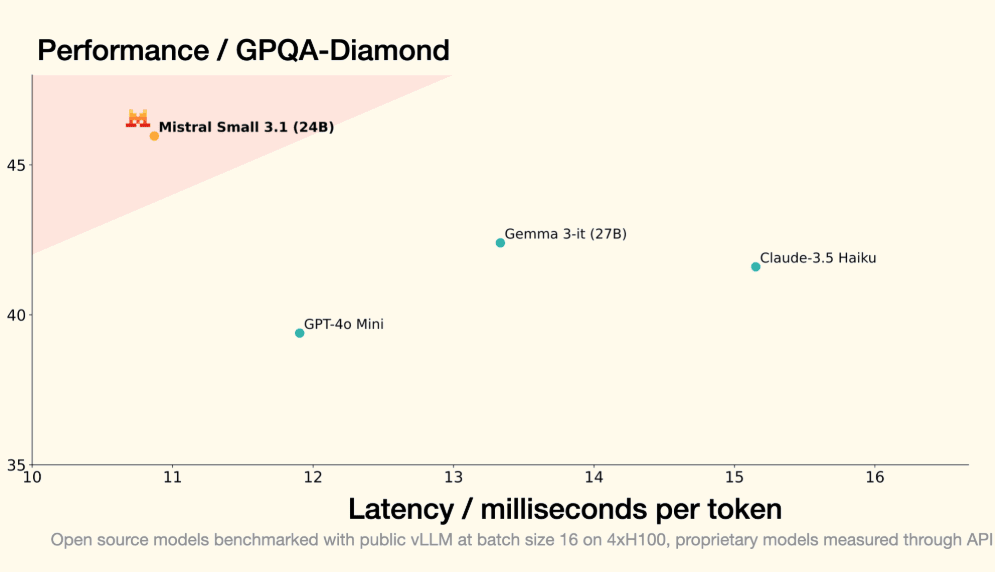
欧洲大模型之光MistralAI开源了2个全新的多模态大模型,即Mistral-Small-3.1-24B基座版本和指令微调版本。这两个大模型均以Apache2.0协议开源,因此可以完全免费商用。而官方也给出了这个模型在多个评测集上的效果,高于GPT-4o-mini和Gemma 3 27B。因为其参数规模较小,推理速度可以达到每秒150个tokens,同时支持多种语言,是一个非常值得关注的小而美的多模态大模型。

2025/03/18 16:41:501,205
GPQA: 可以防止使用谷歌作弊的研究生级别难度的大模型专业能力评测基准(A Graduate-Level Google-Proof Q&A Benchmark)

GPQA: 可以防止使用谷歌作弊的研究生级别难度的大模型专业能力评测基准(A Graduate-Level Google-Proof Q&A Benchmark)

研究生级别的 **Google 防查找问答基准测试**(即Graduate-Level Google-Proof Q&A Benchmark,简称 GPQA)是大型语言模型(LLM)面临的最具挑战性的评估之一。GPQA 旨在推动人工智能能力的极限,提供一个严格的测试平台,不仅评估模型的事实记忆能力,还考察其在专业科学领域的深度推理和理解能力。本篇博文将客观介绍 GPQA,涵盖它的起源、目的、组成部分,以及领先的大型语言模型在这个高要求基准测试中的表现。

2025/03/18 15:05:242,360
Google开源第三代Gemma-3系列模型:支持多模态、最多128K输入,其中Gemma 3-27B在大模型匿名竞技场得分超过了Qwen2.5-Max

Google开源第三代Gemma-3系列模型:支持多模态、最多128K输入,其中Gemma 3-27B在大模型匿名竞技场得分超过了Qwen2.5-Max

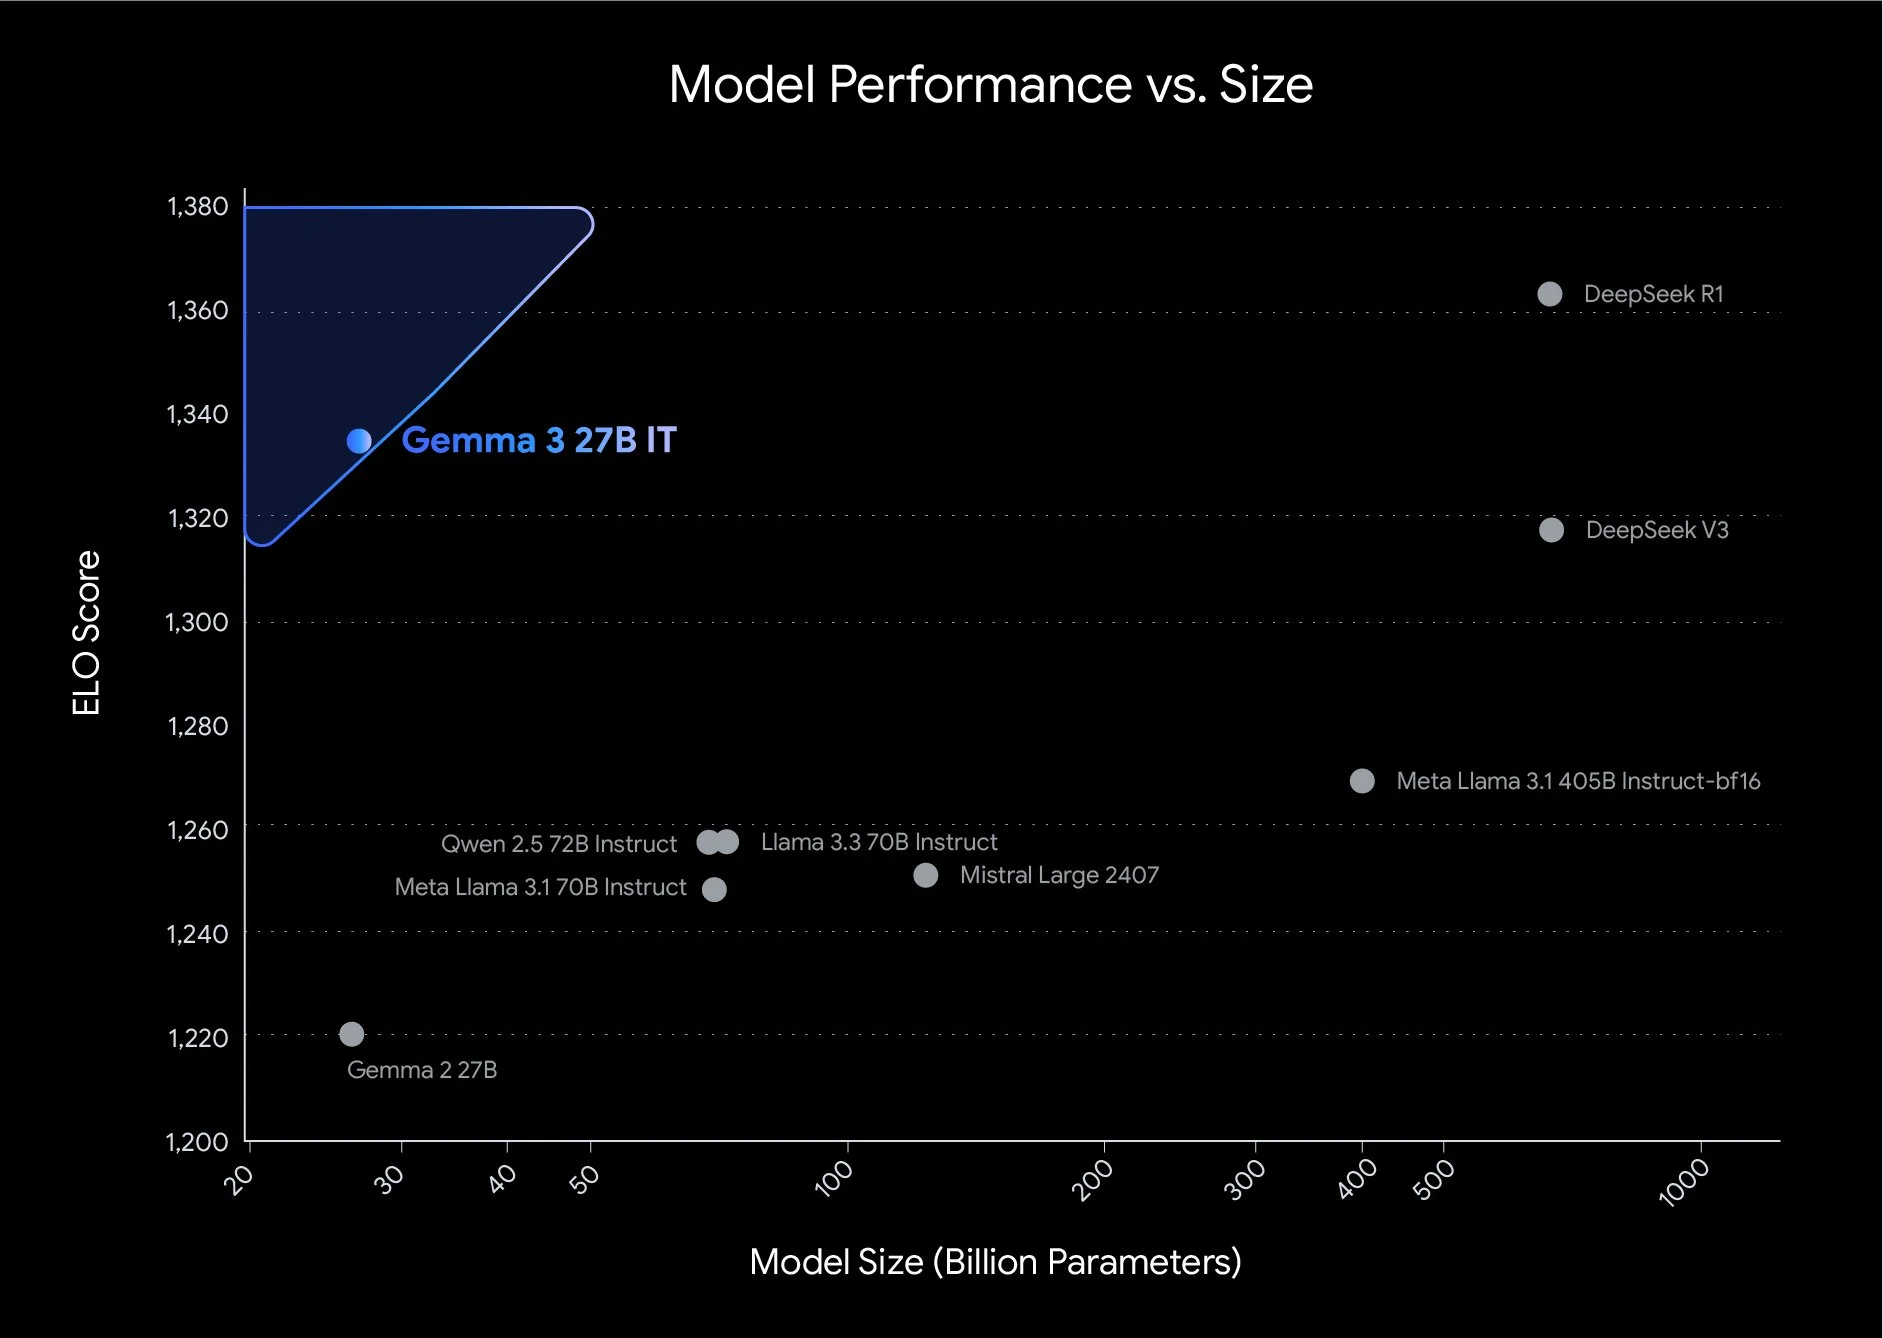
Gemma系列大模型是Google开源的一系列轻量级的大模型。就在刚才(2025年3月12日),Google开源了第三代Gemma系列大模型,共包含4个不同参数规模版本,第三代的Gemma 3系列是多模态大模型,即使是最小的10亿参数规模的Gemma 3-1B也支持多模态输入。

2025/03/12 22:50:222,235
腾讯发布了一个全新的大模型Hunyuan Turbo S:号称评测效果超过GTP-4o和DeepSeek V3等模型,但没有开源或者放开使用

腾讯发布了一个全新的大模型Hunyuan Turbo S:号称评测效果超过GTP-4o和DeepSeek V3等模型,但没有开源或者放开使用

Hunyuan大模型是腾讯训练的大模型品牌名,2022年4月份,某中文语言理解能力排行榜第一名就出现了Hunyuan模型,在2022年11月,Hunyuan大模型就有了1万亿参数的规模,即HunYuan-NLP 1T大模型(比ChatGPT还早发布)。但是最近2年,这个系列的模型几乎没有出现在公众视野上。而昨天(2025年3月10日),Hunyuan官方在X平台上宣布了旗下最新的Hunyuan Turbo S大模型,称其在多个评测基准上超越了GPT-4o的表现。

2025/03/11 22:51:481,385
什么时候该使用推理大模型?OpenAI官方推出推理大模型和大语言模型的最佳使用指南

什么时候该使用推理大模型?OpenAI官方推出推理大模型和大语言模型的最佳使用指南

随着DeepSeek R1和OpenAI的o1、o3等推理大模型的发布,我们当前可使用的大模型种类也变多了。但是,推理大模型和普通大模型之间并不是二选一的关系,在不同的问题上二者各有优势。为了让大家更清晰理解推理大模型和普通大模型的应用场景。OpenAI官方推出了一个推理大模型最佳实践指南。描述了二者的对比。本文将总结这份推理大模型最佳实践指南。

2025/03/05 12:53:441,338