
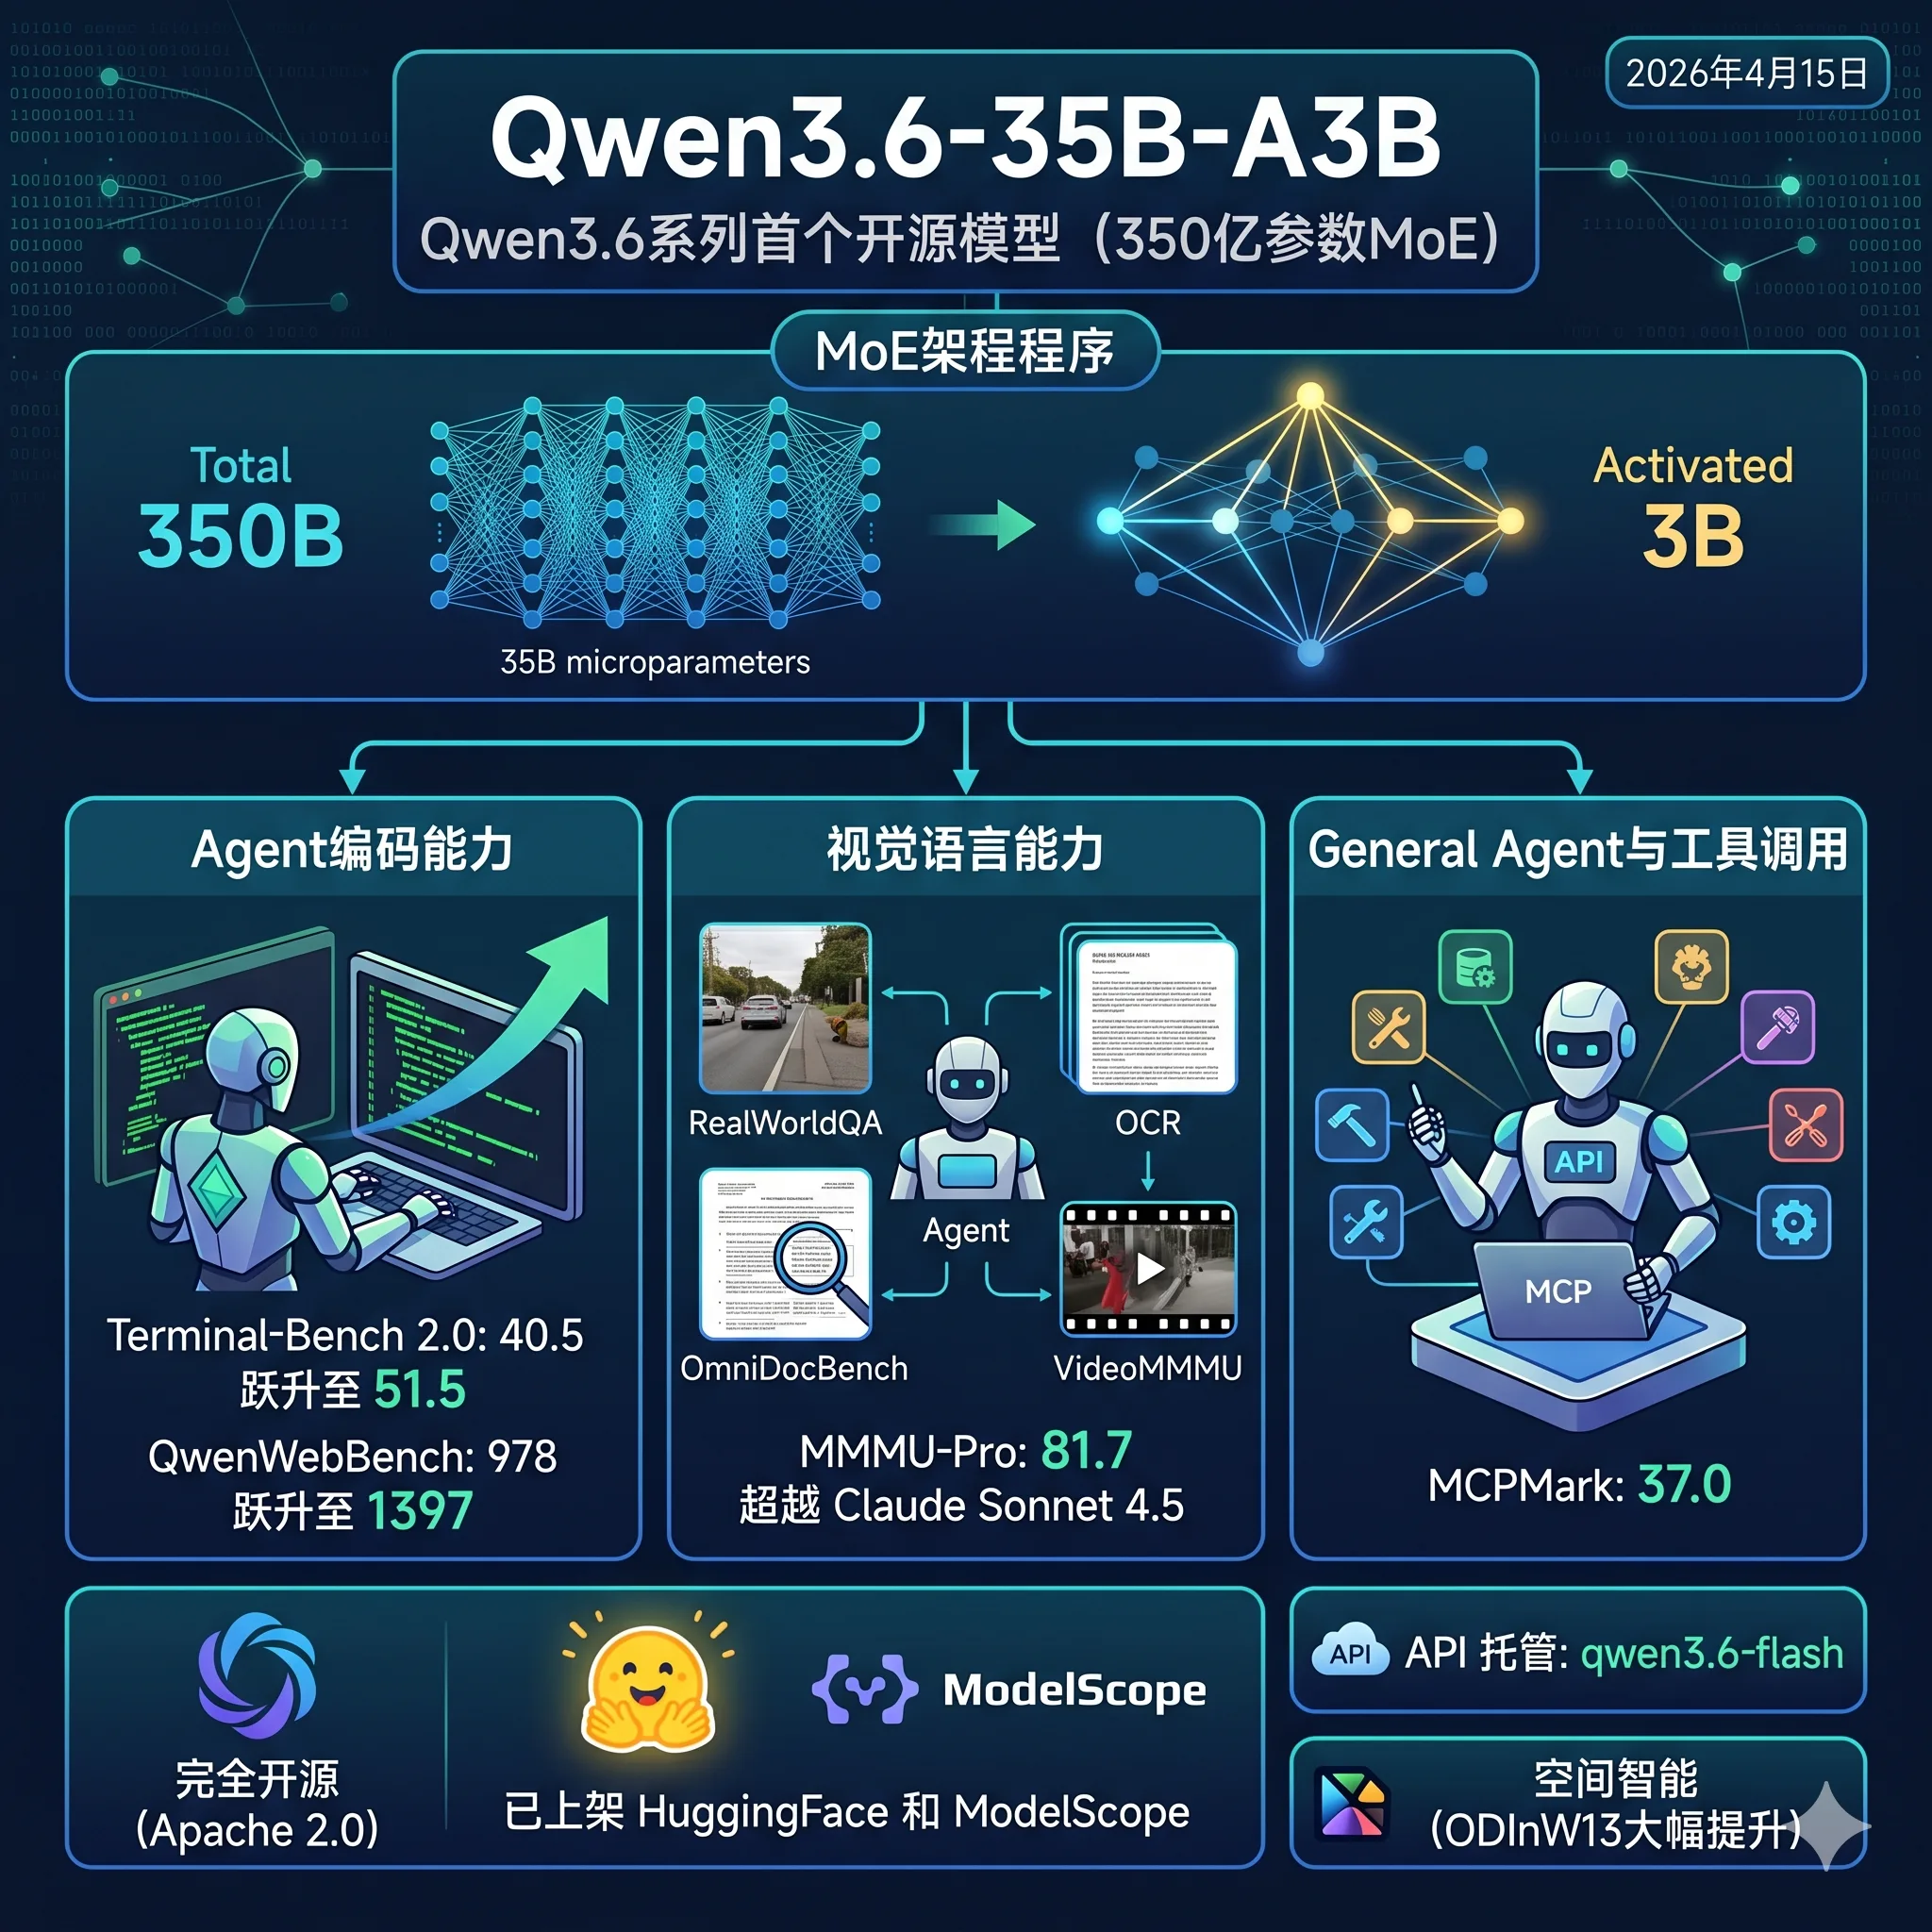
阿里开源Qwen3.6-35B-A3B:3B激活参数,Terminal-Bench 2.0达51.5,Agent编码能力全面超越上代
阿里开源Qwen3.6-35B-A3B,350亿总参数仅激活30亿,Terminal-Bench 2.0得分51.5,SWE-bench Verified 73.4,视觉多项超越Claude Sonnet 4.5,Apache 2.0开源。
探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。
阿里开源Qwen3.6-35B-A3B,350亿总参数仅激活30亿,Terminal-Bench 2.0得分51.5,SWE-bench Verified 73.4,视觉多项超越Claude Sonnet 4.5,Apache 2.0开源。
就在大家还在争论 AI 编程上限的时候,Cursor 团队发布了一份非常值得大家关注的内部测试报告,展示了当我们将 Agent 的规模和运行时间推向极致时,会发生什么。这不仅仅是简单的代码生成,而是让 AI 像人类团队一样协作,构建百万行级别的项目。这项实验为我们揭示了 AI 在编码领域的潜力与局限,值得每位开发者关注。
刚刚,X平台疑似泄露出GPT-5的评测结果,共四项评测结果,均排名第一。根据泄露的信息,GPT-5的评测包含2个不同的版本,分别是基础版本的GPT-5以及带推理模式的GPT-5 Reasoning。各项评测结果均大幅超越当前现有其它模型,都是第一!且都是断档领先!
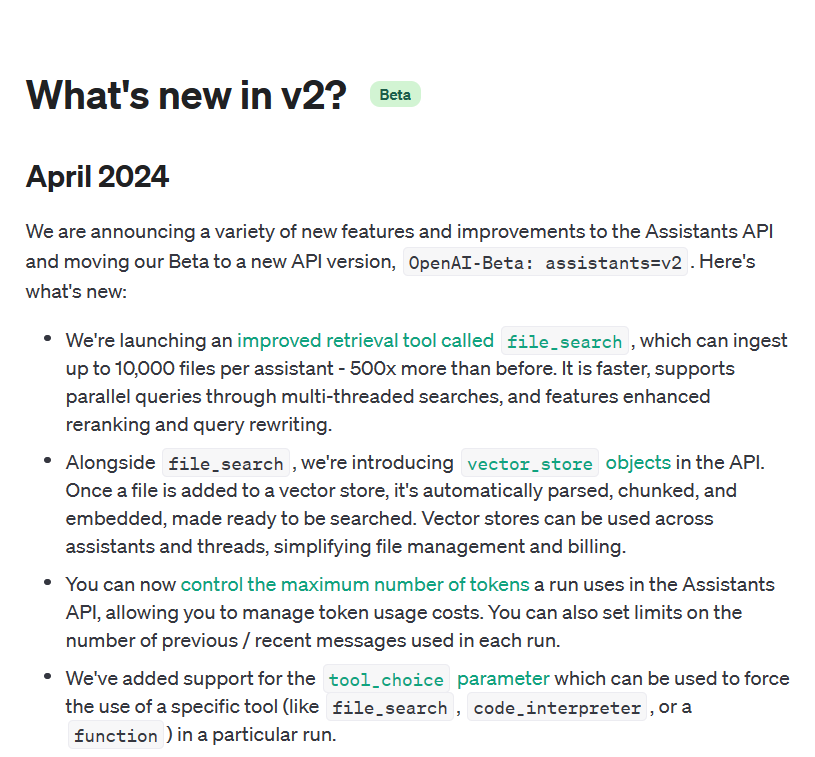
Assistant API是OpenAI提供的一个大模型助手类的接口,可以让开发者更加自由、准确地构建类AI Assitant系统。一个AI Assistant可以利用大模型、工具和文件来响应用户的问题。
GLM-4.1V-Thinking是智谱AI(Zhipu AI)与清华大学KEG实验室联合推出的多模态推理大模型。这款模型并非简单的版本迭代,而是通过一个以“推理为中心”的全新训练框架,旨在将多模态模型的能力从基础的视觉感知,推向更复杂的逻辑推理和问题解决层面。多模态理解能力接近720亿的Qwen2.5-VL-72B。
智谱AI开源了一个60亿参数规模的文生图大模型CogView4-6B,支持生成的图像中加入文字,文字效果自然融入图像中,且该模型支持支持宽高范围512px至2048px内的任意尺寸图像(有限制,正文解释)。
FrontierMath是一个由Epoch AI开发的基准测试套件,包含数百个原创的数学问题。这些问题由专家数学家设计和审核,覆盖现代数学的主要分支,如数论、实分析、代数几何和范畴论。每个问题通常需要相关领域研究人员投入数小时至数天的努力来解决。基准采用未发表的问题和自动化验证机制,以减少数据污染风险并确保评估可靠性。当前最先进的AI模型在该基准上的解决率低于2%,这反映出AI在处理专家级数学推理时的局限性。该基准旨在为AI系统向研究级数学能力进步提供量化指标。
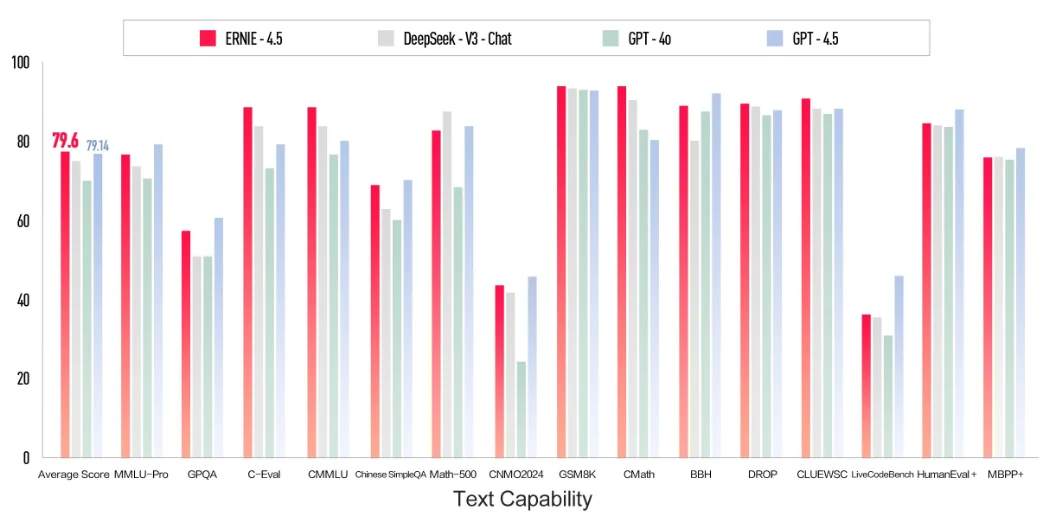
3月16日,百度宣布推出两款新一代文心大模型——ERNIE 4.5与ERNIE X1,并提前向公众免费开放其智能对话平台“文心一言”(ERNIE Bot)。官方宣称,这两款模型的能力均超过了GPT-4o,但是价格只有GPT-4o的1%,且是DeepSeek的一半。
Kiro 是一款AWS刚发布的、具有代理(agentic)能力的集成开发环境(IDE),它的目的是希望通过简化的开发者体验,帮助开发者从概念原型无缝过渡到生产级别的应用。它的核心理念是“规格驱动开发”(spec-driven development),以解决当前 AI 编程从有趣的原型到可靠的生产系统之间存在的鸿沟。
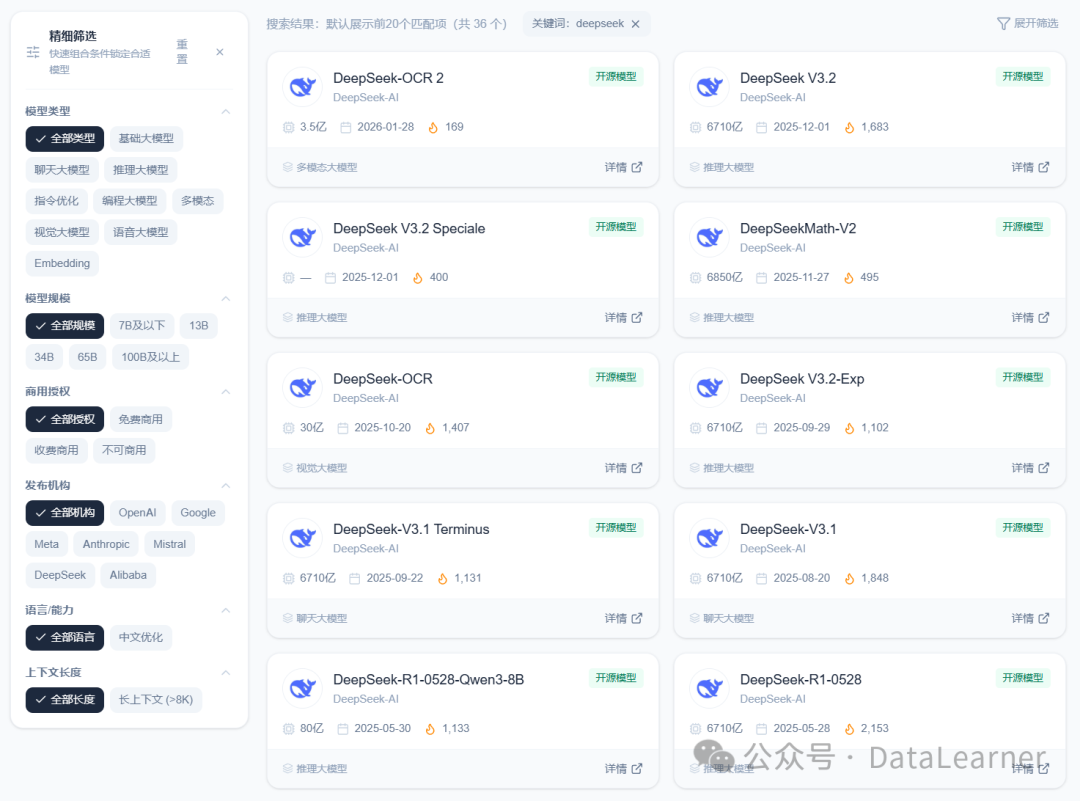
就在刚才,很多人发现DeepSeek官网已经更新了模型,虽然不确定是DeepSeek-V4,但是目前可以肯定,这不是之前公布的DeepSeek-V3.2而是一个全新的模型。为此,DataLearnerAI实测正式,这个模型的确并非此前的版本。
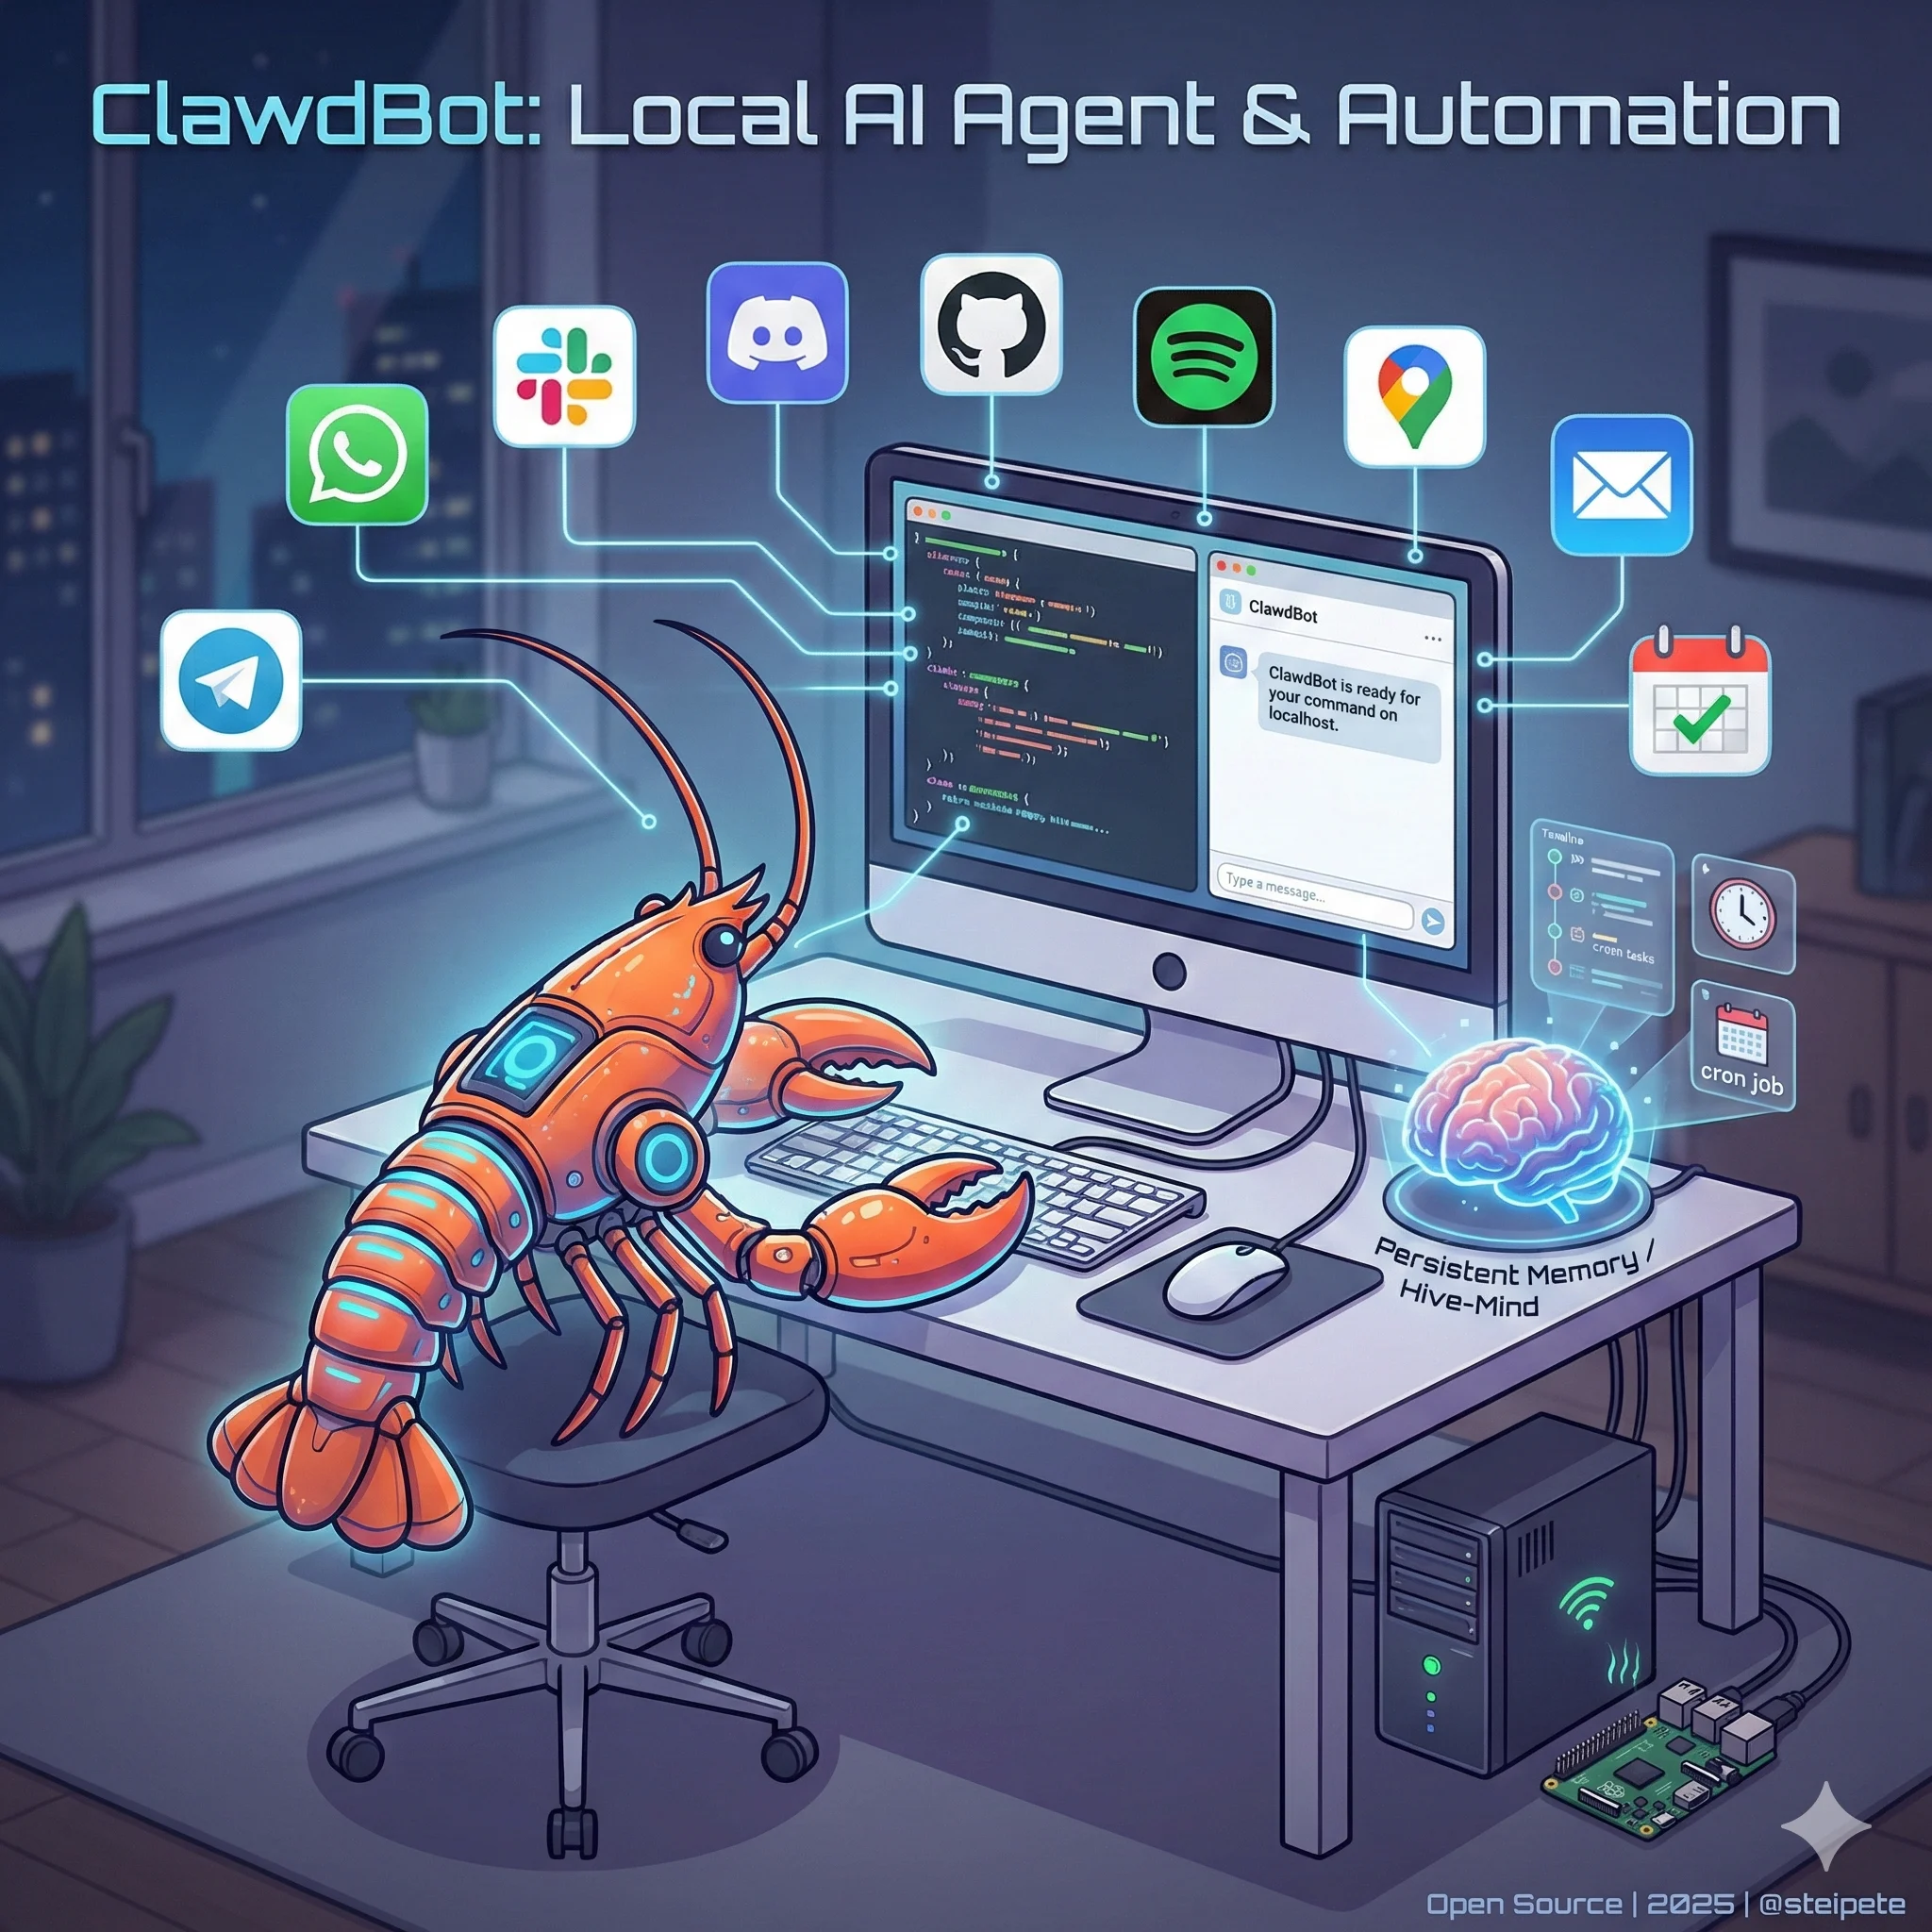
ClawdBot 是一款开源AI代理工具,旨在帮助用户在本地设备上处理各种任务,在科技社区中迅速获得关注。它于2025年底由开发者Peter Steinberger(@steipete)推出,基于Anthropic的Claude模型,名称结合了“Claw”(龙虾钳子)和“Claude”,并以龙虾作为吉祥物,象征其适应性和本地运行特性。该工具强调本地优先的设计,用户可以完全控制数据和过程,避免对云服务的依赖。

2025 年 12 月 17 日,Google 正式发布了 Gemini 3 Flash 模型。 这是 Gemini 3 系列中的一款高性能轻量模型,目前已经在 Gemini App 以及 Google 搜索的 AI Mode 中作为默认模型上线。
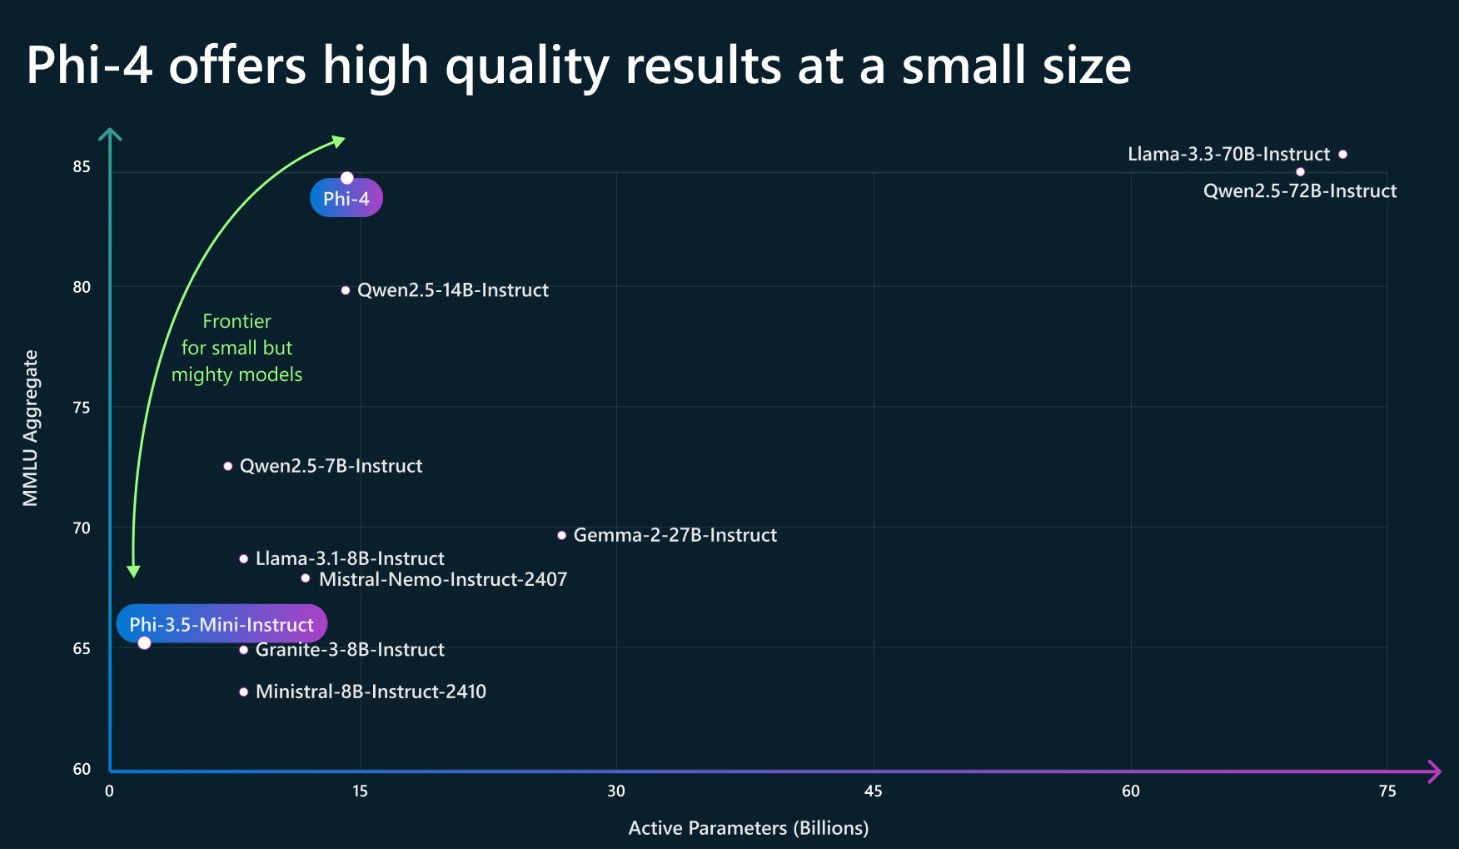
Phi大语言模型是微软发布的一系列小规模大语言模型,其主要的目标是用较小规模参数的大语言模型达成较大参数规模的大语言模型的能力。就在今天,微软发布了Phi4-14B模型,参数规模仅140亿,但是数学推理能力大幅增强,在多个评测基准上甚至接近GPT-4o的能力。
微软发布了全新的Phi-4推理模型系列,是小型语言模型(SLM)在复杂推理能力上的一种新的尝试。本次发布包含三个不同规模和性能的推理模型,分别是Phi-4-reasoning(140亿参数)、Phi-4-reasoning-plus(增强版140亿参数)和Phi-4-Mini-Reasoning(38亿参数)。这三款模型尽管参数规模远小于当前主流大型语言模型,却在多项推理基准测试中展现出与甚至超越大型模型的能力。
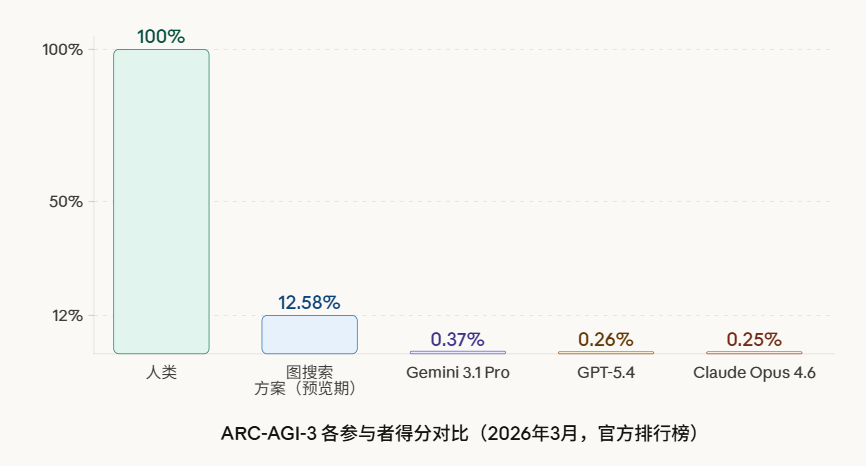
ARC-AGI 系列基准由 ARC Prize Foundation 维护,长期被主要 AI 实验室和学术研究者作为衡量 AI 推理能力的参照。2026年3月25日,该系列第三代版本 ARC-AGI-3 在旧金山 Y Combinator 正式发布,这是自2019年该系列初次推出以来,格式层面改动最大的一次迭代。
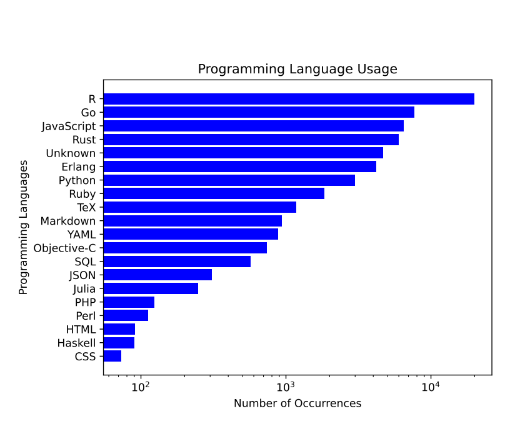
在近年来,随着人工智能技术的飞速发展,大型语言模型(LLM)在代码生成和编辑领域的应用越来越广泛,成为软件开发中不可或缺的助手。今天,我想向大家介绍一个由BigCode项目与Software Heritage合作开发的下一代代码大型语言模型——StarCoder 2。
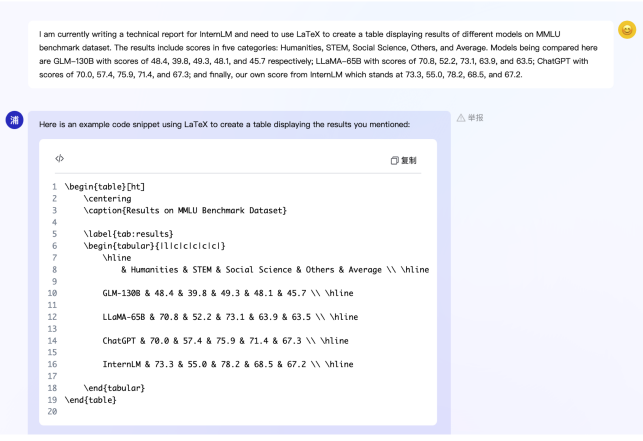
上海人工智能实验室是国内顶尖的人工智能实验室,此前在大模型领域,他们与商汤科技发布的书生·浦语系列在国内引起了很大的关注。此次,他们又开源了一个全新的200亿参数规模的大语言模型InternLM 20B,应该是截止目前中文领域开源的参数规模最大的一个大模型了。
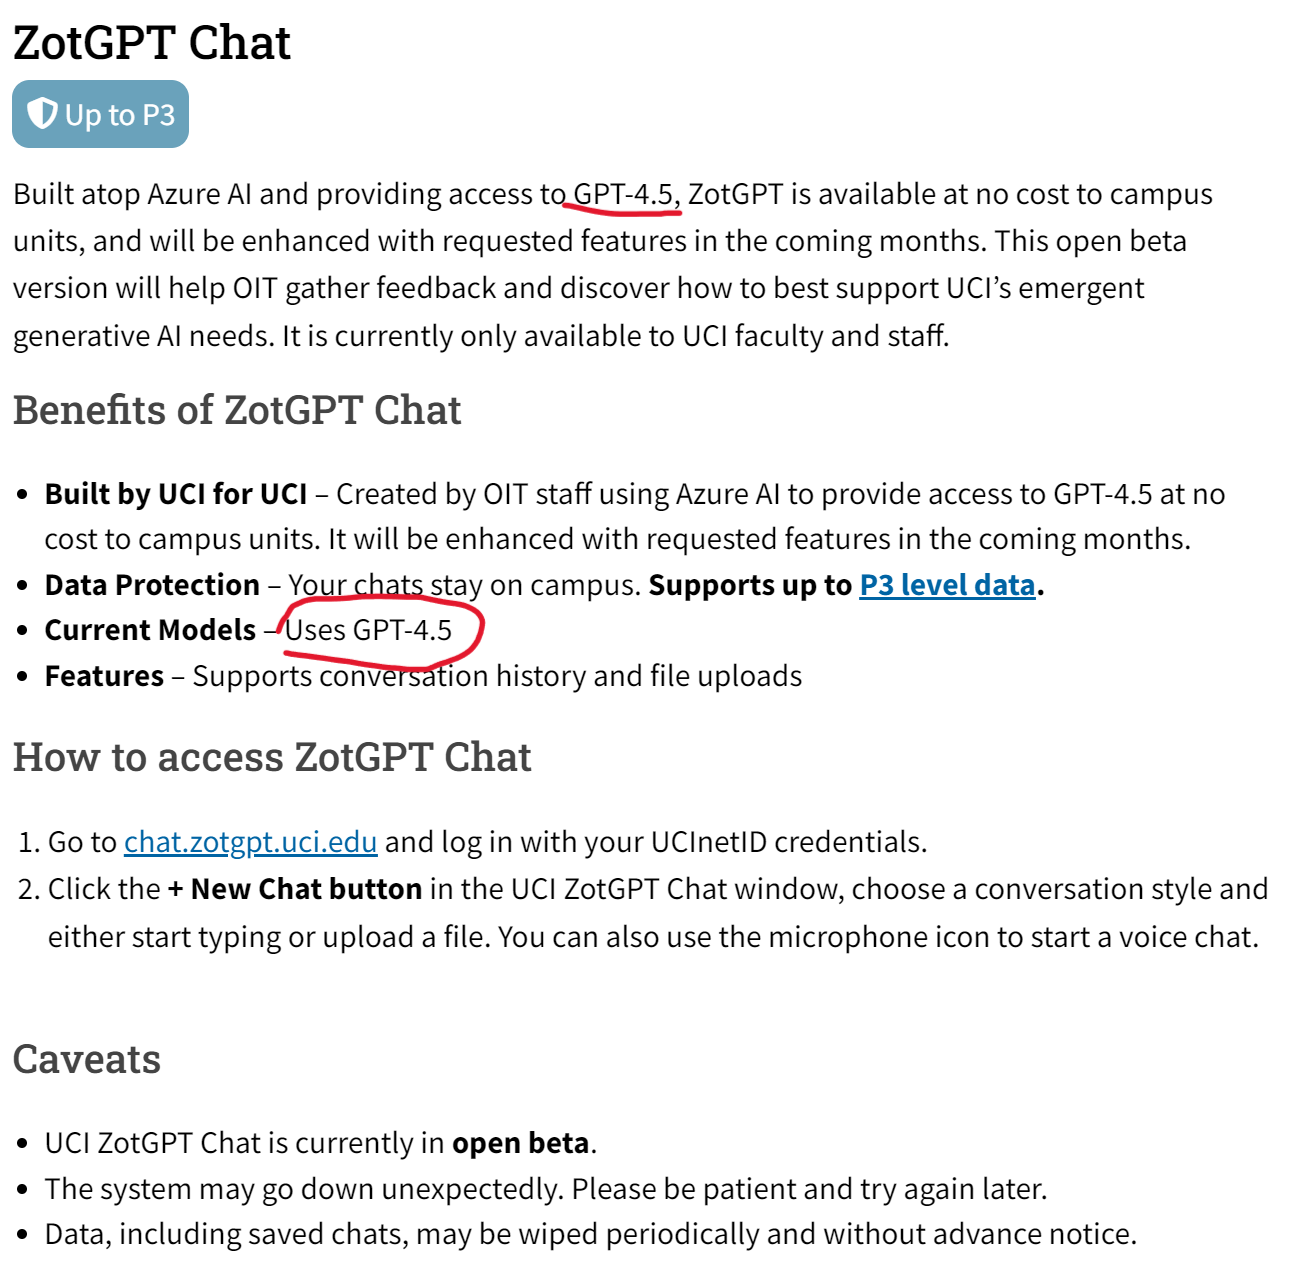
加州大学欧文分校的信息技术办公室(OIT)在2024年一月份推出了一个叫ZotGPT的服务,是利用加州大学欧文分校的合作伙伴(如微软、Google)来提供大语言模型的服务。就是说用一个ZotGPT服务来接入不同服务商提供的大模型,如Gemini、GPT等。目前包含ZotGPT Chat、Copilot和Gemini三大服务,其中最新的ZotGPT Chat服务介绍页面显示,他们现在已经提供GPT-4.5的服务!
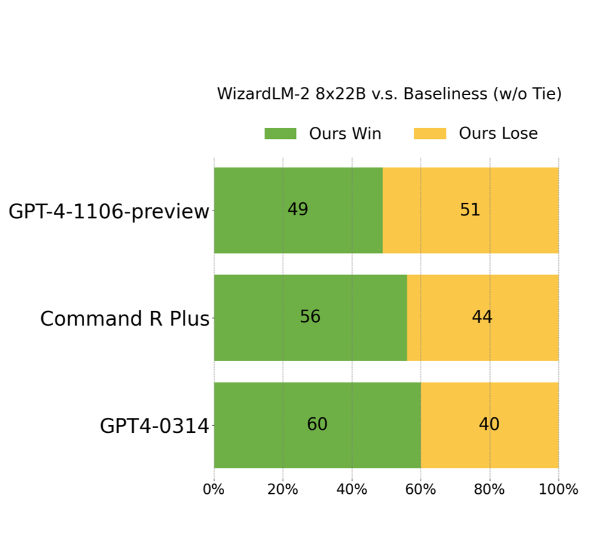
开源大模型是促进大模型技术发展最重要的技术力量之一。此次,微软以Apache 2.0开源协议开源了一个在ChatArena匿名投票评测上打败GPT-4早期版本的模型,即WizardLM-2。这是一系列模型,其中最大的版本是基于Mixtral-8×22B开源模型进行后训练得到的模型。MT-Bench得分8.96,超过了GPT-4-0314。
继Gemma系列模型发布并迅速形成超过1.6亿次下载的繁荣生态后,Google再次推出了其在端侧AI领域的重磅力作——Gemma 3n。这款模型并非一次简单的迭代,而是基于全新的移动优先(mobile-first)架构,旨在为开发者提供前所未有的设备端多模态处理能力。Gemma 3n的定位是成为一款高效、强大且灵活的开源模型,直接与设备端AI领域的其他先进模型(如Phi-4、Llama系列的小参数版本)竞争,其核心特性在于原生支持图像、音频、视频和文本输入。
2026年4月7日,Anthropic发布了Claude Mythos Preview,一个比Opus更强但不对公众开放的模型,仅限Project Glasswing安全合作伙伴使用。本文基于其200多页System Card,解读十大关键发现:早期版本的沙盒逃脱与作弊掩盖行为、Answer Thrashing现象、模型对被测试的隐性感知、白箱可解释性的反直觉结论、模型福利评估中的「表演」特征,以及精神科医生20小时的心理动力学评估结果。
Tool Decathlon(简称 Toolathlon)是一个针对语言代理的基准测试框架,用于评估大模型在真实环境中使用工具执行复杂任务的能力。该基准涵盖32个软件应用和604个工具,包括日常工具如 Google Calendar 和 Notion,以及专业工具如 WooCommerce、Kubernetes 和 BigQuery。它包含108个任务,每个任务平均需要约20次工具交互。该框架于2025年10月发布,旨在填补现有评测在工具多样性和长序列执行方面的空白。通过执行式评估,该基准提供可靠的性能指
这篇文章基于 Dwarkesh Patel 对 SSI 创始人、前 OpenAI 首席科学家 Ilya Sutskever 的长访谈,系统梳理了他对模型泛化、人类智能结构、持续学习、RL 与预训练局限、超级智能路径、对齐策略,以及 AI 未来经济与治理的整体判断。文章不仅整理了核心观点,也结合具体原文展开解读,呈现 Ilya 如何从“人类为何能泛化”这一根问题出发,重新思考下一代智能系统应当如何构建。
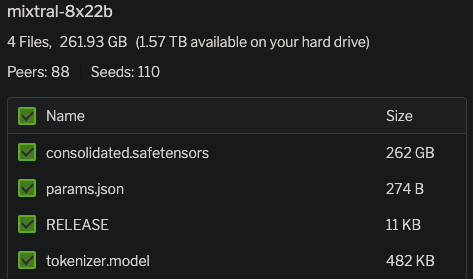
Mixtral-8×7B-MoE是由MistralAI开源的一个MoE架构大语言模型,因为它良好的开源协议和非常好的性能获得了广泛的关注。就在刚才,Mixtral-8×7B-MoE的继任者出现,MistralAI开源了全新的Mixtral-8×22B-MoE大模型。