
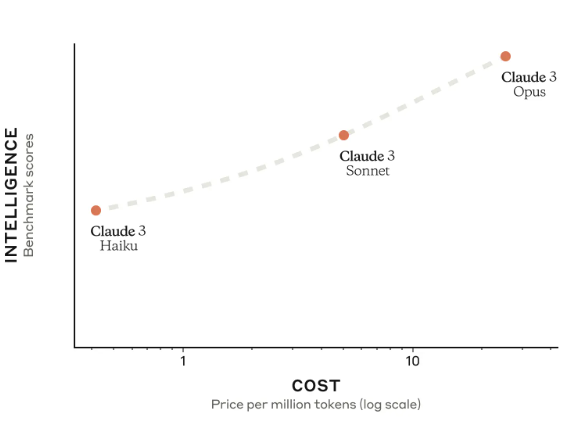
评测结果超过GPT-4,Anthropic发布第三代大语言模型Claude3,具有多模态能力,实际评测表现优秀!
Anthropic被认为是最像OpenAI的一家公司。他们推出的Claude2模型是全球首个支持200K超长上下文的商业模型。在PDF理解方面被认为表现优秀。就在2023年3月4日,Anthropic推出了他们的第三代大语言模型Claude3,包含3个不同的版本,支持多模态和最高100万上下文输入!
探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。
Anthropic被认为是最像OpenAI的一家公司。他们推出的Claude2模型是全球首个支持200K超长上下文的商业模型。在PDF理解方面被认为表现优秀。就在2023年3月4日,Anthropic推出了他们的第三代大语言模型Claude3,包含3个不同的版本,支持多模态和最高100万上下文输入!

MMEB(Massive Multimodal Embedding Benchmark)是一个用于评估多模态嵌入模型的基准测试框架。该基准最初聚焦于图像-文本嵌入,并在后续版本中扩展到文本、图像、视频和视觉文档输入。MMEB通过收集多样化数据集,提供一个统一的评估平台,用于测试模型在分类、检索和其他任务上的性能。
今天,OpenAI官方宣布了一个非常有意思的论文,他们使用GPT-4模型来自动解释GPT-2中每个神经元的含义,试图让语言模型来对语言模型本身的原理进行解释。
据传,Meta公司即将推出一款名为Code LLaMA的开源AI模型,用于生成编程代码。这一新模型被视为与OpenAI的Codex模型竞争的产品,并建立在Meta最近发布的LLaMA 2上。以下是关于这一新技术的详细分析。
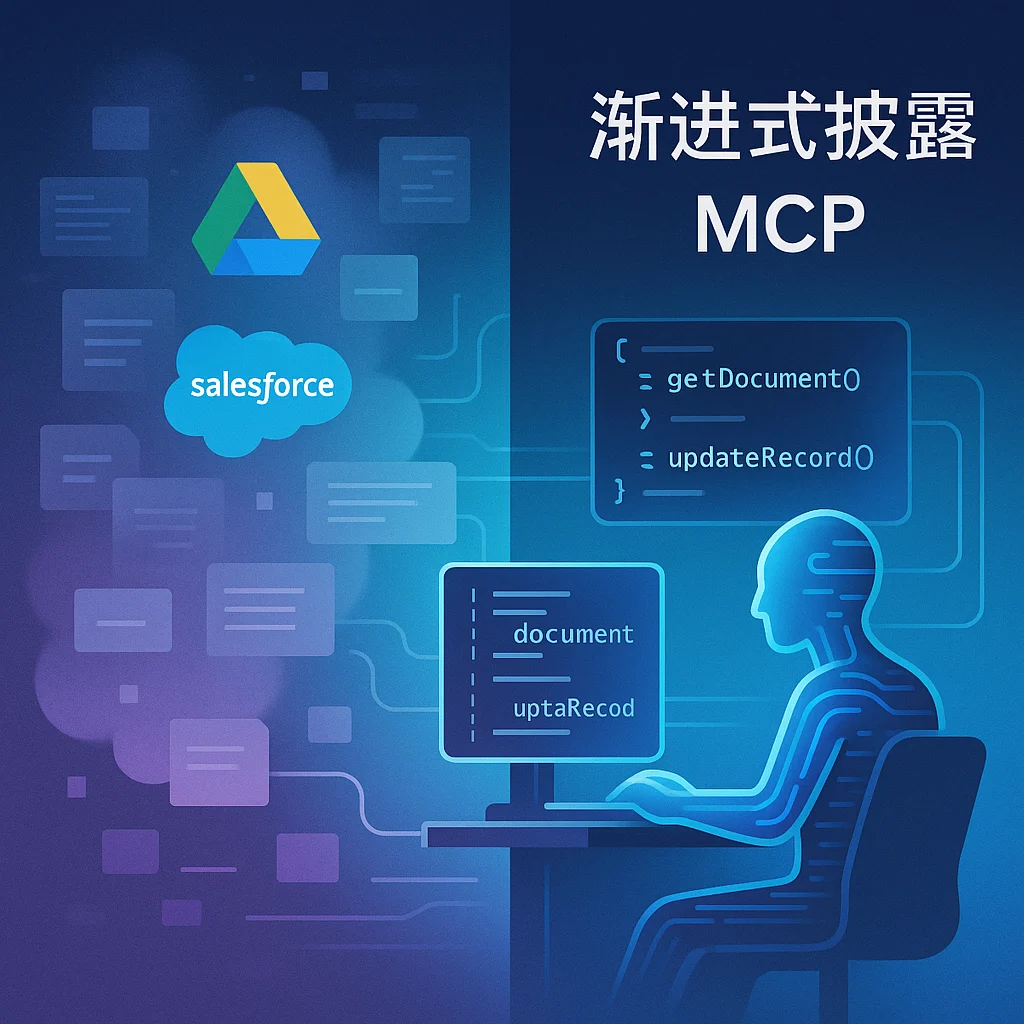
让AI Agent通过编写代码来调用工具,而不是直接工具调用。这种方法利用了MCP(Model Context Protocol,模型上下文协议)标准,能显著降低token消耗,同时保持系统的可扩展性。下面,我结合原文的逻辑,分享我的理解和改写版本,目的是记录这个洞察,并为后续实验提供参考。Anthropic作为领先的AI研究机构,于2024年11月推出了MCP,这是一个开放标准,旨在简化AI Agent与外部工具和数据的连接,避免传统自定义集成的碎片化问题。
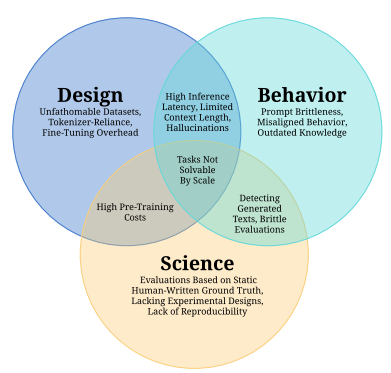
前天,EleutherAI、MetaAI、StabilityAI、伦敦大学等研究人员合作提交了一个关于大语言模型(Large Language Model,LLM)的挑战和应用的论文综述,引用了688篇参考文献总结了当前LLM的主要挑战和应用方向。
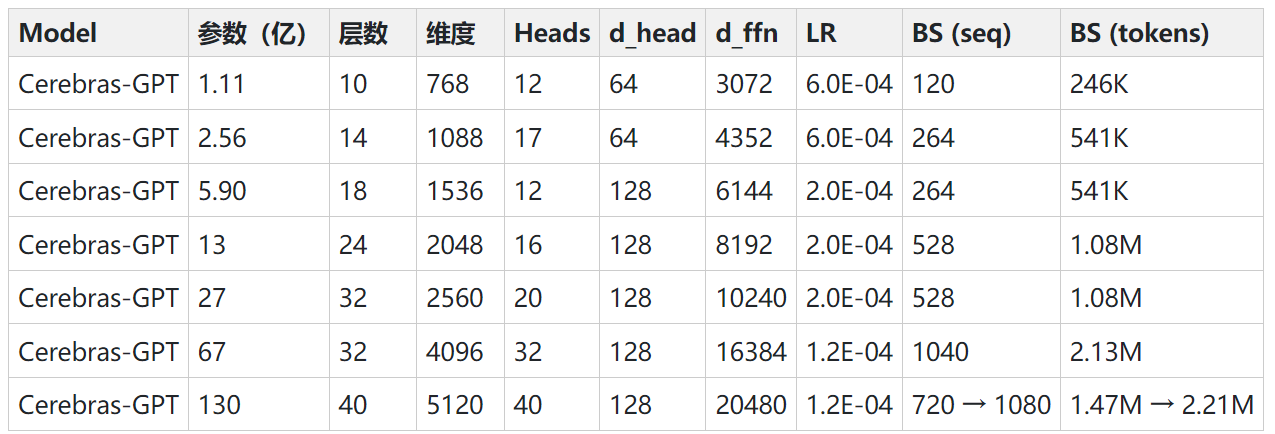
在最近的24个小时内,有2个开源的自然语言处理领域的开源预训练大模型发布。这两个模型都是类似GPT的Transformer模型,可以完成和ChatGPT类似的能力。最重要的是这2个模型完全开源!
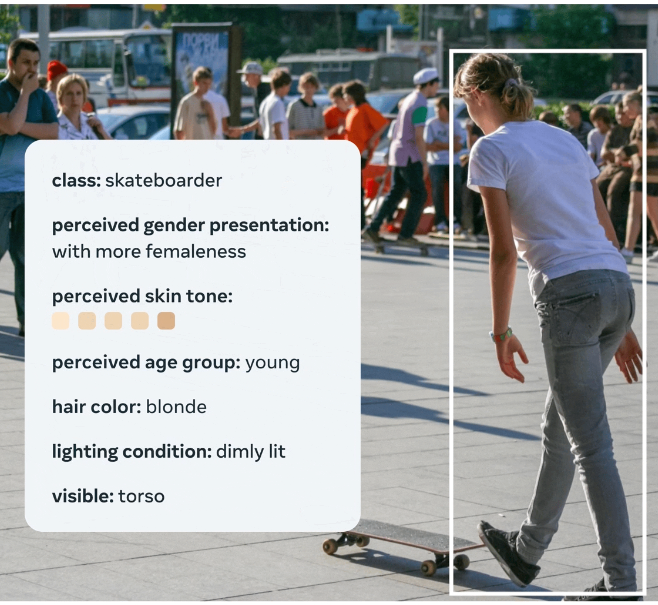
MetaAI在2023年8月31日开源了一个全新的图像数据集,FACET(FAirness in Computer Vision EvaluaTion),FACET数据集包含32,000张图片和50,000人,这些图片由专家进行了详细的标注,包括人口统计属性(如感知性别表达和感知年龄组)和其他物理属性(如感知肤色和发型)。这样的设计使得研究人员可以更全面、更深入地评估模型在不同人群中的表现,从而更准确地识别和解决模型的不公平性问题。
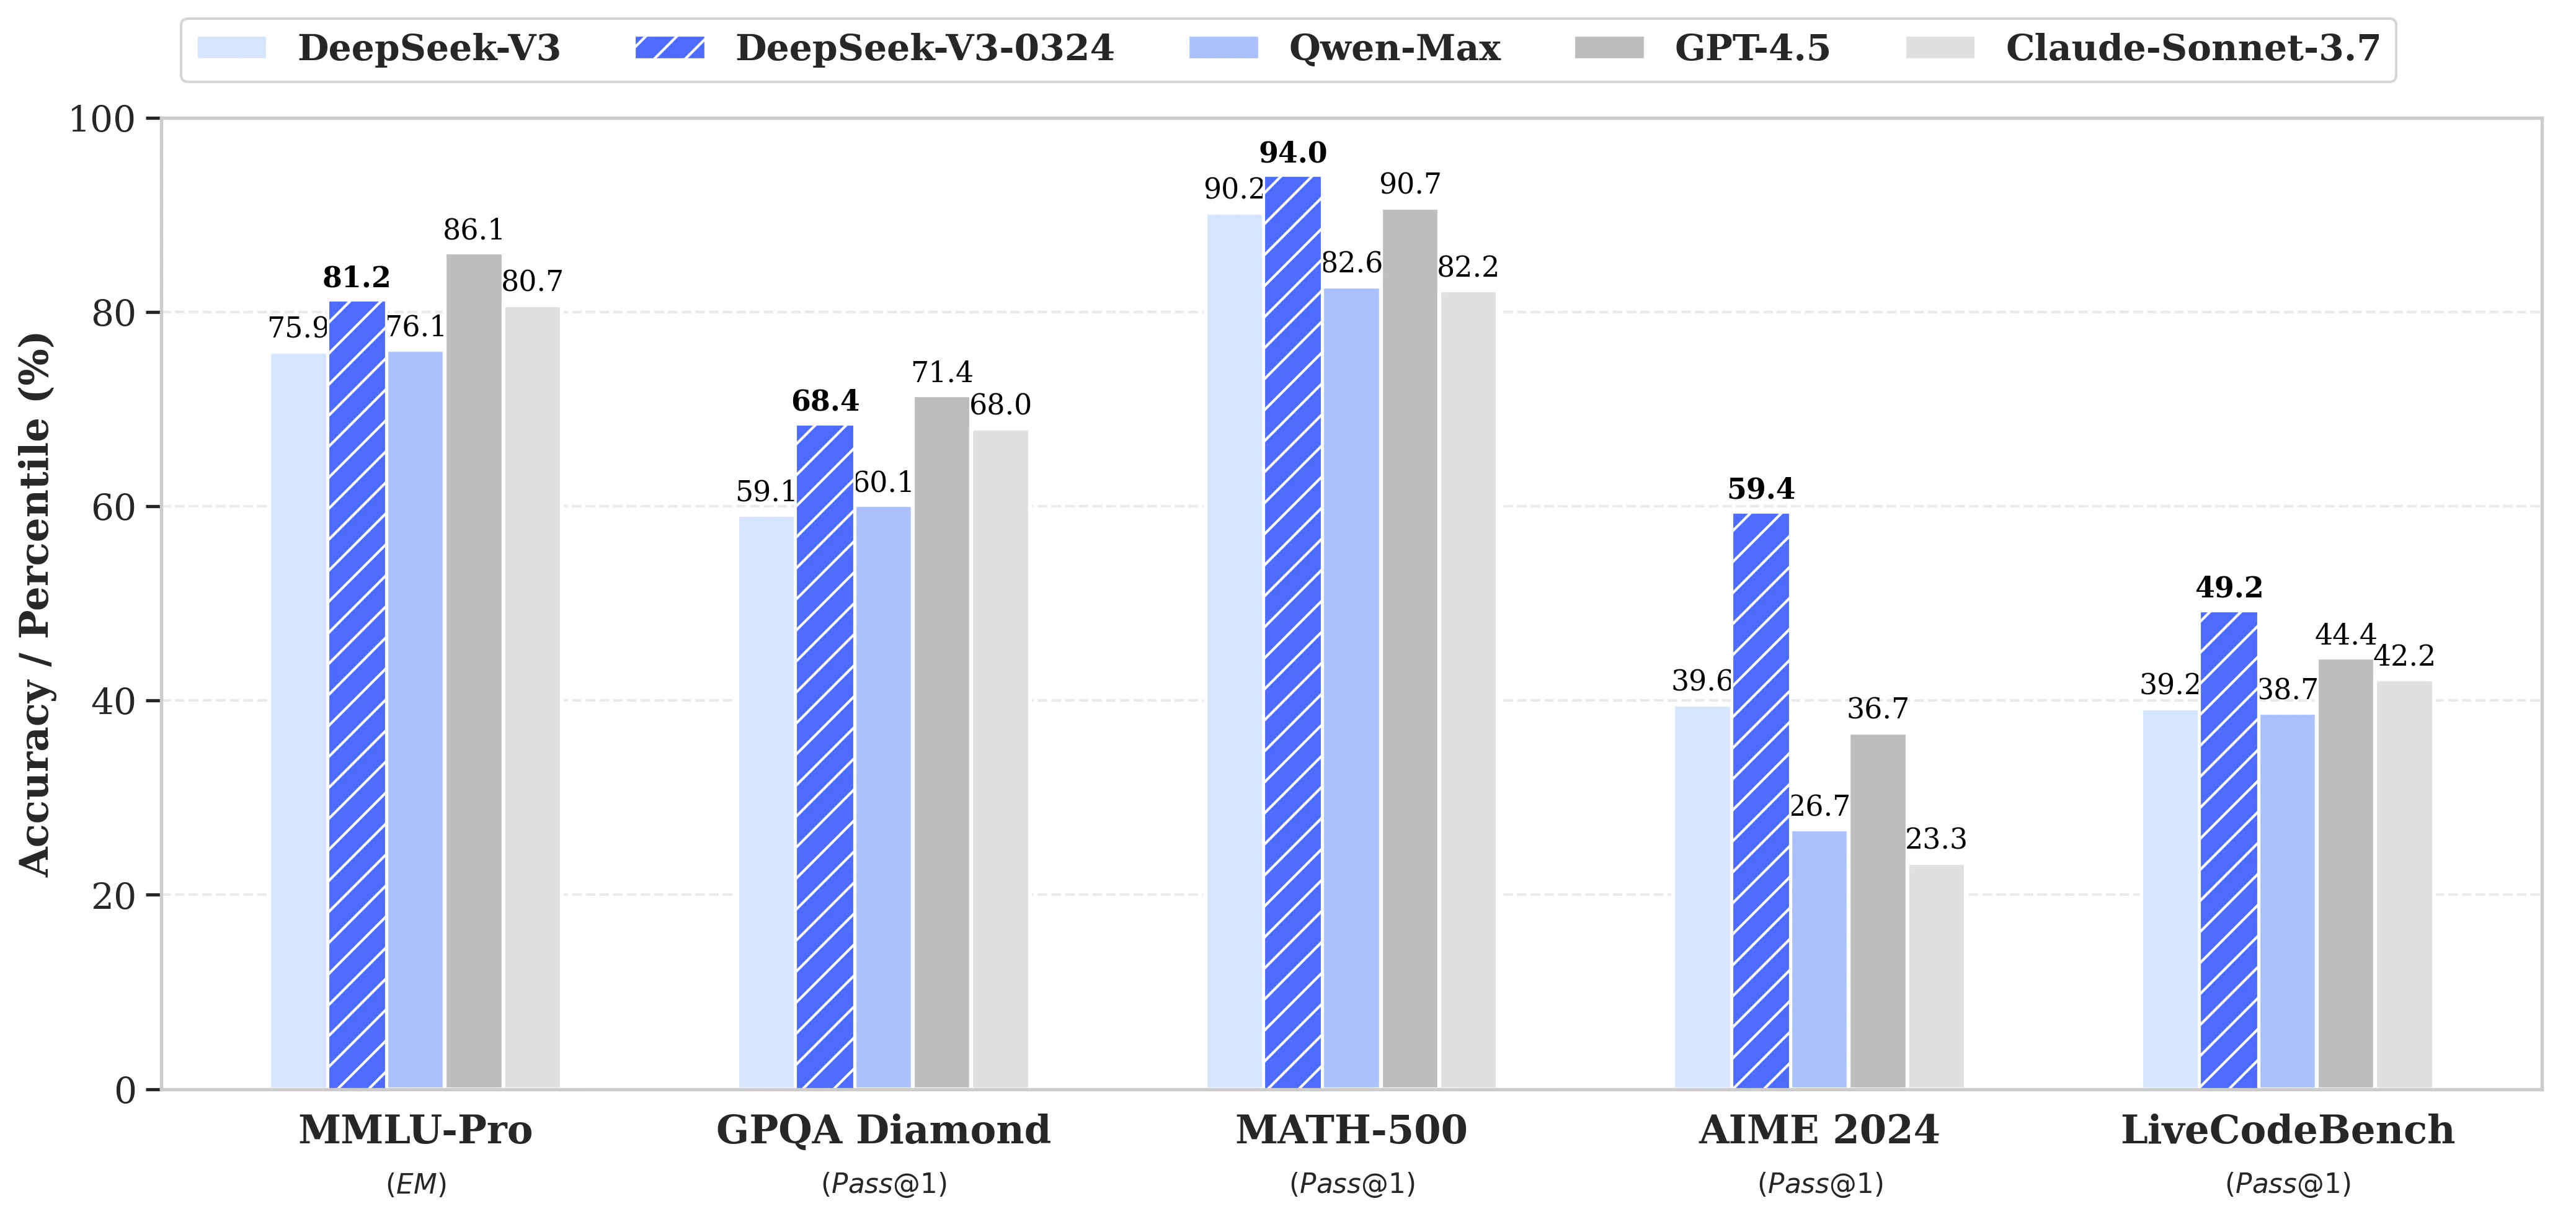
2025年3月25日,DeepSeekAI低调开源了DeepSeek-V3-0324大模型。作为DeepSeek-V3的重要升级版本,该模型在推理能力、中文写作、前端开发以及功能调用等多个关键领域实现了显著提升。在MMLU Pro等评测上,已经成为了非推理大模型中最强的模型,部分评测结果超过GPT-4.5模型。
今天,OpenAI在其官网上发布了一个全新的研究成果:一个利用较弱的模型来引导对齐更强模型的能力的技术,称为由弱到强的泛化。OpenAI认为,未来十年来将诞生超过人类的超级AI系统。但是,这会出现一个问题,即基于人类反馈的强化学习技术将终结。因为彼时,人类的水平不如AI系统,所以可能无法再对模型输出的内容评估好坏。为此,OpenAI提出这种超级对齐技术,希望可以用较弱的模型来对齐较强的模型。这样可以在出现比人类更强的AI系统之后可以继续让AI模型可以遵循人类的意志、偏好和价值观。
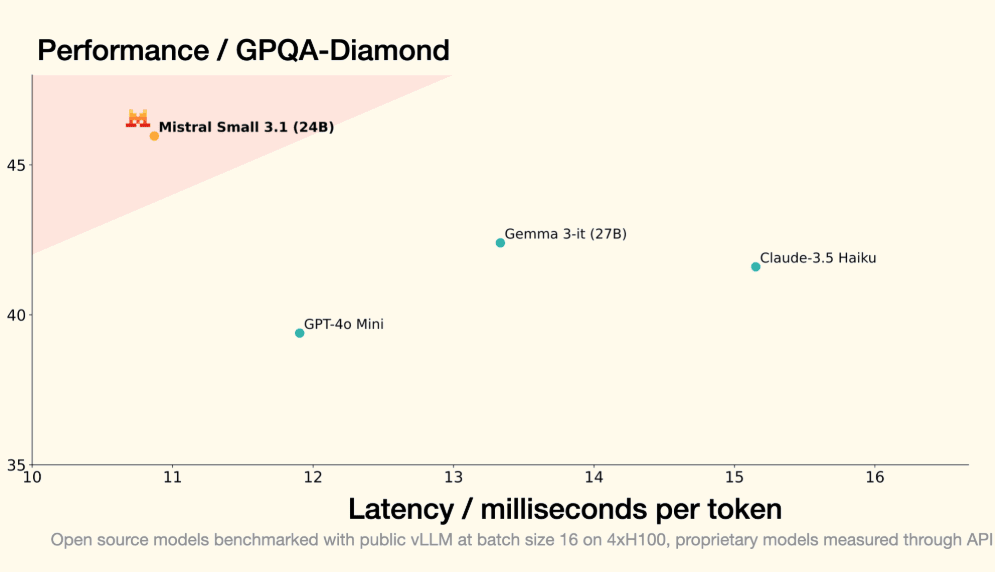
欧洲大模型之光MistralAI开源了2个全新的多模态大模型,即Mistral-Small-3.1-24B基座版本和指令微调版本。这两个大模型均以Apache2.0协议开源,因此可以完全免费商用。而官方也给出了这个模型在多个评测集上的效果,高于GPT-4o-mini和Gemma 3 27B。因为其参数规模较小,推理速度可以达到每秒150个tokens,同时支持多种语言,是一个非常值得关注的小而美的多模态大模型。
近日,OpenAI在发布其开源模型gpt-oss-120b和gpt-oss-20b的同时,也推出了一种专为这些模型设计的全新消息格式——Harmony。对于希望在自有解决方案中充分利用这些开源模型的开发者而言,理解Harmony至关重要。本文将以客观的第三方视角,详细解析Harmony格式的设计理念与技术细节。
就在刚才,谷歌推出了 Nano Banana Pro(Gemini 3 Pro Image)。这是基于 Gemini 3 Pro 打造的专业级图像生成与编辑模型,相比几个月前的 Nano Banana,这次升级几乎重构了谷歌图像生成能力的上限。从文本渲染、多图一致性,到世界知识、摄影级控制和信息可视化,Nano Banana Pro 在多个维度显著拉开了与上一代、乃至整个行业同类产品的差距。
MiniMaxAI于2025年6月17日正式发布了其新一代大模型——MiniMax-M1。MiniMax-M1的核心亮点在于结合了混合专家(MoE)架构和创新的闪电注意力(Lightning Attention)机制。MiniMax-M1不仅原生支持高达100万Token的上下文长度,推理的tokens也支持最高80K,是当前支持的最多推理长度的大模型。此外,MiniMax-M1在计算效率上也很高,例如在生成10万Token时,其FLOPs消耗仅为DeepSeek R1的25%!
OpenAI 刚刚把 GPT-5.2 推上来了。我们在 DataLearnerAI 上把它和 Claude Opus 4.5、Gemini 3.0 Pro(Preview) 放到同一个对比页里,拉齐公开评测与基础规格,做一个“站在真实选择角度”的快速判断。
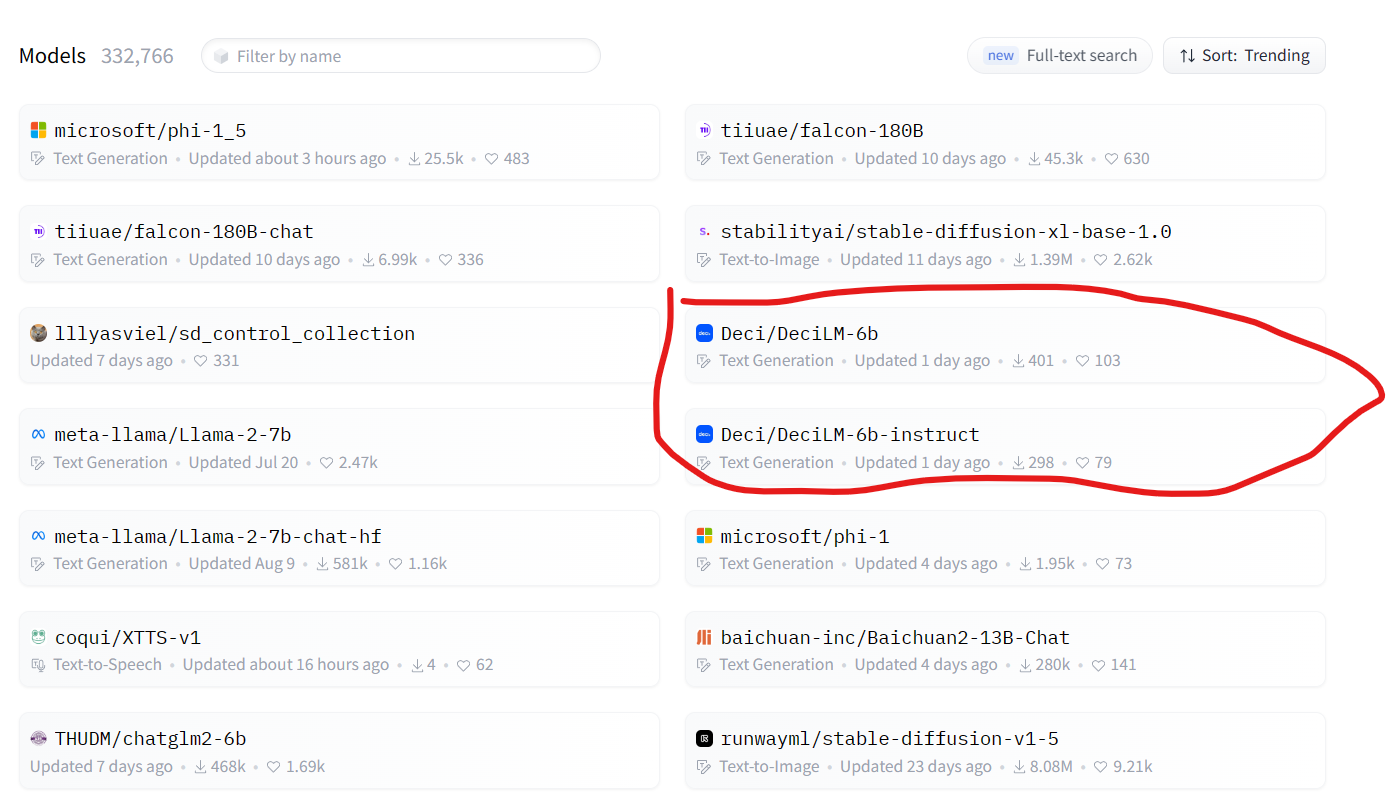
随着大型语言模型(LLMs)的不断发展,它们在训练和推理方面的计算需求已经呈指数级增长。这一趋势不仅带来了高昂的成本和能源消耗,还引入了模型部署和可伸缩性方面的障碍。为此,DeciLM开源了2个全新的DeciLM-6B和DeciLM-6B-Instruct大模型,参数比LLaMA2 7B略低,性能相当,但是推理速度却超过LLaMA2 7B的15倍。
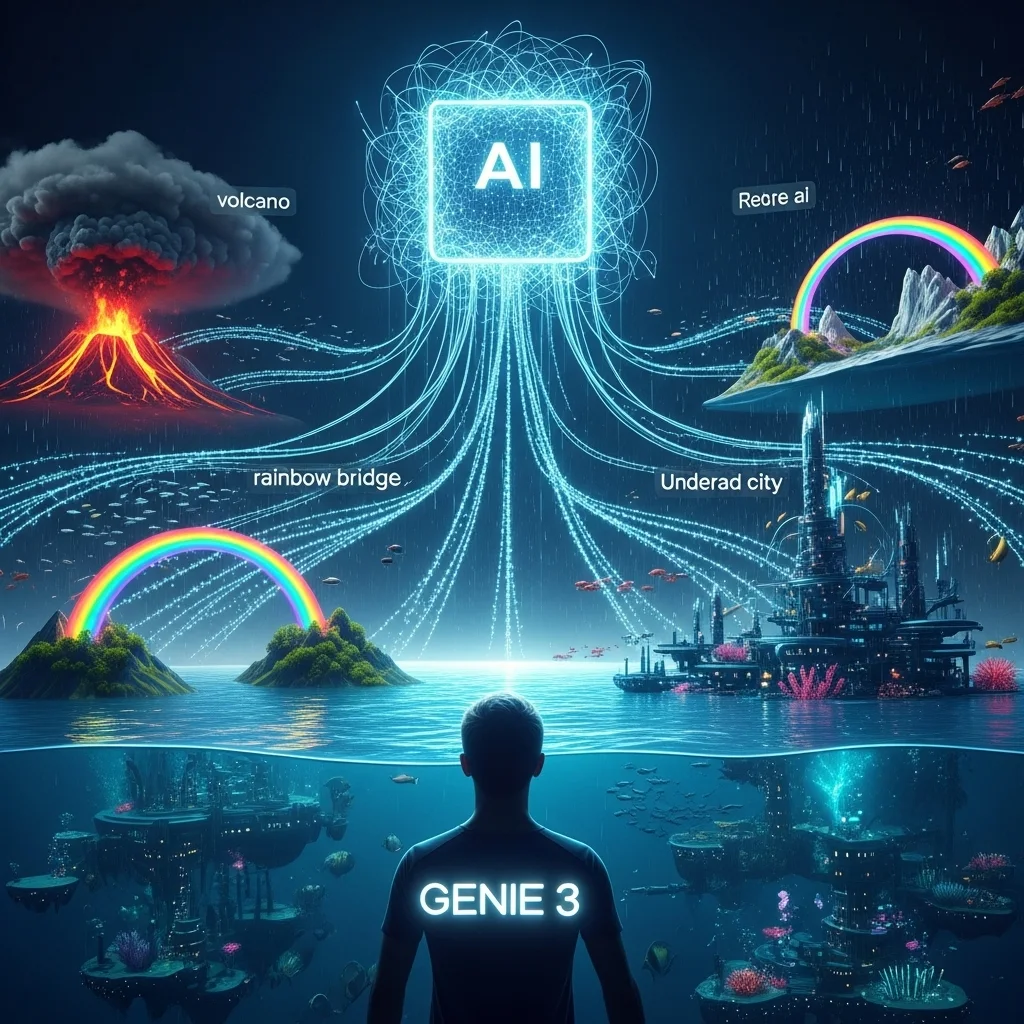
谷歌DeepMind发布了一个全新的大模型——Genie 3,这是一个能够根据文本描述生成多样化、可实时交互虚拟世界的通用世界模型。目前,Genie3可以生成几分钟的720P的视频,且每秒24帧左右。用户也可以在生成的视频中实时交互控制。从谷歌官方的视频看,这个Genie 3模型生成的视频和游戏世界的质量很高,非常令人心动!
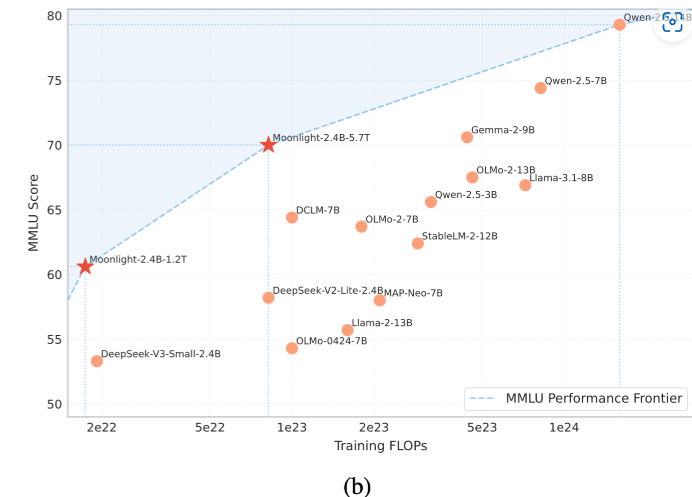
月之暗面(Moonshot AI)是此前中国大模型企业中非常受关注的一家企业。旗下的Kimi大模型和产品因为强悍的性能、超长的上下文以及非常快速的响应引起了广泛的关注。不过,此前MoonshotAI的策略一直是闭源模型,但是产品免费。也许是受到了DeepSeek的压力,月之暗面在2025年2月23日首次开源了旗下的一个小规模参数的大语言模型Moonlight-16B。
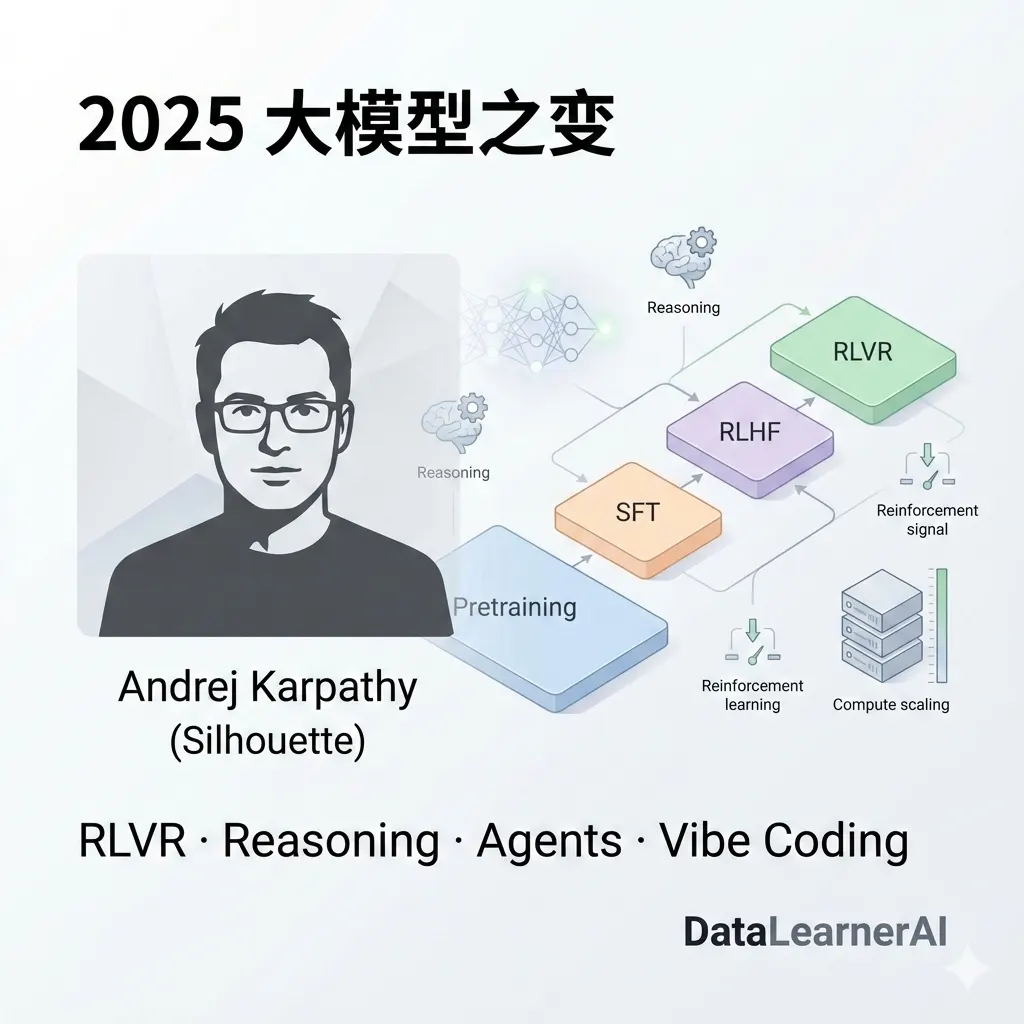
昨天,Karpathy 发布了《2025 LLM Year in Review》,对过去一年大模型领域发生的结构性变化进行了深度复盘。在这篇总结中,他不再纠结于具体的模型参数,而是将目光投向了推理范式的演进、Agent 的真实形态以及一种被称为“Vibe Coding”的新型开发模式。

Hugging Face一直在努力支持深度学习,但是,这只是深度学习的一部分。传统统计机器学习领域里面最重要的工具Scikit-learn如今终于和深度学习的开源标杆工具Hugging Face联手。
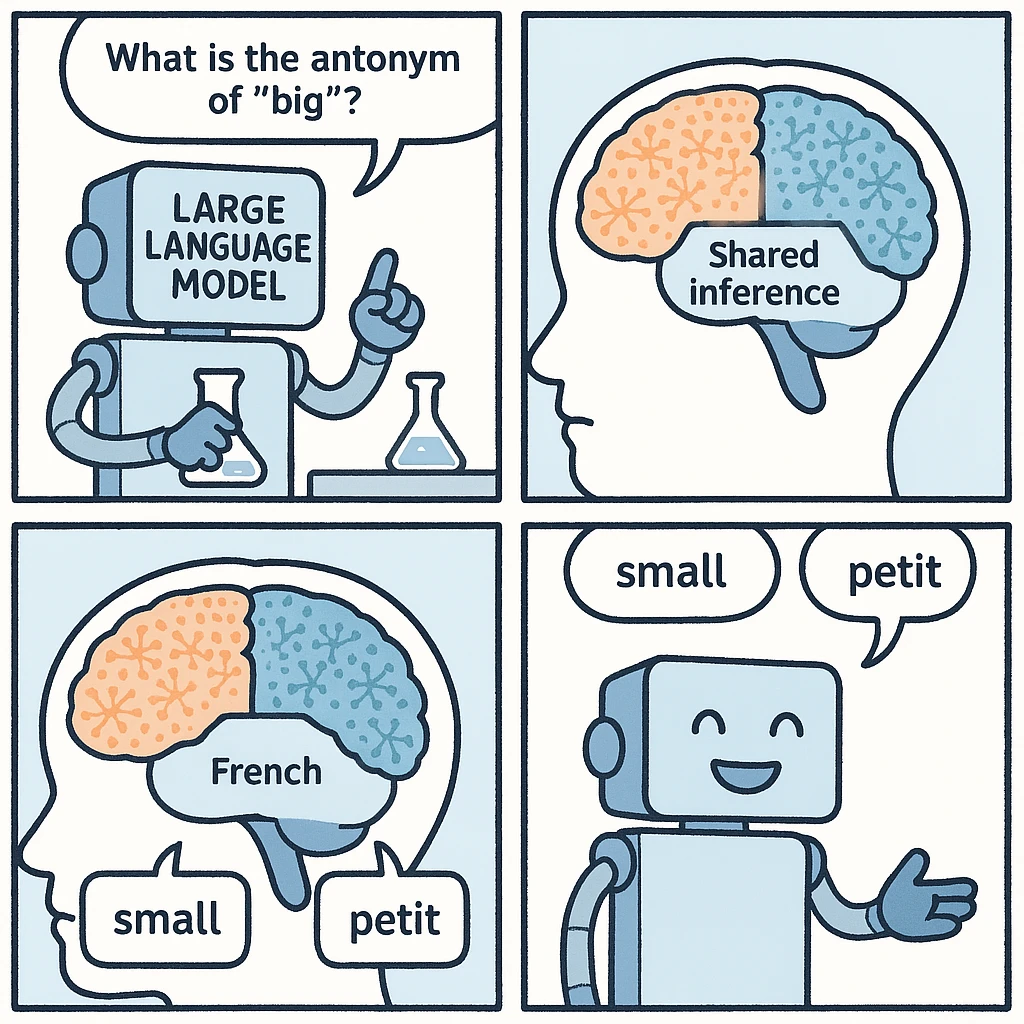
最近,Anthropic研究人员通过观察大模型内部运作机制发现了大模型内部可能存在一种与特定语言无关的内部共享区域,它可以把不同语种的输入,在同样的区域进行内部推理,并最终根据语种输出答案。这个现象让我们发现大模型本身理解语言的时候可能与人类类似,拥有高度抽象的内部表示,能够跨越多种语言统一相同的概念。
OpenAI发布了ChatGPT的企业版,这是一个专为企业设计的聊天机器人。这个版本不仅提供了企业级的安全和隐私保护,还具有更高的处理速度和更多的自定义选项。相比较个人版的ChatGPT,企业版主要是提升了性能、强调了安全等。
腾讯发布并开源了其混元大模型系列的新成员Hunyuan-A13B。该模型定位为一个基于细粒度专家混合(MoE)架构的大语言模型。其主要特点是高效率和可扩展性,旨在为开发者和研究人员,特别是在资源受限的环境中,提供高级推理和通用应用能力。Hunyuan-A13B是由原来的微软的WizardLM团队成员打造,评测结果超Qwen2.5-72B和Qwen3-A22B
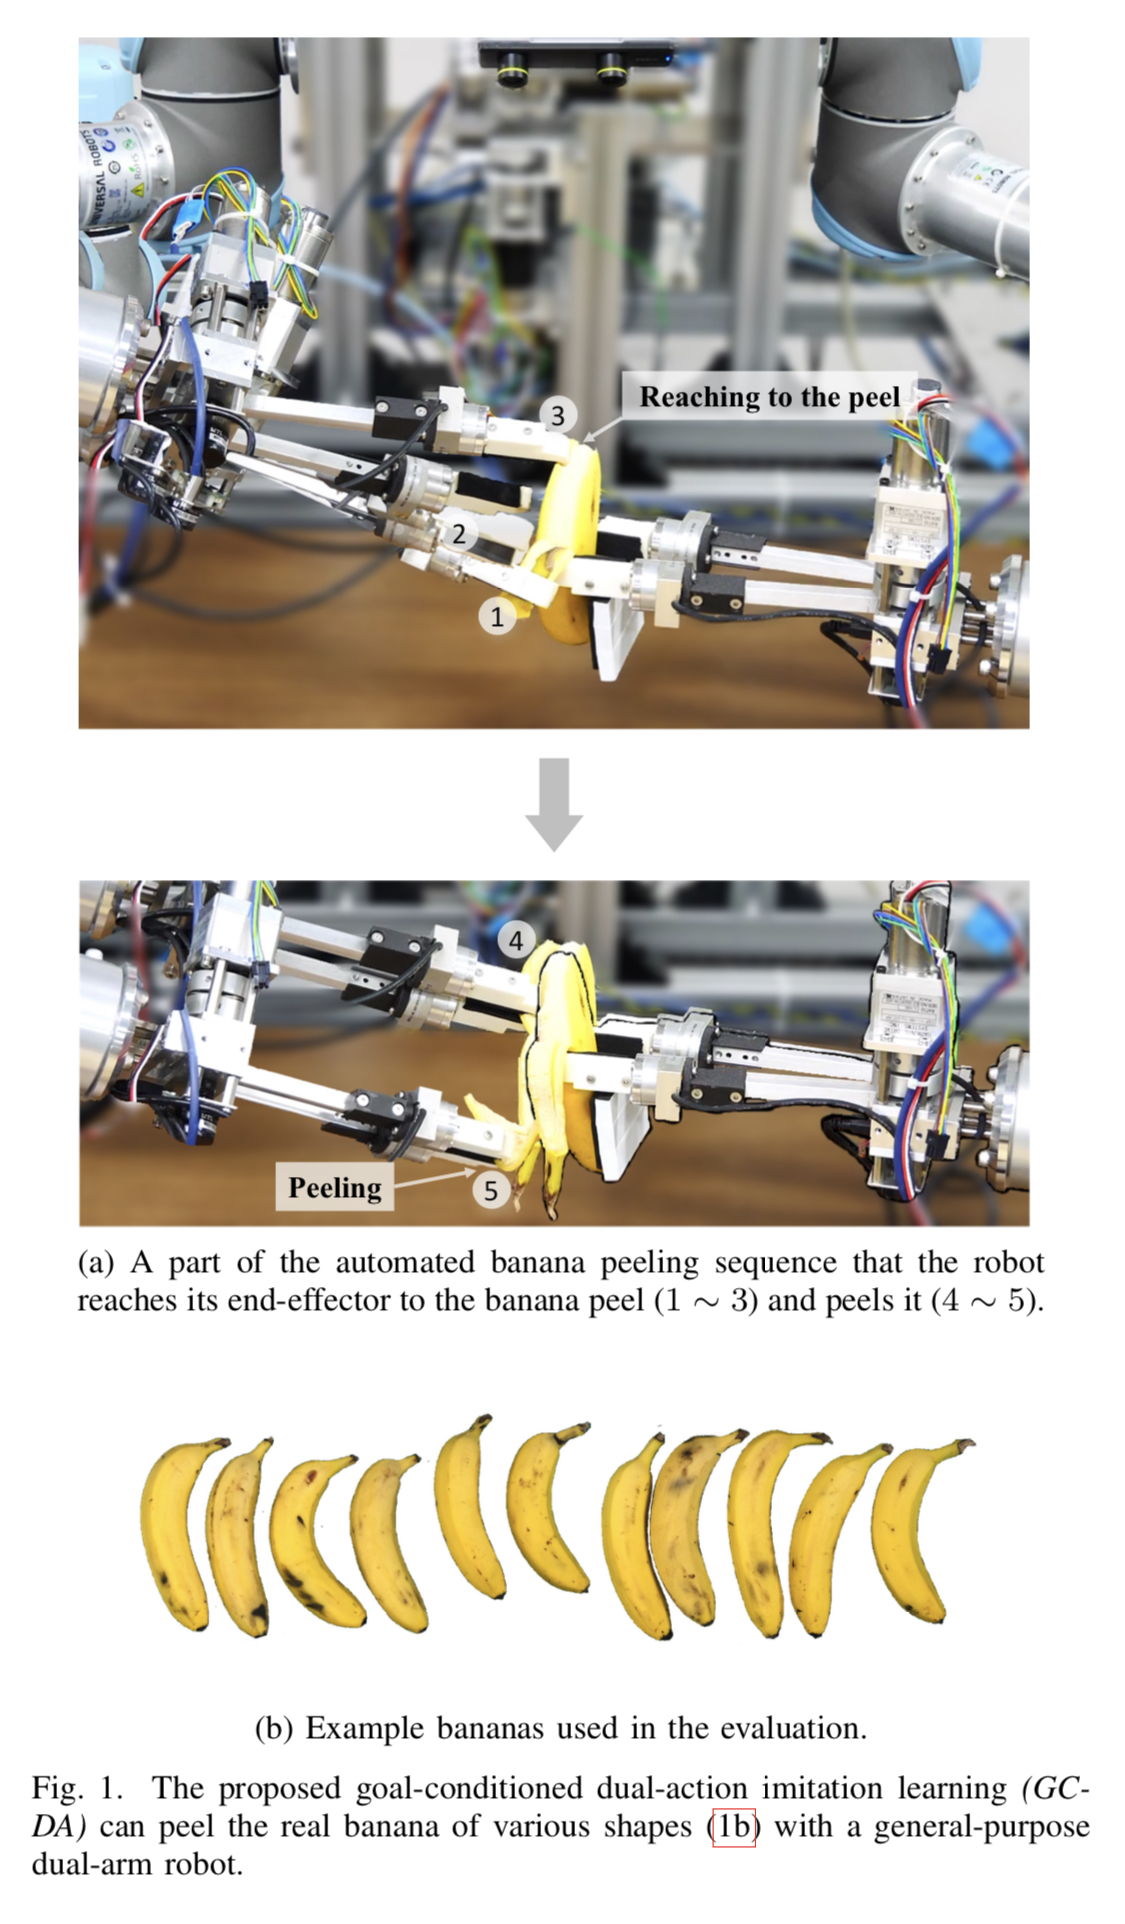
仅仅使用来自人类数据集的机器学习,在短短9个小时内,日本研究人员让一个机器人学会了如何拿起和剥开香蕉。