

彭博社发布金融领域的ChatGPT模型——BloombergGPT
彭博社今天发布了一份研究论文,详细介绍了BloombergGPT的开发,这是一个新的大规模生成式人工智能(AI)模型。这个大型语言模型(LLM)经过专门的金融数据训练,支持金融业内的多种自然语言处理(NLP)任务。
探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。
彭博社今天发布了一份研究论文,详细介绍了BloombergGPT的开发,这是一个新的大规模生成式人工智能(AI)模型。这个大型语言模型(LLM)经过专门的金融数据训练,支持金融业内的多种自然语言处理(NLP)任务。
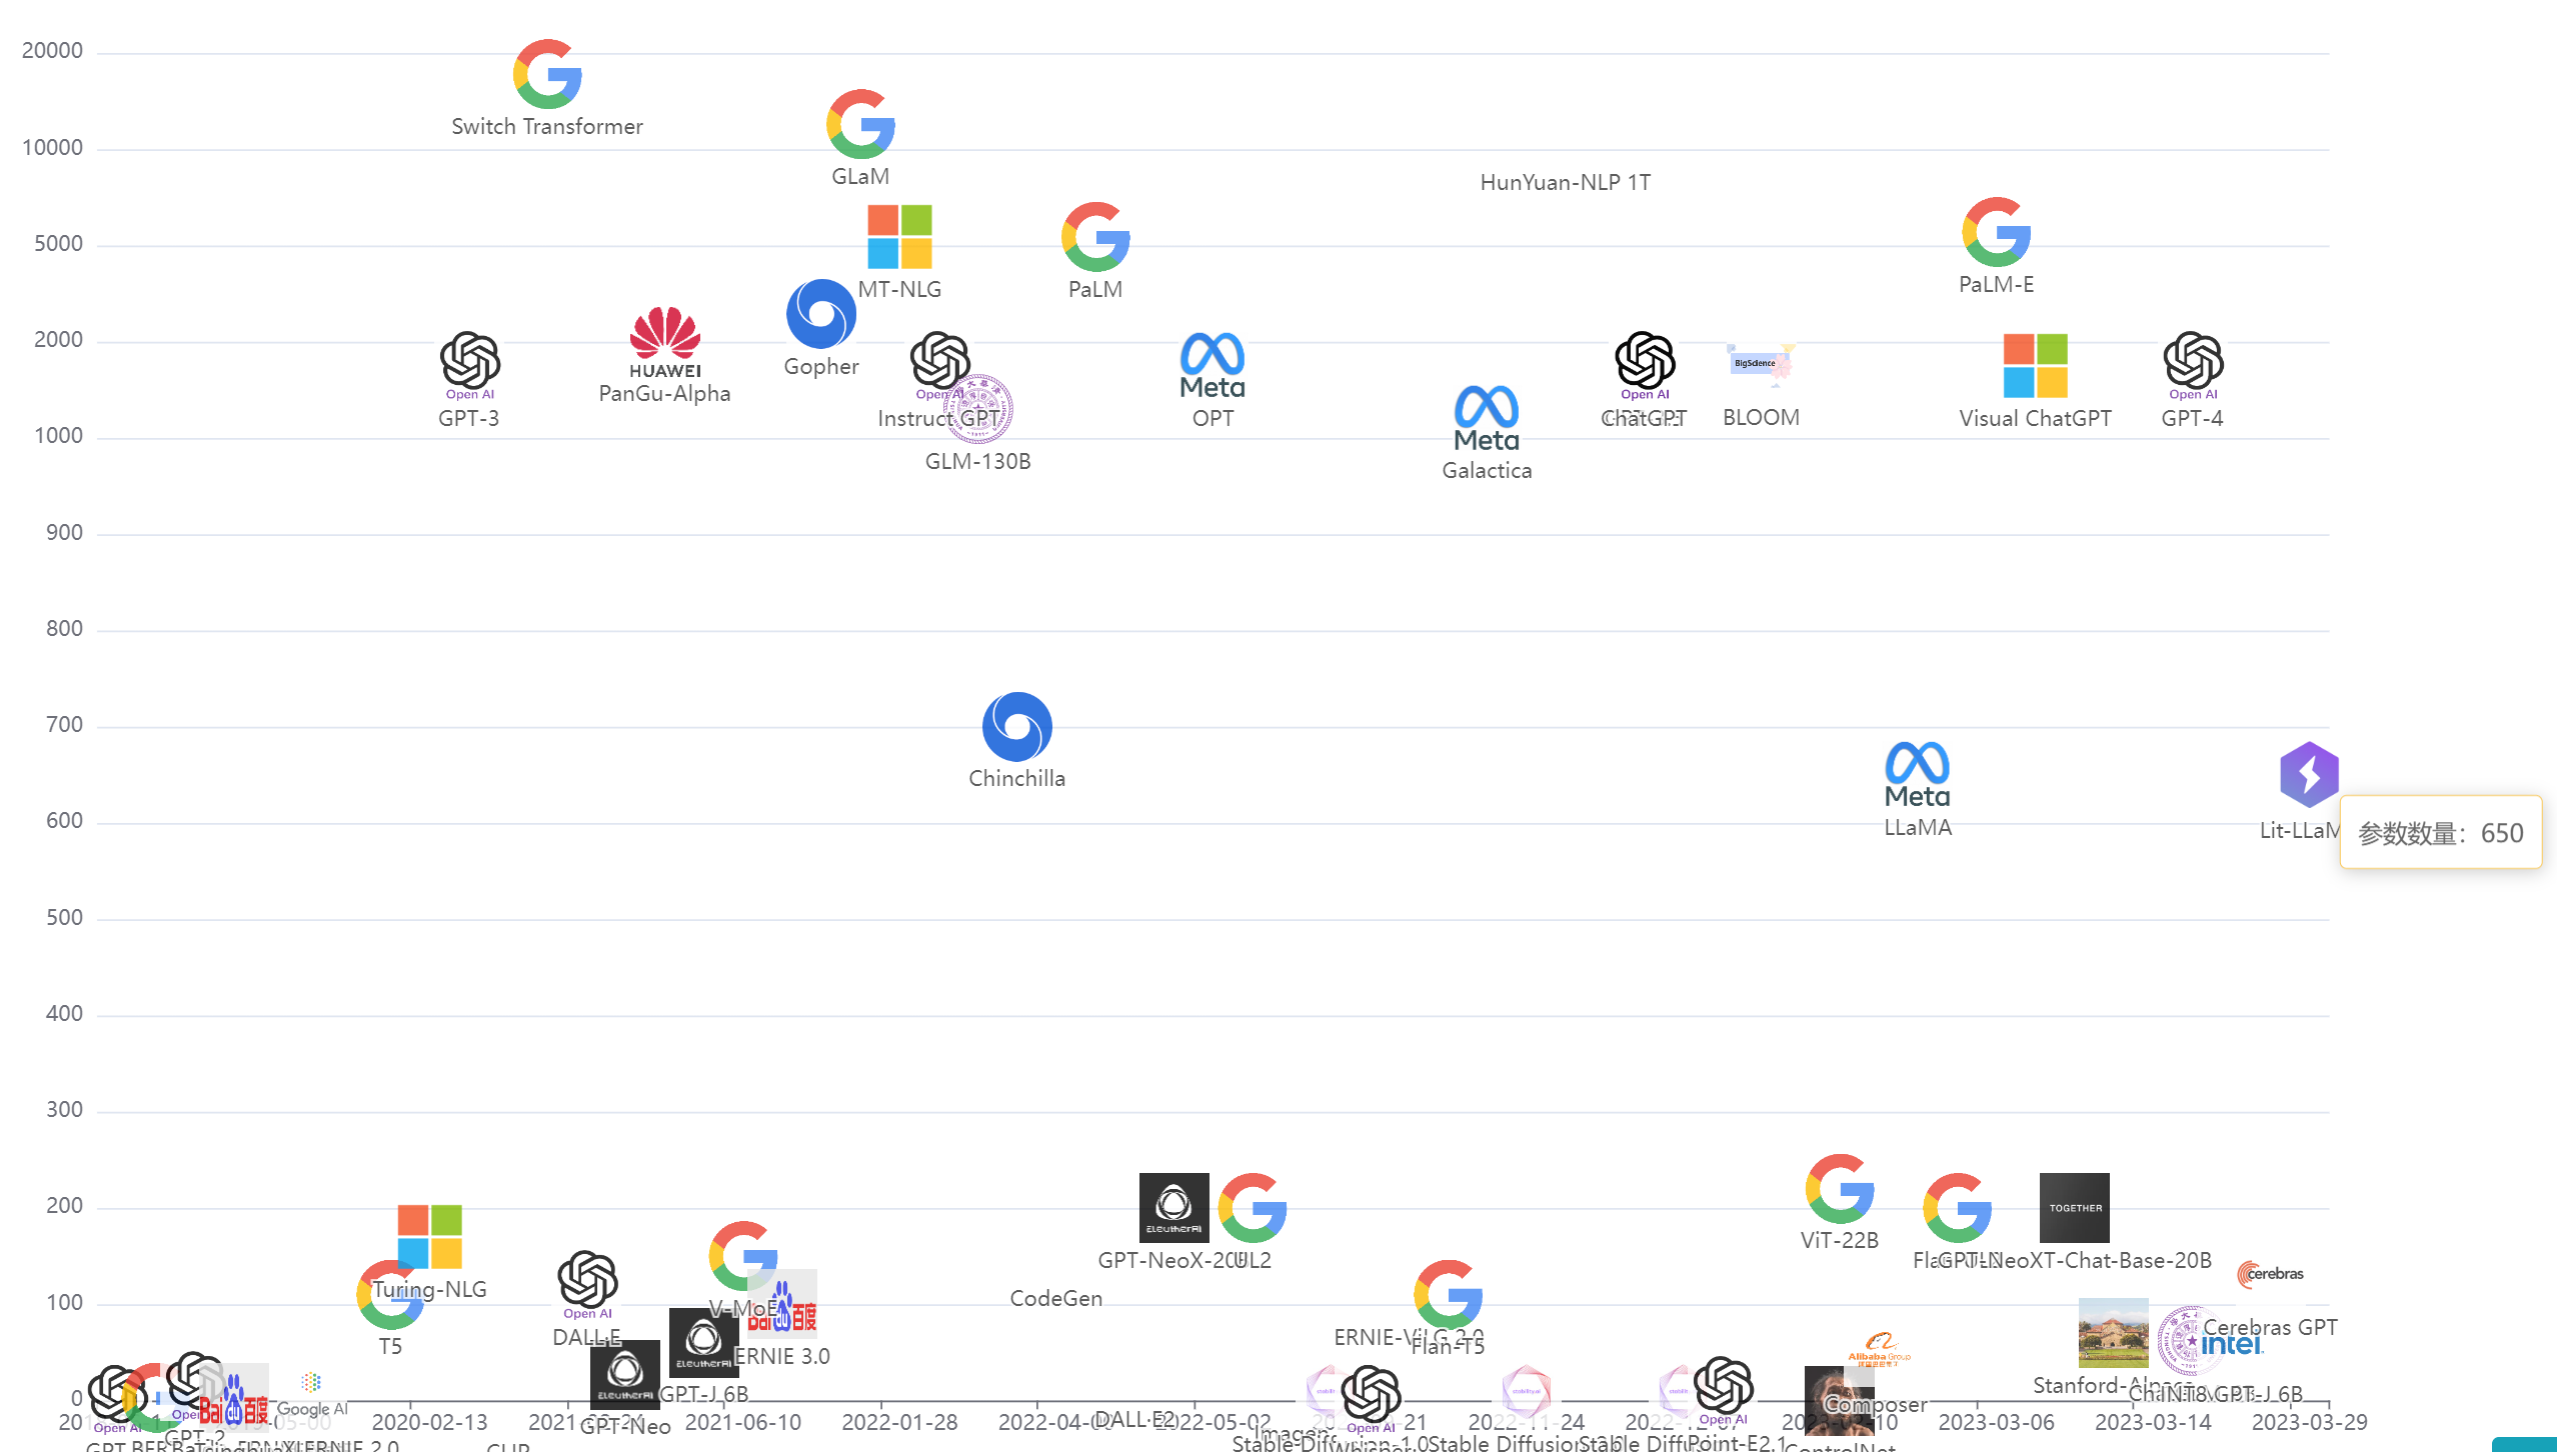
斯坦福大学发布的基础大模型追踪图谱Ecosystem Graphs,用图谱的方式给大家呈现了模型之间的联系,让人非常清楚明白追踪不同模型之间的关系。
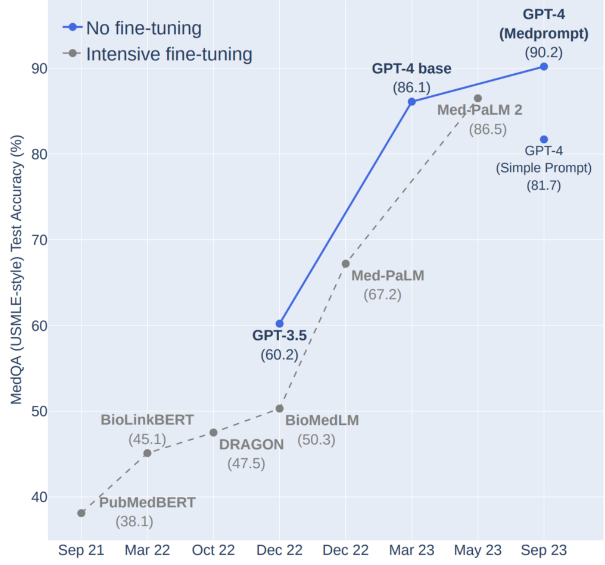
在GPT-4这种超大基座模型发布之后,一个非常活跃的方向是专有模型的发展。即一个普遍的观点认为,基座大模型虽然有很好的通用基础知识,但是对于专有的领域如医学、金融领域等,缺少专门的语料训练,因此可能表现并不那么好。如果我们使用专有数据训练一个领域大模型可能是一种非常好的思路,也是一种非常理想的商业策略。但是,微软最新的一个研究表明,通用基座大模型如果使用恰当的prompt,也许并不比专有模型差!同时,他们还提出了一个非常新颖的动态prompt生成策略,结合了领域数据,非常值得大家参考。
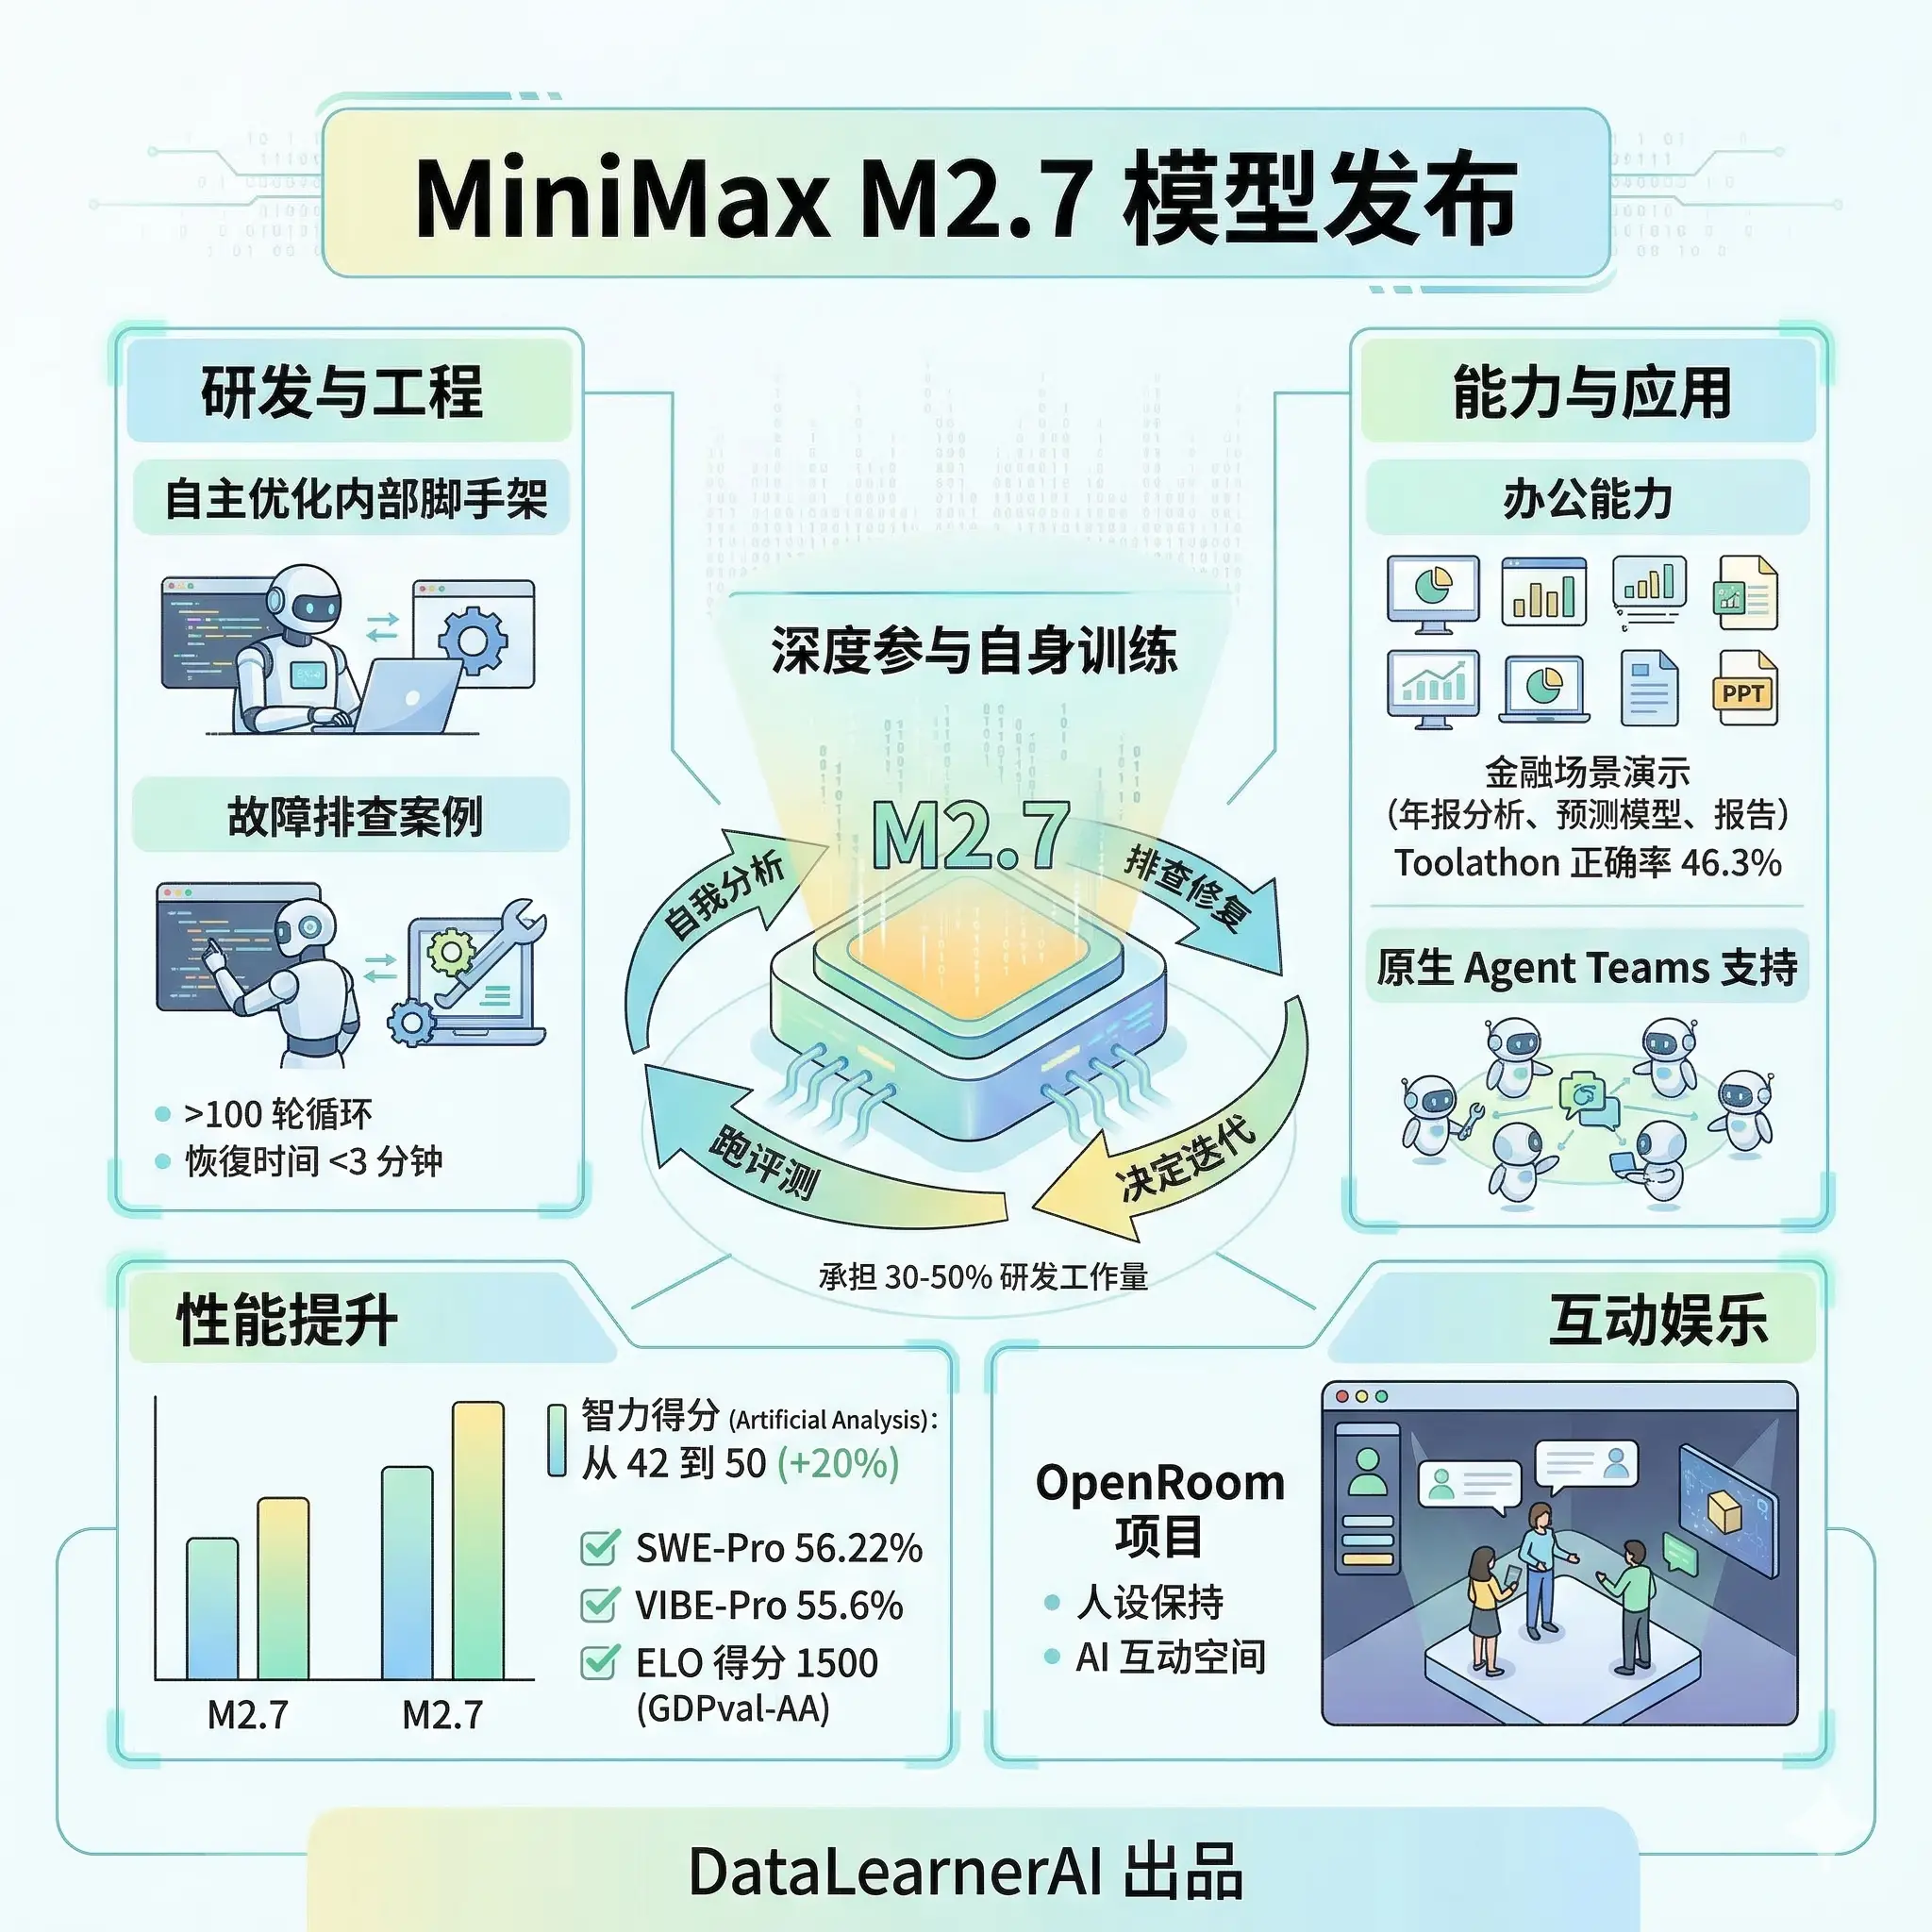
MiniMaxAI 刚刚发布了全新的 M2.7 模型,官方说本次发布的 M2.7 最大的特点是第一个深度参与迭代自身训练流程的模型,也就是说模型在训练过程中进行了自我分析并参与迭代。目前 M2.7 已经可以在官网使用,接口价格不变。不过该模型当前并未宣布开源,还不确定未来情况。
在人工智能快速发展的今天,创新型模型如Mixtral 8x7B的出现,不仅推动了技术的进步,还为未来的AI应用开辟了新的可能性。这款基于Sparse Mixture of Experts(SMoE)架构的模型,不仅在技术层面上实现了创新,还在实际应用中展示了卓越的性能。尽管一个月前这个模型就发布,但是MistralAI今天才上传了这个模型的论文,我们可以看到更详细的信息。
今天,Google为全球开发者社区带来了一款激动人心的新工具——**Gemini CLI**。这是一款免费、开源的AI智能体,它将Google当前最强大的模型Gemini 2.5 Pro的能力,直接集成到了开发者最熟悉的命令行界面(CLI)中。对于那些视终端为“家”的开发者来说,这无疑是一个重大的升级。它不仅擅长编码,更是一个可以处理内容生成、问题解决、深度研究和任务管理的多功能本地实用工具。它的发布,旨在为个人开发者提供前所未有的便捷AI体验,非常强大!

Context Arena 是一个专注于评估大语言模型长上下文处理能力的基准平台。它基于 OpenAI 发布的 Multi-Round Coreference Resolution (MRCR) 数据集,提供交互式排行榜,用于比较不同模型在复杂长对话中的信息检索和理解性能。该基准强调模型在长上下文下的实际表现,避免单纯依赖训练数据记忆。
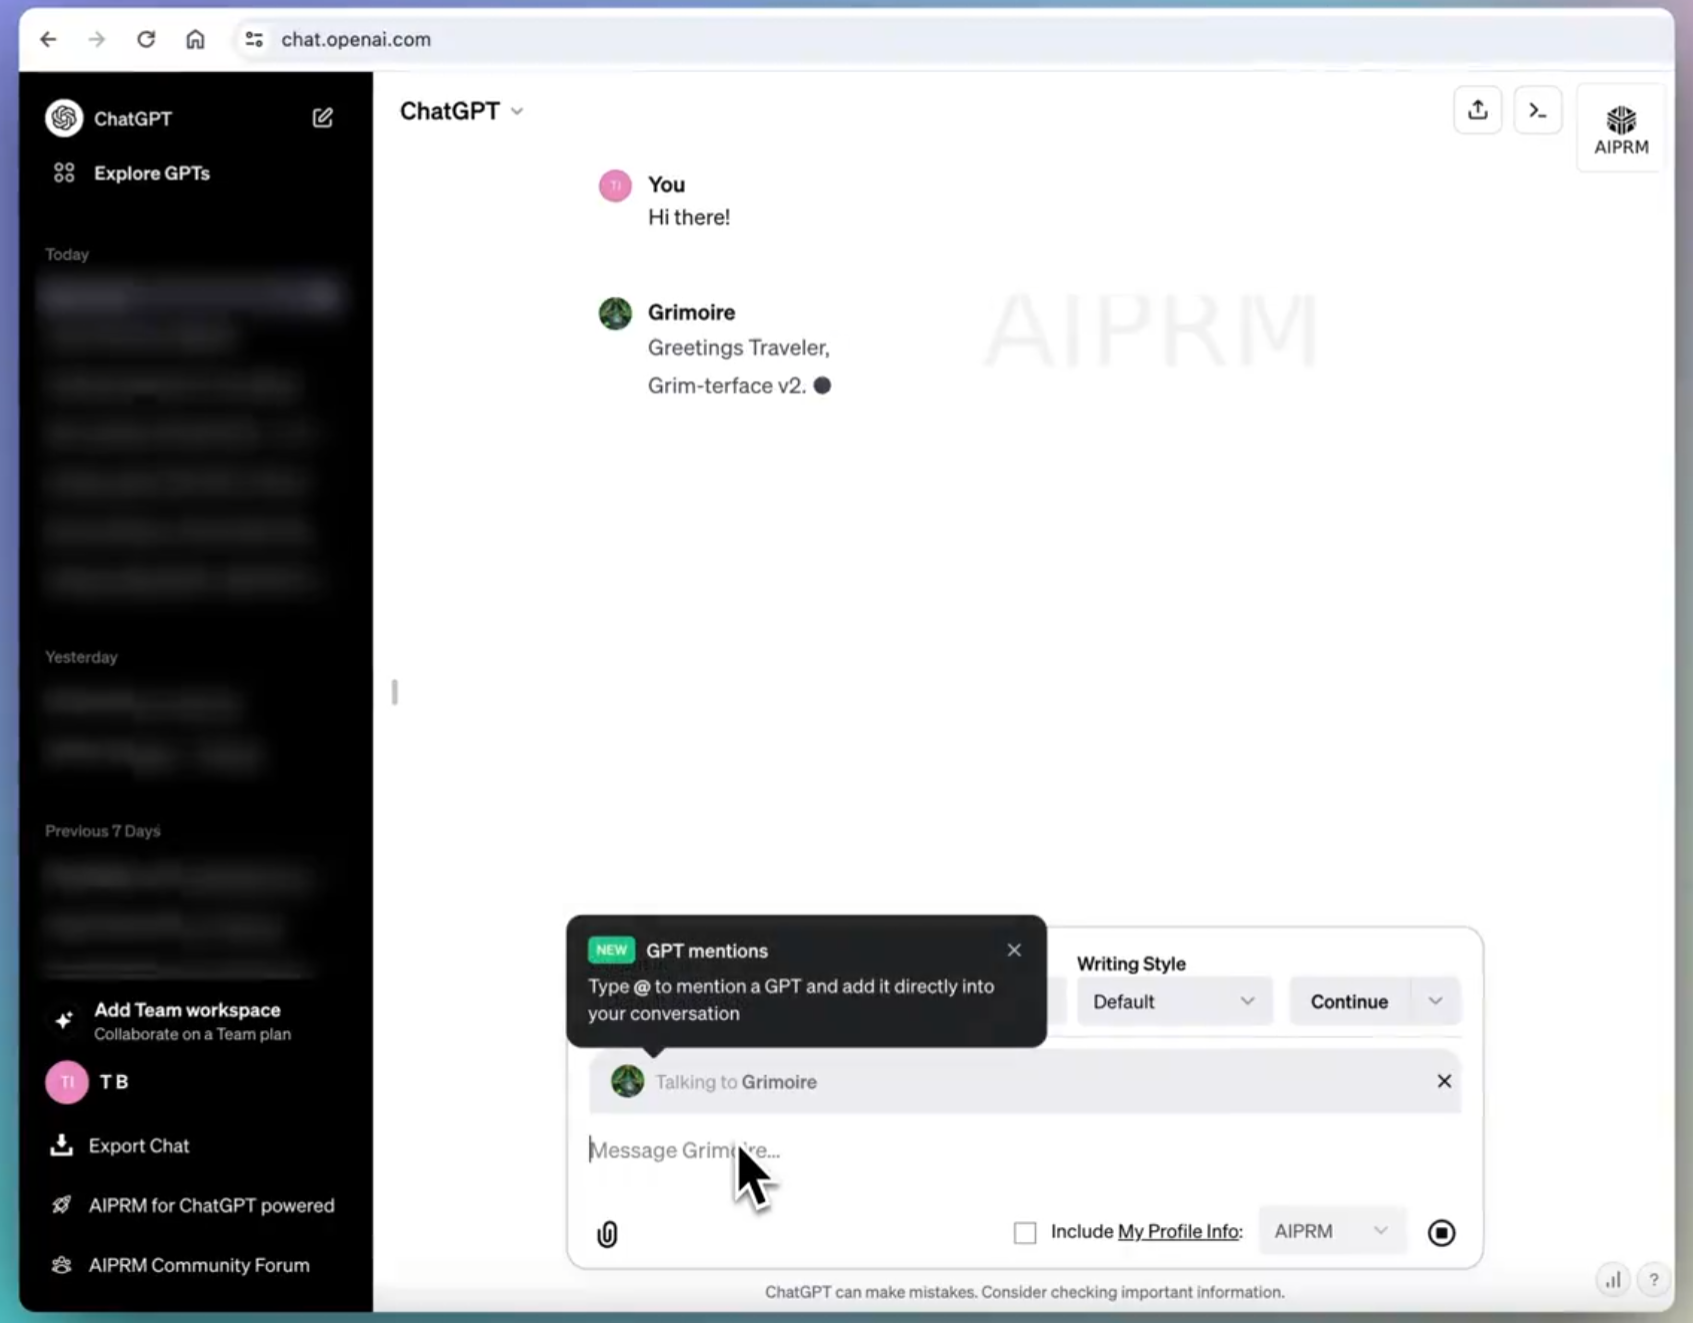
在最新的ChatGPT的前端代码中,有网友发现了一个OpenAI隐藏的或者正在测试的功能,即在ChatGPT的对话中可以@ 任意GPTs商店中公开的GPTs,然后由这个GPTs为用户当前的对话进行回复,这个功能不需要用户离开当前对话页面。这意味着在一次对话中,我们可以与几百万个不同的GPTs同时协作聊天,就像一个巨大的聊天群,里面有无数个各种各样的GPT一起为你解决问题。
上周,MoonshotAI 发布了 Kimi K2,并宣布 完全开源、允许商用。发布 24 小时内,社区即完成了 MLX 移植、4-bit 量化等后续工作。外网很多人评价说,Kimi K2是另一个DeepSeek R1时刻。本文尝试以第三方视角,把Kimi开发者公开的技术讨论、社区疑问与公开配置里的数字串成一条完整的技术决策链,解释Kimi K2背后的技术决策以及他们眼中大模型创业企业的方向。
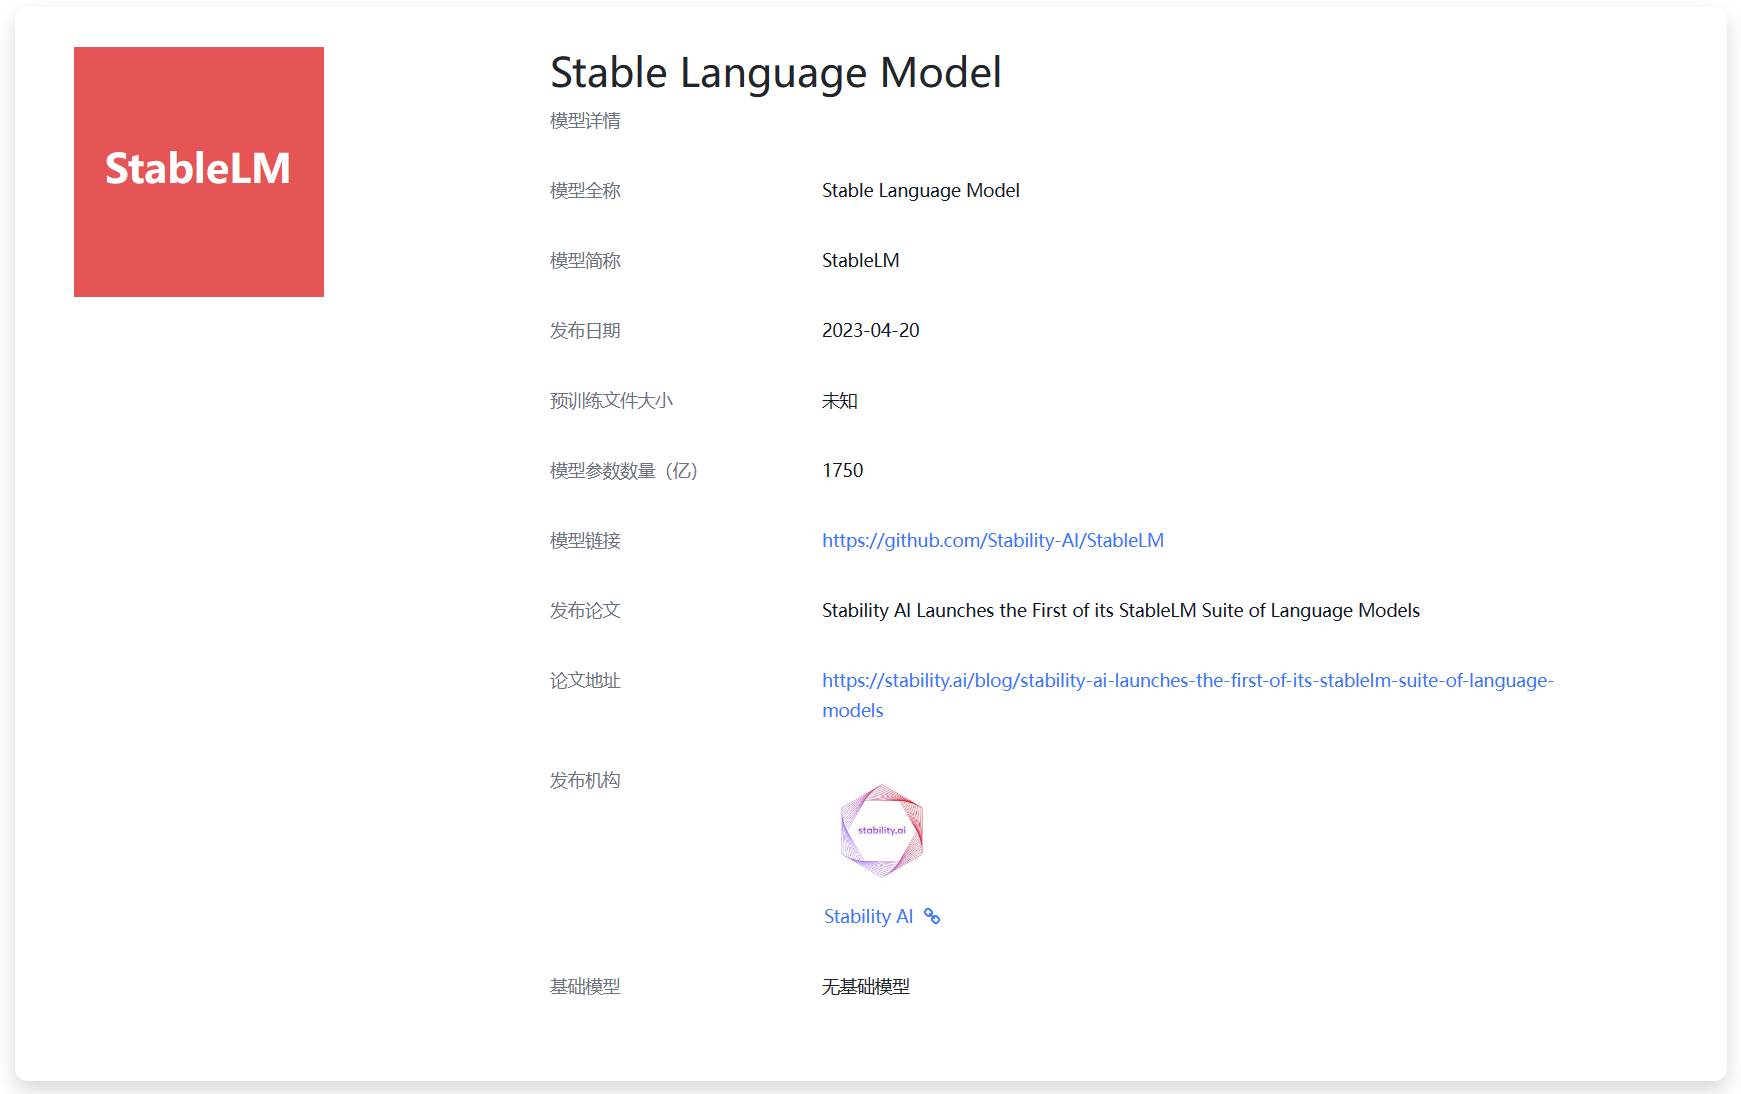
今天,Stability宣布开源StableLM计划,这是一个正在开发过程的大语言模型,但是它是开源可商用的模型。本文将对该模型做简单的介绍!
AI Agent 的一个关键趋势正在浮现:从“快速回答问题”转向“长时间稳定执行复杂任务”。本文系统梳理了为什么 Anthropic、OpenAI 等企业开始强调“长时运行 Agent”,并解释其真实含义并非模型一直思考,而是通过作业化、异步执行、可恢复运行和动态上下文管理,实现跨会话完成复杂目标。文章深入对比了长时 Agent 与传统脚本化 LLM Loop 的本质差异,分析其在自治能力、上下文工程、耐久执行与治理上的核心价值,并总结构建长时运行 AI Agent 所需的关键技术等。
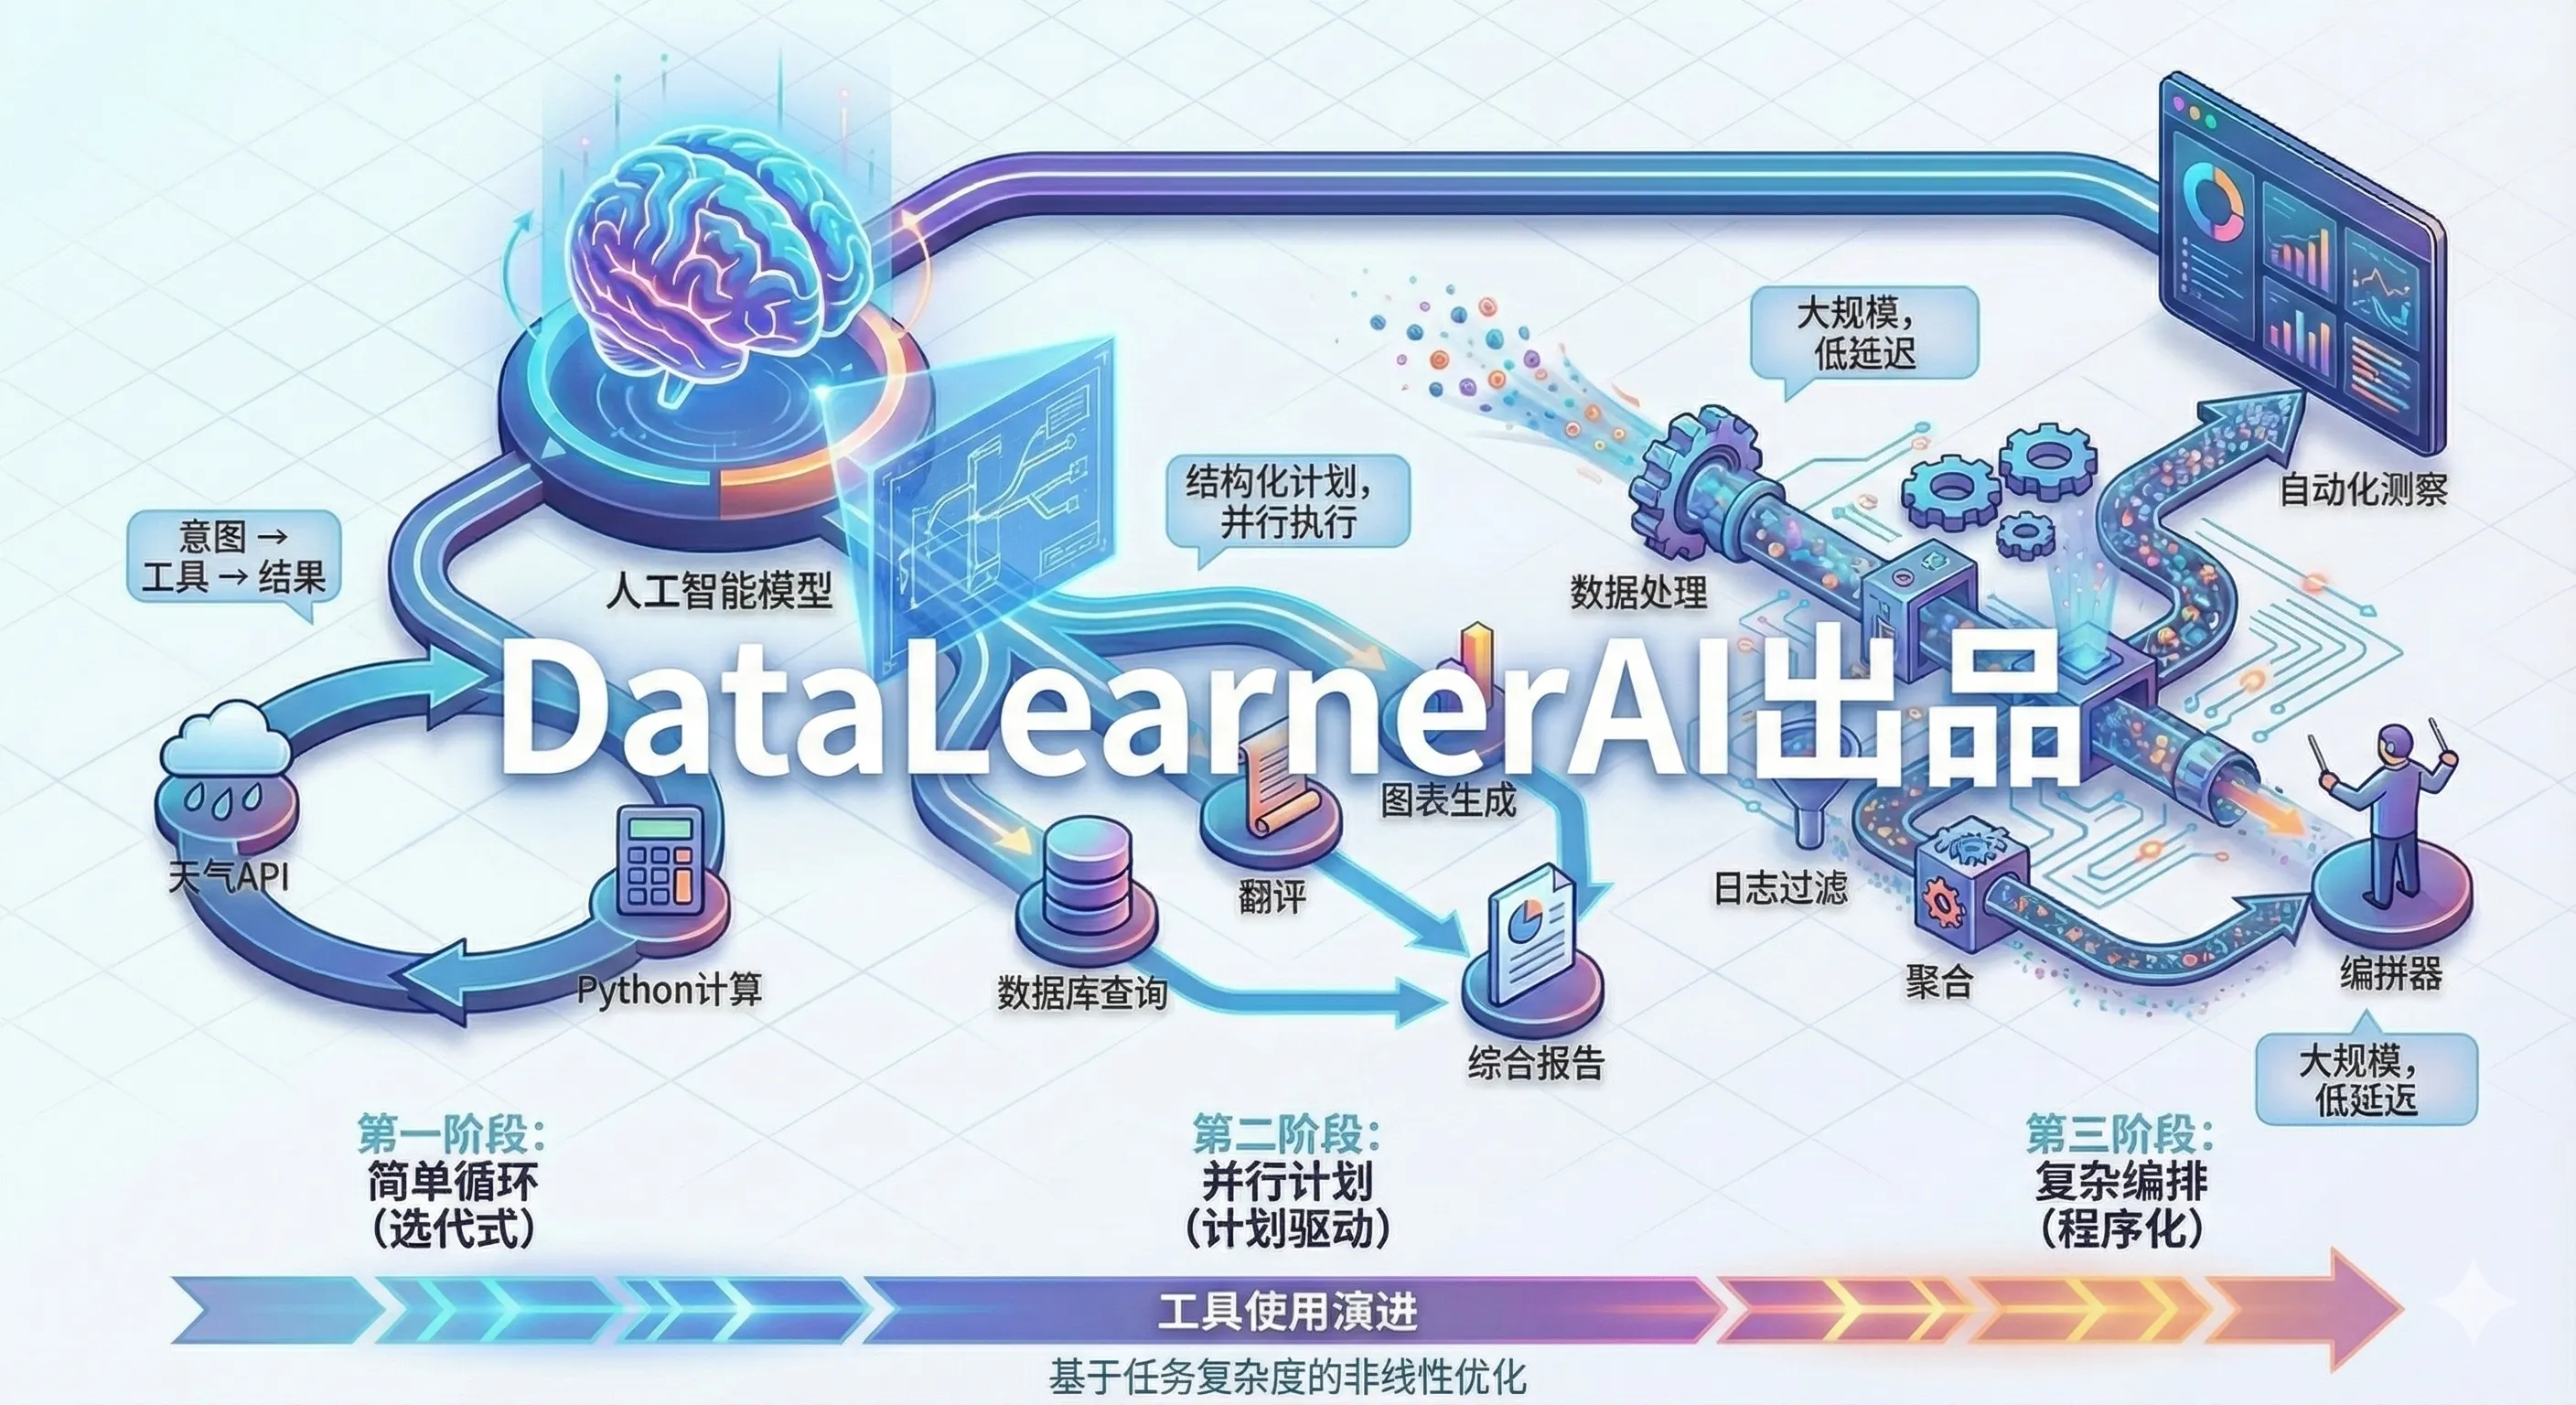
本文系统梳理了大模型工具使用(Tool Use)的三个演进阶段:循环式工具选择(Function Calling)、计划驱动执行(Plan-then-Execute)和程序化工具编排(Programmatic Tool Calling)。从 OpenAI Function Calling 的单次调用模式,到支持并行调度的计划-执行范式,再到最新的代码驱动编排方式,工具使用正在从"逐步决策"走向"计划驱动、代码驱动"。
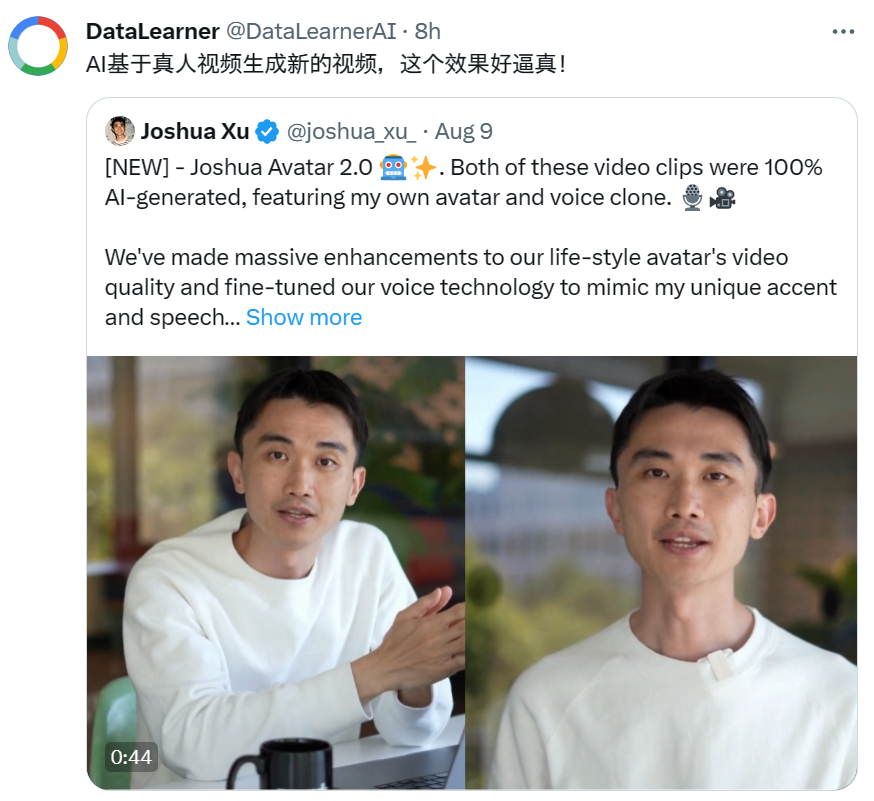
电影《流浪地球2》里面一个非常重要的情节就是数字生命计划。将人类的意识上传到计算机之后,可以通过AI技术让人类以数字化的形式在计算机中存活。而今天HeyGen官方宣布的即将推出的真人视频生成技术,可以根据真人的照片生成非常逼真的数字人视频,其动作、表情、声音等全部由AI技术生成,而几乎无法分辨是真人拍摄的视频还是AI生成的视频。
Whisper是由Open AI训练并开源的语音识别模型,它在英语语音识别方面接近人类水平的鲁棒性和准确性。该模型于2022年9月21日发布之后引起了广大的关注。由于模型的准确性太过惊人,大家已经认为可以直接用于视频的配音制作了。而今天有人发现Whisper的GitHub上有了一个新的提交记录,显示Whisper V2版本即将来临。
Phi系列大语言模型是微软开源一个小规模参数的语言模型。第一代和第二代的Phi模型参数规模都不超过30亿,但是在多个评测结果上都取得了非常亮眼的成绩。今天,微软发布了第三代Phi系列大模型,最高参数规模也到了140亿,其中最小的模型参数38亿,评测结果接近GPT-3.5的水平。
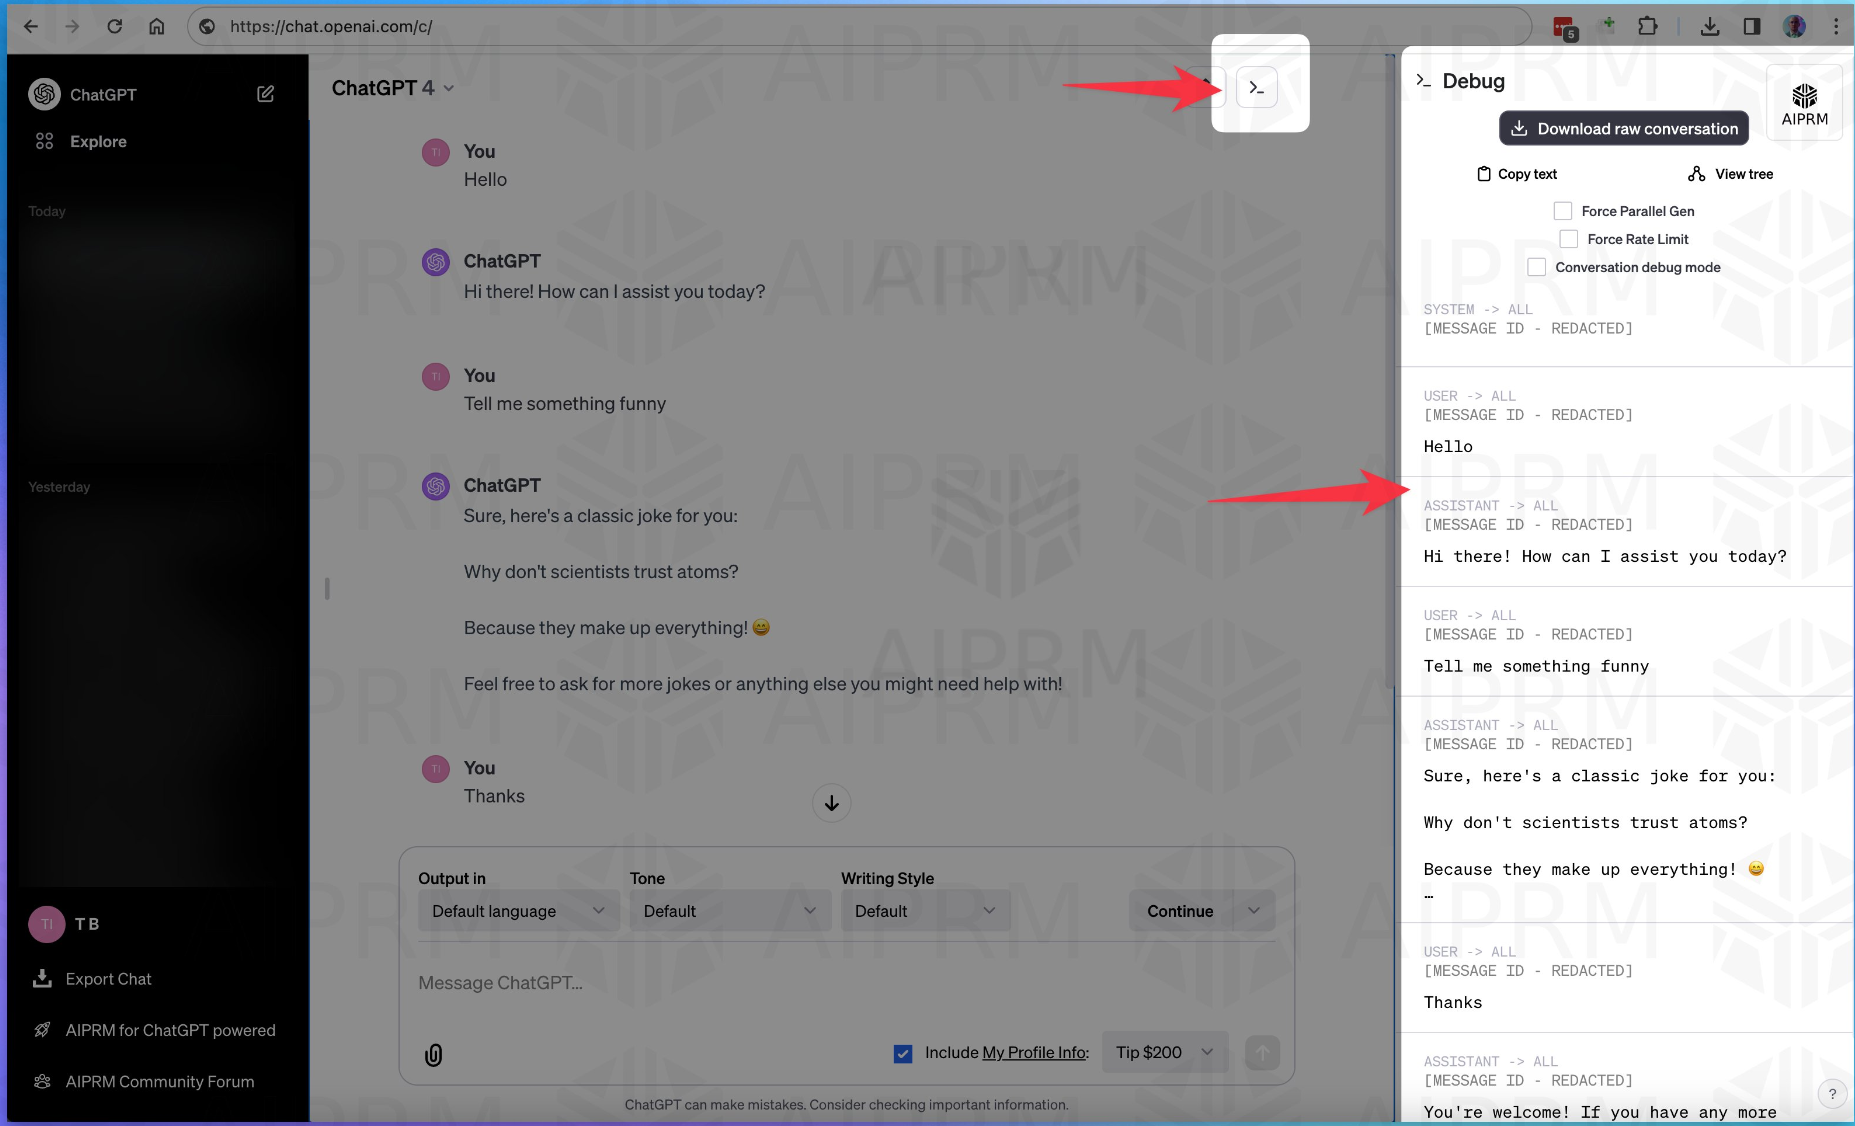
AIPRM的工作人员最近发现ChatGPT的客户端隐藏内置了一个新的debug特性,可以提高ChatGPT对话的问题调试功能。这个特性包含非常多的功能。同时,最新的截图显示ChatGPT Team版本计划可能延迟但没有取消。
今天BusinessInsider发布了一个消息,说根据最新的消息,OpenAI目前还在训练GPT-5,但是有一些企业客户最近已经获得了该最新模型及其对ChatGPT工具的相关增强功能的演示。
Scale AI 于 2025 年 9 月 21 日发布了 SWE-Bench Pro,这是一个针对 AI 代理在软件工程任务上的评估基准。该基准包含 1,865 个问题,来源于 41 个活跃维护的代码仓库,聚焦企业级复杂任务。现有模型在该基准上的表现显示出显著差距,顶级模型的通过率低于 25%,而最近的榜单更新显示部分模型已超过 40%。这一发布旨在推动 AI 在长时程软件开发中的应用研究。
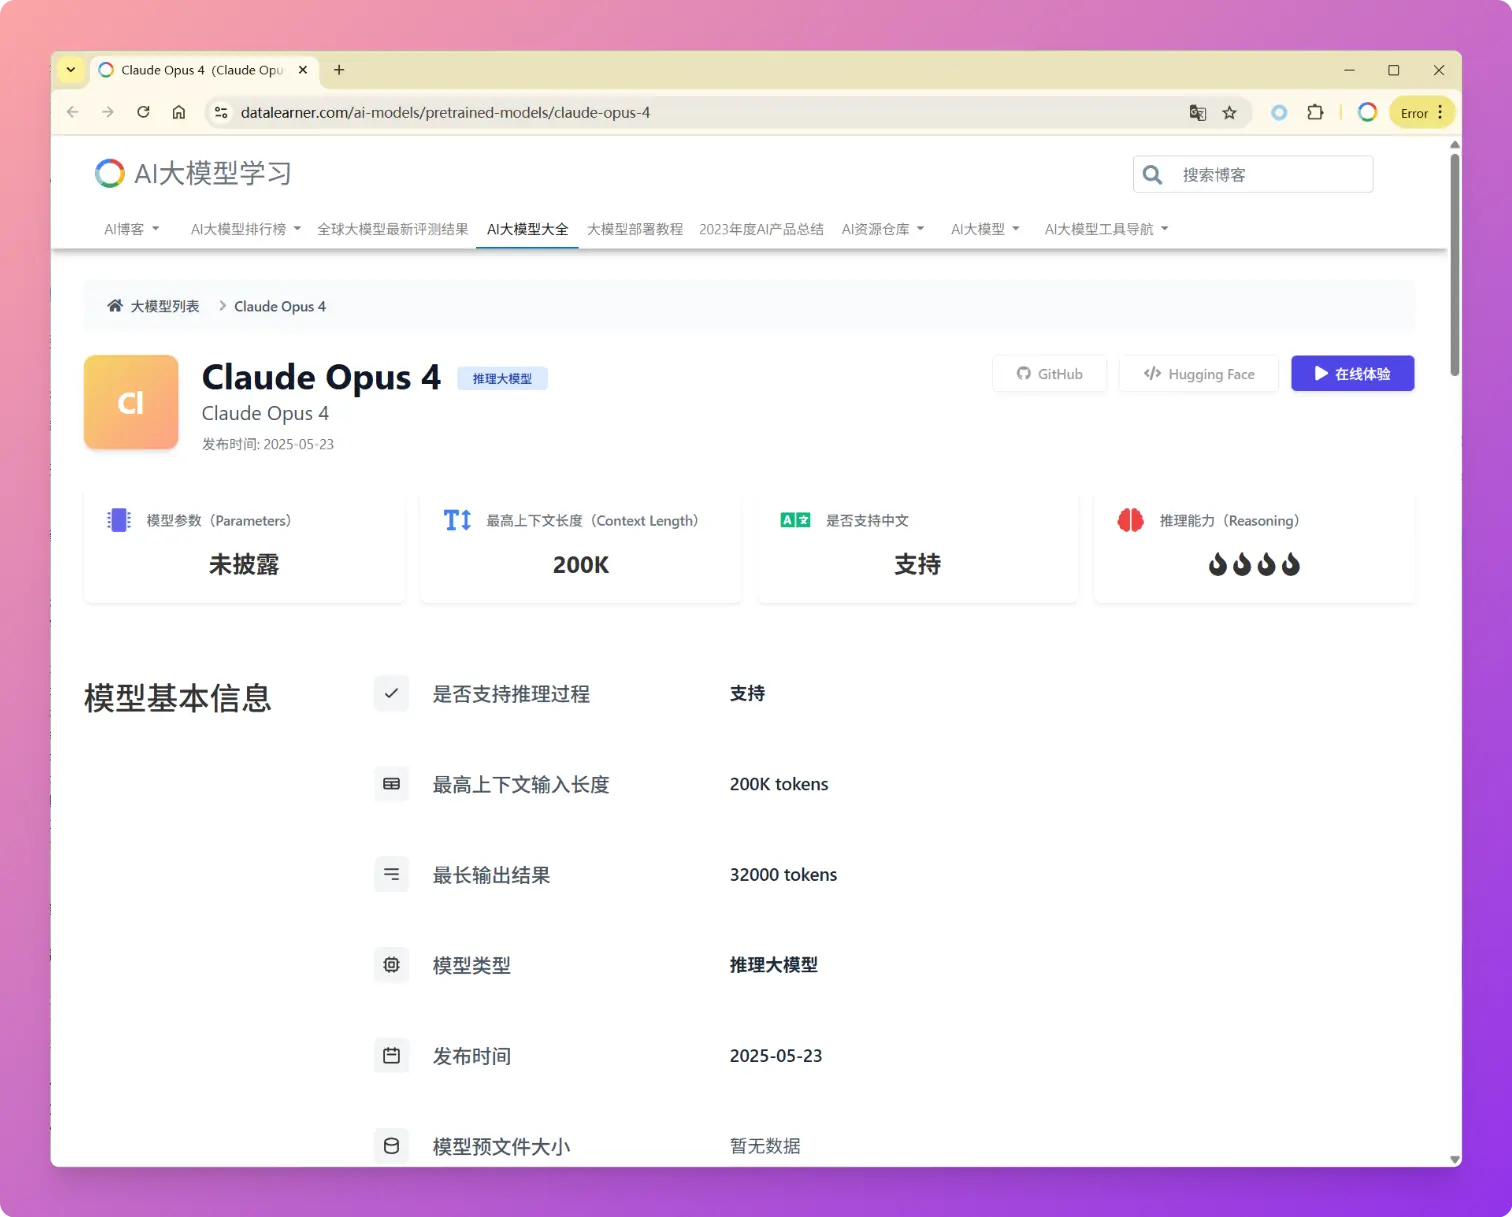
2025年5月23日,Anthropic发布了新一代大语言模型Claude 4系列,包括Claude Opus 4和Claude Sonnet 4两个版本。Anthropic的官方博客强调Claude Opus 4是当前全球最强的编程大模型,与传统聚焦于文本生成和知识问答的模型不同,Claude 4明确定位为任务执行引擎和AI Agent系统的核心组件。这次发布不仅仅是性能参数的提升,更代表了Anthropic认为AI模型从"对话助手"向"自主工作伙伴"的根本性转变。
OpenAI发布的模型中最主要的是大语言模型GPT系列。而且GPT系列模型也在朝着多模态的方向发展。尽管OpenAI有自己的TTS和ASR大模型,但是此前从未正式宣布过。就在今天,OpenAI正式宣布了他们首个语音合成大模型VoiceEngine,该模型也将提供API访问。OpenAI官方的声明中说,现有的基于声音的认证系统应该被淘汰掉!因为已经不安全了!
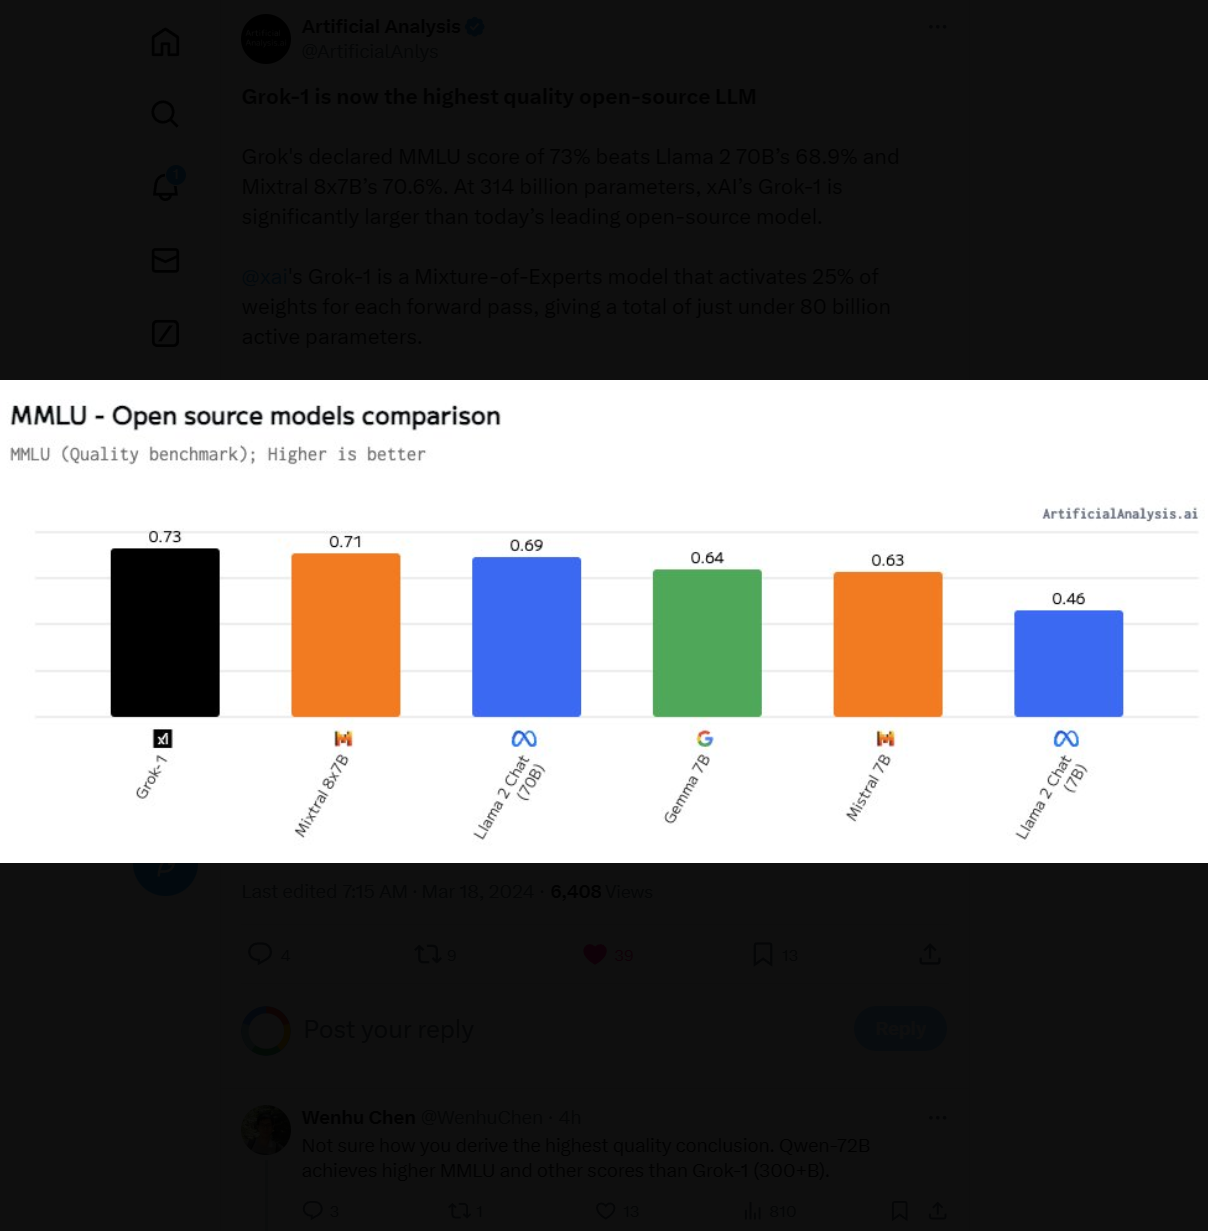
此前,马斯克在推特上宣布要开源旗下大模型公司开发的Grok-1大语言模型。一周后的现在,这个模型Grok-1正式宣布以Apache2.0开源协议开源,本文将针对Grok-1的技术部分进行介绍。
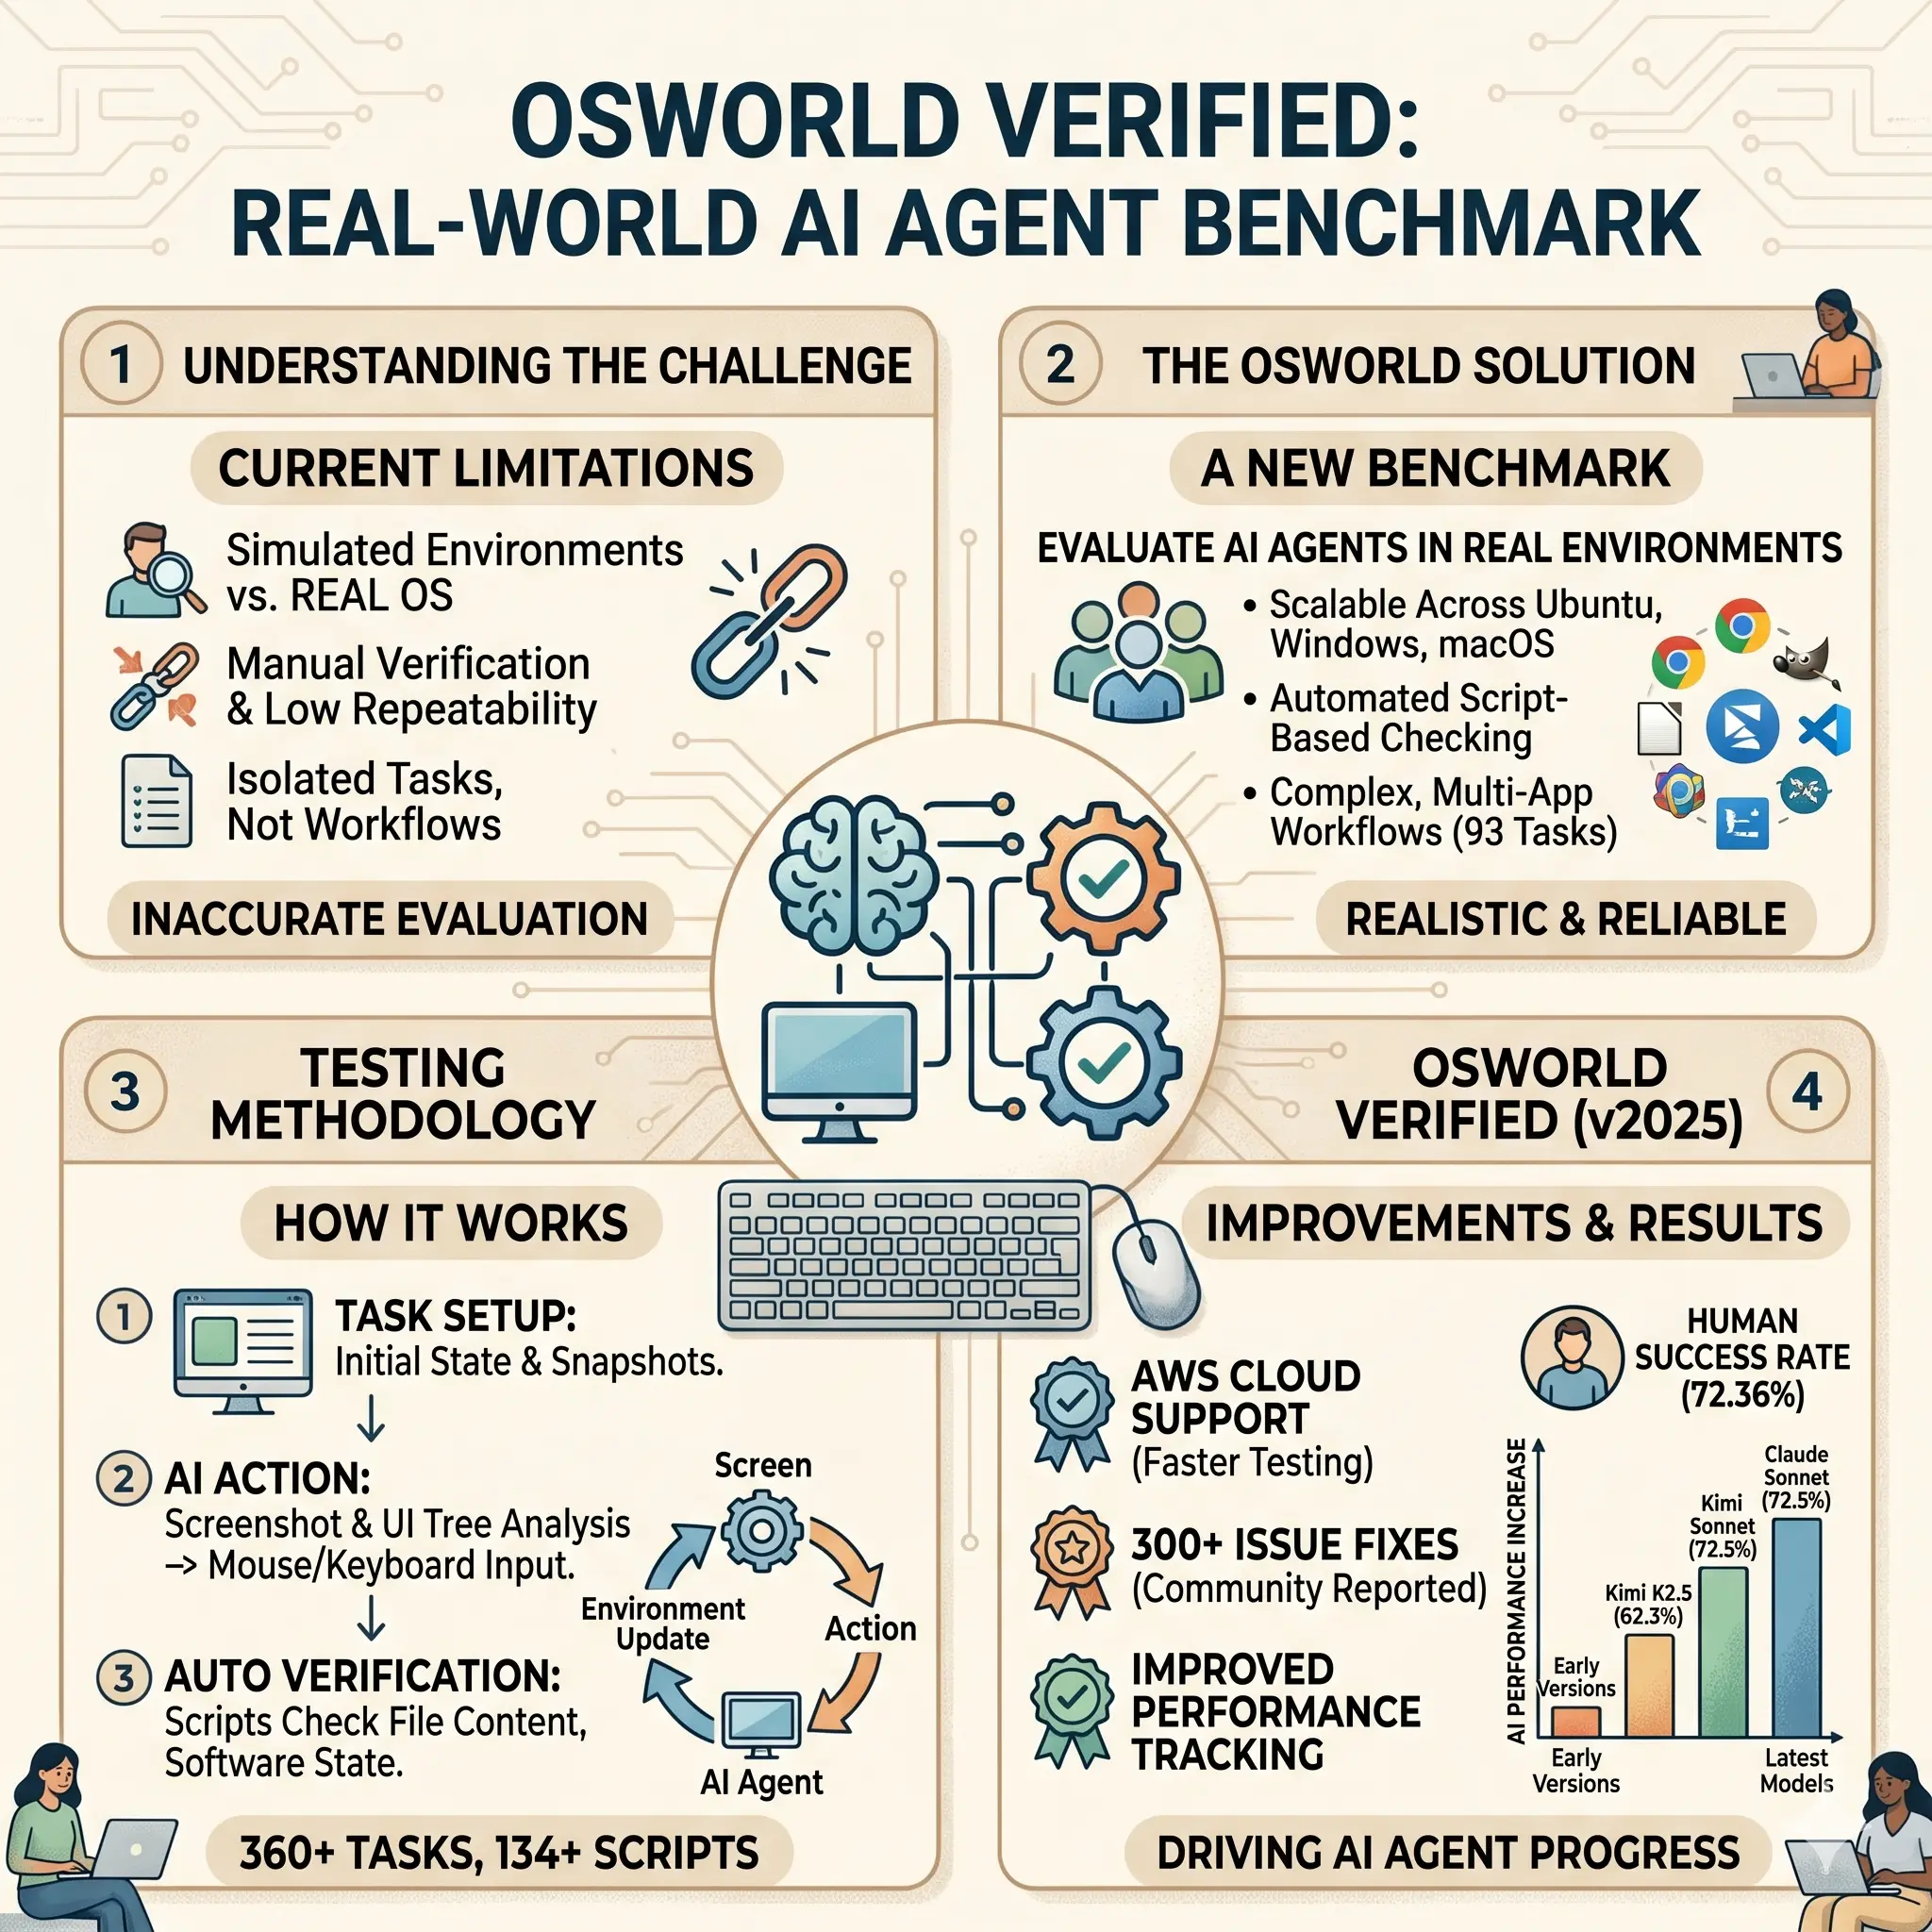
OSWorld 是一个用于测试 AI 代理在真实计算机环境中的基准。这些代理是能处理文字、图片等信息的 AI 系统。基准包括开放式任务,比如操作文件或使用软件。OSWorld Verified 是它的改进版,通过修复问题和提升运行方式,提供更准确的测试结果。它支持不同操作系统,如 Ubuntu、Windows 和 macOS,并允许 AI 通过互动学习来完成任务。