
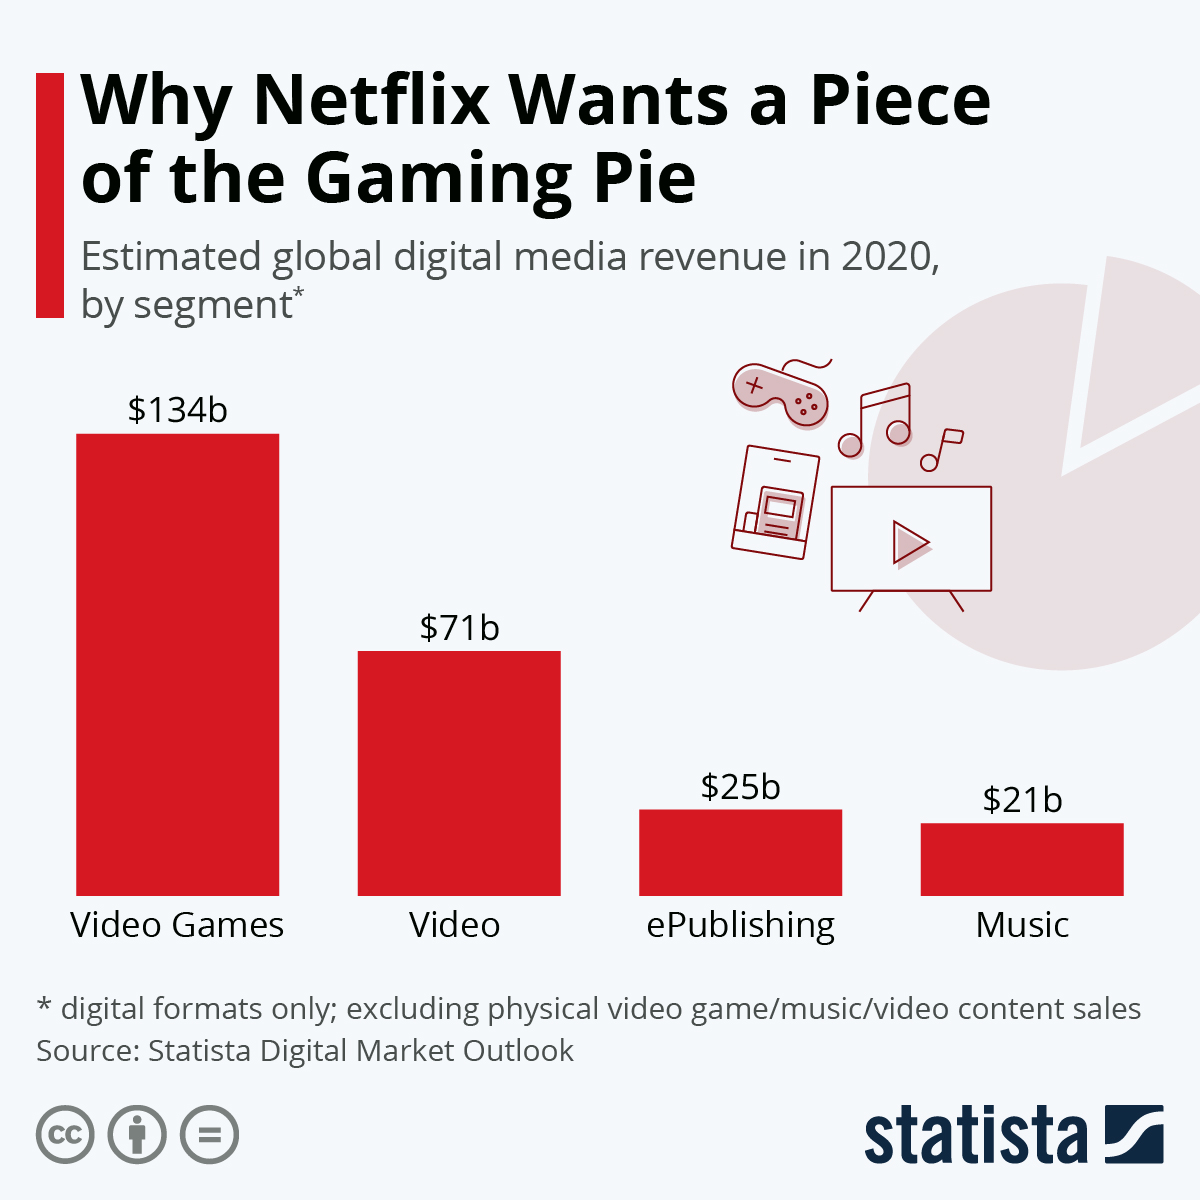
几幅图解释为什么Netflix要进军游戏行业
Netflix是一家网络视频服务公司,国内的爱奇艺、腾讯视频都与此类似。前几年大火的《纸牌屋》也就是这家公司提供的。当时最热吵的就是说Netflix凭借大数据选择的剧本形式与演员,让搞数据科学的人风光了好一阵。最近很火的《鱿鱼游戏》也是在Netflix全球独家播出。那么,网络视频搞得这么火热的Netflix为啥要开始搞游戏呢?这里有几个统计数据图可以解释Netflix这样做的原因。
探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。
Netflix是一家网络视频服务公司,国内的爱奇艺、腾讯视频都与此类似。前几年大火的《纸牌屋》也就是这家公司提供的。当时最热吵的就是说Netflix凭借大数据选择的剧本形式与演员,让搞数据科学的人风光了好一阵。最近很火的《鱿鱼游戏》也是在Netflix全球独家播出。那么,网络视频搞得这么火热的Netflix为啥要开始搞游戏呢?这里有几个统计数据图可以解释Netflix这样做的原因。
随着DeepSeek R1和OpenAI的o1、o3等推理大模型的发布,我们当前可使用的大模型种类也变多了。但是,推理大模型和普通大模型之间并不是二选一的关系,在不同的问题上二者各有优势。为了让大家更清晰理解推理大模型和普通大模型的应用场景。OpenAI官方推出了一个推理大模型最佳实践指南。描述了二者的对比。本文将总结这份推理大模型最佳实践指南。
最初,大模型的应用主要通过像ChatGPT这样的聊天机器人展现其智能理解能力。随着技术的进步,基于大模型的智能代理(AI Agent)成为突破大模型能力边界的重要方向。这些智能代理能够执行一系列任务、解决问题,并进行决策,具备深刻理解用户需求和自主规划解决方案的能力,并能够根据规划结果,选择和使用各种工具来完成任务。然而,AI Agent系统面临的关键挑战是如何高效地将外部工具、知识、资源等迅速接入大模型,并实现有效利用。尤其是,如何将现有的工具和资源整合进大模型,提升其生产力能力,是一个亟待解决的问题。
近年来,AI 编码助手与 Agent 框架层出不穷,从 Github Copilot 到 Cursor,再到各种基于 LangChain 的多代理方案。然而,真正让开发者普遍感受到“顺手”与“愉快”的,却是 Claude Code(简称 CC)。它的特别之处,并不在于引入了复杂的新架构,而恰恰在于其极简而精心打磨的设计选择。 Claude模型本身的强大毋庸置疑,但是即使是相同的模型,Claude Code体验也比其它的Agent似乎体验更好。本文基于2025年8月21日vivek公开发布的一篇英文博客,

Aider 是一个在终端里进行结对编程的开源工具。为评估不同大模型在“按照指令对代码进行实际可落地的编辑”上的能力,Aider 提出并维护了公开基准与排行榜,用于比较模型在无人工干预下完成代码修改任务的可靠性与成功率。该评测已被多家模型提供方在技术说明中引用,用作代码编辑与指令遵循能力的对照指标。
Terminal-Bench是一个新兴的开源基准测试,专为评估人工智能Agent(AI Agent)在命令行终端环境中的实际操作能力而设计。它通过一系列模拟真实世界场景的复杂任务,旨在客观、可量化地衡量AI Agent在执行代码编译、服务器管理和数据处理等任务时的熟练程度与自主性。
GPTs是OpenAI推出的用户自定义的GPT功能,这里的GPTs可以认为是specific GPT。用户创建GPTs主要是通过OpenAI提供的GPT Builder完成。GPT Builder提供的最基本的能力就是基于对话的方式来帮助用户创建GPTs。那么,这个对话式的GPT背后的指令是什么?官方设置了什么样的Prompt来让GPT帮助普通用户建立GPTs呢?本文基于官方最新的博客介绍一下。
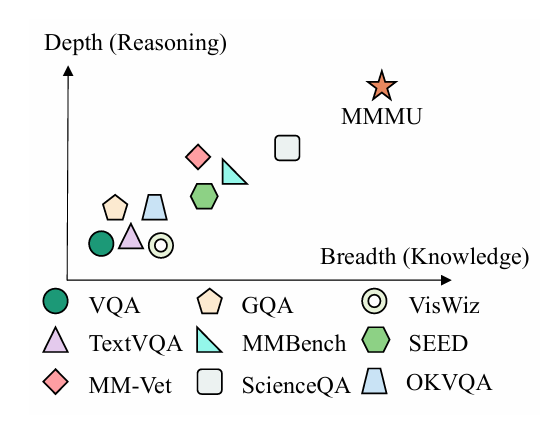
大模型多模态评测基准MMMU(大规模多学科多模态理解和推理基准)是一项旨在评估多模态人工智能模型在复杂跨学科任务中综合能力的测试工具。
Hunyuan大模型是腾讯训练的大模型品牌名,2022年4月份,某中文语言理解能力排行榜第一名就出现了Hunyuan模型,在2022年11月,Hunyuan大模型就有了1万亿参数的规模,即HunYuan-NLP 1T大模型(比ChatGPT还早发布)。但是最近2年,这个系列的模型几乎没有出现在公众视野上。而昨天(2025年3月10日),Hunyuan官方在X平台上宣布了旗下最新的Hunyuan Turbo S大模型,称其在多个评测基准上超越了GPT-4o的表现。
Grok4是马斯克旗下大模型初创企业xAI的第四代代码,在五月份的时候,马斯克就透露他们马上要发布Grok 3.5模型,六月份的时候说这个模型效果很好,版本号就直接改为4,这中间经过多次波折,最终马斯克说Grok 4将在7月4日之后发布。截止目前,虽然xAI官方没有正式宣布Grok 4,但是目前Grok 4已经透露了很多的消息。本文将对这些信息做总结和分析。
RedPajama模型是TOGETHER发布的一个开源可商用的大模型。2023年6月6日,TOGETHER在官方宣布该模型完成训练,经过测试,该模型目前超过所有7B规模的大模型,比LLaMA-7B和Falcon-7B的效果还要好!
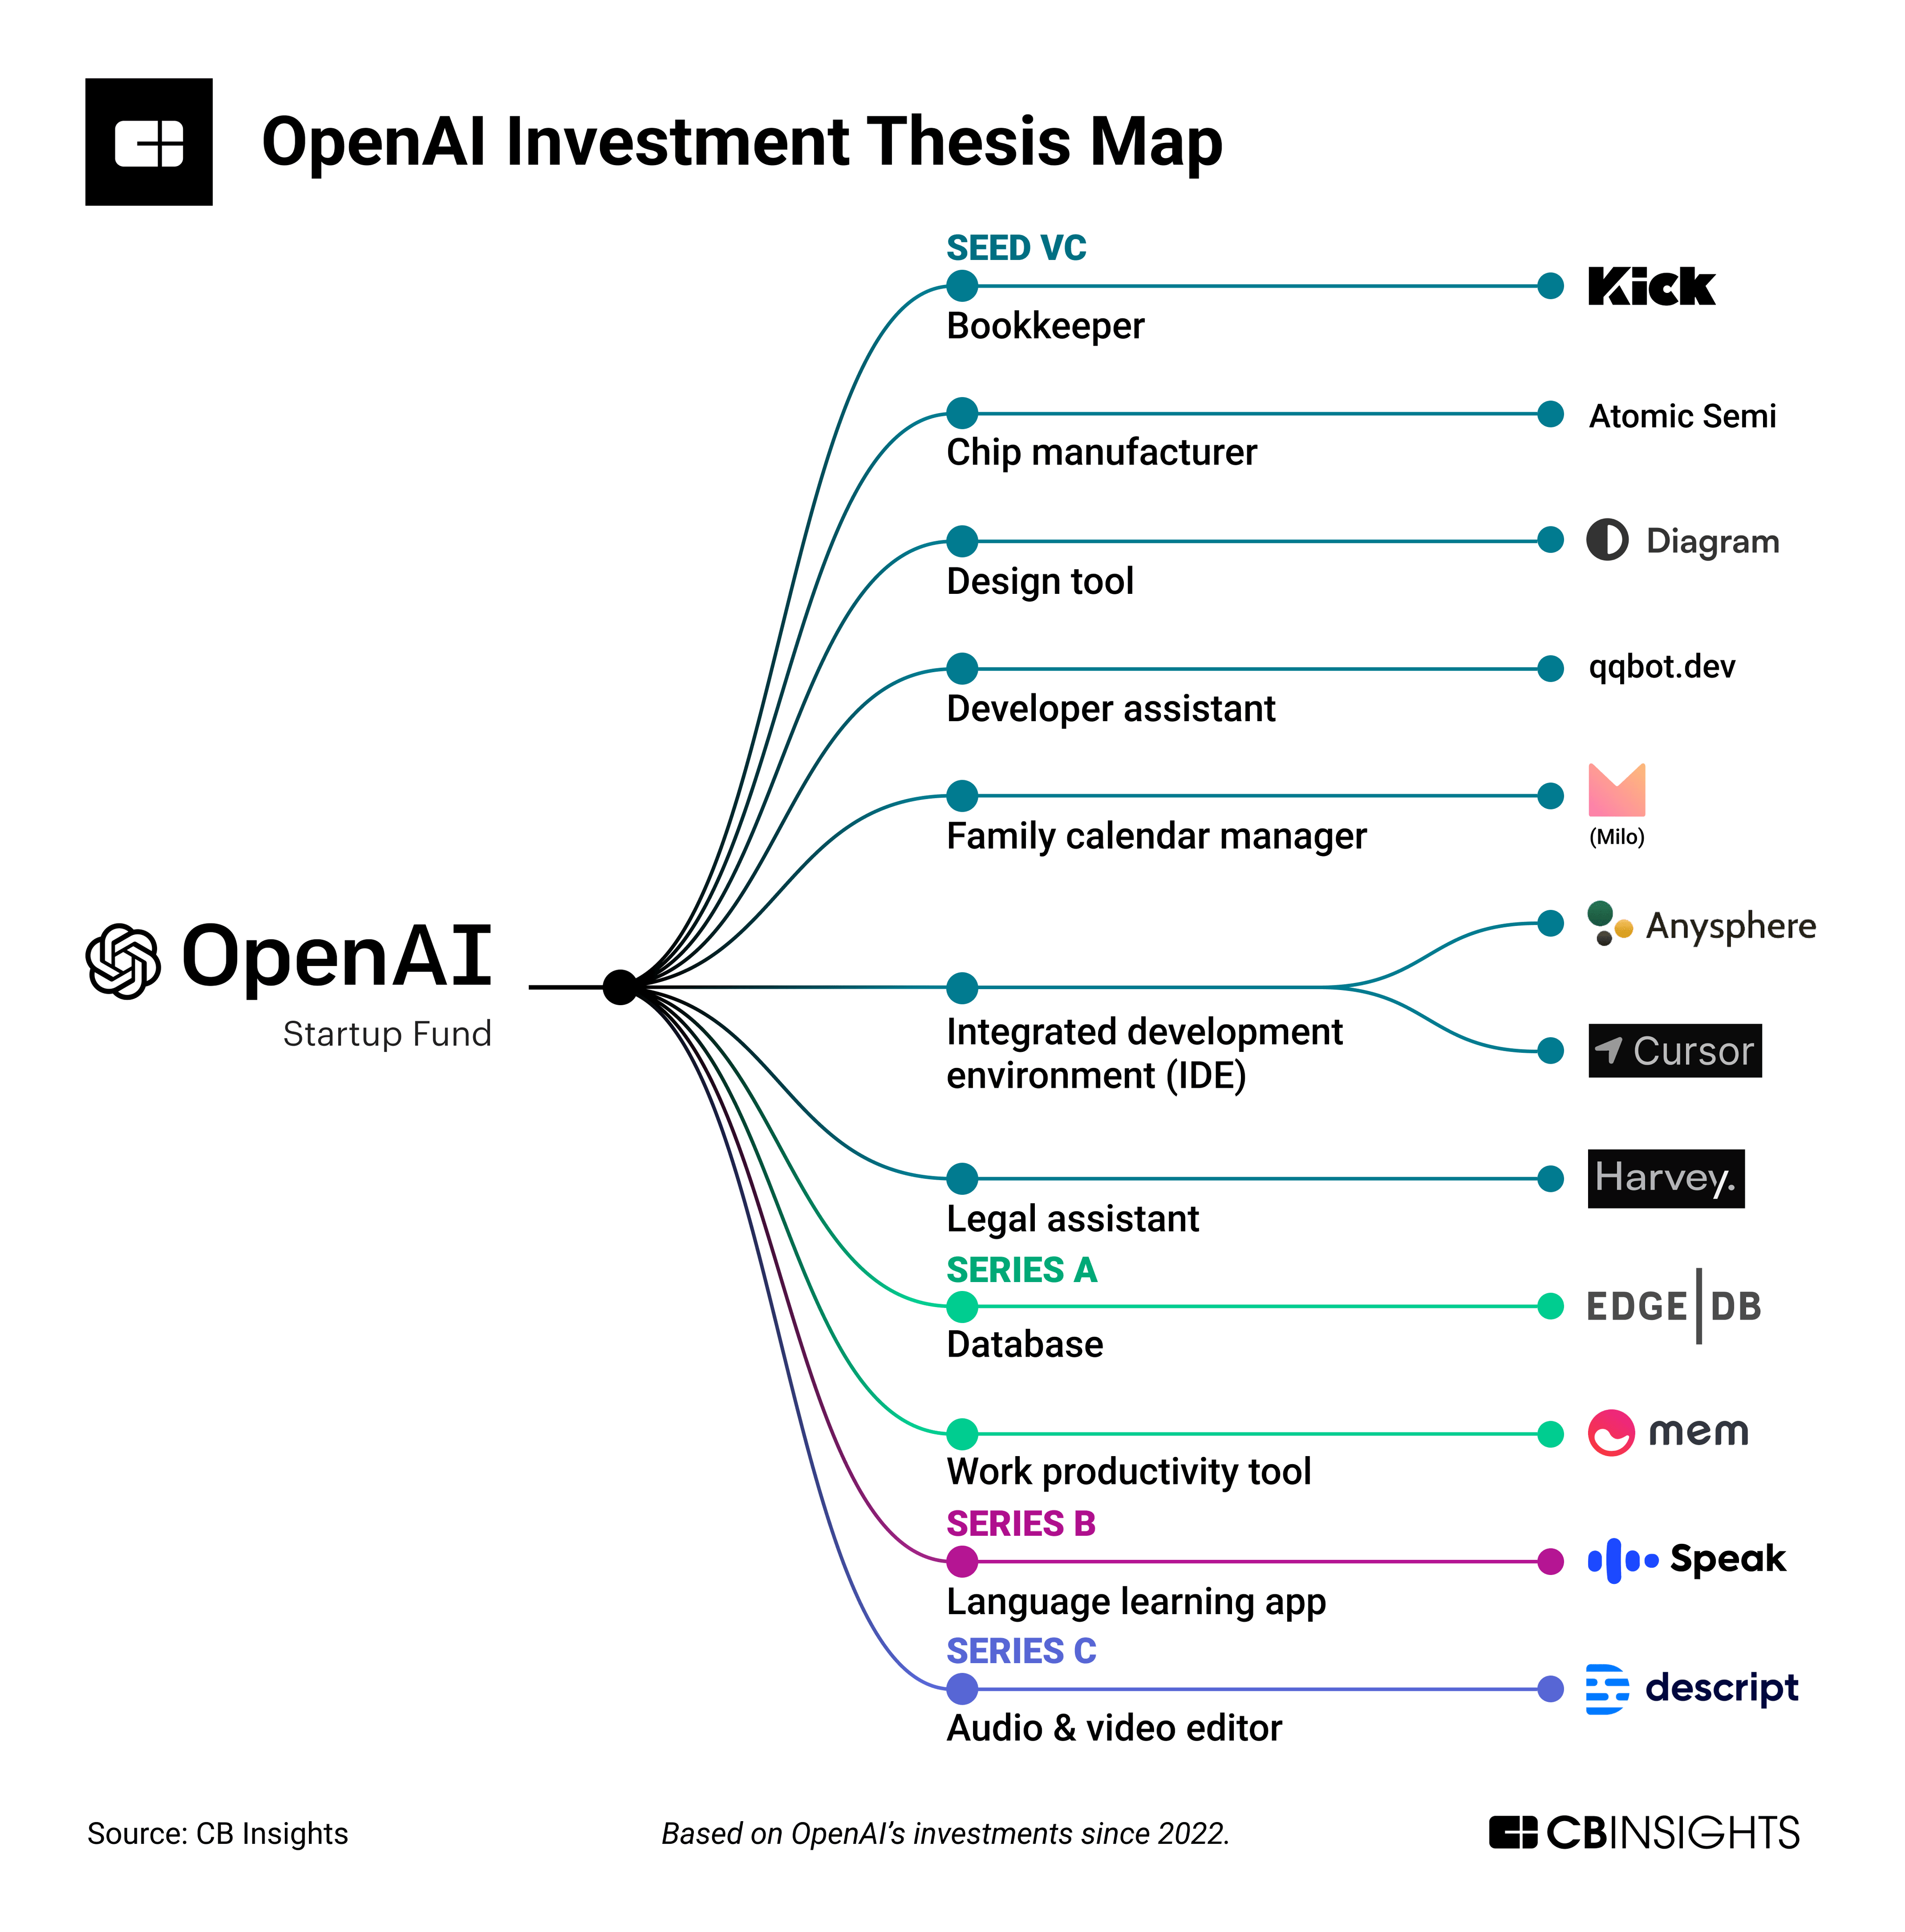
OpenAI Startup Fund是OpenAI和微软等合作伙伴在2022年推出的一个创业基金,收到OpenAI Startup Fund投资的初创企业几乎可以等同于OpenAI认为的未来AI应用重要方向。这些企业不仅可以获得资金支持,还可以比其它企业更早使用OpenAI的模型。本文将简要介绍当前OpenAI已经投资的企业,它们可能是未来AI领域重要的角色!
阿里发布了全新的语音识别大模型Qwen3-ASR-Flash,该模型是Qwen3系列模型中首个语音识别大模型,中英文语音识别错误率低于GPT-4o-transcribe和Gemini 2.5 Pro。不过,该模型目前仅通过API提供,不开源!
就在刚才,阿里开源了Qwen Image大模型,这是阿里千问团队开源的高质量图片生成和编辑的大模型。这份发布迅速在AI社区引起了广泛关注,其核心并非又一个单纯追求图像美学或真实感的模型,而是直指一个长期存在的行业痛点:在图像中进行复杂、精准、尤其是高保真的多语言文本渲染。
2025年2月25日,Anthropic发布了Claude 3.7 Sonnet大模型,该模型是业界第一个同时支持标准输出和深度推理模式的单一大模型,各项评测相比较Claude Sonnet 3.5大幅提升。特别是代码能力进一步增强。
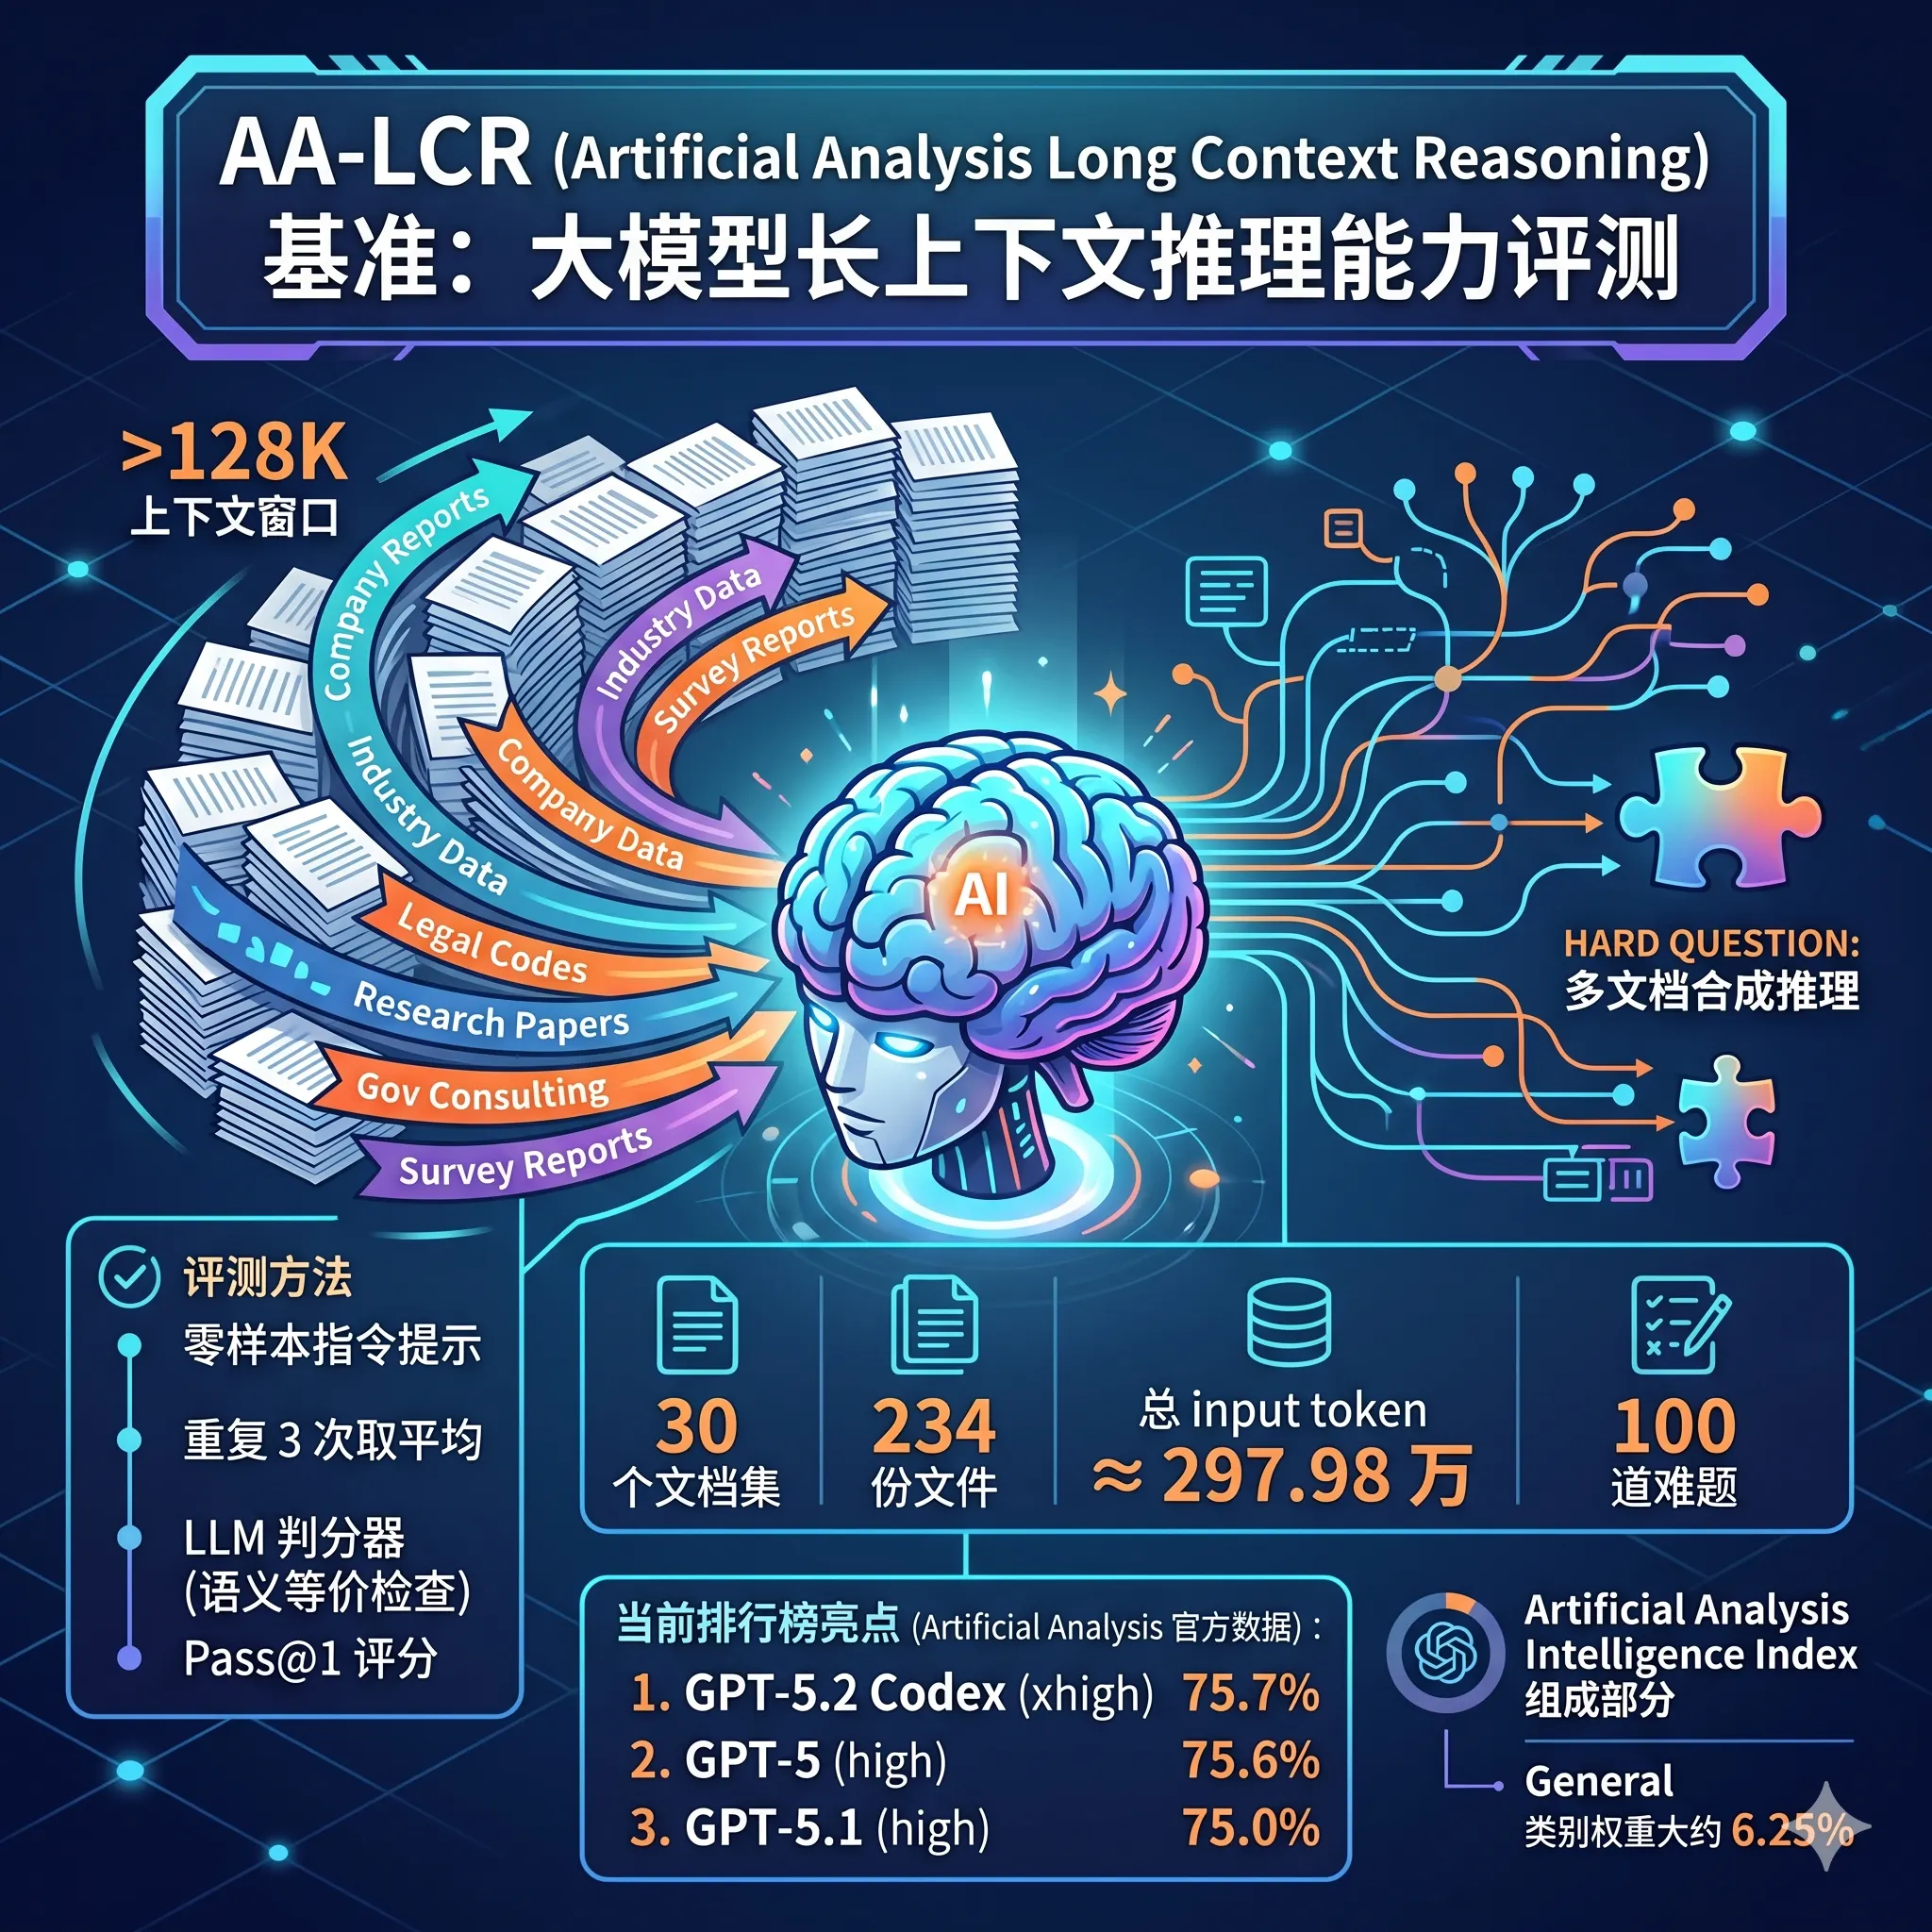
AA-LCR 是由独立 AI 评测机构 Artificial Analysis 开发的基准测试集,旨在真实模拟知识工作者(如分析师、研究员、律师)处理海量文档的场景。

CVPR2022的一篇论文带来了一个39亿参数的自回归图像模型公开了他们的代码和论文。
国产大语言模型的开源领域一直是很多企业或者科研机构都在卷的领域。最早,智谱AI开源ChatGLM-6B之后,国产大模型的开源就开始不断发展。早期大模型开源的参数规模一直在60-70亿参数规模,随着后续阿里千问系列的140亿参数的模型开源以及智源340亿参数模型开源之后,元象科技开源650亿参数规模的大语言模型XVERSE-65B,将国产开源大模型的参数规模提高到新的台阶。
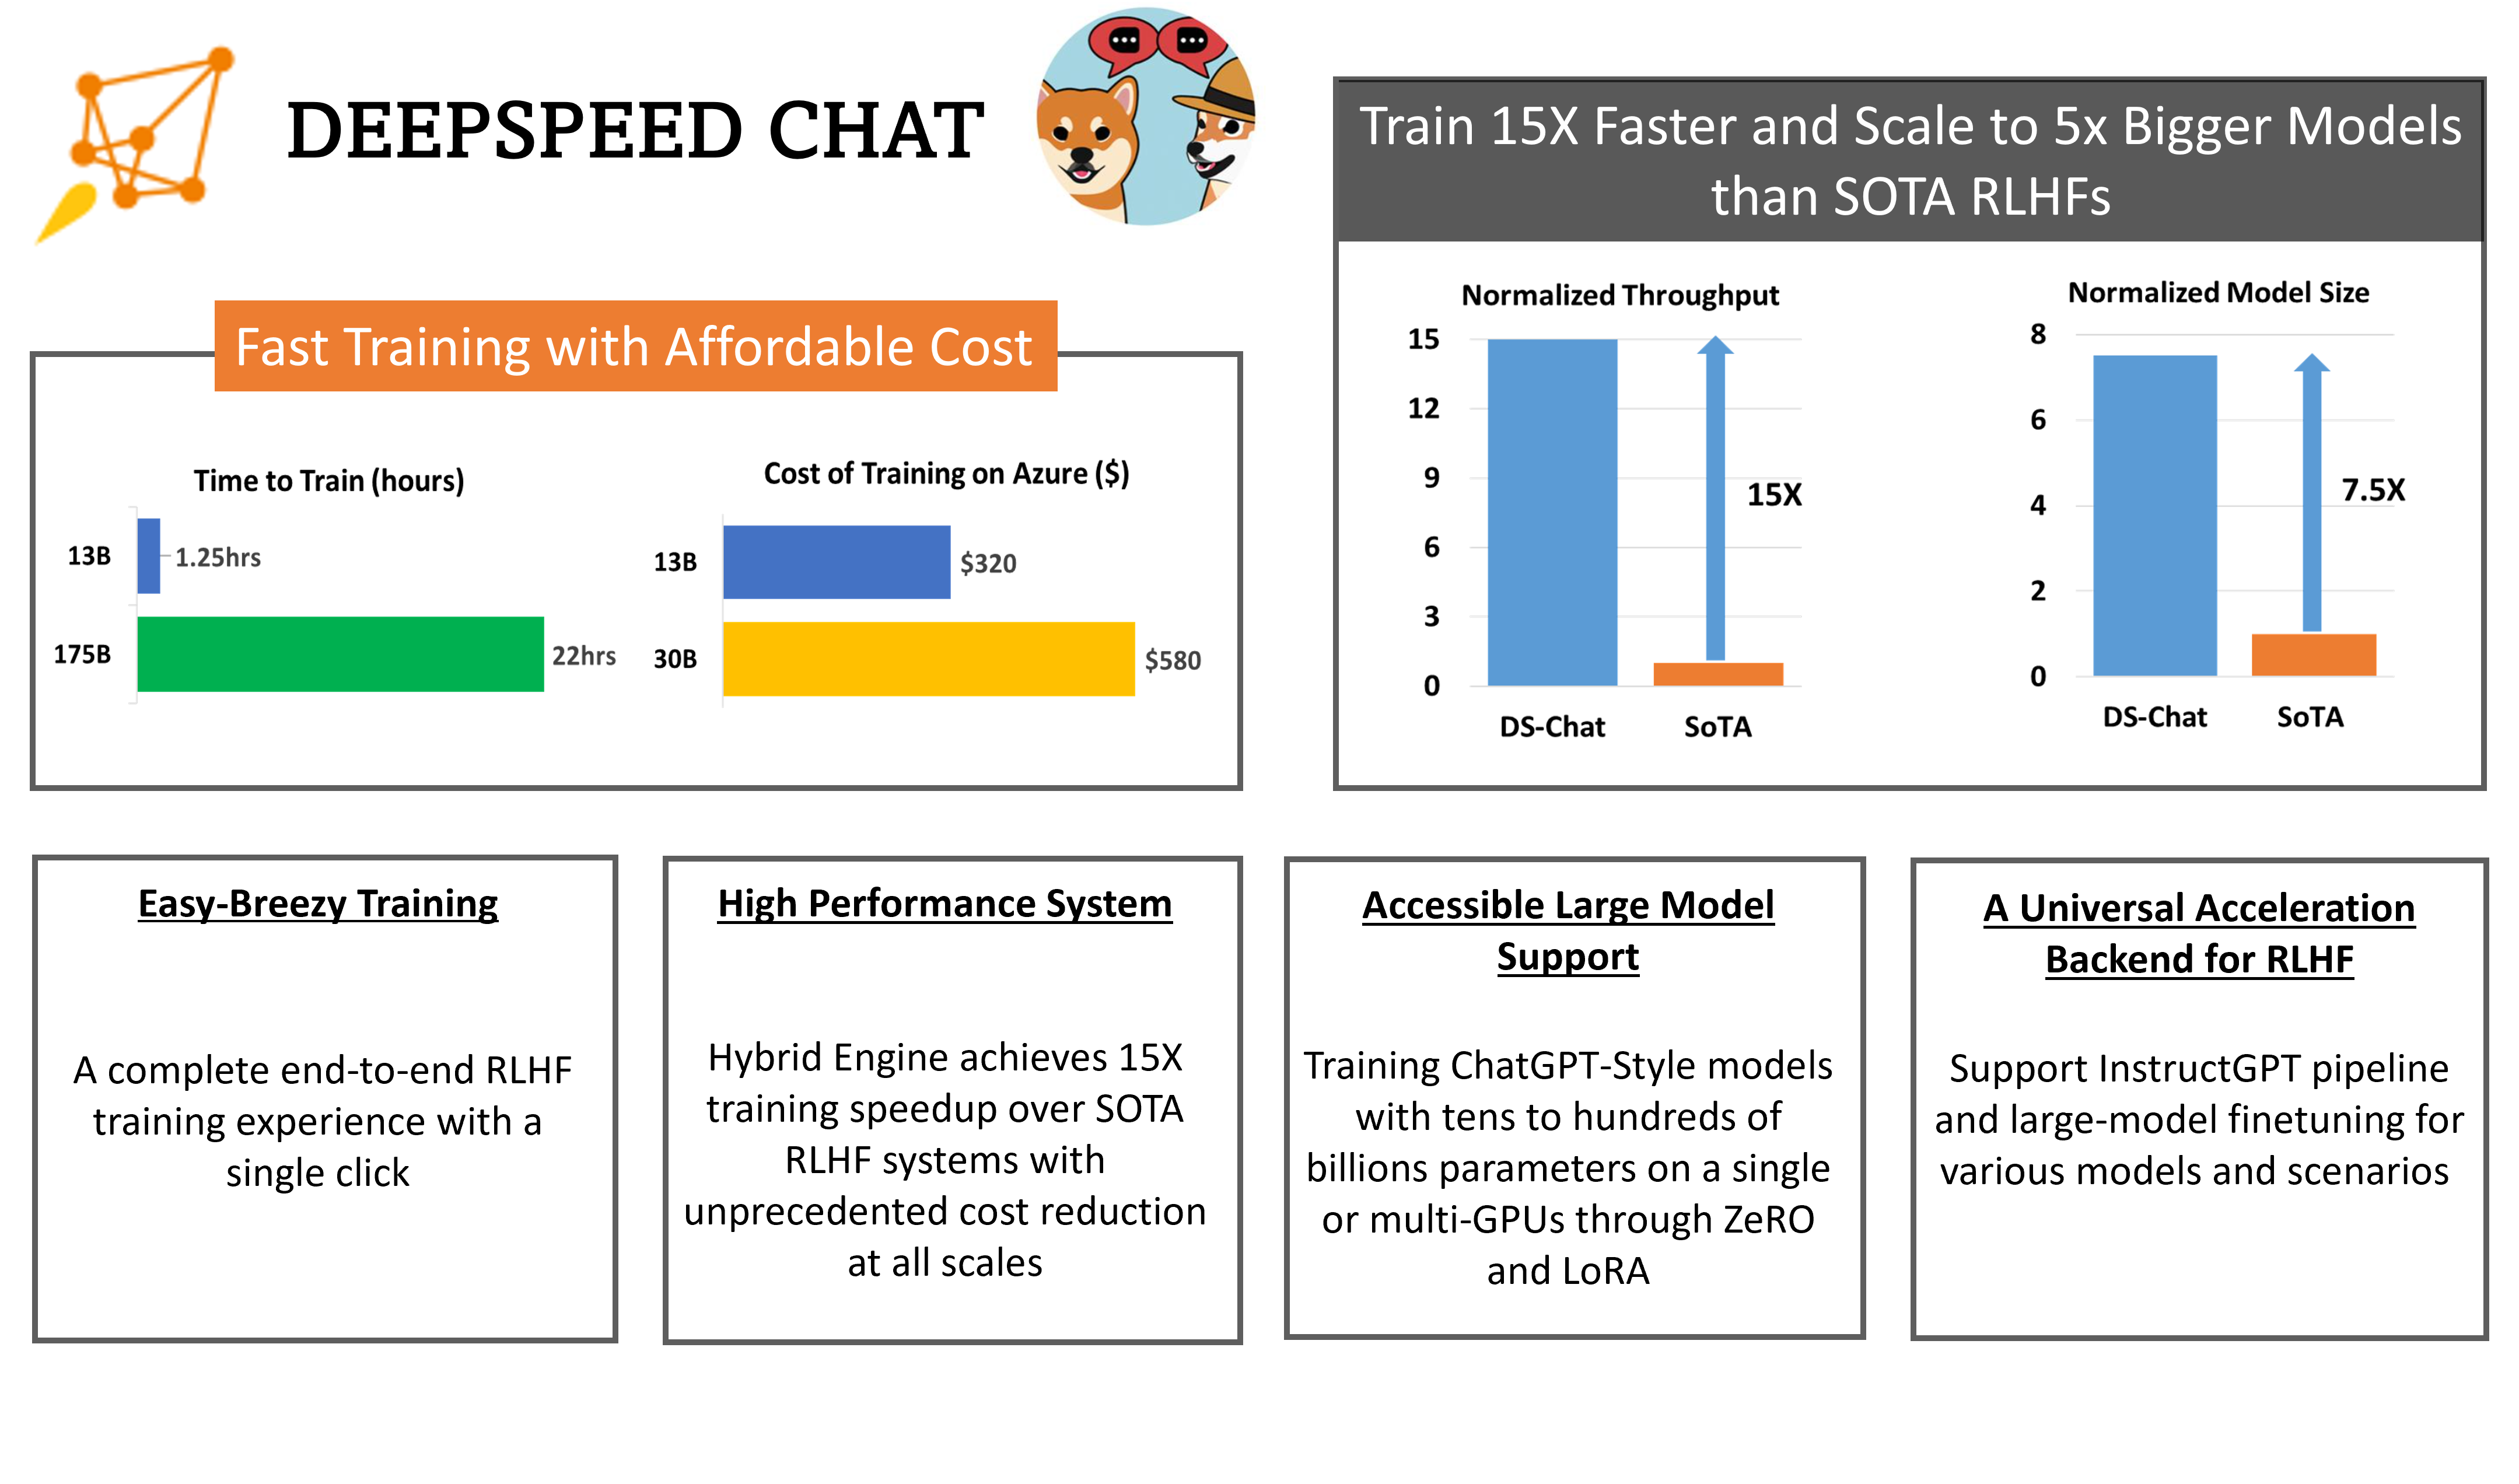
RLHF全称Reinforcement Learning from Human Feedback,是随着ChatGPT火爆之后而被大家所关注的技术。昨天,微软开源了业界第一个RLHF的pipeline框架,可以用来训练类似ChatGPT的模型。
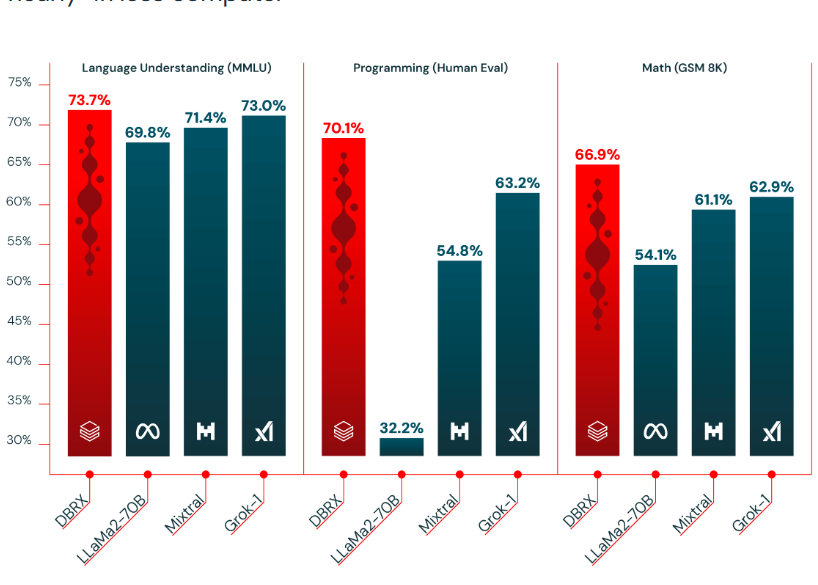
基于混合专家技术的大语言模型是当前大语言模型的一个重要方向。去年MistralAI开源了全球最有影响力的Mixtal-8×7B-MoE模型,吸引了很多关注。在2024年3月27日的今天,Databricks宣布开源一个全新的1320亿参数的混合专家大语言模型DBRX。
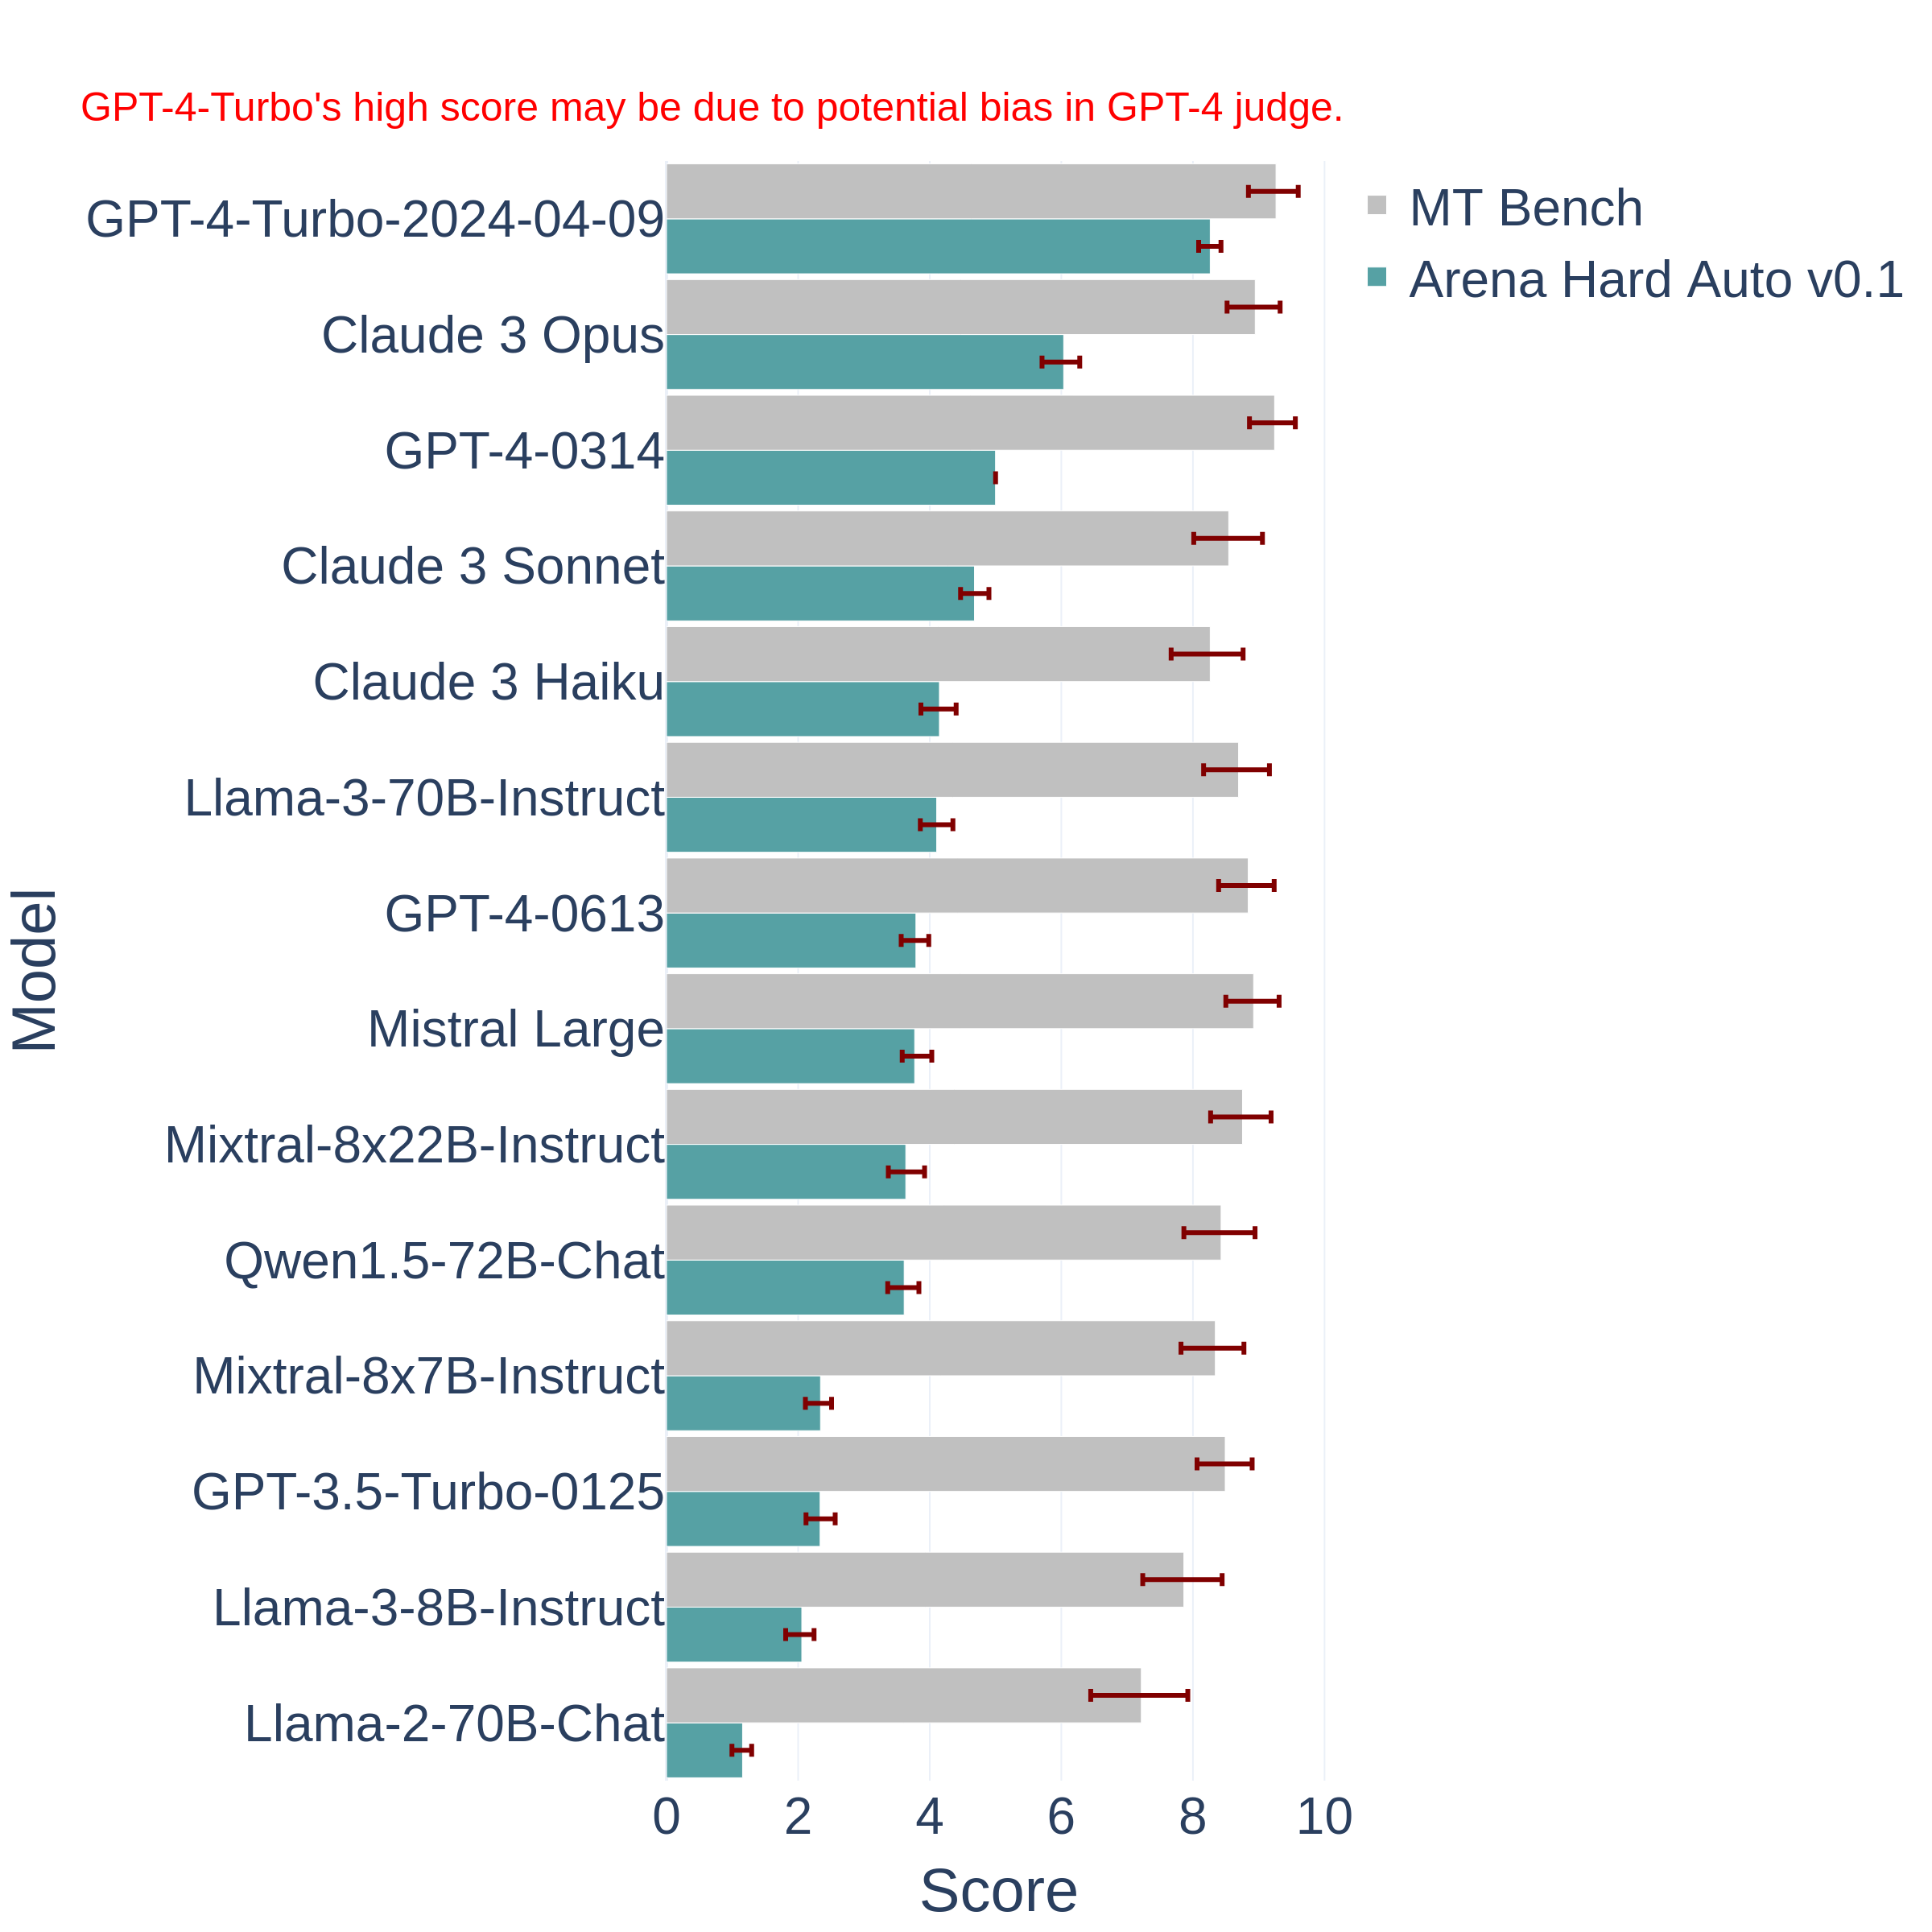
评估日益发展的大型语言模型(LLM)是一个复杂的任务。传统的基准测试往往难以跟上技术的快速进步,容易过时且无法捕捉到现实应用中的细微差异。为此,LM-SYS研究人员提出了一个全新的大模型评测基准——Arena Hard。这个平常基准是基于Chatbot Arena发展而来,相比较常规的评测基准,它更难也更全面。
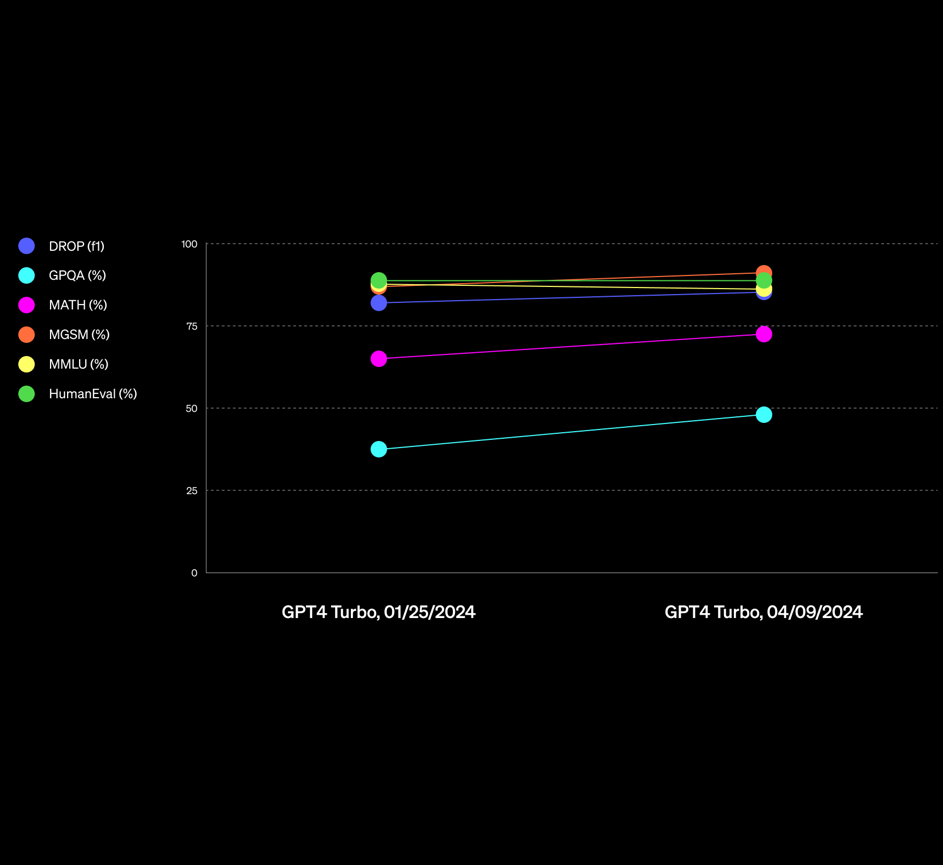
OpenAI的GPT-4一直是全球最强的大语言模型。但是在最近的一系列新模型对比中,已经有一些模型在某些领域被认为已经接近或者超过GPT-4了。而在前几天,OpenAI更新了一个新版本的GPT-4,是GPT-4-Turbo-2024-04-09,官方说该版本的GPT在推理和数学能力上有明显提升,而实测结果也很不错。在基准测试评测中,最高有19%的提升幅度!在GPT-4这样强的模型上有这样的提升幅度,十分不错!
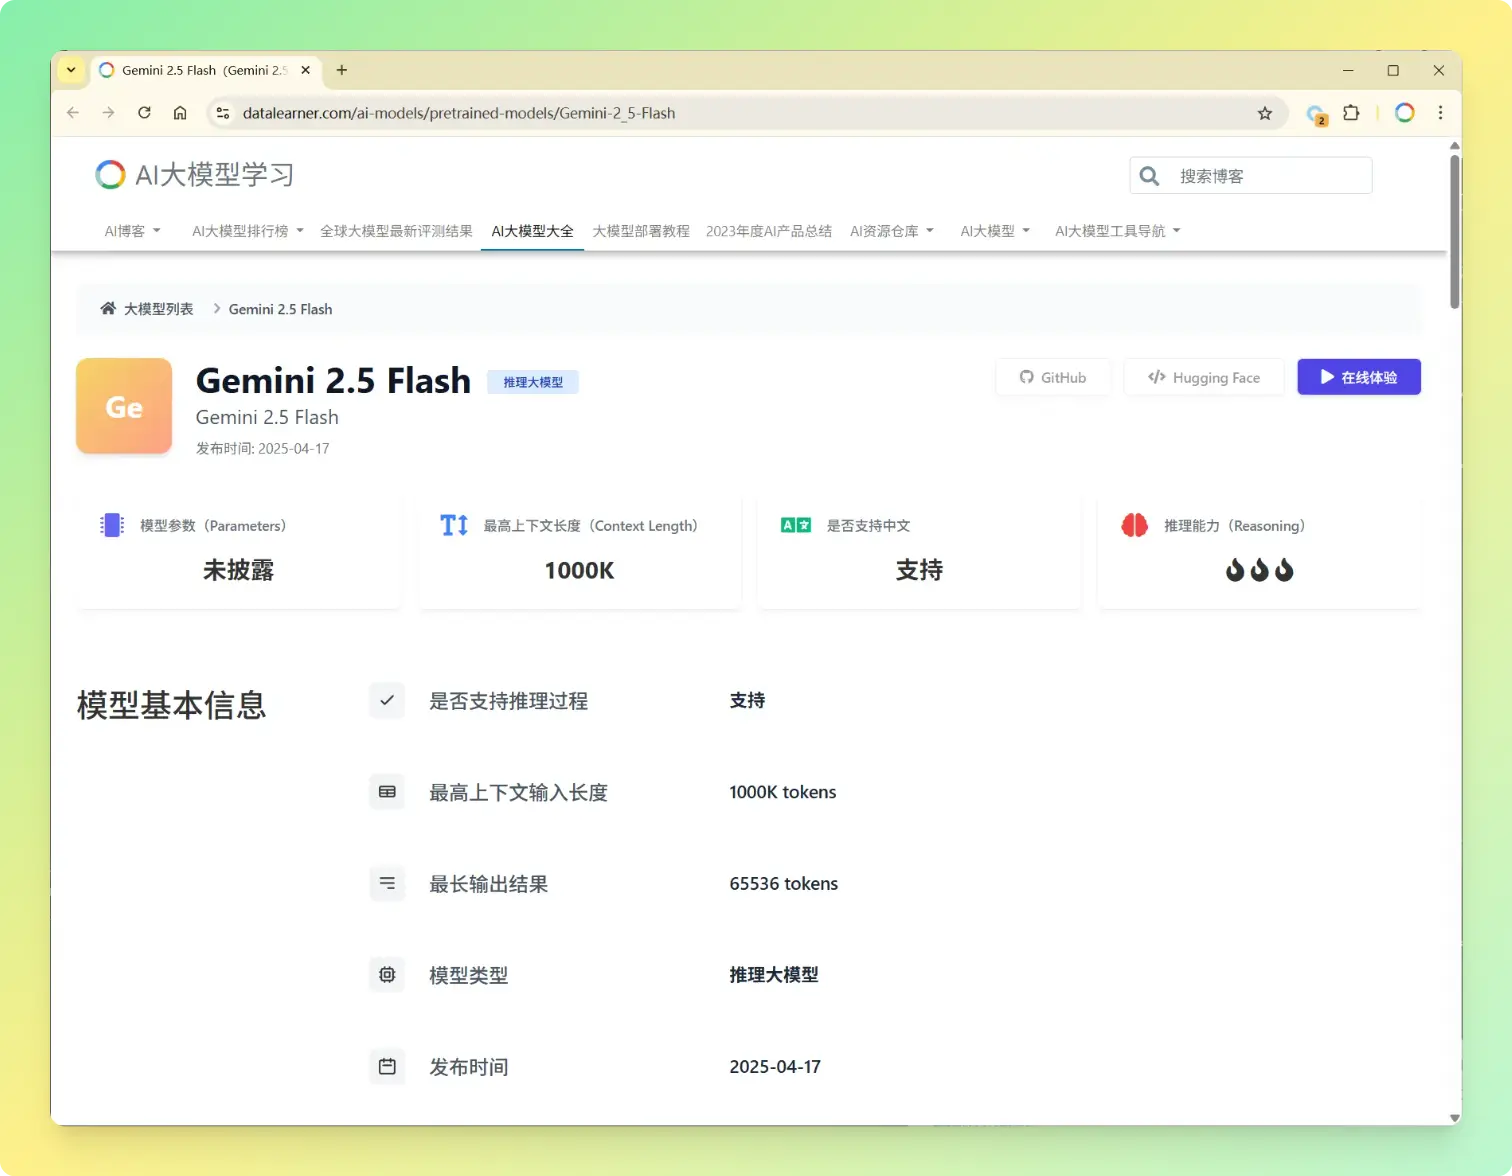
Gemini系列是Google的大模型品牌,2025年3月25日,Google发布了Gemini 2.5 Pro版本,这是谷歌发布的Gemini 2.5系列的第一个模型,参数规模较大,但是在多项评测结果上获得了全球最优的效果,Gemini 2.5 Pro成本比较高,时延也比较大,20天之后,谷歌又发布了Gemini 2.5 Flash模型,是性能、成本和效果的最佳均衡模型。
马斯克旗下的xAI公司正式发布Grok4大模型,包含Grok 4和Grok4 Heavy版本,其中Grok4 Heavy是一个Agent系统,在AIME2025(美国的数学邀请赛)得分满分,超过了所有大模型。此前透露的Grok 4 Code和视频生成能力都没有发布。