DataLearner 标志
原创博客

原创AI技术博客

探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。

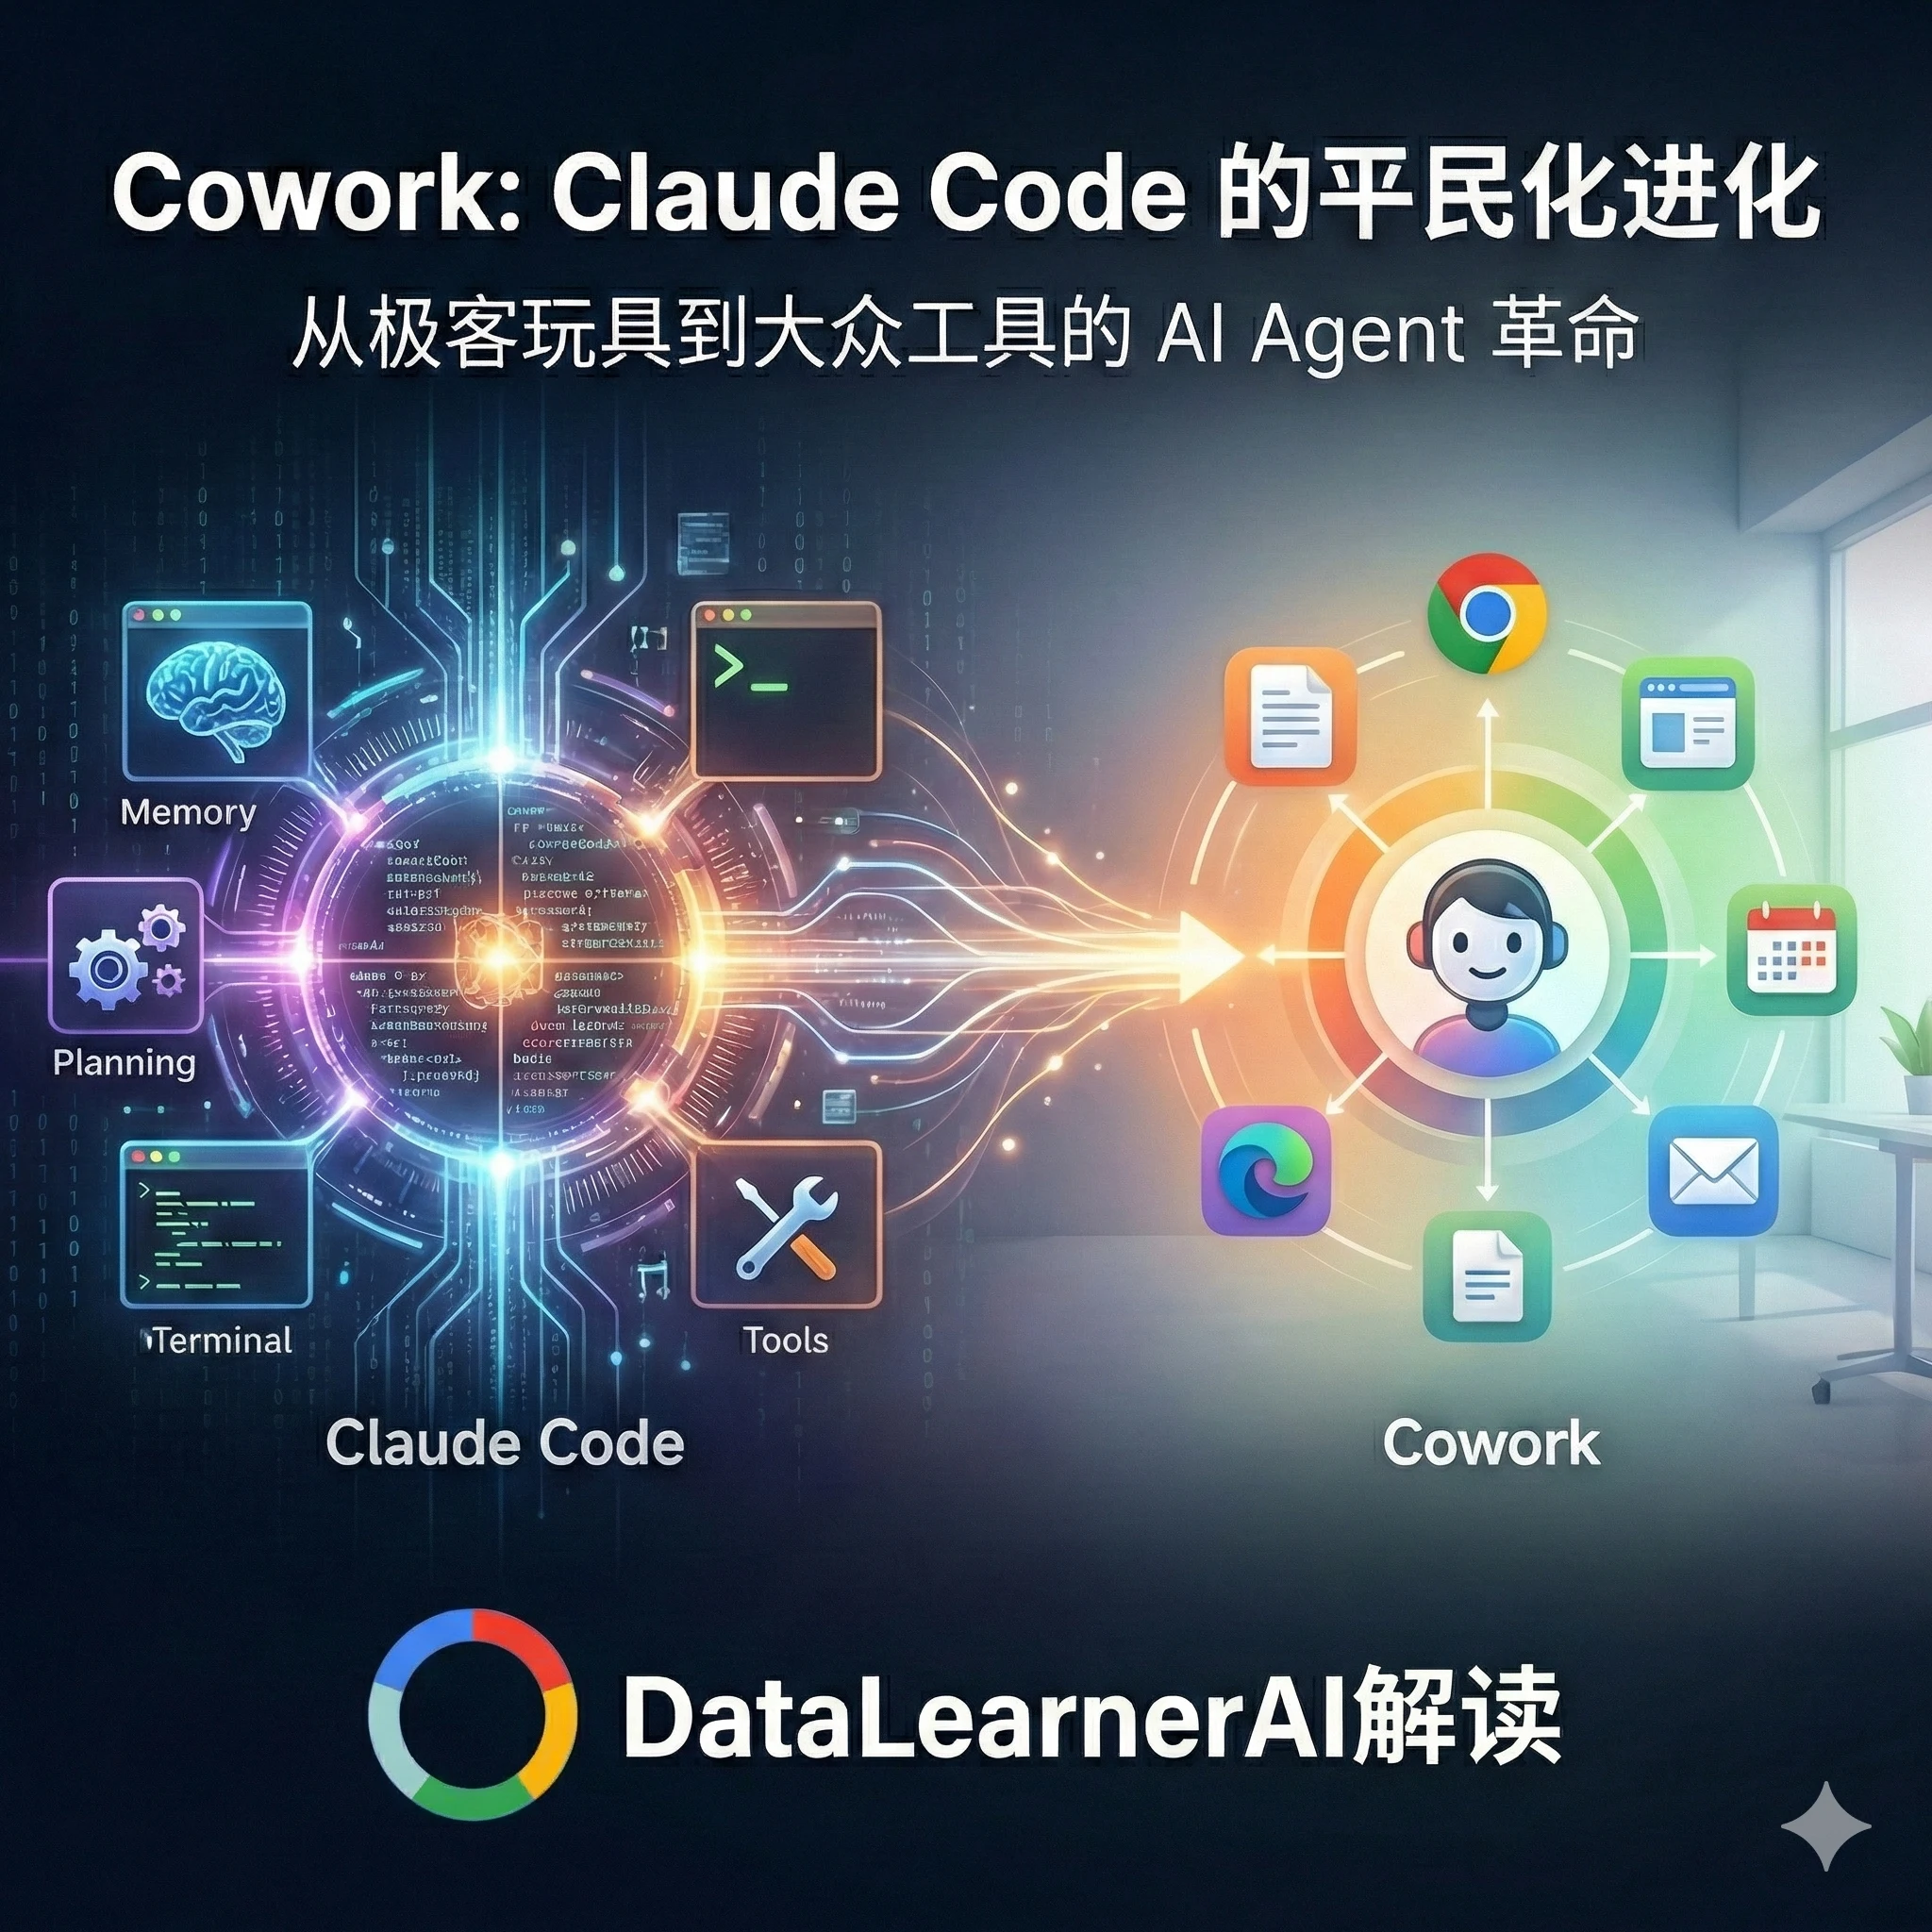
Anthropic 发布 Cowork:从 Claude Code 的发展历史看 Cowork 的能力与定位,它可能成为普通人的下一代桌面 AI 助手吗?

Anthropic 发布 Cowork:从 Claude Code 的发展历史看 Cowork 的能力与定位,它可能成为普通人的下一代桌面 AI 助手吗?

Anthropic 于 2026 年 1 月 12 日发布了 Cowork,这是一款基于 Claude 模型的新型 AI Agent工具,作为 Claude 桌面应用的 macOS 版本研究预览版推出。目前仅限 Claude Max 订阅者使用,未来计划扩展到 Windows 和跨设备同步。Cowork 继承了 Claude Code 的核心代理能力,但更注重非开发者用户的日常生产力任务,例如访问用户指定的文件夹,读取、编辑或创建文件,帮助整理杂乱下载、从截图生成电子表格,或从笔记起草报告。

2026/01/13 22:46:491,448
2022年了,Java和Java的生态怎么样了?

2022年了,Java和Java的生态怎么样了?

不久前,Java18发布,至此这款编程语言已经走过三十多年。随着近几年深度学习的发展,python已经开始霸榜编程语言,Java的流行度似乎下降很多。那么,如今的Java到底是什么状态,未来它的方向在哪?近期,JRebel对中大型企业技术人员的访谈,给我们一些指引和回答。

2022/03/31 22:13:141,450
人工智能颠覆影响者营销的八种方式

人工智能颠覆影响者营销的八种方式

影响者营销将是极好的机会,可以使你的形象更加完善,并接触到新的受众,是一个人性化的宏伟机会?的确如此。它是否充满了影响者和品牌宁愿不管理的问题?同样地,是的。

2021/11/11 09:13:441,459
大模型新王者!谷歌发布Gemini 3.0 Pro,各方面评测几乎都是第一,全球首个大模型匿名投票得分超1500分的模型,支持100万输入上下文!

大模型新王者!谷歌发布Gemini 3.0 Pro,各方面评测几乎都是第一,全球首个大模型匿名投票得分超1500分的模型,支持100万输入上下文!

谷歌终于在2025年11月18日发布了新一代Gemini 3模型:Gemini 3.0 Pro。该模型目前在各个评测排行榜中都获得了非常优秀的结果,几乎是领先了所有的模型。而根据此前大家的匿名投票评分和早期测试,该模型的文本生成、编程、SVG生成等方面都非常优秀。谷歌官方强调,Gemini 3.0 Pro不仅在推理能力上达到了新的业界巅峰,更在理解深度、细微差别以及“思考”能力上实现了质的飞跃。

2025/11/19 09:24:471,461
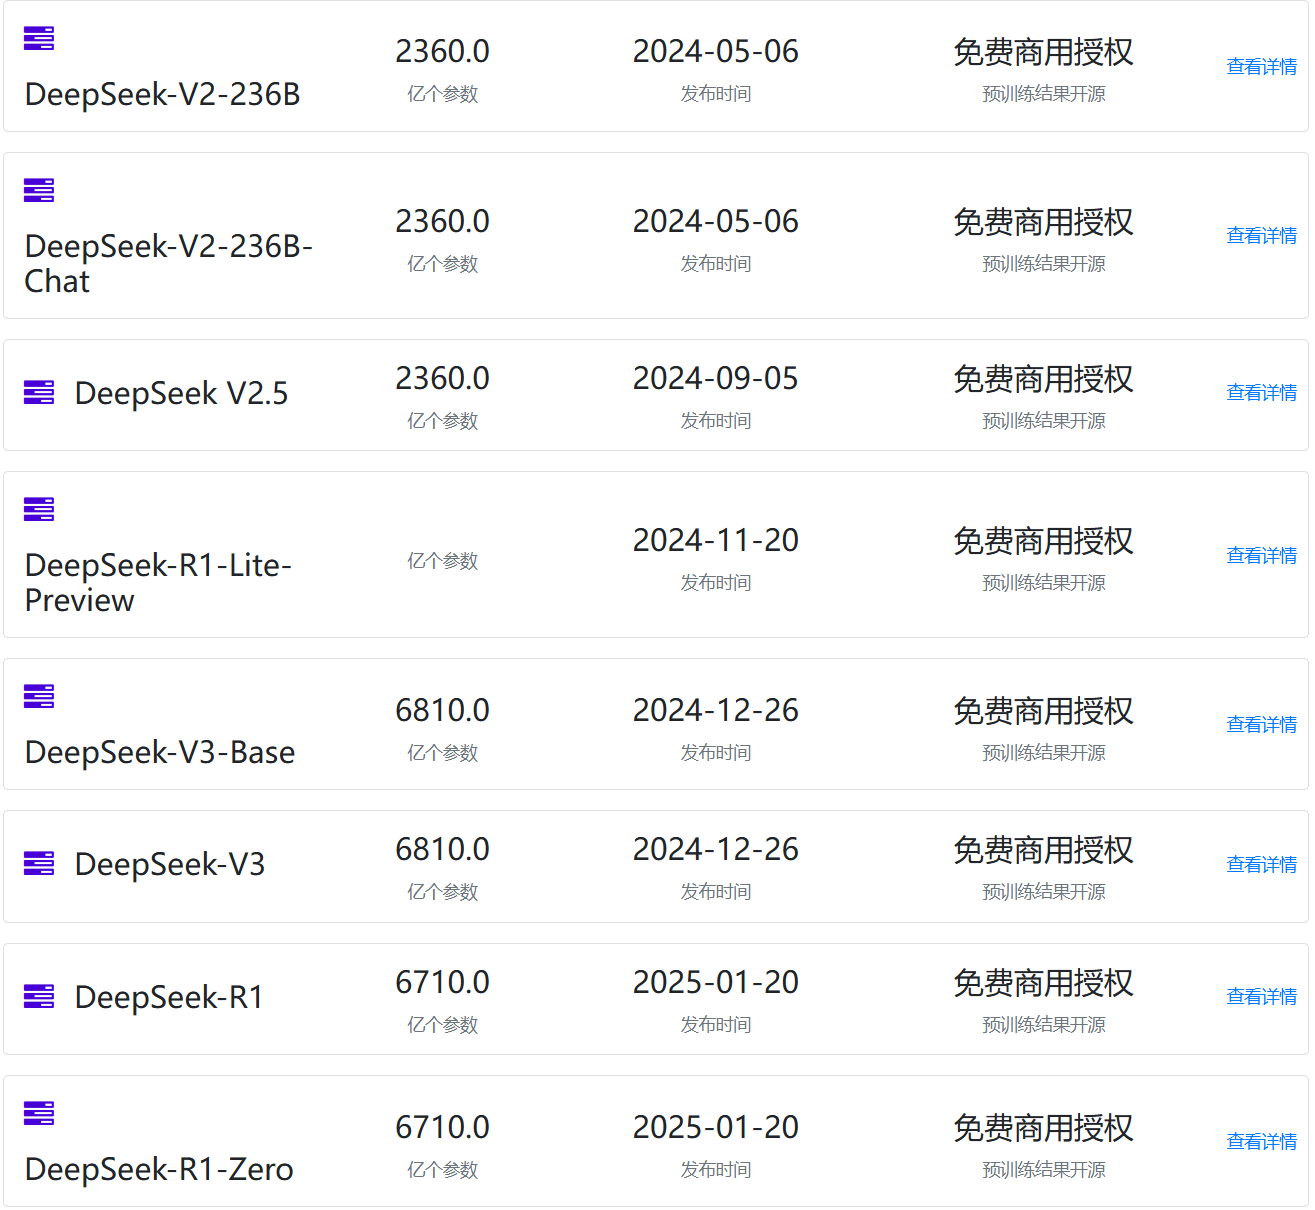
20条关于DeepSeek的FAQ解释DeepSeek发布了什么样的模型?为什么大家如此关注这些发布的模型?他们真的绕过CUDA限制,打破了Nvidia的护城河了吗?

20条关于DeepSeek的FAQ解释DeepSeek发布了什么样的模型?为什么大家如此关注这些发布的模型?他们真的绕过CUDA限制,打破了Nvidia的护城河了吗?

DeepSeekAI最近发布的几个模型,如DeepSeek V3、DeepSeek R1等引起了全球的广泛关注和讨论,特别是低成本训练出高质量模型之后,引起了很多的争论。引起了大家对OpenAI、英伟达等公司未来的质疑。然而,对于DeepSeekAI的模型为什么引起了如此广泛的关注,以及大家讨论的核心内容是什么,很多人并不是很清楚。本文基于著名的独立科技行业分析师Ben Thompson的总结,配合DataLearnerAI的分析,为大家总结DeepSeek引起的全球讨论。

2025/02/02 17:33:131,462
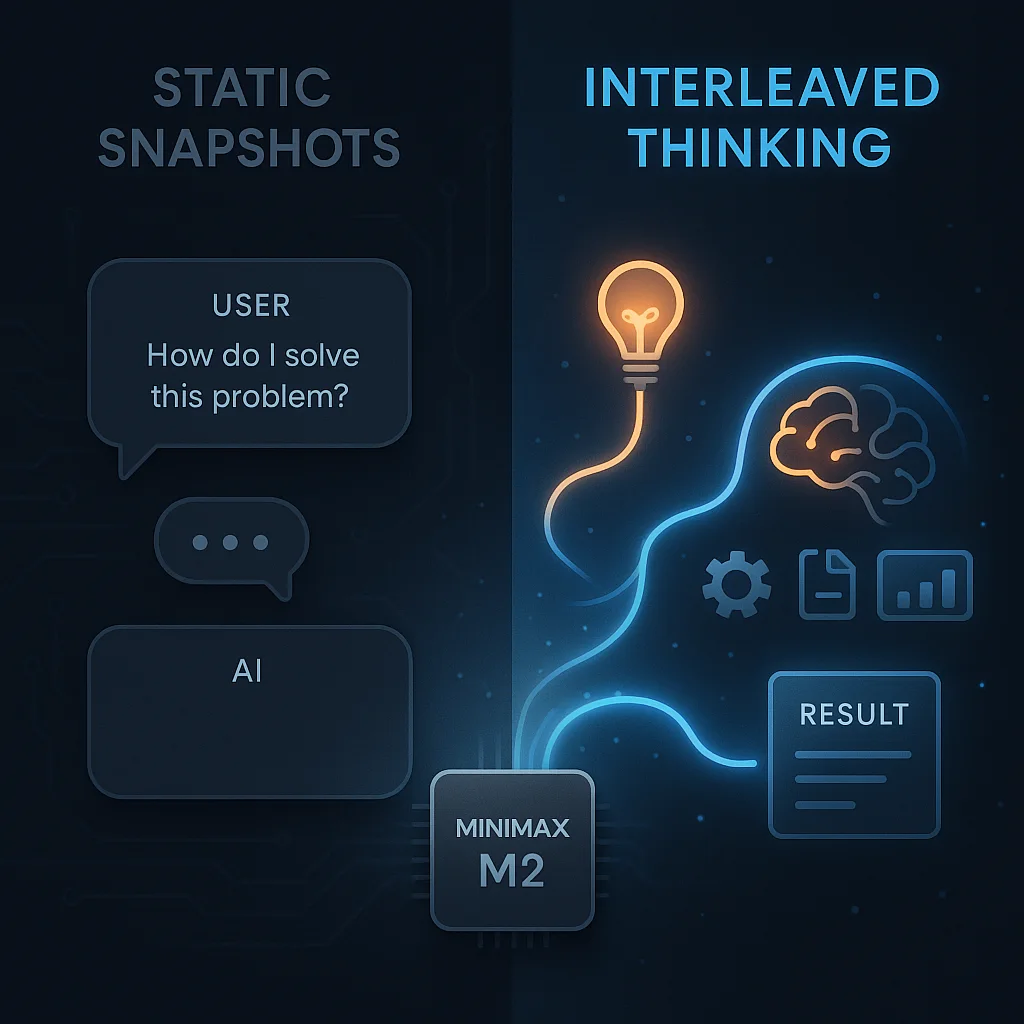
你的MiniMax M2模型效果为什么不好?可能是用错了,官方建议正确使用Interleaved Thinking,模型效果最多可提升35%的效果

你的MiniMax M2模型效果为什么不好?可能是用错了,官方建议正确使用Interleaved Thinking,模型效果最多可提升35%的效果

MiniMax M2发布2周后已经成为OpenRouter上模型tokens使用最多的模型之一。已经成为另一个DeepSeek现象的大模型了。然而,实际使用中,很多人反馈说模型效果并不好。而此时,官方也下场了,说当前大家使用MiniMax M2效果不好的一个很重要的原因是没有正确使用Interleaved Thinking。正确使用Interleaved thinking模式,可以让MiniMax M2模型的效果最多可以提升35%!本文我们主要简单聊聊这个Interleaved thinking。

2025/11/05 22:34:281,466
个人网站申请免费ssl证书最靠谱的办法

个人网站申请免费ssl证书最靠谱的办法

如今,不支持https的网站基本都无法访问,https网站需要在服务端保存ssl证书才可以建立。这个原理本文不多说。目前,各大云服务厂商也提供ssl证书的发放和管理,但都是收费的。对于个人网站来说,基于第三方的服务申请免费证书其实是合适的。但是,国内申请证书并不好用。本文主要记录一个最简单的免费证书申请安装方法。

2023/05/21 15:08:401,474
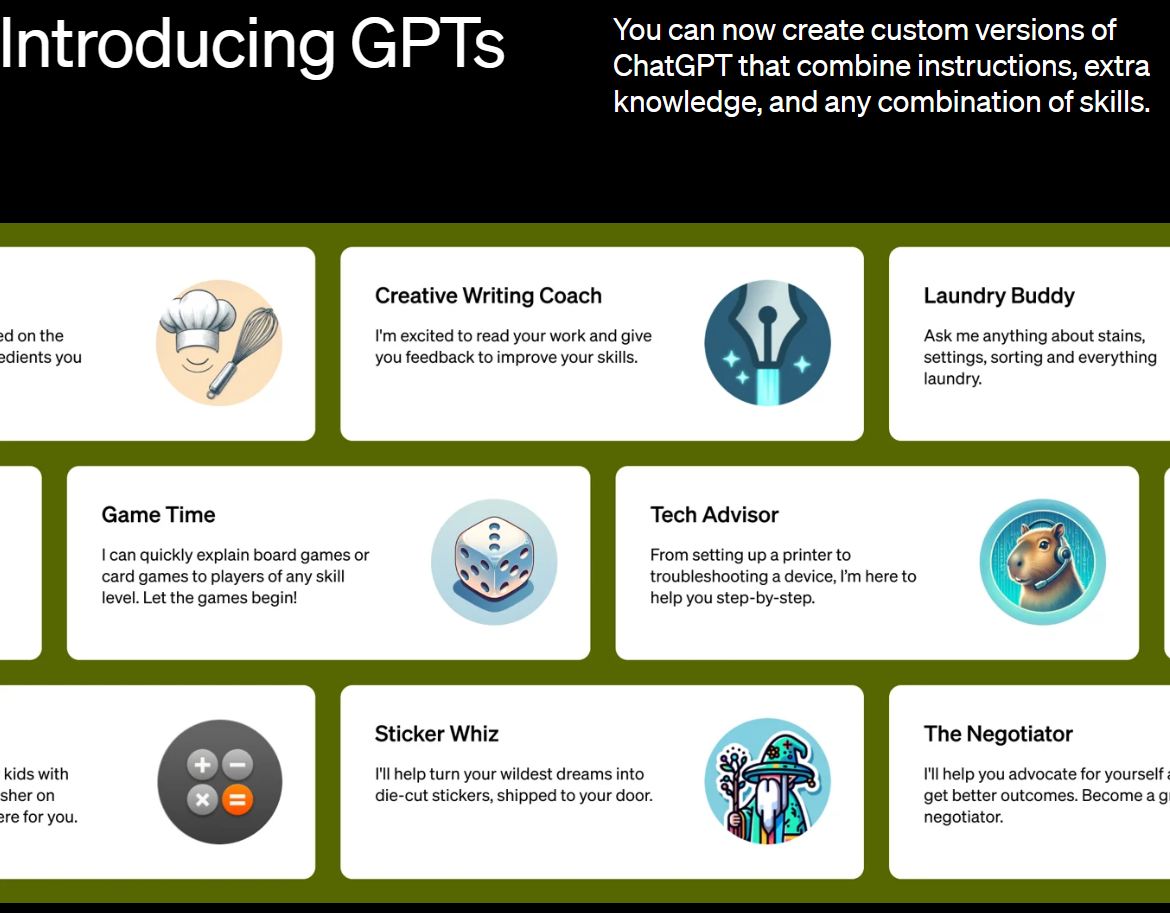
OpenAI发布2周后有哪些GPTs受欢迎?访问量如何?GPTs两周数据分析

OpenAI发布2周后有哪些GPTs受欢迎?访问量如何?GPTs两周数据分析

GPTs是OpenAI在其开发者日发布的一项最新的个性化GPT功能。所有人可以基于现有的GPT-4,配合网络流量、文件访问等功能,上传自己的数据,对接自己的接口来构建个性化的GPT,并对外提供服务。那么,2周后的今天GPTs的发展怎么样?有哪些受欢迎的GPTs被大量使用?本文结合各方数据介绍一下当前GPTs的情况。

2023/11/20 00:18:181,477
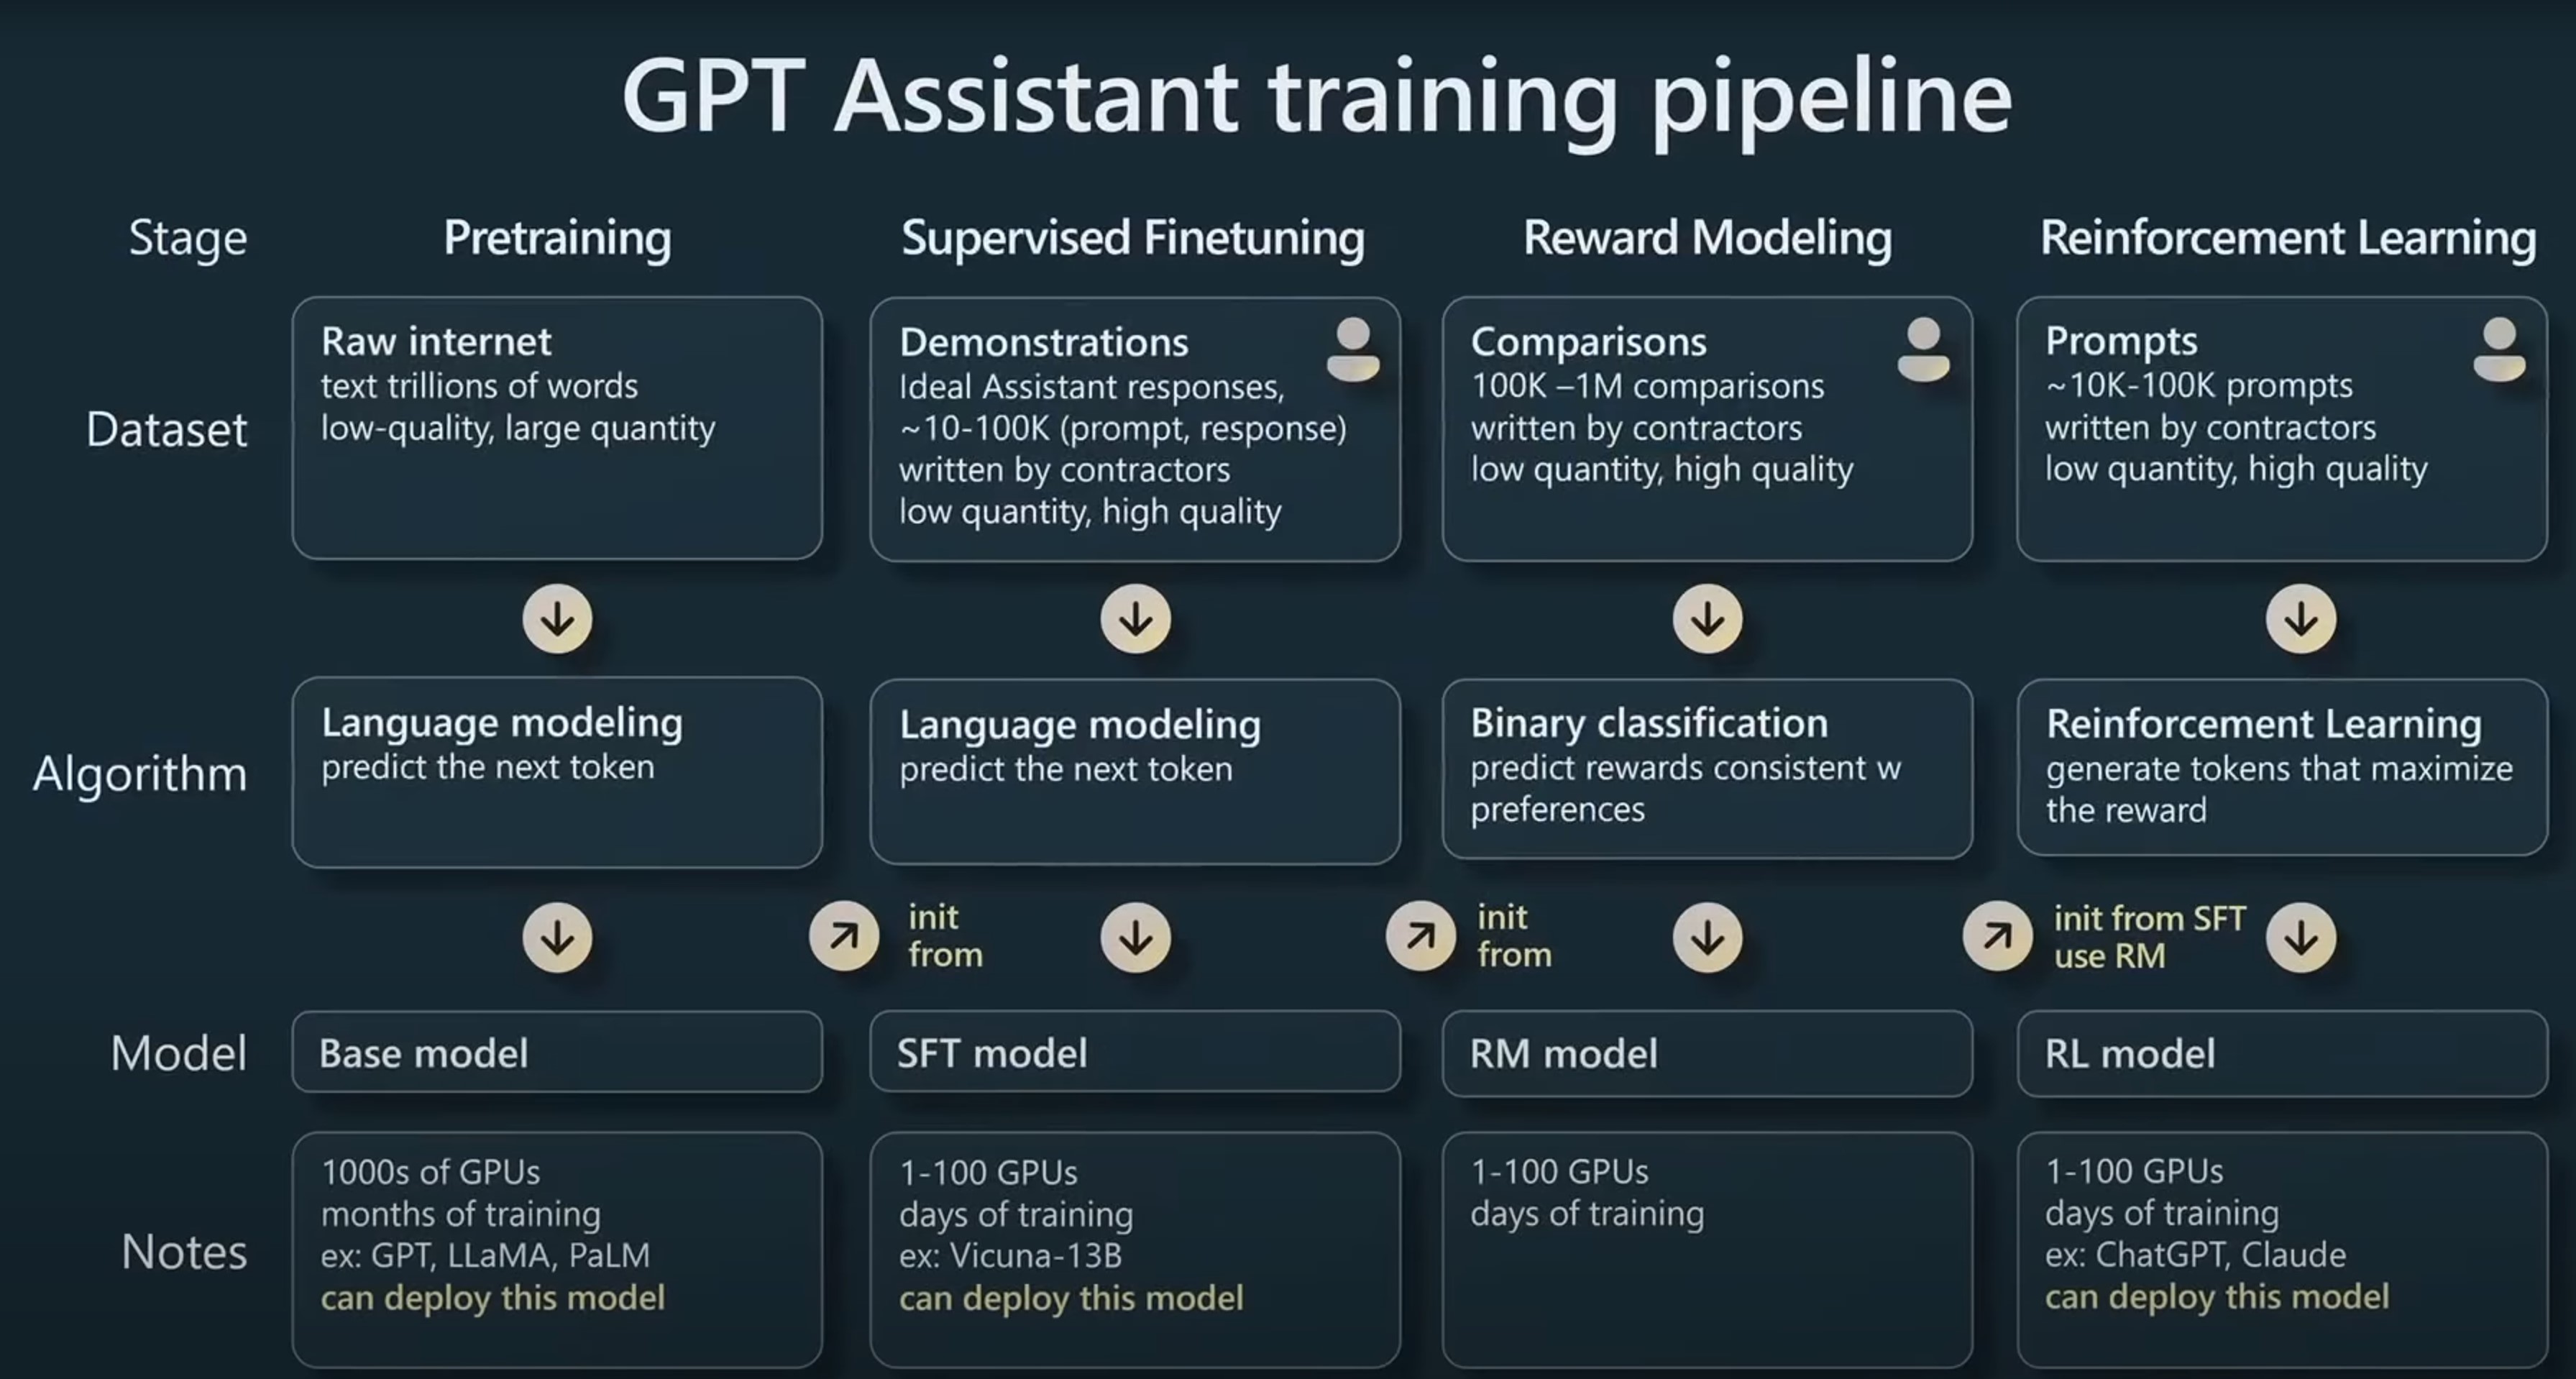
如何训练一个大语言模型?当前基于transformer架构的大语言模型的通用训练流程介绍

如何训练一个大语言模型?当前基于transformer架构的大语言模型的通用训练流程介绍

在当今的人工智能领域,大型语言模型(LLM)已成为备受瞩目的研究方向之一。它们能够理解和生成人类语言,为各种自然语言处理任务提供强大的能力。然而,这些模型的训练不仅仅是将数据输入神经网络,还包括一个复杂的管线,其中包括预训练、监督微调和对齐三个关键步骤。本文将详细介绍这三个步骤,特别关注强化学习与人类反馈(RLHF)的作用和重要性。

Pika和HeyGen的开源替代品:上海人工智能实验室开源可以生成高质量最长61秒视频的LaVie文本生成视频大模型

Pika和HeyGen的开源替代品:上海人工智能实验室开源可以生成高质量最长61秒视频的LaVie文本生成视频大模型

最近,初创企业Pika引起了全球的目光。这家公司发布的Pika 1.0产品可以基于生成式AI技术来创建3D动画视频或者电影级别的视频。由于其逼真的效果,引起了很多人的关注。本文则介绍一个由上海人工智能实验室开源的文本生成视频大模型LaVie。这个模型可以根据文本生成高质量的视频内容。

2023/12/05 21:49:091,500
Python编程环境搭建——小白起步教程!

Python编程环境搭建——小白起步教程!

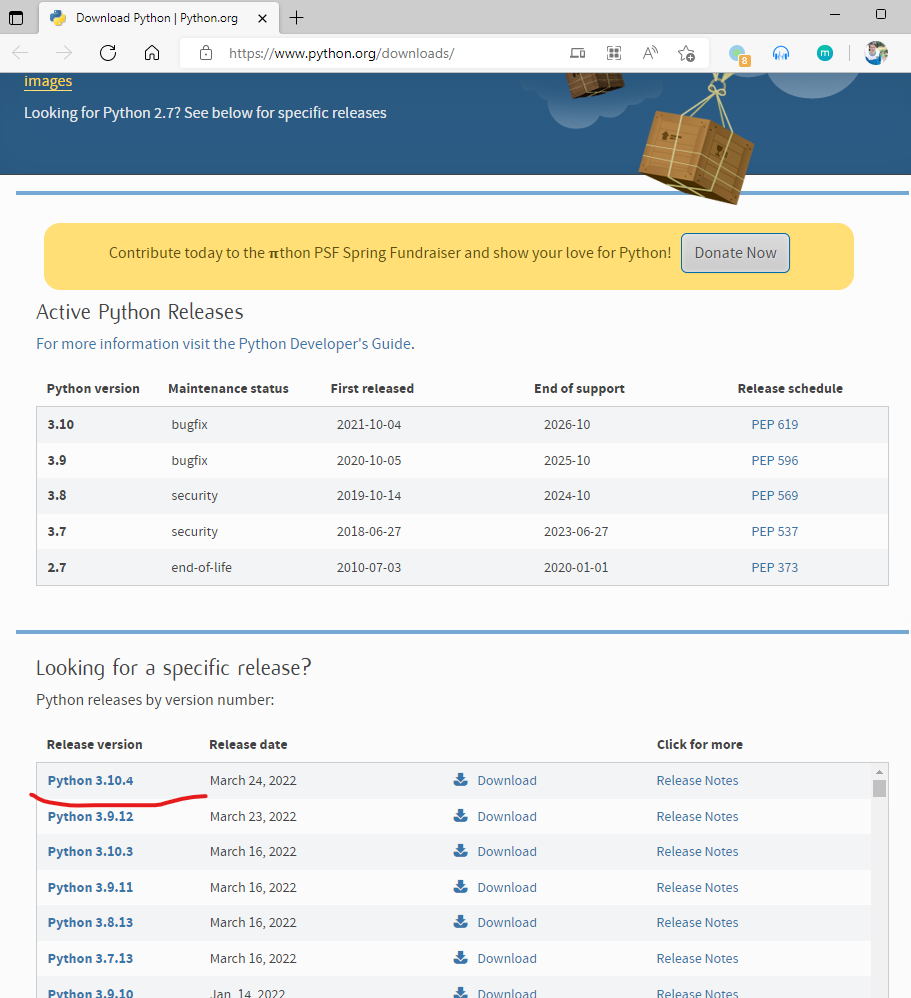
Python作为目前最流行的编程语言,因为其易用性以及丰富的库成为很多人的工具。它不仅是程序员的编程语言,也是各行各业提升工作效率的工具。本篇博客作为一篇针对完全小白的python语言搭建环境,不会为python语言本身做介绍,完全只考虑搭建python编程环境,目的是让你动手在电脑上写下第一行python程序,并成功运行,为广大童鞋提供一个入门参考。

2022/05/06 21:43:201,506
最近很火的基于人工智能(AI)的vibe coding是什么?它和传统软件编码之间有什么区别?

最近很火的基于人工智能(AI)的vibe coding是什么?它和传统软件编码之间有什么区别?

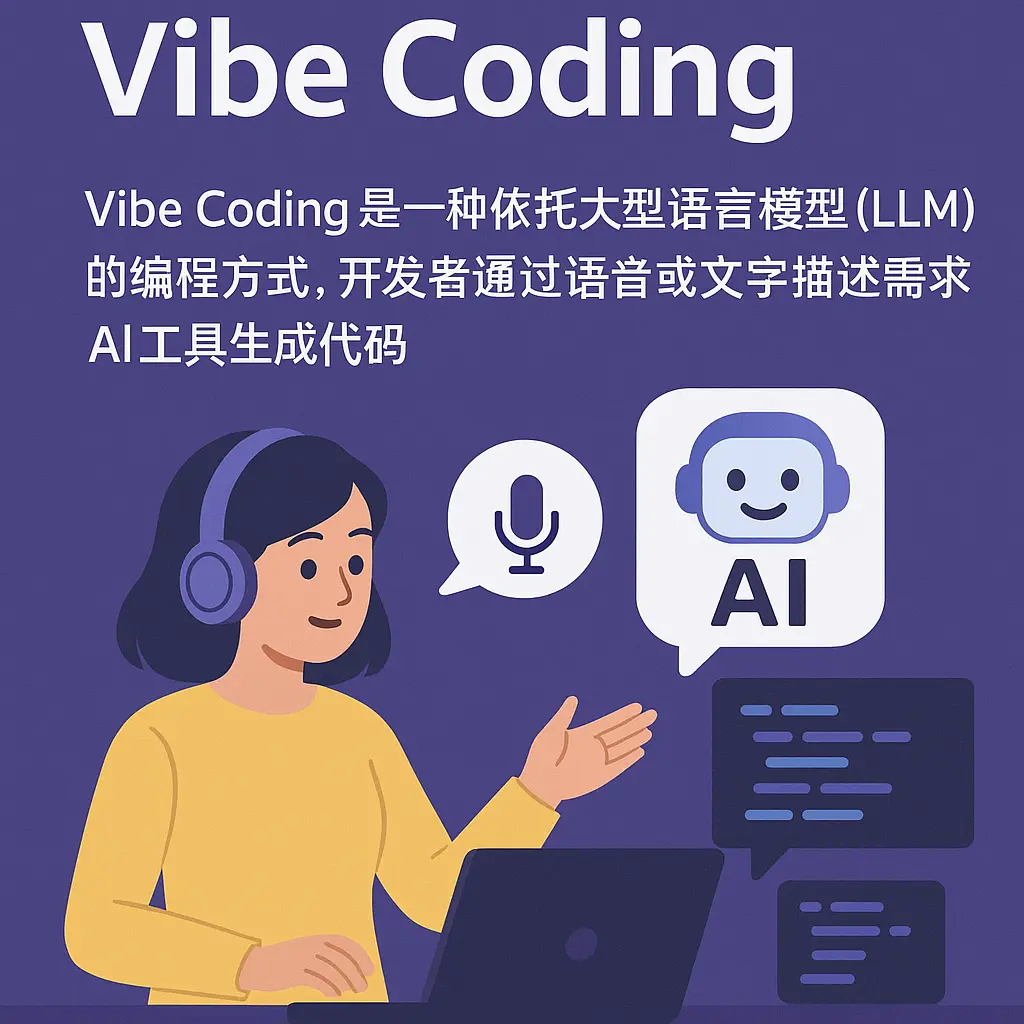
“Vibe Coding”(氛围编程)是一种新兴的编程范式,强调通过自然语言与人工智能(AI)协作开发软件。该概念由前 OpenAI 研究员 Andrej Karpathy 于 2025 年提出,旨在让开发者沉浸于创作氛围中,利用 AI 的能力,将自然语言描述转化为实际源代码,从而简化编程过程。

2025/06/08 20:56:211,515
如何基于Gradio构建生成式AI的应用:吴恩达联合HuggingFace推出最新1小时短课

如何基于Gradio构建生成式AI的应用:吴恩达联合HuggingFace推出最新1小时短课

ChatGPT是属于生成式AI的一种应用。由于其强大的效果已经变成了当前最主流的一种AI方案。而构建生成式AI应用的一个重要方向是构建友好的web形态的demo让用户能快速体验。Gradio就是这样一种开源方案,也是当前最流行的一种快速构建AI Web应用的方案。昨天吴恩达的DeepLearningAI与HuggingFace共同推出了最新的一期短课程《Building Generative AI Applications with Gradio》,教大家如何使用Gradio快速构建生成式AI的应用。

2023/07/27 09:56:251,516
重磅!MetaAI开源4050亿参数的大语言模型Llama3.1-405B模型!多项评测结果超越GPT-4o,与Claude-3.5 Sonnet平分秋色!

重磅!MetaAI开源4050亿参数的大语言模型Llama3.1-405B模型!多项评测结果超越GPT-4o,与Claude-3.5 Sonnet平分秋色!

Llama系列大语言模型是由MetaAI开源的一系列大语言模型。作为最早开源的大语言模型,Llama系列对大模型开源社区的推动有目共睹。而现在MetaAI开源Llama3.1系列模型,其中包括迄今为止最大规模的开源大语言模型Llama3.1-405B,参数规模达到了4050亿!其多项评测结果超过GPT-4、GPT-4o模型,与Claude3.5-Sonnet几乎有来有回!

2024/07/24 00:10:361,521
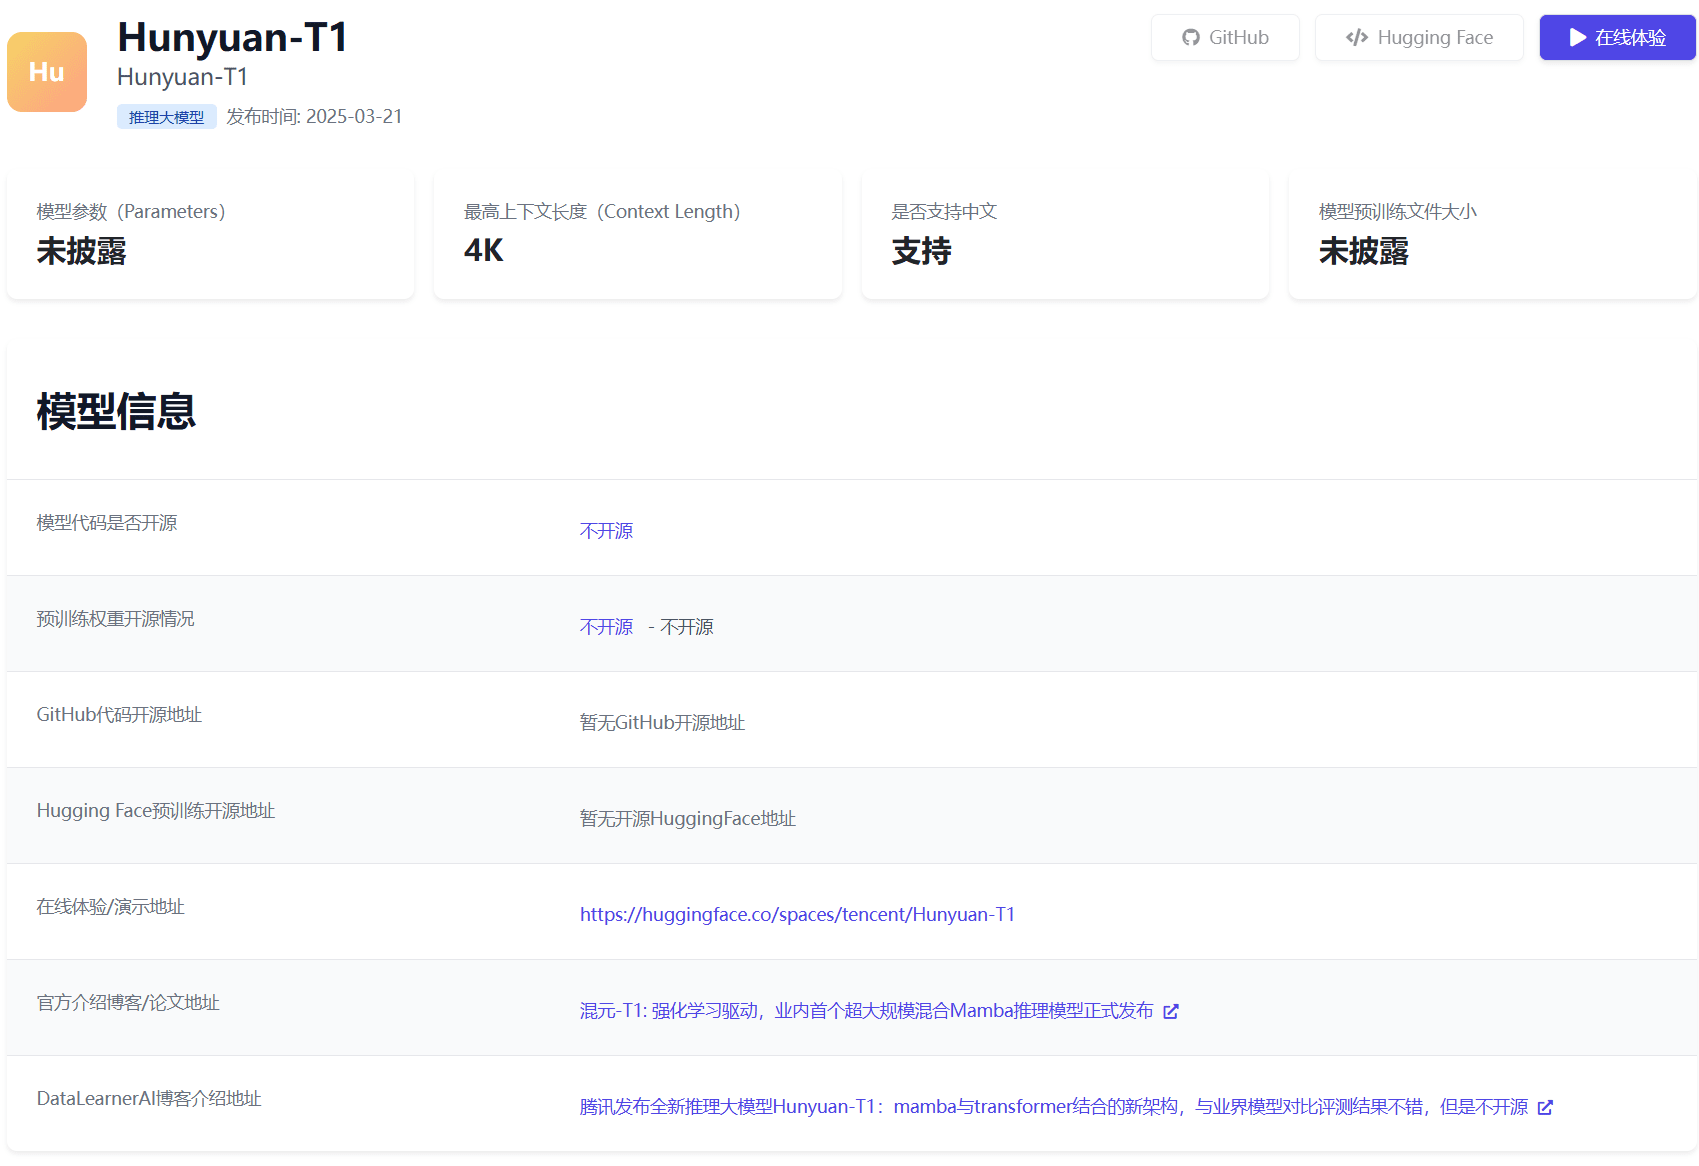
腾讯发布全新推理大模型Hunyuan-T1:mamba与transformer结合的新架构,与业界模型对比评测结果不错,但是不开源

腾讯发布全新推理大模型Hunyuan-T1:mamba与transformer结合的新架构,与业界模型对比评测结果不错,但是不开源

2025年3月21日,腾讯正式推出其全新大模型**Hunyuan-T1**,该模型基于此前发布的TurboS快速思维基座,首次采用**Hybrid-Transformer-Mamba混合专家架构(MoE)**,在推理效率、长文本处理及资源消耗优化等方面表现还不错。此外,这个新架构也使得Hunyuan-T1速度非常快,模型支持首字符1秒内响应,生成速度达60-80 token/秒,适用于实时交互场景。

2025/03/22 11:43:191,526
CerebrasAI开源可以在iPhone上运行的30亿参数大模型:BTLM-3B-8K,免费可商用,支持最高8K上下文输入,仅需3GB显存

CerebrasAI开源可以在iPhone上运行的30亿参数大模型:BTLM-3B-8K,免费可商用,支持最高8K上下文输入,仅需3GB显存

大模型的进展非常快,但是如何在移动端部署和使用依然是一个非常大的挑战。今天,CerebrasAI联合Opentensor一起开源了一个30亿参数规模的模型BTLM-3B-8K,官方宣称其性能接近70亿参数规模的大模型,但是运行的资源却很低,最低量化版本只需要不到4GB显存即可。

2023/07/25 17:10:341,534