DataLearner 标志
标签

「G」相关文章(第3页)

汇总「G」相关的原创 AI 技术文章与大模型实践笔记,持续更新。

标签:#G
如何在HuggingFace上快速下载DeepSeek-OCR模型?快速下载Hugging Face 大模型的几种实用方法简介

如何在HuggingFace上快速下载DeepSeek-OCR模型?快速下载Hugging Face 大模型的几种实用方法简介

在AI时代,Hugging Face Hub已成为开源大语言模型(LLM)和预训练模型的宝库。从Qwen到DeepSeek系列,这些模型往往体积庞大(几GB甚至上百GB),下载过程容易受网络波动影响,导致中断、重试或失败。作为一名AI从业者,你可能不止一次遇到过“下载到99%就崩”的尴尬。本文将从客观角度,基于实际使用经验,介绍四种常见下载Hugging Face大模型的方法:从基础的Git克隆,到CLI工具、Transformers库,再到国内镜像加速。每种方法都有其适用场景和优缺点,我们将逐一剖析,帮
2025/10/26 20:45:041,115
如何让你的Agent更快,支持更多上下文?Anthropic发布Skills:专为AI Agent系统打造的专业领域工具规范,MCP强大的补充,更低的门槛和资源消耗

如何让你的Agent更快,支持更多上下文?Anthropic发布Skills:专为AI Agent系统打造的专业领域工具规范,MCP强大的补充,更低的门槛和资源消耗

Anthropic 正式推出全新功能 Claude Skills,旨在让通用 AI 代理(Agent)具备专业领域能力。该功能允许用户通过创建包含 SKILL.md 文件的技能文件夹,为 Claude 注入可执行脚本、模板与资源,实现 Excel 处理、PPT 生成等特定任务的自动化操作。与传统提示词不同,Skills 采用结构化加载与本地沙箱执行机制,兼顾安全性与效率。

2025/10/17 13:12:331,901
如何评估大模型的Agent能力?τ²-Bench:评估双控对话智能体的新标准

如何评估大模型的Agent能力?τ²-Bench:评估双控对话智能体的新标准

为了解决大模型的Agent操作依赖交互和人工处理这个问题,普林斯顿大学与 Sierra Research 的研究团队在 2025 年 6 月提出了 τ²-Bench(Tau-Squared Benchmark),并发布了论文《τ²-Bench: Evaluating Conversational Agents in a Dual-Control Environment》。 它是对早期 τ-Bench 的扩展版本,旨在建立一种标准化方法,评估智能体在与用户共同作用于环境时的表现。

直接使用大模型通过界面来操作电脑和浏览器:谷歌发布Gemini 2.5 Computer Use 模型,重塑 AI 与界面交互能力,实测优秀~

直接使用大模型通过界面来操作电脑和浏览器:谷歌发布Gemini 2.5 Computer Use 模型,重塑 AI 与界面交互能力,实测优秀~

就在昨天,2025年10月7日,Google DeepMind 正式发布其最新模型——Gemini 2.5 Computer Use。该模型基于 Gemini 2.5 Pro 的视觉理解与推理能力,新增了“界面交互(UI 控制)”能力,能够在浏览器或移动端界面上像人类那样点击、输入、滚动、选择控件等操作。

2025/10/08 22:15:371,116
如何快速五分钟就能了解GitHub中一个项目的代码架构和逻辑:智谱类DeepResearch的大模型产品Zread介绍,GitHub仓库解读神器

如何快速五分钟就能了解GitHub中一个项目的代码架构和逻辑:智谱类DeepResearch的大模型产品Zread介绍,GitHub仓库解读神器

智谱AI于2025年7月发布了Zread。这款产品能够利用其大模型能力,结合类似Deep Research的Agent技术,对GitHub项目进行深度解读和问答。其价值在于将强大的模型能力通过优秀的工程化设计,变成了一个真正“好用”的工具。它解决的正是那种“代码就在那里,但我就是看不懂”的尴尬,这种体验是单纯聊天机器人无法替代的。

2025/09/27 20:55:06910
阿里一次发布3款Qwen大模型:开源的全模态Qwen3-Omni和图像编辑大模型Qwen-Image-Edit-2509和不开源的语音识别大模型Qwen3-TTS

阿里一次发布3款Qwen大模型:开源的全模态Qwen3-Omni和图像编辑大模型Qwen-Image-Edit-2509和不开源的语音识别大模型Qwen3-TTS

几个小时前,阿里一次更新了3个大模型,分别是开源的全模态大模型Qwen3-Omni、开源的图像编辑大模型Qwen3-Image-Edit和不开源的语音识别大模型Qwen3-TTS。本次发布的3个模型均为多模态大模型,可以说阿里的大模型真的是全面开花,节奏很快!

2025/09/23 09:40:47911
大模型速度、效果与价格的完美结合?xAI发布Grok 4 Fast:性能接近Grok 4,成本降 98%,生成速度翻倍!

大模型速度、效果与价格的完美结合?xAI发布Grok 4 Fast:性能接近Grok 4,成本降 98%,生成速度翻倍!

xAI 正式发布 Grok 4 Fast —— 一款以 极致性价比与前沿性能 为核心卖点的新一代推理模型。相比前代产品,它不仅在推理准确率上几乎与旗舰模型Grok 4等持平,还凭借 40%更高的推理效率 和 高达98%的成本降低,将高质量智能推理真正带入大众用户和企业应用场景。

2025/09/21 21:09:22976
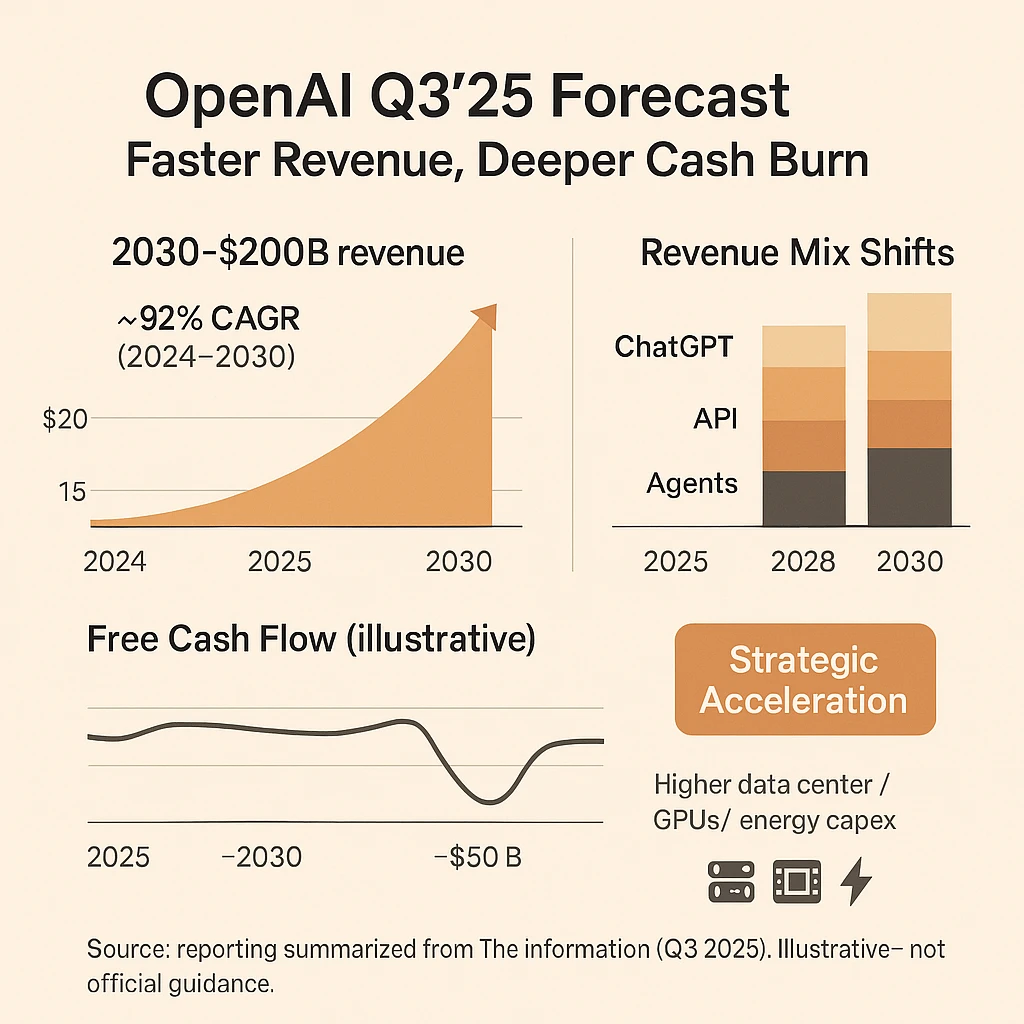
OpenAI收入大揭秘:2024年收入40亿美金,2030年预计达到2000亿,年均复合增长超90%!ChatGPT占比将逐年下降!

OpenAI收入大揭秘:2024年收入40亿美金,2030年预计达到2000亿,年均复合增长超90%!ChatGPT占比将逐年下降!

根据TheInformaiton的披露,近期OpenAI更新了他们最新财务预测(截至2025年第三季度)。这份收入预测展示了当前OpenAI的收入情况,并描绘了一幅引人注目的未来图景。与2025年第一季度OpenAI自己的预测相比,新数据不仅上调了收入预期,也揭示了公司因基础设施投入而面临的巨大现金消耗压力。本文将简单解读一下这份数据,包括OpenAI的收入情况,不同产品占比,如ChatGPT的比重等。

2025/09/06 20:21:001,701
Moonshot AI发布Kimi K2-Instruct-0905:256K上下文长度加持,全面升级的开放式智能体模型

Moonshot AI发布Kimi K2-Instruct-0905:256K上下文长度加持,全面升级的开放式智能体模型

今日,Moonshot AI正式发布了最新旗舰模型 Kimi K2-Instruct-0905。这是一款基于混合专家架构(MoE)的前沿大语言模型,总参数规模达到 1万亿,激活参数为 320亿,不仅在编码智能上实现了断层式提升,更凭借 256K超长上下文 成为当前同类产品中的佼佼者。官方称其在公共基准和真实智能体任务上的表现均有显著突破,已对标并超越部分国际顶尖模型。

2025/09/06 04:23:041,145
语音大模型正式进入Voice Agent时代!OpenAI发布GPT Realtime模型,可以直接调用接口和工具进行实时语音对话!

语音大模型正式进入Voice Agent时代!OpenAI发布GPT Realtime模型,可以直接调用接口和工具进行实时语音对话!

就在几个小时前,OpenAI 发布了全新的 GPT Realtime 大模型。这是一个 Speech-to-Speech(S2S)模型,能通过单个模型与 API完成从音频输入到音频输出的全流程,显著降低交互延迟并充分保留语音细节。 GPT Realtime 以“端到端语音理解—推理—合成”为核心路径,解决了传统“识别—推理—合成”多阶段带来的延迟与风格割裂问题。

2025/08/29 04:27:25861
来自OpenAI官方的GPT-5编码提示词优化实践:6 条“更懂开发者”的提示工程技巧

来自OpenAI官方的GPT-5编码提示词优化实践:6 条“更懂开发者”的提示工程技巧

GPT-5 在指令遵循和推理能力上比前代更强,但也因此更“敏感”:如果规则里有冲突或表述过度强硬,模型往往会卡壳或输出异常。为此,OpenAI 发布了面向开发者的 《GPT-5 for Coding》技巧小抄,其中总结了使用 GPT-5 进行编程与代码生成时最实用的六条经验。这些技巧与普通的“写作提示工程”不同,它们专门针对软件开发场景:如何写规则、怎样控制推理强度、如何避免模型“想太多”,以及怎样利用 GPT-5 的新特性把它真正驯化成可靠的结对编程伙伴。本文对这六条技巧逐条进行解释总结。

2025/08/16 21:48:20835
GPT-5 模式与配额全解析:自动与手动 Thinking 的区别、不同用户的使用配额问题等

GPT-5 模式与配额全解析:自动与手动 Thinking 的区别、不同用户的使用配额问题等

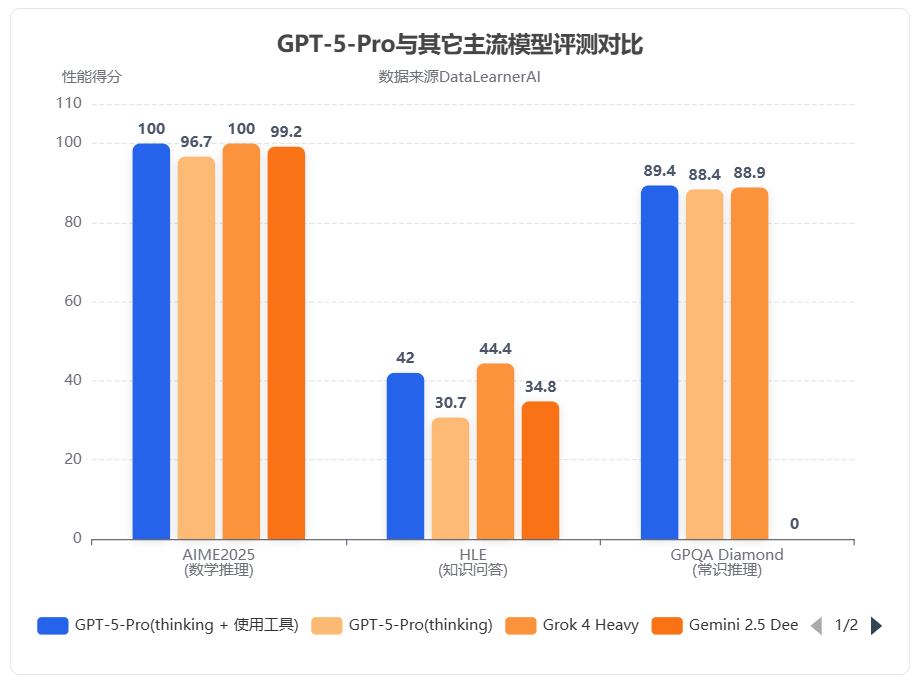
GPT-5 在 ChatGPT 中引入了“自动在普通/推理间切换”的机制,但模式命名、配额规则和速率限制让许多用户困惑。本文梳理不同模式的作用、是否计入推理配额、各订阅层的可用性与限制、旧模型的替换规则,并提供三步配额优化策略。特别提示:编码与大上下文任务应优先使用 GPT-5 Thinking(≈196k 上下文),而普通 Chat 模式上下文为 32k。

2025/08/12 22:51:123,605
智谱AI发布GLM-4.5V多模态推理模型

智谱AI发布GLM-4.5V多模态推理模型

智谱AI刚刚开源了新一代视觉-语言模型(Vision-Language Model, VLM)——GLM-4.5V。该模型基于其旗舰文本基础模型GLM-4.5-Air(总参数量1060亿,激活参数量120亿),延续GLM-4.1V-Thinking的技术路线,在42项公开视觉多模态基准测试中,在同规模模型中实现领先性能。GLM-4.5V面向图像、视频、文档理解以及GUI任务等常见多模态场景,采用Mixture-of-Experts(MoE)架构,并保持开源。

2025/08/11 23:28:481,129
xAI发布Grok Imagine功能,一条文本命令即可生成图片和最长达15秒的视频,也可以基于现有照片生成视频,免费用户也可以使用~

xAI发布Grok Imagine功能,一条文本命令即可生成图片和最长达15秒的视频,也可以基于现有照片生成视频,免费用户也可以使用~

Grok Imagine 是一个由 xAI 开发的创新功能,集成到 Grok AI 聊天机器人中,旨在让用户能够从文本和视觉命令快速生成图像和视频。Grok Imagine最大的特点是能够生成长达 15 秒的视频,带有同步音频,使其成为 OpenAI 的 Sora 和 Google 的 Veo 3 等工具的直接竞争者。此外,它还包括一个“Spicy”模式,允许生成成人或显式内容,这一点引发了伦理和潜在误用的争议。

2025/08/08 22:07:142,441
谷歌发布Genie 3:一个可以生成720P开启实时交互式虚拟世界生成新纪元

谷歌发布Genie 3:一个可以生成720P开启实时交互式虚拟世界生成新纪元

谷歌DeepMind发布了一个全新的大模型——Genie 3,这是一个能够根据文本描述生成多样化、可实时交互虚拟世界的通用世界模型。目前,Genie3可以生成几分钟的720P的视频,且每秒24帧左右。用户也可以在生成的视频中实时交互控制。从谷歌官方的视频看,这个Genie 3模型生成的视频和游戏世界的质量很高,非常令人心动!

2025/08/05 23:17:111,221
重磅!阿里开源媲美GPT-4o的图片生成和编辑大模型Qwen Image,中文渲染能力很强,还有精确的文字控制,免费开源!

重磅!阿里开源媲美GPT-4o的图片生成和编辑大模型Qwen Image,中文渲染能力很强,还有精确的文字控制,免费开源!

就在刚才,阿里开源了Qwen Image大模型,这是阿里千问团队开源的高质量图片生成和编辑的大模型。这份发布迅速在AI社区引起了广泛关注,其核心并非又一个单纯追求图像美学或真实感的模型,而是直指一个长期存在的行业痛点:在图像中进行复杂、精准、尤其是高保真的多语言文本渲染。

2025/08/05 08:23:391,393
Zhipu AI重磅发布GLM-4.5系列:技术深度解析与多维度性能评测

Zhipu AI重磅发布GLM-4.5系列:技术深度解析与多维度性能评测

7月28日,智谱AI(Zhipu AI)向开源社区投下了一枚重磅炸弹,正式发布了其最新的旗舰模型系列:GLM-4.5。该系列包含两个新成员——GLM-4.5和GLM-4.5-Air,两者均以开源权重形式提供。官方技术报告详细阐述了其设计理念、技术细节以及在多项基准测试中的表现。本次发布的核心目标是打造一个能够统一推理、代码和Agent智能体能力的模型,以应对日益复杂的AI应用需求。本文将深入解析这份官方报告,剖析其核心技术、性能表现,并探讨其在当前大模型竞争格局中的战略定位。

2025/07/29 11:06:251,785
如何评价大模型和AI Agent在命令行环境中执行工具解决任务的能力?Terminal Bench评测简介

如何评价大模型和AI Agent在命令行环境中执行工具解决任务的能力?Terminal Bench评测简介

Terminal-Bench是一个新兴的开源基准测试,专为评估人工智能Agent(AI Agent)在命令行终端环境中的实际操作能力而设计。它通过一系列模拟真实世界场景的复杂任务,旨在客观、可量化地衡量AI Agent在执行代码编译、服务器管理和数据处理等任务时的熟练程度与自主性。

2025/07/23 16:56:161,338