DataLearner 标志
原创博客

原创AI技术博客

探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。

三年后OpenAI再次发布自动语音识别和语音合成大模型(替换Whisper系列):不开源,仅提供API,英文错字率已经下降到2.46%

三年后OpenAI再次发布自动语音识别和语音合成大模型(替换Whisper系列):不开源,仅提供API,英文错字率已经下降到2.46%

2025年3月20日,OpenAI 推出了三款新模型——gpt-4o-transcribe、gpt-4o-mini-transcribe 和 gpt-4o-mini-tts——标志着自动语音识别 (ASR) 和文本转语音 (TTS) 领域的重要进步。这些模型基于 GPT-4o 架构,旨在为开发人员和用户提高准确性、自定义能力和可访问性,与 OpenAI 对于代理式 AI 系统的更广泛愿景一致。本文提供了对每个模型、其能力、定价、可用性和竞争环境的详细审查,确保技术和非技术受众都能全面理解。
2025/03/21 13:18:491,875
GPQA Diamond:评估专家级推理能力的问答基准

GPQA Diamond:评估专家级推理能力的问答基准

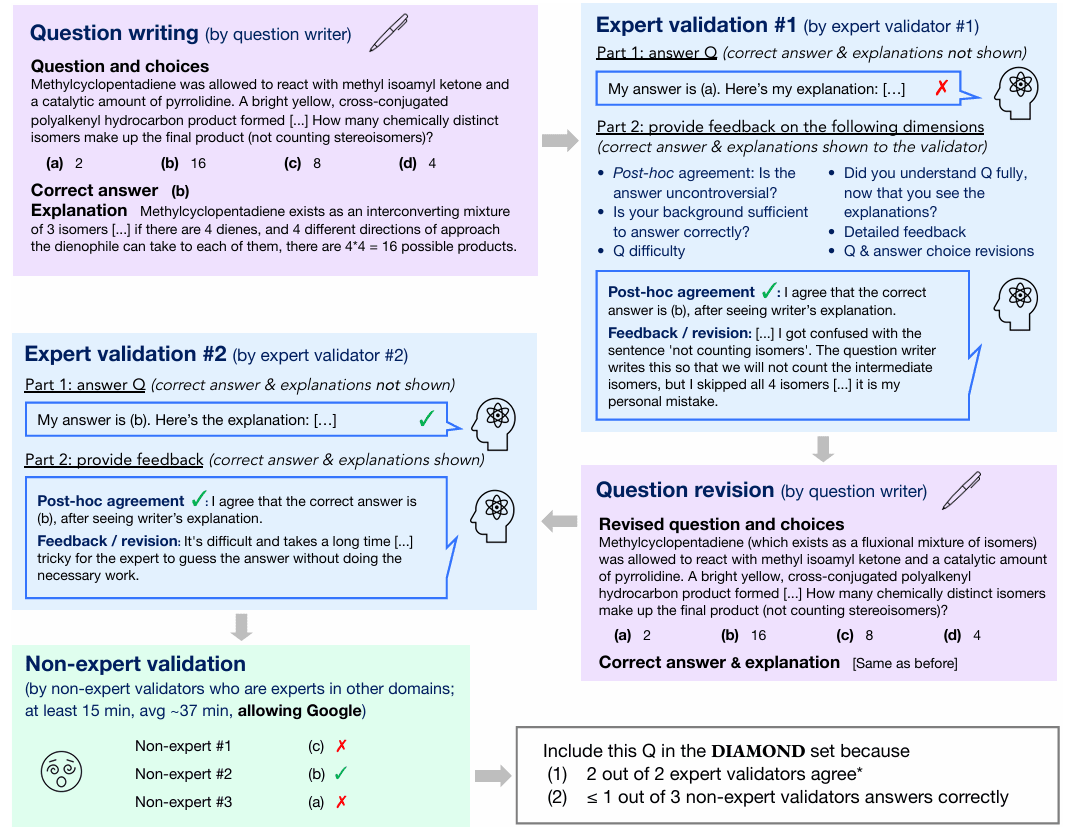
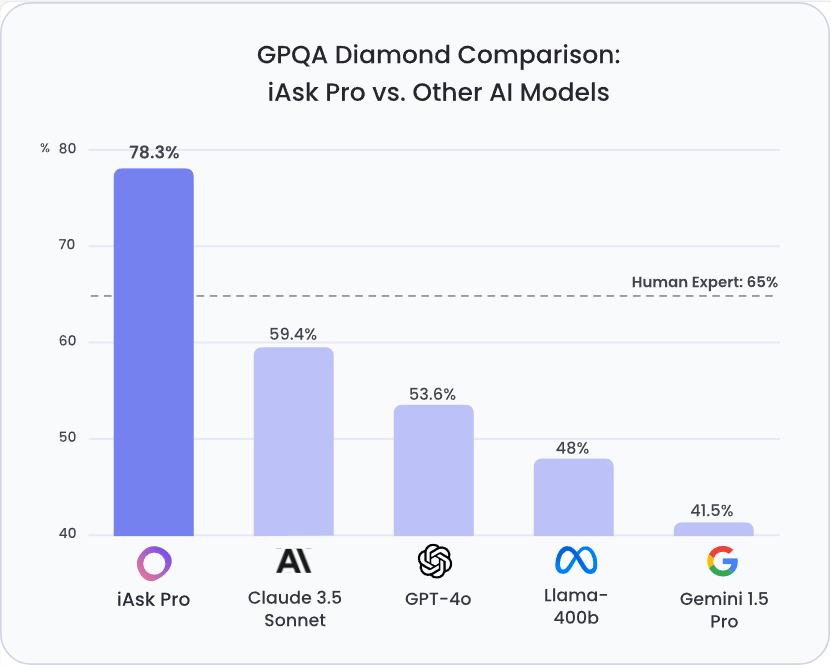
通用人工智能(AGI)的进步需要可靠的评估基准。GPQA (Grade-Level Problems in Question Answering) Diamond 基准旨在衡量模型在需要深度推理和领域专业知识问题上的能力。该基准由纽约大学、CohereAI 及 Anthropic 的研究人员联合发布,其相关论文可在 arXiv 上查阅 (https://arxiv.org/pdf/2311.12022 )。GPQA Diamond是GPQA系列中最高质量的评测数据,包含198条结果。

2025/03/20 17:34:133,879
MistralAI开源240亿参数的多模态大模型Mistral-Small-3.1-24B:评测结果与GPT-4o-mini与Gemma 3 27B有来有回,开源且免费商用,支持24种语言

MistralAI开源240亿参数的多模态大模型Mistral-Small-3.1-24B:评测结果与GPT-4o-mini与Gemma 3 27B有来有回,开源且免费商用,支持24种语言

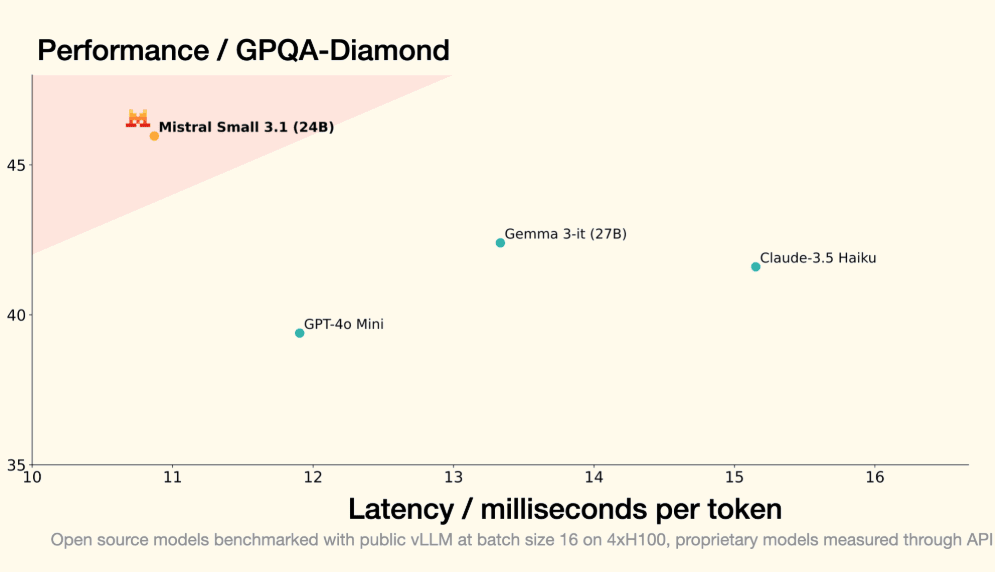
欧洲大模型之光MistralAI开源了2个全新的多模态大模型,即Mistral-Small-3.1-24B基座版本和指令微调版本。这两个大模型均以Apache2.0协议开源,因此可以完全免费商用。而官方也给出了这个模型在多个评测集上的效果,高于GPT-4o-mini和Gemma 3 27B。因为其参数规模较小,推理速度可以达到每秒150个tokens,同时支持多种语言,是一个非常值得关注的小而美的多模态大模型。

2025/03/18 16:41:501,190
GPQA: 可以防止使用谷歌作弊的研究生级别难度的大模型专业能力评测基准(A Graduate-Level Google-Proof Q&A Benchmark)

GPQA: 可以防止使用谷歌作弊的研究生级别难度的大模型专业能力评测基准(A Graduate-Level Google-Proof Q&A Benchmark)

研究生级别的 **Google 防查找问答基准测试**(即Graduate-Level Google-Proof Q&A Benchmark,简称 GPQA)是大型语言模型(LLM)面临的最具挑战性的评估之一。GPQA 旨在推动人工智能能力的极限,提供一个严格的测试平台,不仅评估模型的事实记忆能力,还考察其在专业科学领域的深度推理和理解能力。本篇博文将客观介绍 GPQA,涵盖它的起源、目的、组成部分,以及领先的大型语言模型在这个高要求基准测试中的表现。

2025/03/18 15:05:242,352
Google开源第三代Gemma-3系列模型:支持多模态、最多128K输入,其中Gemma 3-27B在大模型匿名竞技场得分超过了Qwen2.5-Max

Google开源第三代Gemma-3系列模型:支持多模态、最多128K输入,其中Gemma 3-27B在大模型匿名竞技场得分超过了Qwen2.5-Max

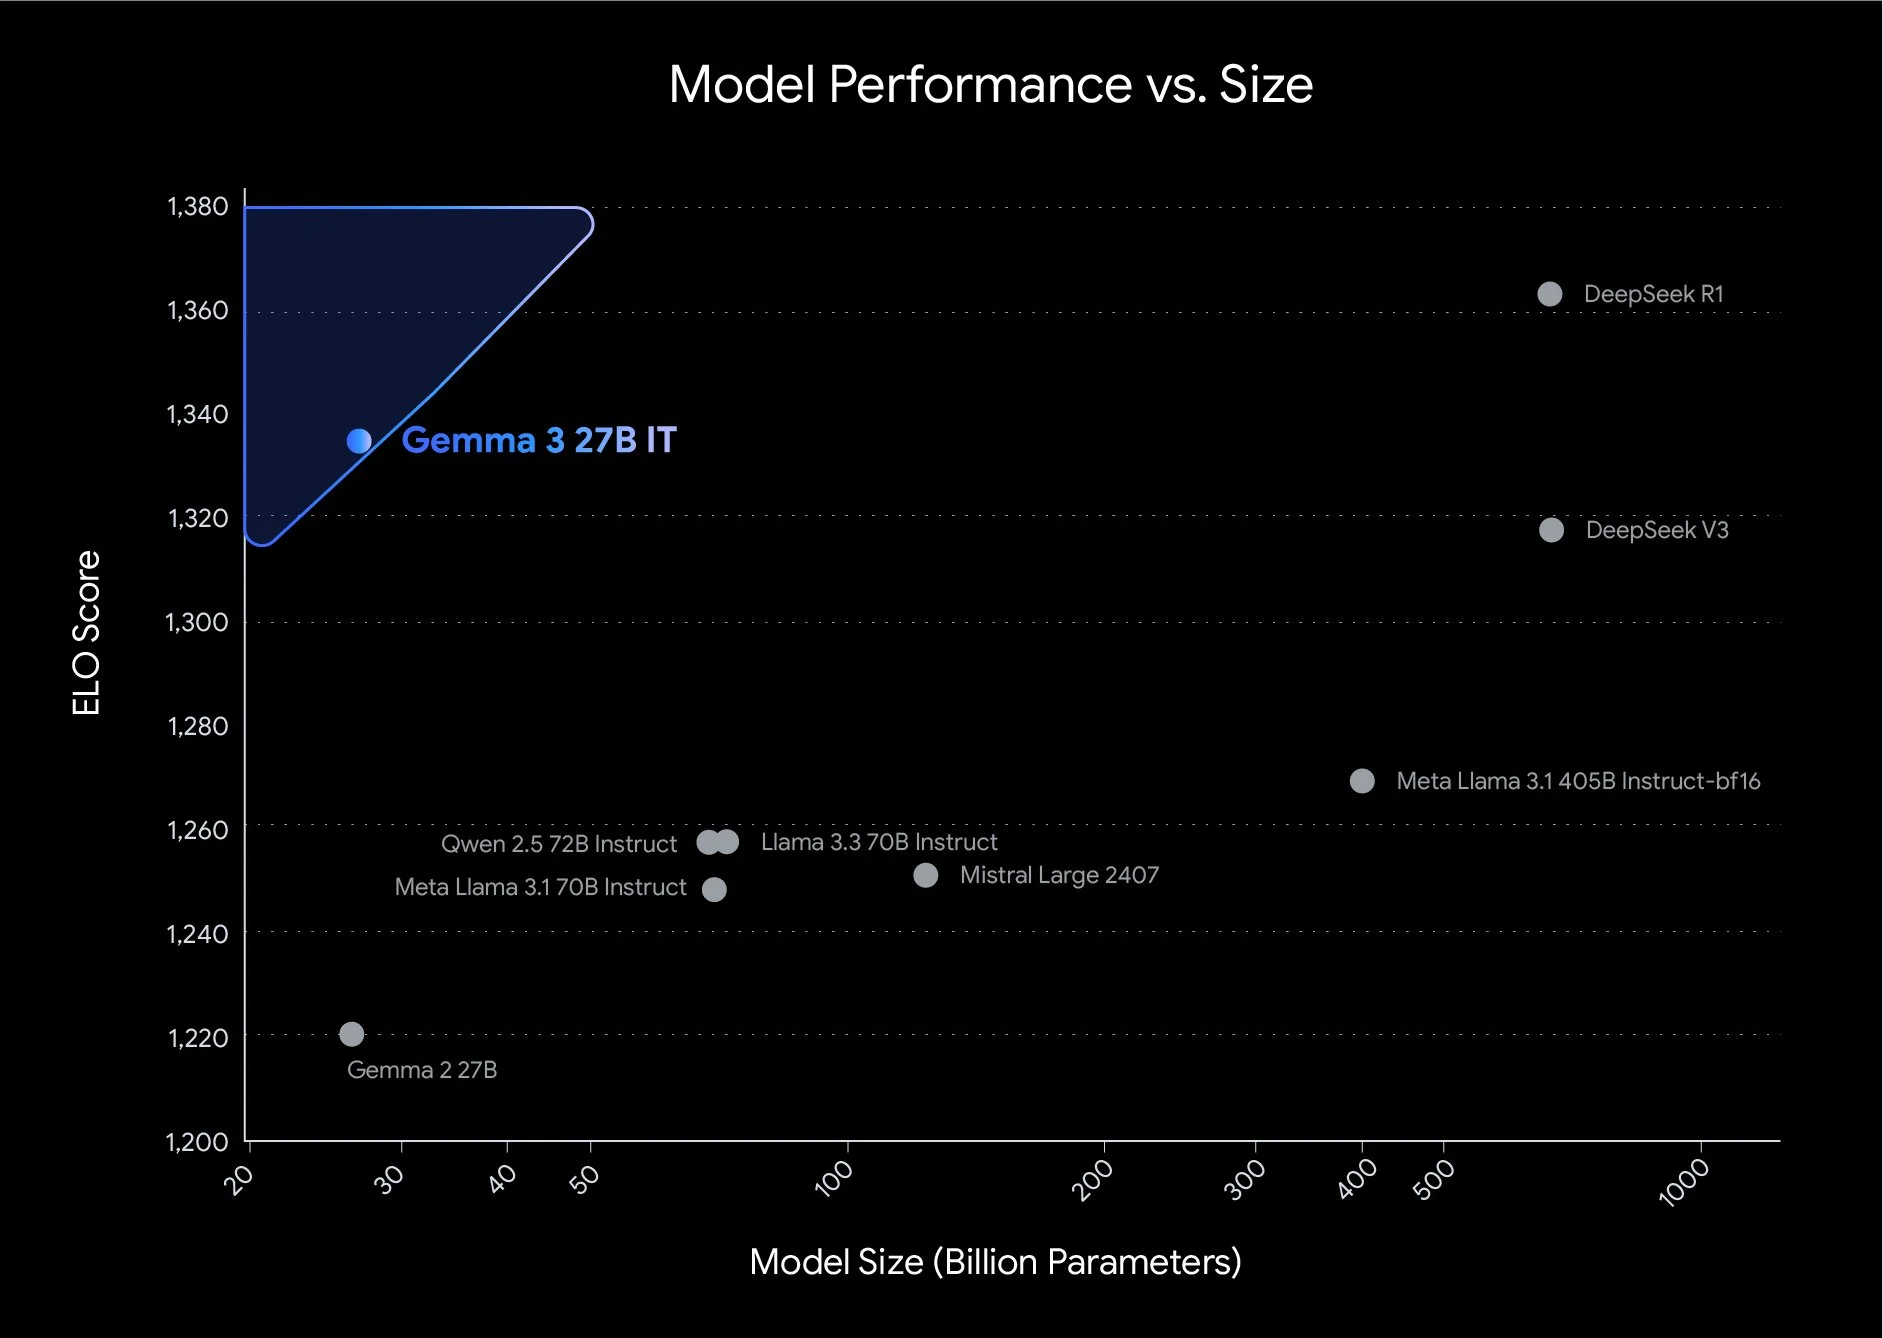
Gemma系列大模型是Google开源的一系列轻量级的大模型。就在刚才(2025年3月12日),Google开源了第三代Gemma系列大模型,共包含4个不同参数规模版本,第三代的Gemma 3系列是多模态大模型,即使是最小的10亿参数规模的Gemma 3-1B也支持多模态输入。

2025/03/12 22:50:222,215
腾讯发布了一个全新的大模型Hunyuan Turbo S:号称评测效果超过GTP-4o和DeepSeek V3等模型,但没有开源或者放开使用

腾讯发布了一个全新的大模型Hunyuan Turbo S:号称评测效果超过GTP-4o和DeepSeek V3等模型,但没有开源或者放开使用

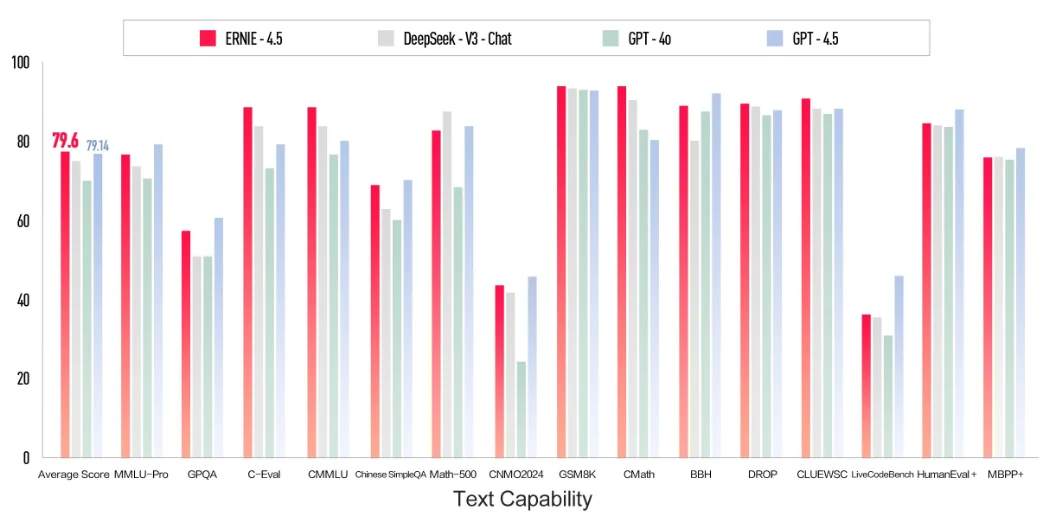
Hunyuan大模型是腾讯训练的大模型品牌名,2022年4月份,某中文语言理解能力排行榜第一名就出现了Hunyuan模型,在2022年11月,Hunyuan大模型就有了1万亿参数的规模,即HunYuan-NLP 1T大模型(比ChatGPT还早发布)。但是最近2年,这个系列的模型几乎没有出现在公众视野上。而昨天(2025年3月10日),Hunyuan官方在X平台上宣布了旗下最新的Hunyuan Turbo S大模型,称其在多个评测基准上超越了GPT-4o的表现。

2025/03/11 22:51:481,380
LiveCodeBench:全面的 LLM 代码评测基准基准

LiveCodeBench:全面的 LLM 代码评测基准基准

LiveCodeBench 由加州大学伯克利分校、麻省理工学院和康奈尔大学的研究人员开发,是一个先进的评测基准套件,专门用于严格评估大语言模型 (LLMs) 在代码处理方面的能力,并解决现有基准测试的局限性。通过引入实时更新的问题集和多维度评估方法,LiveCodeBench 确保对 LLM 进行公平、全面和稳健的评估。

2025/03/09 19:55:144,545
什么时候该使用推理大模型?OpenAI官方推出推理大模型和大语言模型的最佳使用指南

什么时候该使用推理大模型?OpenAI官方推出推理大模型和大语言模型的最佳使用指南

随着DeepSeek R1和OpenAI的o1、o3等推理大模型的发布,我们当前可使用的大模型种类也变多了。但是,推理大模型和普通大模型之间并不是二选一的关系,在不同的问题上二者各有优势。为了让大家更清晰理解推理大模型和普通大模型的应用场景。OpenAI官方推出了一个推理大模型最佳实践指南。描述了二者的对比。本文将总结这份推理大模型最佳实践指南。

2025/03/05 12:53:441,318
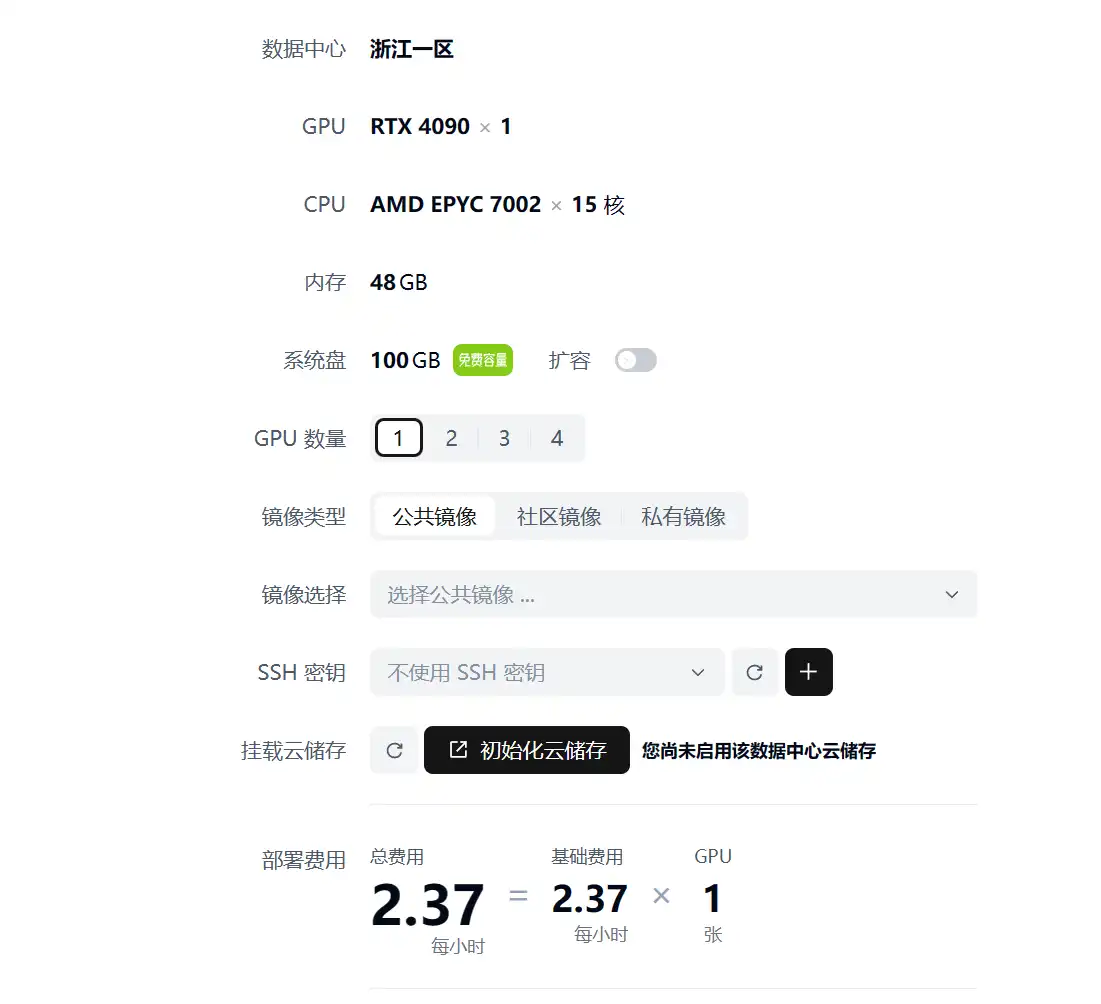
推荐一个国内可以按分钟计费的4090显卡租用公有云,一个小时24GB显存的4090只需要2.37元——仙宫云

推荐一个国内可以按分钟计费的4090显卡租用公有云,一个小时24GB显存的4090只需要2.37元——仙宫云

大模型的发展速度很快,对于需要学习部署使用大模型的人来说,显卡是一个必不可少的资源。使用公有云租用显卡对于初学者和技术验证来说成本很划算。DataLearnerAI在此推荐一个国内的合法的按分钟计费的4090显卡公有云服务提供商仙宫云,可以按分钟租用24GB显存的4090显卡公有云实例,非常具有吸引力~

2025/03/05 12:35:377,104
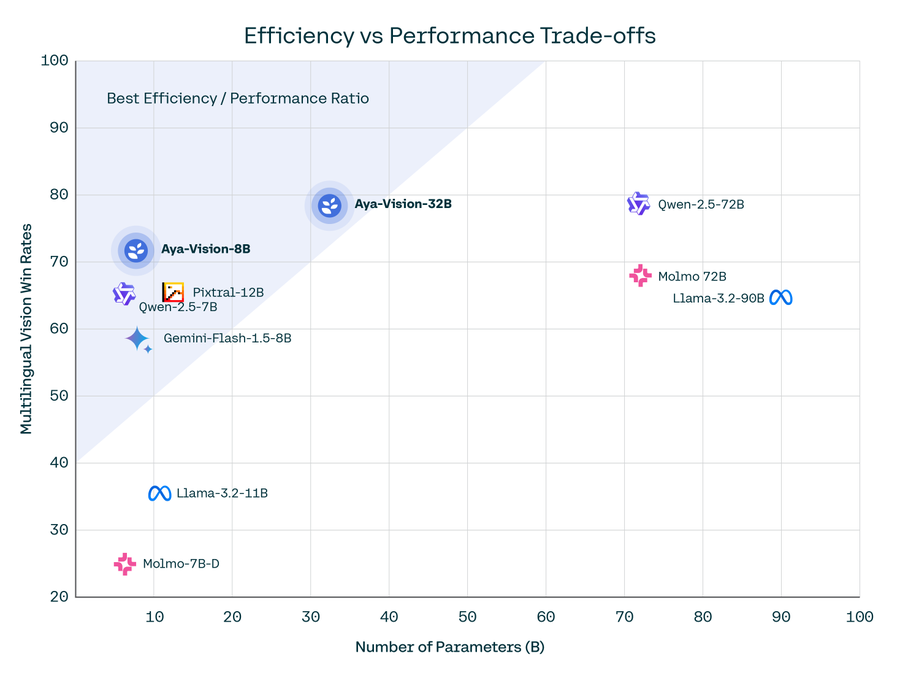
CohereAI开源了2个Aya Vision多模态大模型:80亿和320亿两种规格多模态大模型,评测结果超越Qwen2.5 72B和Llama 3.2 90B,支持23种语言

CohereAI开源了2个Aya Vision多模态大模型:80亿和320亿两种规格多模态大模型,评测结果超越Qwen2.5 72B和Llama 3.2 90B,支持23种语言

Cohere For AI 推出了 Aya Vision 系列,这是一组包含 80 亿(8B)和 320 亿(32B)参数的视觉语言模型(VLMs)。这些模型针对多模态AI系统中的多语言性能挑战,支持23种语言。Aya Vision 基于 Aya Expanse 语言模型,并通过引入视觉语言理解扩展了其能力。该系列模型旨在提升同时需要文本和图像理解的任务性能。

2025/03/04 23:24:06665
GPT-4.5:技术细节与用户反馈

GPT-4.5:技术细节与用户反馈

OpenAI 于 2025 年 2 月 27 日发布了 GPT-4.5,作为其语言模型系列的最新版本。尽管具体的技术细节因商业保密而未完全公开,基于现有信息和合理推测,DataLearner提供更具体的数据和分析,同时补充更多来自用户的评价。

2025/03/02 13:07:30972
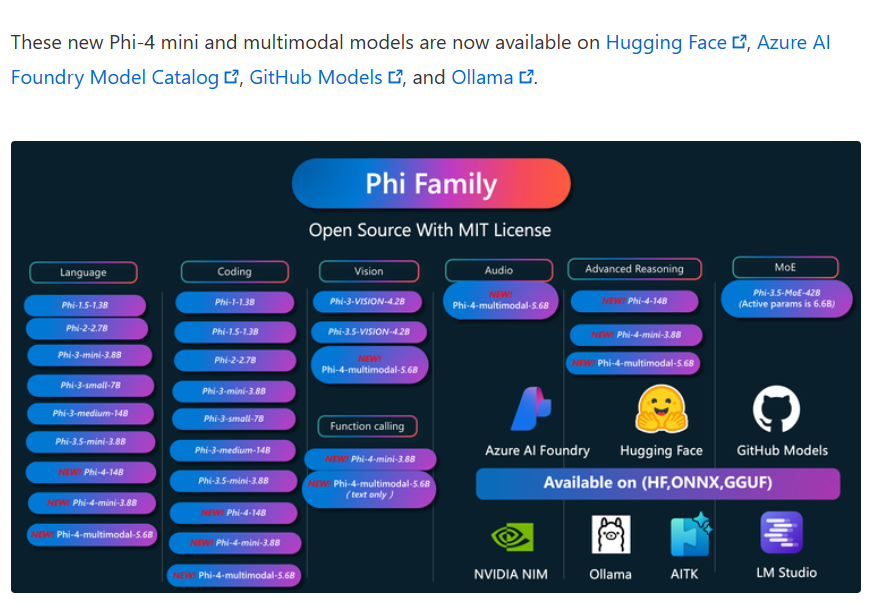
微软开源最强38亿小规模参数大语言模型以及56亿参数规模全模态大模型,但是总体评测结果超过Qwen2.5-7B以及Llama3.1-8B等模型,接近GPT-4o mini。

微软开源最强38亿小规模参数大语言模型以及56亿参数规模全模态大模型,但是总体评测结果超过Qwen2.5-7B以及Llama3.1-8B等模型,接近GPT-4o mini。

2025年2月27日,微软正式发布了其全新系列的大型语言模型——Phi-4系列。这一系列包含了三个创新性的模型:Phi-4-Mini、Phi-4-Multimodal和一款经过推理优化的Phi-4-Mini。此次发布的模型不仅在性能上展现出色,更在多模态能力与推理任务中实现了显著突破。其中,Phi-4-Multimodal是一个仅仅包含56亿参数规模的多模态大模型,但是支持文本、语音、图片的输入,十分强大。

2025/02/27 22:20:01927
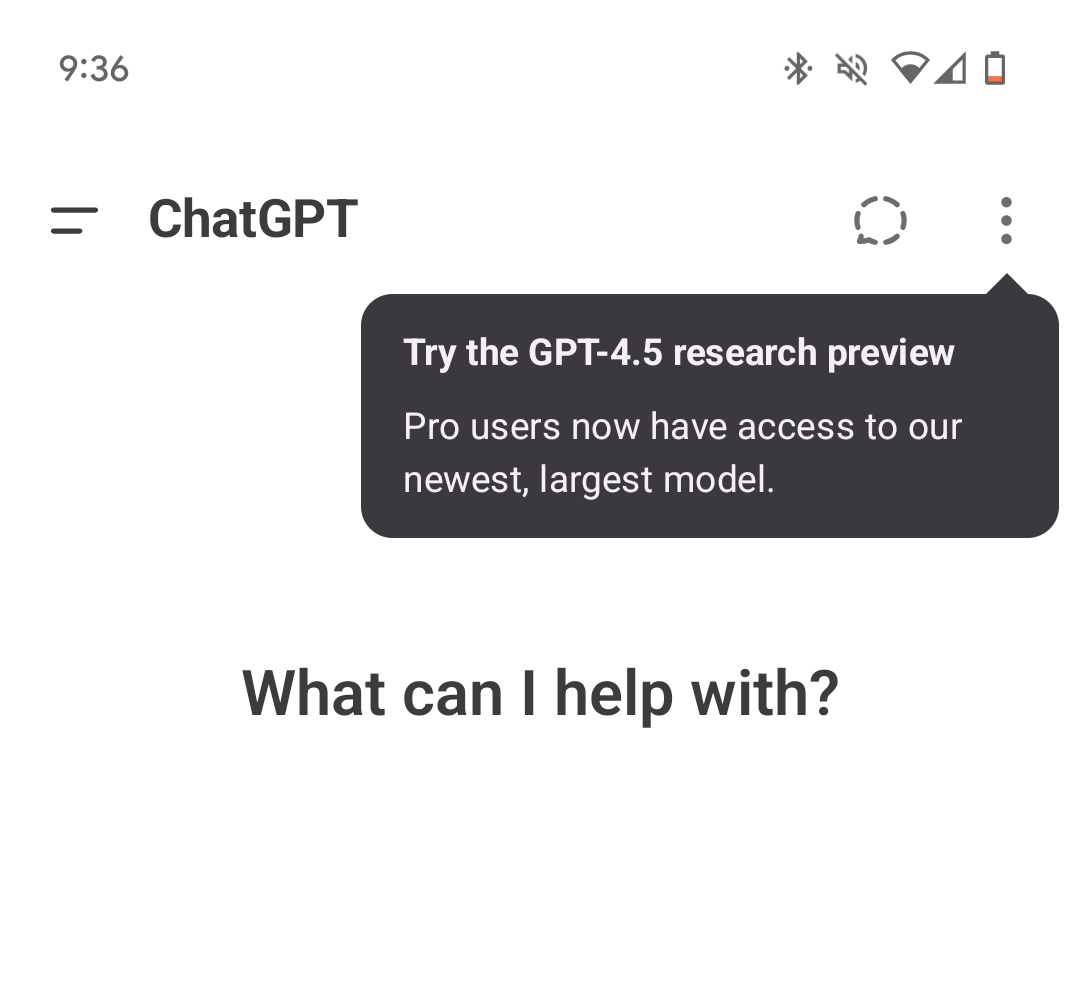
GPT-4.5发布时间越来越近,OpenAI安卓客户端泄露GPT-4.5即将推出,Pro用户可以做好准备,Plus用户请往后

GPT-4.5发布时间越来越近,OpenAI安卓客户端泄露GPT-4.5即将推出,Pro用户可以做好准备,Plus用户请往后

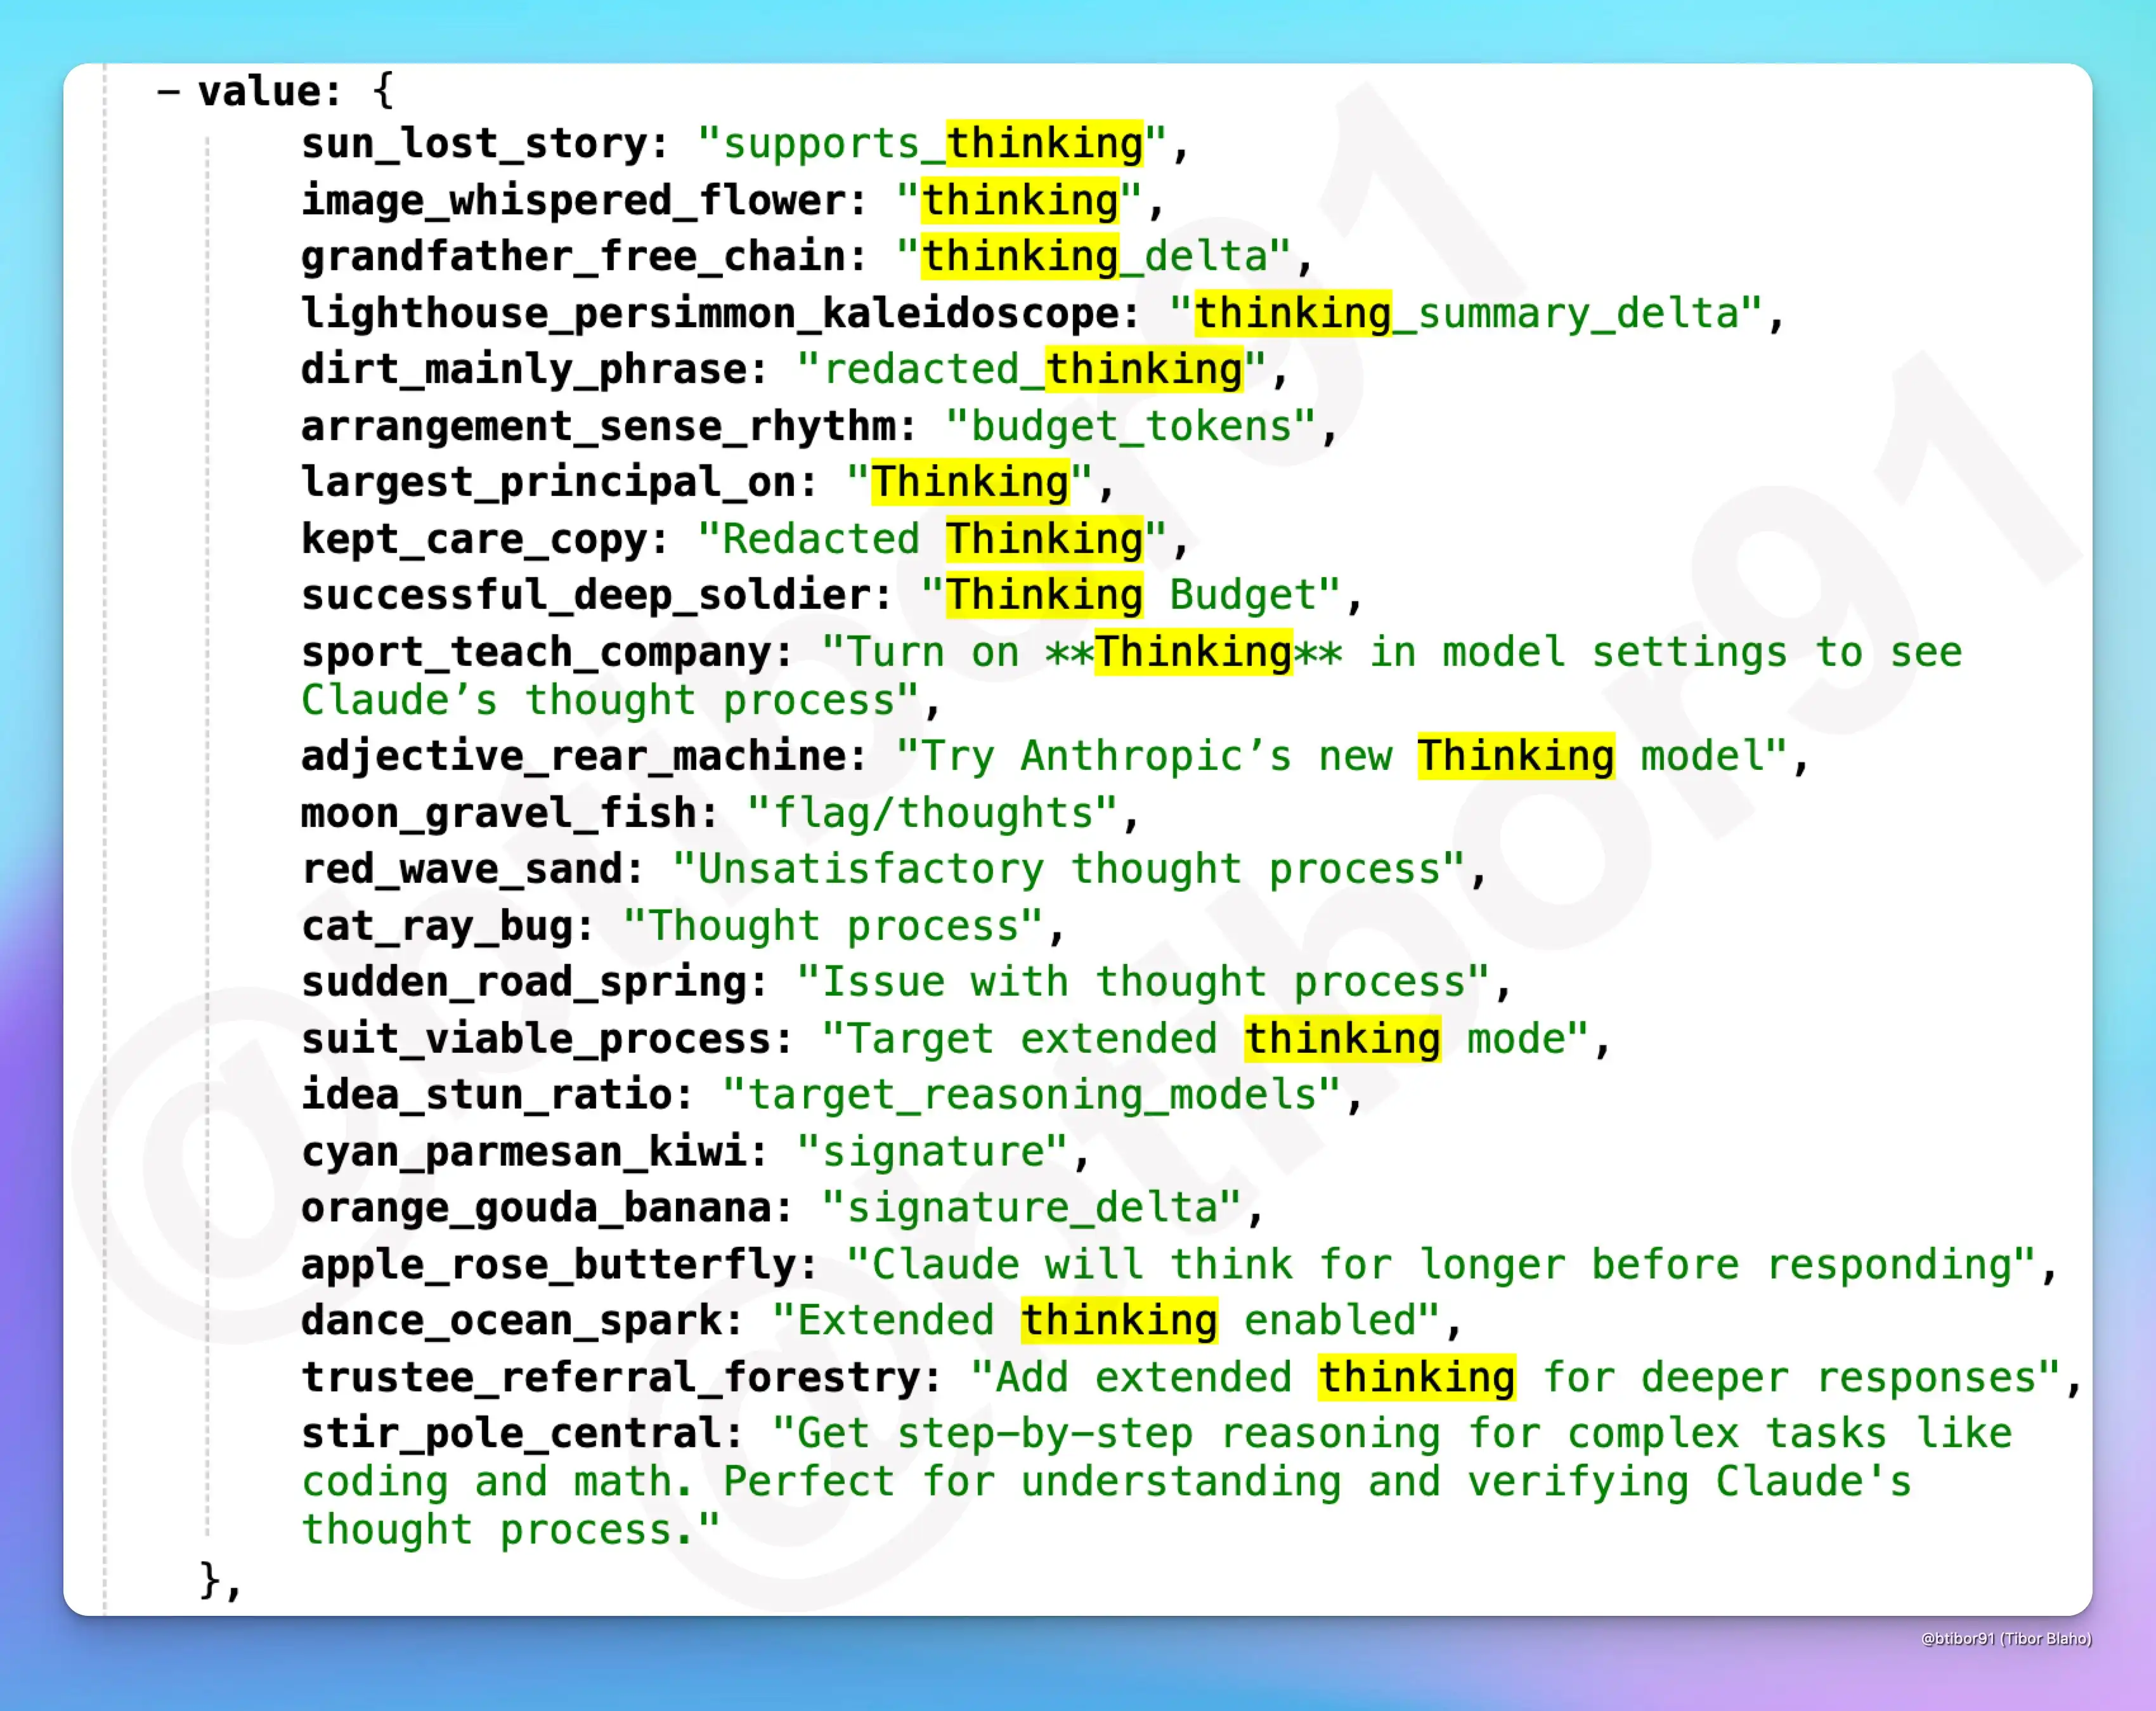
最近,一张截图在网络上流传,显示OpenAI安卓客户端的应用字符串文件(strings.xml)中出现了关于GPT-4.5的相关描述。这一发现引发了广泛关注,暗示OpenAI可能即将推出其最新的大型语言模型——GPT-4.5。该信息最早由开发者 @bitbor91 发现并分享,截图内容似乎来自ChatGPT安卓客户端的应用资源文件。

2025/02/26 18:49:57532
Anthropic发布Claude 3.7 Sonnet大模型,全球最强编程模型再次进步。业界第一个既支持标准输出也支持扩展思考推理双重模式的单一大模型,评测结果超DeepSeek R1,低于Grok3-Beta Reasoning,免费用户可用

Anthropic发布Claude 3.7 Sonnet大模型,全球最强编程模型再次进步。业界第一个既支持标准输出也支持扩展思考推理双重模式的单一大模型,评测结果超DeepSeek R1,低于Grok3-Beta Reasoning,免费用户可用

2025年2月25日,Anthropic发布了Claude 3.7 Sonnet大模型,该模型是业界第一个同时支持标准输出和深度推理模式的单一大模型,各项评测相比较Claude Sonnet 3.5大幅提升。特别是代码能力进一步增强。

2025/02/25 14:25:561,393
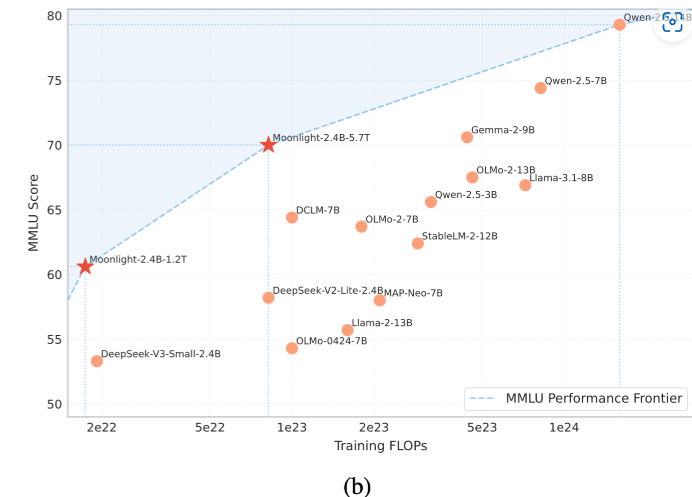
月之暗面开源了一个全新的160亿参数规模的MoE大语言模型Moonlight-16B:其训练算力仅需业界主流的一半

月之暗面开源了一个全新的160亿参数规模的MoE大语言模型Moonlight-16B:其训练算力仅需业界主流的一半

月之暗面(Moonshot AI)是此前中国大模型企业中非常受关注的一家企业。旗下的Kimi大模型和产品因为强悍的性能、超长的上下文以及非常快速的响应引起了广泛的关注。不过,此前MoonshotAI的策略一直是闭源模型,但是产品免费。也许是受到了DeepSeek的压力,月之暗面在2025年2月23日首次开源了旗下的一个小规模参数的大语言模型Moonlight-16B。

2025/02/23 21:08:111,220
SWE-Lancer:OpenAI发布的一个全新大模型评测基准,用来测试大模型解决真实世界软件工程的能力

SWE-Lancer:OpenAI发布的一个全新大模型评测基准,用来测试大模型解决真实世界软件工程的能力

短短两年间,AI技术的进步为软件工程带来了新的可能性。然而,这些模型在真实世界的软件工程任务中究竟能发挥多大的作用?它们能否通过完成实际的软件工程任务来赚取可观的收入?为了验证大模型解决真实任务的能力和水平,OpenAI发布了一个全新的大模型评测基准SWE-Lancer来评测大模型这方面的能力。

2025/02/19 21:40:31776